لوپ انجینئرنگ: ایک فوری کورس
15 تصورات · ایجنٹک کوڈنگ سے ایسے خود کار پرامپٹنگ نظاموں تک جو آپ کے سوتے وقت بھی کام کریں، بلکہ خواب بھی دیکھیں
آپ کوڈنگ ایجنٹ استعمال کرنا پہلے ہی جانتے ہیں۔ آپ اسے ایک ہدایت دیتے ہیں۔ وہ آپ کی فائلیں پڑھتا اور بدلتا ہے، پھر آپ اس کا کام جانچتے ہیں۔ اس کے بعد آپ اگلی ہدایت دیتے ہیں، پھر اس سے اگلی۔ ہر قدم آپ کے قابو میں رہتا ہے۔
اب تصور کریں کہ آپ قدم بہ قدم رہنمائی چھوڑ دیتے ہیں۔ اس کی جگہ ایک چھوٹا سا نظام بناتے ہیں۔ یہ ہر صبح خود شروع ہوتا ہے، رات بھر کی تبدیلیاں دیکھتا ہے، طے کرتا ہے کہ کیا کرنا ہے، ہر کام کسی ایجنٹ کو دیتا ہے، نتیجہ جانچتا ہے، اور صرف ان فیصلوں کے لیے آپ کو بلاتا ہے جن میں واقعی انسان درکار ہو۔ آپ یہ نظام ایک بار بناتے ہیں؛ اس کے بعد یہ خود چلتا ہے۔
یہی لوپ انجینئرنگ ہے۔ اب سب سے اہم مہارت آپ کا لکھا ہوا پرامپٹ نہیں بلکہ آپ کا بنایا ہوا لوپ ہے۔ یہ کورس دو باتیں سکھاتا ہے: لوپ کن حصوں سے بنتا ہے، اور اسے کیسے بنایا جاتا ہے۔ آپ اسے Claude Code اور OpenCode دونوں میں بنائیں گے۔ دونوں بہت مختلف طریقوں سے ایک ہی نتیجے تک پہنچتے ہیں۔
پہلے یہ درکار ہے: Claude Code اور OpenCode: ایک فوری کورس۔ اس کورس نے plan mode، سیاق کا انتظام، قواعد کی فائل، مہارتیں، subagents اور MCP سکھائے تھے۔ موجودہ کورس فرض کرتا ہے کہ آپ یہ سب جانتے ہیں۔ اگر یہ الفاظ نئے ہیں تو پہلے وہ کورس کریں، کیونکہ لوپ انجینئرنگ اسی بنیاد پر بنتی ہے۔ پہلے Spec-Driven Development کرنا بھی مفید ہے۔ لوپ کی رکنے کی شرط دراصل ایک spec ہوتی ہے، اور وہ کورس اسے لکھنا سکھاتا ہے۔ آپ اس کے بغیر بھی ساتھ چل سکتے ہیں، مگر آپ کے لوپ اتنے ہی اچھے ہوں گے جتنی اچھی شرطیں آپ لکھ سکیں۔
یہاں نئے ہیں؟ جو کچھ پہلے سے معلوم ہونا چاہیے، اس کا 2 منٹ کا خلاصہ
- Plan mode: ایجنٹ آپ کی فائلیں پڑھ کر کسی تبدیلی سے پہلے منصوبہ دکھاتا ہے۔ آپ پہلے منظوری دیتے ہیں۔
- قواعد کی فائل (
CLAUDE.md/AGENTS.md): مختصر، مستقل نوٹس جنہیں ایجنٹ ہر سیشن کے آغاز میں پڑھتا ہے۔ - مہارتیں (
SKILL.md): محفوظ ہدایت جسے ایجنٹ صرف متعلقہ کام آنے پر لوڈ کرتا ہے۔ - Subagents: اپنی الگ سیاقی کھڑکی رکھنے والا مددگار۔ وہ ایک کام کرتا ہے اور صرف نتیجہ واپس دیتا ہے۔
- Connectors / MCP: ایجنٹ کو بیرونی ٹولز، مثلا GitHub، Slack یا ڈیٹابیس سے جوڑنے کا معیاری طریقہ۔
- سیاق کا انتظام: گفتگو مختصر رکھیں۔ بھرنے کے ساتھ ماڈل کی کارکردگی گرتی اور لاگت بڑھتی ہے۔
اگر ان میں سے کوئی بات نئی ہے تو پہلے ایجنٹک کوڈنگ فوری کورس کریں۔ موجودہ کورس انہی خیالات کو براہ راست استعمال کرتا ہے۔
اہم الفاظ، سادہ زبان میں
یہ الفاظ پورے کورس میں آئیں گے۔ ابھی فہرست ایک بار پڑھیں، پھر جب کوئی اصطلاح غیر واضح لگے تو واپس دیکھ لیں۔
| اصطلاح | سادہ مطلب |
|---|---|
| ایجنٹ | اے آئی نظام جو ٹولز استعمال کر کے مراحل مکمل کر سکتا ہے، صرف سوال کا جواب نہیں دیتا۔ |
| پرامپٹ | وہ ہدایت جو آپ ایجنٹ کو دیتے ہیں۔ |
| لوپ | ایسا نظام جو کام شروع کرتا، اسے جانچتا، نتیجہ محفوظ کرتا، اور ضرورت پر دہراتا ہے۔ |
| بیٹ | لوپ کا ایک مکمل چلاؤ۔ |
| دھڑکن | وہ schedule، event یا condition جو ایک بیٹ شروع کرے۔ |
| Trigger / fire | کسی run کو شروع کرنا۔ مثال کے طور پر GitHub کا واقعہ کسی Routine کو trigger، یعنی fire، کر سکتا ہے۔ |
| بغیر نگرانی | ہر قدم پر کسی انسان کی نگرانی کے بغیر چلنا۔ |
| رکنے کی شرط | قابل جانچ اصول جو لوپ کو بتاتا ہے کہ کام کب مکمل ہوا۔ |
| Maker-checker | ایک ایجنٹ کام بناتا ہے؛ دوسرا ایجنٹ یا کمانڈ اسے جانچتا ہے۔ |
| Worktree | الگ کام کا فولڈر اور branch جو متوازی ایجنٹس کو ایک ہی فائلیں بدلنے سے روکتا ہے۔ |
| مہارت | محفوظ پروجیکٹ ہدایات جنہیں ایجنٹ دوبارہ استعمال کر سکے۔ |
| Connector / MCP | ایسا رابطہ جس سے ایجنٹ GitHub، Slack یا ڈیٹابیس جیسے بیرونی نظام کو استعمال کر سکے۔ |
| State / memory | ماڈل سے باہر محفوظ معلومات تاکہ اگلا run جان سکے کہ پہلے کیا ہوا تھا۔ |
| ریڑھ کی ہڈی | محفوظ state کے لیے اس کورس کی اصطلاح، جو ایک بیٹ کو اگلے بیٹ سے جوڑتی ہے۔ |
| انسانی دروازہ | وہ مقام جہاں خطرناک عمل آگے بڑھنے سے پہلے انسان کا جائزہ یا منظوری لازمی ہو۔ |
| Routine | Claude Code کی cloud automation، جو محفوظ پرامپٹ اور trigger سے نیا سیشن شروع کرتی ہے۔ |
کورس کبھی جسم کی مثال استعمال کرتا ہے: دھڑکن کام شروع کرتی ہے، جسم اسے انجام دیتا ہے، اور ریڑھ کی ہڈی runs کے درمیان یادداشت لے جاتی ہے۔ ہر مثال کے ساتھ اس کا تکنیکی مطلب بھی دیا گیا ہے۔
2026 میں ان ٹولز کے بنانے والوں نے بات صاف لفظوں میں کہی۔ Claude Code بنانے والے Boris Cherny نے کہا: "میں اب Claude کو پرامپٹ نہیں کرتا۔ میرے پاس ایسے لوپ چل رہے ہیں جو Claude کو پرامپٹ کرتے ہیں... میرا کام لوپ لکھنا ہے۔" OpenClaw بنانے والے Peter Steinberger نے کہا: "آپ کو ایسے لوپ ڈیزائن کرنے چاہییں جو آپ کے ایجنٹس کو پرامپٹ کریں۔" پھر Addy Osmani نے اس pattern کو نام دیا اور اس کے حصے گنوائے۔ کوئی یہ نہیں کہتا کہ کام آسان ہو گیا۔ ان کا کہنا ہے کہ اہم مہارت کی جگہ بدل گئی۔ پورا کورس اسی خیال پر قائم ہے۔
کچھ لوگ لوپ ڈیزائن کو اس وقت ایجنٹ بنانے کی سب سے اہم مہارت کہتے ہیں۔ دوسرے کہتے ہیں کہ یہ صرف اس کام کا نیا نام ہے جو ایجنٹ ٹولز پہلے ہی کرتے تھے۔ دونوں باتیں کسی حد تک درست ہیں۔ حصے نئے نہیں، مگر اب روزمرہ استعمال کے لیے کافی سستے اور قابل اعتماد ہو گئے ہیں۔ اس لیے اصل کام ہر باری ایجنٹ کی رہنمائی کے بجائے لوپ بنانا بنتا جا رہا ہے۔ کوئی نام اس وقت مفید ہوتا ہے جب وہ طریقہ عام کام بن جائے۔ (اہم اقتباسات، دعوے اور تکنیکی تفصیلات آخر میں ذرائع اور مزید مطالعہ میں درج ہیں۔)
ذہنی تبدیلی، ایک تصویر میں
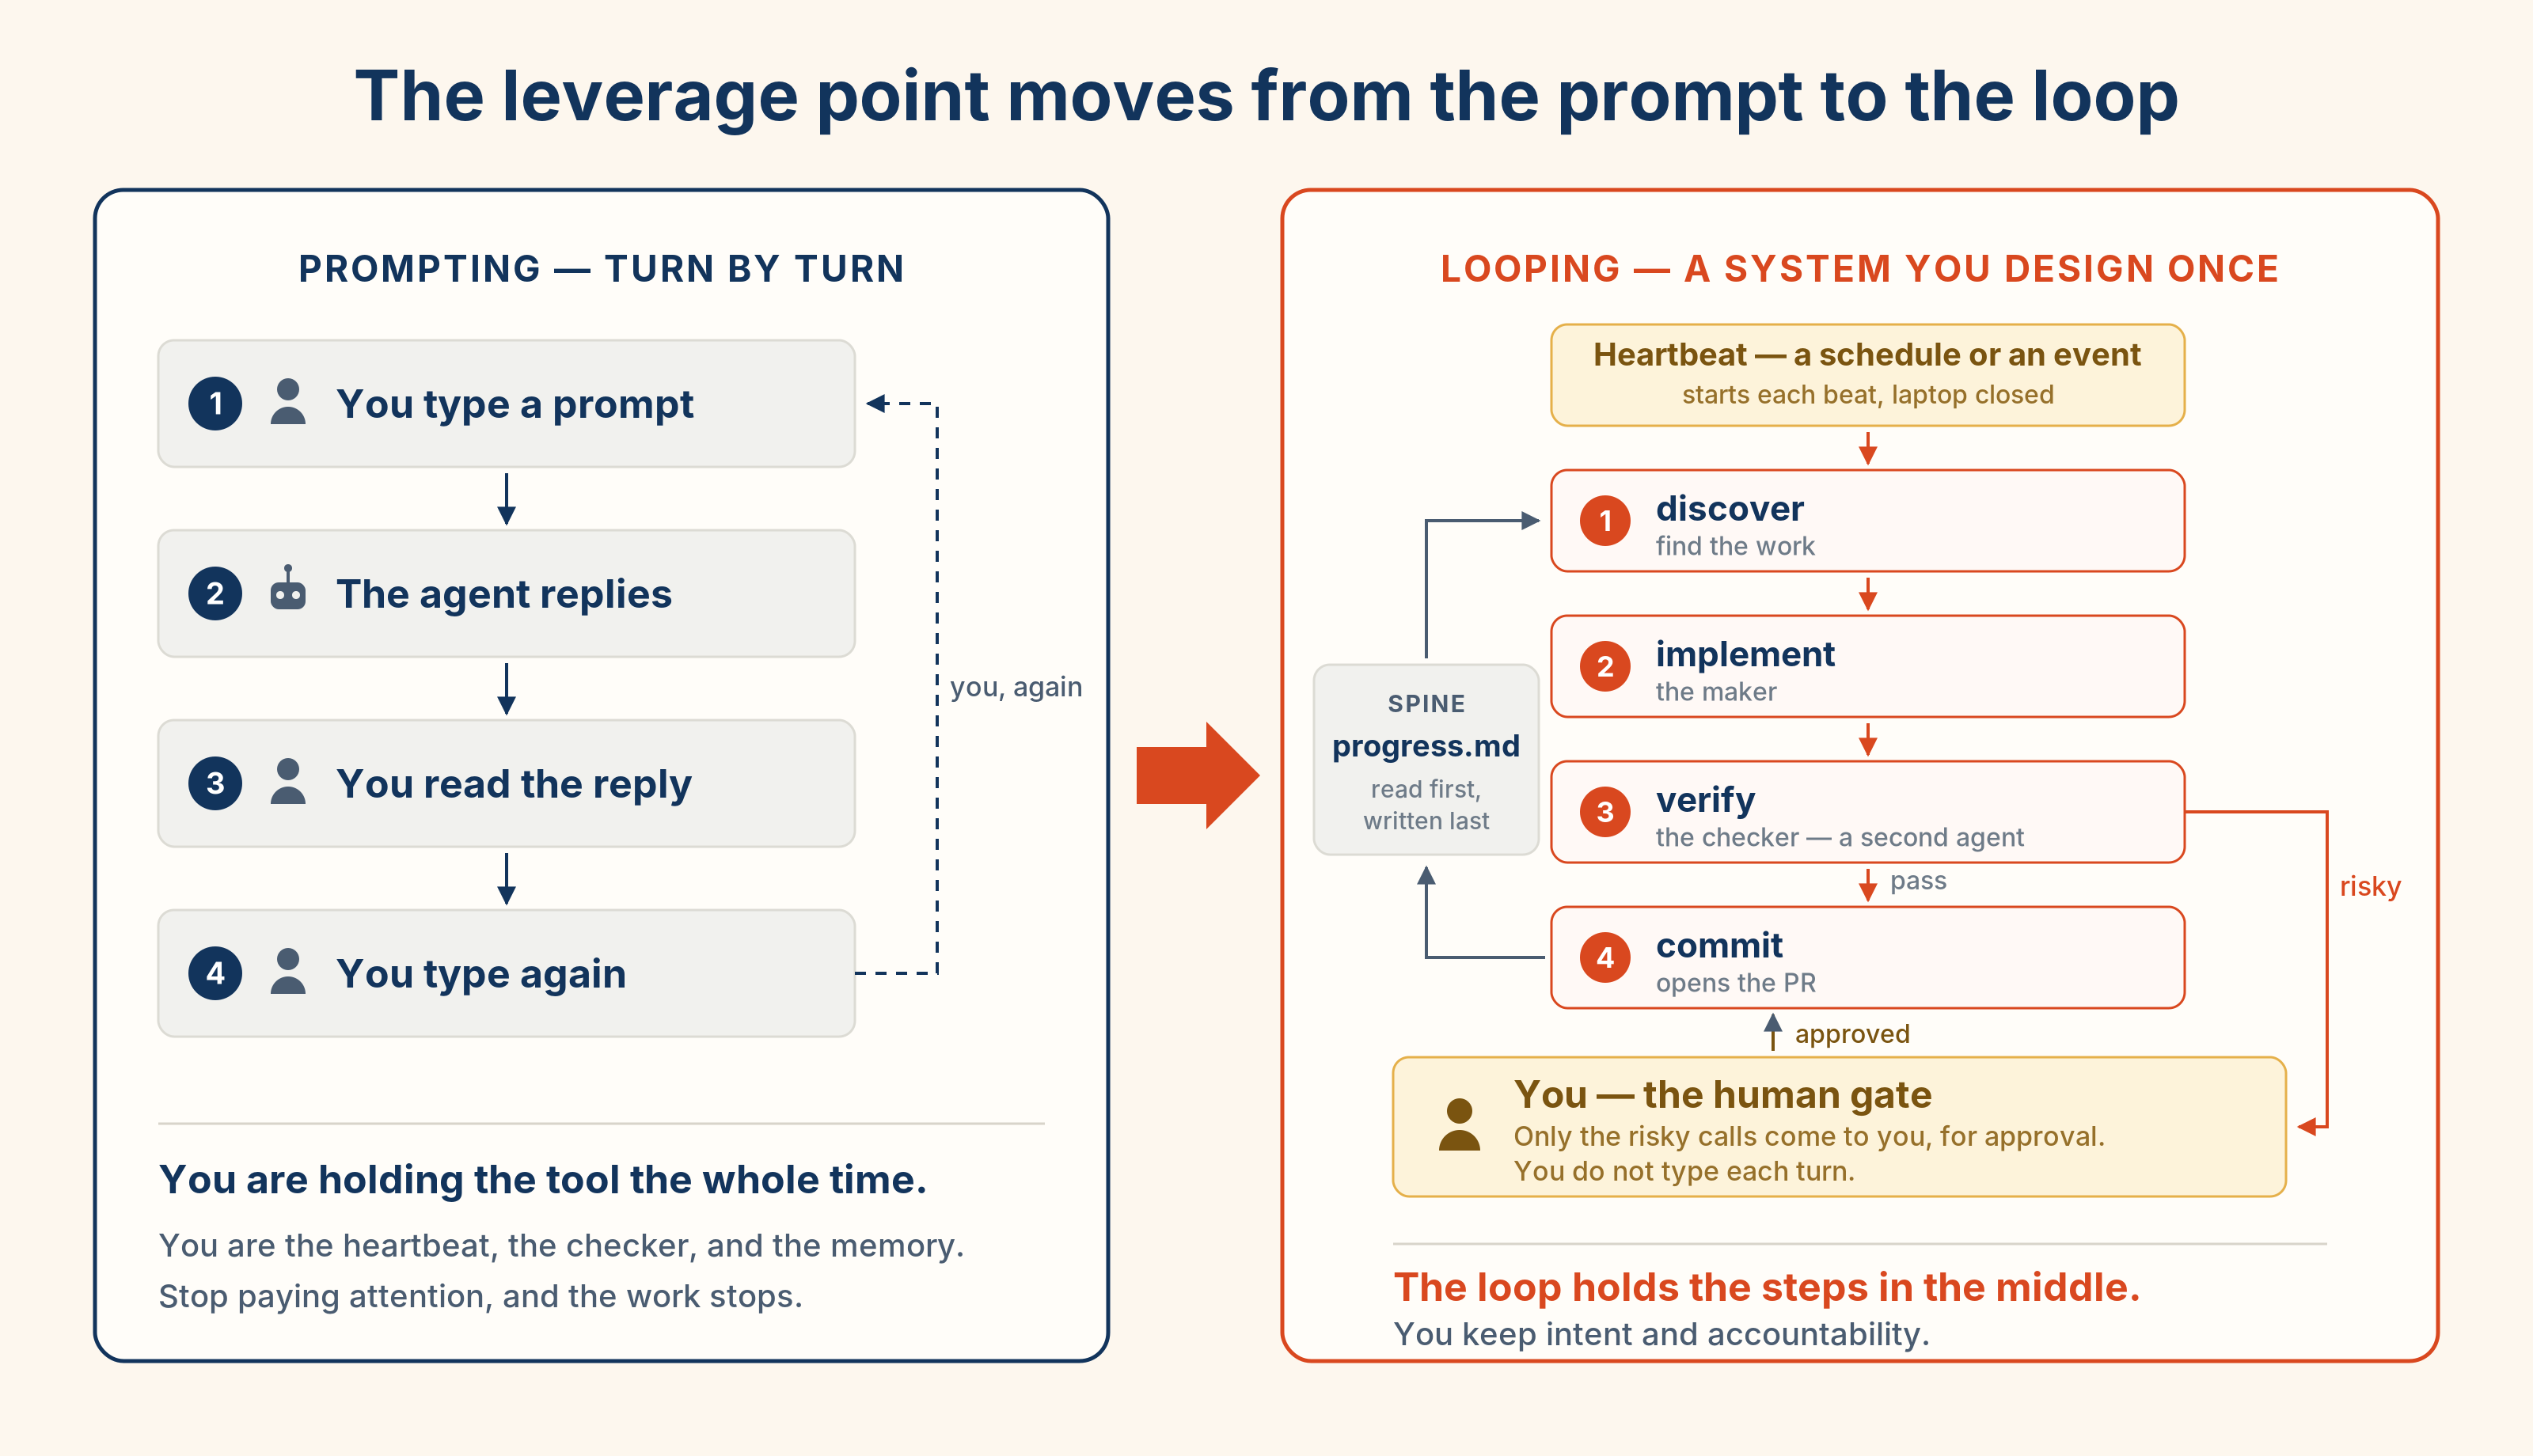
اوپر کی تصویر کو خود چلا کر دیکھیں۔ بائیں جانب ہر قدم خود شروع کریں، پھر دائیں جانب اس نظام سے مقابلہ کریں جو ہر قدم خود شروع کرتا ہے۔ آپ ہر بدلی ہوئی جگہ دوبارہ دیکھیں گے: حصہ 2 میں schedule، تصور 11 میں checker، اور حصہ 5 میں انسانی دروازہ۔
یہ کورس دو ٹولز ساتھ سکھاتا ہے۔ جو طریقہ دونوں میں کام کرے، وہ کسی ایک پروڈکٹ کا کرتب نہیں بلکہ قابل انتقال مہارت ہے۔ دونوں ٹولز حصے مختلف انداز سے دیتے ہیں۔ Claude Code میں لوپ کی بہت سی خصوصیات پہلے سے شامل ہیں۔ OpenCode ایجنٹ worker دیتا ہے، جبکہ ہر run شروع کرنے کے لیے آپ آپریٹنگ سسٹم یا CI استعمال کرتے ہیں۔ کمانڈز مختلف ہیں، مگر لوپ کی شکل ایک ہی رہتی ہے۔
Claude Code لوپ کی زیادہ خصوصیات خود دیتا ہے۔ OpenCode worker دیتا ہے، اور schedule سمیت دوسرے حصے آپ خود جوڑتے ہیں۔
جولائی 2026 کے وسط تک درست۔ دونوں ٹولز تیزی سے بدلتے ہیں، اور Claude Code کی کئی لوپ خصوصیات تحقیقاتی آزمائش میں ہیں۔ ہر سیشن سے پہلے
claude updateیاopencode upgradeچلائیں۔ کسی حد یا flag پر بھروسا کرنے سے پہلے براہ راست دستاویزات (code.claude.com/docs، opencode.ai/docs) دیکھیں۔
لوپ کہاں چل سکتا ہے؟
حقیقی لوپ بغیر نگرانی چلتا ہے۔ آپ کی غیر موجودگی میں یہ خود کو پرامپٹ کرتا ہے۔ جولائی 2026 تک ویب یہ کام بالکل نہیں کر سکتا تھا۔ claude.ai اور chatgpt.com پر صرف chat box ہوتا تھا، اور chat box ہر باری آپ کا انتظار کرتا ہے: schedule آپ تھے۔ حقیقی لوپ چلانے کے لیے browser چھوڑ کر خود fire ہونے والا ٹول، یعنی Claude Code یا OpenCode، استعمال کرنا پڑتا تھا۔
جولائی 2026 میں یہ بدل گیا۔ دونوں کمپنیوں نے اپنے agent products انہی ویب پتے میں شامل کر دیے۔ Claude Cowork اب claude.ai پر چلتا ہے؛ Cowork فوری کورس دیکھیں۔ اس کے دور دراز سیشن Anthropic کے servers پر چلتے ہیں، اس لیے scheduled لوپ اس browser tab کے بند ہونے کے بہت بعد بھی fire ہوتا ہے۔ ChatGPT Work یہی کام chatgpt.com پر کرتا ہے۔ اس لیے "ویب پر لوپ نہیں چل سکتا" اب درست نہیں۔ درست بات یہ ہے: chat box میں لوپ نہیں چل سکتا، مگر اس کے گرد موجود ویب صفحات پر چل سکتا ہے۔ ان میں زیادہ تر سہولتیں paid ہیں، اور کئی مرحلہ وار beta میں جاری ہو رہی ہیں۔ آپ لوپ کہیں بھی سیکھ اور ڈیزائن کر سکتے ہیں۔ اسے چلانے کے لیے ان میں سے کوئی سطح چاہیے۔ یہ کورس کوڈنگ والی دونوں سطحیں دکھاتا ہے۔ اچھا سوال ہے۔ جواب جولائی 2026 میں بدل گیا، اس لیے اسے پہلے اور بعد کی صورت میں دیکھیں۔ جولائی 2026 سے پہلے: claude.ai اور chatgpt.com chat boxes تھے۔ chat box ہر باری آپ کا انتظار کرتا ہے؛ schedule یا event پر خود شروع نہیں ہو سکتا۔ آپ اسے ہاتھ سے دوبارہ پرامپٹ کر سکتے تھے، مگر تب دھڑکن آپ ہوتے، جبکہ لوپ اسی کام کو ہٹاتا ہے۔ اس لیے ویب پر لوپ نہیں چل سکتا تھا۔ آپ وہاں اسے ڈیزائن کرتے، پھر Claude Code یا OpenCode میں چلاتے تھے۔ جولائی 2026 کے بعد: دونوں کمپنیوں نے اپنے agent products انہی ویب پتوں میں رکھ دیے۔ chat box اب بھی ہر باری آپ کا انتظار کرتا ہے اور کرتا رہے گا۔ تبدیلی اس کے ساتھ موجود چیزوں میں آئی: دو کمپنیاں، چند دن کے فرق سے، لوپ کو browser میں لے آئیں۔ یہ اس کورس کے مرکزی دعوے کی اب تک سب سے مضبوط دلیل ہے: مہارت ٹول نہیں بلکہ شکل ہے۔ یوں کام کی تقسیم ختم نہیں ہوئی بلکہ زیادہ واضح ہو گئی۔ chat box وہ جگہ ہے جہاں آپ لوپ ڈیزائن اور مشق کرتے ہیں: skill کا مسودہ بنائیں، reviewer کا پرامپٹ لکھیں، رکنے کی شرط طے کریں، ایک بیٹ ہاتھ سے چلائیں۔ اس کے ساتھ agent surface، چاہے Cowork ہو، Routine، ChatGPT Work یا OpenCode، وہ جگہ ہے جہاں آپ اسے چلاتے ہیں۔ Spec-Driven Development کے بعد یہ قدرتی اگلا قدم ہے۔ جولائی 2026 کے وسط تک درست۔ ویب پر Cowork اور ChatGPT Work دونوں چند ہفتے پرانے ہیں، plans کے مطابق مرحلہ وار جاری ہو رہے ہیں، اور استعمال ناپا جاتا ہے۔ کسی حد یا خصوصیت پر انحصار سے پہلے براہ راست product pages دیکھیں۔"مگر میں نے پورا Spec-Driven کورس claude.ai میں کیا تھا۔ کیا وہاں لوپ بھی چلا سکتا ہوں؟"
claude.ai/code/routines پر بنایا جاتا ہے۔ یہ Anthropic کے servers پر تازہ cloud sessions چلاتی ہیں، laptop بند ہو تب بھی۔ paid plan اور تحقیقاتی آزمائش درکار ہے۔
chat box میں لوپ ڈیزائن اور اس کی مشق کریں۔ بغیر نگرانی چلانے کے لیے ایسی سطح استعمال کریں جو خود fire ہو: Claude Code، OpenCode، Cowork یا ChatGPT Work۔ جولائی 2026 کے بعد اس کے لیے browser چھوڑنا ضروری نہیں۔ Cowork claude.ai اور ChatGPT Work chatgpt.com پر چلتے ہیں۔
یہاں سے آگے تقریبا ہر تصور حقیقی session میں چلایا جا سکتا ہے، صرف پڑھا نہیں جاتا۔ اس صفحے کے ساتھ terminal (claude یا opencode) کھلا رکھیں اور ہر خیال سامنے آتے ہی آزمائیں۔ کسی چھوٹے، غیر اہم git repo سے شروع کریں تاکہ لوپ آپ کی کسی ضروری چیز کو نقصان نہ پہنچا سکے۔
یہ کورس کیا سکھاتا ہے
| حصہ | موضوع | آپ کیا سیکھتے ہیں |
|---|---|---|
| 1 | تبدیلی | لوپ کیا ہے، اس کے چھ حصے، اور اسے بنانے کے دو طریقے |
| 2 | لوپ کو کیا شروع کرتا ہے | کسی چیز کو خود سے چلانا: session کے اندر، شرط پوری ہونے تک، schedule پر، یا event سے |
| 3 | لوپ ہر run میں کیا کرتا ہے | isolation، علم، عمل، اور maker-checker تقسیم |
| 4 | runs کے درمیان یادداشت | وہ state جو runs کے درمیان باقی رہتی ہے، یعنی وہ حصہ جسے لوگ بھول جاتے ہیں |
| 5 | ایک لوپ، دو بار | صبح کی triage سے PR تک ایک مکمل لوپ، حقیقی فائلوں کے ساتھ دونوں ٹولز میں |
| 6 | انسانی اختیار برقرار رکھنا | token کی لاگت، کام کی جانچ، اور لوپ بہتر ہونے کے ساتھ بڑھنے والے خطرے |
| عملی | کتاب کے اپنے لوپ | وہ دو loops جو اس کورس پر production میں چلتے ہیں، اور ہر ایک میں انسان کہاں آتا ہے |
| مشق | مشق کے projects | آٹھ loops، آسان سے مشکل، جنہیں آپ خود بناتے ہیں |
| ضمیمہ | Routines، آغاز سے اختتام تک | Routines کی مکمل رہنمائی: form کا ہر field، تینوں triggers، secrets، عام مسائل، تین عملی drills اور capstone |
تین لوپس جو آج چلا سکتے ہیں، صرف پڑھ نہیں سکتے
کورس کا زیادہ حصہ خیالات پر مشتمل ہے، مگر یہ تین صرف خیالات نہیں۔ چار دھڑکنوں میں سے تین کے ساتھ ایک چھوٹا project ہے جسے چند منٹ میں clone اور fire کیا جا سکتا ہے۔ ہر project اسی تصور کے اندر ہے جو اسے سمجھاتا ہے، تاکہ مناسب وقت پر سامنے آئے۔
| Project | تصور | کیا ہوتا ہے |
|---|---|---|
| خلائی اسٹیشن دیکھیں | 4، session کے اندر | ایک سادہ جملہ لکھیں، اور حقیقی ISS ہر منٹ اپنی جگہ بتائے گا جبکہ آپ کچھ اور کریں گے۔ terminal بند کریں تو نگرانی ختم، اور یہی تصور ہے۔ |
| اپنا portfolio بنائیں | 5، شرط پر مبنی | اپنا CV رکھیں، /goal کو اختتامی لکیر دیں، اور چلے جائیں۔ یہ PDF پڑھتا، صفحہ بناتا، اپنا کام جانچتا، اور pass ہونے تک دوبارہ کوشش کرتا ہے۔ |
| دروازے کی گھنٹی | 7، event-driven | pull request کھولیں تو کسی کے مانگے بغیر review ایسے computer پر ظاہر ہوتا ہے جو آپ کا نہیں، laptop کھلا ہو یا بند۔ |
مشکل درست ترتیب میں بڑھتی ہے: پہلا پانچ منٹ لیتا اور کچھ نہیں مانگتا؛ دوسرا پوری دوپہر کا حقیقی کام ہے؛ تیسرا آپ کے بغیر چلتا ہے۔ تصور 6، schedules، کا ابھی project نہیں کیونکہ اسے ثابت کرنے میں ایک رات لگتی ہے۔
تینوں agentfactory-labs میں ہیں۔ کم از کم پہلا ضرور کریں۔ جس دھڑکن کو آپ نے fire ہوتے دیکھا ہو، وہ پڑھی ہوئی تین دھڑکنوں سے زیادہ قیمتی ہے۔
کر کے سیکھنا چاہتے ہیں؟ پورا لوپ آغاز سے اختتام تک دیکھنے کے لیے پہلے حصہ 5 پڑھیں، پھر حصوں کی طرف واپس آئیں۔ خیالات واضح ہو جائیں تو مشق کے projects میں خود بنانے کے لیے آٹھ loops ملتے ہیں۔
پہلی بار؟ بنیادی راستہ اختیار کریں: حصے 1 سے 5 ترتیب سے پڑھیں۔ "مزید گہرائی" والے تمام نوٹس چھوڑ دیں۔ وہ درست ہیں، مگر بعد کا کچھ بھی ان پر منحصر نہیں۔ Projects 1 سے 3 کریں، پھر رک جائیں۔ اس راستے میں تقریبا دو گھنٹے، یا خیالات نئے ہوں تو تین گھنٹے لگتے ہیں۔ اس کے بعد آپ محفوظ لوپ بنا اور چلا سکیں گے۔
دوسری بار، جب پہلا لوپ واقعی چل چکا ہو: گہرے نوٹس، پورا حصہ 6، Projects 4 سے 8، اور Routines ضمیمہ اس وقت پڑھیں جب حقیقی cloud routine بنانے کو تیار ہوں۔ دوسری بار پڑھنے کا فائدہ اسی لیے ہے کہ اب سوچنے کے لیے آپ کے پاس چلتا ہوا لوپ موجود ہے۔
اس کورس میں دو پرتیں ساتھ چلتی ہیں، اور وہ مختلف رفتار سے پرانی ہوتی ہیں۔ پہلی یاد رکھیں؛ دوسری ضرورت پر دیکھیں۔
- دیرپا پرت۔ لوپ کی شکل، یعنی دھڑکن، چار کام کرنے والے حصے اور ریڑھ کی ہڈی؛ maker-checker تقسیم؛ اور دو چیزیں جو لوپ آپ کے لیے کبھی نہیں کر سکتا: ارادہ، یعنی اپنی مطلوبہ چیز اتنی صاف بیان کرنا کہ نتیجہ جانچا جا سکے، اور جواب دہی، یعنی جو چیز جاری ہو اس کی ذمہ داری لینا۔ یہی مہارت ہے، اور ہر کمانڈ بدلنے کے بعد بھی درست رہتی ہے۔
- مشینی پرت۔ ہر flag، path، model name اور command۔ یہ ٹولز ہر ہفتے بدلتے ہیں، اور کئی خصوصیات تحقیقاتی آزمائش ہیں۔ ہر کمانڈ کو یاد رکھنے والی حقیقت نہیں بلکہ براہ راست دستاویزات کی طرف اشارہ سمجھیں۔ کورس اور موجودہ docs میں اختلاف ہو تو docs درست ہیں۔
چھ حصوں والی شکل یاد رکھ کر ہر keystroke بھول جائیں تو آپ نے لوپ انجینئرنگ سیکھ لی۔ keystrokes یاد کر کے شکل بھول جائیں تو صرف اس مہینے کی کمانڈز سیکھی ہیں۔
📚 تدریسی معاون
پوری Presentation دیکھیں — لوپ انجینئرنگ: ایک فوری کورس
حصہ 1: تبدیلی
1. prompt سے loop تک
تقریبا دو سال تک، کوڈنگ ایجنٹ سے کام لینے کا طریقہ سادہ تھا۔ ایک اچھا prompt لکھیں۔ اسے کافی context دیں۔ جو واپس آئے اسے پڑھیں۔ اگلی چیز ٹائپ کریں۔ ایجنٹ ایک ٹول تھا، اور آپ اسے ایک وقت میں ایک turn استعمال کرتے تھے۔
ایک لوپ آپ، یعنی operator کی جگہ ایک سسٹم لے آتا ہے۔ سسٹم کام ڈھونڈتا ہے، اسے بانٹتا ہے، جانچتا ہے، لکھ لیتا ہے کہ اس نے کیا کیا، اور فیصلہ کرتا ہے کہ آگے کیا ہے۔ یہ ایجنٹ کو prompt کرتا ہے، تاکہ آپ کو نہ کرنا پڑے۔
تو پھر قدر کہاں جاتی ہے؟ ختم نہیں ہوتی۔ وہ ان دو سروں میں بٹ جاتی ہے جنہیں لوپ خودکار نہیں کر سکتا: ارادہ — یہ ٹھیک ٹھیک بتانا کہ آپ کیا چاہتے ہیں، اتنی وضاحت سے کہ نتیجہ جانچا جا سکے — اور جوابدہی — جو نکلتا ہے اس کے پیچھے کھڑے رہنا۔ لوپ بیچ والے حصے، یعنی قدموں کو خودکار کرتا ہے؛ سرے آپ ہی کے رہتے ہیں۔ آپ کو ارادے اور فیصلے کے لیے ادائیگی ملتی ہے، اس بات کو نظرانداز کرنے کے لیے نہیں کہ کام کیسے بنا۔
فرق "ایک بڑا prompt" نہیں ہے۔ یہ کام کی ایک مختلف ساخت ہے:
| prompt کرنا (جو آپ جانتے ہیں) | لوپ کرنا (جو یہ کورس بڑھاتا ہے) |
|---|---|
| ہر turn آپ شروع کرتے ہیں | ہر turn کوئی schedule یا event شروع کرتا ہے |
| آپ output پڑھتے ہیں اور طے کرتے ہیں آگے کیا ہے | ایک checker output جانچتا ہے؛ لوپ طے کرتا ہے آگے کیا ہے |
| جیسے ہی آپ ٹائپ کرنا چھوڑیں، رک جاتا ہے | آپ کے سونے کے دوران بھی چلتا رہتا ہے |
| ایک کام، ایک سیشن، آپ کی پوری توجہ | کئی چھوٹے runs، زیادہ تر بے توجہ، آپ کی توجہ صرف gate پر |
یہ اختیاری تکنیکی تفصیل ہے؛ پہلی بار پڑھتے ہوئے اسے چھوڑنا محفوظ ہے۔
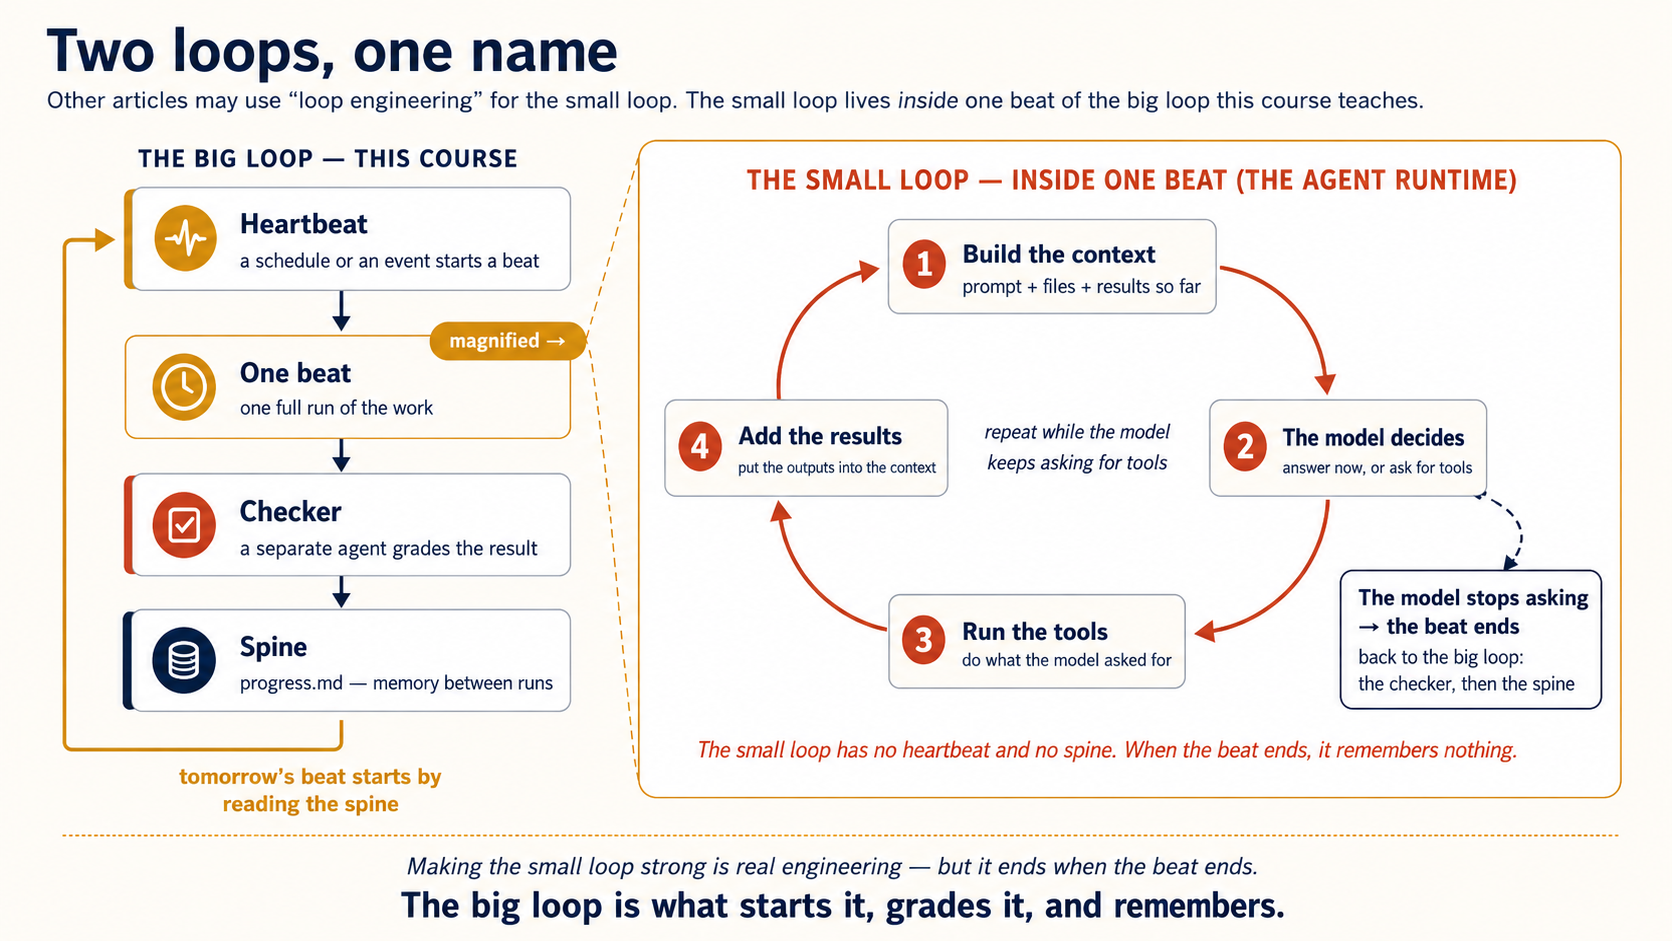
ایک نام کی الجھن پہلے دور کریں۔ «لوپ انجینئرنگ» دو مختلف چیزوں کے لیے استعمال ہوتا ہے۔ یہ کورس بڑا لوپ سکھاتا ہے، مگر آپ یہی الفاظ چھوٹے لوپ کے لیے بھی سنیں گے۔ دونوں درست ہیں، مگر الگ سطحوں پر۔
ایک beat کے اندر چھوٹا loop model runtime چلاتا ہے: context بنائیں، model فیصلہ کرے، tool چلائیں، result context میں واپس ڈالیں، اور model کے رکنے تک دہرائیں۔ یہ agentic coding course کا loop ہے۔ اس کی heartbeat یا spine نہیں اور beat ختم ہونے پر memory ختم۔
while True:
    reply = model(context)
    if not reply.tool_calls:
        break                     # the model decided it is done
    context += run_tools(reply.tool_calls)
break والی سطر کو غور سے دیکھیں۔ یہ اہم ہے۔ چھوٹا لوپ اس وقت رکتا ہے جب ماڈل خود فیصلہ کرے کہ کام مکمل ہے۔ کوئی چیز یہ نہیں جانچتی کہ ماڈل درست ہے یا نہیں۔
یہ مسئلہ ہے، کیونکہ ماڈل اپنا کام خود جانچ رہا ہے۔ عام ناکامی یوں ہوتی ہے: ایجنٹ فائل بدلتا ہے، اعتماد سے "Done! All fixed." لکھتا ہے اور رک جاتا ہے، مگر tests کبھی نہیں چلاتا۔ turn ختم ہو گیا؛ کام نہیں۔
اسی لیے یہ کورس بیرونی روک سکھاتا ہے، جو ماڈل کی اپنی رائے پر منحصر نہیں ہوتی:
- جانچی ہوئی شرط، یعنی حقیقی test سے کام ثابت کرنا
- حد، یعنی کوششوں کی زیادہ سے زیادہ تعداد
- پیش رفت نہ ہونے کی جانچ، یعنی بہتری رک جائے تو رک جانا
- الگ checker، یعنی دوسرا process جو کام کو grade کرے
ان سب کی ایک ہی وجہ ہے۔ چھوٹے لوپ کے پاس اپنی طرف سے صرف ماڈل کی اپنے بارے میں رائے ہوتی ہے۔
اس beat کے گرد بڑا loop یہ کورس بناتا ہے: چھوٹے لوپ کو ایک کام کرنے والا worker سمجھیں، اور بڑے لوپ کو manager۔ manager طے کرتا ہے worker کو کون سا کام ملے، کب شروع ہو، نتیجہ کیسے جانچا جائے، اور کل کے لیے کیا یاد رکھا جائے۔ چھوٹے لوپ کا ایک پورا run بڑے لوپ کا صرف ایک beat ہے۔
ہر layer پچھلی کو لپیٹتی ہے۔ تقریبا ایک سال کے وقفے سے صنعت کی توجہ بھی اسی ترتیب میں ان پر گئی، اسی لیے ہر ایک نے کچھ عرصہ بہت نمایاں جگہ لی۔ چار layers یوں ہیں:
- Prompt engineering: بھیجے گئے الفاظ۔
- Context engineering: ایک turn میں model کو دکھائی دینے والی ہر چیز۔
- Harness engineering: model کے گرد code، tools، permissions، retries اور errors؛ چھوٹا loop یہاں ہے۔
- Loop engineering: یہ کورس؛ پورا system کس کام پر، کب اور کس completion proof تک چلتا ہے۔
اسی لیے prompt اب پہلے سے کم مرکزی ہے۔ وہ بڑے system کا صرف ایک input ہے۔
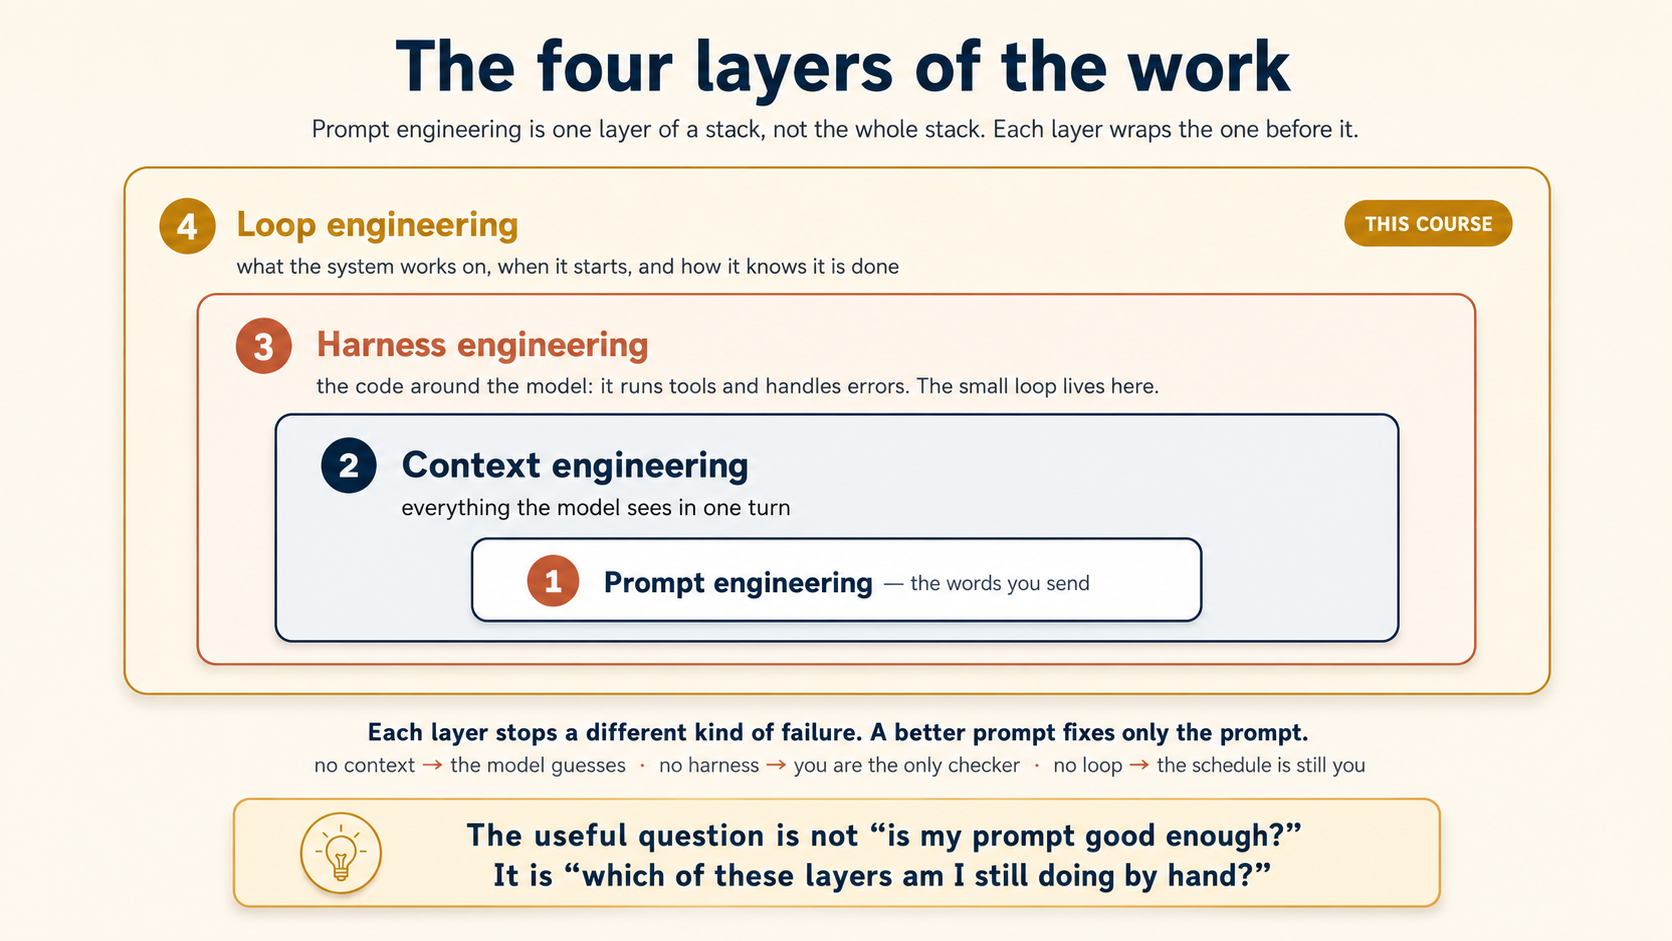
ہر layer الگ failure روکتی ہے۔ strong context weak prompt سنبھال سکتا ہے، مگر کوئی prompt missing context، missing checker یا ایسا schedule نہیں سنبھال سکتا جو اب بھی آپ ہوں۔ خود سے پوچھیں: ان layers میں سے کون سی اب بھی ہاتھ سے چلا رہا ہوں؟
چھوٹے loop کی مضبوط stop conditions، صاف context اور درست tools واقعی engineering ہیں، مگر سب ایک beat کے اندر ختم ہوتا ہے۔ بڑے لوپ کے لیے چھوٹا لوپ جہاں اہم ہوگا، یہ کورس نشان دہی کرے گا: رکنے کی شرطیں تصور 5 میں، اور connector design تصور 10 میں۔
یہ جادو نہیں ہے، اور یہ "لگا کر بھول جاؤ" بھی نہیں ہے۔ خود سے چلنے والا لوپ، خود سے غلطیاں کرنے والا لوپ بھی ہے۔ اس کورس کی ہر چیز اسی لیے موجود ہے تاکہ آپ ایسا لوپ بنا سکیں جس پر آپ واقعی بھروسہ کر کے اسے اپنے بغیر چلا سکیں۔ یہ prompt کرنے سے مشکل تر ہے، آسان نہیں۔ انعام ہے leverage: ایک اچھا لوپ آپ کے لیے یہ کام بار بار کرتا ہے، وہ کام جو ورنہ آپ کو ہر بار ہاتھ سے شروع کرنا پڑتا۔
2. loop کن چیزوں سے بنتا ہے
ایسے لوپ کے، جو واقعی خود سے چلتا ہے، پانچ کام کرنے والے حصے اور ایک محفوظ یادداشت کی تہہ ہوتی ہے۔ یہ کورس اس تہہ کو ریڑھ کی ہڈی کہتا ہے۔ پانچ میں سے چار حصوں سے آپ ایجنٹک کوڈنگ کورس میں مل چکے ہیں۔ یہاں یہ نیا کام سنبھالتے ہیں۔
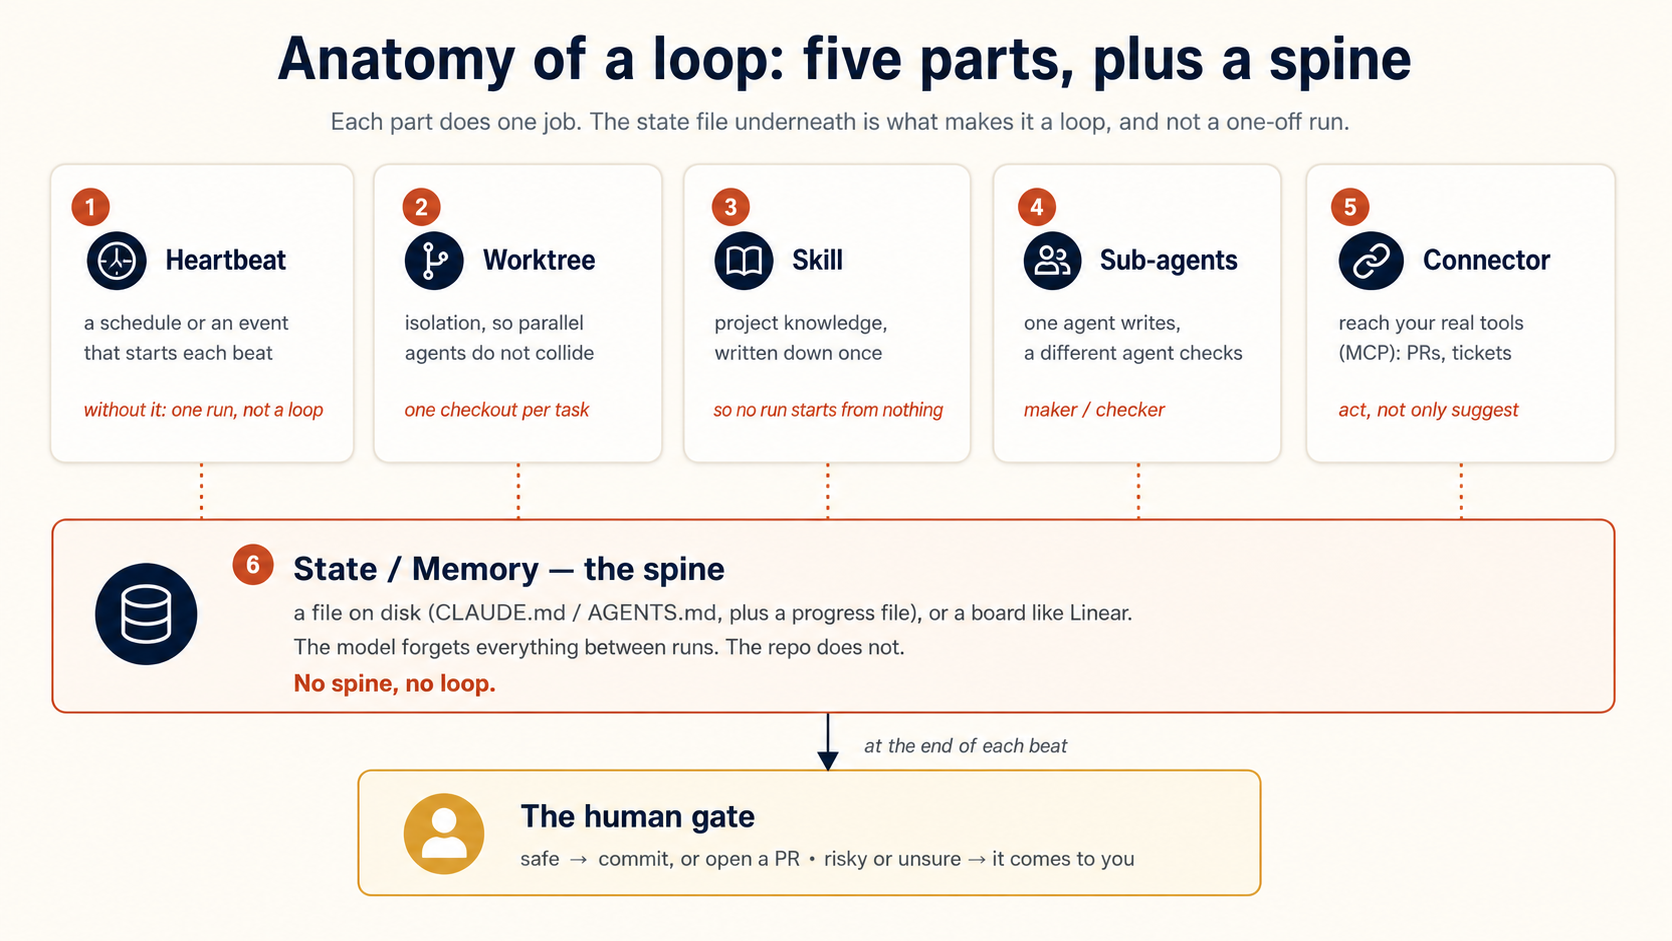
- Heartbeat — ایک schedule (یا event) جو لوپ شروع کرتا ہے۔ اس کے بغیر آپ کے پاس ایک ہی run ہے، لوپ نہیں۔ ایک لفظ ابھی سیکھیں کیونکہ پورا کورس اسے استعمال کرتا ہے: لوپ کے ایک مکمل چلاؤ کو beat کہتے ہیں۔ دھڑکن beats پیدا کرتی ہے؛ نیچے کے تمام حصے ایک beat کے اندر کام کرتے ہیں۔
- Worktree — علیحدگی، تاکہ بیک وقت کام کرتے ہوئے دو ایجنٹس ایک دوسرے کی فائلوں پر نہ لکھیں۔
- Skill — آپ کا پروجیکٹ علم ایک بار لکھا گیا، تاکہ ہر run صفر سے شروع نہ ہو۔
- Sub-agents — maker–checker تقسیم: جو ایجنٹ کوڈ لکھتا ہے وہ اسے جانچنے والا ایجنٹ نہیں ہوتا۔
- Connector (MCP) — تاکہ لوپ آپ کے حقیقی ٹولز میں عمل کر سکے (کوئی PR کھولے، ticket اپڈیٹ کرے)، صرف تجویز نہ کرے۔
اور چھٹا، جسے نوآموز چھوڑ دیتے ہیں:
- State / Memory — ریڑھ کی ہڈی۔ disk پر ایک فائل (یا Linear جیسا board) جو رکھتی ہے کہ کیا ہو چکا اور آگے کیا ہے۔ ماڈل runs کے درمیان سب کچھ بھول جاتا ہے۔ ریڑھ کی ہڈی وہ طریقہ ہے جس سے آج کا run جانتا ہے کہ کل کے run نے کیا کیا۔ کوئی ریڑھ کی ہڈی نہیں، تو کوئی لوپ نہیں — بس وہی پہلا قدم، ہمیشہ کے لیے دہراتا ہوا۔
کورس کا باقی حصہ ہر جز کے لیے ایک section ہے، پھر ایک مکمل مثال جو سب کو جوڑتی ہے۔
نہیں۔ مثالوں میں repos، tests اور PRs ہیں کیونکہ ٹولز وہاں سب سے مضبوط ہیں، مگر لوپ کی شکل کام کی نوعیت سے آزاد ہے۔ کتاب، report، course یا newsletter بھی files کے repo میں رہ سکتے ہیں۔ یہ کتاب خود Markdown files کا repo ہے۔ ہر رات links کی جانچ، style sweep، یا پرانے model names کی نشان دہی، سب اسی باب کے loops ہیں۔
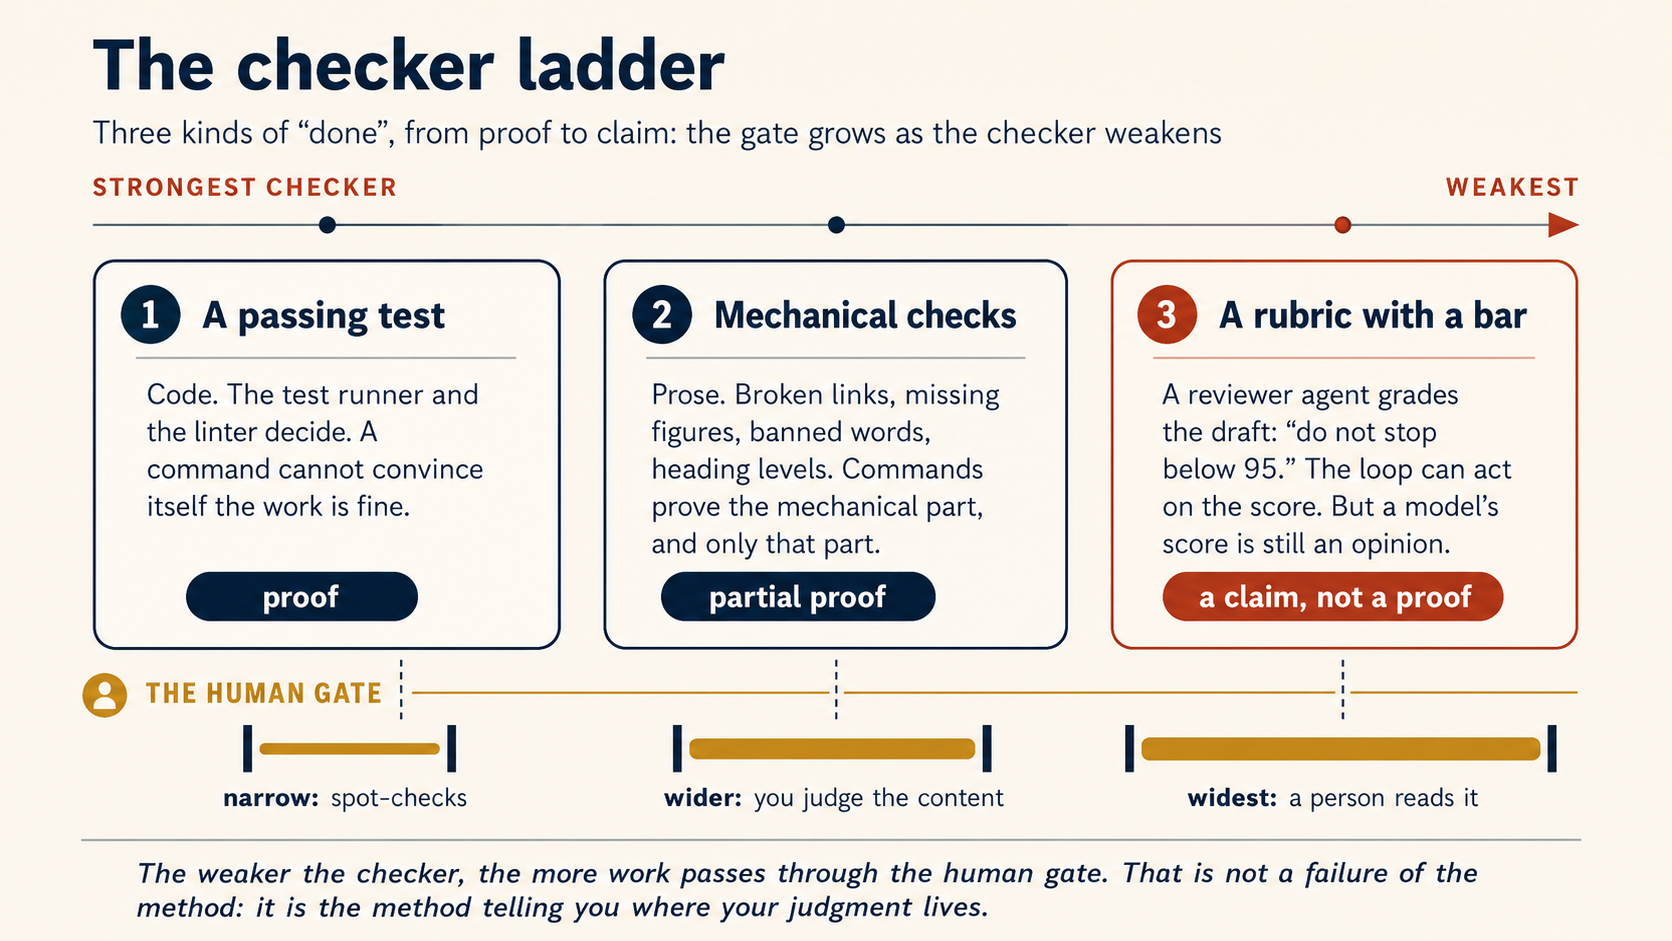
فرق checker میں آتا ہے۔ code کے tests اور linters «done» کا مضبوط ثبوت دیتے ہیں۔ prose میں mechanical checks، جیسے broken links، missing figures، banned words اور heading levels، صرف mechanical حصہ ثابت کرتے ہیں؛ باقی کے لیے written rubric والا reviewer چاہیے۔ project کے اپنے قواعد، مثلا "memory files میں relative dates نہ ہوں" یا "ہر figure کے alt text میں 40 سے زیادہ الفاظ ہوں"، code کی شکل دینے کے بعد commands بن جاتے ہیں۔ تصور 11 کے بعد interlude یہی دکھاتا ہے، اور rubric سے command تک منتقل ہونے والا ہر اصول دعوے کو ثبوت بناتا ہے۔ score اور bar، مثلا "اس draft کو rubric کے مطابق grade کریں؛ 95 سے کم پر نہ رکیں"، نرم فیصلے کو stopping condition بناتے ہیں، مگر model کا score پھر بھی claim ہے، proof نہیں۔ checker جتنا کمزور ہو، human gate اتنا زیادہ کام سنبھالتا ہے۔
ایک اور بات بھی نہیں بدلتی: heartbeat menu۔ domain heartbeat نہیں چنتا، task کی shape چنتی ہے۔ "ابھی کریں، مکمل ہونے تک" conditional loop ہے اور فورا شروع ہوتا ہے۔ "ہر رات کریں" schedule ہے اور مقررہ وقت پر چلتا ہے۔ "کچھ پہنچے تو ردعمل دیں" event ہے۔ repo میں code ہو یا chapters، menu ایک ہی ہے۔ اور جب آپ خود actively لکھ یا code کر رہے ہوں تو عموما لوپ ہوتا ہی نہیں؛ دھڑکن آپ ہوتے ہیں، اور loops آپ کے گرد محدود کام اور maintenance سنبھالتے ہیں۔
اگر آپ کا کام code کے بجائے documents ہے تو یہ کورس اسی طرح پڑھیں، پھر non-coding tools میں انہی loops کے لیے Cowork اور OpenWork فوری کورس دیکھیں۔
3. loop بنانے کے دو راستے: built-in tools یا اپنے connectors
یہ وہ واحد جگہ ہے جہاں دونوں ٹولز واقعی مختلف ہیں، اور یہ ہر آنے والی بات کی شکل طے کرتا ہے۔
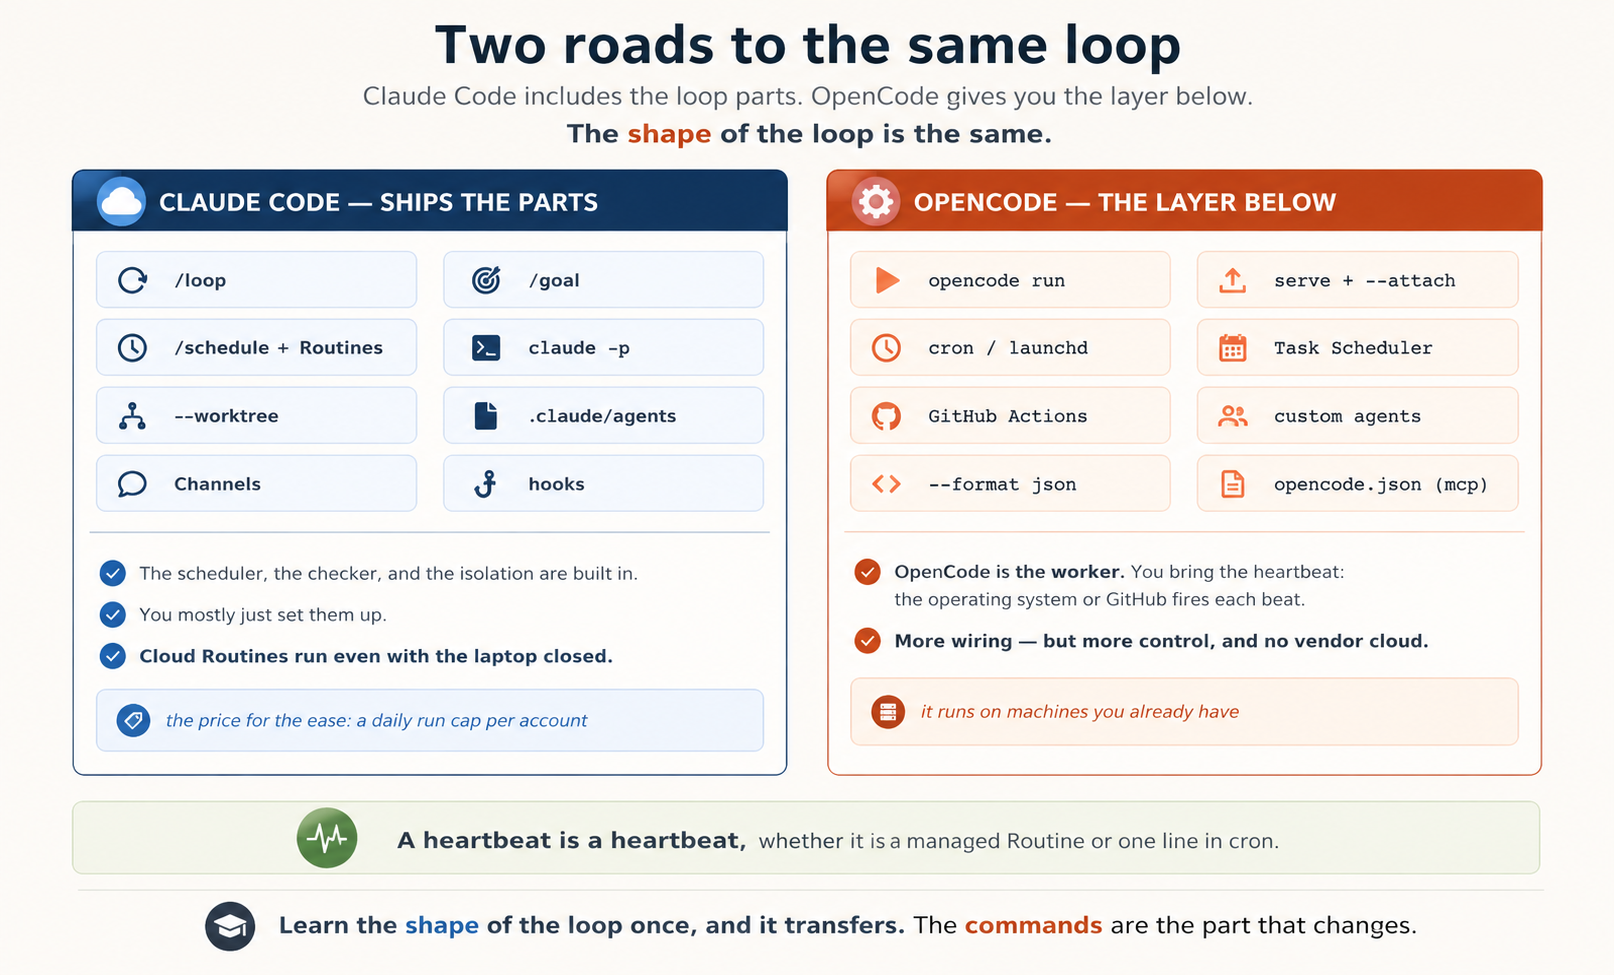
Claude Code لوپ کے حصے پروڈکٹ کے اندر شامل کر کے دیتا ہے۔ دھڑکن (/loop، /schedule، cloud Routines)، built-in checker کے ساتھ run-until-done (/goal)، علیحدگی (--worktree)، event کی آمد (Channels) — یہ سب اب built-in commands ہیں۔ ایک سال پہلے یہ سب حاصل کرنے کے لیے آپ کو shell scripts کا ایک ڈھیر لکھنا اور سنبھالنا پڑتا۔ آج آپ زیادہ تر بس اسے سیٹ کر دیتے ہیں۔
سب سے اہم Routines ہیں: cloud automations جو Anthropic کے servers پر تب بھی چلتی ہیں جب آپ کا laptop بند ہو۔ انہیں schedule، API call یا GitHub event شروع کر سکتا ہے۔ بدلے میں ہر account کی روزانہ run limit ہے۔ launch کے وقت Pro پر 5، Max پر 15، اور Team/Enterprise پر 25 runs روزانہ تھے۔ حد کے بعد اضافی استعمال خریدا جا سکتا ہے، اور one-off scheduled runs شمار نہیں ہوتے۔ مگر docs اب مقررہ اعداد نہیں دکھاتے، اس لیے انہیں launch کی مثال سمجھیں، وعدہ نہیں۔ Routines تحقیقاتی آزمائش ہیں اور limits بدل سکتی ہیں۔ صرف آپ کا usage page (claude.ai/settings/usage) قابل اعتماد عدد ہے۔
OpenCode آپ کو نیچے والی پرت دیتا ہے۔ کوئی built-in cloud scheduler نہیں۔ اس کے بجائے OpenCode وہ worker ہے جسے آپ بلاتے ہیں، اور دھڑکن آپ لاتے ہیں — آپریٹنگ سسٹم سے یا CI سے۔
اہم کمانڈ ہے opencode run "<prompt>"۔ یہ chat screen کے بغیر ایک prompt چلاتی ہے، نتیجہ چھاپتی ہے، اور باہر نکل جاتی ہے۔ وہی ایک کمانڈ لوپ کی ایک دھڑکن ہے۔ آپ اسے لوپ میں اس وقت بدلتے ہیں جب اسے کسی ایسی چیز میں لپیٹتے ہیں جو timer پر فائر ہو: cron یا launchd (macOS اور Linux)، Task Scheduler (Windows)، یا schedule trigger کے ساتھ GitHub Actions۔ یہ زیادہ wiring ہے، مگر آپ کو پورا کنٹرول ملتا ہے، یہ انہی مشینوں پر چلتا ہے جو آپ کے پاس پہلے سے ہیں، اور اسے کسی vendor cloud کی ضرورت نہیں۔
غور کریں کہ دونوں tabs انہی پانچ حصوں کو بیان کرتے ہیں۔ دھڑکن دھڑکن ہی ہے، چاہے وہ کوئی managed Routine ہو یا cron میں ایک لائن۔ maker–checker تقسیم وہی خیال ہے، چاہے /goal اسے grade کرے یا دوسرا opencode run۔ لوپ کی ساخت ایک بار سیکھ لیں، یہ منتقل ہو جاتی ہے۔ اسی لیے ہم دونوں سکھاتے ہیں۔
مکمل loop جو آپ بنائیں گے
حصوں سے پہلے، یہ رہی منزل۔ وہ لوپ جو آپ حصہ 5 میں بنائیں گے، چھ سادہ قدم ہیں:
every weekday at 9am:                 # 1. Heartbeat
  read progress.md                    # 6. Spine (memory)
  find overnight CI failures + issues # what to work on
  for each one:
    draft a fix in its own checkout   # 2. Worktree
    using the project's triage skill  # 3. Skill
    have a separate reviewer grade it # 4. Subagents (maker/checker)
    if PASS: open a PR via GitHub      # 5. Connector (MCP)
    if risky: write it to progress.md and leave it for a human
  update progress.md                  # 6. Spine again
یہ تصویر ذہن میں رکھیں۔ حصہ 2–4 کا ہر تصور اس کی ایک لائن ہے۔
ایک لوپ ہر صبح چلتا ہے، مگر ہر run نئے سرے سے شروع ہوتا ہے اور کبھی یاد نہیں رکھتا کہ کل اس نے کیا کیا۔ چھ حصوں میں سے کون سا غائب ہے — اور یہ لوپ کو کیوں توڑتا ہے؟ ریڑھ کی ہڈی (state / memory)۔ ماڈل runs کے درمیان سب کچھ بھول جاتا ہے، تو disk پر کسی state file کے بغیر لوپ بس اپنا پہلا قدم ہمیشہ دہراتا رہتا ہے، کل کے کام پر تعمیر کرنے کے بجائے۔جواب دکھائیں
حصہ 2: loop کو کیا شروع کرتا ہے (دھڑکن)
دھڑکن وہ ہے جو ایک run کو لوپ بنا دیتی ہے۔ اس کی چار قسمیں ہیں، "اسی سیشن میں رہتی ہے" سے لے کر "آپ کے بالکل بغیر چلتی ہے" تک۔ انہیں ترتیب سے سیکھیں — زیادہ تر حقیقی لوپ آخری دو استعمال کرتے ہیں۔
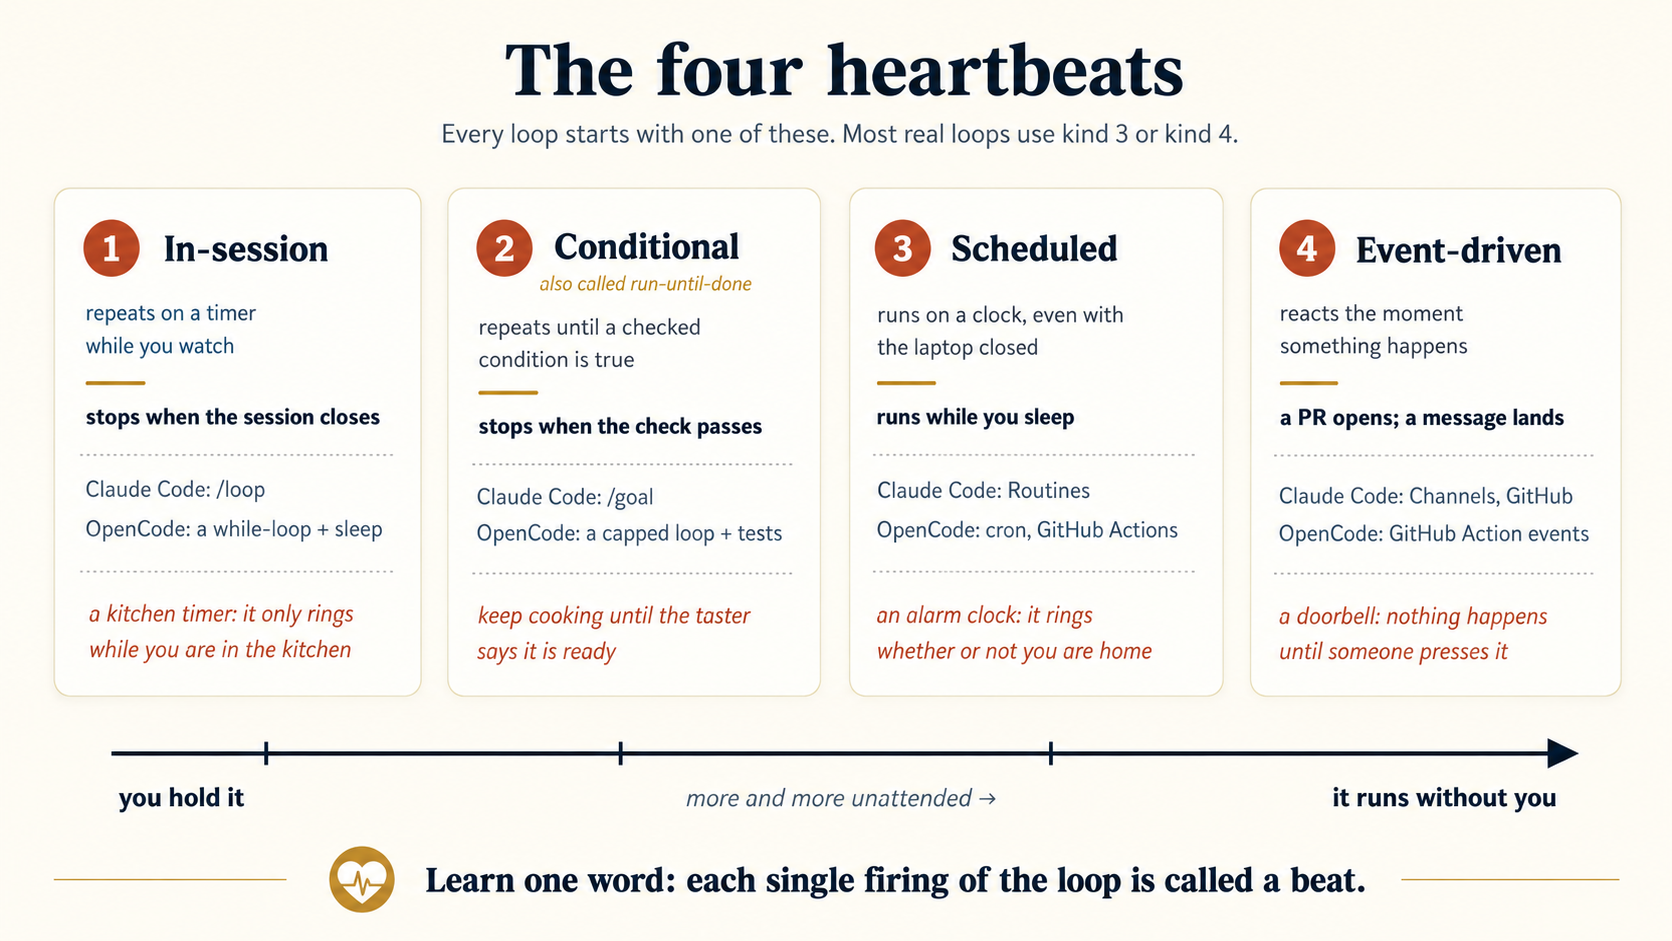
تفصیل سے پہلے چاروں کو سادہ تصویروں میں سمجھیں۔ session کے اندر loop kitchen timer جیسا ہے؛ صرف آپ کے kitchen میں رہنے تک بجتا ہے۔ conditional loop، یعنی run-until-done، کہتا ہے: "کھانا تب تک پکاتے رہو جب تک چکھنے والا تیار نہ کہے۔" schedule alarm clock جیسا ہے؛ آپ گھر ہوں یا نہ ہوں بجتا ہے۔ event doorbell ہے؛ کوئی دبائے تو فورا بجتی ہے، ورنہ خاموش۔ نیچے کی ہر command انہی چار میں سے کسی ایک کا نام ہے۔
چاروں کے نیچے ایک خیال ہے: لوپ ایک action نہیں بلکہ "یہ کریں، انتظار کریں، پھر یہی کریں" ہے۔ beats کے درمیان اگلا beat fire کرنے کے لیے کسی چیز کو جاگتے رہنا پڑتا ہے۔ سوال صرف یہ ہے کہ وہ چیز کہاں رہتی ہے۔
- session کے اندر loop کا timer آپ کے کھلے session میں رہتا ہے۔ session بند کریں تو timer رکھنے والا process ختم، اور لوپ رک جاتا ہے۔
- scheduled task یا Routine، جسے تصور 6 میں بنائیں گے، timer کو session سے باہر ایسے scheduler پر رکھتی ہے جو نہیں سوتا۔ ہر tick پر وہ بالکل نیا مختصر run شروع کرتا، مکمل ہونے دیتا، بند کرتا، اور اگلی بار نیا run چلاتا ہے۔
| دھڑکن | timer کہاں رہتا ہے | beats کے درمیان کیا جاگتا رہتا ہے |
|---|---|---|
session کے اندر /loop | session کے اندر | آپ کا کھلا session، یعنی machine اور terminal |
| Scheduled task / Routine | باہر، scheduler میں | scheduler، جو ہر tick پر تازہ run شروع کرتا ہے |
یہ تصویر آگے کی ہر limit سمجھاتی ہے: session loop session کے ساتھ رک جاتا ہے، اور بند laptop سے بچنے والے loop کو بیرونی scheduler درکار ہے۔
4. session کے اندر loops (نگرانی میں repetition)
سب سے سادہ دھڑکن: ایک prompt کو timer پر دوبارہ چلائیں جب تک سیشن کھلا ہے۔ "اسے ختم ہونے تک دیکھتے رہو" کے لیے اچھا ہے — کوئی deploy، کوئی لمبا test run، کوئی CI job۔
session کھلا رہنے تک یہ ہر interval پر beat fire کرتا ہے اور deploy مکمل ہوتے دیکھ لیتا ہے کیونکہ آپ موجود رہتے ہیں۔ session بند کریں تو نگرانی ختم۔ اسی لیے یہ آپ کے سوتے وقت نہیں چل سکتا۔
bundled /loop skill استعمال کریں۔ اسے ایک interval اور ایک prompt دیں:
/loop 5m check if the deployment finished and tell me what happened
Claude interval کو ایک schedule میں بدلتا ہے، کام کو ایک ID دیتا ہے، اور جب تک سیشن کھلا رہے ہر 5 منٹ بعد prompt چلاتا ہے۔ جب آپ کا کام ہو جائے، اسے cancel کریں اور آگے بڑھیں۔
/loop کو cancel کرنا۔ ہر loop ایک ID والا scheduled task ہے۔ دیکھنے یا cancel کرنے کے لیے سادہ زبان استعمال کریں:
show my running loops
cancel the deploy-check loop
Claude task تلاش کر کے cancel کر دیتا ہے۔ کئی loops ہوں تو پوچھتا ہے کہ کون سا روکنا ہے، یا آپ براہ راست task ID دے سکتے ہیں۔ session بند کرنا بھی plain-session loop روک دیتا ہے، مگر cancel کرنا صاف طریقہ ہے؛ جان بوجھ کر روکا گیا loop session بند ہونے پر منحصر نہیں ہونا چاہیے۔ exact subcommands مشینی پرت ہیں۔ سادہ زبان کام نہ کرے تو براہ راست docs دیکھیں۔
دھڑکن کے بارے میں پڑھنا اور اسے چلتے دیکھنا ایک بات نہیں۔ اس تصور کے لیے ایک چھوٹا منصوبہ صرف ایک کام کرتا ہے: یہ حقیقی International Space Station کو زمین کے گرد اڑتے دیکھتا ہے۔
git clone https://github.com/panaversity/agentfactory-labs.git
cd agentfactory-labs/crash-course/loop-eng/iss-loop
claude
جب یہ پوچھے کہ کیا آپ folder پر بھروسا کرتے ہیں تو yes کہیں۔ اسی سے منصوبے کے ساتھ آنے والی permission آن ہوتی ہے، اس لیے لوپ آپ سے پوچھنے کے لیے نہیں رکتا۔ پھر ایک سادہ جملہ لکھیں:
/loop show me the location of the ISS every minute
یہ آخری چیز ہے جو آپ لکھتے ہیں۔ ہر منٹ نئی جگہ سامنے آتی ہے اور آپ کسی دوسرے کام میں لگے رہتے ہیں۔ دو باتیں غور کے قابل ہیں، کیونکہ دونوں مل کر پورا تصور بناتی ہیں:
/loopنے "every minute" کو heartbeat سمجھا۔ آپ نے schedule، script یا URL نہیں لکھا۔ project folder سب کچھ ساتھ لاتا ہے، اسی لیے پرامپٹ ایک جملہ تھا۔- اب terminal بند کریں۔ نگرانی بھی ختم ہو جاتی ہے۔ یہ bug نہیں؛ session loop کی تعریف ہے، اور اسی لیے تصورات 6 اور 7 موجود ہیں۔
مکمل ہدایات اور دو مشکل prompts project کے README میں ہیں۔
اختیاری: session بند ہونے پر کیا ہوتا ہے؟
ایک حد جاننا ضروری ہے: سادہ-session والا /loop جان بوجھ کر آپ کے session کے اندر چلتا ہے۔ Terminal بند کریں یا laptop کو سونے دیں تو وہ رک جاتا ہے۔ یہ safety feature ہے، bug نہیں۔ عام in-session loop اس session سے زیادہ زندہ رہنے کے لیے نہیں بنا جس نے اسے شروع کیا۔ دو حالیہ تبدیلیاں اس قاعدے کو نرم کرتی ہیں:
--resumeان tasks کو واپس لاتا ہے جو expire نہیں ہوئے؛ recurring task سات دن تک valid رہتا ہے۔- Session کو background میں بھیجنا اس کے
/looptasks بھی ساتھ لے جاتا ہے۔ Terminal بند ہو تب بھی وہ fire ہوتے ہیں، مگر machine سوتے وقت miss ہوئے fires دوبارہ نہیں چلتے۔
جو کام ہر حال میں چلتا رہنا ہو اس کے لیے /loop پر بھروسا نہ کریں۔ Scheduled task یا Routine (تصور 6) استعمال کریں۔ ٹول اب یہ بات بھی آپ کے لیے سنبھالتا ہے۔ Cloud session میں، جو آپ کی machine کے بجائے remote server پر چلتی ہے، حالیہ releases /loop دیتے ہی نہیں، کیونکہ request ختم ہوتے ہی session بند ہو جاتی ہے۔ لوپ کو جاری رکھنے کے لیے کچھ زندہ نہیں رہتا۔
درمیانی راستہ: background sessions۔
Background session، in-session /loop اور Routine کے درمیان والا درجہ ہے۔ Terminal window بند کرنے کے بعد بھی یہ آپ کی اپنی machine پر ایک run زندہ رکھتی ہے۔ اسے claude --bg سے شروع کریں۔
اپنے آپ میں یہ ایک کام کرتی ہے اور رک جاتی ہے۔ اس کی قدر لوپ کو ساتھ لے جانے میں ہے۔ ایک /loop شروع کریں، پھر session کو background میں بھیج دیں؛ window بند ہونے کے بعد بھی لوپ چلتا رہتا ہے۔ (claude agents اسے بعد میں دکھاتا ہے، اور /resume اسے bg نشان کے ساتھ دوبارہ کھولتا ہے۔)
جب terminal بند کرنا ہو مگر deploy یا طویل test کی نگرانی جاری رکھنی ہو تو یہ اختیار چنیں۔ بس "اپنی machine پر زندہ" رہنے کی قیمت یاد رکھیں: computer کو جاگتا رہنا ہوگا۔ جس لمحے کام کو بند laptop سے بھی بچنا ہو، آپ scheduler کے علاقے میں آ گئے؛ درست ٹول Routine (تصور 6) ہے۔
تینوں درجے ایک سوال پر سیدھے ہو جاتے ہیں: کتنا کچھ جاگتا رہنا ضروری ہے؟
| درجہ | Option | Terminal بند ہونے کے بعد fire؟ | Laptop off ہونے پر fire؟ |
|---|---|---|---|
| نیچے | In-session /loop | نہیں | نہیں |
| درمیان | Background session (--bg) کے اندر /loop | ہاں | نہیں |
| اوپر | Scheduled task / Routine | ہاں | ہاں |
ٹول OpenCode میں کوئی /loop command نہیں۔ آپ timer خود shell سے بناتے ہیں۔ چونکہ opencode run ایک prompt کے بعد باہر نکل جاتا ہے، اس لیے ایک while لوپ sleep کے ساتھ وہی کام کرتا ہے:
while true; do
  opencode run "check if the deployment finished; if it did, say DONE"
  sleep 300   # 5 minutes
done
یہ /loop ہی کا خیال ہے، مگر نچلی سطح کے اجزا سے بنا ہے۔ Shell دھڑکن ہے، اور opencode run دھڑکن کی ایک ضرب۔ اس لوپ کو روکنے کے لیے Ctrl-C دبائیں۔ اگر یہ background میں چل رہا ہو تو اس process کو ختم کریں۔ ہر تازہ opencode run کچھ بھی کرنے سے پہلے پورا runtime شروع کرتا ہے: config، model، plugins اور کوئی بھی MCP servers۔ ہر دھڑکن پر آغاز کی یہ لاگت ادا نہ کرنے کے لیے ایک server صرف ایک بار شروع کریں اور اس سے attach ہوں:
opencode serve --port 4096 &
# then, each beat:
opencode run --attach http://localhost:4096 "check the deploy status"
session کے اندر loop اس وقت استعمال کریں جب آپ کام دیکھ رہے ہوں۔ session یا machine رکنے پر یہ رک جاتا ہے۔ کام آپ کے بغیر جاری رہنا ہو تو cloud Routine یا کوئی اور unattended schedule استعمال کریں۔
5. conditional loop، یعنی مکمل ہونے تک چلائیں
Fixed-timer loop (تصور 4) منتخب وقفے پر دہراتا ہے۔ ہر run کام کی جانچ کر سکتا ہے، لیکن نتیجہ timer کو نہیں روکتا۔ لوپ اس وقت تک چلتا رہتا ہے جب تک آپ اسے cancel نہ کریں، session ختم نہ ہو، یا task کی مدت ختم نہ ہو جائے۔
Conditional loop، جسے run-until-done بھی کہتے ہیں، تب رکتا ہے جب کوئی خاص شرط سچ ہو جائے۔ یوں سوچیں: "tests pass ہونے تک چلاؤ،" نہ کہ "میرے دیکھتے ہوئے ہر پانچ منٹ بعد چلاؤ۔"
بنیادی فرق سادہ ہے: fixed-timer loop نہیں جانتا کہ کام کب مکمل ہوا۔ Conditional loop کام مکمل ہونے کی وجہ سے رکتا ہے۔ یہ فیصلہ کسی الگ command یا checker کو کرنا چاہیے۔ کام کرنے والے ایجنٹ کو اپنا نتیجہ خود approve نہیں کرنا چاہیے۔
لوپ کوشش جاری رکھتا ہے اور ایک الگ checker "مکمل" کا فیصلہ کرتا ہے۔ مقصد ثابت ہوتے ہی یہ رک جاتا ہے؛ نہ timer، نہ آپ۔
/goal استعمال کریں۔ اسے رکنے کی ایسی شرط دیں جسے Claude اپنے output میں ثابت کر سکے، مثلا "test/auth کے سارے tests pass ہوں۔" Claude شرط پوری ہونے تک کام جاری رکھتا ہے۔
ہر turn کے بعد ایک الگ چھوٹا ماڈل، default طور پر Haiku، transcript پڑھ کر پوچھتا ہے: "کیا کام مکمل ہوا؟" یوں code لکھنے والا ایجنٹ اپنا کام خود grade نہیں کرتا۔
checker commands نہیں چلا سکتا؛ صرف گفتگو پڑھ سکتا ہے۔ اس لیے worker کو tests چلا کر نتائج output میں دکھانے پڑتے ہیں۔ نظر آنے والے ثبوت کے بغیر checker مقصد پورا ہونے کی تصدیق نہیں کر سکتا۔
/goal All tests in test/auth pass and `npm run lint` is clean.
یہ edit کرے گا، tests چلائے گا، ناکامیاں پڑھے گا، دوبارہ کوشش کرے گا، اور صرف اسی وقت رکے گا جب checker تصدیق کر دے کہ شرط واقعی پوری ہو گئی — یا جب آپ خود اسے Unattended run میں لوپ اس وقت کام کر رہا ہوتا ہے جب کوئی اسے نہیں دیکھ رہا، مثلا رات بھر یا جب آپ keyboard سے دور ہوں۔ اگر وہ پھنس جائے تو اسے روکنے والا کوئی شخص موجود نہیں ہوتا۔ اسی لیے یہاں retries کی حد ضروری ہے۔ Retry کا مطلب کسی ناکام step کو دوبارہ آزمانا ہے، مثلا timeout ہونے والی API call۔ حد نہ ہو تو پھنسا ہوا لوپ آپ کے سوتے وقت ہمیشہ retry کر کے وقت اور tokens خرچ کر سکتا ہے۔ Claude Code اب یہ cap یوں دیتا ہے: نام اور numbers mechanical layer ہیں، اس لیے live docs دیکھیں۔ مستقل اصول یہ ہے کہ unattended run کی limit جان بوجھ کر چنی جائے۔/goal clear سے روک دیں۔ کوئی built-in "N کوششوں کے بعد ہار مان لو" نہیں ہے: اگر آپ کو حد چاہیے، تو اسے شرط میں لکھ دیں (…or stop after 20 turns)۔ ایسی شرطیں لکھیں جنہیں کوئی کمانڈ ثابت کر سکے — "tests pass ہوں اور lint clean ہو،" نہ کہ "auth کوڈ اچھا ہے۔" یہیں Spec-Driven Development والا spec کام آتا ہے: اس کے acceptance criteria پہلے ہی ایسی شرطیں ہیں جنہیں کوئی کمانڈ ثابت کر سکتا ہے، تو ایک اچھا spec آپ کو رکنے کی شرط مفت میں دے دیتا ہے۔اختیاری: Claude Code کی موجودہ retry settings
CLAUDE_CODE_MAX_RETRIES)، اور cap پندرہ تک بڑھ سکتی ہے۔CLAUDE_CODE_RETRY_WATCHDOG=1 set کریں۔ یہ temporary errors کو زیادہ دیر retry کرتا اور اپنا MAX_RETRIES set کرنے پر پندرہ والی حد اٹھاتا ہے۔
npm test صاف رکنے کی شرط ہے کیونکہ tests پہلے سے لکھے ہوتے ہیں۔ زیادہ تر کام ایسا نہیں۔ Portfolio project مشکل سوال پوچھتا ہے: انسان کے دیکھنے والے صفحے کے لیے "مکمل" کا مطلب کیا ہے، اور کیا آپ اسے اتنی درستی سے لکھ سکتے ہیں کہ لوپ وہاں پہنچ سکے؟
اپنا CV یا LinkedIn PDF فولڈر میں رکھیں، پھر /goal کو اختتامی لکیر دیں:
/goal Build my portfolio in site/ from my-cv.pdf, following spec.md. Done when `python3 check.py site` prints 20/20 and the reviewer agent replies PASS on all six judgment promises — show me both. Stop after 15 check attempts or 3 review rounds and write what is still failing to progress.md.
پھر چلے جائیں۔ یہ PDF پڑھتا، design چنتا، الفاظ لکھتا، صفحہ بناتا، checker چلاتا، ناکامیاں پڑھتا اور دوبارہ کوشش کرتا ہے، یہاں تک کہ وہ جملہ سچ ہو جائے۔
ہر clause اسی تصور کا کوئی خیال عملی بناتا ہے۔ کمانڈ سے ثابت ہونے والی شرط: check.py وہ 20 checks چلاتا ہے جن کا فیصلہ machine کر سکتی ہے، مثلا پانچ sections موجود ہوں، contrast درست ہو، اور phone سے کچھ باہر نہ نکلے۔ نظر آنے والا ثبوت: show me both اس لیے ہے کہ /goal کا checker صرف transcript پڑھتا ہے؛ نہ دکھایا ہوا نتیجہ confirm نہیں ہو سکتا۔ حد: 15 attempts، کیونکہ /goal خود give-up نہیں کرتا، اور ناممکن condition کا پیچھا پوری رات چل سکتا ہے۔ maker سے الگ checker: spec الگ reviewer agent کو لازمی قرار دیتا ہے۔
یہ آخری بات project کو tutorial سے حقیقی کام بناتی ہے۔ 20/20 مکمل نہیں۔ reviewer کو چھ ایسی باتیں بھی pass کرنی ہیں جنہیں command نہیں ناپ سکتی: کیا تحریر CV کے مطابق سچی ہے، کیا واقعی design ہے یا صرف formatting، کیا یہ محض PDF ہو سکتا تھا؟ spec صاف کہتا ہے: "Part A ایک صبح کا کام ہے۔ Part B اصل کام ہے۔" تصور 2 کی checker ladder میں یہی خیال دیکھا تھا؛ یہاں اسے محسوس کریں گے۔
project ایک سخت اصول پر سمجھوتا نہیں کرتا: pass کرانے کے لیے check.py کبھی edit نہ کریں۔ سبز نتیجے کو optimize کرنے والا لوپ اسی طرف جائے گا، اور اس خواہش کو پہچاننا ہی سبق ہے۔
OpenCode میں کوئی /goal نہیں، تو آپ وہی maker–checker stop خود shell اور exit codes سے بناتے ہیں۔ pattern یہ ہے: ایجنٹ کام کرتا ہے، پھر ایک حقیقی کمانڈ (ایجنٹ نہیں) فیصلہ کرتی ہے کہ رکنا ہے یا نہیں۔
for i in $(seq 1 8); do          # cap the tries — never loop forever
  opencode run "Make the tests in test/auth pass and fix any lint errors."
  if npm test -- test/auth && npm run lint; then
    echo "Condition met on try $i"; break
  fi
done
یہاں test runner اور linter ہی checker ہیں — سب سے ایماندار checker جو موجود ہے، کیونکہ کوئی کمانڈ خود کو یہ یقین نہیں دلا سکتی کہ کام ٹھیک ہے۔ زیادہ ذہین جانچ کے لیے، ایک وقف review agent کے ساتھ دوسرا opencode run چلائیں (تصور 11) اور اس سے PASS یا FAIL چھپوائیں۔ کوششیں ہمیشہ محدود رکھیں؛ بغیر حد کے دوبارہ کوشش کرنے والا لوپ ہی وہ طریقہ ہے جس سے token bills قابو سے باہر بڑھتے ہیں۔
OpenCode agent config میں steps limit بھی لیتا ہے؛ پرانا maxSteps نام deprecated ہے۔ Shell cap beats کی تعداد محدود کرتا ہے اور steps ایک beat کے اندر agent کے turns۔ دونوں set کریں۔
ہر لوپ کو تین stops درکار ہیں۔ ہر ایک ناکامی کے الگ طریقے کو روکتا ہے:
| Stop | کیا ہے | چھوڑ دیں تو کیا ہوگا |
|---|---|---|
| کامیابی کی شرط | لوپ کیسے جانتا ہے کہ کام مکمل ہوا | "مکمل" کی تعریف نہیں، اس لیے لوپ ارادے سے رک یا grade نہیں ہو سکتا |
| حد | زیادہ سے زیادہ کوششیں، منٹ یا خرچ | ناقابل حصول مقصد پورا token budget کھا جاتا ہے |
| پیش رفت نہ ہونے کی جانچ | ایک ہی arguments کے ساتھ وہی action دہرانے پر رکنا | پورا limit ایک ہی غلطی دہرانے میں خرچ ہو جاتا ہے |
ایک نام جو online ملے گا: Ralph loop۔ یہ سب سے سادہ مشہور run-until-done loop ہے۔ وہی پرامپٹ بار بار چلاتا ہے؛ ہر run ایک state file پڑھتا اور بدلتا ہے۔ تین میں سے صرف دو stops رکھتا ہے، یعنی کامیابی کی شرط اور وقت کی حد؛ stuck-check، skill یا الگ checker نہیں۔ یہی سادگی سبق نمایاں کرتی ہے۔ مبہم شرط والا Ralph loop وقت ختم ہونے تک بھٹکتا رہتا ہے؛ command سے ثابت ہونے والی شرط کے ساتھ اچھا چلتا ہے۔
لوپ اپنی رکنے کی شرط جتنا ہی اچھا ہے۔
بہت turns چلنے والا run-until-done loop اپنا سیاق پرانے tool output، بند راستوں اور stale reasoning سے بھر لیتا ہے۔ ڈھیر بڑھنے کے ساتھ فیصلے خراب ہوتے ہیں۔ کمیونٹی اسے doom loop کہتی ہے: گندا سیاق خراب فیصلہ پیدا کرتا ہے، وہ مزید گندگی بڑھاتا ہے، اور اگلا فیصلہ مزید خراب ہوتا ہے۔ دفاع وہی سیاقی عادتیں ہیں جو ایجنٹک کوڈنگ کورس نے سکھائیں:
- لمبے runs compact کریں: وقفے وقفے سے خام گفتگو کو مختصر خلاصے میں بدلیں تاکہ سیاق چھوٹا رہے۔
- بڑے outputs files میں رکھیں: logs، data یا generated text فائل میں لکھیں اور سیاق میں صرف pointer رکھیں۔
- گندے subtasks subagent کو دیں: مددگار الگ سیاق میں exploration کرے اور صرف صاف جواب واپس دے۔
تینوں کے پیچھے ایک خیال ہے: سیاق کو جان بوجھ کر خرچ ہونے والا بجٹ سمجھیں، مسلسل بھرنے والی بالٹی نہیں۔ چھوٹا، صاف سیاق ہی لمبے run کے فیصلے تیز رکھتا ہے۔
6. unattended schedules (آپ کے سوتے وقت بھی)
یہ وہ دھڑکن ہے جو لوپ انجینئرنگ کو اہم بناتی ہے: ایک کام جو چاہے آپ کمپیوٹر پر ہوں یا نہ ہوں چلتا ہے۔ "ہر working day صبح 9 بجے، رات بھر کی CI failures چھانٹو۔" "ہر پیر، dependencies جانچو اور محفوظ fixes کے ساتھ ایک PR کھولو۔"
claude.ai پر Routine مقرر کریں، laptop بند کریں، اور دیکھیں کہ Anthropic کے servers اسے آپ کا laptop بند ہونے کے باوجود schedule پر چلاتے رہتے ہیں۔
پہلے نام واضح کریں۔ scheduler ہر ایسی ہمیشہ چلتی گھڑی ہے جو وقت پر تازہ run شروع کرے، مثلا cron، GitHub Actions یا cloud service۔ Routine Claude Code کا اپنا cloud-hosted scheduler ہے، جہاں گھڑی اور machine دونوں Anthropic دیتا ہے، اس لیے آپ کا کوئی device آن ہونا ضروری نہیں۔ ہر Routine scheduler ہے؛ ہر scheduler Routine نہیں۔
دو قسمیں ہیں، اس بنیاد پر کہ laptop آن چاہیے یا نہیں۔
Cloud Routines، جن کے لیے laptop آن ہونا ضروری نہیں۔ یہ جدید default ہے، اس لیے اسے آہستہ سمجھیں۔ Cloud Routine ایک مستقل ہدایت ہے جو آپ کے computer پر نہیں بلکہ Anthropic کے servers پر رہتی ہے۔ آپ ہدایت ایک بار لکھتے ہیں۔ پھر وہ آپ کے مقرر کردہ وقت پر خود چلتی ہے، چاہے laptop کھلا ہو، سو رہا ہو، یا bag میں رکھا ہو۔ اسے یوں سمجھیں جیسے worker آپ کے نہیں بلکہ Anthropic کے office میں بیٹھا ہو: آپ تحریری job description دیتے ہیں، اور hosting آپ کو نہیں کرنی پڑتی۔
اس پورے section میں ایک مثال ذہن میں رکھیں۔ ہر صبح آپ وہی triage کرتے ہوئے 30 منٹ خرچ کرتے ہیں: رات میں آنے والے issues پڑھنا، انہیں label کرنا، crash جیسی چیز flag کرنا، اور team کے Slack پر خلاصہ post کرنا۔ یہ آدھا گھنٹہ Routine کے لیے بہترین ہے۔ کام دہراتا ہے، ایسے rules مانتا ہے جنہیں لکھا جا سکتا ہے، اور اسے آپ کی موجودگی نہیں بلکہ آپ کی ہدایات درکار ہیں۔
ہر Routine کے چار حصے۔ Routine بناتے وقت آپ چار خانے پر کرتے ہیں۔ ہر خانہ ایک سوال کا جواب دیتا ہے۔
- Prompt: اسے کیا کرنا چاہیے؟ یہ مستقل ہدایت ہے، جسے آپ اسی spec کی طرح لکھتے ہیں جس کی مشق پہلے کی: مقصد، rules، اور "مکمل" ہونے کی واضح شکل۔ ہر run میں یہی prompt ملتا ہے اور وضاحت مانگنے کے لیے کوئی انسان موجود نہیں ہوتا، اس لیے اسے آپ کی غیر موجودگی میں بھی قابل عمل ہونا چاہیے۔ triage کی مثال کے لیے:
Review all issues opened in the last 24 hours. Label each as bug,
feature-request, or question. If any issue describes a crash or data
loss, add the "urgent" label. Then post a summary to the #triage Slack
channel: total new issues, how many urgent, and one line per urgent
issue. If there are no new issues, post "No new issues overnight."
Do not close or comment on any issue.
Prompt کی anatomy دیکھیں: ایک مقصد، یعنی triage اور خلاصہ؛ rules، یعنی labels اور urgent کی تعریف؛ boundary، یعنی کسی issue کو close یا comment نہ کرنا؛ اور empty case کے لیے بھی "مکمل" کی واضح تعریف۔
-
Repos: یہ کن چیزوں کو چھو سکتا ہے؟ آپ ان repositories کے نام دیتے ہیں جہاں Routine کام کر سکتی ہے۔ جو چیز list میں نہ ہو وہ اس کی پہنچ سے باہر ہے۔ صرف
yourteam/product-appدیں۔ آپ کے دوسرے repos، billing code والے repo سمیت، اس Routine کے لیے موجود ہی نہیں ہیں۔ -
Connectors: یہ کہاں تک پہنچ سکتا ہے؟ Slack، email اور calendars۔ یہ repo سے باہر Routine کے ہاتھ ہیں، یعنی باہر کی دنیا پڑھنے اور آپ کو نتیجہ دینے کا طریقہ۔ صرف Slack connector لگائیں تاکہ وہ #triage پر post کر سکے۔ Connectors permissions ہیں، suggestions نہیں: email connector کے بغیر prompt کہے تب بھی وہ email نہیں بھیج سکتی۔
-
Trigger: یہ کب شروع ہوتا ہے؟ یہی heartbeat ہے۔ کام کی تین شکلوں کے لیے تین قسمیں ہیں۔ Schedule: ہر working day صبح 8:30 پر clock اسے شروع کرتی ہے، تاکہ team کے بیٹھنے سے پہلے summary تیار ہو۔ API call: کوئی دوسرا program اسے شروع کرتا ہے، مثلا deploy script release کے بعد smoke-check چلاتا ہے؛ کام fixed clock کے بجائے ضرورت کے وقت شروع ہوتا ہے۔ GitHub event: repository event اسے شروع کرتا ہے، اس لیے "pull request opened" trigger پرسکون دن میں صفر بار اور مصروف دن میں نو بار چل سکتا ہے۔ تصور 7 میں اسے تفصیل سے دیکھیں گے۔
کیا کرنا ہے، کہاں کام کرنا ہے، کہاں تک پہنچنا ہے، اور کب شروع ہونا ہے۔ ہر Routine یہی چار جواب ہے۔ اب issue-triage worker پوری طرح متعین ہے: اوپر والا prompt، ایک repo، ایک Slack connector، اور working days میں صبح 8:30 کا وقت۔
ایک feature، تین دروازے۔ Routine کو claude.ai/code/routines پر، Desktop app میں، یا CLI کے /schedule سے بنایا جا سکتا ہے۔ یہ الگ features نہیں ہیں۔ تینوں ایک ہی cloud feature کو manage کرتے ہیں: کسی بھی دروازے سے بنی Routine اسی cloud account میں save ہوتی اور تینوں جگہ دکھائی دیتی ہے۔ مثلا terminal میں /schedule سے بنا کر بعد میں browser میں edit کر سکتے ہیں۔
Run کے وقت کیا ہوتا ہے۔ پیر صبح 8:30 پر Anthropic کے servers تازہ Claude session شروع کرتے، اسے prompt دیتے، اور صرف درج کیا ہوا repo اور connectors فراہم کرتے ہیں۔ وہ weekend کے issues پڑھتا، labels لگاتا، #triage پر summary post کرتا، اور بند ہو جاتا ہے۔ منگل کا run بالکل تازہ شروع ہوتا ہے؛ پیر کا session ختم ہو چکا ہوتا ہے۔ کسی چیز کا انحصار آپ کی machine پر نہیں، اسی لیے یہ ایسا حقیقی loop ہے جسے دیکھتے رہنا نہیں پڑتا۔ یہی وجہ ہے کہ spine، یعنی تصور 12، repo میں ہونی چاہیے۔ اس پر انحصار کرنے سے پہلے موجودہ product کے دو rules جانچیں۔ Rule one: روزانہ cap ہے۔ ہر account کو روزانہ Routine runs کی مقررہ تعداد ملتی ہے: launch کے وقت Pro پر 5، Max پر 15، اور Team یا Enterprise پر 25۔ کسی دوسرے کے servers پر چلنے والے unattended system کا budget ہونا چاہیے۔ Pro plan پر فوری حساب کریں: issue triage کا 1 run، شام کی commit summary کا 1 run، اور چار pull requests والے دن PR-review Routine کے 4 runs، یعنی کل 6۔ یہ cap سے ایک زیادہ ہے۔ ترجیح کے مطابق دو daily reports کو ایک Routine میں ملائیں، مصروف دن PR reviewer کے لیے extra usage خریدیں، یا plan upgrade کریں۔ یہ حساب اس سے پہلے کریں کہ loop خاموشی سے پانچویں run پر رک جائے۔ تین باتیں cap کو نرم کرتی ہیں: یہ launch-time numbers ہیں، اس لیے Rule two: default طور پر یہ صرف یہ رکاوٹ نہیں بلکہ حفاظت ہے۔ Routine جتنا چاہے کام کر سکتی ہے، مگر merge ہونے کا فیصلہ آپ کے پاس رہتا ہے۔ مثلا flaky tests درست کرنے والی Routine رات 3 بجے fix کسی بعد میں، جب repo کئی صاف runs کے بعد اعتماد کما لے، تو صرف اسی repo کے لیے Allow unrestricted branch pushes setting بند کی جا سکتی ہے۔ یہ کام جان بوجھ کر، ایک وقت میں ایک repo کے لیے کریں، جیسے کسی کو چابی دینا۔اختیاری: Routine کی موجودہ limits اور branch rules
claude.ai/settings/usage دیکھیں؛ one-off scheduled runs شمار نہیں ہوتے؛ اور cap کے بعد extra usage خریدا جا سکتا ہے۔claude/ branches پر push کر سکتی ہے۔ تازہ Routine main پر نہیں لکھ سکتی۔ اس کی ہر pushed branch کا نام claude/ سے شروع ہونا چاہیے۔claude/ branch پر push کرتی ہے۔ صبح آپ change پڑھتے، درست ہونے کی تصدیق کرتے، اور خود merge کرتے ہیں۔ Routine نے آپ کے سوتے وقت کام کیا؛ آپ نے جاگ کر جانچ کی۔ یہی فاصلہ اصل مقصد ہے۔
Routine کب درست tool ہے: جب کام کو آپ کی machine کی ضرورت نہ ہو۔ Issue triage، stakeholders کے لیے Friday کا "اس ہفتے کیا بدلا" digest، competitor کے changelog کی نگرانی، یا معمول کے support issues کے جواب draft کرنا۔ اگر خیال آئے کہ "یہ میرے بغیر ہر روز خود ہونا چاہیے،" تو یہی tool ہے۔ ہر form field، environment اور secrets Routines appendix میں ہیں۔ Cloud اور cron کے درمیان تیسرا native option Desktop scheduled tasks ہے، جو Desktop app میں بنتا ہے۔ یہ آپ کی اصل local files، unsaved changes سمیت، بغیر open session کے استعمال کرتا ہے، مگر machine آن ہونی چاہیے۔ Routine کو سادہ زبان میں create، list، فورا run، یا update کیا جا سکتا ہے: تین فوری باتیں: اگر CLI میں اختیاری: terminal سے Routine manage کریں
/schedule every weekday at 9am, run the daily-triage skill   # create it
/schedule list                                               # see what you have
/schedule run the triage routine now                         # fire one run, to test it
/schedule update the triage routine to every two hours       # change the timing
update ایک cron expression بھی لیتا ہے، یعنی exact وقت بتانے والا مختصر code۔ مثلا 0 9 * * 1-5 کا مطلب Monday سے Friday صبح 9 بجے ہے۔/schedule tomorrow at 9am, …۔ One-offs روزانہ run limit میں شمار نہیں ہوتیں، اس لیے روزانہ چلانے کا وعدہ کرنے سے پہلے prompt ایک بار آزمانے کا مفت طریقہ ہیں۔/schedule غائب لگے تو Routines appendix میں دیکھیں کہ کیا check کرنا ہے۔
اپنی machine، cron کے ساتھ۔ claude -p ایک prompt چلا کر نکل جاتا ہے، اس لیے اسے اپنے crontab میں رکھا جا سکتا ہے:
# every weekday at 9am: sort through CI and summarize failures
0 9 * * 1-5 cd /path/to/repo && claude -p "check the CI dashboard and summarize any failures" >> ~/claude-cron.log 2>&1
پہلی حقیقی Routine بنانے کے لیے، جس میں ہر field، تینوں triggers، secrets اور عام مسائل شامل ہیں، آخر میں Routines appendix قدم بہ قدم رہنمائی دیتا ہے۔
Schedule وہ heartbeat ہے جسے fire ہوتے آپ نہیں دیکھ سکتے، کیونکہ midnight اس وقت آتا ہے جب آپ دیکھ نہیں رہے ہوتے۔ اسی لیے ایک project کو رات بھر اکیلا چھوڑنے کے لیے بنایا گیا ہے: Sky Watch۔ ہر صبح یہ NASA کی asteroid feed دیکھ کر note چھوڑتا ہے: آج زمین کے قریب کیا گزر رہا ہے، اور کیا کوئی چیز خطرناک ہے۔
اسے clone کریں اور پہلے ہاتھ سے ثابت کریں کہ یہ کام کرتا ہے:
what asteroids are coming this week?
نتیجے میں سادہ زبان کا watch ملتا ہے: "فکر کی کوئی بات نہیں، سب سے قریب چیز Moon سے 23 گنا فاصلے پر گزرے گی، سب clear ہے۔" پھر ایک line سے اسے loop بنائیں:
/schedule every day at midnight, run the sky-watch skill for today and write me the forecast
Laptop بند کر دیں۔ صبح watch تیار ہوگی، ایسی machine نے لکھی ہوگی جو کبھی آپ کی نہیں تھی، اس وقت جب آپ سو رہے تھے۔ Email connector لگائیں تو یہ inbox میں visual card کی شکل میں آ سکتی ہے، جہاں ہر pass proximity bar کے طور پر دکھایا جائے۔ Prompt میں for today لکھا ہے، "اگلا ہفتہ" نہیں: daily run کو اسی دن کی report دینی چاہیے جس دن وہ چلے، ورنہ وہ ہر صبح کل کی forecast دوبارہ بھیج دے گا۔ Window کو cadence کے مطابق رکھیں۔
دو باتیں اسے schedule بناتی ہیں، doorbell نہیں، جسے تصور 7 میں دیکھیں گے۔ یہ پیچھے کے بجائے آگے دیکھتا ہے: کل کے pass کی warning، نہ کہ کل گزرے واقعے کی report۔ اور یہ کچھ نہ ہونے پر بھی بولتا ہے۔ زیادہ تر صبح صرف "سب clear" کہتا ہے، اور یہی خاموش report watch کا مقصد ہے۔ Event-driven loop پرسکون دن خاموش رہتا ہے؛ schedule بہرحال report کرتا ہے۔ Midnight کا انتظار کیے بغیر rehearsal کے لیے پہلے one-off چلائیں: /schedule in 2 minutes, run the sky-watch skill، کیونکہ one-offs daily cap میں شمار نہیں ہوتے۔ یہ حصہ 6 کا rule عملی بناتا ہے: کسی چیز کو slow اور unattended بھروسہ دینے سے پہلے fast اور watched ثابت کریں۔
OpenCode کی بے توجہ دھڑکن ہمیشہ OS یا CI ہوتی ہے — یہی OpenCode کا راستہ ہے۔ opencode run کو chat screen کے بغیر استعمال کریں، اور scheduler کو اسے فائر کرنے دیں۔اختیاری: community scheduling plugins
opencode-scheduler جیسے community plugins سادہ زبان کی request کو operating-system schedule میں بدل سکتے ہیں، overlapping runs روک سکتے ہیں، اور انسانی جواب کا انتظار کرنے والے prompts reject کر سکتے ہیں۔ یہ third-party software ہے، اس لیے بھروسہ کرنے سے پہلے دیکھیں کہ plugin فعال طور پر maintained ہے۔
OpenCode کی اپنی machine والی cron شکل:
# every weekday at 9am: sort through CI and summarize failures
0 9 * * 1-5 cd /path/to/repo && opencode run "check the CI dashboard and summarize any failures" >> ~/opencode-cron.log 2>&1
cloud، GitHub Actions کے ساتھ (آپ کی کوئی مشین آن ہونے کی ضرورت نہیں)۔ نیچے دی گئی model string صرف مثال کے طور پر ہے — اپنے install کو معلوم درست IDs کے لیے opencode models چلائیں:
name: Scheduled OpenCode Task
on:
  schedule:
    - cron: "0 9 * * 1-5"   # weekdays at 9am UTC
jobs:
  opencode:
    runs-on: ubuntu-latest
    permissions: { contents: write, pull-requests: write, issues: write }
    steps:
      - uses: actions/checkout@v6
        with: { persist-credentials: false }
      - uses: anomalyco/opencode/github@latest
        env: { ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }} }
        with:
          model: anthropic/claude-sonnet-5   # confirm with `opencode models`
          prompt: |
            Review the codebase for TODO comments and summarize them.
            If any are worth acting on, open an issue to track them.
scheduled events کے لیے prompt لازمی ہے (پڑھنے کے لیے کوئی comment نہیں ہوتا)، اور اگر لوپ کو branches یا PRs کھولنے ہوں تو آپ کو contents: write / pull-requests: write دینا ہوگا۔
Claude Code Routine Anthropic کے servers پر چلتی ہے۔ OpenCode schedule آپ کے operating system یا GitHub Actions سے چلتا ہے۔ دونوں مقررہ وقت پر تازہ کام شروع کرتے ہیں، اس لیے دونوں کو model سے باہر محفوظ state درکار ہے۔
یہ اختیاری تکنیکی تفصیل ہے؛ پہلی بار پڑھتے ہوئے چھوڑنا محفوظ ہے۔
موجودہ سرکاری docs میں OpenCode GitHub Action کو anomalyco/opencode/github@latest لکھا جاتا ہے؛ کچھ پرانی guides اب بھی sst/opencode/github@latest دکھاتی ہیں۔ دونوں ایک ہی project کی طرف اشارہ کرتے ہیں۔ وہی نام استعمال کریں جو opencode github install بنائے۔ models میں Claude Sonnet 5 اب موجودہ Sonnet tier ہے، جس کا API ID claude-sonnet-5 ہے کیونکہ major-version releases minor number چھوڑ دیتی ہیں۔ یہ Sonnet 4.6 کا براہ راست بدل ہے، جبکہ 4.6 اب بھی درست pinned ID ہے۔ لوپ بنانے والے کے لیے دو باتیں اہم ہیں: adaptive thinking default طور پر on ہے، اور نیا tokenizer اسی text کے لیے تقریبا 30 فیصد زیادہ tokens بناتا ہے، اس لیے 4.6 کے token budgets بغیر تبدیلی کے منتقل نہیں ہوتے۔ Dateless IDs نسل 4.6 میں آئیں، جہاں dateless string خود pinned snapshot ہے۔ نسل 4.5 کے models، مثلا Haiku 4.5، کا dated canonical ID (claude-haiku-4-5-20251001) اور dateless claude-haiku-4-5 alias دونوں ہیں۔ نیچے examples reproducibility کے لیے dated Haiku ID pin کرتی ہیں۔ Model generations اس کتاب سے تیز بدلتی ہیں۔ کسی ID کو pin کرنے سے پہلے opencode models چلائیں، اور نیا release غائب ہو تو model list refresh کریں۔
7. event-driven (واقعہ ہوتے ہی ردعمل)
ایک schedule پوچھتا ہے "ہر گھنٹے جانچو۔" ایک event پوچھتا ہے "X ہوتے ہی فورا ردعمل دو۔" کوئی PR کھلتا ہے، کوئی issue دائر ہوتا ہے، کوئی message آتا ہے — اور لوپ جواب میں چلتا ہے۔
یہ کسی گھڑی اور نگرانی کے بغیر خاموش بیٹھا رہتا ہے۔ پھر کچھ ہوتا ہے: PR، message یا alert۔ لوپ ہر event کے اپنے راستے سے آتے ہی فورا ردعمل دیتا ہے، پھر دوبارہ خاموش ہو جاتا ہے۔
یہ section events کے بارے میں ہے۔ event صرف کسی چیز کے ہونے کا نام ہے۔ ہر قسم کے event کا ایک catcher، یعنی ردعمل دینے والا ٹول، ہوتا ہے اور سب catchers ایک جیسے نہیں۔ GitHub events اور باقی ہر چیز کے events کو Routine پکڑتی ہے۔ chat messages کو Channel پکڑتا ہے۔ یوں تین میں سے دو catchers Routines ہیں، جبکہ Channel نہیں۔ Channel کی ایک کمزوری، یعنی machine آن رہنے کی شرط، نیچے table میں صاف دکھائی گئی ہے۔
Claude Code میں event کہاں سے آتا ہے، یہی طے کرتا ہے کہ کون سا ٹول استعمال ہوگا۔ تین راستے ہیں۔
1. GitHub سے آنے والے event کے لیے Routine استعمال کریں۔ Routine کا گھڑی پر چلنا ضروری نہیں؛ اس کا trigger GitHub event بھی ہو سکتا ہے۔ دو اقسام کام کرتی ہیں: pull request میں تبدیلی، یعنی اس کا کھلنا، اپڈیٹ ہونا یا merge ہونا؛ اور release کا publish ہونا۔ مثلا: "PR کھلے تو اس کا review کر کے comment کریں"، یا "release publish ہو تو changelog کا draft بنائیں۔"
ایک بنانے سے پہلے تین تفصیلات اہم ہیں:
- سیٹ اپ۔ Claude GitHub App کو repository پر install کرنا ضروری ہے۔
/web-setupصرف clone access دیتا ہے اور GitHub App install نہیں کرتا۔ یہی فرق بہت سی پہلی کوششیں ناکام کرتا ہے۔ - push trigger نہیں۔ مگر پہلے سے کھلے PR والی branch پر نئے commits push ہوں تو GitHub اسے PR update، یعنی
synchronizedevent، شمار کرتا ہے اور Routine چلتی ہے۔ PR کے بغیر branch پر push ہو تو کچھ نہیں ہوتا۔ - Filters۔ author، title، labels، branch، draft state اور مزید fields سے طے کر سکتے ہیں کہ کون سے events Routine چلائیں۔ مکمل field list، hourly limits اور مشکل تفصیل Routines appendix کے A3 میں ہے۔
2. chat app سے آنے والے event کے لیے Channel استعمال کریں۔ Channel بیرونی app کا message سیدھا اس session میں پہنچاتا ہے جو پہلے سے چل رہا ہو۔ Telegram، Discord اور iMessage بغیر اضافی setup کے کام کرتے ہیں؛ باقی sources کے لیے webhook لگایا جا سکتا ہے۔ یہی حصہ 2 کی doorbell ہے: message آنے تک کچھ نہیں ہوتا، پھر session فورا ردعمل دیتا ہے۔
Desk سے دور ہوں تو Telegram پر پوچھ سکتے ہیں، "deploy مکمل ہوا؟" موجودہ session اپنی context، skills اور history استعمال کر کے جواب دیتا ہے۔ Loop اسی Channel سے report واپس بھی بھیج سکتا ہے۔
دو احتیاطیں:
- اسے live session درکار ہے۔ session پہلے سے چل رہا ہو، خواہ open terminal ہو یا background session؛ machine بند ہو تو Channel کام نہیں کرتا۔
- یہ کھلا دروازہ ہے۔ اس source پر message بھیج سکنے والا ہر شخص session کو سمت دے سکتا ہے، اس لیے صرف اپنے control والے sources connect کریں۔
Setup: code.claude.com/docs/en/channels۔
3. باقی ہر source کے لیے API trigger والی Routine استعمال کریں۔ بعض events نہ GitHub سے آتے ہیں نہ chat app سے: monitoring tool alert دیتا ہے، deploy مکمل ہوتا ہے، یا form submit ہوتا ہے۔ Routine کو API trigger دیں، پھر authenticated web request بھیجنے والا کوئی بھی system laptop بند ہونے پر بھی اسے چلا سکتا ہے۔ request کا optional text field alert message یا failing log جیسی run-specific context محفوظ prompt کے ساتھ بھیج سکتا ہے۔ endpoint، token اور retry warning Routines appendix کے A3 میں ہیں۔
چار راستوں میں انتخاب:
| Event کہاں سے آتا ہے | استعمال کریں | کام کہاں چلتا ہے | laptop بند؟ |
|---|---|---|---|
| GitHub، یعنی PR یا release | GitHub trigger والی Routine | ہر event پر تازہ cloud session | کام کرتا ہے |
| GitHub، Routine کے بغیر | CI میں Claude Code GitHub Action | ہر event پر تازہ CI runner | کام کرتا ہے |
| chat message، مثلا Telegram، Discord یا iMessage | Channel | پہلے سے چلتا ہوا آپ کا session | نہیں، machine درکار ہے |
| کوئی بھی system جو web request بھیج سکے | API trigger والی Routine | ہر call پر تازہ cloud session | کام کرتا ہے |
دوسری row توقع سے زیادہ اہم ہے۔ Routine ہی laptop بند ہونے کے بعد کام جاری رکھنے کا واحد طریقہ نہیں۔ GitHub Actions workflow میں anthropics/claude-code-action@v1 یہی کام کرتا ہے، مگر تحقیقاتی آزمائش اور روزانہ run cap کے بغیر۔ Pro یا Max plan کافی ہے: claude setup-token runner کے لیے credential بناتا ہے، اس لیے API key بھی نہیں چاہیے۔ unattended کام کی طرف یہ سب سے سستا دروازہ ہے۔
چاروں rows کے نیچے اصل اصول یہ ہے: سوال یہ نہیں کہ "کیا یہ Routine ہے؟" بلکہ یہ ہے کہ "کام کس کے computer پر چلتا ہے؟" اپنا computer بند کریں تو وہ رک جاتا ہے۔ Anthropic کے servers اور GitHub runners نہیں رکتے کیونکہ وہ کبھی آپ کے تھے ہی نہیں۔ اسی لیے ان rows کو token درکار ہے جبکہ /loop کو نہیں تھا: آپ کا laptop پہلے سے جانتا تھا کہ آپ کون ہیں؛ کرائے کا اجنبی computer نہیں جانتا۔ credentials کی ضرورت اور بند laptop کے باوجود چلنا ایک ہی حقیقت کے دو رخ ہیں۔
Channel کے سوا ہر row کا pattern نوٹ کریں: ہر event ایک تازہ session شروع کرتا ہے، اس لیے دو events ایک دوسرے کے بارے میں کچھ نہیں جانتے۔ ایک PR پر دو pushes، دو الگ sessions ہیں۔ ریڑھ کی ہڈی، یعنی تصور 12، انہیں state بانٹنے دیتی ہے۔
اوپر کا دعوی اس وقت تک بے معنی ہے جب تک آپ اسے ہوتا نہ دیکھیں۔ اس تصور کا چھوٹا project The Doorbell صرف ایک کام کرتا ہے: ایسے pull request کا review جسے کسی نے review کرنے کو نہیں کہا۔
اس کی kit اپنے repo میں copy کریں، claude setup-token سے token بنائیں، اسے ایک secret کے طور پر شامل کریں، پھر bug والا pull request کھولیں۔ تقریبا ایک منٹ بعد review ظاہر ہوتا ہے۔ آپ نے کوئی پرامپٹ نہیں لکھا؛ کوئی نگرانی نہیں کر رہا تھا۔
اب وہ حصہ کریں جو تصور ذہن میں بٹھاتا ہے: laptop بند کریں اور کسی دوسرے شخص سے PR کھلوائیں۔ review پھر بھی آتا ہے۔ ایک ہی حرکت میں تصور 4 سے فرق واضح ہو جاتا ہے۔ ISS loop terminal بند ہونے پر مر گیا تھا کیونکہ آپ کی machine پر چل رہا تھا۔ یہ کبھی آپ کی machine پر تھا ہی نہیں۔ گھنٹی بجے تو GitHub computer کرائے پر لیتا، کام چلاتا اور machine ضائع کر دیتا ہے۔
token کی وجہ بھی یہی ہے۔ آپ کا laptop آپ کی شناخت جانتا تھا؛ کرائے کا اجنبی computer نہیں جانتا۔ ہر unattended loop یہ قیمت ادا کرتا ہے۔
ایک بات پہلے سے جان لیں، کیونکہ اسی پر ہمارا ایک گھنٹہ ضائع ہوا: سبز checkmark کا مطلب یہ نہیں کہ کام ہوا۔ ایک setting رہ جائے تو run کامیاب ہوتا، review کرتا، مگر کچھ post نہیں کرتا۔ project کا README setting اور symptom دونوں بتاتا ہے۔ یہ Routine کے بجائے Claude Code GitHub Action استعمال کرتا ہے: وہی doorbell، preview access یا daily cap کے بغیر۔
اختتام اوپر کے paragraph کا ثبوت ہے۔ دوسری بار push کریں تو نیا review پہلے commits کے hashes درست طور پر cite کرے گا، حالانکہ وہ ایسے computer پر چلا جو پہلے موجود نہیں تھا اور کچھ یاد نہیں رکھتا۔ اس نے یاد نہیں رکھا؛ اس نے repo پڑھا۔ یہی spine ہے، جسے حصہ 4 میں باقاعدہ دیکھیں گے۔
GitHub agent کو ایک بار opencode github install سے install کریں، جو .github/workflows/opencode.yml شامل کرتا ہے۔ اس کے بعد، OpenCode repository کے events پر ردعمل دیتا ہے — pull_request، issues، اور /oc یا /opencode comments — آپ کے GitHub Actions runners کے اندر چلتے ہوئے:
name: opencode-review
on:
  pull_request:
    types: [opened, synchronize, reopened, ready_for_review]
jobs:
  review:
    runs-on: ubuntu-latest
    permissions: { contents: read, pull-requests: read }
    steps:
      - uses: actions/checkout@v6
        with: { persist-credentials: false }
      - uses: anomalyco/opencode/github@latest
        env:
          ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }}
          GITHUB_TOKEN: ${{ secrets.GITHUB_TOKEN }}
        with:
          model: anthropic/claude-sonnet-5
          use_github_token: true
          prompt: |
            Review this pull request for bugs, quality issues, and security risks.
بغیر prompt والے pull_request event کے لیے، OpenCode default کے طور پر PR کا review کرتا ہے۔
وقت کام شروع کرے تو schedule استعمال کریں۔ کوئی بیرونی action، مثلا pull request کھلنا یا message آنا، کام شروع کرے تو event استعمال کریں۔
آپ چاہتے ہیں کہ ایک لوپ کسی ناکام test کو pass ہونے تک ٹھیک کرتا رہے، پھر خود ہی رک جائے۔ آپ کون سی دھڑکن چنیں گے، اور "ہو گیا" کا فیصلہ کون کرے گا؟ Run-until-done — Claude Code میں جواب دکھائیں
/goal، یا OpenCode میں ایک capped shell لوپ۔ ایک کمانڈ (test runner) "ہو گیا" کا فیصلہ کرتی ہے، کبھی وہ ایجنٹ نہیں جس نے fix لکھا — اور پھر بھی اسے ایک ceiling چاہیے تاکہ یہ ہمیشہ کوشش نہ کرتا رہے۔
اب آپ چار دھڑکنیں جانتے ہیں۔ سب سے بڑی کو فورا نہ چنیں۔ ہر لوپ دو فیصلوں سے بنتا ہے: اسے کیا شروع کرتا ہے، اور کیا روکتا ہے۔ کچھ بنانے سے پہلے task کے بارے میں پوچھیں: یہ ختم ہوتا ہے یا دہرایا جاتا ہے؟
- task ختم ہوتا ہے، اور command اختتام ثابت کر سکتی ہے → conditional loop۔ اسے ابھی شروع کریں اور مکمل ہونے تک چلنے دیں۔
- task دہرایا جاتا ہے → schedule یا event۔
- task ایک ہی بار ہوتا ہے → لوپ بالکل نہیں۔ عام session، turn بہ turn، درست ٹول ہے۔ بیشتر کام کے لیے اب بھی یہی درست ہے۔
ایک اور اصول: نیا repeating loop پہلے چند حقیقی runs آپ کی نگرانی میں چلائے، پھر unattended بھروسا کریں۔ حصہ 6 اسے صاف اصول بناتا ہے: رات بھر استعمال سے پہلے لوپ کو ثابت کریں۔
ناموں پر آخری نوٹ۔ online لوگ الفاظ ڈھیلے انداز میں استعمال کرتے ہیں۔ "Turn-based" عام session ہے۔ "Goal-based" ہمارا conditional loop ہے۔ "Time-based" ہماری دو الگ اقسام، in-session اور scheduled، کو ملا دیتا ہے۔ "Proactive" حصہ 5 جیسا مکمل composed loop ہے۔ labels مختلف، حصے وہی۔
مشق: دھڑکن منتخب کریں، پھر ایک بنائیں
اب آپ چاروں دھڑکنیں جانتے ہیں، اور انہیں استعمال کرنے کا یہی بہترین وقت ہے، جب چاروں تصویریں ابھی ذہن میں تازہ ہیں۔ دو مرحلے ہیں۔ پہلے ثابت کریں کہ آپ درست دھڑکن منتخب کر سکتے ہیں۔ پھر جا کر ایک شروع کریں۔
پہلا مرحلہ: انتخاب کریں (2 منٹ، کچھ انسٹال کرنے کی ضرورت نہیں)۔ نیچے ہر کام کے لیے دھڑکن کا نام بتائیں۔ ان میں سے ایک پھندا ہے۔
- ہر جمعہ، ٹیم کے لیے اس ہفتے merge ہونے والی pull requests کا خلاصہ تیار کریں۔
- اس ناکام build پر اس وقت تک کام جاری رکھیں جب تک وہ کامیاب نہ ہو جائے، پھر رک جائیں۔
- کوئی شخص pull request کھولے، اور اس کا review ہونا چاہیے۔
- ایک 40 منٹ کی migration چل رہی ہے، اور آپ اسی لمحے جاننا چاہتے ہیں جب وہ ختم ہو۔
- پورے repo میں ایک variable کا نام بدلیں۔
جوابات دکھائیں
- طے شدہ۔ یہ گھڑی کے مطابق دہرایا جاتا ہے، اور وہاں کسی شخص کا ہونا ضروری نہیں۔ ایک Routine، یا
cronکی ایک لائن (تصور 6)۔ - مشروط، یعنی مکمل ہونے تک چلنے والا لوپ۔ یہ ختم ہوتا ہے، اور ایک کمانڈ اختتام ثابت کر سکتی ہے۔
/goal، یا حد والا shell loop (تصور 5)۔ - واقعے سے چلنے والا۔ کوئی بیرونی عمل اسے شروع کرتا ہے، اس لیے پرسکون دن میں یہ صفر بار چلتا ہے (تصور 7)۔
- سیشن کے اندر۔ آپ اب بھی دیکھ رہے ہیں، اور سیشن بند کرنے پر یہ رک سکتا ہے۔
/loop، یاwhileloop کے ساتھsleep(تصور 4)۔ - کوئی لوپ نہیں۔ کام صرف ایک بار ہوتا ہے، اس لیے عام سیشن درست ٹول ہے۔ اگر آپ نے اس کے لیے لوپ منتخب کیا تو اوپر دیا گیا مشورہ دوبارہ پڑھیں۔ زیادہ تر کام اب بھی اسی قطار میں آتا ہے، اور اس کورس کے بعد بھی یہی رہے گا۔
دوسرا مرحلہ: ایک بنائیں۔ کورس کے آخر میں ہر دھڑکن کے لیے ایک پروجیکٹ موجود ہے۔ ابھی چاروں نہ کریں۔ دو آپ کے لیے تیار ہیں، اور دو جان بوجھ کر ان حصوں تک جاتے ہیں جنہیں آپ نے ابھی نہیں پڑھا:
| دھڑکن | تصور | اسے یہاں بنائیں | ابھی تیار؟ |
|---|---|---|---|
| سیشن کے اندر | 4 | پروجیکٹ 1، ایک watch loop | ہاں |
| مشروط | 5 | پروجیکٹ 2، tests کامیاب کریں، پھر رکیں | ہاں |
| طے شدہ | 6 | پروجیکٹ 3، memory کے ساتھ صبح کی رپورٹ | حصہ 4 کے بعد، اسے ریڑھ کی ہڈی چاہیے |
| واقعے سے چلنے والا | 7 | پروجیکٹ 6، doorbell loop | حصہ 3 کے بعد، اسے connectors چاہییں |
آخری کالم پر ایک لمحہ رکنا بنتا ہے۔ memory کے بغیر schedule ہر صبح وہی پہلا قدم دہراتا ہے، اور ایسی واقعے سے چلنے والی loop جو pull request نہ کھول سکے صرف بات کر سکتی ہے۔ اس لیے وہ دونوں دھڑکنیں جو آپ کے بغیر چلتی ہیں، عین وہی ہیں جنہیں پہلے کورس کے باقی حصوں کی ضرورت ہے۔ یہ غیر ضروری مواد نہیں۔ یہی اس نظام کی اصل ساخت ہے۔
پروجیکٹ 1 سب سے سستا آغاز ہے: تقریبا 15 منٹ، کسی schedule کی ترتیب نہیں، اور کوئی ایسی چیز نہیں جو آپ کی غیر موجودگی میں چل سکے۔ اگر حصہ 3 سے پہلے صرف ایک کام کرنا ہو تو یہی کریں۔
حصہ 3: ہر run میں لوپ کیا کرتا ہے (جسم)
دھڑکن لوپ شروع کرتی ہے۔ یہ چار حصے وہ ہیں جو لوپ ہر دھڑکن پر کرتا ہے۔ ان سے آپ ایجنٹک کوڈنگ کورس میں کارآمد اضافی چیزوں کے طور پر مل چکے ہیں۔ کسی لوپ میں یہ واقعی اہم ہوتے ہیں، کیونکہ ہر قدم کو کوئی شخص نہیں دیکھ رہا ہوتا۔
8. isolation: worktrees
جس لمحے کوئی لوپ بیک وقت ایک سے زیادہ ایجنٹ چلاتا ہے، وہ ایک دوسرے کی فائلوں پر لکھنا شروع کر دیتے ہیں — بالکل ویسے ہی جیسے دو لوگ ایک دوسرے کو بتائے بغیر ایک ہی لائنیں edit کریں۔ ایک git worktree اسے ٹھیک کرتا ہے: ایک علیحدہ working folder، اپنی الگ branch پر، جو وہی repo history شیئر کرتا ہے۔ ایک ایجنٹ کی edits دوسرے کے checkout کو چھو نہیں سکتیں۔
built-in۔ --worktree flag استعمال کریں تاکہ کوئی سیشن اپنے الگ checkout میں کھلے، یا کسی subagent پر isolation: worktree سیٹ کریں تاکہ ہر مددگار کو ایک تازہ checkout ملے جو بعد میں خود کو صاف کر لے۔ ایک scheduled task فی run worktree علیحدگی آن کر سکتا ہے، تو متوازی runs کبھی آپ کے اپنے دستی کام سے نہیں ٹکراتے۔
کوئی واحد flag نہیں۔ آپ git کے اپنے worktrees استعمال کرتے ہیں اور ہر ایک کی طرف ایک run کا رخ کرتے ہیں۔ وہی علیحدگی، صاف ظاہر کی گئی:
git worktree add ../wt-feature-a feature-a
git worktree add ../wt-feature-b feature-b
( cd ../wt-feature-a && opencode run "implement feature A" ) &
( cd ../wt-feature-b && opencode run "implement feature B" ) &
wait
Community runners (OpenCode کے گرد بنے worktree managers) آپ کے لیے یہ حساب کتاب سنبھال سکتے ہیں اگر آپ یہ اکثر کرتے ہیں۔
9. علم: skills، تاکہ کوئی run صفر سے شروع نہ ہو
ایک لوپ ہر بار ٹھنڈا چلتا ہے — ایک تازہ سیشن جسے آپ کے پروجیکٹ کی عادتوں کی کوئی یاد نہیں۔ بغیر مدد کے، یہ ہر دھڑکن پر آپ کا پورا سیٹ اپ سمجھتا (یا اندازہ لگاتا) ہے، tokens ضائع کرتا اور غلطیوں کو دعوت دیتا ہے۔ ایک skill وہی علم ہے جو ایک بار، ایک SKILL.md فائل میں لکھا جاتا ہے، جہاں ایجنٹ اسے ہر run پر پڑھتا ہے۔
یہ دونوں ٹولز میں ایک جیسا کام کرتا ہے: ہدایات اور metadata والے ایک SKILL.md کے ساتھ ایک folder، جس میں اختیاری scripts اور references بھی ہوں۔ کسی لوپ میں قاعدہ سادہ ہے: جو کچھ بھی آپ کو ہر run پر دوبارہ سمجھانا پڑے، اس کا تعلق کسی skill سے ہے۔ triage کے قدم، پروجیکٹ کی عادتیں، "ہم ایسا اس لیے نہیں کرتے کیونکہ ایک بار وہ واقعہ ہوا تھا" — یہ سب skill میں رہتا ہے، تو لوپ نئے سرے سے شروع ہونے کے بجائے خود پر تعمیر کرتا ہے۔ (مکمل تفصیل Skills & Connectors فوری کورس میں۔)
ہدایات کی ایک دیوار کسی ایسے schedule میں چپکانے کے بجائے جسے کوئی اپڈیٹ نہیں رکھے گا، آپ کا scheduled prompt ایک لائن بن جاتا ہے — "daily-triage skill چلاؤ" — اور تفصیل skill رکھتا ہے۔ مختصر لوپ prompt، آسانی سے اپڈیٹ ہونے والی logic، ہر دھڑکن پر کم token لاگت۔
10. action: connectors، تاکہ loop صرف تجویز نہیں بلکہ عمل کرے
ایسا لوپ جو صرف آپ کی فائلیں پڑھ سکتا ہے، ایسا لوپ ہے جو صرف بات کر سکتا ہے۔ Connectors — MCP پر بنے — اسے کرنے دیتے ہیں: کوئی PR کھولنا، کوئی Linear ticket اپڈیٹ کرنا، Slack پر پوسٹ کرنا، کسی database سے query کرنا، کسی staging API کو call کرنا۔ یہی فرق ہے اس لوپ میں جو کہتا ہے "یہ رہا fix" اور اس لوپ میں جو PR کھولتا ہے، ticket جوڑتا ہے، اور CI green ہوتے ہی channel پر پوسٹ کرتا ہے۔
دونوں ٹولز MCP بولتے ہیں، تو protocol ان کے درمیان منتقل ہوتا ہے — مگر packaging اور authentication (local بمقابلہ hosted، OAuth، permissions) کو اکثر ٹول کے مطابق wiring چاہیے ہوتی ہے۔
MCP servers اپنی config میں شامل کریں اور انہیں کسی routine کی connector list میں رکھیں، تاکہ بے توجہ run ان تک پہنچ سکے۔ وہی connectors جو آپ ہاتھ سے استعمال کرتے ہیں، scheduled اور cloud runs کو دستیاب ہوتے ہیں۔
Servers کو mcp section میں opencode.json کے اندر declare کریں — local servers ایک subprocess شروع کرتے ہیں، remote servers خودکار OAuth کے ساتھ کسی HTTPS endpoint تک پہنچتے ہیں۔ کسی scheduled opencode run میں، ایک بار opencode serve شروع کریں اور اس سے --attach ہوں، تاکہ آپ ہر دھڑکن پر MCP آغاز کی لاگت ادا نہ کریں۔
لوپ دوبارہ کوشش کرتا ہے، اور بغیر نگرانی کے tools منتخب کرتا ہے۔ اس سے اچھے tool set کی شکل بدل جاتی ہے:
- بہت سے ایک جیسے tools کے مقابلے میں کم اور واضح مقصد والے tools بہتر ہیں۔ ہر دھڑکن پر ماڈل خود فیصلہ کرتا ہے کہ کون سا tool استعمال ہو، اور کوئی اسے دیکھ نہیں رہا ہوتا۔ ایک جیسے کام کرنے والے سو tools دے دیں تو درست انتخاب مشکل ہو جاتا ہے۔ عملی تجربے میں agent کو دستیاب tools کم کرنے سے کامیابی کی شرح بہتر ہوئی ہے۔ Anthropic کا سادہ اصول ہے: اگر انسانی engineer یقین سے نہیں بتا سکتا کہ کام کے لیے کون سا tool درست ہے تو agent بھی نہیں بتا سکے گا۔ ہاتھ سے کام کرتے وقت غلط tool چننے میں ایک لمحہ ضائع ہوتا ہے؛ لوپ میں ہر بار ایک پوری دھڑکن ضائع ہوتی ہے۔ اس لیے connector list میں صرف وہی tools رکھیں جن کی لوپ کو واقعی ضرورت ہے۔ Routines کا ضمیمہ حفاظت کی خاطر بھی یہی کہتا ہے۔
- لکھنے والے actions کو دوبارہ چلانا محفوظ ہونا چاہیے۔ ناکام قدم پر دوبارہ کوشش کرنے والا لوپ وہی write action پھر چلا سکتا ہے۔ اگر “customer بنائیں” دوبارہ چلنے پر دوسرا customer بنا دے تو duplicate records اور دوہری billing ہو سکتی ہے۔ blind create کے بجائے update-or-create یا ہر branch کے لیے ایک PR جیسی operations اختیار کریں جنہیں دہرانا محفوظ ہو۔
- error اگلا قدم واضح کرے۔ لوپ میں error message ہی اگلی دھڑکن کا input بنتا ہے۔ “Permission denied:
reposcope مانگیں” اگلی کوشش میں درست کیا جا سکتا ہے؛ صرف “Error 403” ایک دھڑکن ضائع کرتا ہے۔
ہاتھ سے کام کرتے ہوئے آپ یہ تینوں مسائل خود سنبھال لیتے ہیں: درست tool چنتے، duplicate روک لیتے اور error تلاش کر لیتے ہیں۔ unattended run میں ایسا کرنے والا کوئی موجود نہیں ہوتا۔
11. maker-checker: subagents
کسی لوپ کا سب سے اہم فیصلہ: جو ایجنٹ کام لکھتا ہے وہ اسے منظور کرنے والا ایجنٹ نہیں ہونا چاہیے۔ اپنے ہی output کو grade کرنے والا ماڈل اپنے ساتھ کہیں زیادہ نرمی کرتا ہے۔ مختلف ہدایات اور ممکنہ طور پر مختلف ماڈل والا دوسرا agent وہ مسائل پکڑ سکتا ہے جو پہلے سے رہ گئے۔ یہی separation unattended loop کو زیادہ محفوظ بناتی ہے۔ اسے LLM-as-judge بھی کہا جاتا ہے: maker کے خود کو grade کرنے کے بجائے ایک الگ model کام کا فیصلہ کرتا ہے۔
subagents کو .claude/agents/ میں define کریں، اور انہیں agent teams کے طور پر یکجا کریں: ایک کھوج کرتا ہے، ایک implement کرتا ہے، ایک spec اور tests کے خلاف جانچتا ہے۔ "spec" وہی ہے جو آپ نے Spec-Driven Development میں لکھنا سیکھا: اس کے acceptance criteria بالکل وہی ہیں جن کے خلاف ایک قابل بھروسہ checker grade کرتا ہے — مبہم spec آپ کو مبہم فیصلہ دیتا ہے۔ یہی وہ کام ہے جو /goal اندر کرتا ہے: ایک تازہ ماڈل فیصلہ کرتا ہے کہ لوپ مکمل ہوا یا نہیں، worker کے خود کو grade کرنے کے بجائے۔
OpenCode کے primary agents Build اور Plan ہیں۔ اس میں تین subagents بھی شامل ہیں: general، explore اور scout۔ Scout read-only ہے اور external documentation اور dependency research کے لیے استعمال ہوتا ہے۔ آپ اضافی agents کو opencode.json یا agents folder کی Markdown فائلوں میں define کر سکتے ہیں۔
checker کو اس کا اپنا model دیں، جو اکثر سستا اور read-only ہو سکتا ہے۔ maker اسے @ mention یا Task tool کے ذریعے بلا سکتا ہے۔ عام design میں مضبوط model تحقیق اور implementation کرتا ہے، پھر focused model نتیجہ جانچتا ہے۔
لوپ میں دو settings خاص طور پر اہم ہیں: ہر agent کے لیے steps کی حد (تصور 5)، اور permission.task کے rules جو subagent کو مزید subagents شروع کرنے سے روکتے ہیں۔ ان حدود کے بغیر agents ایک دوسرے کو دائرے میں کام سونپ سکتے ہیں اور غیر ضروری tokens خرچ کر سکتے ہیں۔
---
mode: subagent
model: anthropic/claude-haiku-4-5-20251001
description: Reviews a diff against the spec and tests. Replies PASS or FAIL with reasons.
---

You are a strict code reviewer. You do not make changes.
Check the diff against the spec and the test results, then reply PASS or FAIL with the reasons.
ہر sub-agent اپنا الگ ماڈل اور tools چلاتا ہے، تو maker–checker تقسیم واقعی زیادہ tokens خرچ کرتی ہے۔ یہی ایک ایسے checker کی قیمت ہے جس پر آپ بھروسہ کر سکیں۔ اسے وہاں خرچ کریں جہاں دوسری رائے اہم ہو (ہر وہ چیز جو لوپ آپ کی غیر موجودگی میں commit کرے گا)؛ پھینک دینے والے، read-only کاموں کے لیے اسے چھوڑ دیں۔
وقفہ: dynamic workflows سے جسم کو باقاعدہ بنائیں
اب تک، ایک دھڑکن کا جسم — کام ڈھونڈنا، ہر fix کو اپنے checkout میں draft کرنا، کسی علیحدہ ایجنٹ سے اسے grade کروانا — وہ ہے جسے ایجنٹ turn بہ turn جوڑتا ہے۔ Claude Code اب آپ کو اس پوری orchestration کو ایک دوبارہ چلائے جانے والے script کے طور پر codify کرنے دیتا ہے، جسے dynamic workflow کہتے ہیں: آپ کام بیان کرتے ہیں، Claude ایک script لکھتا ہے جو کام کو کئی sub-agents میں پھیلاتا ہے، اور ایک runtime اسے background میں چلاتا ہے جبکہ آپ کا سیشن آزاد رہتا ہے۔ یہ maker–checker تقسیم (تصور 11) اور worktree تقسیم (تصور 8) کو ایک دہرائے جانے والے unit میں packaged کر دیتا ہے — اور یہ ایک حقیقی quality pattern لاگو کر سکتا ہے، صرف زیادہ ایجنٹ چلانے سے زیادہ: آزاد reviewers کسی بھی چیز کی رپورٹ ہونے سے پہلے ایک دوسرے کے نتائج کو adversarially جانچ سکتے ہیں۔
سادہ الفاظ میں ایک مانگیں ("use a workflow to…")، اسے ultracode keyword سے trigger کریں (پرانا workflow trigger لفظ 2026 کے وسط میں ختم کر دیا گیا؛ مطلوبہ کام عام الفاظ میں بیان کرنا اب بھی کام کرتا ہے)، یا bundled /deep-research چلائیں۔ جب کوئی run وہ کرے جو آپ چاہتے ہیں، تو s دبائیں؛ /workflows view اس کا script ایک /command کے طور پر محفوظ کر دے گا جسے آپ ہر branch پر دوبارہ چلا سکیں۔ guardrails اسے قابو میں رکھتے ہیں: agents کی حد ہے (ایک وقت میں تقریبا 16، فی run 1000)، اس لیے runaway script بے قابو نہیں بڑھتا۔ بار بار validation میں ناکام ہونے والے subagents چند کوششوں کے بعد رک جاتے ہیں۔ کسی run کی memory صرف اسی run کے اندر رہتی ہے: اسی session میں اسے resume کر سکتے ہیں، مگر تازہ session اسے نئے سرے سے شروع کرتا ہے۔
کوئی /workflows کمانڈ نہیں۔ جو script آپ پہلے ہی لکھتے ہیں وہی workflow ہے: تصور 5 والا capped for لوپ اور تصور 8 والا &/wait fan-out اسی خیال کا ہاتھ سے بنا ہوا نسخہ ہیں — آپ کا shell منصوبہ رکھتا ہے، opencode run ہر ایجنٹ ہے، اور exit codes checker ہیں۔ آپ کو پورا کنٹرول اور کوئی agent cap نہیں ملتا، اس قیمت پر کہ orchestration آپ خود لکھتے اور سنبھالتے ہیں۔
جیسے ہی workflows طاقتور محسوس ہونے لگتے ہیں، یہی سب سے آسان غلطی ہے۔ ایک dynamic workflow ایک بار چلتا ہے، جب آپ (یا ultracode setting) اسے شروع کریں، اور ختم ہوتے ہی سب کچھ بھول جاتا ہے۔ اس کی کوئی heartbeat یا spine نہیں۔ اس لیے یہ ایک heartbeat کا جسم ہے، loop نہیں۔ Loop ایک ترکیب ہے: heartbeat، یعنی Routine، /loop یا cron، beat شروع کرتی ہے؛ workflow اس beat پر چلنے والا جسم ہے؛ اور agents کی لکھی ہوئی progress file وہ spine ہے جسے اگلی beat پڑھتی ہے۔
یاد رکھنے کے لیے: workflow engine ہے، Routine چابی گھماتی ہے، اور progress.md معلومات اگلے سفر تک لے جاتی ہے۔
آپ کا لوپ ایک ہی وقت میں دو ایجنٹس چلاتا ہے، اور آپ اس کی غیر موجودگی میں ہونے والی commits پر بھی بھروسہ کرنا چاہتے ہیں۔ یہ دو الگ مسائل ہیں۔ جسم کا کون سا حصہ ہر مسئلہ حل کرتا ہے؟ Worktrees متوازی کام کا مسئلہ حل کرتے ہیں: ہر ایجنٹ کو الگ checkout ملتا ہے، اس لیے ان کی edits نہیں ٹکراتیں۔ Maker-checker بھروسے کا مسئلہ حل کرتا ہے: ایک الگ ایجنٹ کام کو جانچتا ہے، اس لیے آپ کے دیکھے بغیر بھی «مکمل» کا مطلب واضح رہتا ہے۔ لوگ انہیں ملا دیتے ہیں۔ isolation ایجنٹس کو ایک دوسرے کے راستے سے دور رکھتی ہے، جبکہ checker خراب کام کو repo سے دور رکھتا ہے۔ دونوں ضروری ہیں، مگر مختلف وجوہ سے۔جواب دکھائیں
وقفہ: verification skills کے ذریعے checker کو باقاعدہ بنائیں
پچھلے وقفے نے ایک دھڑکن کے جسم کو باقاعدہ بنایا تھا۔ یہ وقفہ checker کو باقاعدہ بناتا ہے۔ جولائی 2026 میں Anthropic کی Claude Code ٹیم نے اسی موضوع پر اپنی رہنمائی شائع کی، اور اسے verification loop کہا: ایجنٹ اپنا کام جانچتا ہے اور خرابی درست کرنے کی کوشش کرتا رہتا ہے، یہاں تک کہ جانچ کامیاب ہو جائے۔ آپ اس لوپ کو پہلے اس کتاب کے نام سے دیکھ چکے ہیں۔ یہ ایجنٹک کوڈنگ کورس کا Attempt → Check → Fix → Repeat چکر ہے، جسے Boris Cherny ٹول استعمال کرنے کا سب سے اہم مشورہ کہتے ہیں۔
پہلے نام واضح کر لیں تاکہ «لوپ» آپ کو الجھائے نہیں۔ verification loop ایک دھڑکن کے اندر چلتا ہے۔ اس کی اپنی heartbeat یا spine نہیں۔ دھڑکن ختم ہو تو یہ بھی ختم ہو جاتا ہے۔ اس کورس کی زبان میں یہ چھوٹے لوپ کی مشینری ہے۔ اس باب سے اس کا تعلق اگلے قدم میں بنتا ہے: ایک ہی check کو ایک بار لکھ دیا جائے تو heartbeat کے چلتے ہی وہ بڑے لوپ کا checker بن جاتا ہے۔ حصہ 5 کا reviewer عین اسی طرح کی لکھی ہوئی جانچ کے خلاف درجہ بندی کرتا ہے۔ یعنی اصل کام یہ ہے کہ ذہن میں موجود جانچ کو ایک فائل دے دی جائے۔
کون سی جانچ لکھنی چاہیے۔ اصول سادہ ہے: ایجنٹ کے ختم ہونے کے بعد جو چیز آپ ہر بار ہاتھ سے درست کرتے ہیں، اسے check کی صورت میں لکھ دینا فائدہ مند ہے۔ ہر frontend تبدیلی کے بعد manual click-through، error logs سے request body ہٹانے کی پڑتال، یا approval سے پہلے migration دوبارہ پڑھنا۔ طریقہ سادہ زبان میں ایسے لکھیں جیسے پہلے دن کسی نئے ساتھی کو دے رہے ہوں۔ اگر واضح طور پر نہ لکھ سکیں تو پہلے ایجنٹ سے best-practice نسخہ مانگیں، پھر اسے اپنی ضرورت کے مطابق بدلیں۔ عام حصہ ماڈل پہلے جانتا ہے۔ آپ کے پروجیکٹ سے مخصوص فرق ہی اصل قیمتی حصہ ہے۔
جانچ کے لیے فیصلہ طلب ہونا بھی ضروری نہیں۔ «ایسی migration رد کریں جو backfill کے بغیر column حذف کرے» ایک مقررہ قاعدہ ہے جسے کمانڈ ثابت کر سکتی ہے، مگر کوئی عام linter اسے شامل نہیں کرے گا کیونکہ یہ آپ کا قاعدہ ہے۔ تصور 2 کی checker ladder میں یہ ایک اہم درجہ ہے: پہلے سے موجود mechanical checks اور reviewer کے rubric کے درمیان وہ mechanical checks جو صرف آپ لکھ سکتے ہیں۔ rubric سے اس درجے پر منتقل ہونے والا ہر قاعدہ دعوے کو ثبوت میں بدل دیتا ہے۔
اسے skill میں پیک کریں۔ تصور 9 کا container آپ جانتے ہیں: ایک SKILL.md جسے کام کے مطابق ایجنٹ لوڈ کرتا ہے۔ verification skill اسی container میں procedure کے بجائے check رکھتی ہے۔ مکمل مثال ایک screen میں آ جاتی ہے:
# .claude/skills/verify-log-hygiene/SKILL.md  (or .opencode/skills/…)
---
name: verify-log-hygiene
description: Check that error logs include the request ID and never
  include the request body. Use when the diff touches error handling
  or logging.
allowed-tools: [Read, Edit, Grep]
---

Read the error-handling paths in the current diff.

For each log call on an error path, confirm it includes the request ID
and does not pass the request body, headers, or any user-supplied
payload.

Report each violation with file:line, then fix it: add the request ID
where it's missing and strip the payload from the log call.
allowed-tools کی لائن پر غور کریں: یہ check صرف پڑھ، edit اور search کر سکتا ہے۔ یہی تصور 14 کی standing-permission سوچ ہے۔ reviewer کی tools line کی طرح یہ tool names لیتی ہے، انفرادی commands نہیں۔ check کو مخصوص commands تک محدود کرنے والی enforcement اگلے Harness Engineering کورس میں ہے۔
جانچ کہاں چلتی ہے۔ Anthropic کی رہنمائی یہاں ایک نیا مفید نکتہ دیتی ہے: ایک check کے چار ممکنہ گھر ہیں، اور ہر گھر کی heartbeat الگ ہے۔
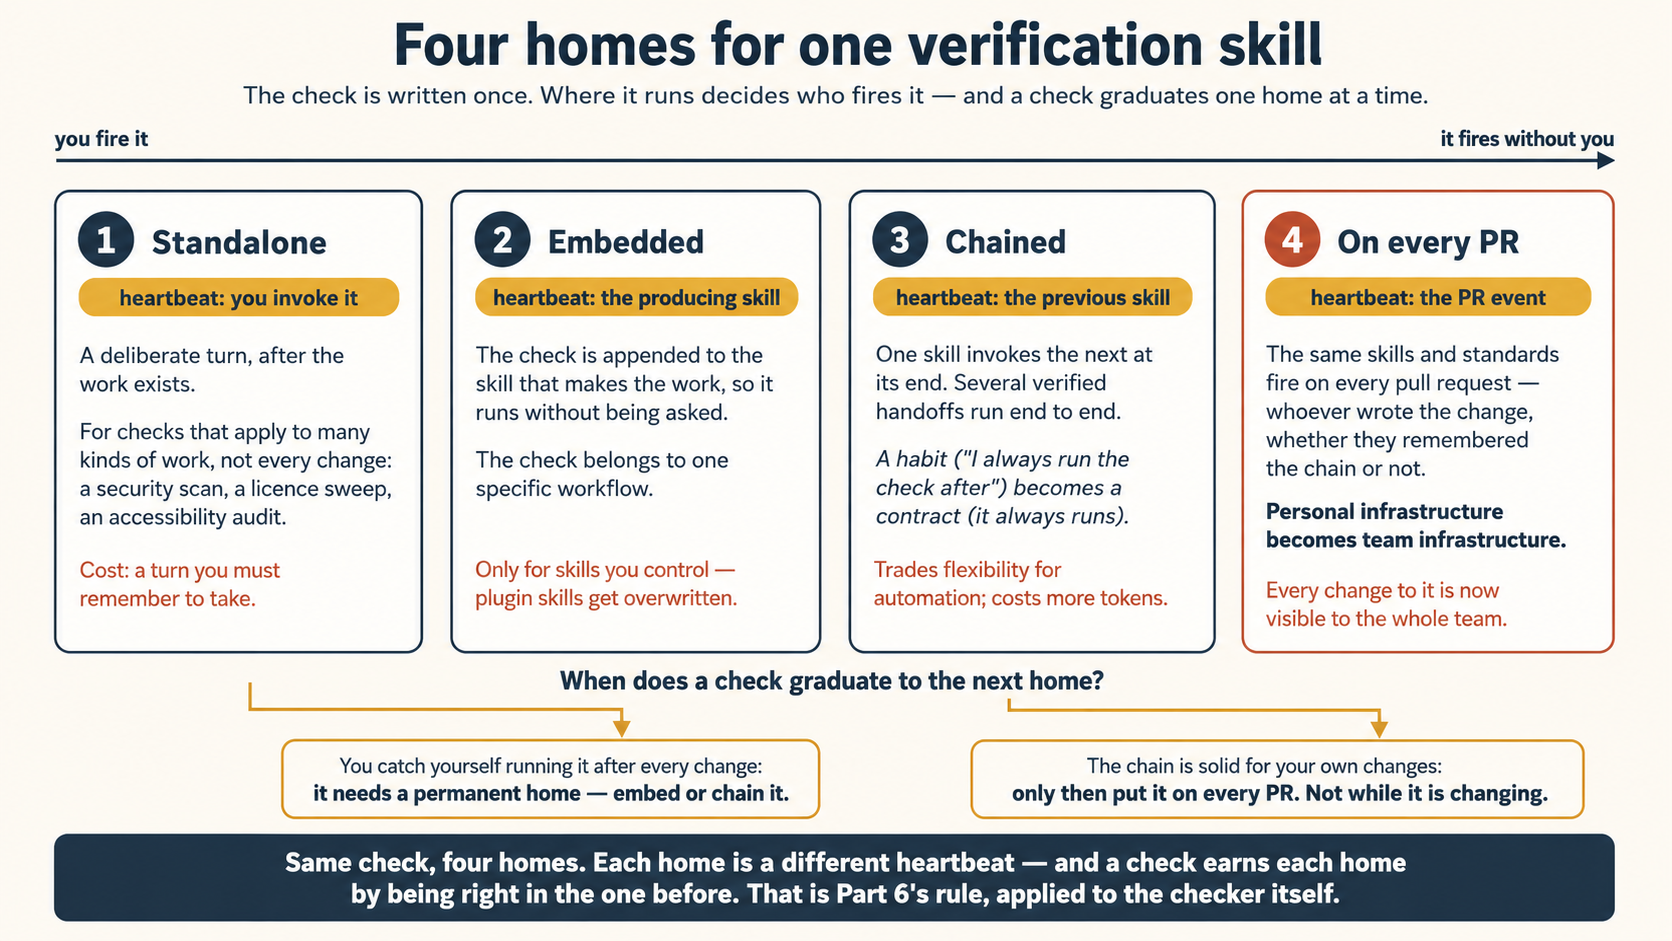
- Standalone۔ کام بن جانے کے بعد آپ اسے جان بوجھ کر چلاتے ہیں۔ یہاں آپ heartbeat ہیں۔ یہ ان checks کے لیے مناسب ہے جو کئی طرح کے کام پر لگتی ہیں مگر ہر تبدیلی پر نہیں، جیسے security scan، licence-header sweep، یا accessibility audit۔ قیمت یہ ہے کہ ہر بار اسے چلانا یاد رکھنا پڑتا ہے۔
- Embedded۔ check کو کام بنانے والی skill کے آخر میں شامل کر دیں تاکہ workflow اسے خود چلائے۔ سادہ صورت میں ایک لائن کافی ہے: «component بنانے کے بعد eslint چلائیں اور نتیجہ دینے سے پہلے ہر error درست کریں۔» نئی task پر skill چلا کر تصدیق کریں کہ check واقعی چلتی ہے۔ اگر نہیں، تو پہلے والی ہدایات اسے لوڈ نہیں کر رہیں۔ سخت حد یہ ہے کہ صرف وہ skill embed کی جا سکتی ہے جسے آپ edit کر سکتے ہیں۔ built-in یا plugin-managed skills update پر overwrite ہو جاتی ہیں، اس لیے وہاں chain استعمال کریں۔
- Chained۔ ایک skill اختتام پر دوسری کو چلاتی ہے، یوں کئی verified handoffs آخر تک چلتے ہیں۔ Anthropic کی Claude Code ٹیم روزانہ یہی کرتی ہے:
/code-reviewbugs ڈھونڈتا ہے،/simplifydiff صاف کرتا ہے،/verifyمکمل رویہ چیک کرتا ہے، اور custom/designskill UI کوDESIGN.mdکے خلاف جانچتی ہے۔ جس skill کو بدل نہیں سکتے، اس کے گرد wrapper skill لکھنا بھی chaining ہے۔ یاد رکھنے والی بات: جو عادت تھی، «میں بعد میں ہمیشہ check چلاتا ہوں»، وہ معاہدہ بن جاتی ہے، «skill ختم ہوتے ہی ہمیشہ check چلتی ہے»۔ مگر قیمت بھی حقیقی ہے: flexibility کم ہوتی ہے اور ہر link ہر run پر tokens خرچ کرتا ہے۔ - ہر PR پر۔ اپنی تبدیلیوں پر chain مضبوط ہو جائے تو تصور 7 کے event heartbeat، یعنی Doorbell، کے ذریعے یہی skills ہر pull request پر چلائیں۔ اب ہر ساتھی کی تبدیلی انہی gates سے گزرتی ہے، چاہے اس نے خود کچھ invoke کیا ہو یا نہیں۔ یہاں verification ذاتی infrastructure سے ٹیم infrastructure بنتی ہے۔
ترقی کا قاعدہ۔ چوتھے گھر سے آغاز نہ کریں۔ standalone check اس وقت اگلے گھر کے لیے تیار ہے جب آپ خود کو ہر تبدیلی کے بعد اسے چلاتے پائیں۔ تب اسے embed یا chain کریں۔ chain کے بدلتے رہنے کے دوران اسے پوری ٹیم کے PRs پر نہ لگائیں، کیونکہ وہاں اس کی ہر تبدیلی سب کو نظر آئے گی۔ یہی حصہ 6 کا قاعدہ ہے: پہلے تیز اور نگرانی میں ثابت کریں، پھر آہستہ اور غیر حاضر حالت میں بھروسہ کریں۔
جولائی 2026 کے آخر تک تین موجودہ shortcuts:
- جو ساتھ آتا ہے اس سے شروع کریں۔ built-in
/verifyskill آپ کی application بناتی، چلاتی اور تبدیلیاں دیکھتی ہے۔ اپنی skill لکھنے سے پہلے اسے آزمائیں۔CLAUDE.mdمیں اپنے عین build اور test commands لکھیں تاکہ کوئی run اندازہ نہ لگائے۔ - ایجنٹ کو اپنا interview لینے دیں۔ verification skill لکھنے کا تیز طریقہ skill-creator plugin ہے:
/skill-creator Create a skill for verifying frontend changes end-to-end. Interview me about my workflow.سوالوں کے جواب دیں، اور فائل بن جائے گی۔ ہاتھ سے.claude/skills/میں لکھنا بالکل تصور 9 کی طرح کام کرتا ہے۔ - managed چوتھا گھر۔ Code Review ایک managed multi-agent research preview ہے جو فعال repos کی pull requests پر خودکار review چلاتا ہے۔ finding درست کر کے push کریں، یا GitHub Action موجود ہو تو finding پر
@claudeلکھیں۔
کچھ نیا انسٹال نہیں کرنا۔ اوپر والا SKILL.md .opencode/skills/ میں بغیر تبدیلی کام کرتا ہے:
- Standalone یہ ہے:
opencode run "run the verify-log-hygiene skill on the current diff"۔ - Embedded اپنی producing skill کے آخر میں وہی ایک لائن ہے۔
- Chained آپ کا script ہے: ہر skill کی exit state طے کرتی ہے کہ اگلا
opencode runچلے یا نہیں۔ - ہر PR پر تصور 7 کی GitHub Action ہے، جس میں check prompt ہے۔ پہلے دیکھا گیا default no-prompt PR review دراصل OpenCode کے اجزا سے بنا Anthropic کا
/code-reviewتصور ہے۔ اپنی verification skill کی طرف اشارہ کرنے والا prompt اسے generic کے بجائے آپ کے standards بناتا ہے۔
verification skill وہ دستی جانچ ہے جو آپ پہلے ہی کرتے تھے، مگر اب ایک بار لکھ دی گئی ہے تاکہ ایجنٹ اسے چلائے اور ملنے والی خرابی درست کرے۔ پہلے خود چلائیں۔ جب ہر بار چلانے لگیں تو workflow کے ساتھ جوڑیں۔ جب پوری chain آپ کے لیے درست کام کرے، تب ہر PR پر لگائیں۔
دو موضوع جان بوجھ کر پڑوسی کورسز کے لیے چھوڑے گئے ہیں۔ Enforcement، یعنی check کو checking کے سوا کچھ کرنے سے روکنا، Harness Engineering کورس میں ہے۔ allowed-tools toolbox محدود کرتا ہے، مگر اصل locks اسی اگلے کورس میں ہیں۔ Grading، یعنی rubric والی check اور model کے score پر اعتماد کی حد، Trusting the Checker کورس میں ہے۔ Claude Managed Agents کی Rubrics beta تصور 2 کے rubric-with-a-bar کی managed شکل ہے: الگ grader agent outcomes کو rubric کے خلاف جانچتا ہے اور ناکام کام خود ایک اور کوشش کے لیے واپس جاتا ہے۔
آپ نے بہترین accessibility check لکھی ہے اور آج ہی سے پوری ٹیم کی PRs پر چلانا چاہتے ہیں۔ یہ دو بار چلی ہے، دونوں مرتبہ آپ نے ہاتھ سے چلائی۔ ترقی کا قاعدہ کیا کہتا ہے، اور آپ کون سے دو گھر چھوڑ رہے ہیں؟ ابھی نہیں۔ دو دستی runs کے بعد check اب بھی standalone گھر میں ہے، اور ہر تبدیلی کے بعد مسلسل چلنے کا pattern ثابت نہیں ہوا۔ سیدھا ہر PR پر جانا embedded اور chained گھر چھوڑ دیتا ہے، جہاں check پہلے آپ کے کام پر خود کو ثابت کرتی ہے۔ ٹیم کے PRs کی gate بننے کے بعد اس کی ہر درستگی پوری ٹیم کو دکھائی دے گی۔ وہی سیڑھی: نگرانی کے بعد غیر حاضر، ذاتی کے بعد ٹیم۔جواب دکھائیں
حصہ 4: runs کے درمیان memory (ریڑھ کی ہڈی)
12. runs کے درمیان زندہ رہنے والی state
یہ رہا وہ حصہ جسے نوآموز چھوڑ دیتے ہیں، اور یہی وہ ہے جو لوپ کو لوپ بناتا ہے۔ ماڈل runs کے درمیان سب کچھ بھول جاتا ہے۔ اگر ہر دھڑکن صفر سے شروع ہو، تو آپ کے پاس لوپ نہیں — آپ کے پاس وہی پہلا قدم ہے، ہمیشہ کے لیے دہراتا ہوا۔ حل سادہ اور طاقتور ہے: state کو ماڈل سے باہر، disk پر رکھیں۔
save file کے بغیر ایجنٹ ہر run میں انہی spikes پر ختم ہو جاتا ہے۔ پھر یہ save کرتا ہے، اور switch آپ کے ہاتھ میں آ جاتا ہے۔ آن ہو تو فائل پڑھ کر منزل تک پہنچتا ہے۔ آف ہو تو بھول کر پھر آغاز سے چلتا ہے۔
یہ کھیل عین اسی تصور کو دکھاتا ہے۔ ایجنٹ runs کے درمیان سب کچھ بھولتا ہے، اس لیے disk پر save file رکھتا ہے، اور یہی فائل ریڑھ کی ہڈی ہے۔ آغاز کے بجائے checkpoint سے واپس آنا آپ کی progress file (progress.md) ہے: کیا مکمل ہوا اور کیا باقی ہے، تاکہ اگلا run صفر سے شروع کرنے کے بجائے وہیں سے آگے بڑھے۔ اس کا محفوظ کیا ہوا «آگے spikes ہیں» نوٹ آپ کی rules file (CLAUDE.md / AGENTS.md) ہے: ایک بار سیکھا ہوا سبق، تاکہ وہی غلطی دوبارہ نہ ہو۔ اسی لیے switch اہم ہے۔ فائلوں کے ساتھ لوپ ہر run پر بہتر بنیاد سے بنتا ہے۔ ان کے بغیر وہ ہمیشہ start line پر اجنبی رہتا ہے۔ ہر run یہ فائلیں پہلے پڑھتا اور آخر میں اپڈیٹ کرتا ہے، کیونکہ repo وہ یاد رکھتا ہے جو ماڈل نہیں رکھ سکتا۔
state کی دو پرتیں، ساتھ مل کر کام کرتیں:
- Rules file (
CLAUDE.md/AGENTS.md) — مستقل عادتیں جنہیں لوپ ہر run پر پڑھتا ہے۔ (اسے مختصر رکھیں؛ آپ نے پچھلے کورس میں وجہ سیکھ لی تھی۔ ایک پھولی ہوئی rules file کی قیمت ہر دھڑکن پر ادا ہوتی ہے۔) - ایک progress file — ایک سادہ markdown فائل (یا MCP کے ذریعے کوئی Linear board) جو ریکارڈ رکھتی ہے کہ کیا آزمایا گیا، کیا pass ہوا، کیا اب بھی کھلا ہے۔ یہی اصل ریڑھ کی ہڈی ہے۔ کل کا صبح 9 بجے والا run اسے کھولتا ہے اور وہیں سے اٹھاتا ہے جہاں آج کا run رکا تھا۔
عادت: ہر run آغاز میں progress file پڑھتا ہے اور آخر میں اسے اپڈیٹ کرتا ہے۔ جب لوپ بار بار وہی غلطی کرے، تو حل کوئی زیادہ ذہین prompt نہیں — بلکہ یہ ہے کہ لوپ سے سبق rules file میں لکھوایا جائے، تاکہ fix ہر آنے والے run کے لیے قائم رہے۔
اگر state کی دو پرتیں مجرد لگیں تو ایک نئے انٹرن کا تصور کریں۔ آپ اسے ایک بار context دیتے ہیں: workflow، ticket board، کون سے کام اٹھا سکتا ہے، اور کب آپ سے پوچھنا ہے۔ پھر ایک ڈائری اور دو مستقل ہدایات دیتے ہیں۔ پہلی: feedback ملتے ہی سبق ڈائری کے اگلے حصے میں لکھو، اور ہر صبح دوبارہ پڑھو۔ مثلا «یہ design pattern استعمال نہ کرو»، «یہ ٹیم commits squash کرتی ہے»، «کچھ دکھانے سے پہلے ہمیشہ linter چلاؤ»۔ دوسری: گھر جانے سے پہلے پچھلے حصے میں لکھو کہ کیا مکمل کیا اور کہاں رکے، تاکہ اگلا دن صفر کے بجائے وہیں سے شروع ہو۔ ڈائری کا اگلا حصہ rules file ہے: دیرپا سبق، ہر run میں پڑھا جاتا ہے۔ پچھلا حصہ progress file ہے: checkpoints، ہر run میں اپڈیٹ ہوتے ہیں۔ ڈائری کے بغیر انٹرن وہی corrections دوبارہ سیکھتا اور کل کا کام پھر کرتا ہے۔ لوپ بھی یہی کرتا ہے، بلکہ ماڈل کی memory تو runs کے درمیان پوری صاف ہو جاتی ہے۔ ڈائری سہولت نہیں، ملازم اور روز آنے والے اجنبی کے درمیان فرق ہے۔
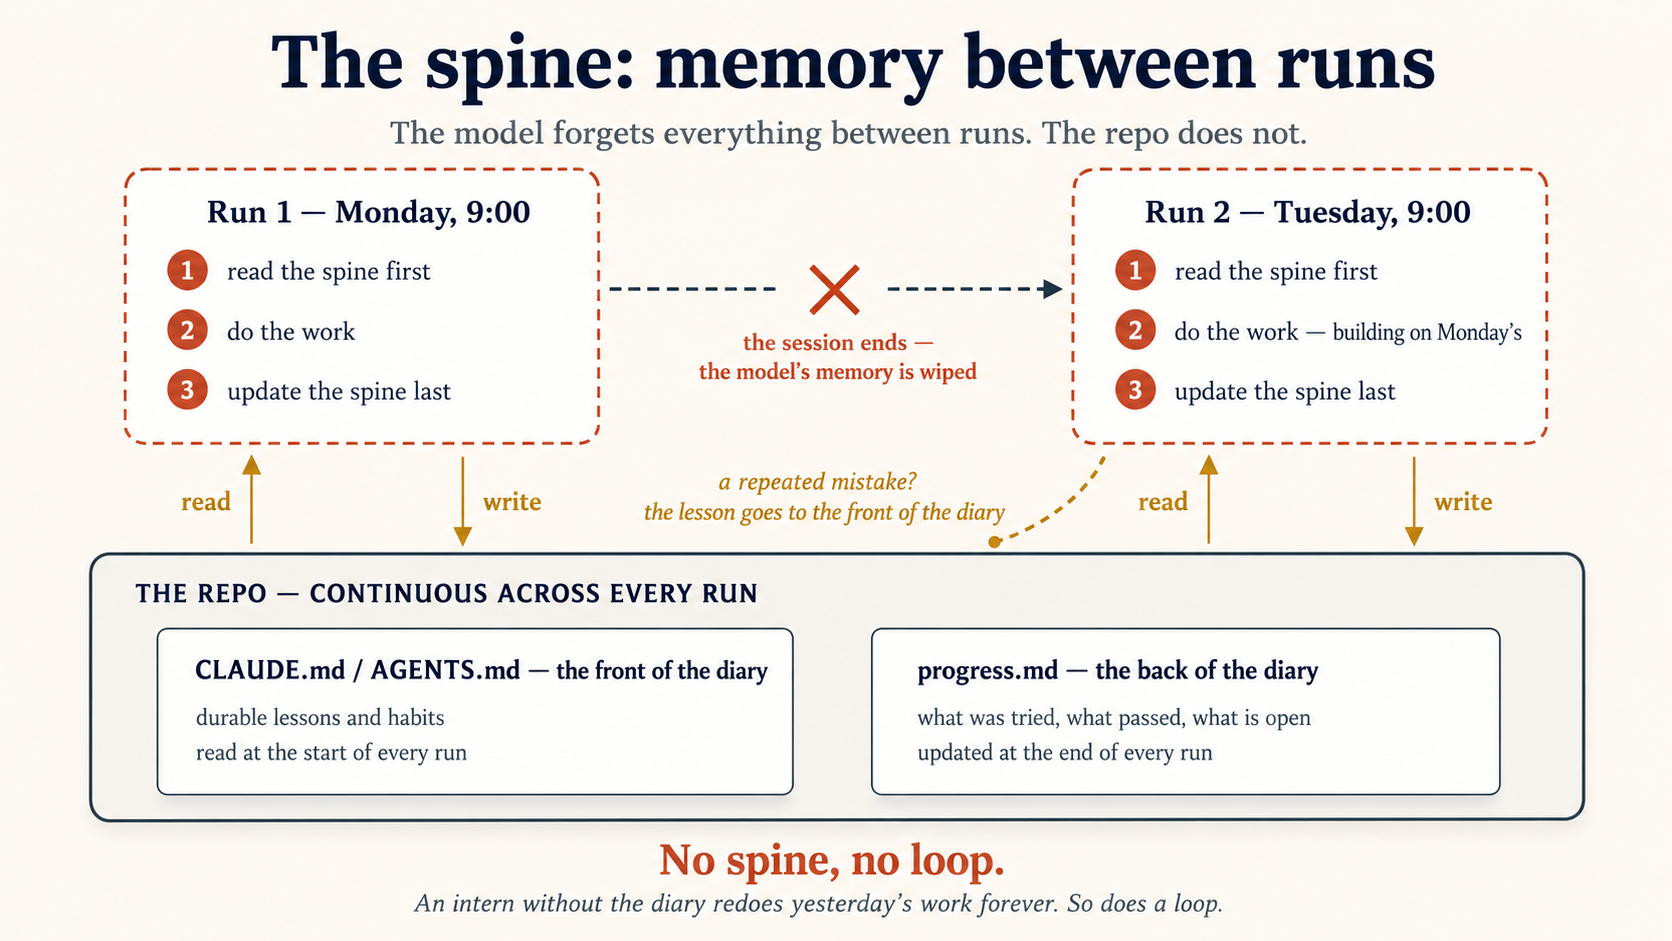
<!-- progress.md — the loop's memory between runs -->

## Done

- 2026-06-22: fixed flaky test in test/auth (retry on token refresh)

## In progress

- Dependency audit: 3 of 7 advisories patched; lodash bump blocked by an API change

## Open / needs a human

- CVE-2026-xxxx in image lib — the fix changes the output format, escalating to a maintainer
چونکہ progress file آپ کے repo میں محض text ہے، یہ اس کام کا ریکارڈ بھی بن جاتی ہے جو لوپ نے آپ کی غیر موجودگی میں کیا۔ جب آپ انسانی gate پر بیٹھتے ہیں، تو آپ ریڑھ کی ہڈی پڑھتے ہیں — ہر run کا پورا transcript نہیں۔
ریڑھ کی ہڈی کی قدر تب واضح ہوتی ہے جب لوپ کو واقعی بھولتے دیکھیں۔ Paper Watch ہر روز آپ کے منتخب موضوع پر نئی research papers دکھاتا ہے، مگر صرف وہ جو پہلے نہیں دکھائے گئے۔ کچھ انسٹال نہیں کرنا اور key بھی نہیں چاہیے؛ Claude خود arXiv سے مواد لیتا ہے۔
repo clone کریں، folder ایجنٹ میں کھولیں، اور کہیں:
show me what's new on arXiv about "LLM agents"
نئی papers تازہ ترین ترتیب میں ملیں گی۔ اب بالکل وہی بات دوبارہ کہیں، اور جواب آئے گا: "nothing new since last run ✓"۔ لوپ نے ہر دکھائی گئی paper کو progress.md میں لکھا اور اگلی بار فائل پڑھی۔ یہی spine ہے۔ ثبوت کے لیے memory حذف کر کے پھر پوچھیں:
rm progress.md
show me what's new on arXiv about "LLM agents"
تمام papers پھر «نئی» بن جائیں گی۔ آپ نے لوپ کی پوری memory مٹا دی: spine نہیں، loop نہیں۔ اسے روزانہ watch بنانے کے لیے تصور 6 کی heartbeat دیں: /schedule every weekday at 9am, run the paper-watch skill and show me what's new۔ arXiv تقریبا روز refresh ہوتا ہے، اس لیے روزانہ run مناسب rhythm ہے۔
اسے تصور 6 کے Sky Watch کے ساتھ رکھیں۔ دونوں daily Routines ہیں۔ Sky Watch ہر run میں آج کے asteroids دوبارہ دکھاتا ہے اور اسے memory نہیں چاہیے؛ Paper Watch صرف نیا مواد دکھاتا ہے اور spine کے بغیر چل ہی نہیں سکتا۔ ایک heartbeat، مگر memory کی بالکل الٹ ضرورت۔ یہی فرق بتاتا ہے کہ لوپ کو memory کب چاہیے۔
اختیاری پس منظر، پہلی reading میں چھوڑ سکتے ہیں۔
اس کورس کی spine disk پر plain markdown ہے۔ یہ beginner کے لیے سادہ کیا گیا عارضی حل نہیں۔ ایک سال کے متبادل آزمانے کے بعد Anthropic کی memory engineering بھی یہیں پہنچی:
- پہلے rules file (
CLAUDE.md) آئی، جو ہر session کے آغاز میں شامل ہوتی ہے۔ مؤثر تھی مگر پھولتی گئی، اور ہر run میں اس کا خرچ ہوتا ہے۔ - پھر in-session memory tools آئے، جن میں ایجنٹ خود طے کرتا تھا کہ کب یادداشت پڑھے یا لکھے۔ autonomy مفید تھی، tooling بہت opinionated تھی۔
- Skills نے growth حل کی: ایجنٹ پہلے مختصر description پڑھتا ہے اور مکمل body صرف ضرورت پر لوڈ کرتا ہے۔
- موجودہ best practice سب سے سادہ ہے: memory کو plain file system سمجھیں۔ folders میں Markdown files، اور انہیں
grepیا shell جیسے عام tools سے تلاش کریں، کسی خاص memory API سے نہیں۔
یہی spine ہے: repo میں files، شروع میں read، آخر میں update، عام tools سے search۔ جب frontier lab کا production جواب اور beginner کا پہلا loop ایک design استعمال کریں تو design بوجھ اٹھانے والا ہے، training wheels نہیں۔
اختیاری technical detail، پہلی reading میں چھوڑ سکتے ہیں۔
اوپر rules-file کی عادت دکھنے سے بڑی ہے۔ جب لوپ ایک سبق CLAUDE.md میں لکھتا ہے تاکہ ہر آئندہ run بہتر ہو تو آپ ہاتھ سے وہ کام کر رہے ہیں جسے hill-climbing loop کہتے ہیں۔ اس کا output خود کام نہیں؛ اس کا output کام کرنے والے system کی بہتری ہے۔
خودکار شکل یوں کام کرتی ہے۔ ہر run ایک trace چھوڑتا ہے۔ ایک قدم traces پڑھ کر بار بار ہونے والی غلطیاں ڈھونڈتا ہے۔ findings پھر prompt، tools یا checker کے rules بدلتی ہیں۔ مختصر یہ کہ loop اپنے گرد موجود system کو edit کرتا ہے۔
LangChain چار loop تہیں بیان کرتا ہے: agent کا tool cycle، checking loop، event-driven loop، اور اوپر improvement loop۔ swyx انہیں stack کرنے کو loopcraft کہتا ہے۔ پہلے تین اسی کورس کے inner loop، maker-checker اور heartbeat ہیں، صرف نام مختلف ہیں۔ صنعت بار بار اسی شکل تک پہنچتی ہے؛ یہ مضبوط evidence ہے کہ skill tool نہیں، shape ہے۔
ایک فرق اس سب کو ایماندار رکھتا ہے: یہ model کا سیکھنا نہیں۔ آج کوئی public model آپ کے sessions کی بنا پر اپنے weights نہیں بدلتا۔ کل چلنے والا model عین آج والا model ہے۔ بہتر اس کے گرد موجود چیزیں ہوتی ہیں: rules file، skills، checker rubric اور prompt۔ کچھ لوگ پہلی چیز کو self-learning اور دوسری کو self-improving کہتے ہیں۔ اس کورس کا ہر loop دوسری قسم ہے، اور spine اسی لیے کام کرتی ہے: سبق disk پر زندہ رہتا ہے کیونکہ model میں نہیں رہ سکتا۔ disappointing run کے بعد بھی یہی فرق دکھتا ہے۔ beginner کا ردعمل اگلے دن بہتر prompt ہے، پھر صفر سے آغاز، اس لیے کچھ carry نہیں ہوتا۔ loop کا ردعمل ہے: run، log، سبق نکالنا، system میں لکھنا، پھر run۔ memory بنتی، system sharp ہوتا، اور gains run بہ run جمع ہوتے ہیں۔
شروع کرنے کو خاص platform نہیں چاہیے۔ ایک ہفتے کے progress.md entries پڑھیں اور ایک سوال پوچھیں: «rules file میں کیا لکھوں کہ اس قسم کی غلطی دوبارہ نہ ہو؟» یہی خیال human speed پر ہے۔ ایک warning، Part 6 کے باقی ہر مقام جیسی: ایسا improvement loop جسے آپ کبھی نہ پڑھیں اپنے rules کسی کی نگرانی کے بغیر دوبارہ لکھ رہا ہے۔ خود loop کی تبدیلی بھی human gate کی مستحق ہے۔
اختیاری technical detail، پہلی reading میں چھوڑ سکتے ہیں۔
Anthropic کی applied AI ٹیم hill-climbing loop کی managed صورت کو dreaming کہتی ہے۔ یہ working agents کے آرام کے دوران چلتی ہے اور ان کی سیکھی ہوئی باتوں کو صاف اور منظم کرتی ہے۔
live session کے اندر memory work کو in-band کہتے ہیں۔ یہ کام کرتا ہے، مگر agent کو موجودہ task اور future runs کی memory کے درمیان attention بانٹنی پڑتی ہے، اور وہ صرف اپنا session دیکھتا ہے۔ دس sessions یا دس agents میں دہرائی جانے والی غلطی اسے نظر نہیں آتی۔
Dreaming out-of-band جواب ہے۔ اس کی اپنی heartbeat اور token budget ہوتا ہے۔ ہر beat میں:
- memory store اور حالیہ run transcripts جمع ہوتے ہیں، tool calls سمیت۔
- orchestrator transcripts کو analyst subagents میں تقسیم کرتا ہے۔
- وہ sessions میں دہرائے جانے والے patterns ڈھونڈتے ہیں۔
- memory store میں تبدیلیاں evidence کے ساتھ تجویز ہوتی ہیں۔
- ہر تبدیلی لاگو ہونے سے پہلے انسان قبول یا رد کرتا ہے۔
اس فہرست کو کورس کی زبان میں پھر پڑھیں۔ batch schedule heartbeat، memory store spine، transcript analysts subagents، اور evidence والی proposal کے بعد انسانی فیصلہ maker-checker ہے جس کے اوپر human gate موجود ہے۔ dreaming کوئی نئی شکل نہیں؛ وہی چھ حصوں والا loop ہے جو code کے بجائے اپنی memory پر کام کرتا ہے۔ talk میں اس کی تصویر school ہے: students، یعنی working agents، کام کرتے ہیں؛ head teacher، یعنی dreaming pass، تمام marked papers پڑھتا، دیکھتا ہے کہ ہر class ایک ہی سوال میں ناکام ہوئی، اور curriculum درست کرتا ہے۔ اگلے دن ہر student بہتر ہے اور کسی نے class time اس کام پر خرچ نہیں کیا۔
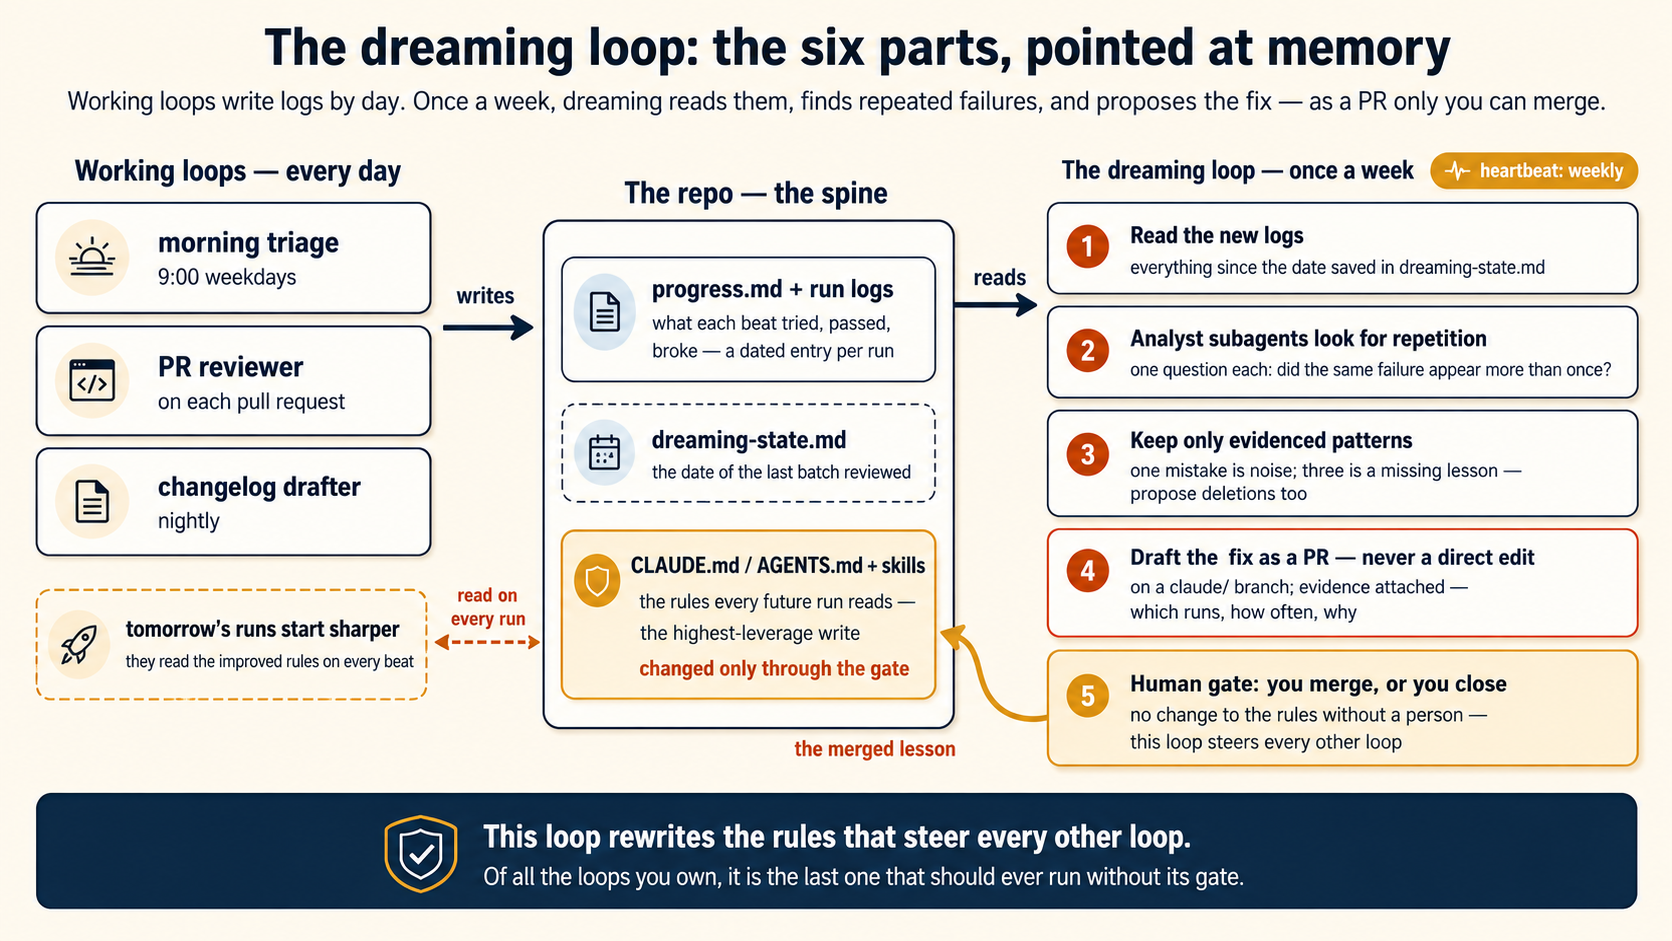
دو انتباہ اہم ہیں۔ Memories باسی ہو جاتی ہیں، اس لیے prune کرنا ضروری ہے۔ اور shared memory store کو production guardrails چاہییں، جن کا ذکر تصور 14 میں ہے۔
اپنے tools پہلے دیکھیں، کیونکہ اس کی ایک شکل پہلے سے ship ہو رہی ہے۔ Claude Code کا research-preview feature Auto Dream ہے۔ کام کے دوران Claude Code خاموشی سے project کے notes لکھتا ہے۔ کئی sessions میں duplicates جمع اور پرانے facts نئے، متضاد facts کے ساتھ پڑے رہتے ہیں۔ Auto Dream صفائی کرنے والا ہے: sessions کے درمیان background میں چل کر duplicates merge کرتا، نئی work سے غلط ثابت notes حذف کرتا، اور صرف memory files میں لکھ سکتا ہے، code میں کبھی نہیں۔ دستیابی دیکھنے کے لیے session میں /memory چلائیں اور Auto-dream toggle دیکھیں۔ ہاتھ سے pass چلانے کے لیے کہیں «consolidate my memory files»۔ OpenClaw اسی نوع کا opt-in /dreaming system دیتا ہے، اور OpenCode users کو community alternatives ملتی ہیں۔ ہمیشہ کی طرح یہ mechanical layer ہے؛ live docs دیکھیں۔
بھروسے سے پہلے ایک warning۔ cleaner پرانے notes کے مقابلے میں نئے evidence پر بھروسہ کرتا ہے، اس لیے آپ کا ہاتھ سے لکھا note بھی rewrite یا delete کر سکتا ہے۔ یہ rule رکھیں: جس rule کو کبھی touch نہ ہونے دینا ہو اسے CLAUDE.md میں رکھیں، وہ file جس پر صرف آپ کا control ہے۔ auto-managed notes Claude کی notebook ہیں؛ CLAUDE.md آپ کی ہے۔
دونوں ملتے جلتے jobs کا فرق بھی واضح رکھیں۔ Auto Dream صفائی، یعنی notes کی hygiene، کرتا ہے۔ نیچے والا loop بہتری کرتا ہے: بار بار ہونے والی غلطی ڈھونڈ کر اسے روکنے والا نیا rule تجویز کرتا ہے۔ ایک cleaner، ایک coach۔ شکل ایک، job مختلف؛ coach خود بنانا مفید ہے، کیونکہ ہر part آپ جانتے ہیں:
- Heartbeat: ہفتہ وار، روزانہ نہیں۔ dreaming runs کے درمیان patterns دیکھتی ہے، اس لیے دیکھنے کو batch چاہیے۔ weekly cloud Routine، weekly
cronیا GitHub Actions schedule درست cadence ہے۔ daily patterns دیکھنے کے لیے بہت جلد ہے اور بے وجہ cost بڑھاتی ہے (تصور 13)۔ - Input: loops سے readable transcripts چھڑوائیں۔ یہی prerequisite ہے۔ working loops observability habit کے مطابق ہر beat کی dated
progress.mdentry اور repo میں run logs چھوڑیں۔ OpenCode میںopencode run --format jsonاورopencode exportمکمل record دیتے ہیں؛ Claude Code میں ہر Routine اپنا outcome committed log file میں append کرے۔ logs نہیں تو dream کرنے کو کچھ نہیں۔ - Body: orchestrator اور analyst subagents۔ dreaming prompt پچھلے run کے بعد کا log batch پڑھتا ہے۔ بڑے batch میں subagents حصے لیتے اور ایک سوال پوچھتے ہیں: کیا ناکام ہوا، اور کیا وہی failure ایک سے زیادہ بار آئی؟ ایک غلطی noise ہے؛ تین بار وہی غلطی missing lesson۔
- Maker-checker، دو بار۔ analysts propose کرتے، orchestrator صرف کافی evidence والے patterns رکھتا ہے۔ پھر اصل checker: loop rules file یا skill براہ راست edit کبھی نہیں کرتا۔ وہ
claude/branch پر change draft اور PR کھولتا ہے؛ description میں evidence ہوتا ہے کہ کن runs میں pattern آیا، کتنی بار، اور یہ line کیوں روکے گی۔ - Human gate: آپ merge یا close کریں۔
CLAUDE.mdیا skill کی تبدیلی پورے system کی highest-leverage write ہے، کیونکہ ہر future loop run اسے پڑھتا ہے۔ عین اسی جگہ gate چاہیے: مہنگی، واپس لینا مشکل، اس لیے انسان فیصلہ کرے۔ - Dreaming loop کی اپنی spine۔
dreaming-state.mdجیسی چھوٹی state file آخری reviewed batch کی date رکھتی ہے، تاکہ اگلے ہفتے پوری history پھر dream کرنے کے بجائے صرف نئے logs پڑھے جائیں۔
اس design میں کئی چیزیں مفت ملتی ہیں۔ store git میں ہو تو versioning اور rollback کی cost نہیں۔ تمام rule changes PRs سے آتی ہیں، اس لیے permission سادہ ہے: آپ کے سوا کوئی merge نہیں۔ staleness کا فطری مقام بھی ہے: dreaming prompt deletions بھی تجویز کرے، یعنی وہ rules جن کی کسی recent run کو ضرورت نہ تھی یا جنہیں current logs contradict کرتے ہیں۔ صرف بڑھتی memory ایسی rules file ہے جس کی cost ہر beat پر دیتے اور ہر مہینے کم trust کرتے ہیں۔
یہ حملہ دھو کر مستقل rule بنا سکتا ہے۔ dreaming pass کے transcripts میں outsiders کا لکھا text ہوتا ہے: issue bodies، PR descriptions، اور loop کے fetched pages۔ security researchers اسے memory poisoning کہتے ہیں: ایک run کے input میں planted instruction memory میں لکھ کر اصل attack ختم ہونے کے بہت بعد ہر future run کو steer کرتی ہے۔ dreaming pass عین وہ machine ہے جو one-time injection کو permanent rule بنا سکتی ہے۔ یہ dreaming چھوڑنے کی وجہ نہیں، بلکہ design کے پہلے سے موجود دو rules کی وجہ ہے۔ evidence ہمیشہ: proposal اپنے source runs cite کرے تاکہ lesson پر trust سے پہلے source پڑھ سکیں۔ human gate ہمیشہ: review bypass کرنے والی rule change وہ write ہے جو attacker سب سے زیادہ چاہتا ہے۔ یہی pass آپ کے حق میں بھی کام کرتی ہے، کیونکہ rules file کی weekly reading ایسی line پکڑنے کا بہترین موقع ہے جسے آپ نے approve نہیں کیا۔
یہ اپنی memory کو گھسا سکتا ہے۔ repeated memory rewriting کے studies میں دو failure patterns ملے۔ Brevity bias general point رکھ کر specifics گرا دیتا ہے، مثلا «response payload check کریں، status code نہیں» بدل کر «errors handle کریں» رہ جاتا ہے۔ Context collapse میں ہر full rewrite پچھلے کی lossy copy ہے، یہاں تک کہ detailed playbook مبہم paragraph بن جاتا ہے۔ دفاع وہی ہے جو loop پہلے استعمال کرتا ہے: چھوٹے diffs تجویز کریں، کبھی full rewrite نہیں۔ store git میں ہو تو سکڑتی rules file diff میں دکھتی ہے اور آپ اسے روک سکتے ہیں۔ ایک چھوٹی عادت decay کی پوری قسم روکتی ہے: memory file میں relative date کبھی نہ ہو۔ «کل Redis چنا» چھ ہفتے بعد بے معنی ہے۔ ہر consolidation pass «کل» کو اصل date میں بدلے، اور loops ابتدا ہی سے absolute dates لکھیں۔
ایک اور honest limit: dream کو material چاہیے۔ تین runs کی history یا throwaway project میں pattern نہیں، اور pass noise سے plausible-sounding lessons بنا دے گی۔ حقیقی mileage والے loops پر چلائیں، اور نتیجہ سستے طریقے سے جانچیں: مؤثر lesson وہ failure ہے جو اگلے ہفتے کے logs میں دوبارہ نہ آئے۔
اوپر improvement-loop note والی warning پھر: یہ loop باقی ہر loop کو steer کرنے والے rules دوبارہ لکھتا ہے۔ آپ کے تمام loops میں یہی آخری ہے جسے کبھی gate کے بغیر چلنا چاہیے۔
Anthropic managed version کو Managed Agents memory tooling میں ship کرتا ہے۔ course میں ہر جگہ کی طرح یہ mechanical layer ہے: کسی product detail پر rely کرنے سے پہلے live platform docs دیکھیں۔ مستقل layer shape ہے، اور اسے آپ دو paragraphs پہلے خود بنا چکے ہیں۔
لوپ کو اب تک جو کیا اسے کہاں رکھنا چاہیے، اور گفتگو میں کیوں نہیں؟ disk پر — ایک progress file (نیز rules file)، یا Linear جیسا board۔ ماڈل کی memory runs کے درمیان مٹ جاتی ہے، تو جو کچھ زندہ رہنا ہو وہ ماڈل سے باہر رہتا ہے۔ repo یاد رکھتا ہے؛ ماڈل نہیں۔جواب دکھائیں
حصہ 5: ایک مکمل loop، دو بار
کسی بھی لوپ کو خود سے چلنے دینے سے پہلے، اسے ان ساتوں کی ضرورت ہے۔ وہ لوپ جو آپ ابھی بنانے والے ہیں ان میں سے ہر ایک رکھتا ہے:
- Success condition — یہ کیسے جانتا ہے کہ کام ہو گیا (تصور 5)۔
- Ceiling — زیادہ سے زیادہ کوششیں، منٹ، یا خرچ، تاکہ یہ ہمیشہ نہ چلتا رہے (تصور 13)۔
- علیحدہ branch یا worktree — تاکہ متوازی کام نہ ٹکرائے (تصور 8)۔
- Read-only checker — ایک علیحدہ ایجنٹ جو grade کرتا ہے مگر edit نہیں کر سکتا (تصور 11)۔
- State file — ریڑھ کی ہڈی، تاکہ یہ runs کے درمیان یاد رکھے (تصور 12)۔
- انسانی gate — خطرناک یا ناکام کام کسی شخص کے پاس جاتا ہے، کبھی سیدھا
mainپر نہیں (حصہ 5)۔ - ایک log یا notification — تاکہ رات بھر کی کوئی ناکامی نظر آئے، خاموش نہ رہے (حصہ 6)۔
ایک بھی چوک جائے اور لوپ غیر محفوظ، بھلکڑ، یا غیر مرئی ہے۔
اب حصوں کو جوڑیں۔ یہ رہا ایک لوپ — ایک صبح کا maintenance لوپ جو رات بھر کی CI failures چھانٹتا ہے، محفوظ fixes draft کرتا ہے، انہیں جانچواتا ہے، محفوظ والوں کے لیے PRs کھولتا ہے، اور باقی کو flag کرتا ہے — ہر ٹول میں ایک بار بنایا گیا۔ نیچے دی گئی فائلیں حقیقی ہیں؛ آپ انہیں کسی repo میں copy کر کے چلا سکتے ہیں۔
لوپ کی ساخت (دونوں میں ایک جیسی):
- Heartbeat: ہر working day صبح 9 بجے۔
- Skill: ایک
daily-triageskill قدم رکھتا ہے، تو prompt ایک لائن رہتا ہے۔ - Spine: آغاز میں
progress.mdپڑھیں، آخر میں اسے اپڈیٹ کریں۔ - Worktree: ہر fix اپنے checkout میں draft ہوتا ہے۔
- Maker–checker: ایک implementer draft کرتا ہے؛ ایک علیحدہ reviewer PASS یا FAIL کہتا ہے۔
- Connector: PASS کے لیے PR کھولیں؛ FAIL یا کسی بھی خطرناک چیز کے لیے، اسے "needs a human" میں لکھیں اور رک جائیں۔
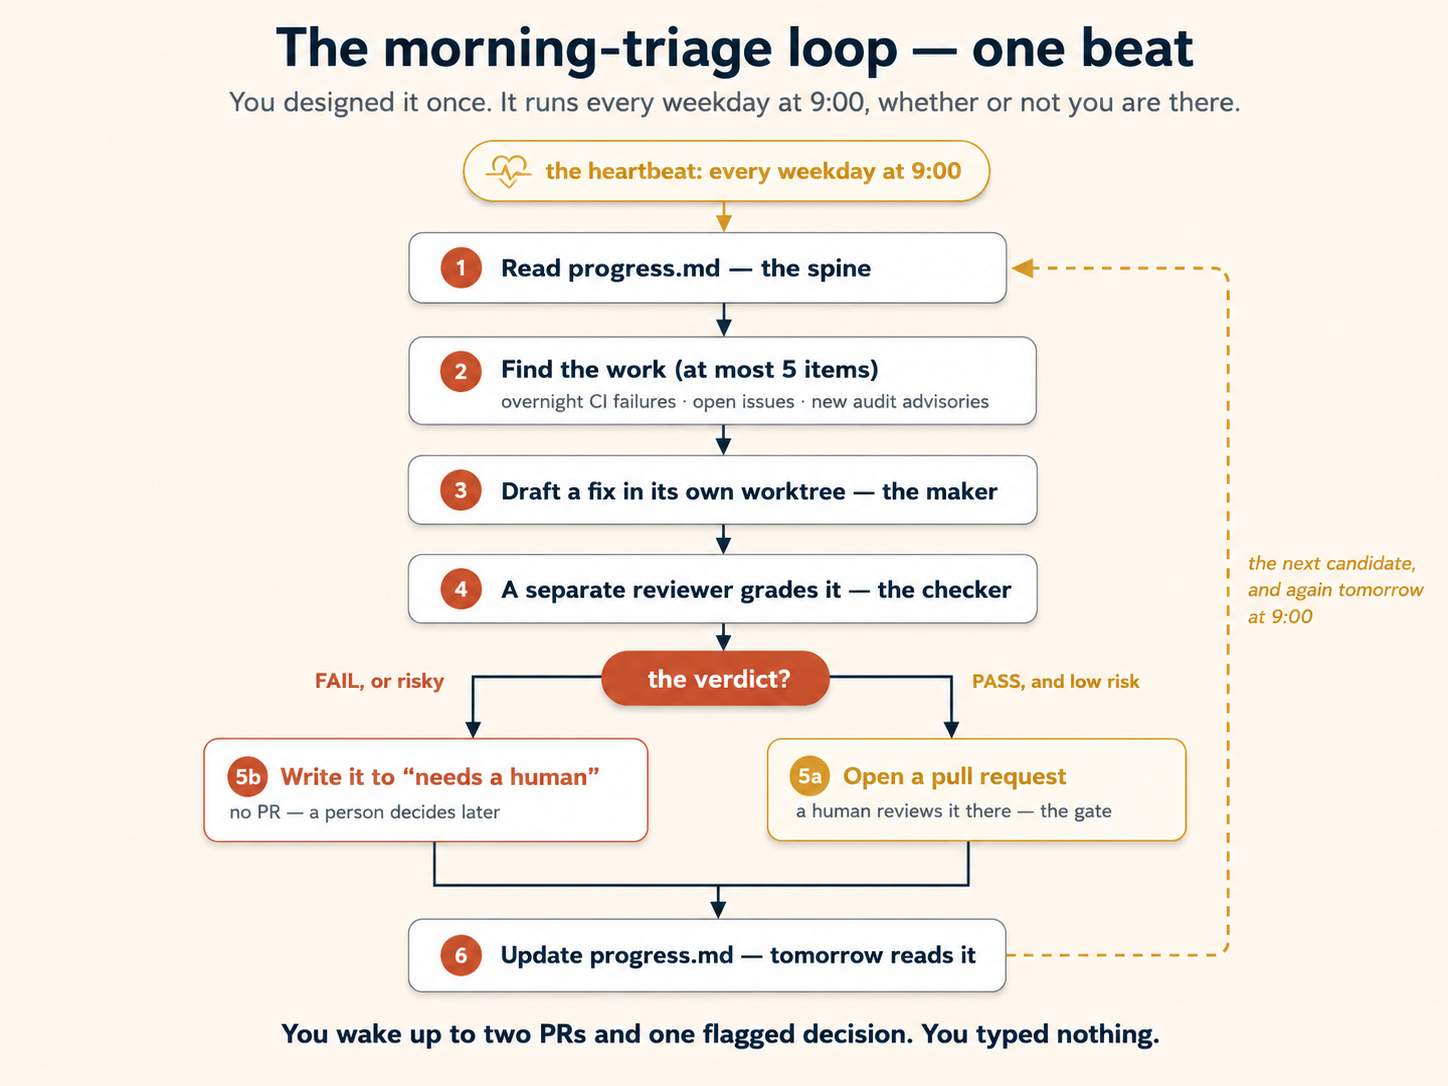
مشترکہ skill
یہ ایک فائل دونوں ٹولز میں کام کرتی ہے۔ اسے .claude/skills/daily-triage/SKILL.md (Claude Code) یا .opencode/skills/daily-triage/SKILL.md (OpenCode) کے طور پر محفوظ کریں۔
---
name: daily-triage
description: >-
  Runs the morning maintenance pass. Reads the progress file, gathers overnight
  CI failures, open issues, and new audit advisories, drafts safe fixes (each
  one checked by a separate reviewer agent), opens pull requests for what passes,
  and writes anything risky to the progress file for a human. Use this for the
  scheduled morning maintenance loop.
---

# Daily triage

You are the morning maintenance loop. Work through these steps in order.
Do not skip the progress file. It is your only memory between runs.

## 1. Read your memory first

- Open `progress.md`. Read the "In progress" and "Open / needs a human" sections.
- Do not redo anything already listed under "Done".

## 2. Find the work

Gather candidates in this order, and stop once you have at most 5:

1. CI runs that failed since the last entry in `progress.md`.
2. Open issues labelled `bug` or `maintenance`.
3. New advisories from `npm audit` (or this project's audit command).

## 3. Work each candidate

- Create an isolated checkout: a git worktree, or a fresh branch named
  `claude/<short-slug>`.
- Draft the smallest fix that solves the one problem. Do not bundle changes.
- Send the diff to the reviewer agent. Wait for its verdict before going on.

## 4. Decide from the verdict

- PASS, and the change is low risk (no public API change, no data migration,
  no file deletion): open a pull request. Title it `fix: <one short line>` and
  link the issue.
- FAIL, or the change touches anything risky: do NOT open a pull request. Add a
  short entry to the "Open / needs a human" section of `progress.md`. Say what
  you tried and why you stopped.

## 5. Update your memory last

- Move finished items to "Done" with today's date.
- Save `progress.md`. This is the file tomorrow's run will read.

## Rules

- Never open more than 5 pull requests in one run.
- Never change `main` directly. Only `claude/*` branches.
- When in doubt, escalate. A flagged item a human checks is always safer than a
  wrong fix shipped while no one was watching.
reviewer (checker)
reviewer عملی طور پر maker–checker تقسیم ہے۔ آپ کو دونوں فائلیں چاہئیں — یہ کوئی "یا یہ یا وہ" ٹول کا انتخاب نہیں۔ format ہر ٹول میں ذرا مختلف ہے، تو ہر ایک نیچے مکمل دکھائی گئی ہے۔
Claude Code — .claude/agents/reviewer.md کے طور پر محفوظ کریں:
---
name: reviewer
description: Reviews a diff against the spec and the test results. Replies PASS or FAIL with reasons. Makes no changes.
tools: Read, Bash
model: claude-haiku-4-5-20251001
---

You are a strict, read-only code reviewer. You never edit files.

1. Run the tests and the linter. Read the output yourself. Do not trust a claim
   that they pass.
2. Check the change against the project conventions in `CLAUDE.md` and the
   relevant spec.
3. Look for bugs, missing edge cases, security risks, and any change to public
   behaviour.

Then reply with exactly one of:

- `PASS` — followed by one line saying what you verified.
- `FAIL` — followed by the specific reasons, one per line.

A change that only "looks fine" is not a PASS. The tests must actually pass, and
the change must do only what was asked.
tools والی line کے بارے میں ایک صاف بات: یہ صرف tool names لیتی ہے (Read، Bash)، اس لیے reviewer کو صرف test، lint اور diff commands تک محدود نہیں کر سکتی۔ ابھی یہ حد numbered instructions سنبھالتی ہیں۔ اگلا کورس Harness Engineering اسے نافذ کرنے والا rule شامل کرتا ہے۔ reviewer جن checks کے خلاف grade کرتا ہے، ضروری نہیں کہ وہ اسی prompt میں ہوں۔ verification-skills interlude دکھاتا ہے کہ ہر check کو الگ skill کیسے بنائیں، تاکہ reviewer اور /goal checker ایک ہی file کے خلاف grade کریں۔
OpenCode — .opencode/agents/reviewer.md کے طور پر محفوظ کریں:
---
mode: subagent
model: anthropic/claude-haiku-4-5-20251001
description: Reviews a diff against the spec and tests. Replies PASS or FAIL with reasons. Read-only.
permission:
  edit: deny
  bash:
    "*": deny
    "npm test*": allow
    "npm run lint*": allow
    "git diff*": allow
---

You are a strict, read-only code reviewer. You never edit files.

1. Run the tests and the linter. Read the output yourself. Do not trust a claim
   that they pass.
2. Check the change against the project conventions in `AGENTS.md` and the
   relevant spec.
3. Look for bugs, missing edge cases, security risks, and any change to public
   behaviour.

Reply with exactly one of:

- PASS — followed by one line saying what you verified.
- FAIL — followed by the specific reasons, one per line.

A change that only "looks fine" is not a PASS. The tests must actually pass, and
the change must do only what was asked.
schedule سے loop شروع کرنا
claude.ai/code/routines پر ایک Routine بنائیں جس میں working day صبح 9 بجے کا schedule، آپ کا repo، اور آپ کے GitHub + Slack connectors ہوں۔ اس کا prompt skill کی طرف موڑ دیں، تو routine کی تعریف چھوٹی رہتی ہے:
Run the daily-triage skill.
Start by reading progress.md; finish by updating it.
For each fix: draft it in an isolated worktree, have the reviewer subagent grade it,
open a PR only on PASS, and append anything risky to the "needs a human" section.
قدم skill رکھتا ہے۔ .claude/agents/reviewer.md checker ہے۔ isolation: worktree متوازی fixes کو الگ رکھتا ہے۔ GitHub connector PRs کھولتا ہے۔ چونکہ یہ cloud Routine ہے، یہ صبح 9 بجے چلتا ہے چاہے آپ کا laptop کھلا ہو یا نہیں۔ یہ plan کے daily run cap میں بھی آسانی سے آتا ہے: weekdays پر صبح 9 بجے کا schedule ہفتے میں پانچ runs ہے، اس لیے Pro کی روزانہ پانچ runs کی cap میں کافی گنجائش رہتی ہے؛ ہر چند گھنٹے بعد چلنے والی Routine میں ایسا نہیں ہوگا۔ پہلی بار اسے بناتے وقت environment، connector scoping اور secrets panel کی ہر field Routines appendix میں سمجھائی گئی ہے۔
اسے ایک GitHub Actions workflow کے طور پر بنائیں، تو یہ cloud میں چلتا ہے، آپ کی کسی مشین کے جاگے بغیر۔ Action دھڑکن ہے؛ opencode run worker ہے؛ آپ کا repo skill، agents، اور progress.md رکھتا ہے۔
name: morning-maintenance
on:
  schedule:
    - cron: "0 9 * * 1-5"
jobs:
  triage:
    runs-on: ubuntu-latest
    permissions: { contents: write, pull-requests: write, issues: write }
    steps:
      - uses: actions/checkout@v6
        with: { persist-credentials: false }
      - uses: anomalyco/opencode/github@latest
        env: { ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }} }
        with:
          model: anthropic/claude-sonnet-5   # confirm with `opencode models`
          prompt: |
            Run the daily-triage skill.
            Read progress.md first; update it last.
            For each candidate fix: draft it on a new branch, then invoke the
            @reviewer subagent to grade it. Open a PR only when the reviewer
            replies PASS. Append anything risky to the "needs a human" section
            of progress.md and leave it for the maintainer.
reviewer ایجنٹ (ایک سستے read-only ماڈل پر) checker ہے۔ CI میں نئی branches worktree علیحدگی کا کام کرتی ہیں۔ OpenCode GitHub app PRs کھولتا ہے۔ اسے GitHub کے بجائے اپنی ہی مشین پر چاہتے ہیں؟ بالکل وہی prompt ایک cron لائن سے چلتا ہے جو opencode run کو call کرتی ہے — صرف دھڑکن بدلتی ہے۔
ایک حقیقی صبح کیسی ہوتی ہے
آپ نے اوپر کی ہر چیز ایک بار ڈیزائن کی۔ یہ رہا ایک ہی run، اسی طرح کا جس کے ساتھ آپ جاگیں گے (نیچے دیا گیا run ساخت کی ایک مثال ہے، کوئی recording نہیں):
[09:00] daily-triage fires
  → reads progress.md: 1 item still "in progress" (lodash bump), nothing new flagged
  → finds: 2 CI failures overnight, 1 new npm-audit advisory
  → CI failure #1 (flaky auth test):
        drafts fix on branch claude/fix-auth-retry
        reviewer → PASS (tests green; retries on token refresh; no API change)
        → opens PR #142, links the issue
  → CI failure #2 (type error in report.ts):
        drafts fix on branch claude/fix-report-types
        reviewer → PASS → opens PR #143
  → advisory (image library):
        the safe fix changes the output format
        reviewer → FAIL (public behaviour change)
        → writes it to "Open / needs a human" in progress.md, opens no PR
  → updates progress.md, exits
[you, 09:30] two PRs to review, one flagged item to decide on. You typed nothing.
اوپر کا run animation میں دیکھیں: heartbeat fire ہوتی ہے، loop کام ڈھونڈتا اور ہر fix draft کرتا ہے، پھر الگ reviewer ہر ایک کو PASS یا FAIL grade کرتا ہے۔ محفوظ دو fixes PRs کی صورت میں ship ہوتے ہیں اور خطرناک fix روک دیا جاتا ہے۔ پھر human gate آپ کے پاس آتا ہے، اور وہ ایک فیصلہ آپ کرتے ہیں جسے انسان درکار ہے۔
دیکھیں کیا ہوا۔ لوپ نے کام ڈھونڈا، اسے draft کیا، جانچا، محفوظ حصہ شپ کیا، اور آپ کو صرف وہ ایک فیصلہ سونپا جس کے لیے کسی شخص کی ضرورت تھی۔ یہی عملی طور پر لوپ انجینئرنگ ہے۔ اور غور کریں: دونوں ٹولز کے درمیان واحد حقیقی فرق دھڑکن اور یہ تھا کہ run کہاں ہوا۔ بیچ کی ہر چیز — skill، ریڑھ کی ہڈی، worktree، maker–checker، connector — وہی ڈیزائن تھا۔
صبح کے triage لوپ میں، آپ کے سونے کے دوران کوئی غلط fix merge ہونے سے کیا چیز روکتی ہے؟ تین چیزیں مل کر: reviewer subagent کو PASS واپس کرنا ہوتا ہے (maker–checker)، صرف کم خطرے والی تبدیلیاں ہی PR کھول سکتی ہیں، اور انسانی gate کسی بھی خطرناک یا ناکام چیز کو جواب دکھائیں
main کے بجائے "needs a human" نوٹ میں بھیجتا ہے۔ ہر run capped اور logged بھی ہوتا ہے۔
حصہ 6: انسانی control برقرار رکھنا
ایک لوپ کام بدلتا ہے؛ یہ آپ کو اس سے باہر نہیں کرتا۔ جیسے جیسے آپ کے لوپ بہتر ہوتے ہیں، تین مسئلے بڑے ہوتے ہیں، چھوٹے نہیں۔ یہ حصہ کورس میں سب سے اہم ہے۔
آپ کا لوپ تین لوپوں کے اندر کیسے بیٹھتا ہے
آپ نے ابھی ایک لوپ بنایا ہے۔ اس کے چھ حصے ہیں، اور جیسے ہی یہ شروع ہوتا ہے، یہ خود بخود چلتا ہے: agent کوڈ لکھتا ہے، اسے test کرتا ہے، ٹھیک کرتا ہے، اور دوبارہ کوشش کرتا ہے — آپ کے بغیر۔
یہ ایک لوپ ہے۔ یہ سب سے تیز لوپ ہے۔ یہ منٹوں میں گھومتا ہے۔ مگر یہ اکیلا کام نہیں کرتا۔ یہ تین لوپوں میں سب سے چھوٹا ہے، اور باقی دو چلانا آپ کا کام ہے۔
انہیں دیکھنے کا سب سے آسان طریقہ ایک مثال ہے۔ فرض کریں آپ کسی agent سے کہتے ہیں کہ کسی بچے کے لیے ایک چھوٹا typing گیم بنائے۔
- کوڈنگ لوپ منٹوں میں گھومتا ہے۔ agent گیم لکھتا ہے، اسے test کرتا ہے، اور bugs ٹھیک کرتا ہے یہاں تک کہ وہ آپ کی ہدایات سے میل کھا جائے۔ یہی وہ لوپ ہے جو آپ نے ابھی بنایا۔
- فیڈبیک لوپ گھنٹوں میں گھومتا ہے۔ آپ گیم کھولتے ہیں، اسے آزماتے ہیں، اور طے کرتے ہیں کہ کیا بدلنا ہے — buttons بڑے کریں، بلی کے ایسے لباس شامل کریں جو بچہ کھول سکے، اور ایک login شامل کریں تاکہ کوئی والدین مدد کر سکیں۔ پھر آپ اپنی ہدایات update کرتے ہیں، اور agent دوبارہ بناتا ہے۔
- بیرونی لوپ دنوں میں گھومتا ہے۔ حقیقی لوگ گیم استعمال کرتے ہیں۔ کوئی دوست اسے آزماتا ہے۔ کوئی بچہ اس سے کھیلتا ہے۔ وہ جو کرتے ہیں، وہی آپ کو دکھاتا ہے کہ اگلا کیا ٹھیک کرنا ہے۔
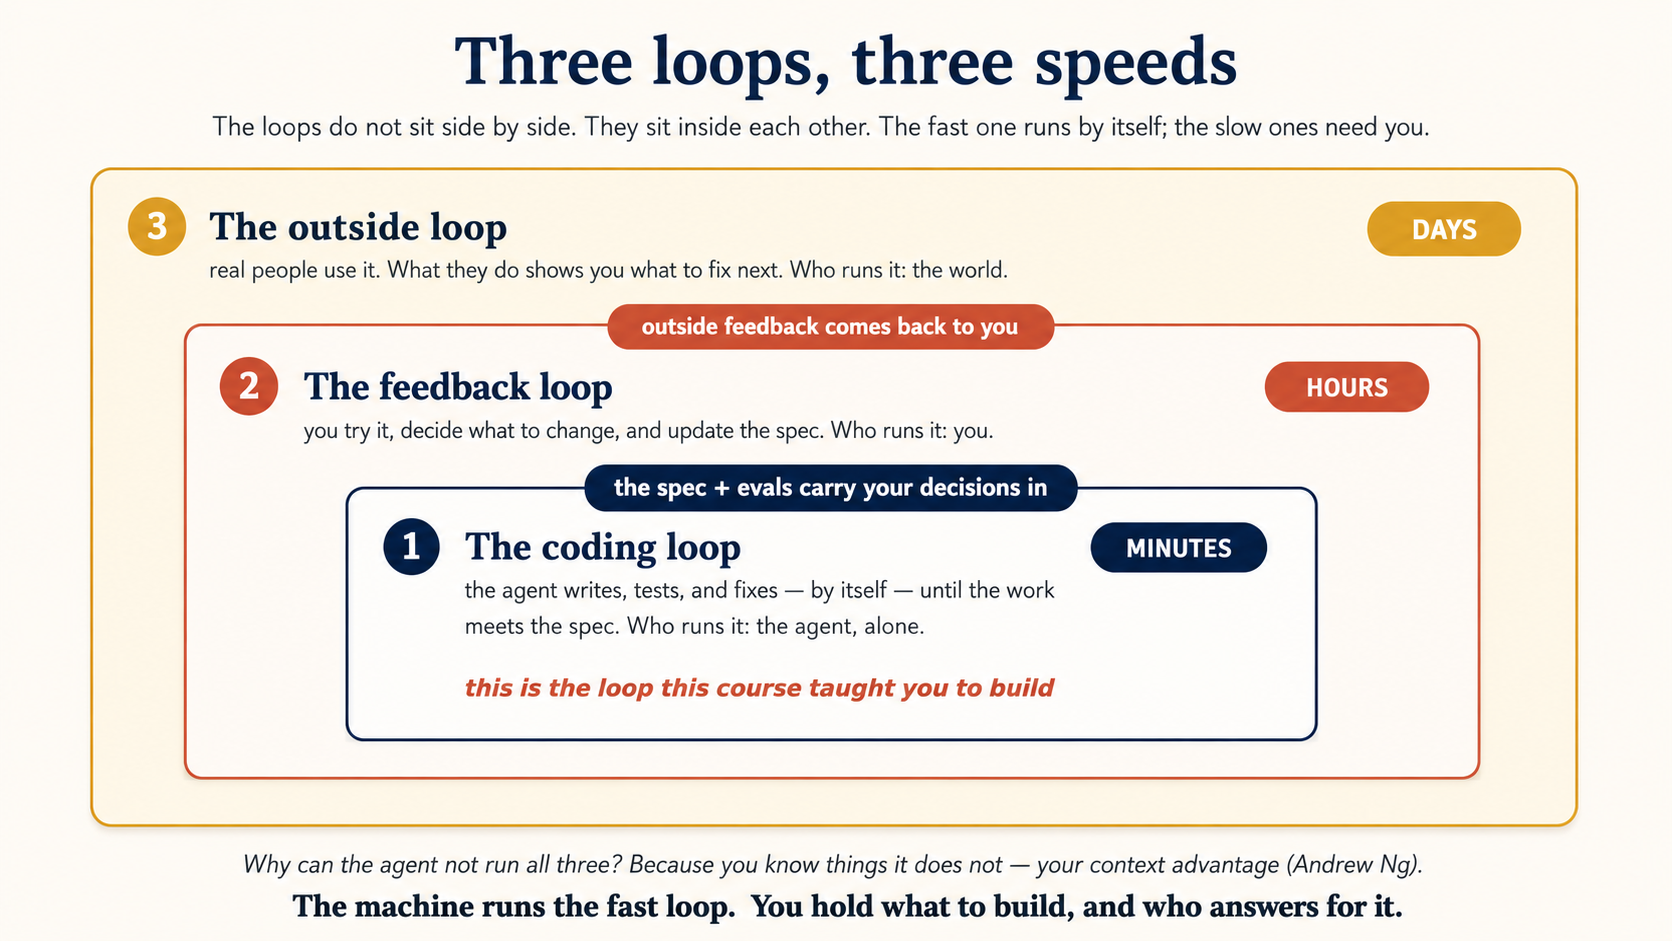
لوپ ایک دوسرے کے ساتھ ساتھ نہیں بیٹھتے۔ وہ ایک دوسرے کے اندر بیٹھتے ہیں۔ آپ کے ایک فیڈبیک لوپ کے دوران کئی کوڈنگ لوپ چلتے ہیں۔ باہر کی دنیا سے feedback کا ایک دور آنے کے دوران کئی فیڈبیک لوپ چلتے ہیں۔ تیز لوپ خود چلتا ہے۔ سست لوپوں کو آپ کی ضرورت ہوتی ہے۔
جاننے کے لیے دو الفاظ۔ ایک spec اس بات کی آپ کی تحریری وضاحت ہے کہ کیا بنانا ہے۔ Evals ٹیسٹوں کا ایک چھوٹا سیٹ ہیں جو جانچتے ہیں کہ agent نے اسے درست کیا یا نہیں۔ یہ دونوں مل کر پہلے دو لوپوں کے درمیان بیٹھتے ہیں اور آپ کے فیصلوں کو کوڈ تک لے جاتے ہیں۔
اب اصل خیال، Andrew Ng کی طرف سے۔ agent تینوں لوپ خود کیوں نہیں چلا سکتا؟ کیونکہ آپ ایسی چیزیں جانتے ہیں جو وہ نہیں جانتا — یہ کون استعمال کرے گا، انہیں حقیقت میں کیا چاہیے، اور "اچھا" کیسا محسوس ہوتا ہے۔ جب تک آپ کوئی ایسی بات جانتے ہیں جو agent نہیں جانتا، آپ اسے بتانے کے لیے لوپ میں رہتے ہیں۔ Ng اسے آپ کا context advantage کہتے ہیں۔
یہی وہ سبق ہے جس پر یہ کورس ختم ہوتا ہے۔ مشین تیز لوپ چلاتی ہے۔ آپ وہ دو چیزیں تھامے رکھتے ہیں جو وہ کبھی نہیں تھام سکتی: کیا بنانا ہے، اور اس کا جواب دہ کون ہے۔
چاہے آپ کبھی کوئی product نہ بنائیں، اس نقشے کو یاد رکھیں۔ یہ دکھاتا ہے کہ کسی بھی agent کے کام میں انسان کہاں بیٹھتا ہے۔ اس spec کو تیز تر کرنے کے لیے جو پہلے دو لوپوں کو جوڑتی ہے، Spec-Driven Development دیکھیں۔ یہ دیکھنے کے لیے کہ باہری لوپوں میں آپ کا کردار کیسے بڑھتا ہے، The Roles This Book Trains دیکھیں۔
13. اصل حد token cost ہے، commands نہیں
لوپس عموما اسی جگہ غلط ہوتے ہیں۔ لوپ بار بار چلتا ہے، اکثر subagents شروع کرتا ہے، اور ہر subagent اپنا model اور tools چلاتا ہے۔ لاگت توقع سے کہیں تیز بڑھ سکتی ہے۔ حل سادہ ہیں:
- ہر loop کی حد رکھیں: زیادہ سے زیادہ کوششیں، منٹ یا خرچ، ہمیشہ (تصور 5)۔
- model کو کام کے مطابق چنیں: planning اور checking کے لیے مضبوط model، واضح مشینی کام کے لیے سستا model۔ Claude Code میں ہر beat کے مطابق effort level بھی رکھیں:
/effort، یا headless runs میںCLAUDE_CODE_EFFORT_LEVEL۔ routine triage کے لیے default کافی ہے؛ ہر scheduled firing پر maximum effort ادا کرنا mechanical chore کے لیے frontier model چلانے جیسا ہے۔ - loop prompt اور rules file مختصر رکھیں: ان کی قیمت ہر beat پر ادا ہوتی ہے۔ detail ایسی skills میں رکھیں جو ضرورت پر load ہوں۔
- کم بار چلائیں: ہر پانچ منٹ کے بجائے عموما گھنٹے میں ایک بار کافی اور تقریبا بارہ گنا سستا ہے۔
اعداد کا فوری اندازہ (مثال). فرض کریں maker اور checker والی ایک beat تقریبا 40,000 tokens پڑھتی اور 6,000 لکھتی ہے۔ standard Sonnet قیمت، input کے لیے فی million $3 اور output کے لیے $15، پر یہ تقریبا $0.20 فی beat ہے۔ بیس working days میں روزانہ پانچ beats تقریبا $20 بنتی ہیں۔
وہی loop ہر پانچ منٹ، دن رات چلے تو سو گنا سے بھی زیادہ beats بنتی ہیں، اور ہر beat وہی کام کرنے کے باوجود ماہانہ قیمت آسانی سے $1,000 سے بڑھ سکتی ہے۔ اضافہ command name سے نہیں، frequency سے آتا ہے۔
موجودہ model کی اختیاری تفصیل: Sonnet 5 اگست 2026 تک introductory pricing کے ساتھ آیا، اور اس کا tokenizer اسی text کے لیے پرانے models سے زیادہ tokens بنا سکتا ہے۔ اپنے حقیقی loop کے tokens ناپیں، انہیں موجودہ model price سے ضرب دیں، پھر scheduled runs کی تعداد سے۔
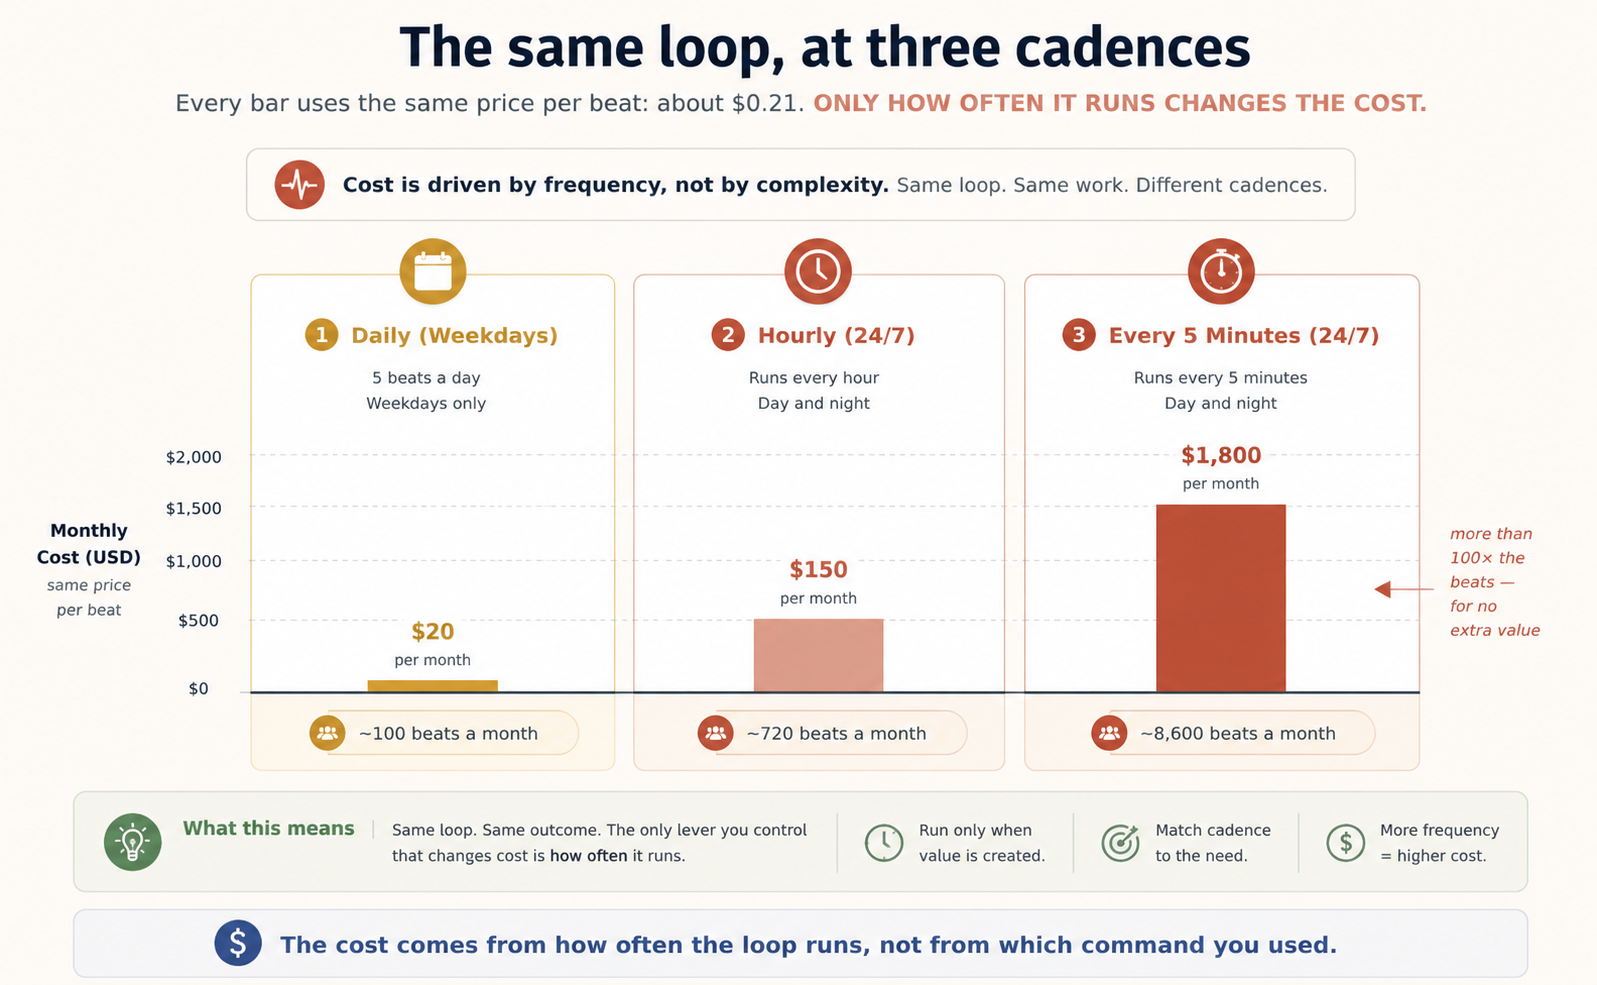
OpenCode میں model لاگت کا دوسرا lever ہے۔ اوپر کی مثال standard Sonnet-class model فرض کرتی ہے۔ Claude Code کے loop commands Claude استعمال کرتے ہیں، جبکہ OpenCode دوسرا model منتخب کرنے دیتا ہے۔ کم قیمت model فی beat لاگت بہت گھٹا سکتا ہے۔
لیکن کمزور maker زیادہ ناکام کوششیں پیدا کر سکتا ہے، جس سے بچت ختم ہو جاتی ہے۔ عملی pattern ہے: کم قیمت maker، قابل اعتماد checker۔ واضح mechanical کام کے لیے سستا model استعمال کریں، اور tests، linters یا قابل اعتماد reviewer کو checker رکھیں۔
frequency پھر بھی سب سے اہم ہے۔ تیس گنا سستا model اگر ہر پانچ منٹ چلے تو گھنٹے میں ایک بار چلنے والے Sonnet سے مہنگا ہو سکتا ہے۔ model فی beat قیمت بدلتا ہے؛ schedule اور retry rate طے کرتے ہیں کہ آپ کتنی beats کی قیمت دیتے ہیں۔
عام ناکامی ہمیشہ ایک جیسی ہے: خود سے چلتا loop، ایسی stopping condition جسے وہ کبھی پورا نہ کر سکے، پوری رات retry کرتا رہتا ہے۔ شروع کرنے سے پہلے limit رکھیں، پہلے چند حقیقی runs دیکھیں، پھر اسے خود چلنے دیں۔
spine صرف correctness feature نہیں۔ Anthropic کے production fleets میں اچھی memory store کے ساتھ agent دوسری بار کام بہتر کرتا ہے، کیونکہ پہلی کوشش کا سبق disk پر موجود ہوتا ہے۔ بہتر پہلی کوشش کا مطلب کم retries اور کم tokens ہے۔ یہی dreaming pass پر tokens خرچ کرنے کا ایماندار جواب ہے: pass ایک بار قیمت لیتا ہے اور ہر آئندہ پہلی کوشش میں کامیاب beat پر وہ قیمت واپس دیتا ہے۔
14. کام جانچنا اب بھی آپ کی ذمہ داری ہے
خود سے چلتا لوپ، خود سے غلطیاں کرتا لوپ ہے۔ maker–checker تقسیم لوپ کے "ہو گیا" کو کوئی معنی دیتی ہے — مگر "ہو گیا" پھر بھی ایک دعوی ہے، ثبوت نہیں۔ آپ کا کام غائب نہیں ہوا؛ یہ منتقل ہو گیا۔ آپ اب ہر قدم ٹائپ نہیں کرتے، مگر آپ ہی وہ ہیں جو تصدیق کرتے ہیں کہ لوپ نے ایسا کوڈ شپ کیا جو واقعی کام کرتا ہے۔ وہ diffs پڑھیں جو لوپ نے کھولے۔ لوپ پر کام کرنے کا بھروسہ کریں؛ کام شمار ہونے سے پہلے اسے جانچیں۔
اختیاری technical detail، پہلی reading میں چھوڑ سکتے ہیں۔
ایک loop کے لیے اس کورس کی تین باتیں کئی loops کے ساتھ organization کے مسائل بن جاتی ہیں۔ enterprise platforms کی دنیا تینوں پر لکھنا شروع کر چکی ہے۔
پہلا، جب کوئی نہ دیکھ رہا ہو تو failure کی ریاضی۔ model کے steps قابل اعتماد ہیں، یقینی نہیں۔ پانچ مسلسل steps اگر ہر بار 95% درست ہوں تو تقریبا چار میں صرف تین runs صاف ختم ہوں گے۔ معاملہ مزید بگڑتا ہے کیونکہ unattended loop کی غلطیاں spine میں جمع ہوتی ہیں۔ آج رات progress.md کی غلط line کل کا غلط نقطۂ آغاز ہے۔ maker-checker اسی لیے اہم ہے: checker ایک غلط step کو مستقل بننے سے روکتا ہے۔
دوسرا، صرف review نہیں؛ loop کی capability محدود کریں۔ reviewer دکھایا گیا work، یعنی diff، grade کرتا ہے۔ اس سے ثابت نہیں ہوتا کہ loop نے کچھ اور نہیں کیا۔ وہ config بدل سکتا، flag flip کر سکتا یا دستیاب connector سے بیرونی system بلا سکتا ہے۔ حل زیادہ ذہین reviewer نہیں، زیادہ محدود loop ہے۔ ہر جز کو standing permission سمجھیں: schedule سوتے وقت عمل کی اجازت ہے، connector حقیقی system کی مستقل رسائی ہے، subagent ادھار identity کے تحت کام کرتا ہے۔ ہر loop کو صرف اپنے کام کی ضرورت دیں۔ claude/ prefix، مختصر connector list اور read-only checker اسی ایک اصول کی مثالیں ہیں۔
تیسرا، گنتی کا سوال۔ جب پانچ ساتھی loop copy کریں تو کوئی پوچھے گا: ٹیم کتنے loops چلاتی ہے؟ ہر ایک کیا چھو سکتا ہے؟ کس identity کے تحت؟ کس نے approve کیا؟ یہ loop engineering نہیں، workforce management ہے۔ یہی مقام Human-Agent Teams اور Digital FTE کے تصور کا اگلا قدم ہے۔ اکیلا trust کمانے والا loop بھی ٹیم میں جگہ کمانے کا محتاج ہے۔
اختیاری technical detail، پہلی reading میں چھوڑ سکتے ہیں۔
اپنی progress.md لکھنے والے ایک loop کو یہ پیچیدگی نہیں چاہیے۔ لیکن جیسے ہی کئی loops یا پوری fleet ایک مشترک memory store پڑھے اور لکھے، نئے failure modes آتے ہیں: دو agents ایک ہی file ساتھ لکھتے ہیں؛ ایک agent organization-wide rules “درست” کرتا ہے جنہیں باقی سب پڑھتے ہیں؛ یا جنوری کا درست سبق جون میں غلط رہ جاتا ہے۔ Anthropic کی production fleets چار guardrails بتاتی ہیں:
- Versioning۔ store کی ہر تبدیلی record ہو: کیا بدلا، کس run نے بدلا، اور کس نے بنایا۔ خراب update ہر آئندہ run کو خاموشی سے poison کرنے کے بجائے rollback ہو سکے۔ git-tracked spine یہ مفت دیتی ہے۔
- لکھنے سے پہلے conflict check۔ agent edit commit کرنے سے پہلے دیکھے کہ draft کے دوران file تو نہیں بدلی۔ بدلی ہو تو دوبارہ پڑھے اور پھر کوشش کرے، کسی اور update کو overwrite نہ کرے۔
- level کے مطابق permissions۔ agent اپنے scratch space میں آزاد لکھ سکتا ہے، مگر organization-wide rules عام agents کے لیے read-only ہوں اور changes review سے گزریں۔ اوپری سطح کی ایک غلط line پوری fleet تک پھیلتی ہے۔
- Portability۔ curated memory ایسا asset ہے جو کئی products میں چاہیے۔ اسے صاف interface کے پیچھے plain، open format میں رکھیں تاکہ وہ آپ کے ساتھ منتقل ہو سکے۔
مشترک memory production data ہے اور production discipline چاہتی ہے۔ stale-memory مسئلہ ہی وہ چیز ہے جسے تصور 12 کا dreaming pass صاف کرتا ہے۔
لوپ کے اندر، لوپ پر، یا لوپ سے باہر: gate کے صنعتی نام
یہ کورس «human gate» کہتا ہے۔ AI safety، EU AI Act، banks اور enterprise procurement تین پرانے نام استعمال کرتے ہیں:
| اصطلاح | مطلب | اس کورس میں مثال |
|---|---|---|
| Human in the loop | ہر action لاگو ہونے سے پہلے شخص approval دے۔ زیادہ control، کم رفتار۔ | turn-by-turn prompting، plan mode، human gate پر merge، A4 کی two-routine gate۔ |
| Human on the loop | system خود action لے، شخص نگرانی کرے اور مداخلت کر سکے۔ | Routine کا claude/ branch پر push، صبح spine پڑھنا۔ |
| Human out of the loop | نہ نگرانی، نہ مداخلت کا راستہ۔ | جان بوجھ کر کہیں نہیں؛ یہ اختیار نہیں بلکہ failure mode ہے۔ |
table سے تین نتائج نکلتے ہیں۔
پہلا، تصور 1 کی ذہنی تبدیلی کا اب نام ہے۔ prompting میں انسان in the loop ہے: آپ heartbeat، checker اور memory ہیں، اور آپ کی turn کے بغیر کچھ نہیں ہوتا۔ loop engineering انسان کو on the loop لے جاتی ہے: system چلتا ہے اور آپ کی توجہ gate پر ہوتی ہے۔
دوسرا، اچھا loop ایک حالت نہیں بلکہ ہر action کے مطابق mix ہے۔ morning-triage loop safe fixes میں on-the-loop چلتا ہے، مگر reviewer کے FAIL، public-behavior change اور merge پر in-the-loop ہو جاتا ہے۔ claude/ branch rule بالکل یہی ہے: unattended work، مگر main سے پہلے لازمی انسانی قدم۔ تصور 2 کی checker ladder mix طے کرتی ہے: checker جتنا کمزور ہو، اتنی actions on-the-loop سے واپس in-the-loop جائیں۔ passing test autonomy کماتا ہے؛ rubric score نہیں۔
تیسرا، AI gravity system کو out-of-the-loop کھینچتی ہے۔ کوئی اسے جان بوجھ کر design نہیں کرتا؛ یہ drift سے ہوتا ہے۔ diffs پڑھنا، green checks سے آگے دیکھنا، یا weekly review چھوڑ دیں تو design بدلے بغیر on-the-loop system out-of-the-loop بن جاتا ہے۔ dogfooding rule دفاع ہے: انسان وہاں رکھیں جہاں غلط automatic move مہنگا اور واپس لینا مشکل ہو، اور دیکھتے رہیں کہ انسان واقعی موجود ہے۔
regulated vertical میں Digital FTE بیچتے وقت سوال انہی الفاظ میں آئے گا: «human in the loop ہے یا on the loop؟» اب آپ action-by-action درست جواب دے سکتے ہیں۔
In: شخص ہر action approve کرتا ہے۔ On: system عمل کرتا ہے، شخص دیکھ اور روک سکتا ہے۔ Out: کوئی نہیں دیکھتا، جو writes کے لیے کبھی قابل قبول نہیں۔ اس کورس کے loops default طور پر on-the-loop ہیں، risky steps پر in-the-loop gates کے ساتھ۔
dogfooding section کا What's New loop approval کے بغیر publish کرتا ہے۔ یہ in، on یا out of the loop ہے، اور وہاں کیوں قابل قبول ہے؟ On the loop۔ ہر run پہلے approve نہیں ہوتا، مگر output public، logged اور ایک revert سے درست ہو سکتا ہے، اور ٹیم transcripts پڑھتی ہے۔ اگر کوئی کبھی output نہ پڑھے تب یہ out of the loop ہوگا۔ غلط changelog line واپس لینا سستا ہے، اسی لیے dial یہاں مختلف ہے۔جواب دکھائیں
15. اپنے ہی پروجیکٹ کو سمجھنا بند نہ کریں
جتنی تیزی سے کوئی لوپ ایسا کوڈ شپ کرتا ہے جو آپ نے نہیں لکھا، اتنا ہی چوڑا وہ فاصلہ ہوتا ہے جو آپ کے پروجیکٹ میں موجود چیز اور جو آپ واقعی سمجھتے ہیں، کے درمیان ہے۔ یہ فاصلہ ایک حقیقی لاگت ہے، اور ایک ہموار لوپ اسے خاموشی سے بڑھاتا ہے۔ علاج اور جال ایک ہی عمل ہیں۔ لوپ ڈیزائن کرنا آپ کو مصروف رکھتا ہے جب آپ اسے دھیان سے کریں — اور آپ کو سوچنا چھوڑنے دیتا ہے جب آپ اسے کام سے بچنے کے لیے کریں۔ ایک ہی عمل، مخالف نتیجہ۔ لوپ فرق نہیں بتا سکتا۔ آپ بتا سکتے ہیں۔
دو لوگ بالکل ایک جیسا لوپ بنا سکتے ہیں اور مخالف نتائج پا سکتے ہیں۔ ایک اسے ایسے کام پر تیز چلنے کے لیے استعمال کرتا ہے جسے وہ گہرائی سے سمجھتا ہے۔ دوسرا اسے اس کام کو سمجھنے سے بچنے کے لیے ہی استعمال کرتا ہے۔ لوپ بنائیں۔ مگر اسے ایسے بنائیں جیسے کوئی ایسا شخص جو انجینئر بنے رہنے کا ارادہ رکھتا ہے — صرف وہ نہیں جو go دباتا ہے۔
یہ دونوں لوگ اسی force کے نیچے ہیں، اور اس force کا نام ہے۔ MIT Sloan کے Eric So اسے AI gravity کہتے ہیں: وہ مسلسل pull جو آپ کو اپنی thinking کا زیادہ سے زیادہ حصہ AI کو دینے کی طرف کھینچتا ہے۔ Loop وہی pull ہے، بس heartbeat کے ساتھ: یہ آپ کے سوتے وقت بھی چلتا ہے، اس لیے جو ship ہوتا ہے اور جو آپ سمجھتے ہیں ان کے درمیان gap تب بھی بڑھتا ہے جب آپ کچھ touch نہیں کرتے۔ اگر اسے اکیلا چھوڑ دیا جائے تو gravity ان دو سروں کو دبا دیتی ہے جنہیں یہ course آپ کا کہتا ہے: intent ایک precise، checkable condition سے پتلا ہو کر "بس اسے working رکھو" بن جاتا ہے، اور accountability diffs پڑھنے سے پتلی ہو کر green checkmarks پر بھروسہ بن جاتی ہے۔ Loop دونوں حالتوں میں چلتا رہتا ہے۔ یہ نہیں بتا سکتا کہ آپ اب بھی engineer ہیں یا نہیں۔ Concept 15 کے سوال کا جواب دینے والی weekly habit — کیا ship ہوا پڑھنا، اور check کرنا کہ آپ کی understanding ساتھ چلی — وہ طریقہ ہے جس سے آپ pull کے خلاف اپنا وزن قائم رکھتے ہیں۔
اور یہی پورے کورس کا مرکزی خیال ہے۔ ہر سال tools loop کی مزید مشینری انجام دیتے ہیں۔ dynamic workflows، /goal، Routines، retry limits، ہر agent کی steps limits اور background sessions اب وہ کام بدل رہے ہیں جن کے لیے پہلے custom scripts درکار تھیں۔
tools پھر بھی تصور 1 کے دو سروں کو نہیں سنبھال سکتے: اتنی واضح intent کہ اسے check کیا جا سکے، اور ship ہونے والی چیز کی accountability۔ یہی ذمہ داریاں اسے engineering بناتی ہیں، صرف button دبانا نہیں۔ مضبوط tools استعمال کریں، مگر intent اور accountability انسانی control میں رکھیں۔
جب آپ سو رہے ہوں اور کوئی لوپ ناکام ہو
ایک بے توجہ لوپ بے توجہی سے ہی ناکام بھی ہوتا ہے۔ کسی پر رات بھر بھروسہ کرنے سے پہلے، اسے قابل مشاہدہ بنائیں:
- output وہاں بھیجیں جہاں آپ دیکھیں گے — کوئی log file، کوئی Slack یا Discord message (Claude Code Channels)، یا Triage inbox۔ وہ terminal نہیں جسے آپ پہلے ہی بند کر چکے۔
- ہر run پر ایک لائن لکھیں، ناکامی پر بھی — ہر دھڑکن
progress.md(یا کسی log) میں ایک timestamp والا نوٹ شامل کرتی ہے: اس نے کیا آزمایا، کیا pass ہوا، کیا ٹوٹا۔ خاموش ناکامی بدترین قسم ہے۔ - runs کو دوبارہ چلانے کے قابل رکھیں — OpenCode میں،
opencode run --format json،opencode export <id>، اورopencode session listآپ کو پورا record دیتے ہیں۔ Claude Code میں Routine اپنی run history web UI میں رکھتی ہے، اور background sessions interactive sessions کے ساتھ--resumeمیں دکھتے ہیں۔ - ceiling پر اونچی آواز سے ناکام ہوں — جب لوپ اپنی cap سے ٹکرائے یا error دے، تو اسے ایک واضح "needs a human" نوٹ چھوڑنا چاہیے، بس رک نہیں جانا چاہیے۔
- رات کی جگہ کمائیں — اسے رات بھر بے توجہ چلنے دینے سے پہلے چند دن گھنٹہ وار اور دیکھتے ہوئے چلائیں۔ جب کچھ غلط لگے، پہلے ریڑھ کی ہڈی پڑھیں؛ یہ بتاتی ہے کہ آخری اچھے run نے کیا کیا۔
ایسا لوپ جسے آپ debug نہیں کر سکتے، ایسا لوپ ہے جس پر آپ بھروسہ نہیں کر سکتے۔
loops کے بعد: graph engineering
یہ کورس ایک سوال کھلا چھوڑتا ہے۔ 18 جولائی 2026 کو Peter Steinberger نے پوچھا: "Are we still talking loops or did we shift to graphs yet?" نعرہ بنا «loop engineering ختم، graph engineering زندہ باد»، مگر اصل سوال سنجیدہ ہے: ایک سے زیادہ loops ہوں تو انہیں wiring چاہیے۔ کون کس کو input دیتا ہے، کون کس کو check کرتا ہے، shared memory کہاں ہے، اور کون سی measurement سے کوئی loop بحث نہیں کر سکتا؟
اس سوال کا مکمل Graph Engineering کورس ہے، اس سلسلے میں دو قدم آگے، Harness Engineering کے بعد۔ یہ فقرے کے دونوں حصے سمجھاتا ہے: آپ کے loops کے shared memory graphs، یعنی کام کا commit DAG اور حقائق کا knowledge graph، Karpathy کے autoresearch اور Anthropic کی Knowledge Graph Cookbook کے ذریعے؛ اور کئی loops کو دیانت دار رکھنے والا governance graph، Carlos E. Perez کی single loop کی چار failures کے ذریعے، جن میں یہ بھی ہے کہ نعرہ کیوں غلط ہے۔ ابھی صرف نعرے کی سچی شکل یاد رکھیں، کیونکہ باقی سب اسے فرض کرتا ہے: graph، compose کیے ہوئے loops ہے۔ loops ہٹا دیں تو graph خالی boxes رہ جاتا ہے۔ ہر stopping condition، checker، spine اور gate جو آپ نے یہاں بنایا، graph engineering فرض کرتی ہے کہ آپ اسے پہلے ہی بنانا جانتے ہیں۔ پہلا loop عین اسی طرح بنائیں جیسے کورس نے سکھایا۔ دوسرا بناتے ہی graph course آپ کا منتظر ہے۔
یہ بات جولائی 2026 کے آخر میں درست تھی۔ اصطلاح رہے یا ختم ہو، pattern قائم ہے۔
اس کتاب میں ان loops کا استعمال (dogfooding)
اب شکل جانی پہچانی ہے۔ Loop ایسا system ہے جو کام ڈھونڈتا، اسے کرتا، اپنے نتیجے کو check کرتا، کیے ہوئے کام کا record لکھتا، اور اگلا قدم طے کرتا ہے۔ Heartbeat اسے شروع کرتی ہے اور spine سب حصے جوڑتی ہے۔ آپ کاغذ پر اسے دو بار بنا چکے ہیں۔ یہاں یہ کاغذ سے نکل کر حقیقت بنتا ہے۔
کسی tool سے اعتماد مانگنے سے پہلے منصفانہ سوال ہے: کیا اسے بنانے والے لوگ خود بھی اسے چلاتے ہیں؟ Software میں اسے dogfooding کہتے ہیں، یعنی اپنے product کو demo میں نہیں بلکہ حقیقی production میں استعمال کرنا۔ صاف جواب یہ ہے: دو loops ہر روز اس کتاب کو چلاتے ہیں، اور وہی loops ہیں جو اس کورس نے ابھی سکھائے۔ کتاب اپنے ساتھ عین وہی کرتی ہے جو آپ کو اپنے لیے کرنا سکھا رہی ہے۔ دونوں مختلف stacks پر چلتے ہیں، یعنی تصور 3 حقیقت میں: loop ایک بار سیکھیں، پھر وہ tools بدلنے کے باوجود ساتھ رہتا ہے۔
Loop 1: feedback loop، جو کتاب درست رکھتا ہے۔ ہر lesson کے آخر میں feedback box، اس lesson سمیت، loop کا front door ہے۔
- Heartbeat: دو cloud Routines۔ ایک ہفتے میں چند بار نئی feedback triage کرتی ہے، اور دوسری ہر ہفتے fixes draft کرتی ہے۔
- Spine: ہر reader note کا live database اور ان notes سے کھلنے والے GitHub issues۔ ہر run پہلے runs کا کام پڑھتا ہے، اس لیے ایک note دوبارہ process نہیں ہوتا۔
- ایک beat: نئی feedback پڑھ کر sort کرنا۔ زیادہ تر چیزیں، یعنی ratings، شکریہ، duplicates اور پہلے حل شدہ notes، خود بند ہو جاتی ہیں، اس لیے کسی شخص کو انہیں چھونا نہیں پڑتا۔ باقی tracked issues بنتی ہیں، اور چھوٹی محفوظ چیزوں کے لیے loop اصل fix کے ساتھ pull request draft کرتا ہے۔
- Human gate: صرف ضروری چند چیزیں شخص تک پہنچتی ہیں: blocked reader، contribution کی پیشکش، یا حقیقی content error۔ ہر drafted fix ship ہونے سے پہلے شخص approve بھی کرتا ہے۔ باقی چھوٹی چیزیں کسی انسان کے بغیر handle اور close ہوتی ہیں۔ انسان وہاں آتے ہیں جہاں ضرورت ہو، five-star rating بند کرنے کے لیے نہیں۔
- اس نے کیا کیا: پہلی runs میں اس نے ہزاروں notes کا backlog صاف کیا جسے پڑھنے کا وقت کسی انسان کے پاس نہیں تھا، اور صرف وہ چند notes اوپر بھیجے جنہیں واقعی فیصلے کی ضرورت تھی۔
Loop 2: What's New loop، جو readers کو باخبر رکھتا ہے۔ What's New page، جسے آپ ابھی کھول سکتے ہیں، ہاتھ سے نہیں بلکہ loop سے لکھی جاتی ہے۔
- Heartbeat: دن میں ایک بار GitHub Actions schedule۔ Worker Claude Code نہیں بلکہ OpenCode ہے، یعنی دوسرا tool جو یہ کورس سکھاتا ہے۔
- Spine: چھوٹی state file آخری لکھی گئی تبدیلی یاد رکھتی ہے، اس لیے نہ entry دہرائی جاتی ہے نہ کوئی رہ جاتی ہے۔
- ایک beat: پچھلی بار کے بعد کتاب میں ہونے والی ہر تبدیلی دیکھنا، طے کرنا کہ reader کے لیے کیا اہم ہے، ہر اہم چیز کے لیے ایک سادہ sentence لکھنا، اپنے links check کرنا تاکہ کوئی نہ ٹوٹے، اور publish کرنا۔
- Human gate: کوئی نہیں۔ Live ہونے سے پہلے کوئی شخص اسے approve نہیں کرتا۔
اب وہ ایک جگہ دیکھیں جہاں دونوں loops مختلف ہیں، کیونکہ اس صفحے کا سب سے مفید سبق وہی ہے۔ Feedback loop کچھ ship ہونے سے پہلے انسان کے لیے رکتی ہے؛ What's New loop کسی کے لیے نہیں رکتی۔ فیصلہ اس سے نہیں ہوتا کہ کون سا loop زیادہ اہم ہے، بلکہ غلط move کی قیمت سے ہوتا ہے۔ Lesson میں غلط edit مہنگی اور undo کرنا مشکل ہے۔ بھدی changelog line صرف ایک revert سے درست ہو سکتی ہے۔ اپنا rule مختصر رکھیں: انسان کو وہاں رکھیں جہاں غلط automatic move مہنگی اور واپس پلٹانا مشکل ہو، اور باقی ہر جگہ انسان کو loop سے باہر رکھیں۔ یہ تصور 1 کا "intent اور accountability آپ کے پاس رہتی ہے" والا اصول ہے، مگر ہر loop کے لیے الگ مقرر ہونے والے dial کی شکل میں۔ حصہ 6 کی صنعتی زبان میں: جہاں غلطی مہنگی ہو وہاں human-in-the-loop، باقی جگہ human-on-the-loop۔
اور ایماندار بات، کیونکہ پچھلے صفحات engineer رہنے کے بارے میں تھے: کوئی loop مکمل طور پر اکیلا نہیں چھوڑا جاتا۔ ہم run transcripts پڑھتے ہیں، کیونکہ green run درست run نہیں، جیسا کہ ضمیمہ A5 بتاتا ہے۔ شخص اب بھی طے کرتا ہے کہ کون سی feedback fix بنے۔ Loops نہ تھکنے والا درمیانی کام کرتے ہیں، جبکہ دونوں سروں کا اختیار ہمارے پاس رہتا ہے۔ یہ کوئی کمی نہیں جس پر معذرت کی جائے؛ یہی design ہے۔
اب آپ نے production میں چلتا ایک مکمل loop باہر سے دیکھ لیا ہے۔ نیچے projects میں اپنا پہلا loop بنائیں گے۔
🚀 Projects
لوپ کے بارے میں پڑھنا ایک بنانے جیسا نہیں۔ یہ رہے پانچ projects، آسان سے مشکل۔ انہیں کسی بھی ٹول میں کریں — لوپ کی ساخت ایک ہی ہے، تو متعلقہ تصور سے کمانڈ تک پہنچیں (Claude Code میں /loop اور /goal؛ OpenCode میں ایک shell timer کے ساتھ opencode run)۔
شروع کرنے سے پہلے دو قاعدے، ہر بار:
- ایک پھینک دینے والا git repo استعمال کریں۔ ایک لوپ خود سے فائلیں edit کرتا ہے۔ اپنے پہلے لوپ ایسے کام کی طرف نہ موڑیں جس کی آپ کو پروا ہو۔
- پہلے ایک ceiling سیٹ کریں۔ زیادہ سے زیادہ کوششیں، منٹ، یا خرچ — کسی چیز کو خود سے چلنے دینے سے پہلے (تصور 13)۔
Project 115-30 minایک watch لوپایک لوپ سے کسی لمبے کام کی نگرانی کروائیں اور ختم ہوتے ہی آپ کو بتانے دیں۔
دشواری: آسان · استعمال: تصور 4 (in-session لوپ)۔
بنائیں۔ اپنے repo میں ایک لمبا کام شروع کریں (مثلا ایک script جو کچھ دیر sleep کرے اور پھر ایک فائل لکھے)۔ ایک in-session لوپ سیٹ کریں جو ہر منٹ جانچے کہ کام ختم ہوا یا نہیں، اور جیسے ہی ہو آپ کو بتا دے۔
مکمل جب لوپ نوٹ کرے کہ کام ختم ہو گیا، ایک بار یہ کہے، اور آپ اسے صاف ستھرے انداز میں روک سکیں — اور آپ نے terminal دیکھتے ہوئے بیٹھنا نہ پڑے۔
Project 230-45 mintests کو pass کرائیں، پھر رکیںاس وقت تک لوپ کریں جب تک ایک کمانڈ — نہ کہ ایجنٹ — یہ طے کرے کہ کام ہو گیا۔
دشواری: آسان–درمیانی · استعمال: تصور 5 (run-until-done)، تصور 11 (maker–checker)۔
بنائیں۔ اپنے repo میں 2–3 چھوٹے ناکام tests ڈالیں۔ ایک ایسا لوپ بنائیں جو tests کے pass ہونے تک کام کرتا رہے — مگر "ہو گیا" کا فیصلہ کسی کمانڈ (test runner) کو کرنے دیں، ایجنٹ کو نہیں۔ اسے، مثلا، 6 کوششوں پر cap کریں۔
مکمل جب لوپ اس لیے رکے کہ tests واقعی pass ہو گئے، اس لیے نہیں کہ یہ cap سے ٹکرا گیا۔ اگر یہ بار بار cap سے ٹکراتا ہے، تو آپ کی رکنے کی شرط یا آپ کے prompt میں کام درکار ہے — یہی سبق ہے۔
Project 345-60 minmemory والا صبح کا خلاصہایک scheduled لوپ جس کا دوسرا run واضح طور پر اپنے پہلے پر تعمیر کرے۔
دشواری: درمیانی · استعمال: تصور 6 (بے توجہ schedule)، تصور 12 (ریڑھ کی ہڈی)۔
بنائیں۔ ایک scheduled لوپ بنائیں جو ایک بار چلے، ایک progress.md پڑھے، repo سے کوئی سادہ چیز جمع کرے (open TODO comments، یا پچھلے دن کے commits)، ایک مختصر خلاصہ لکھے، اور progress.md کو اس سے اپڈیٹ کرے جو اسے ملا اور تاریخ کے ساتھ۔
مکمل جب آپ اسے دو بار چلائیں اور دوسرا run واضح طور پر پہلے پر تعمیر کرے — یہ وہ نہ دہرائے جو پہلے ہی ریکارڈ کر چکا۔ یہ ثابت کرتا ہے کہ آپ کی ریڑھ کی ہڈی کام کرتی ہے۔ اگر دوسرا run صفر سے شروع ہو، تو آپ کے لوپ کی ابھی کوئی memory نہیں۔
Project 41-2 hrsحقیقی checker والا ایک fix لوپایک implementer draft کرتا ہے، ایک علیحدہ reviewer grade کرتا ہے، اور صرف PASS ایک PR کھولتا ہے۔
دشواری: درمیانی–مشکل · استعمال: تصور 8 (worktree)، تصور 9 (skill)، تصور 11 (maker–checker)۔
بنائیں۔ حصہ 5 کے لوپ کا ایک چھوٹا نسخہ۔ اپنے fix قدموں کے ساتھ ایک مختصر skill لکھیں، اور ایک reviewer ایجنٹ جو PASS یا FAIL کہے۔ ایک حقیقی bug لیں، implementer سے اس کا fix اپنے checkout (worktree یا branch) میں draft کروائیں، اور reviewer سے اسے grade کروائیں۔ PR صرف PASS پر کھولیں۔
مکمل جب دو باتیں دونوں سچ ہوں: ایک اچھے fix کو PASS اور ایک PR ملے، اور ایک جان بوجھ کر لگائے گئے برے fix کو وجوہات کے ساتھ FAIL ملے۔ اگر reviewer برے fix کو pass کر دے، تو آپ کا checker بہت نرم ہے — اسے سخت کریں۔ ایسا checker جو ہر چیز منظور کرے، کوئی checker نہیں۔
Project 51-1.5 hrsجسم کو باقاعدہ بنائیںپروجیکٹ 4 کی orchestration کو ایک دوبارہ چلنے والی unit بنائیں، پھر ثابت کریں کہ یہ loop نہیں۔
دشواری: درمیانی سے مشکل · استعمال: dynamic-workflows وقفہ، تصورات 8 اور 11۔
بنائیں۔ پروجیکٹ 4 کے fix loop کا جسم باقاعدہ بنائیں۔ Claude Code میں سادہ الفاظ میں کہیں: «workflow استعمال کر کے تین issues کے fixes parallel worktrees میں draft کریں، اور reviewer سے ہر ایک grade کروائیں۔» کامیاب run کو /workflows view سے /command کے طور پر save کریں۔ OpenCode میں یہی shell script سے کریں: candidates پر for loop، fan-out کے لیے &/wait، اور checker کے طور پر reviewer exit code۔ اسے دو بار چلائیں۔
مکمل جب ایک command پورا draft-and-review جسم، کئی candidates، isolated checkouts اور ہر verdict بغیر step-by-step prompting کے چلائے؛ پھر fresh session یا shell میں ثابت کریں کہ workflow پچھلے run سے کچھ یاد نہیں رکھتا۔ اسے loop بنانے کے لیے دو چیزیں بتائیں: اسے چلانے والی heartbeat، اور agents کی لکھی progress file۔
Project 645-60 mindoorbell looppull request پر خود ردعمل دینے والا loop، بغیر prompt لکھے۔
دشواری: درمیانی · استعمال: تصور 7، تصور 10۔
بنائیں۔ throwaway repo سے اپنی pull requests review کروائیں۔ OpenCode میں opencode github install چلائیں۔ Claude Code میں GitHub pull-request trigger والی Routine بنائیں؛ appendix filters سمجھاتی ہے۔ پھر planted bug، مثلا off-by-one یا حذف شدہ null check، والی PR کھولیں۔
مکمل جب PR کو ایسا review ملے جو آپ نے مانگا نہ ہو اور bug flag ہو۔ miss ہو تو prompt سخت کر کے push کریں؛ synchronize event loop دوبارہ چلاتا ہے۔ اس کے ساتھ چاروں heartbeats مکمل ہیں۔
Project 745-60 minجان بوجھ کر توڑیںاپنے loop کو sabotage کریں، پھر صرف spine سے diagnosis کریں۔
دشواری: درمیانی · استعمال: Observability، تصورات 13 اور 14۔
بنائیں۔ پروجیکٹ 3 کی ایک beat کے read/write tokens نوٹ کر کے cadence سے monthly cost نکالیں۔ پھر prompt کو non-existent file دیں یا ناممکن success condition دیں، مگر limit کے ساتھ۔ schedule پر fail ہونے دیں اور مکمل transcript replay کیے بغیر صرف log اور progress.md سے diagnosis کریں۔
مکمل جب spine سے معلوم ہو کیا اور کب ناکام ہوا، loop واضح «needs a human» note چھوڑے، اور current cadence کی ماہانہ قیمت معلوم ہو۔ خاموش failure ہو تو سب سے پہلے log line شامل کریں۔
Project 82-4 hrsآپ کا اپنا روزانہ loopحقیقی کام پر مکمل چھ حصوں والا loop، ایک ہفتہ unattended: capstone۔
دشواری: capstone · استعمال: تمام چھ حصے۔
بنائیں۔ حقیقی project میں boring recurring chore چنیں: dependency audit، docs freshness، changelog draft یا lint sweep۔ heartbeat، worktree، skill، maker-checker، connector اور spine کے ساتھ مکمل loop بنائیں، budget guards لگائیں اور چلنے دیں۔
مکمل جب ایک ہفتہ unattended چلے اور آپ output پر اس لیے بھروسہ کریں کہ آپ نے اسے پڑھا، نہ کہ پڑھنا چھوڑ دیا۔ پھر تصور 15 کا جواب دیں: کیا آپ کی understanding loop کی تبدیلیوں کے ساتھ رہی؟ نہیں تو cadence کم کریں۔ رات میں ناکام ہو، اور کبھی نہ کبھی ہوگا، تو model کو الزام دینے سے پہلے جب unattended loop ناکام ہو والا طریقہ اپنائیں۔
ضمیمہ: Routines، آغاز سے اختتام تک
یہ ضمیمہ product settings، limits، authentication اور failure cases بتاتا ہے۔ حقیقی cloud Routine configure کرتے وقت پڑھیں؛ loop engineering سمجھنے کے لیے اسے یاد کرنا ضروری نہیں۔
اصل کورس Routine کو heartbeat کی ایک قسم کہہ کر آگے بڑھتا ہے۔ یہ ضمیمہ field guide ہے: form کا ہر field، تینوں triggers، secrets رکھنے کی جگہ، اور وہ failure modes جو لوگوں کے حقیقی گھنٹے ضائع کرتے ہیں۔ یہ کورس کا سب سے mechanical حصہ ہے۔ Routines ابھی research preview ہیں، اس لیے تبدیلی متوقع ہے اور اختلاف میں official page کو درست مانیں۔ اسے پہلی حقیقی Routine بنانے کے وقت پڑھیں، پہلے نہیں۔
پہلے ایک جملے کی سمت۔ Routine محفوظ Claude Code configuration ہے: prompt، ایک یا زیادہ repositories، cloud environment اور connectors کا set، جسے ایک بار package کیا جاتا اور Anthropic کے servers پر خود چلایا جاتا ہے۔ یہ تصور 6 کی heartbeat ہے جو product بن گئی۔ Loop design آپ لاتے ہیں؛ scheduler، machine اور plumbing platform دیتا ہے۔
جلدی پڑھنے والوں کے لیے پورا ضمیمہ اس ایک table میں ہے۔ ہر row کی وضاحت نیچے کے sections میں ہے:
| default یا رویہ | خطرہ | حل |
|---|---|---|
| New-routine dialog میں "Local" | Desktop task کو cloud Routine سمجھ لینا | Remote cloud routine ہے؛ Local Desktop scheduled task ہے (A1) |
| تمام connectors شامل، writes allowed | unattended agent ہر linked tool میں عمل کر سکتا ہے | غیر ضروری connector ہٹائیں (A2) |
.env gitignored | cloud clone میں credentials نہیں | environment-variables panel استعمال کریں (A4) |
| ہر run fresh clone اور environment | loop ہر بار پہلا قدم دہراتا ہے | committed context/progress file یا external board (A4) |
| schedule floor 1 گھنٹہ | design 15-minute fires فرض کرتا ہے | زیادہ frequency کے لیے API trigger اور اپنا scheduler (A3) |
| bearer token ایک بار، deduplication نہیں | token گم یا webhook retry سے duplicate runs | فورا محفوظ کریں اور prompt repeat-safe رکھیں (A3) |
| GitHub events hourly capped، overflow dropped | event-heavy loop کام miss کرتا ہے | nightly reconciliation sweep (A3) |
matches regex پورا field دیکھتا ہے | hotfix لمبے title سے match نہیں | .*hotfix.* یا contains (A3) |
| runs آپ کی identity سے، mid-run approval نہیں | external actions آپ کے نام سے ship | دو-Routine gate (A4) |
| green status صرف infrastructure success | task failure سبز دکھ سکتی ہے | ہر run transcript پڑھیں (A5) |
A1. local session cloud Routine نہیں
Desktop app کا New routine button Remote یا Local کا انتخاب دیتا ہے، اور ان ناموں نے internet کے آدھے tutorials کو الجھایا ہے۔ Remote cloud routine بناتا ہے، جس کے بارے میں یہ appendix ہے۔ Local ایک Desktop scheduled task بناتا ہے: مختلف feature جو آپ کی machine پر حقیقی files، unsaved changes سمیت، صرف machine on رہنے تک چلتا ہے۔ اصل rule تصور 6 والا ہے۔ local files چاہییں تو Desktop task استعمال کریں۔ laptop بند ہونے کے باوجود run کی guarantee، connectors، یا API اور GitHub triggers چاہییں تو cloud Routine۔ اچھا پہلا قدم یہ ہے کہ prompt کو Desktop task یا one-off run میں ثابت کریں، پھر درست behavior دکھانے پر scheduled cloud Routine میں لے جائیں۔
A2. creation form، field بہ field
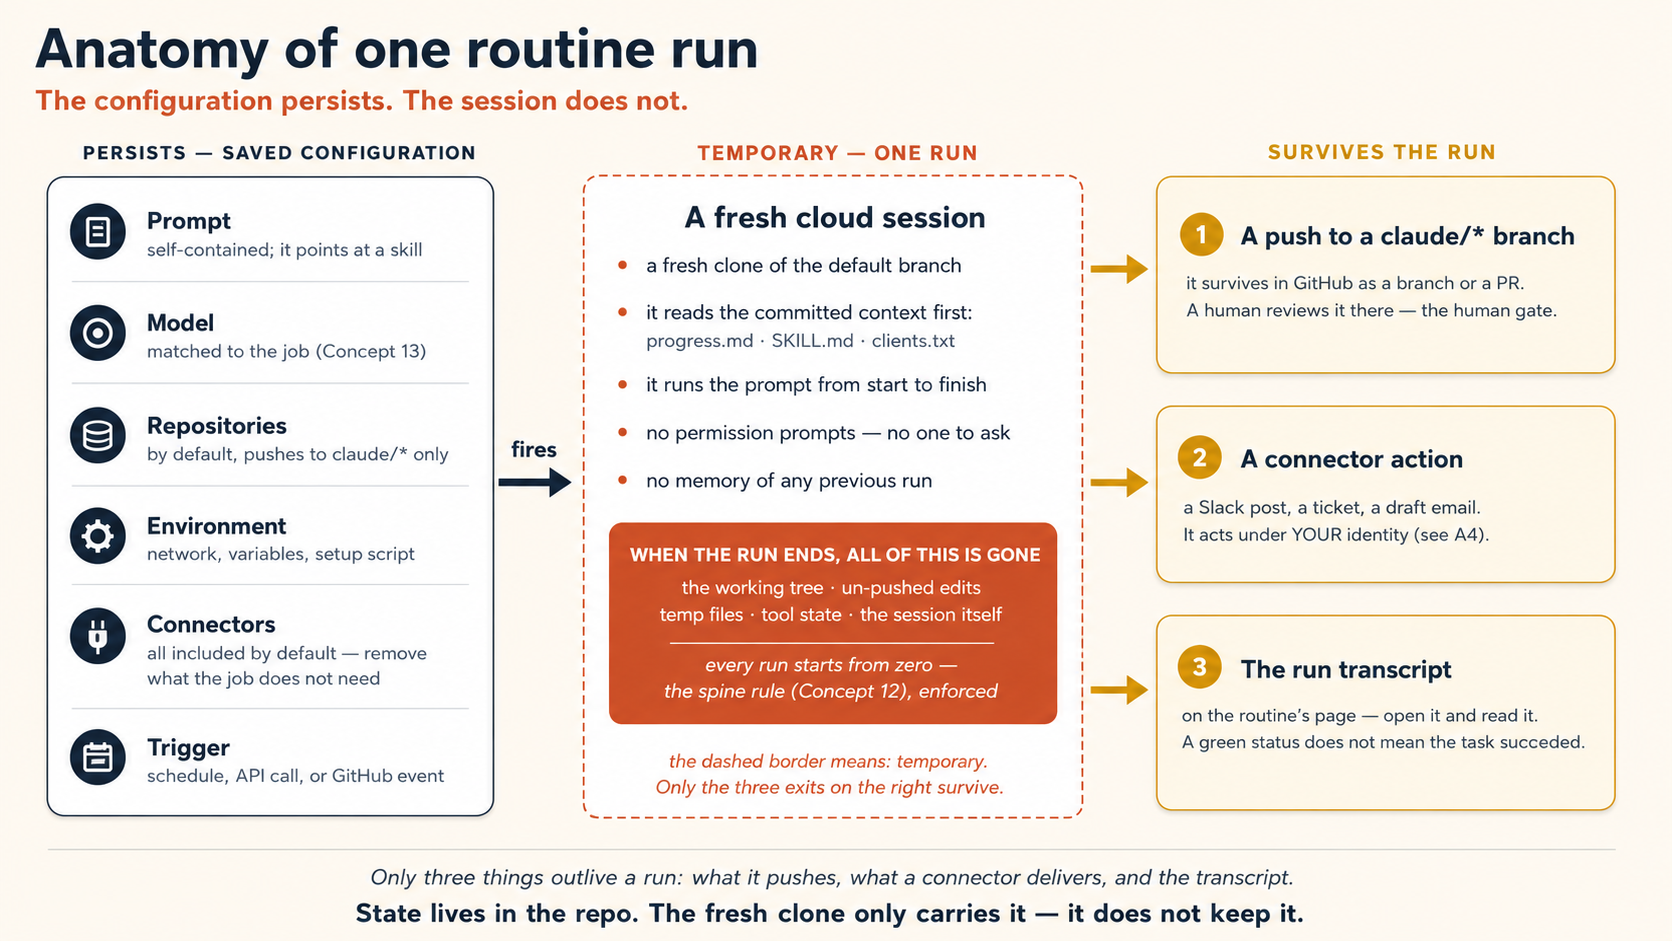
Routine claude.ai/code/routines، Desktop app میں Routines → New routine → Remote، یا CLI میں سادہ زبان کے /schedule سے بنائیں۔ تینوں ایک ہی account میں لکھتے ہیں، اور ایک جگہ بنی Routine دوسری جگہوں پر نظر آتی ہے۔ CLI صرف schedule-triggered Routines بناتا ہے؛ API اور GitHub triggers بعد میں web پر شامل ہوتے ہیں۔ /schedule list، /schedule update اور /schedule run موجودہ Routines manage کرتے ہیں۔
Name اور prompt۔ prompt پوری job description ہے اور اسے self-contained ہونا چاہیے۔ Routine مکمل autonomous cloud session کے طور پر چلتی ہے، جہاں permission prompts نہیں اور درمیان میں پوچھنے کے لیے کوئی شخص نہیں۔ اس لیے Claude کو درکار ہر چیز، یعنی کیا پڑھنا، کیا کرنا، success کیسی دکھتی ہے، اور کیا نہیں چھونا، prompt یا run کی reachable files میں ہونی چاہیے۔ یہاں کورس کا مشورہ جمع ہوتا ہے: prompt کو repo میں committed skill کی طرف اشارہ دیں (تصور 9) اور Routine کا اپنا متن چند lines رکھیں۔ prompt box میں model selector ہے۔ Routine ہر run میں وہی model استعمال کرتی ہے، اس لیے اسے job سے match کریں (تصور 13)۔
Repositories۔ ہر شامل repo default branch سے شروع ہوتے ہوئے ہر run میں fresh clone ہوتی ہے۔ default طور پر Claude صرف ان branches پر push کر سکتا ہے جن کے نام claude/ سے شروع ہوں۔ Permissions کے تحت Allow unrestricted branch pushes toggle ہر repository کے لیے یہ حد ہٹا دیتا ہے۔ unrestricted pushes بند رکھیں جب تک انہیں allow کرنے کی کوئی خاص، reviewed وجہ نہ ہو۔ خراب run میں unattended agent کا main پر push وہی خطرہ ہے جسے human gate روکنے کے لیے بنایا گیا ہے۔
Environment۔ ہر Routine cloud environment میں چلتی ہے جو تین چیزیں control کرتی ہے: network access، environment variables اور dependencies install کرنے والا setup script۔ setup کا result cache ہوتا ہے، اس لیے وہ ہر session دوبارہ نہیں چلتا۔ Default environment کا Trusted network access package registries، cloud-provider APIs، container registries اور عام development domains کی fixed allowlist دیتا ہے۔ دوسری host 403 اور x-deny-reason: host_not_allowed کے ساتھ fail ہوتی ہے۔ اپنی service درکار ہو تو environment Custom کریں اور default list کے ساتھ صرف وہ ایک domain allow کریں۔ Full access بھی موجود ہے مگر اکثر loops کی ضرورت سے زیادہ دیتا ہے۔ اسے احتیاط سے وسیع کریں۔
Connectors۔ یہاں وہ default ہے جسے ہر بار بدلنا چاہیے۔ آپ کے تمام connected claude.ai connectors default میں شامل ہوتے ہیں۔ Claude ان کے ہر tool، writes سمیت، بغیر پوچھے استعمال کر سکتا ہے۔ save سے پہلے ہر وہ connector ہٹا دیں جس کی job کو ضرورت نہیں۔ دو مزید تفصیلات۔ connector traffic Anthropic کے servers سے گزرتا ہے، اس لیے connectors network allowlist بدلے بغیر کام کرتے ہیں۔ local claude mcp add servers آپ کی machine پر رہتے ہیں، account پر نہیں، اس لیے Routine کو نظر نہیں آتے۔ انہیں claude.ai/customize/connectors پر connector کے طور پر شامل کریں، یا committed .mcp.json میں declare کریں تاکہ clone کے ساتھ جائیں۔
A3. تین triggers
Schedule۔ presets hourly، daily، weekdays یا weekly ہیں۔ وقت آپ کے local timezone میں درج ہوتا ہے اور آپ کے لیے تبدیل کیا جاتا ہے۔ جان بوجھ کر رکھے گئے وقفے کی وجہ سے runs گھنٹے کے چند منٹ بعد شروع ہو سکتے ہیں؛ کسی ایک Routine کے لیے یہ offset ہر بار ایک ہی رہتا ہے۔ ایک گھنٹہ کم از کم وقفہ ہے، اور اس سے زیادہ تیزی سے fire ہونے والی cron expressions رد کر دی جاتی ہیں۔ زیادہ frequency درکار ہو تو API trigger کے ساتھ اپنا scheduler لائیں۔ custom intervals، مثلا ہر دو گھنٹے یا مہینے کی پہلی تاریخ، کے لیے قریب ترین preset چنیں اور پھر CLI میں cron expression کے ساتھ /schedule update چلائیں۔ one-off schedule مقررہ وقت پر ایک بار fire ہو کر خود بند ہو جاتا ہے۔ one-off scheduled runs روزانہ Routine cap میں شمار نہیں ہوتے، اس لیے prompt کو مستقل schedule دینے سے پہلے آزمانے کا سستا طریقہ ہیں۔ CLI انہیں سادہ زبان میں لیتا ہے: /schedule tomorrow at 9am, summarize yesterday's merged PRs۔
API۔ API trigger Routine کو اس کا اپنا /fire endpoint اور bearer token دیتا ہے۔ token generate کرتے وقت صرف ایک بار دکھایا جاتا ہے اور بعد میں واپس حاصل نہیں کیا جا سکتا، اس لیے اسے فورا اپنے alerting tool کے secret store میں محفوظ کریں؛ اسی window سے اسے Regenerate یا Revoke کیا جا سکتا ہے۔ اب کوئی بھی system جو authenticated POST بھیج سکتا ہو Routine کو fire کر سکتا ہے: alerting webhook، deploy pipeline، form handler، یا آپ کی اپنی machine کا cron job۔ request body optional text field لیتی ہے جو کسی خاص run کا context، مثلا alert body یا failing log، saved prompt کے ساتھ Routine کو آزاد، unparsed text کی صورت میں دیتی ہے۔ response نئے session کی ID اور URL دیتا ہے، تاکہ caller براہ راست run کا link دے سکے۔
curl -X POST https://api.anthropic.com/v1/claude_code/routines/<routine-id>/fire \
  -H "Authorization: Bearer <routine-token>" \
  -H "anthropic-beta: experimental-cc-routine-2026-04-01" \
  -H "anthropic-version: 2023-06-01" \
  -H "Content-Type: application/json" \
  -d '{"text": "Sentry alert SEN-4521 fired in prod. Stack trace attached."}'
تاریخ والا beta header لازم ہے اور preview کے بدلنے کے ساتھ بدلے گا۔ docs وعدہ کرتی ہیں کہ دو تازہ ترین پچھلے versions چلتے رہیں گے، تاکہ callers کو migration کا وقت مل سکے۔
/fire endpoint میں built-in deduplication نہیں، اور webhook senders default طور پر retry کرتے ہیں۔ اس لیے دوبارہ بھیجا گیا alert duplicate run ہے، اور غلط configured alert جو ساری رات retry کرے ایسا loop بن جاتا ہے جسے آپ نے کبھی design نہیں کیا۔ مالی پہلو جتنا دکھتا ہے اس سے زیادہ سخت ہے۔ API-triggered runs روزانہ Routine allowance میں شمار ہوتے ہیں، اس لیے retry storm آپ کے جاگنے سے پہلے پورے دن کا cap استعمال کر سکتا ہے؛ metered extra usage on ہو تو cap حد نہیں رہتا بلکہ bill بن جاتا ہے۔ تصور 13 کا اصول صرف loops نہیں، triggers پر بھی لاگو ہوتا ہے۔ sender پر deduplicate یا rate-limit کریں۔ prompt کو بھی repeat-safe لکھیں، مثلا draft بنانے سے پہلے دیکھے کہ fix branch پہلے سے موجود تو نہیں۔ یہی تصور 10 کے connector rules کا سبق ہے۔
GitHub events۔ GitHub trigger connected repo پر matching event آنے پر fresh session شروع کرتا ہے۔ دو event kinds supported ہیں: pull request، جیسے opened، closed، labeled یا synchronized، اور release۔ ہر kind کسی خاص action یا تمام actions پر fire ہو سکتی ہے۔ repository پر Claude GitHub App install ہونا لازم ہے۔ یاد رکھیں کہ /web-setup clone access دیتا ہے مگر app install نہیں کرتا؛ اس فرق نے بہت سی پہلی کوششیں الجھائی ہیں۔ filters طے کرتے ہیں کہ کون سی PRs Routine کو fire کریں: author، title، body، base branch، head branch، labels، draft state اور merged state، اور operators میں contains، is one of اور matches regex شامل ہیں۔ اہم بات: matches regex پورے field کو test کرتا ہے، اس کے کسی حصے کو نہیں۔ اس لیے hotfix صرف عین hotfix title سے ملتا ہے؛ .*hotfix.* لکھیں یا صرف contains استعمال کریں۔ loop design کے لیے دو مزید حقائق اہم ہیں۔ preview میں GitHub events پر per-Routine اور per-account hourly caps ہیں، اور cap سے آگے کے events window reset ہونے تک drop ہو جاتے ہیں۔ وہ queue نہیں ہوتے، اس لیے event-heavy design کو reconciliation sweep، مثلا nightly scheduled run، درکار ہے تاکہ رہ جانے والے events پکڑے جا سکیں۔ دوسرا، ہر matching event اپنا الگ session شروع کرتا ہے۔ ایک PR پر دو pushes دو sessions ہیں جو ایک دوسرے کے بارے میں کچھ نہیں جانتے۔ GitHub کی صورت میں یہی تصور 12 کا spine lesson ہے۔
A4. secrets، state اور identity
Secrets environment variables panel میں، .env میں کبھی نہیں۔ .env gitignored ہوتی ہے، gitignored files GitHub تک نہیں پہنچتیں، اس لیے fresh cloud clone میں وہ موجود نہیں ہوتی۔ ہر key variables panel میں رکھیں اور prompt میں صاف لکھیں: "credentials are available as environment variables; do not look for a .env file." اس کے بغیر Claude عادتا .env تلاش کر سکتا ہے۔
ہر run صفر سے شروع ہوتا ہے۔ fresh clone، fresh environment، کوئی working tree، cookies یا leftovers نہیں۔ Routine کو جو کچھ یاد رکھنا ہو، run ختم ہونے سے پہلے machine سے باہر جانا چاہیے: repo میں push ہو، connector کے ذریعے external system میں لکھا جائے، یا board کی API سے بھیجا جائے۔ یہ کوئی ایسی limitation نہیں جس سے بچنا ہو؛ یہ تصور 12 کا spine rule ہے جسے infrastructure نافذ کرتی ہے۔ متعلقہ pattern کا نام ہے: repo میں context files۔ committed clients.txt، progress.md یا triage-rules.md ہر run میں پڑھی جا سکتی ہے اور prompt کو چھوئے بغیر update ہوتی ہے۔ client list بدلے تو file edit ہوتی ہے، Routine کا متن نہیں۔
Routines آپ کے طور پر عمل کرتی ہیں۔ وہ آپ کے individual account سے تعلق رکھتی، آپ کے روزانہ allowance میں شمار ہوتی، اور ان کا ہر کام، یعنی commits، PRs، Slack posts، Linear tickets اور drafted emails، آپ کی identity رکھتا ہے۔ clients کو جواب دینے والی Routine آپ کی چھٹی کے دوران بھی آپ ہی کے طور پر جواب دیتی رہتی ہے۔ کسی بھی externally visible action کو schedule کرنے سے پہلے identity کے اس پہلو پر غور کریں۔
mid-run approval نہیں۔ Routine اپنا prompt شروع سے آخر تک چلاتی ہے؛ وہ رک کر آپ سے پوچھ نہیں سکتی۔ اس لیے جب کسی فیصلے کو واقعی انسان درکار ہو، مثلا payment، باہر بھیجی جانے والی email یا deploy، gate ایک Routine کے اندر نہیں بلکہ دو Routines کے درمیان بنائیں۔ یہ تین مرحلوں میں کام کرتا ہے۔ Routine A کام draft کر کے ایسی جگہ رکھتی ہے جہاں آپ review کر سکیں: claude/ branch، Slack message یا draft email۔ انسان اسے پڑھ کر approve کرتا ہے۔ approval API trigger کے ذریعے Routine B کو fire کرتا ہے اور Routine B عمل کرتی ہے۔ یہی Part 5 کا human gate ہے، جسے دو Routines اور webhook کی صورت میں لکھا گیا ہے۔
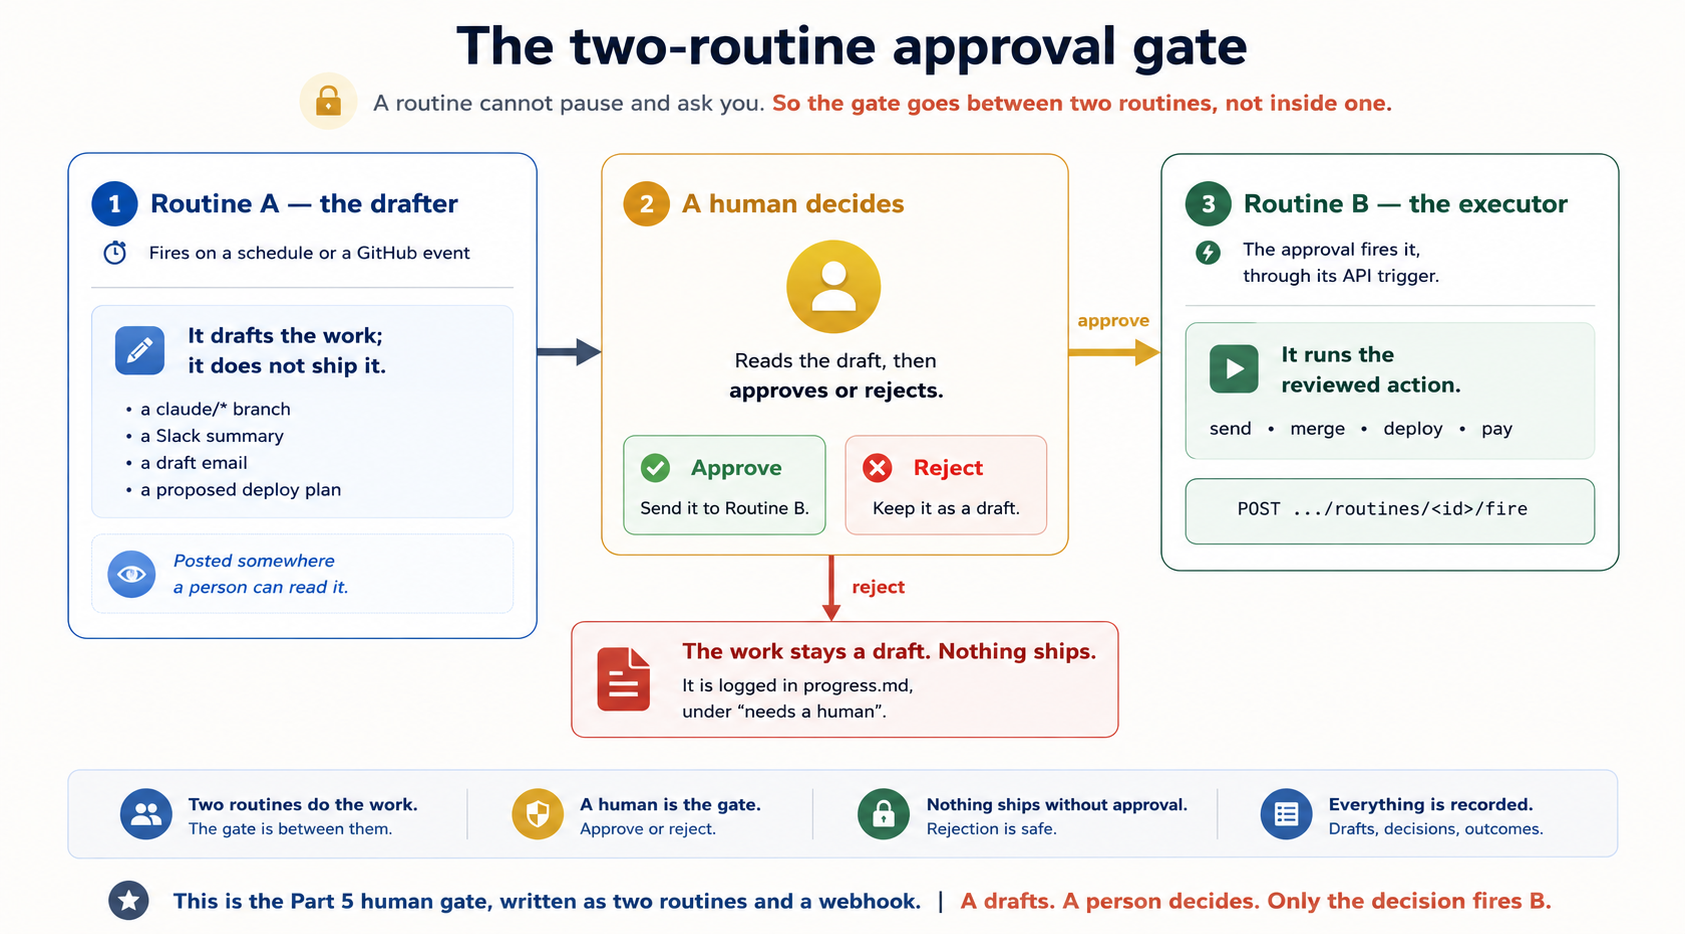
A5. runs پڑھنا
ہر run Routine کے detail page پر مکمل session کی صورت میں آتا ہے۔ transcript ہر tool call، decision اور change دکھاتا ہے، اور آپ گفتگو ہاتھ سے جاری رکھ سکتے ہیں یا نتیجے کو PR بنا سکتے ہیں۔ docs کی واضح warning، جس کی تجربہ بھی تصدیق کرتا ہے: green status کا مطلب ہے کہ session infrastructure error کے بغیر ختم ہوا۔ اس کا مطلب یہ نہیں کہ آپ کا task کامیاب ہوا۔ blocked network requests، missing connector tools اور سادہ task failures سب transcript میں ہیں، status column میں نہیں۔ run کھول کر پڑھیں۔ managed scheduler کے باوجود تصور 14 لاگو رہتا ہے۔
سادہ الفاظ میں: green کا مطلب platform نے session مکمل کیا۔ یہ requested کام کی کامیابی ثابت نہیں کرتا۔
Run now testing کے لیے فوری run شروع کرتا ہے۔ Repeats section کا pause toggle configuration مٹائے بغیر schedule روکتا ہے۔ cost کے لحاظ سے runs subscription usage سے بھی نکلتے ہیں اور روزانہ Routine cap میں شمار ہوتے ہیں۔ cap کے بعد، extra usage enabled ہو تو metered rates پر bill بنتا ہے؛ دونوں claude.ai/settings/usage پر نظر آتے ہیں۔ اگر /schedule CLI سے غائب لگے تو عام وجہ API-key یا cloud-provider authentication ہے، کیونکہ اسے claude.ai login درکار ہے؛ دوسری وجوہ telemetry بند کرنے والی environment variables یا پرانا CLI ہیں۔ web UI ہر صورت کام کرتی ہے۔
اوپر کی ہر row کا GitHub Actions میں متبادل ہے، کیونکہ OpenCode approach نے یہ مسائل پہلے ہی زیادہ سادہ parts سے حل کیے تھے۔ environment-variables panel repository secrets (secrets.ANTHROPIC_API_KEY) ہے۔ connector list committed file کا mcp section ہے جو opencode.json میں ہوتا ہے۔ schedule اور PR triggers on: schedule اور on: pull_request ہیں۔ statelessness وہی ہے، کیونکہ CI runners بھی ہر run میں تازہ ہوتے ہیں، اس لیے committed-context-file pattern جوں کا توں چلتا ہے۔ identity personal account کے بجائے GitHub App یا bot token سے آتی ہے۔ branch guardrail وہ branch protection rules ہیں جو آپ خود طے کرتے ہیں۔ نام اور configuration الگ، مگر بنیادی مسائل وہی ہیں۔ یہی course کی مرکزی دلیل ہے۔
A6. checklist کی Routine شکل
minimum safe loop checklist براہ راست لاگو ہوتی ہے۔
success condition اور limit prompt میں رہتے ہیں، کیونکہ platform روزانہ runs کو cap کرتی ہے، کسی ایک run کے نقصان کو نہیں۔ isolation claude/ branch prefix ہے، اس لیے اسے on رہنے دیں۔ read-only checker cloned repo میں defined reviewer subagent ہے۔ state file committed context file ہے، کیونکہ clone ہر بار fresh ہوتا ہے۔ human gate اوپر والا two-routine pattern ہے، یا سادہ اصول: "صرف draft PRs، کبھی merge نہیں۔" log run transcript اور ایسی جگہ connector post ہے جسے آپ واقعی دیکھتے ہیں، اور یاد رہے green کا مطلب done نہیں۔
ہر بار یہ list دیکھیں۔ ایک منٹ لگتا ہے، اور یہی فرق ہے محض پڑھے ہوئے appendix اور قابل اعتماد loop میں:
- Repositories: صرف درست repo؛ unrestricted pushes بند۔
- Prompt: self-contained، success condition اور limit سمیت۔
- Connectors: ہر غیر ضروری connector حذف۔
- Environment: secrets panel میں،
.envمیں نہیں؛ network محدود۔ - Trigger: سوچ کر منتخب، accidental high frequency نہیں، retry-safe۔
- State: committed progress/context file یا external board۔
- Human gate: draft only؛ direct merge، deploy، payment یا client send نہیں۔
- Test run: one-off یا Run now، پھر status color نہیں بلکہ transcript پڑھیں۔
مشق: تین Routine drills
field guide پڑھنا اور form میں خود click کرنا ایک بات نہیں۔ یہ تین drills جان بوجھ کر appendix کے اہم ترین failure cases ایک throwaway repo میں دوبارہ پیدا کرتی ہیں، تاکہ قیمت اور خطرہ کم ہونے کے دوران آپ ہر مسئلہ خود دیکھ سکیں۔ انہیں روزانہ run cap کے مطابق بھی بنایا گیا ہے۔ پہلی drill one-off runs استعمال کرتی ہے، جو cap میں شمار نہیں ہوتے۔ باقی دو کو مجموعی طور پر تقریبا پانچ runs چاہییں، یعنی Pro cap کا ایک دن۔ main projects کے دو اصول اب بھی لاگو ہیں: throwaway repo استعمال کریں، اور limits پہلے طے کریں۔
(اس section کے آخر میں Project 12 drill نہیں۔ یہ Projects 3 یا 8 پر بننے والا دوسرا capstone ہے اور weekly چلتا ہے، اس لیے اس کے runs الگ plan کریں۔) مشکل: آسان · استعمال: A1، A3 (one-off schedules)، A5 (runs پڑھنا)۔ بنائیں۔ throwaway repo میں ایک ایسی Routine بنائیں جس کا prompt ایک چھوٹا، قابل جانچ کام کرے، مثلا کل کے commits کا خلاصہ مکمل تب ہے جب آپ دو green runs دیکھ چکے ہوں: ایک جس کا transcript success دکھائے، اور دوسرا جس کا transcript failure دکھائے۔ آپ ایک جملے میں بتا سکیں کہ status column ان دونوں میں فرق کیوں نہیں بتا سکا۔ یہی A5 کا سبق ہے: green کا مطلب صرف یہ ہے کہ session infrastructure error کے بغیر ختم ہوا، اس سے زیادہ کچھ نہیں۔ مشکل: آسان سے درمیانی · استعمال: A4 (secrets)، A2 (environment)۔ بنائیں۔ ایسا prompt لکھیں جسے ایک secret درکار ہو۔ dummy token کافی ہے، کیونکہ drill اس بات پر ہے کہ value کہاں رہتی ہے، نہ کہ یہ کیا کھولتی ہے۔ پہلے run میں token کو gitignored مکمل تب ہے جب دوسرا run environment سے token پڑھ لے، اور آپ پہلے run کی failure کی mechanical وجہ سمجھا سکیں: gitignored files کبھی GitHub تک نہیں پہنچتیں، اس لیے fresh cloud clone میں وہ موجود نہیں ہوتیں۔ مشکل: درمیانی سے مشکل · استعمال: A3 (API trigger)، A4 (gate)، A6 (checklist)۔ بنائیں۔ one-off schedule پر Routine A کوئی reviewable چیز draft کرے: مکمل تب ہے جب تین باتیں درست ہوں: B صرف آپ کے fire کرنے کی وجہ سے چلی؛ B کا transcript دکھائے کہ action واقعی ہوا؛ اور آپ دونوں Routines پر A6 checklist چلا چکے ہوں، غیر ضروری connectors حذف ہوں، unrestricted pushes بند ہوں، اور state file منتخب ہو۔ یہ Part 5 کا human gate ہے، اور اب آپ نے اسے حقیقی حصوں سے بنایا ہے۔ مشکل: capstone · استعمال: Concept 12 (spine اور improvement loop)، Concept 11 (maker-checker)، Concept 6 (schedule)، Part 5 (human gate)۔ بنائیں۔ آپ کو ایک ایسا loop چاہیے جو ایک ہفتہ چل چکا ہو اور مکمل تب ہے جب تین باتیں درست ہوں۔ PR کی proposed change حقیقی، cited log entries تک واپس جاتی ہو، محض قابل یقین اندازہ نہ ہو۔ logs میں جان بوجھ کر لگائی گئی repeated failure، جسے آپ ہاتھ سے شامل کریں، پکڑی جائے اور proposal بنے۔ اور آپ کے merge کیے بغیر rules file میں کچھ نہ بدلے۔ اگر loop evidence کے بغیر تبدیلیاں تجویز کرے تو prompt سخت کریں: اندازہ لگانے والا improvement loop نہ ہونے والے improvement loop سے بدتر ہے، کیونکہ اس کے اندازے ہر آئندہ run کی سمت بدلتے ہیں۔Project 920-30 minRoutine مفت rehearse کریںschedule سے پہلے one-off runs سے prompt ثابت کریں۔
claude/summary branch پر لکھنا۔ اسے repeating schedule پر نہ رکھیں۔ one-off run (/schedule tomorrow at 9am, … یا Run now) سے چلائیں اور status column کے بجائے پورا transcript پڑھیں۔ پھر prompt کو اس طرح بدلیں کہ task لازما fail ہو، مثلا ایسی file پڑھنے کو کہیں جو موجود نہیں، اور ایک بار پھر چلائیں۔Project 1030-45 minsecrets drill.env والی failure جان بوجھ کر ایک بار دیکھیں۔
.env file میں رکھیں اور Routine چلائیں۔ دیکھیں کہ اسے value نہیں ملتی، اور transcript پڑھیں کہ Claude نے اس کے بجائے کیا آزمایا۔ دوسرے run میں token کو environment-variables panel میں منتقل کریں، اور prompt میں appendix کی تجویز کردہ ایک line شامل کریں: "credentials environment variables کی صورت میں دستیاب ہیں؛ .env file نہ ڈھونڈیں۔"Project 111-2 hrsدو-Routine gate بنائیںA draft کرے، آپ فیصلہ کریں، صرف فیصلہ B کو چلائے۔
claude/ branch، یا connector کے ذریعے بھیجا گیا مختصر خلاصہ۔ Routine B کا API trigger ہو اور وہ ایک چھوٹا follow-up action کرے۔ B کا bearer token دکھتے ہی محفوظ کریں، کیونکہ یہ صرف ایک بار دکھایا جاتا ہے۔ A کا draft خود review کریں۔ پھر A3 والی curl call سے B کو fire کر کے approve کریں۔Project 122-3 hrsdreaming loop بنائیںweekly loop جو دوسرے loops کے logs پڑھ کر rule changes کی PR تجویز کرے۔
progress.md میں date والی entries چھوڑ چکا ہو؛ Project 3 یا Project 8 یہ بنیاد دیتا ہے۔ اب اس کے اوپر دوسرا loop بنائیں۔ weekly schedule پر یہ اپنی dreaming-state.md میں محفوظ تاریخ کے بعد کی تمام log entries پڑھے، ایسی failure یا correction ڈھونڈے جو ایک سے زیادہ بار آئی ہو، اور اس سے بچانے والی سب سے چھوٹی rules-file یا skill تبدیلی claude/ branch کی PR کے طور پر draft کرے، direct commit کبھی نہیں۔ PR description میں evidence لازم ہو: کون سے runs، کتنی بار، اور یہ line مسئلہ کیوں روکے گی۔ اس سے ایک deletion بھی تجویز کروائیں: ایسا rule جس کی کسی حالیہ run کو ضرورت نہیں پڑی۔ آخر میں dreaming-state.md update کریں۔
آگے کہاں جائیں
- ایک سے زیادہ loops چلا رہے ہیں؟ جیسے ہی دو loops کام یا state کا تبادلہ کریں، آپ کو wiring اور مشترک memory درکار ہوتی ہے۔ اس سلسلے میں دو قدم آگے Graph Engineering دونوں موضوعات سمجھاتا ہے۔
- غیر coding کام کے لیے loops بنا رہے ہیں؟ Cowork & OpenWork crash course professionals کے لیے یہی heartbeat تصور دکھاتا ہے، جہاں cron کے بجائے scheduled tasks ہوتے ہیں۔
- terminal کے بجائے API سے loops چلا رہے ہیں؟ Claude Platform کے Managed Agents scheduled deployments کی سہولت دیتے ہیں: agent کو cron schedule دیں، اور ہر firing Anthropic کے infrastructure پر تازہ session شروع کرتی ہے؛ آپ کو scheduler بنانا یا host نہیں کرنا پڑتا۔ یہ Routines کا تصور بطور platform primitive ہے۔ schedule heartbeat، prompt beat، اور spine اب بھی آپ فراہم کرتے ہیں۔
- improvement loop بھی managed چاہیے؟ Managed Agents platform میں memory اور dreaming tooling بھی ہے، یعنی تصور 12 کے note والا out-of-band improvement pass بطور product۔ شکل وہی ہے: batch job heartbeat، memory store spine، اور approval step انسانی gate ہے۔
- checker بھی managed چاہیے؟ دو research previews verification-skills interlude کو products بناتے ہیں۔ Code Review منتخب repos کے ہر PR پر managed multi-agent review چلاتا ہے، اور Rubrics in Claude Managed Agents (beta) تصور 2 کے rubric-with-a-bar کو platform primitive بناتا ہے: الگ grader agent outcome verify کرتا اور ناکام کام نئی کوشش کے لیے واپس بھیجتا ہے۔ model کے grade پر کتنا اعتماد کیا جائے، یہ Trusting the Checker course میں ہے۔
- unattended runs کی retries tune کرنا چاہتے ہیں؟ Claude Code کی Error reference automatic retry settings بیان کرتی ہے، جن میں
CLAUDE_CODE_MAX_RETRIESاور CI طرز کے unattended sessions کے لیےCLAUDE_CODE_RETRY_WATCHDOGmode شامل ہیں۔ - clone-and-run نقطۂ آغاز چاہیے؟ community repo cobusgreyling/loop-engineering (MIT) کئی agent CLIs کے لیے production loop patterns کو readiness checklist سمیت starter kits کی صورت میں جمع کرتا ہے۔ یہ third-party اور نیا ہے، اس لیے دیکھیں کہ maintained ہے۔ اس کی primitives table اسی کورس کے چھ حصوں کو دوسرے ناموں سے بیان کرتی ہے۔ مزید مطالعے کے لیے Hugging Face پر community-curated awesome-loop-engineering collection بنیادی مضامین ایک جگہ جمع کرتی ہے۔
- Spec-Driven Development میں لکھی spec ہی loop کی stopping condition ہے: اس کے acceptance criteria وہ ہیں جن کے خلاف checker grade کرتا ہے اور جنہیں
/goalرکنے سے پہلے ثابت کرتا ہے۔ اگر loop کو اکیلا چھوڑنا غیر محفوظ لگے تو حل عموما زیادہ واضح spec ہے، زیادہ automation نہیں۔
Sources & further reading
یہ کورس چند بنیادی sources پر قائم ہے۔ Framing اور quotes انہی سے آئے ہیں، جبکہ technical details official docs سے لی گئی ہیں۔
«loop engineering» کی ابتدا
- Addy Osmani، Loop Engineering: وہ essay جس نے pattern کو نام دیا اور five-parts-plus-spine model پیش کیا۔ https://addyosmani.com/blog/loop-engineering/
- Avi Chawla، Loop Engineering, Clearly Explained: inner-loop anatomy، چار nested engineering layers، یعنی prompt → context → harness → loop، doom-loop framing، اور loops کے tool-design rules۔ https://www.dailydoseofds.com/p/loop-engineering-clearly-explained/
- Data Science Dojo، The 4 Layers of AI Engineering: ہر layer کے لیے ایک failure mode اور "آپ اب بھی کون سی layer ہاتھ سے کر رہے ہیں؟" والا self-check، جسے تصور 1 کے note میں اپنے الفاظ میں پیش کیا گیا ہے۔ https://www.facebook.com/share/p/1HCxfwo5aC/
- Rakesh Gohel، How to Actually Use Fable 5 infographic: self-learning اور self-improving کا فرق، اور prompt کو مزید زور سے لکھ کر پھر صفر سے شروع کرنے کے مقابلے میں run، log، distill، repeat؛ تصور 12 کے note میں اسی کا مفہوم بیان ہوا ہے۔ https://rakeshgohel.substack.com
- Sydney Runkle (LangChain)، The Art of Loop Engineering: four-loop stack، یعنی agent، verification، event-driven اور hill-climbing؛ trace-driven improvement loop؛ اور swyx کی stacked loops والی "loopcraft" framing۔ https://www.langchain.com/blog/the-art-of-loop-engineering
- Lamis (Anthropic، Applied AI)، Context Engineering: Memory and Dreaming، AI DevCon 2026 talk: in-band اور out-of-band memory کا فرق، dreaming consolidation process، shared memory stores کے production guardrails جنہیں تصور 14 کے note میں بیان کیا گیا، اور school/head-teacher analogy جسے تصور 12 کے note میں اپنے الفاظ میں پیش کیا گیا۔ https://www.youtube.com/watch?v=tQ41RxfZZVg
- Letta، Charles Packer، Sarah Wooders اور ساتھی، Sleep-time Compute، April 2025 paper اور blog: dreaming idea کی پہلی productized شکل، جس میں MemGPT lineage کا background agent idle وقت primary agent کی memory دوبارہ لکھتا ہے؛ ساتھ یہ caveat بھی کہ offline consolidation تبھی فائدہ دیتی ہے جب future tasks past tasks سے ملتی ہوں۔ https://www.letta.com/blog/sleep-time-compute/
- Stanford، SambaNova اور UC Berkeley، Agentic Context Engineering (ACE): repeated memory rewriting کے دو failure modes، brevity bias اور context collapse، اور dreaming note میں بیان کیا گیا حل، یعنی monolithic rewrite کے بجائے incremental delta updates۔ https://arxiv.org/abs/2510.04618
- OWASP، Top 10 for Agentic Applications (2026): Memory and Context Poisoning کو الگ agentic threat کے طور پر define کرتا ہے، جہاں injected content memory میں باقی رہتا اور اصل attack ختم ہونے کے بعد بھی behavior بدلتا ہے۔ Dreaming note کی poisoning warning کی بنیاد یہی ہے۔
- Simon Willison، Designing agentic loops، September 2025: یہ اولین صاف بیان کہ اصل skill agent کو drive کرنا نہیں بلکہ loop design کرنا ہے۔ یہ اصطلاح سے بھی پہلے آیا۔ https://simonwillison.net/
- TrueFoundry، Loop Engineering at Enterprise Grade: failure-stacking math، loop کے حصوں کو standing permissions سمجھنے کی framing، اور team-scale inventory problem۔ یہ تصور 14 کے note میں مذکور governance analyses کی نمائندہ مثال ہے۔ https://www.truefoundry.com/blog/loop-engineering-enterprise-agent-runtime
- The New Stack، "The Anthropic leader who built Claude Code says he ditched prompting — now he just writes loops۔" https://thenewstack.io/loop-engineering/
- Boris Cherny کا "my job is to write loops" remark CNBC interview سے ہے، جیسا Business Insider نے report کیا۔ Peter Steinberger کی "design loops that prompt your agents" line ان کی X post سے ہے۔
- Andrew Ng: تین product-development loops، یعنی minutes میں coding، hours میں developer feedback، اور days میں external feedback؛ ساتھ "taste" کو انسان کے context advantage کے طور پر دوبارہ frame کرنا۔ ان کی X post سے۔ https://x.com/AndrewYNg/status/2071988145667928442
- Andrej Karpathy: "اسے یہ نہ بتائیں کہ کیا کرنا ہے، success criteria دیں اور اسے چلتے دیکھیں،" اور AutoResearch project، جس میں agent training script بدلتا، نتیجہ measure کرتا، اور کامیاب تبدیلی رکھتا ہے، جبکہ rounds کے درمیان انسان edit نہیں کرتا۔ ان کی X posts سے۔
Claude Code (official docs)
- Routines: cloud scheduled automations، triggers، run caps، اور ہر plan کی daily limits والا launch announcement۔ https://code.claude.com/docs/en/routines اور https://claude.com/blog/introducing-routines-in-claude-code
- Channels: چلتے ہوئے session میں event-driven input۔ https://code.claude.com/docs/en/channels
- Scheduled tasks:
/loop، cron tools، Desktop tasks اور background-session carryover rule۔ https://code.claude.com/docs/en/scheduled-tasks - Changelog: وہ جگہ جہاں background sessions، retry watchdog،
ultracoderename اور اس chapter کی دوسری mechanical details سب سے پہلے supersede ہوتی ہیں۔ https://code.claude.com/docs/en/changelog - Memory:
CLAUDE.md، auto memory اور Auto Dream research preview کے پیچھے consolidation pass۔ https://code.claude.com/docs/en/memory - Delba de Oliveira، Anthropic Claude Code team، Building verification loops in Claude Code with skills، 22 July 2026: verification-skills interlude کا source؛ checks کو skills میں package کرنا، چار deployment homes، یعنی standalone، embedded، chained اور on-every-PR؛ graduation signals؛ ایسی skills کے لیے wrapper-skill pattern جنہیں آپ edit نہیں کر سکتے؛ Anthropic کی اندرونی
/code-review→/simplify→/verify→/designchain؛ اور Managed Agents میں/verify، Code Review اور Rubrics کے pointers۔ https://claude.com/blog/building-verification-loops-in-claude-code-with-skills - Code Review اور Managed Agents میں Rubrics لکھتے وقت research preview یا beta ہیں۔ Availability یا behavior پر انحصار کرنے سے پہلے live docs دیکھیں۔
OpenCode (official docs)
- CLI:
opencode run،serveاور--attach۔ https://opencode.ai/docs/cli/ - Agents اور subagents: primary agents، subagents، اور ہر agent کے الگ models۔ https://opencode.ai/docs/agents/
- GitHub integration: Action، schedule، PR اور issue triggers، اور
opencode github install۔ https://opencode.ai/docs/github/
Model identifiers
- Anthropic، What's new in Claude Sonnet 5:
claude-sonnet-5model string، Sonnet 4.6 سے direct migration، adaptive-thinking default، اور نیا tokenizer۔ https://platform.claude.com/docs/en/about-claude/models/whats-new-sonnet-5 - Anthropic، Model IDs and versioning: 4.6 generation سے dateless IDs pinned snapshot ہیں؛ Sonnet 5 جیسے major-version releases minor segment چھوڑ دیتے ہیں؛ اور Haiku 4.5 جیسے 4.5-generation models dated canonical ID، یعنی
claude-haiku-4-5-20251001، کے ساتھ dateless alias رکھتے ہیں۔ https://platform.claude.com/docs/en/about-claude/models/model-ids-and-versions - Anthropic، Introducing Claude Fable 5 and Mythos 5: Opus سے اوپر flagship generation جو 2026 کے وسط میں جاری ہوئی، اور یاد دہانی کہ اس chapter کے model examples صرف illustrations ہیں، frontier نہیں۔ https://www.anthropic.com/news/claude-fable-5-mythos-5
تمام links July 2026 کے آغاز تک موجودہ تھے۔ یہ tools اکثر update ہوتے ہیں، اس لیے کسی خاص limit، flag یا model string پر انحصار کرنے سے پہلے live docs سے تصدیق کریں۔
ایک لائن کا خلاصہ
اپنے ایجنٹ کو turn بہ turn prompt کرنا بند کریں۔ وہ لوپ ڈیزائن کریں جو آپ کی جگہ اسے prompt کرے — ایک دھڑکن، چار کام کرنے والے حصے، اور ایک ریڑھ کی ہڈی جو یاد رکھے — اور وہ انجینئر بنے رہیں جو پڑھتا ہے کہ یہ کیا شپ کرتا ہے۔