گراف انجینئرنگ: ایک فوری کورس
16 تصورات · ایک لوپ کی ریڑھ کی ہڈی سے اس گراف تک جسے ہزار ایجنٹس مشترکہ طور پر استعمال کریں
آپ کا لوپ کام کرتا ہے۔ یہ ہر صبح 9 بجے چلتا ہے، harness اسے حدود میں رکھتا ہے، اور اس کی ریڑھ کی ہڈی، یعنی ایک progress.md فائل، کل سیکھی ہوئی بات آج تک پہنچاتی ہے۔ ایک لوپ، ایک یادداشتی فائل۔ یہ کافی تھا۔
اب دیکھیں کامیابی کے بعد کیا ہوتا ہے۔ آپ دوسرا لوپ جوڑتے ہیں، پھر جائزے کا لوپ۔ اس کے بعد کسی مصروف ہفتے میں بیس فائلوں کا ایک ساتھ audit کرنے کے لیے بیس ایجنٹس پھیلا دیتے ہیں۔ ہر ایجنٹ خالی سیاقی کھڑکی سے شروع ہوتا ہے۔ ہر ایک وہ بات دوبارہ دریافت کرتا ہے جو دوسرا ایجنٹ ایک گھنٹہ پہلے تلاش کر چکا تھا۔ ہر ایک اپنی دریافتیں ایسی گفتگو میں لکھتا ہے جسے کوئی دوسرا ایجنٹ کبھی نہیں پڑھے گا۔ کام بڑھ گیا، یادداشت نہیں۔ آپ نے مشترک دماغ کے بغیر ایک ٹیم بنا دی۔
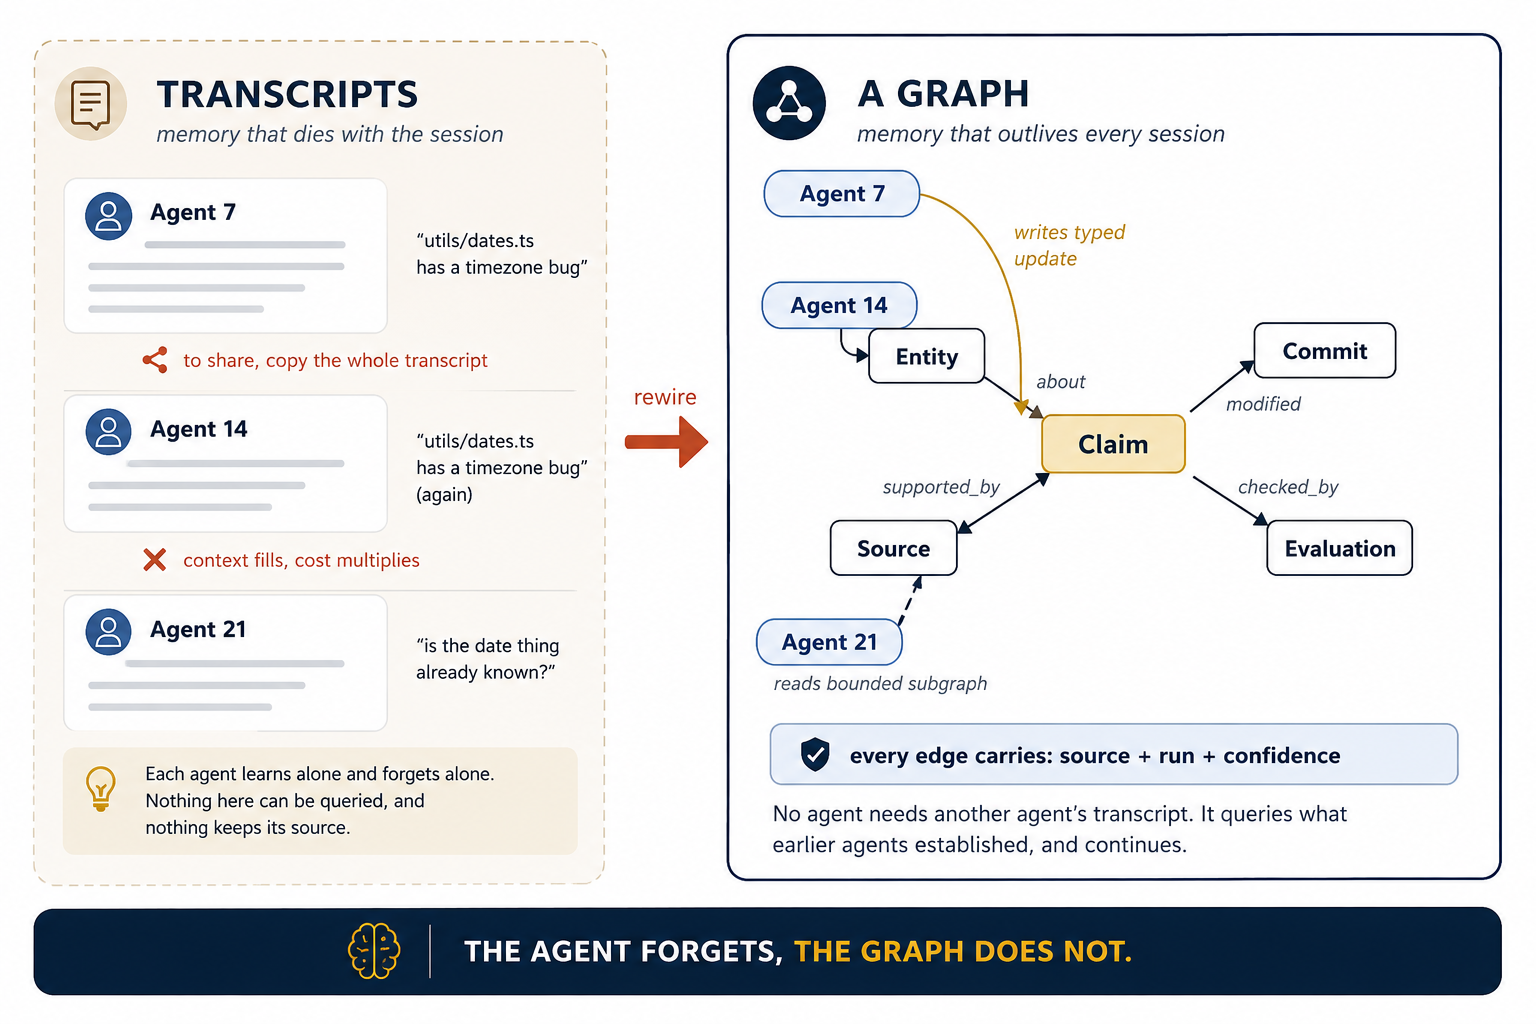
یہی مسئلہ گراف انجینئرنگ حل کرتی ہے۔ خیال ایک جملے کا ہے: ایجنٹ بھول جاتا ہے، گراف نہیں بھولتی۔ ایجنٹس کی سیکھی ہوئی باتیں ان کی گفتگو میں چھوڑنے کے بجائے، آپ انہیں باقاعدہ اقسام والے مربوط ریکارڈز، یعنی nodes اور edges، کی صورت میں لکھواتے ہیں جنہیں کوئی بھی بعد کا ایجنٹ query کر سکے۔ دو گراف یہ کام کرتی ہیں۔ کام کا commit DAG یاد رکھتا ہے: کیا آزمایا گیا، کیا کس سے نکلا، اور کیا برقرار رکھا گیا۔ حقائق کی knowledge graph یاد رکھتی ہے: کون سی entities موجود ہیں، وہ کیسے جڑی ہیں، اور ہر دعوے کو کون سا ماخذ ثابت کرتا ہے۔ یہ کورس دونوں سکھاتا ہے اور 2026 کی واضح ترین دستاویزی مثالیں استعمال کرتا ہے: پہلے کے لیے Andrej Karpathy کا autoresearch اور AgentHub، دوسرے کے لیے Anthropic کی Knowledge Graph Construction Cookbook اور Dynamic Workflows۔ چونکہ لوپس کو بھی wiring چاہیے، حصہ 5 تیسری گراف، governance graph، شامل کرتا ہے: کون کس کو جانچتا ہے، کس کا ہدف کس کے پاس ہے، اور کن پیمائشوں سے کوئی لوپ بحث نہیں کر سکتا۔
پہلے یہ کورس درکار ہیں: لوپ انجینئرنگ اور Harness Engineering۔ لوپ کورس نے beat، ریڑھ کی ہڈی، maker-checker تقسیم، اور ratchet سکھائے۔ Harness کورس نے پانچ افعال اور typed output سکھایا۔ موجودہ کورس فرض کرتا ہے کہ آپ یہ سب جانتے ہیں۔ ریڑھ کی ہڈی ایک لوپ کی نجی یادداشت تھی۔ یہ کورس دکھاتا ہے کہ کئی ایجنٹس کو یادداشت بانٹنی ہو تو وہ کیا بن جاتی ہے۔ اگر یہ الفاظ نئے ہیں تو پہلے وہ کورس کریں۔
📚 تدریسی معاونت
مکمل پریزنٹیشن دیکھیں: گراف انجینئرنگ: ایک فوری کورس
نیچے دی گئی دس شکلیں اسی ترتیب سے سکھانے کے لیے بنائی گئی ہیں: ہر شکل ایک تصور اٹھاتی ہے اور سلائیڈ پر اکیلی بھی سمجھی جا سکتی ہے۔
نیچے ہر تصور کے ساتھ ایک script ہے جسے صرف پڑھنا نہیں بلکہ چلا کر دیکھنا بھی ممکن ہے۔ ان کے لیے bash، git، jq اور python3 درکار ہیں، اور کچھ نہیں: نہ API key، نہ pip install، نہ network۔
git clone https://github.com/panaversity/agentfactory-labs.git
cd agentfactory-labs/crash-course/graph-eng
./verify.sh      # runs all 17 demos and asserts each one
جب نتیجے میں Everything in this course runs. آئے تو فولڈر اس صفحے کے ساتھ کھلا رکھیں۔ ہر تصور اس ایک کمانڈ پر ختم ہوتا ہے جو اسے عملی طور پر دکھاتی ہے: آپ git reset کو commit مٹاتے، schema کو خراب جواب رد کرتے، checker کو غائب edge مانگتے، اور pre-commit gate کو schema violation روکتے دیکھیں گے۔ تجربہ گاہ کی README ہر تصور کو اس کے demo سے جوڑتی ہے۔
اگر ان میں کوئی بات نئی ہے تو پہلے لوپ انجینئرنگ اور Harness Engineering کورس پڑھیں۔ موجودہ کورس ان کی بنائی ہوئی مشینری کو جوڑتا ہے۔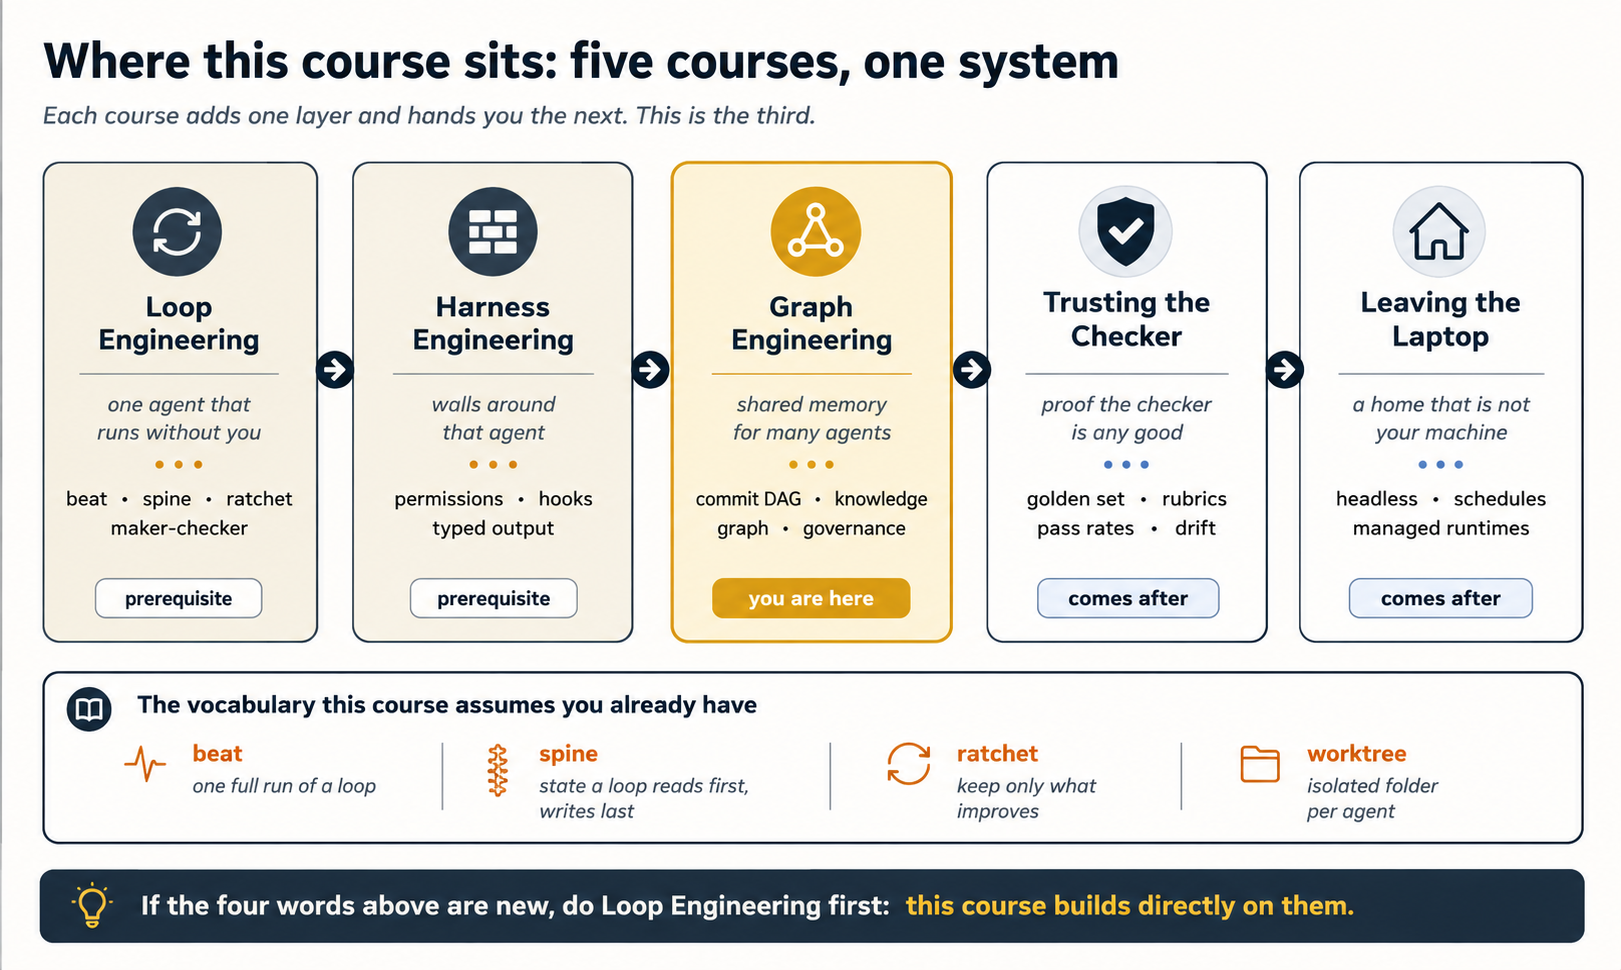
یہاں نئے ہیں؟ پہلے سے معلوم باتوں کا 2 منٹ کا خلاصہ
progress.md، جسے لوپ پہلے پڑھتا اور آخر میں لکھتا ہے تاکہ اگلا beat جان سکے کیا ہوا۔main تک نہیں پہنچتی۔
اہم الفاظ، سادہ زبان میں
یہ الفاظ پورے کورس میں ملیں گے۔ فہرست ابھی ایک بار پڑھیں، پھر جب کوئی اصطلاح غیر واضح لگے تو یہاں واپس آئیں۔
| اصطلاح | سادہ مطلب |
|---|---|
| گراف | نقاط، یعنی nodes، کا مجموعہ جو تیروں، یعنی edges، سے جڑا ہو۔ تیروں کی سمت ہوتی ہے اور سمت معنی رکھتی ہے۔ |
| نوڈ | گراف کا ایک نقطہ: اکائی، دعویٰ، commit، ماخذ یا ایجنٹ اجرا۔ |
| ایج | دو نوڈز کے درمیان نام دار تیر: supports، parent_of، produced، works_for۔ |
| گراف DAG | سمت دار غیر دوری گراف: تیر کبھی گھوم کر اپنے پاس واپس نہیں آتے۔ گٹ کی تاریخ ایک DAG ہے۔ |
| کام کا DAG | کام کا گراف: commits نوڈز اور والد روابط ایجز ہیں۔ یہ جواب دیتا ہے: "کیا آزمایا گیا، اور کیا کس سے نکلا؟" |
| علمی گراف | حقائق کا گراف: اکائیاں نوڈز اور قسم دار تعلقات ایجز ہیں۔ یہ جواب دیتا ہے: "کیا موجود ہے، اور کیسے جڑا ہے؟" |
| اکائی | ایسی چیز جسے گراف درج کرتا ہے: شخص، کمپنی، فائل، فروخت کنندہ یا واقعہ۔ |
| تعلق / ٹرپل | فاعل، تعلق اور مفعول کی صورت میں ایک حقیقت: (Vendor X, supplied, Component Z)۔ |
| ظاہری نام | نام عین اسی طرح جیسے دستاویز میں نظر آئے: "Edwin Aldrin"، "Buzz"، "Col. Aldrin"۔ تین ظاہری نام، ایک شخص۔ |
| اکائی کی تطبیق | یہ طے کرنا کہ کون سے ظاہری نام ایک ہی حقیقی چیز ہیں، اور اصل نام کھوئے بغیر انہیں ایک canonical node میں ملانا۔ |
| ماخذی سراغ | دعوے کے ساتھ رسید: کس ماخذ نے کہا، کس اجرا نے نکالا، اور اخذ پر کتنا اعتماد تھا۔ |
| دعویٰ | ایسا بیان جسے گراف ممکنہ طور پر درست سمجھ کر محفوظ کرے، ہمیشہ ماخذی سراغ کے ساتھ، کبھی مطلق سچ کے طور پر نہیں۔ |
| ذیلی گراف | ایک کام کے لیے گراف کا چھوٹا، متعلقہ حصہ۔ ایجنٹس کو ذیلی گراف دیں، پورا گراف کبھی نہیں۔ |
| ثبوت سے ربط | جواب یا فیصلے کو اپنے تاثر کے بجائے گراف کی حقیقی ایجز کی طرف اشارہ کرنے پر مجبور کرنا۔ |
| ایجنٹوں کا جھنڈ | بہت سے ایجنٹس ایک ہی وقت دریافت، عمل درآمد یا جائزہ لیتے ہیں۔ |
| ساختی نتیجہ | Pydantic model جیسی مقررہ ساخت تک محدود ماڈل کا جواب، تاکہ کوڈ بھروسا کرنے سے پہلے اسے جانچ سکے۔ |
| پروٹوکول MCP | Model Context Protocol: ایجنٹ کے بیرونی نظام تک پہنچنے کا معیاری طریقہ۔ گراف فائلوں میں ہو تو ضرورت نہیں؛ ڈیٹابیس بنے تو یہی جواب ہے۔ |
| نگران گراف | ایسا گراف جس کے نوڈز خود لوپس، انسانی دروازے اور لنگر ہوں، اور ایجز بتائیں کون کس کو مواد دیتا، جانچتا اور محدود کرتا ہے۔ |
| عملی لوپ | بار بار ہونے والا کام کرنے والا لوپ: مسائل کی چھان بین، پی آر کا جائزہ، تبدیلیوں کے اندراج کا مسودہ۔ |
| بہتری کا لوپ | ہدف کے مقابلے میں عدد دیکھنے اور کام کرنے والے نظام کو بدلنے والا لوپ۔ |
| جوابی پیمانہ | دوسرا عدد جسے دوسرا لوپ دیکھتا اور پہلے عدد سے کھیلنے کا عمل پکڑتا ہے۔ |
| حقیقت کا لنگر | ایسی پیمائش جس سے کوئی لوپ بحث نہیں کر سکتا: واقعی چلا ٹیسٹ، واقعی رکا صارف، واقعی آئی آمدنی۔ |
| منجمد نوڈ | ایسا اصول یا فائل جسے بہتر بنانے والے لوپس کبھی نہیں بدل سکتے، عین اس لیے کہ وہ بدلنا چاہیں گے۔ |
لوپ کورس نے جسم کی مثال دی تھی: heartbeat، جسم، ریڑھ کی ہڈی۔ موجودہ کورس ایک اور اضافہ کرتا ہے: گراف مشترک دماغ ہے، ایسی یادداشت جو کسی ایک ایجنٹ کی سیاقی کھڑکی سے زیادہ دیر زندہ رہتی ہے۔
مختصر بات: بنیادی کام حقیقی اور عوامی ہے، مگر اس کی viral پیش کش غلط ہے۔ "Anthropic کے دو seniors کی 11-page PDF" ایک آزاد مطالعہ نوٹ ہے جو اپنے پہلے صفحے پر صاف کہتی ہے کہ وہ Karpathy یا Anthropic سے منسلک یا منظور شدہ نہیں۔ "1000x" پیمائش نہیں، نعرہ ہے۔ پہلے بنیادی ذرائع پڑھیں۔ یہ زمانی ترتیب مختصر اور عوامی ہے۔ 7 مارچ 2026 کو Karpathy نے autoresearch جاری کیا: ایک چھوٹے training repo میں محدود ایجنٹ، جو ایک وقت میں تقریبا پانچ منٹ کا تجربہ چلاتا اور صرف metric بہتر کرنے والی چیز رکھتا ہے۔ چند ہفتوں میں اسے GitHub پر دسیوں ہزار stars ملے اور Fortune نے pattern کو "Karpathy Loop" کہا۔ تین دن بعد اس نے AgentHub کا خاکہ بنایا: "GitHub is for humans. AgentHub is for agents." یہ bare Git repo اور message board تھا، جہاں swarms مرکزی branch کے بجائے commit DAG کے ذریعے رابطہ کرتے ہیں۔ 23 مارچ 2026 کو Anthropic نے Knowledge Graph Construction Cookbook شائع کی، جو روایتی NLP pipeline کو structured-output prompts سے بدلتی ہے: typed entities اور relations نکالیں، duplicates resolve کریں، graph جوڑیں، اور citations کے ساتھ query کریں۔ Anthropic کی Dynamic Workflows، جس کا اعلان 28 مئی 2026 کو ہوا اور جو اب عام طور پر دستیاب ہے، Claude کو orchestration script لکھنے دیتی ہے جو کام متوازی، تازہ سیاق والے sub-agents میں بانٹتی ہے۔ 18 جولائی 2026 کو Peter Steinberger کے آدھی رات کے 12 الفاظ والے سوال، "Are we still talking loops or did we shift to graphs yet?"، نے پورے موضوع کو اس موسم کا نام دیا۔ حصہ 5 اس کہانی اور Carlos E. Perez کا جواب بتاتا ہے۔ چند دن بعد ایک viral post نے سب جوڑ دیا: "Two Anthropic seniors just made Karpathy's loop 1000x better with Graph Engineering — dropped 11-page PDF." اسے دہرانے سے پہلے PDF کا پہلا صفحہ پڑھیں۔ وہ کہتا ہے: independently compiled, not affiliated with Andrej Karpathy and Anthropic, and not endorsed۔ یہ خلاصہ واقعی مفید ہے اور موجودہ کورس اس سے سیکھتا ہے، مگر یہ آزاد مصنف کا مطالعہ نوٹ ہے، Anthropic paper نہیں، اور "1000x" پیمائش نہیں، نعرہ ہے۔ یہی عادت Steinberger کے سوال کو "loop engineering is dead" بنا گئی تھی۔ حصہ 5 اسے کھولتا ہے۔ بنیادی ذرائع حقیقی اور قیمتی ہیں، مگر یہ بات یاد رکھیں: autoresearch اور Anthropic کی cookbook اور workflow docs عوامی ہیں، جبکہ AgentHub جلد private ہو گیا اور اب صرف غیر لائسنس شدہ forks میں بچا ہے۔ تصور 5 میں مزید ہے۔ ایک حقیقی ملاپ meme سے رہ گیا، اور وہ meme سے زیادہ عجیب ہے: 19 مئی 2026 کو Karpathy Anthropic کی pretraining team میں شامل ہوا، تاکہ Claude سے pretraining research تیز کرنے والا گروپ بنائے۔ یوں موجودہ کورس کی loop اور graph روایات واقعی Anthropic میں ملیں، مگر viral post کے بتائے انداز سے نہیں اور اس PDF میں نہیں۔ (تمام ذرائع ذرائع اور مزید مطالعہ میں ہیں۔)مکمل زمانی ترتیب، اور meme نے کیا غلط بتایا
صنعت "graph engineering" کو ایک سے زیادہ معنوں میں استعمال کرتی ہے۔ ان میں سے دو قریبی متعلق ہیں اور یہ کورس دونوں مکمل سکھاتا ہے۔ پہلا memory graph ہے: ایجنٹس کی مشترک، پائیدار، typed state۔ اس میں کام کا commit DAG اور حقائق کی knowledge graph شامل ہیں۔ یہ حصے 2 سے 4 تک ہے۔
دوسرا governance graph ہے: خود لوپس کے درمیان wiring۔ یہ درج کرتی ہے کہ کون کس کو مواد دیتا، کون کس کو جانچتا، انسانی دروازہ کہاں ہے، اور کن پیمائشوں سے کوئی لوپ بحث نہیں کر سکتا۔ یہ حصہ 5 ہے، Peter Steinberger کے سوال اور Carlos E. Perez کے مضمون پر مبنی۔
یہ دونوں ایک نظام کی تہیں ہیں، حریف نہیں۔ Governance graph کارکنوں کو جوڑتی ہے۔ Memory graph ان کی معلومات محفوظ کرتی ہے۔ یہ تصور 10 میں ملتی ہیں، جہاں governance تہہ کا checker یادداشتی تہہ سے ثبوت پڑھتا ہے۔ لوپ کورس عین وہاں ختم ہوتا ہے جہاں موجودہ کورس شروع ہوتا ہے: ایک مکمل لوپ کے ساتھ، اور دونوں اسے یہاں سونپتے ہیں۔
تیسرا معنی بھی رائج ہے، مگر یہ کورس اسے نہیں سکھاتا۔ کچھ مصنف execution topology کے لیے "graph engineering" کہتے ہیں: nodes ریکارڈز یا لوپس کے بجائے مراحل، edges data dependencies، اور سوال یہ کہ کیا متوازی چل سکتا اور run کو کہاں انتظار کرنا ہوگا۔ یہ orchestration frameworks کا میدان ہے اور اصطلاح سے پرانا ہے: LangGraph نے جنوری 2024 میں shared state پر nodes اور edges جاری کیے، جبکہ Microsoft کا AutoGen اور Google کا ADK بھی اپنے versions رکھتے ہیں۔ اس کے بہترین خیالات پھر بھی یہاں آتے ہیں: تصور 11 کا arrow test اور routing split، اور تصور 14 کے budget اور join rules۔ مگر اگر آپ orchestration graph بنانے کا باب ڈھونڈ رہے تھے تو وہ الگ کورس ہے۔ بنانے سے پہلے دونوں سوالوں میں فرق کرنا انہیں ملانے سے زیادہ مفید ہے۔ آپ کے لوپس کی wiring اور ایک run کی شکل متعلقہ مسائل ہیں، مگر جواب مختلف۔
چھ مراحل والا طریقہ اور ہر مرحلہ پہلے کہاں ملا
زیادہ تر قارئین viral چھ مراحل والے طریقے سے یہاں آتے ہیں۔ اس کے چھ میں سے چار مراحل آپ کے پیچھے ہیں۔ موجودہ کورس باقی دو اور فہرست سے چھوٹا حصہ سکھاتا ہے۔ یوں "1000x" کا دیانت دار مفہوم benchmark نہیں۔ مراحل 1 سے 3 آپ کو قابل کارکن دیتے ہیں، اور 4 سے 6 ایسے ہزار کارکنوں کو ایک مشترک یادداشت۔ ماڈل وہی، ڈھانچہ مختلف۔اس سلسلے پر نقش کیے چھ مراحل
پوسٹ میں دیا مرحلہ اصل میں کیا ہے کہاں سیکھا 1. ایک لوپ بنائیں: generate, critique, revise Maker-checker beat اور ratchet لوپ انجینئرنگ 2. ٹولز جوڑیں: search, code, database Connectors اور انہیں محدود رکھنے والی tool schemas لوپ اور Harness Engineering 3. متوازی جائیں: الگ worktrees میں agents Isolation، تاکہ concurrent work نہ ٹکرائے لوپ اور Harness Engineering 4. گراف جوڑیں: transcripts نہیں، typed nodes اور edges سیشن سے زیادہ دیر رہنے والی یادداشت اس کورس کے حصے 2 سے 4 5. Evaluator کو تاثر نہیں، edges میں ground کریں قابل حوالہ ثبوت کے ساتھ تصدیق اس کورس کا تصور 10 6. گراف ہر سیشن کے بعد باقی رہتی ہے Provenance، supersession اور durable state تصورات 8 اور 13، اور حصہ 6
ذہنی تبدیلی، ایک تصویر میں
ٹولز پر ایک مختصر نوٹ۔ Loop، harness اور eval کام میں tool-specific spellings سکھانی تھیں۔ Graph work میں تقریبا کوئی نہیں: graph files، Git، jq اور آپ کا schema ہے، اس لیے نہ کچھ خریدنا، نہ product feature configure کرنا۔ Claude Code اور OpenCode صرف workers ہیں جو پڑھتے اور لکھتے ہیں۔ ہر command دونوں میں یکساں اور claude -p و opencode run باہم بدل سکتے ہیں۔ یہ tool-independence حادثہ نہیں؛ مضبوط ثبوت ہے کہ graph feature نہیں، discipline ہے۔
ایک اصطلاح یہاں ضروری ہے، کیونکہ قارئین اس کی توقع کر کے غلط جگہ رکھتے ہیں۔ پروٹوکول MCP، یعنی Model Context Protocol، ایجنٹ کے بیرونی نظام تک پہنچنے کا معیاری طریقہ ہے: server tools expose کرتا اور MCP سمجھنے والا agent call کرتا ہے۔ اس حجم پر MCP نہیں آتا، اور یہی درست: graph repo میں files ہے، agent موجودہ file/shell tools سے پڑھتا لکھتا ہے۔ اگلے حجم پر MCP جواب ہے۔ Graph Postgres یا Neo4j میں جائے اور مختلف machines کے agents پہنچیں تو ہر agent کو credentials/client نہ دیں؛ store کے سامنے MCP server رکھیں، چھوٹی typed surface: entity resolve، bounded subgraph fetch، validated claim append۔ قواعد server میں ایک بار enforce، prompts میں صرف request نہیں۔
تین تہیں الگ رکھیں۔ مہارت وہ علم ہے جو ایجنٹ load کرتا ہے: یہاں دعوے کیسے لکھنے ہیں۔ پروٹوکول MCP تار ہے: ایجنٹ store تک کیسے پہنچتا ہے۔ گراف خود یادداشت: کیا یاد رکھا گیا۔ Graph کے بغیر skill بے جگہ مشورہ؛ skill کے بغیر graph بے قاعدہ۔ MCP دونوں نہیں، وہ plumbing ہے جب store اسی folder کی file نہ رہے۔
جولائی 2026 کے آخر تک درست، مختلف مدتوں کے ساتھ۔ Autoresearch فعال طور پر تیار ہو رہا ہے۔ AgentHub frozen اور private ہے، اس لیے تاریخ سمجھیں۔ Dynamic Workflows عام دستیاب ہے، حدود اور defaults بدلتے ہیں۔ Cookbook زندہ notebook ہے۔ کسی flag، limit یا model name سے پہلے live sources دیکھیں: github.com/karpathy/autoresearch، platform.claude.com/cookbook، code.claude.com/docs، opencode.ai/docs۔
یہ کورس کیا سکھاتا ہے
| حصہ | موضوع | آپ کیا سیکھتے ہیں |
|---|---|---|
| 1 | یادداشت کا مسئلہ | Transcripts ٹیم کی یادداشت کیوں ناکام، graph کیا، ہر swarm کو کون سی دو graphs چاہیے |
| 2 | کام کا DAG | Karpathy کا راستہ: autoresearch تاریخ Git میں، AgentHub DAG کو collaboration layer بناتا ہے |
| 3 | حقائق کی گراف | Anthropic کا راستہ: schema سے extraction، entity resolution، ہر edge پر provenance |
| 4 | گراف سے کام | Dumps کے بجائے subgraphs اور grounded checker: "triple نہیں ملا"، "غلط لگتا ہے" سے بہتر |
| 5 | لوپس کی گراف | Governance تہہ: کون کس کو جانچتا، single loop کی چار ناکامیاں، anchors جن سے بحث نہیں |
| 6 | ایک گراف، ابتدا سے انتہا | Morning-triage spine کو files/shell سے دونوں tools میں چھوٹی queryable graph |
| 7 | حقیقت سے جڑے رہنا | Level، complexity budget، graph کب نہ بنائیں، اگلے دو courses کا پل |
| عملی | Dogfooding | اس کتاب کی proto-graph اور وہ graph جو جان بوجھ کر نہیں |
| مشق | منصوبے | آٹھ graph builds، آسان سے مشکل |
عمل سے سیکھنا چاہتے ہیں؟ پہلے حصہ 6 پڑھ کر مکمل graph دیکھیں، پھر حصوں پر واپس آئیں۔
پہلی بار؟ یادداشت کا راستہ لیں: حصے 1 سے 4، یعنی تصورات 1 سے 10، پھر سیدھا حصہ 6 بنا لیں۔ حصہ 5 اور "Going deeper" notes چھوڑیں۔ تقریبا دو گھنٹے، examples کریں تو تین۔ پھر projects 1 سے 3۔ اس کے بعد system کو graph draw، claims sources کے ساتھ store، reviewer سے evidence cite کروا سکیں گے۔
دوسری بار، جب پہلی graph transcript سے ناممکن سوال دے: governance path، حصہ 5، پورا 7، projects 4 سے 8۔ کئی loops same memory لکھیں تو دیانت urgent۔ Concept 15 تب اثر کرے جب over-build کا دل ہو۔
دو تہیں، مختلف رفتار سے پرانی۔ پہلی یاد رکھیں، دوسری تلاش کریں۔
- دیرپا تہہ: ایجنٹ بھولتا ہے، گراف نہیں۔ Work lineage اور domain facts الگ graphs؛ collapse نہیں۔ Schema trained pipeline سے سستا۔ Resolution receipts اور reversible۔ ہر claim provenance یا inference۔ Agents کو subgraphs، پوری graph نہیں۔ Checker edges میں grounded۔ Level سے پہلے چھ سوال، run سے پہلے budget۔ ہر optimizing loop کے ساتھ counter-metric watcher۔ کم از کم ایک signal reality، model report نہیں۔ Graph builder judgment اور غلطیاں amplify کرتی ہے۔
- میکانی تہہ: ہر repo، model، flag، star count۔ Autoresearch layout، Dynamic caps، Cookbook classes live source pointer، یاد نہیں۔ اختلاف میں docs درست۔
حصہ 1: یادداشت کا مسئلہ
1۔ ایجنٹ بھولتا ہے، گراف نہیں بھولتا
یہ تجربہ چلائیں: ساتھی تجربہ گاہ میں bash concepts/01-agent-forgets.sh۔ اسے پڑھنا آدھا کام ہے؛ اسے چلتا دیکھنا باقی آدھا۔
آغاز اس چیز سے کریں جو پہلے ہی آپ کے پاس ہے۔ صبح کی چھان بین کا لوپ ایک ریڑھ رکھتا ہے: progress.md، جسے پہلے پڑھا اور آخر میں لکھا جاتا ہے۔ یہ فائل یادداشت ہے، اور ایک لوپ کے لیے مؤثر بھی ہے۔ اب دیکھیے یہ کیا نہیں کر سکتی:
- دوسرا لوپ اس پر بھروسا نہیں کر سکتا۔ فائل
progress.mdنثر ہے۔ تبدیلیوں کے اندراج والے لوپ کو دوسرے لوپ کی ڈائری پڑھ کر سمجھنا ہوگی، اور امید رکھنا ہوگی کہ اس کی شکل کبھی نہیں بدلے گی۔ - بیس متوازی ایجنٹ اسے بانٹ نہیں سکتے۔ بیس جانچ کار پھیلائیں تو ہر ایک خالی ذہن سے شروع کرتا ہے۔ ایجنٹ 7 کو
utils/dates.tsمیں وقت کے خطے کی خرابی ملتی ہے۔ ایک گھنٹے بعد ایجنٹ 14 وہی خرابی پھر ڈھونڈتا ہے۔ دونوں کو جوڑنے والی کوئی چیز نہیں۔ - آپ اس سے سوال نہیں کر سکتے۔ "پچھلے مہینے کی کون سی دریافتیں ادائیگی کے کوڈ سے متعلق تھیں اور جانچ کار نے کن کی تصدیق کی؟" ریڑھ اس کا جواب نہیں دے سکتی۔ آپ نثر میں تلاش کر کے امید ہی کر سکتے ہیں۔
- یہ کوئی حوالہ نہیں دیتی۔ ریڑھ کہتی ہے "غیر مستقل ٹیسٹ درست کر دیا۔" کون سا ٹیسٹ؟ کس اجرا نے اسے ثابت کیا؟ بعد کی کس درستی نے اسے بدل دیا؟ نثر یہ نہیں جانتی۔
سادہ دکھائی دینے والا حل گفتگو کے مکمل ریکارڈ نقل کرنا ہے: ایجنٹ 7 کی گفتگو ایجنٹ 14 کے سیاق میں چسپاں کر دیں۔ یہ عین ضرورت کے وقت ناکام ہوتا ہے۔ سیاق کی گنجائش بھر جاتی ہے اور خرچ کئی گنا بڑھ جاتا ہے۔ گفتگو کا ریکارڈ یادداشت کے لیے غلط ساخت بھی ہے: یہ ثبوت سمیت ثابت شدہ بات کے بجائے کہی گئی ہر بات کو اسی ترتیب میں محفوظ کرتا ہے۔
گراف انجینئرنگ اس کا سوچا سمجھا متبادل ہے۔ ایجنٹ اپنا سیکھا ہوا قسم دار اندراجات کی صورت میں لکھتے ہیں: یہ ایک اکائی ہے، یہ اس کے بارے میں دعویٰ ہے، یہ دعوے کا ماخذ ہے، اور یہ اسے پیدا کرنے والا اجرا ہے۔ نام دار تیر ایک اندراج کو دوسرے سے جوڑتے ہیں۔ بعد کا کوئی بھی ایجنٹ، اگلے دن کا کوئی مرحلہ، دوسرا لوپ، حتیٰ کہ بالکل مختلف ماڈل بھی اپنی ضرورت کے اندراجات مانگ کر وہیں سے آگے بڑھتا ہے۔ اس موضوع کو مقبول بنانے والی آزاد پی ڈی ایف نے اسے پانچ درست الفاظ میں سمیٹا: ایجنٹ بھولتا ہے، گراف نہیں بھولتا۔
گفتگو کا ریکارڈ بات چیت کی روداد ہے۔ گراف فائلیں رکھنے کا نظام ہے۔ ٹیم میں نیا ملازم آئے تو آپ اسے ٹیم کی ہر پرانی گفتگو کی ریکارڈنگ نہیں دیتے؛ آپ منظم، نام دار اور باہم حوالہ شدہ فائلیں دیتے ہیں۔ گراف انجینئرنگ آپ کے ایجنٹوں کے لیے وہی موزوں فائلنگ نظام بناتی ہے۔
آپ کے چھان بین اور تبدیلیوں کے اندراج، دونوں لوپس کو معلوم ہونا چاہیے کہ اس ہفتے کون سی پی آر جاری ہوئیں۔ آج دونوں ہر سیاقی گنجائش میں کام دوبارہ کیا اور سمجھا جا رہا ہے۔ یہ عین "دنیا کو صفر سے دوبارہ بنانے" والی ناکامی ہے۔ حل یہ ہے کہ جو لوپ پہلے یہ ثابت کرے کہ "پی آر نمبر 212 جاری ہوئی اور مسئلہ نمبر 98 درست کرتی ہے"، وہ اسے commit hash کی ماخذی سند کے ساتھ ایک قسم دار اندراج میں صرف ایک بار لکھ دے۔ پھر دونوں لوپس یہی اندراج پڑھیں۔ ایک بار اخذ کریں، بار بار سوال کریں۔git log چلا کر یہ بات نئے سرے سے اخذ کرتے ہیں۔ یہاں کیا ضائع ہو رہا ہے، اور گراف انجینئرنگ اس کا کیا حل دیتی ہے؟جواب دکھائیں
2۔ گراف کیا ہے: نوڈ، ایج اور سمت
یہ تجربہ چلائیں: ساتھی تجربہ گاہ میں bash concepts/02-nodes-edges.sh۔ اسے پڑھنا آدھا کام ہے؛ اسے چلتا دیکھنا باقی آدھا۔
لوپس کے کورس کے آخر میں آپ اس تعریف سے مل چکے ہیں۔ یہاں یہی عملی اوزار بنتی ہے۔ گراف نقاط کا مجموعہ ہے جنہیں نوڈز کہتے ہیں، اور یہ تیروں سے جڑے ہوتے ہیں جنہیں ایجز کہتے ہیں۔ تین خصوصیات سارا کام کرتی ہیں:
- نوڈز کی قسم ہوتی ہے۔ محض "ڈبہ" نہیں، بلکہ "اکائی"، "دعویٰ"، "ماخذ"، "commit" یا "جائزہ"۔ قسم ہر قاری کو بتاتی ہے کہ نوڈ کن سوالوں کا جواب دے سکتا ہے۔
- ایجز نام دار اور سمت والے ہوتے ہیں۔
(claim_441) —supported_by→ (source_readme)کا مطلب الٹے تیر سے مختلف ہے۔ سمت ہی معنی ہے: کون کس کی تائید کرتا ہے، کون کس سے نکلا ہے، اور کس نے کسے جانچا۔ - راستے جواب ہوتے ہیں۔ "کیا فروخت کنندہ X واقعہ Y سے جڑا ہے؟" کا سوال یوں بنتا ہے: "کیا فروخت کنندہ X کے نوڈ سے واقعہ Y کے نوڈ تک تائید شدہ ایجز کا کوئی راستہ ہے؟" دنیا سے متعلق سوال تیروں پر سفر بن جاتا ہے۔
تیسری خصوصیت اصل فائدہ ہے۔ نثر کو پڑھ کر سمجھنا پڑتا ہے۔ گراف میں سفر کیا جا سکتا ہے: کوڈ ہر بار ایک ہی طریقے سے اسے میکانی طور پر طے کرتا ہے۔ یادداشت گراف بنتے ہی غیر واضح اندازوں والے سوال باقاعدہ سوالات بن جاتے ہیں۔
ایک خاص ساخت اتنی اہم ہے کہ اس کا نام ہے۔ سمت دار غیر دوری گراف، یعنی DAG ایسا گراف ہے جس کے تیر کبھی پلٹ کر دائرہ نہیں بناتے۔ آپ برسوں سے نام جانے بغیر اسے استعمال کر رہے ہیں: گٹ کی تاریخ۔ ہر commit اپنے والد کی طرف اشارہ کرتا ہے۔ کوئی commit اپنا جد نہیں ہوتا۔ یہ مثال یاد رکھیں، کیونکہ حصہ 2 اسی پر قائم ہے۔
نوڈ اسم ہیں۔ ایجز سمت والے فعل ہیں۔ گراف تصویری شکل میں جملوں، یعنی فاعل، فعل اور مفعول، کا مجموعہ ہے تاکہ کمپیوٹر نثر سمجھے بغیر جملوں کی زنجیر پر چل سکے۔
دو ایجنٹ درج کرتے ہیں کہ فروخت کنندہ X نے ایک پرزہ فراہم کیا۔ ایک اپنی روداد میں جملہ "فروخت کنندہ X نے پرزہ Z دیا" لکھتا ہے۔ دوسرا گراف میں اس پر چل سکتا ہے۔ جملہ جس ماڈل کو دکھایا جائے اسے درست طور پر پڑھنا اور سمجھنا پڑتا ہے۔ ایج کو ہر بار ایک ہی انداز میں میکانی طور پر طے اور زنجیر بند کیا جا سکتا ہے: (vendor_x) —supplied→ (component_z) لکھتا ہے۔ دونوں درست ہیں۔ بعد کا ایجنٹ دوسرے اندراج کے ساتھ ایسا کیا کر سکتا ہے جو پہلے کے ساتھ نہیں کر سکتا؟جواب دکھائیں
vendor_x سے component_z اور پھر component_z سے جڑی ہر دوسری چیز تک۔ اسی طرح دنیا سے متعلق سوال، جیسے "کیا فروخت کنندہ X اس واقعے سے جڑا ہے؟" فہمِ عبارت کا امتحان رہنے کے بجائے تیروں پر سفر بن جاتا ہے۔ قسم دار ایج اپنی رسید بھی ساتھ رکھتی ہے، جو نثر عموماً کھو دیتی ہے۔
3۔ دو گراف، اور انہیں ایک کیوں نہ کیا جائے
یہ تجربہ چلائیں: ساتھی تجربہ گاہ میں bash concepts/03-two-graphs.sh۔ اسے پڑھنا آدھا کام ہے؛ اسے چلتا دیکھنا باقی آدھا۔
یہی امتیاز پورے کورس کو ترتیب دیتا ہے، اور نئے سیکھنے والے اسے سب سے زیادہ خلط ملط کرتے ہیں۔ کئی ایجنٹوں کے نظام کو دو مختلف گراف درکار ہیں، کیونکہ اسے دو الگ طرح کی چیزیں یاد رکھنی ہوتی ہیں:
| کام کا commit DAG، حصہ 2 | علمی گراف، حصہ 3 | |
|---|---|---|
| کیا یاد رکھتا ہے | کام: کیا آزمایا گیا | حقائق: کیا معلوم ہے |
| نوڈز | commits، تجربات، اجرا | اکائیاں، دعوے، ماخذ |
| ایجز | parent_of, derived_from | supports, works_for, about |
| کن سوالوں کا جواب دیتا ہے | کیا بدلا؟ کون سا نتیجہ batch-size کے تجربے سے نکلا؟ کون سے سلسلے اب بھی زندہ ہیں؟ | کون سی اکائیاں موجود ہیں؟ ان کا تعلق کیا ہے؟ اس دعوے کی تائید کون سا ماخذ کرتا ہے؟ کون سے دعوے متصادم ہیں؟ |
| ایک صورت پہلے ہی آپ کے پاس ہے | گٹ کی تاریخ، کسی حد تک: تصور 4 دیکھیے | ابھی کچھ نہیں: حصہ 3 اسے بناتا ہے |
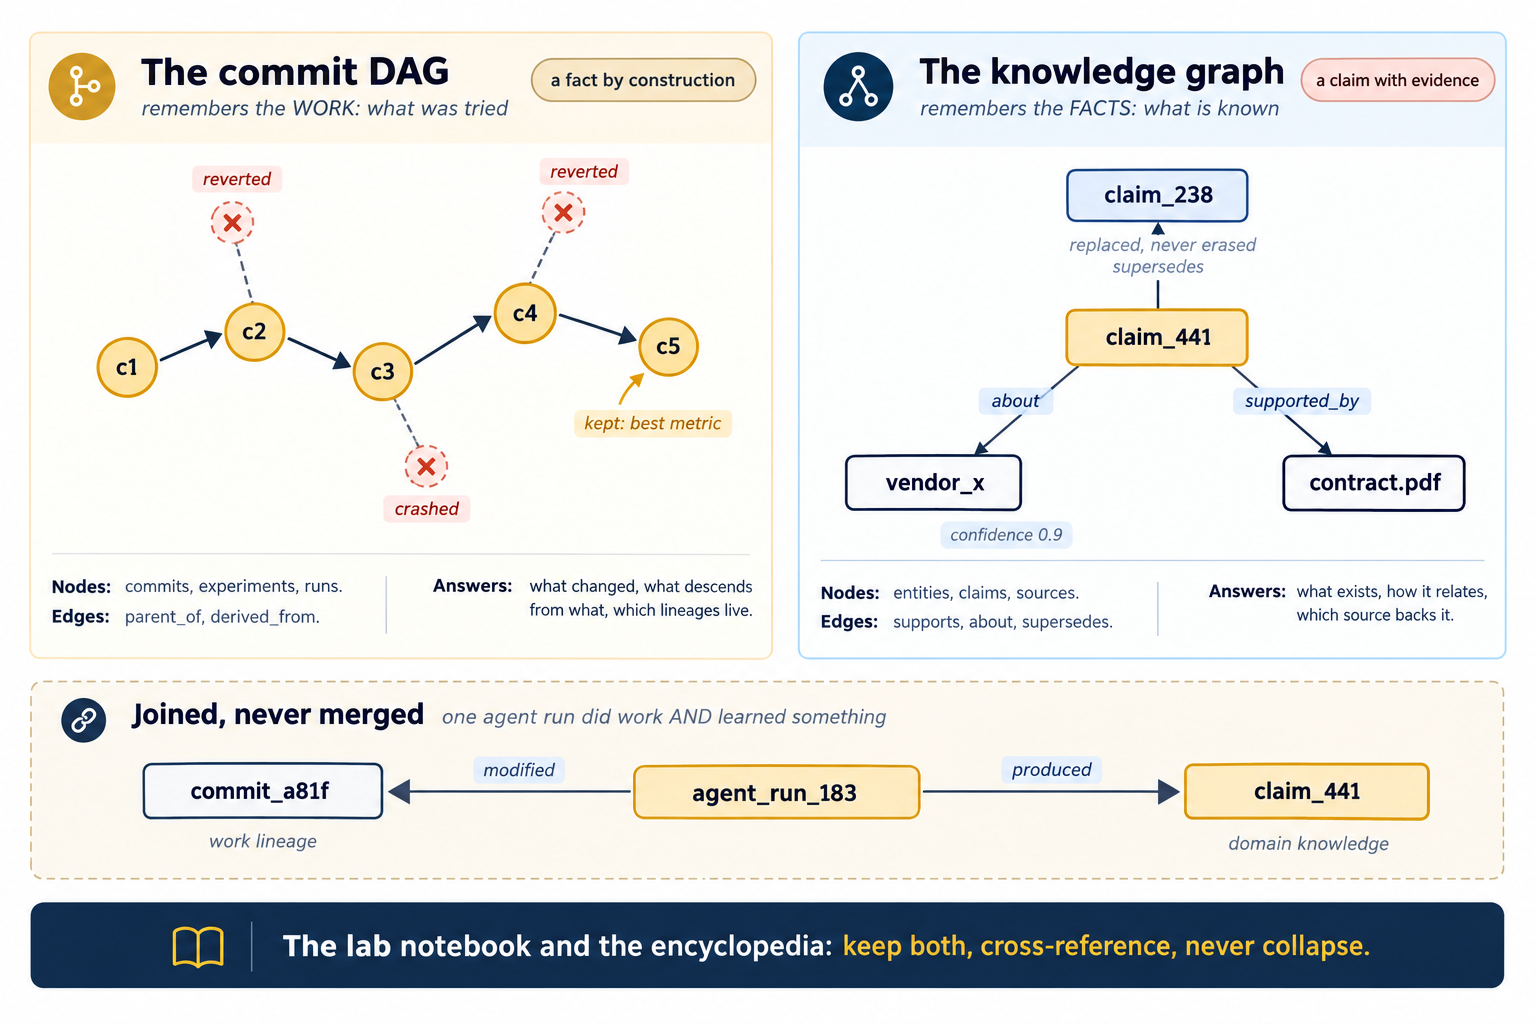
انہیں الگ کیوں رکھیں؟ کیونکہ دونوں کے سچ ہونے کے اصول مختلف ہیں۔ commit اپنی ساخت سے ثابت حقیقت ہے: یہ ہوا، اور گٹ اس کی ضمانت دیتا ہے۔ علمی گراف کا دعویٰ ثبوت والا بیان ہے: یہ غلط، غلط طور پر اخذ شدہ یا کسی نئے دعوے سے بدلا ہوا ہو سکتا ہے، اسی لیے ہر دعوے کی ایج ماخذی سراغ اور اعتماد رکھتی ہے۔ دونوں کو ملائیں تو یا اندازوں کو تاریخ سمجھیں گے، یا تاریخ کو اندازوں تلے دفن کر دیں گے۔
یہ آپس میں جڑتے ضرور ہیں۔ عملی نظام انہیں اپنی ایجز سے جوڑتا ہے:
(agent_run_183) —produced→   (claim_441)
(agent_run_183) —modified→   (commit_a81f)
(claim_441)     —about→      (entity_vendor_x)
(claim_441)     —supported_by→ (source_contract_pdf)
(claim_441)     —supersedes→ (claim_238)
اس حصے کو آہستہ پڑھیں: پانچ سطروں میں پورا کورس ہے۔ ایک اجرا نے کام کیا، یعنی commit بنایا، اور کچھ سیکھا، یعنی دعویٰ پیدا کیا۔ دعویٰ ایک اکائی کے بارے میں ہے، ماخذ اس کی تائید کرتا ہے اور یہ پرانے دعوے کی جگہ لیتا ہے۔ بائیں طرف کام کا سلسلہ اور دائیں طرف شعبے کا علم، دونوں جڑے ہیں مگر مدغم نہیں۔
کام کا commit DAG تجربہ گاہ کی نوٹ بک ہے: تاریخ وار تجربات جن میں ہر ایک کا والد ہے۔ ناکامیاں بھی اس میں رکھیں؛ تصور 4 دکھاتا ہے کہ autoresearch ایسا نہ کرنے کا انتخاب کرتا ہے، جبکہ تصور 5 میں AgentHub انہیں رکھتا ہے۔ علمی گراف وہ انسائیکلوپیڈیا ہے جسے تجربہ گاہ لکھ رہی ہے: اب ہم کس بات کو حاشیوں سمیت درست مانتے ہیں۔ صرف نوٹ بک رکھنے والی تجربہ گاہ سوالوں کے جواب نہیں دے سکتی۔ صرف انسائیکلوپیڈیا رکھنے والی تجربہ گاہ اپنا کام ثابت نہیں کر سکتی۔ دونوں رکھیں اور باہم حوالہ دیں۔
ایک ایجنٹ بتاتا ہے: "میں نے parser کو دوبارہ ترتیب دیا، commit دوبارہ ترتیب دینے کا کام کام کے commit DAG میں رہتا ہے: commit 9fc2، اور اس دوران تصدیق کی کہ فروخت کنندہ کی اے پی آئی 1970 سے پہلے کی تاریخیں رد کرتی ہے۔" جملے کا ہر حصہ کہاں رکھا جائے گا؟جواب دکھائیں
9fc2 اپنے والد کے ربط سمیت خودکار طور پر محفوظ ہے۔ اے پی آئی کا رویہ علمی گراف کا دعویٰ ہے: (vendor_api) —rejects→ (pre-1970 dates)، اور اس کا ماخذی سراغ اجرا اور ثبوت، یعنی خرابی کے جواب، کی طرف جاتا ہے۔ آج یہ دوسری حقیقت گفتگو کے ریکارڈ میں مر جاتی ہے۔ یہی نقصان روکنے کے لیے یہ کورس بنایا گیا ہے۔
زیادہ تر نظاموں کو علمی گراف نہیں بنانا چاہیے، اور اس کی تیاری پر چار حصے پڑھنے سے پہلے آپ کو یہ معلوم ہونا چاہیے۔ مکمل مختصر کسوٹی تصور 15 میں ہے: اگر آپ کے کام ایک دوسرے سے آزاد ہیں، ہر جواب ایک وقت میں ایک دستاویز سے آتا ہے، تعلقات مقرر اور سادہ ہیں، باقاعدہ جدول آپ کے ہر حقیقی سوال کا جواب پہلے ہی دیتی ہے، اور کسی کو ماخذی سراغ نہیں چاہیے، تو یہیں رک جائیں۔ ریڑھ والا ایک لوپ درست جواب ہے۔ گراف شامل کرنے سے ان سوالوں کے بدلے اخذ کی غلطیاں اور ساخت کی دیکھ بھال ملے گی جو کسی نے پوچھے ہی نہیں۔
جب دو لوپس کو حقائق بانٹنے ہوں، خلاصہ کئی کارکنوں کے کام پر پھیلا ہو، تعلقات بدلتے رہیں، یا کسی دن کوئی پوچھے "ہمیں یہ کیسے معلوم ہے؟" تو پلڑا دوسری طرف جھک جاتا ہے۔ ان میں سے کوئی بات درست ہے یا جلد ہونے والی ہے تو آگے پڑھیں۔ تصور 14 اسے ترتیب وار چھ سوالوں میں بدلتا ہے۔
حصہ 2: کام کا ڈی اے جی
4۔ خودکار تحقیق: درجہ بند لوپ اپنی تاریخ گٹ میں لکھتا ہے
یہ تجربہ چلائیں: ساتھی تجربہ گاہ میں bash concepts/04-autoresearch-ratchet.sh۔ اسے پڑھنا آدھا کام ہے؛ اسے چلتا دیکھنا باقی آدھا۔
لوپس کے کورس نے درجہ بند لوپ سکھایا: ایک تبدیلی آزمائیں، جانچیں، عدد بہتر ہو تو رکھیں، ورنہ واپس کر دیں۔ کارپیتھی کی autoresearch، 7 مارچ 2026، یہی لوپ ہے جسے مشین لرننگ کی تربیت پر لگایا گیا۔ اس کورس کے لیے اس کی اہمیت ایک ڈیزائن فیصلے میں ہے: لوپ کی یادداشت گفتگو کا ریکارڈ نہیں بلکہ commit DAG ہے۔
ایک جی پی یو والی چھوٹی تربیتی repository میں تین فائلیں ترتیب دی جاتی ہیں:
- فائل
prepare.pyمقررہ ڈیٹا تیاری اور جانچ رکھتی ہے۔ ایجنٹ اسے چھو نہیں سکتا۔ یہ ایک منجمد نوڈ ہے، یعنی harness کورس کا انکار کا اصول ایک فائل پر نافذ ہے۔ - فائل
train.pyمیں ماڈل، بہتر بنانے والا اور تربیتی لوپ ہے۔ ایجنٹ صرف یہی سطح بدلتا ہے۔ - فائل
program.mdمیں عام زبان کی ہدایات ہیں: پیمانہ، بجٹ، commit اور واپسی کے اصول، اور معاملہ کب انسان تک پہنچانا ہے۔ لوپس کے کورس نے اسے "پروگرام کو پروگرام کرنا" کہا تھا۔
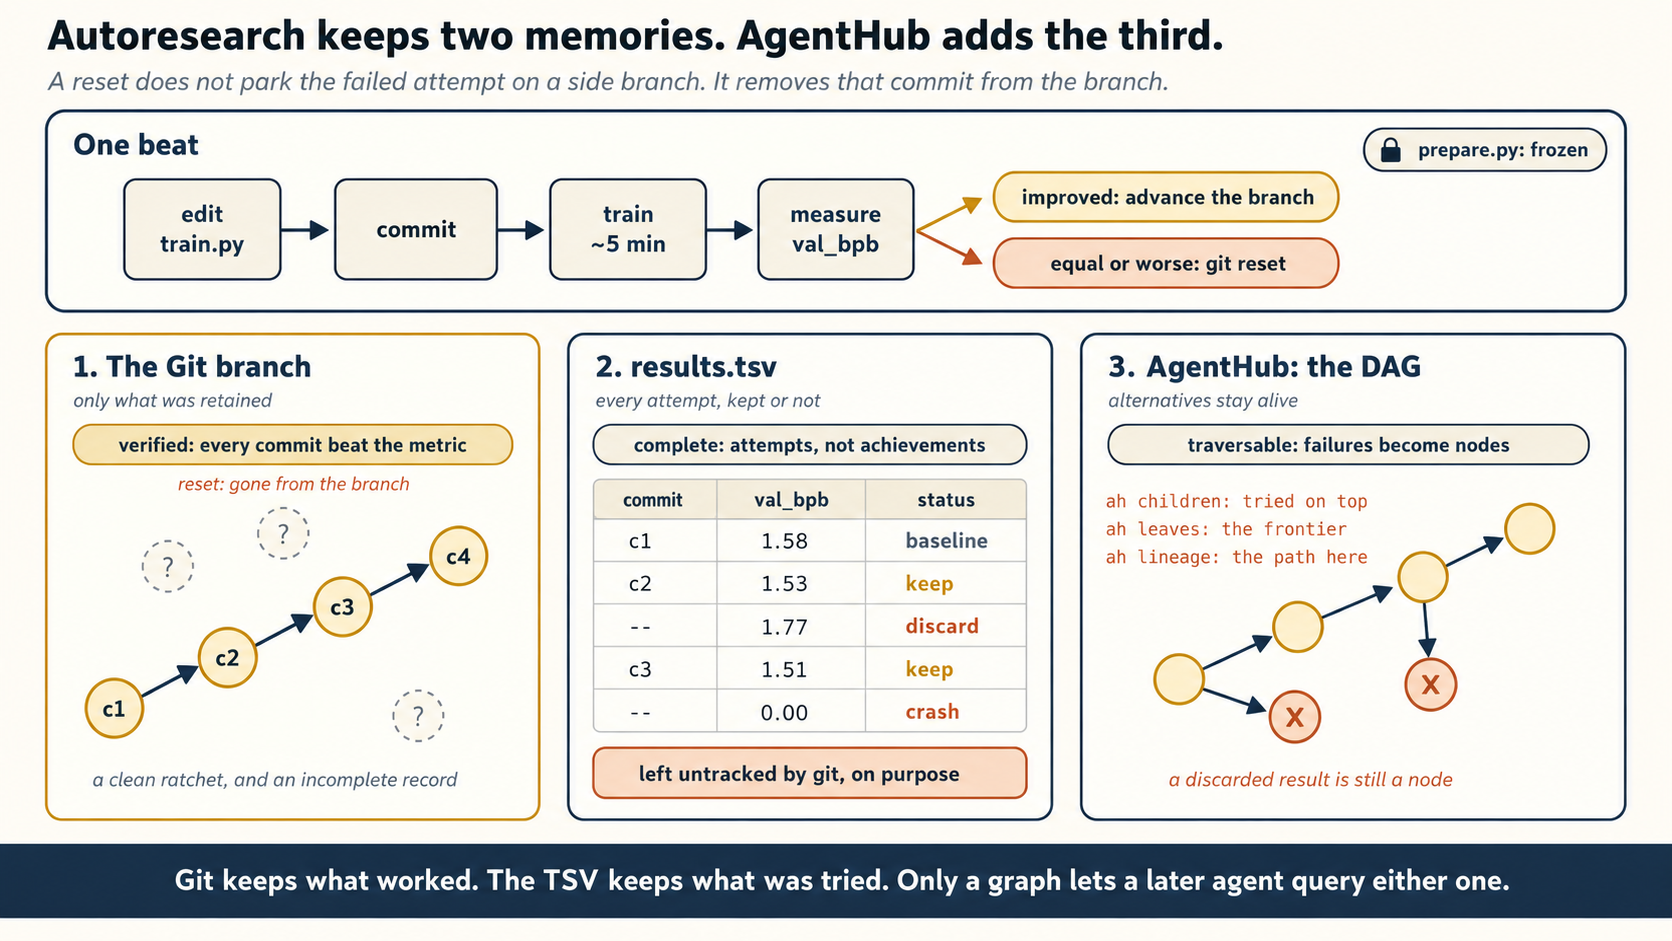
پھر مرحلہ ہمیشہ دہراتا ہے: train.py اور حالیہ تاریخ پڑھیں، وجہ والی ایک تبدیلی تجویز کریں، اسے commit کریں، تقریباً پانچ منٹ تربیت چلائیں، اور تصدیقی نقصان ناپیں۔ بہتری آئی؟ commit برقرار رہے گا۔ نتیجہ خراب یا اجرا ناکام ہوا؟ آخری برقرار commit پر واپس جائیں۔ دونوں صورتوں میں نتیجہ درج کر کے آگے بڑھیں، اور انسان لوپ میں نہ ہو۔
اب غور سے دیکھیں ہر مرحلہ کیا چھوڑتا ہے، کیونکہ نئے سیکھنے والے اور کئی مقبول تحریریں autoresearch کو یہیں غلط سمجھتی ہیں۔ اس کی ایک نہیں، دو یادداشتیں ہیں اور دونوں مختلف چیزیں رکھتی ہیں:
| اس میں کیا ہوتا ہے | سچائی کا معیار | |
|---|---|---|
| گٹ کی branch | صرف برقرار رکھی گئی بہتریاں، تجربے کے لیے مخصوص branch پر commits کی اوپر جاتی زنجیر | تصدیق شدہ: ہر commit نے پیمانہ بہتر کیا |
results.tsv | ہر کوشش: commit hash، پیمانہ، استعمال شدہ یادداشت، برقرار یا رد یا ناکام، اور کیا آزمایا گیا | مکمل: یہ کوششیں درج کرتا ہے، کامیابیاں نہیں |
ناکامی پر جو ہوتا ہے وہ اصل اہمیت رکھتا ہے۔ ہدایات صاف کہتی ہیں: پیمانہ بہتر ہو تو branch آگے بڑھائیں اور commit رکھیں؛ برابر یا خراب ہو تو git reset سے آغاز کی جگہ پر واپس جائیں۔ reset کوشش کو کسی ضمنی branch پر محفوظ نہیں کرتا بلکہ اس commit کو branch سے ہٹا دیتا ہے۔ یوں رد شدہ تجربہ صرف results.tsv میں بچتا ہے، اور results.tsv جان بوجھ کر گٹ میں درج نہیں کی جاتی۔
اسے کوتاہی نہیں بلکہ ڈیزائن سمجھیں، کیونکہ عملی دنیا میں یہ تصور 3 کی سب سے واضح مثال ہے۔ گٹ وہ کام رکھتا ہے جس کی قدر ثابت ہوئی۔ ٹی ایس وی ہر کوشش کا دیانت دار اندراج رکھتی ہے، ناکامیاں بھی۔ انسانی محقق مفروضے، ناکام کوششیں اور مقداروں کے باہمی اثرات ذہن میں رکھ کر کھو دیتا ہے۔ autoresearch دونوں قسمیں دو جگہ اور دو معیاروں کے تحت لکھتی ہے۔ البتہ یہ متبادل سلسلوں کو زندہ اور قابل سفر نہیں رکھتی: رد شدہ خیال متن کی ایک سطر بن جاتا ہے جس سے کوئی دوسرا ایجنٹ سوال نہیں کر سکتا۔ تصور 5 اسی خلا کو پُر کرتا ہے۔
ابتدائی ہفتوں کے بتائے گئے اعداد، یعنی بنیادی کوڈ کی تقریباً 630 سطریں، دو دن میں لگ بھگ 700 تجربات اور قریب 20 برقرار بہتریاں، ساخت سے کم اہم ہیں۔ repository نے دسیوں ہزار ستارے اس لیے نہیں لیے کہ بہتریاں غیر معمولی تھیں، بلکہ اس لیے کہ نمونہ صاف دکھائی دیتا ہے: مختصر کوڈ، نمایاں پیمانہ اور دو دیانت دار اندراج۔ کوئی عدد نقل کرنے سے پہلے براہ راست repository دیکھیں، کیونکہ یہ ہر ہفتے بدلتا ہے۔
اس کے مؤثر ہونے کی چار شرطیں لفظ بہ لفظ لوپس کورس کی فہرست ہیں: نتیجہ قابل تصدیق ہے، یعنی تصدیقی عدد؛ عمل قابل واپسی ہے، یعنی git reset جو کوشش واپس کرتا مگر محفوظ نہیں رکھتا؛ مدت مختصر ہے، یعنی پانچ منٹ کے اجرا؛ ماحول محدود ہے، یعنی ایک repository اور ایک قابل تدوین فائل۔ نئی بات صرف یہ ہے کہ یادداشت کہاں رہتی ہے۔
خودکار تحقیق آپ کا درجہ بند لوپ ہے جس کی یادداشت ایجنٹ کے ذہن سے نکال کر دو فائلوں میں رکھی گئی ہے۔ گٹ branch مؤثر کام رکھتی ہے۔ results.tsv ہر کوشش رکھتی ہے۔ لوپ ناکام ہو کر دوبارہ شروع ہو تب بھی اپنی سمت نہیں کھوتا، کیونکہ کوئی یادداشت سیاقی گنجائش میں نہیں۔ مگر دیانت دار حد یاد رکھیں: رد شدہ تجربہ متن کی سطر چھوڑتا ہے، ایسا نوڈ نہیں جس پر کوئی سفر کر سکے۔
ایسی کوئی repository کھولیں جس پر آپ نے ایجنٹ کے ساتھ کام کیا ہو، اور ڈی اے جی سے وہ سوال پوچھیں جن کا جواب ریڑھ نہیں دے سکتی:
git log --oneline --graph -20        # the DAG, drawn
git log --follow -- path/to/file.ts  # every experiment on one surface
git diff HEAD~5 HEAD -- src/         # what five beats of work changed
پھر ایجنٹ سے کہیں: "آخری 20 commits پڑھیں۔ ظاہری پیمانہ کیا تھا، اور کون سے commits برقرار بہتریاں لگتے ہیں؟" اب دیکھیں ڈی اے جی کیا نہیں بتا سکتا: کون سے تجربات آزمائے اور رد کیے گئے۔ autoresearch میں یہ جواب گٹ سے باہر results.tsv میں ہے۔ تصور 5 ان سطروں کو نوڈز میں بدلتا ہے۔
5۔ ایجنٹ ہب: تلاش کے گراف پر چلیں، main میں مدغم نہ کریں
یہ تجربہ چلائیں: ساتھی تجربہ گاہ میں bash concepts/05-agenthub-traversal.sh۔ اسے پڑھنا آدھا کام ہے؛ اسے چلتا دیکھنا باقی آدھا۔
خودکار تحقیق کے تین دن بعد کارپیتھی نے اگلا قدم بیان کیا: لوپ کو "ایجنٹوں کے لیے غیر ہم وقت اور بہت بڑے تعاون، یعنی SETI@home جیسے انداز" میں بدلنا چاہیے۔ ایک پی ایچ ڈی طالب علم نہیں بلکہ تحقیقی برادری کی نقل بنائیں۔ AgentHub اس تہہ کا خاکہ ہے: ایک Go binary، ایک SQLite database، ایک bare Git repository، ہر ایجنٹ کے لیے ایک API key، اور پیغامات کا تختہ۔ اس کا نعرہ ہی مرکزی خیال ہے: "GitHub انسانوں کے لیے ہے۔ AgentHub ایجنٹوں کے لیے ہے۔"
تصور 4 کے چھوڑے ہوئے خلا سے آغاز کریں۔ ایک درجہ بند لوپ اپنی ناکامیاں reset کر کے ہٹا دیتا ہے، اس لیے رد شدہ خیال کا واحد اندراج غیر درج شدہ متنی فائل کی سطر ہے جس سے دوسرا ایجنٹ سوال نہیں کر سکتا۔ AgentHub کا مرکزی قدم reset روک کر محفوظ کرنا شروع کرنا ہے: ایجنٹ commits کو bundles کی صورت میں بھیجتے ہیں، ہر بھیجا commit مستقل نوڈ بنتا ہے، اور کسی چیز کو main branch پر اکٹھا ہونا لازم نہیں۔ متبادل زندہ اور قابل سفر رہتے ہیں۔ یہی ناکامیوں کی متنی روداد اور ان کے گراف میں فرق ہے۔
ایجنٹوں کے تعاون کو مختلف نظام کیوں چاہیے؟ کیونکہ ایجنٹوں کا جھنڈ انسانی گٹ کے ہر مفروضے کو الٹ دیتا ہے:
- ہزاروں ایجنٹ بیک وقت کھوج کرتے ہیں۔ انسانی repositories چند branches فرض کرتی ہیں۔ جھنڈ میں ہزاروں بیک وقت کوششیں معمول ہیں۔
- زیادہ تر نتائج جان بوجھ کر مدغم نہیں ہوتے۔ انسانوں کے لیے غیر مدغم branch نامکمل کام ہے۔ جھنڈ کے لیے ناکام تجربہ ثبوت ہے: یہ ہر دوسرے ایجنٹ کو بتاتا ہے کہ ایک خیال کسی شرط میں ناکام ہوتا ہے۔
- بنیادی عمل بدل جاتا ہے۔ "اسے main میں مدغم کریں" کے بجائے "تلاش کے گراف پر سفر کریں۔" لازم main branch، pull requests یا merge queue نہیں، اور کسی ایک آخری نوڈ کو حتمی ماننے کی شرط بھی نہیں۔
کمانڈ لائن انٹرفیس اس تبدیلی کو ٹھوس بناتا ہے۔ ہر کمانڈ روزمرہ نام والا گراف سوال ہے:
ah push                 # publish my commit as a new node
ah children <hash>      # what was tried on top of this result?
ah leaves               # the frontier: results nobody has built on yet
ah lineage <hash>       # the full ancestry path that produced this outcome
ah diff <a> <b>         # compare any two experiments, related or not
ah log --agent X        # one agent's trail through the search
کمانڈ children پوچھتی ہے کہ کسی نتیجے کے اوپر کون سے خیالات آزمائے گئے۔ leaves غیر دریافت شدہ سرحد دکھاتی ہے۔ lineage بتاتی ہے نتیجہ کس راستے سے پہنچا۔ روایتی branch ماڈل سے یہی سوال پوچھیں تو ان کی مشکل محسوس ہوگی؛ ڈی اے جی کو گراف سمجھنے سے ہر سوال ایک کمانڈ بن جاتا ہے۔
پیغامات کا تختہ سماجی تہہ ہے اور یادداشت کی کہانی مکمل کرتا ہے۔ ایجنٹ کو ہر سابق گفتگو نہیں چاہیے۔ وہ متعلقہ سلسلے پوچھتا، چند خلاصے پڑھتا، ایک commit لیتا اور آگے بڑھتا ہے۔ آزاد پی ڈی ایف نے اسے درست نام دیا: گراف سے وابستہ سیاق کی تعمیر۔ پوری تاریخ دہرانے کے بجائے موجودہ فیصلے کے لیے مطلوبہ مربوط حالت حاصل کریں۔ یہ فقرہ یاد رکھیں؛ تصور 9 اسے عام بناتا ہے۔ ساتھ چلنے والے ہر شخص کے لیے دو دیانت دار باتیں اہم ہیں۔ پہلی، repository کے اپنے الفاظ میں: "کام جاری ہے۔ محض خاکہ۔ سوچ جاری ہے۔۔۔" AgentHub کے پاس ایجنٹوں کے باہمی اعتماد، نقصان دہ bundles، بڑے پیمانے کی ذخیرہ کاری، نقل کی شناخت یا طویل مدتی اشاریہ سازی کا جواب نہیں تھا۔ اس سے سبق کمزور نہیں بلکہ زیادہ واضح ہوتا ہے۔ خاکہ ٹھیک بتاتا ہے کہ ایجنٹوں کی کثرت پر کون سے انسانی تصورات پہلے ناکام ہوتے ہیں: واحد main branch، انسانی رفتار کا جائزہ، گفتگو کی یادداشت اور merge پر قائم تعاون۔ دوسری، AgentHub اب عوامی نہیں۔ مارچ 2026 میں اجرا کے ایک دن کے اندر اسے چند ہزار ستارے ملے، پھر نجی کر دیا گیا۔ اب محفوظ forks گردش میں ہیں، مگر اصل repository میں license file نہیں تھی۔ ہر نقل کو مطالعے کے لیے تاریخی نمونہ سمجھیں، ایسا برقرار software نہیں جس پر تعمیر کی جائے۔ اسے dependency نہ بنائیں۔ قابل منتقلی ڈیزائن پڑھیں: commits بطور نوڈز، bundles بطور push اکائی، سفر بطور بنیادی عمل، اور پیغامات کا تختہ جہاں رد شدہ نتیجہ بھی سکھاتا ہے۔پہلی بار اختیاری: ایجنٹ ہب کی حالت اور حدود
github.com/karpathy/agenthub پر 404 آتا ہے۔ سب سے واضح عوامی بیان ایک ایسے developer کا ہے جس نے پہلے fork محفوظ کیا اور بعد میں ڈیزائن درج کیا: "کارپیتھی نے پچھلے ہفتے AgentHub کھلے ماخذ کے طور پر جاری کیا، پھر repository نجی ہوگئی۔"
گٹ ہب ایک مشترک "سرکاری" صورت فرض کرتا ہے جس کی طرف سب بڑھتے ہیں۔ جھنڈ ایک سرکاری صورت نہیں چاہتا، اسے ہر آزمائی ہوئی چیز کا نقشہ چاہیے، بند راستے بھی، کیونکہ وہ بھی سکھاتے ہیں۔ AgentHub نقشہ رکھتا اور رسمی کارروائی چھوڑ دیتا ہے۔
ایجنٹ ہب جھنڈ کی یادداشتی تہہ ہے۔ جھنڈ کو چلانے کے لیے پھر بھی کچھ درکار ہے۔ 28 مئی 2026 کو Claude Code کے لیے اعلان شدہ اور اب عام دستیاب، Anthropic کا Dynamic Workflows سب سے واضح عملی نمونہ ہے: آپ کے پھیلاؤ کی اسکرپٹ لکھنے کے بجائے Claude موجودہ کام کے لیے تنظیمی پروگرام لکھتا ہے۔ فائلیں تلاش کریں، ہر فائل کے لیے جانچ کار بنائیں، نتائج چھانیں، انہیں غلط ثابت کرنے کے لیے جانچ کار پھیلائیں، پھر حوالہ شدہ رپورٹ بنانے والا ایک خلاصہ کار چلائیں۔ سرکاری بیان کے مطابق ایک نشست میں دسیوں سے سیکڑوں متوازی ذیلی ایجنٹ، ہر ایک تازہ سیاق کے ساتھ، نتائج شامل کرنے سے پہلے جانچے جاتے ہیں اور پیش رفت محفوظ رہتی ہے تاکہ رکا اجرا صفر سے شروع نہ ہو۔ آپ Claude سے workflow مانگ کر، یا ultracode setting آن کر کے اسے شروع کرتے ہیں؛ یہ محنت کی سطح بڑھاتی اور Claude کو workflow کی ضرورت طے کرنے دیتی ہے۔
تشہیری نمونہ Bun کی منتقلی ہے: Jarred Sumner نے dynamic workflows سے Bun کو Zig سے Rust میں منتقل کیا، تقریباً 750,000 سطریں Rust لکھیں، موجودہ test suite کا 99.8 فیصد کامیاب رہا، اور پہلے commit سے merge تک گیارہ دن لگے۔ Anthropic کے مطابق یہ ابھی production میں نہیں۔
اس سہولت کے ساتھ دو تنبیہات ہیں۔ یہ عام نشست سے خاصے زیادہ tokens استعمال کرتی ہے، اسی لیے پہلا workflow تصدیق مانگتا ہے اور منتظم workflows مکمل بند کر سکتے ہیں۔ متوازی کارکن باہم مربوط غلطیاں بھی کرتے ہیں: تصدیقی لہر تبھی مدد دیتی ہے جب جانچ کاروں کا prompt، evidence set یا کردار مختلف ہو۔ اعلان "دسیوں سے سیکڑوں" کہتا ہے، مگر reference docs زیادہ واضح ہیں اور ڈیزائن انہی کے مطابق ہونا چاہیے: "Behavior and limits" جدول زیادہ سے زیادہ 16 بیک وقت ایجنٹ، کم CPU cores والی مشین پر کم، اور فی اجرا مجموعی 1,000 ایجنٹ بتاتی ہے۔ تعمیر سے پہلے موجودہ اعداد کے لیے دستاویزات دیکھیں۔ یہ سہولت ایک گہرا سوال کھلا چھوڑتی ہے: تازہ سیاق والے سیکڑوں کارکن اپنا سیکھا ہوا کہاں رکھتے ہیں؟ حصہ 3 اسی کا جواب ہے۔
ایجنٹ ہب میں ایجنٹ A کا تجربہ ناکام ہوتا ہے: بڑا batch size یادداشت کی حد پر گر جاتا ہے۔ گٹ ہب کی سوچ میں branch چھوڑ کر بھلا دی جاتی ہے۔ گراف کی سوچ میں اس کے ساتھ کیا ہوتا ہے، اور فائدہ کسے ملتا ہے؟ ناکام commit ڈی اے جی میں نوڈ رہتا ہے، اور پیغامات کے تختے کی تحریر اس کے سلسلے کا حوالہ دیتی ہے: "batch 64 اس hardware پر memory سے بڑھ جاتا ہے۔ اس کے بجائے depth change سے branch بنائیں۔" اس سلسلے پر جواب دکھائیں
children پوچھنے والا ہر آئندہ ایجنٹ crash دوبارہ چلائے بغیر تنبیہ پاتا ہے۔ ناکامی مشترک یادداشت بن گئی۔ جھنڈ اور ہجوم میں یہی پورا فرق ہے۔
حصہ 3: حقائق کا گراف
گٹ نے کام کا commit DAG مفت دے دیا، مگر علمی گراف آپ کو بنانا ہے۔ کئی دہائیوں تک اس کا مطلب تربیت یافتہ قدرتی زبان کا سلسلہ تھا: نام دار اکائی کا ماڈل، تعلقات کا درجہ ساز اور نقل ختم کرنے کا تخمینہ، جن سب کے لیے نام زدہ ڈیٹا اور دیکھ بھال درکار تھی۔ 23 مارچ 2026 کی Anthropic Knowledge Graph Construction Cookbook اس کا 2026 والا طریقہ دکھاتی ہے: پورا سلسلہ ساختی نتائج والے prompts میں سمٹ جاتا ہے۔ چار مراحل، تین تصورات۔
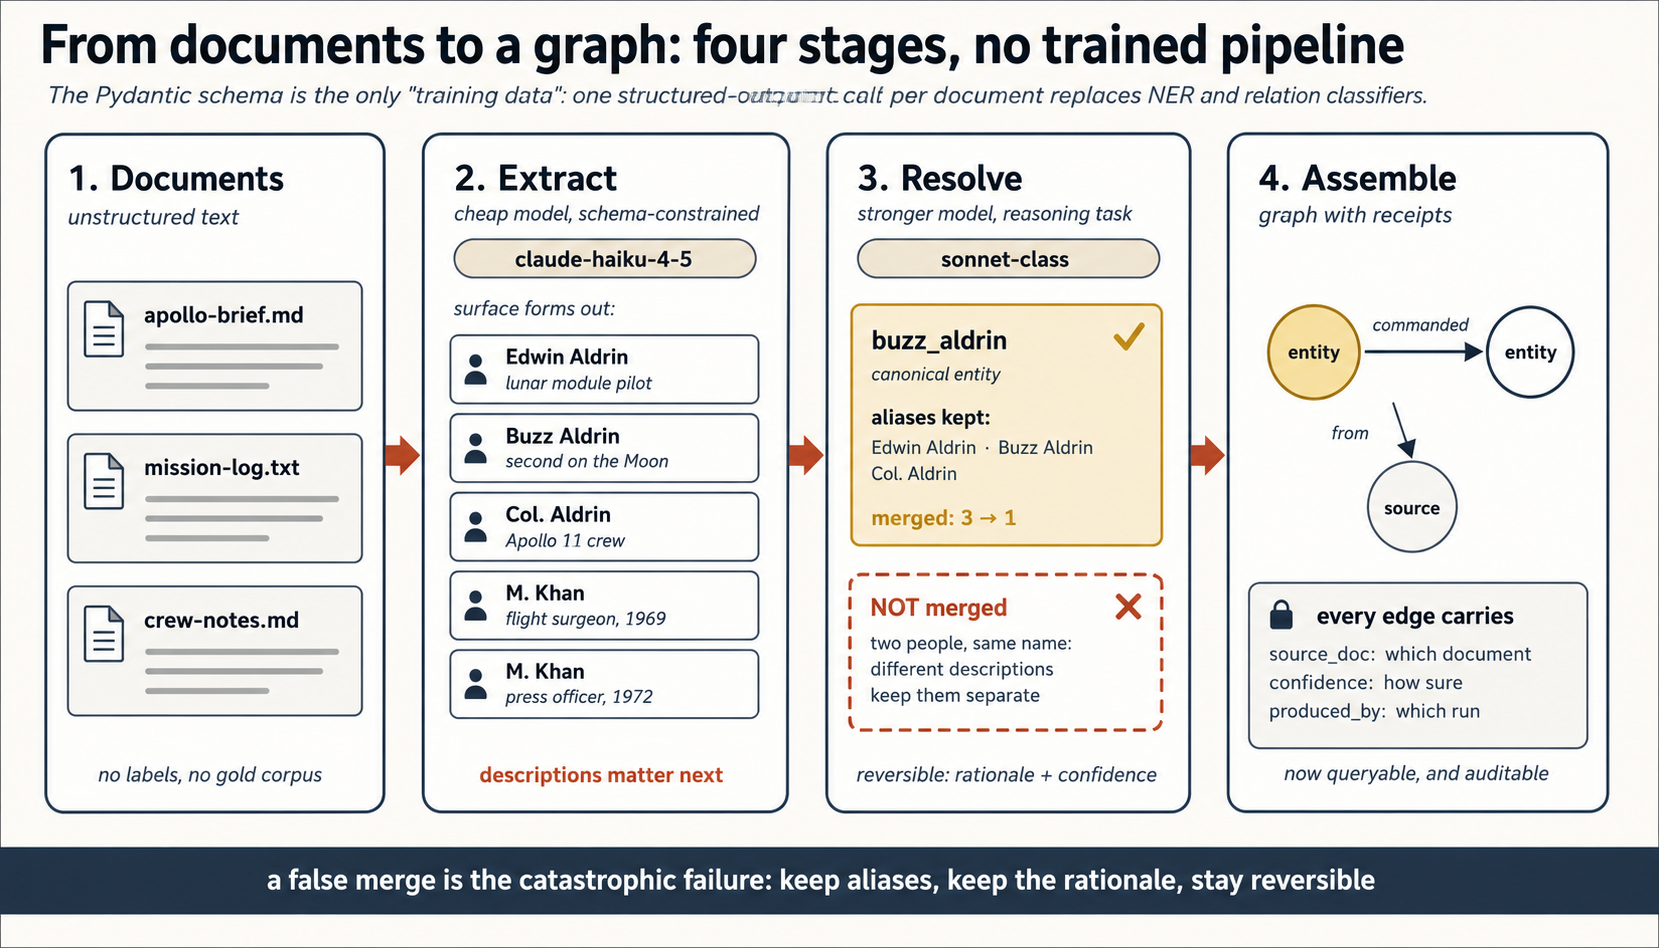
6۔ اخذ: ساخت ہی تربیتی ڈیٹا ہے
یہ تجربہ چلائیں: ساتھی تجربہ گاہ میں python3 concepts/06-extraction.py۔ اسے پڑھنا آدھا کام ہے؛ اسے چلتا دیکھنا باقی آدھا۔
پہلا مرحلہ غیر ساختی متن کو قسم دار ٹکڑوں میں بدلتا ہے۔ مطلوبہ شکل schema میں طے کر کے ماڈل کا نتیجہ اسی تک محدود کریں:
پڑھنے میں آسانی کے لیے نیچے کی شکل مختصر ہے: EntityType، ExtractedGraph اور PROMPT آپ نے متعین کرنے ہیں، جبکہ Cookbook notebook میں قابل اجرا صورت ہے۔ یہاں سطروں کی تعداد نہیں بلکہ ڈیزائن کے تین فیصلے اہم ہیں۔
class Entity(BaseModel):
    name: str
    type: EntityType          # your enum: PERSON | ORG | PROJECT | ...
    description: str          # context, used later for resolution

class Relation(BaseModel):
    source: str               # subject, a name that must appear in entities
    predicate: str            # short verb phrase: "commanded", "supplied"
    target: str               # object, likewise

class ExtractedGraph(BaseModel):
    entities: list[Entity]
    relations: list[Relation]

def extract(text: str, client) -> ExtractedGraph:
    response = client.messages.parse(
        model="claude-haiku-4-5",           # cheap model: extraction is volume work
        max_tokens=4096,
        messages=[{"role": "user", "content": PROMPT.format(text=text)}],
        output_format=ExtractedGraph,       # the schema constrains the reply
    )
    return response.parsed_output
نحو کے بجائے ڈیزائن پڑھیں۔ تین فیصلوں میں پورا سبق ہے:
- پائڈینٹک schema ہی واحد "تربیتی ڈیٹا" ہے۔ نہ نام زدہ corpus، نہ fine-tuned NER model۔ schema اور prompt مل کر وہ کام بدل دیتے ہیں جس میں پہلے ٹیم کی پوری سہ ماہی لگتی تھی۔ اب ontology بدلنے کا مطلب pipeline کو دوبارہ تربیت دینا نہیں بلکہ class کی تدوین ہے۔
- سستا ماڈل بڑی مقدار کا کام کرتا ہے۔ اخذ ہر دستاویز پر ایک بار اور ممکنہ طور پر ہزاروں دستاویزات پر چلتا ہے، اس لیے Haiku استعمال ہوتا ہے۔ مہنگے فیصلہ طلب کام، یعنی اگلا تصور، مضبوط ماڈل کو جاتے ہیں۔ یہ لوپس کورس کی maker–checker معاشیات ہے جو pipeline کے مراحل پر لگائی گئی ہے۔
- فیلڈ
descriptionسجاوٹ نہیں۔ یہ ہر اکائی کے گرد سیاق محفوظ کرتی ہے، اور یہی سیاق تصور 7 کو فیصلہ کرنے دیتا ہے کہ دو نام ایک ہی چیز ہیں یا نہیں۔
یہ harness کورس کے قسم دار نتائج کا اصول بھی ہے جسے ایک جانچ کار کے فیصلے سے اٹھا کر پورے یادداشتی نظام پر لگا دیا گیا ہے: گراف میں کچھ نثر کے طور پر داخل نہیں ہوتا۔ گراف کے ماننے سے پہلے کوڈ ہر اخذ کو schema سے جانچتا ہے۔
آپ ماڈل کو یہ نہیں سکھاتے کہ شخص یا کمپنی کیا ہے؛ وہ پہلے جانتا ہے۔ آپ اسے فارم بھرنے کے لیے دیتے ہیں، اور فارم میں نہ آنے والا ہر جواب رد کر دیتے ہیں۔ فارم ہی پورا سلسلہ ہے۔
خیال سمجھنے کے لیے پائتھن درکار نہیں۔ README والی repository میں وہ headless worker چلائیں جسے آپ پہلے جانتے ہیں:
claude -p 'Read README.md. Return ONLY valid JSON:
{"entities":[{"name":"","type":"PERSON|ORG|TOOL|PROJECT","description":""}],
 "relations":[{"source":"","predicate":"","target":""}]}
Every relation must connect two extracted entities. Predicates are short verb phrases.'
# OpenCode: opencode run '<same prompt>'
تصدیق کے لیے نتیجہ jq . سے گزاریں۔ مبارک ہو: عملی جسامت میں Cookbook کا پہلا مرحلہ یہی ہے۔
7۔ تطبیق: ایک چیز، کئی نام
یہ تجربہ چلائیں: ساتھی تجربہ گاہ میں python3 concepts/07-resolution.py۔ اسے پڑھنا آدھا کام ہے؛ اسے چلتا دیکھنا باقی آدھا۔
اخذ صاف گراف نہیں بلکہ ظاہری نام پیدا کرتا ہے۔ ایک ہی خلا باز تین دستاویزات میں "Edwin Aldrin"، "Buzz Aldrin" اور "Col. Aldrin" کے نام سے آتا ہے۔ انہیں نہ ملائیں تو گراف تین غیر مربوط لوگ رکھے گا، اور Aldrin سے گزرنے والا ہر کئی مرحلوں کا سوال خاموشی سے ناکام ہوگا۔ اکائی کی تطبیق یہ طے کرتی ہے کہ کون سے ظاہری نام ایک ہی حقیقی چیز ہیں۔
متن کی مشابہت کیوں نہیں؟ کیونکہ یہ بیک وقت دونوں سمتوں میں ناکام ہوتی ہے۔ "Edwin Aldrin" اور "Buzz Aldrin" عین اس مقام پر مختلف ہیں جہاں نام کسی کی شناخت کرتا ہے؛ دیے گئے ناموں میں کچھ مشترک نہیں، اس لیے مشابہت کا عدد کسی مناسب merge حد سے نیچے رہ کر درست merge کھو دیتا ہے۔ دوسری طرف "Muhammad Khan" نام کے دو الگ لوگ مکمل مماثلت پاتے ہیں، یوں مشابہت کا عدد غلط merge گھڑ دیتا ہے۔ نام ثبوت کا حصہ ہیں، حتمی ثبوت نہیں۔
اس Cookbook کا طریقہ یہ ہے کہ تطبیق کو استدلالی کام سمجھیں۔ ممکنہ اکائیوں کو قسم کے لحاظ سے جمع کریں، مضبوط ماڈل، یعنی Sonnet، کو تصور 6 کے description fields سمیت ہر گروہ دیں، اور canonical clusters تجویز کرنے کو کہیں۔ descriptions ہی "Edwin Aldrin، Apollo 11 lunar module pilot" اور "Buzz Aldrin، second person on the Moon" کو قابل merge اور ایک نام والے اجنبیوں کو الگ بناتی ہیں۔ بڑے پیمانے پر سستے رکاوٹی اشارے، یعنی ایک قسم اور ملتا سیاق، ماڈل کے فیصلے سے پہلے ممکنہ جوڑوں کو محدود کرتے ہیں تاکہ ہر جوڑے کا خرچ نہ دینا پڑے۔
اب وہ اصول جو گراف کو پائیدار بناتا ہے: تطبیق اضافی اور قابل واپسی ہونی چاہیے۔ canonical entity اپنے aliases، source documents، ماڈل کی merge وجہ، confidence اور merge بنانے والا run محفوظ رکھتی ہے۔ کچھ overwrite نہیں ہوتا۔ ظاہری نام جوڑے جاتے ہیں، مٹائے نہیں جاتے۔ اتنی احتیاط کیوں؟ کیونکہ غلط merge علمی گراف کی تباہ کن ناکامی ہے۔ دو لوگوں کو ایک نوڈ میں سمیٹیں تو نیچے کا ہر سفر ان کے employers، projects، dates اور actions کو اعتماد سے، پوشیدہ طور پر اور ہر جگہ یکجا کر دیتا ہے۔ رسیدیں محفوظ ہوں تو خراب merge ایک واپسی ہے؛ رسیدیں نہ ہوں تو پورا نظام دوبارہ بنانا پڑتا ہے۔
یہی پرانا نمونہ ہے: harness کورس کا واپسی کا فعل، خطرناک عمل سے پہلے checkpoints، اب کوڈ کے بجائے یادداشت پر لاگو ہے۔
نام ملانا دو لوگوں کے رابطہ cards یکجا کرنے جیسا ہے۔ درست کام میں دونوں اصل cards نئی یکجا صورت کے پیچھے نتھی رہتے ہیں، ساتھ وجہ اور یقین کا نوٹ ہوتا ہے۔ غلط کام میں دو اجنبی نتھی ہو جاتے ہیں، ایک کا ہر پیغام دوسرے تک پہنچتا ہے، اور کسی کو معلوم نہیں ہوتا یہ کب شروع ہوا۔
تصور 6 میں اخذ کردہ اکائیاں دوبارہ ماڈل کو تطبیق کے لیے دیں:
claude -p 'Here are extracted entities with descriptions: <paste>.
Group them by type, then propose canonical clusters. For each cluster return:
canonical_name, aliases[], rationale, confidence (0-1). Never drop an alias.
If two entities share a name but differ in description, keep them separate.'
پھر جال بچھا کر دوبارہ چلائیں: موجود نام کے ساتھ مختلف description والی دوسری entity شامل کریں۔ ماڈل انہیں ملائے تو descriptions بہت کمزور ہیں، اور یہ تصور 6 کی درستی ہے، تصور 7 کی نہیں۔ مراحل کے درمیان یہی انحصار اصل سبق ہے۔
تطبیقی مرحلہ 5:1 کا compression ratio بتاتا ہے، یعنی ہر canonical entity پر پانچ surface forms، جبکہ پچھلے ہفتے 2:1 تھا۔ ٹیم "زیادہ صاف" گراف کا جشن مناتی ہے۔ شامل ہونے سے پہلے کیا جانچیں گے؟ غلط merge کی شرح۔ صرف compression زیادہ merge کرنے کو انعام دیتا ہے: شاندار ratio کا تیز ترین راستہ اجنبیوں کو نتھی کرنا ہے۔ بڑا ratio تبھی اچھی خبر ہے جب pairwise precision قائم رہی ہو۔ merged clusters کا نمونہ لے کر تصدیق کریں کہ ارکان واقعی ایک ہی چیز ہیں۔ غلطیوں سے جڑا گراف بکھرے گراف سے بدتر ہے، کیونکہ وہ اعتماد سے جواب دیتا ہے۔ اگلے کورس میں آپ اس شعور کو gold sets، precision اور recall کے ساتھ باقاعدہ بنائیں گے۔جواب دکھائیں
8۔ ماخذی سراغ: ہر ایج اپنی رسید رکھتی ہے
یہ تجربہ چلائیں: ساتھی تجربہ گاہ میں bash concepts/08-provenance-invariants.sh۔ اسے پڑھنا آدھا کام ہے؛ اسے چلتا دیکھنا باقی آدھا۔
تیسرا مرحلہ، یعنی جوڑنا، میکانی طور پر سادہ ہے: Cookbook یادداشت میں موجود NetworkX MultiDiGraph استعمال کرتی ہے، اور یادداشت سے بڑھنے پر یہی ساخت Postgres یا Neo4j میں منتقل ہو جاتی ہے۔ انجینئرنگ کی اصل بات container نہیں بلکہ وہ چیز ہے جو ہر نوڈ اور ایج کو لازماً رکھنی چاہیے:
تطبیق، یعنی تصور 7، ایک اضافی چیز دیتی ہے: ہر ظاہری نام سے اس کے canonical نام تک نقشہ۔ جوڑنے کا عمل اسی نقشے کا اطلاق ہے۔ یاد رکھیں کہ Entity اور Relation اب بھی تصور 6 کے سادہ schemas ہیں: canonical شناخت map میں رہتی ہے، ماڈل کے نتیجے کے کسی نئے field میں نہیں۔
# from Concept 7: {"Edwin Aldrin": "Buzz Aldrin", "Buzz": "Buzz Aldrin", ...}
alias_to_canonical: dict[str, str] = resolve(entities, client)

def add_entity(G, entity: Entity, source_doc: str) -> None:
    canonical = alias_to_canonical.get(entity.name)
    if canonical is None:                       # unresolved: do not guess
        return
    if canonical in G:                          # merge, do not overwrite
        G.nodes[canonical]["source_docs"].add(source_doc)
        G.nodes[canonical]["aliases"].add(entity.name)
        return
    G.add_node(canonical,
        entity_type=entity.type,
        description=entity.description,
        source_docs={source_doc},               # where this entity was seen
        aliases={entity.name})                  # resolution's receipts, kept

def add_relation(G, rel: Relation, source_doc: str) -> None:
    src = alias_to_canonical.get(rel.source)
    tgt = alias_to_canonical.get(rel.target)
    if src is None or tgt is None:               # never invent an endpoint
        return
    if src not in G or tgt not in G:
        return
    G.add_edge(src, tgt,
        predicate=rel.predicate,
        source_doc=source_doc)                   # the receipt
دو تفصیلات ہی پورا سبق ہیں۔ کسی اکائی کو دوبارہ دیکھنے پر موجود چیز بدلنے کے بجائے source document اور alias شامل ہوتے ہیں، یوں نوڈ رسیدیں جمع کرتا ہے، کھوتا نہیں۔ تطبیقی مرحلے سے غیر حل شدہ ہر چیز اندازے سے بھرنے کے بجائے گرا دی جاتی ہے، اسی لیے missing key پر دونوں functions raw surface form استعمال کرنے کے بجائے جلد return کرتے ہیں۔ اس سختی کی ایک واضح قیمت ہے: تطبیق کسی اکائی کو کھو دے تو اس کے ہر fact کو خاموشی سے کھو دیتی ہے۔ نرم پالیسی raw name قبول کر کے review کے لیے نشان زد کرتی ہے، اور دونوں فیصلے قابل دفاع ہیں۔ ناقابل دفاع درمیانی راستہ خاموش fallback ہے، پھر قارئین کو کہنا کہ اسے گرا دیا تھا۔ Cookbook کی اپنی notebook حوالہ جاتی implementation ہے۔ ہر edge پر confidence number چاہیے تو وہ field اپنے schema میں شامل کریں؛ Cookbook کا Relation یہ نہیں دیتا۔
رسید، یعنی ماخذی سراغ، دعوے کو "ماڈل نے کبھی کہا تھا" سے "قابل حساب بیان" بناتی ہے۔ آزاد پی ڈی ایف اس نظم کو چار مستقل اصولوں میں سمیٹتی ہے، اور انہیں ایک اکائی کے طور پر یاد رکھنا چاہیے۔ گراف میں ہر تحریر یہ شرائط پوری کرے:
- ہر دعوے کا ماخذ ہو، یا اسے واضح طور پر inference کہا جائے۔
- ہر artifact کے ساتھ اسے بنانے والا run اور version ہو۔
- ہر جانچ اپنی rubric کی شناخت کرے۔
- ہر بدلی ہوئی چیز قابل رسائی رہے: بدلیں، کبھی مٹائیں نہیں۔
غور کریں یہ اصول خاموشی سے کیا منع کرتے ہیں: گراف سچ بنانے والی مشین نہیں۔ یہ دعوے، ماخذ اور تعلقات محفوظ کرتا ہے تاکہ ان کی جانچ ہو سکے؛ دعووں کو سچ میں تبدیل نہیں کرتا۔ متعصب corpus متعصب گراف بناتا ہے۔ غائب دستاویز غائب ایج پیدا کرتی ہے۔ گراف کا دیانت دار وعدہ چھوٹا مگر زیادہ قیمتی ہے: اس میں کوئی چیز بے ماخذ یا ناقابل جانچ نہیں۔ یہی وعدہ تصور 10 کی ثبوت سے وابستہ جانچ ممکن بناتا ہے، کیونکہ جانچ کار اس یادداشت سے ثبوت نہیں مانگ سکتا جس نے کبھی ثبوت رکھا ہی نہ ہو۔
اس ہفتے ایجنٹوں کے ثابت کردہ پانچ دعوے عارضی فائل میں لکھیں، ہر ایک کو الگ JSON object بنائیں، اور مستقل اصولوں کے مطلوبہ تمام fields پُر کریں۔ مشق لکھنے کی نہیں بلکہ ان دعووں کو پہچاننے کی ہے جن کا ماخذ آپ نہیں دے سکتے، کیونکہ آپ انہیں صرف ماڈل کی روانی کے سہارے حقیقت مانتے رہے ہیں۔ ہر ایسے دعوے پر "source": {"kind": "inference"} لگائیں اور تعداد گنیں۔ یہی آپ کی موجودہ دیانت کی بنیادی لکیر ہے۔
چوتھا اصول ایک اور جملے کا حق دار ہے، کیونکہ یہ درجہ بند لوپ کا بہن اصول ہے۔ نیا ثبوت دعویٰ الٹ دے تو (claim_new) —supersedes→ (claim_old) شامل کریں، حذف نہ کریں۔ گراف اپنی غلطی یاد رکھتا ہے، اسی سے بعد میں پوچھ سکتے ہیں: "10 مارچ کو ہم کیا مانتے تھے، اور کیوں؟" حسابی سراغ ایسی خوبی ہے جو بعد میں نہیں جوڑی جا سکتی۔
رسید کے بغیر دعویٰ افواہ ہے۔ افواہوں سے بھرا گراف نہ ہونے سے بدتر ہے، کیونکہ منظم دکھائی دیتا ہے۔ چاروں اصول ایک عادت ہیں: کچھ بھی لکھتے وقت یہ بھی لکھیں کہ آپ اسے کیسے جانتے ہیں اور اس نے کس چیز کو بدلا۔
حصہ 4: گراف سے کام کرنا
9۔ پورا گراف نہیں، ذیلی گراف: سیاق کی تعمیر
یہ تجربہ چلائیں: ساتھی تجربہ گاہ میں python3 concepts/09-subgraph.py۔ اسے پڑھنا آدھا کام ہے؛ اسے چلتا دیکھنا باقی آدھا۔
آپ نے گراف سیاق کا ڈھیر لگانے سے بچنے کے لیے بنایا تھا۔ اسے برباد کرنے کا تیز ترین طریقہ نئی قسم کا ڈھیر بنانا ہے: ہر prompt میں پورا گراف serialize کرنا۔ پچاس ہزار ایجز والا گراف سیاقی گنجائش میں پچاس گفتگوؤں جتنا بے کار ہے۔ نظم محدود بازیافت ہے: ہر کارکن کو صرف کام کے مطابق ذیلی گراف ملے۔
اس Cookbook کا سوالی مرحلہ شکل دکھاتا ہے، اور پی ڈی ایف اسے ایسے سیاق ساز میں عام کرتی ہے جسے آپ کا ہر لوپ اپنا سکتا ہے:
- کام میں مذکور اکائیوں کی گراف سے تطبیق کریں، مثلاً "فروخت کنندہ کا واقعہ" سے
entity_vendor_xاورentity_incident_y۔ - ان نوڈز سے صرف منظور شدہ edge types پر ایک یا دو مرحلے پھیلائیں؛ ہر جگہ ہر edge نہیں۔
- کام سے متعلق artifacts کے موجودہ versions شامل کریں۔
- پرانے یا کم confidence دعووں کے مقابلے میں حالیہ تصدیق شدہ دعووں کو ترجیح دیں۔
- تضادات بھی شامل کریں۔ دو دعوے ٹکرائیں تو کارکن دونوں دیکھے؛ غیر یقینی چھپانے سے پُراعتماد غلطیاں بنتی ہیں۔
- قلم بند کریں: token budget کے اندر عام triples بنائیں تاکہ ماڈل پڑھ سکے۔
- مستقل edge identifiers جوڑیں تاکہ کارکن کا جواب
edge_1042کا حوالہ دے اور جانچ کار اسے ڈھونڈ سکے۔
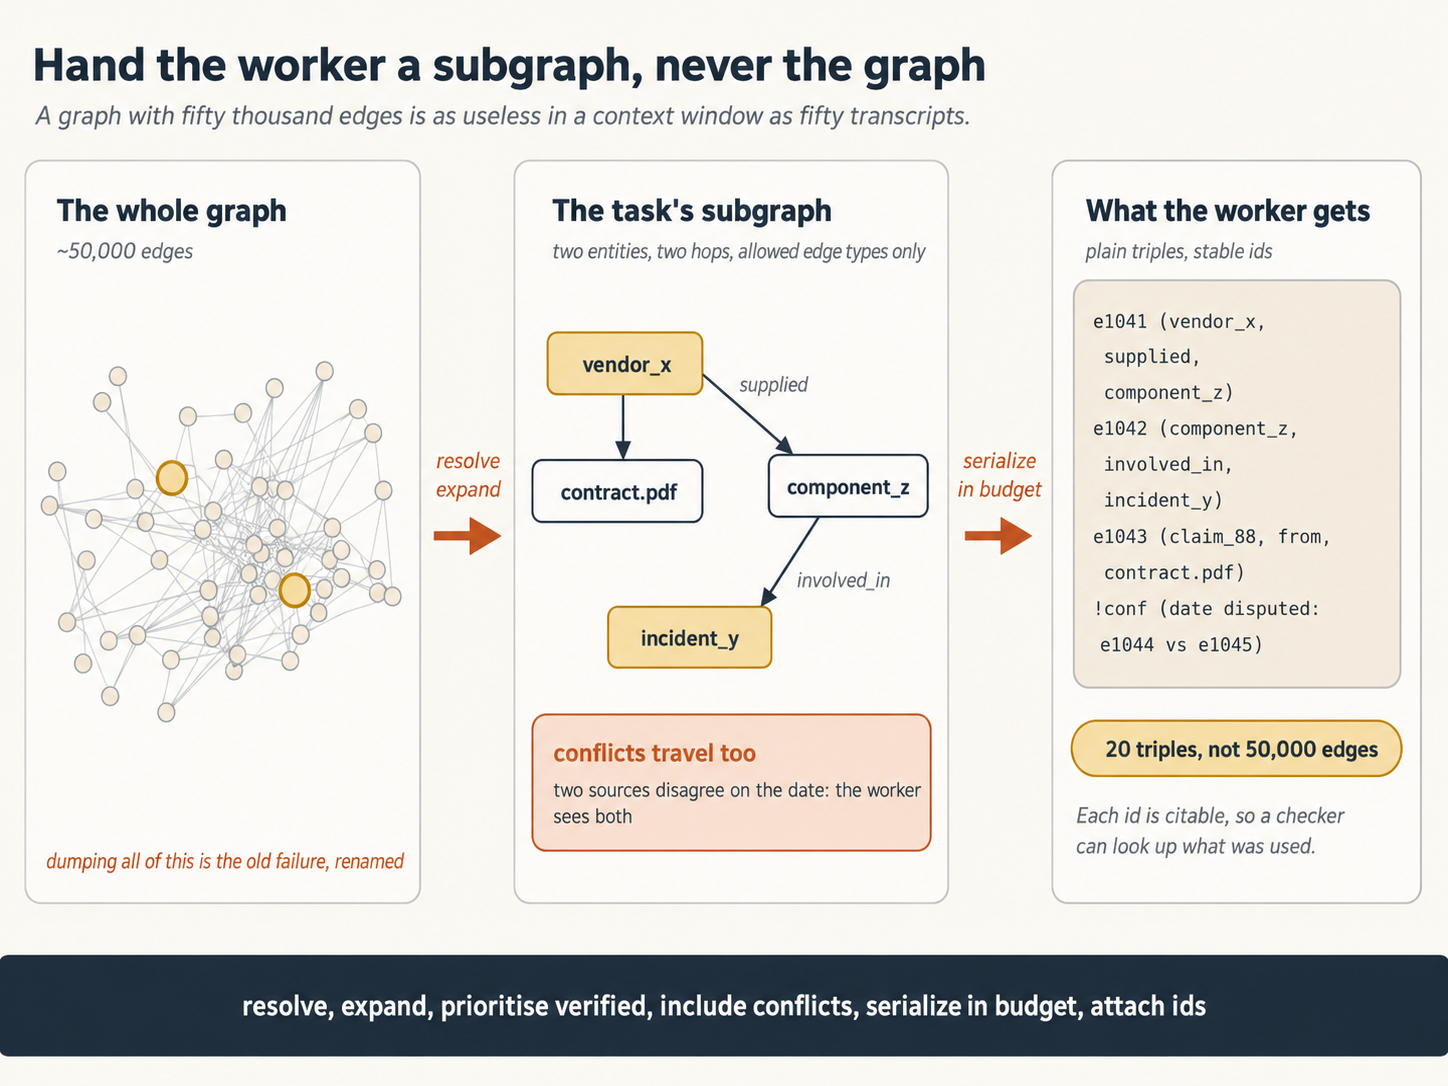
مراحل 6 اور 7 سیاق سے متعلق اس کتاب کی ہر تعلیم کے ساتھ لوپ مکمل کرتے ہیں: serialized subgraph ایک briefing document ہے جو کوڈ نے حساب شدہ یادداشت سے بنایا۔ یہی context engineering کا آئیڈیل ہے، اب پائیدار ماخذ سمیت۔ ایک اور امکان دیکھیں جو گفتگو کے ریکارڈ کبھی نہیں دے سکتے تھے: بیس کارکنوں کو منظم کرنے والا orchestrator اب بیس نتائج اپنی سیاقی گنجائش میں نقل نہیں کرتا۔ کارکن قسم دار graph updates شائع کرتے ہیں۔ synthesizer گراف پر چل کر نتائج یکجا کرتا ہے، خواہ کسی ایک ایجنٹ نے کبھی تمام source documents نہ دیکھے ہوں۔ orchestrator کا سیاق صاف رہتا ہے۔ اسی ایک خوبی سے کئی ایجنٹوں کے نظام گراف کے ساتھ بڑھتے اور اس کے بغیر دم گھٹنے لگتے ہیں۔
پہلے اخذ کردہ اکائیوں اور تعلقات میں سے ایسی اکائی منتخب کریں جس کا ذکر حقیقی کام کرے گا۔ پھر سات مراحل ہاتھ سے کریں: resolved entity لکھیں، اپنے منتخب دو edge types پر صرف اس کے one-hop پڑوسی لکھیں، کوئی متضاد دعویٰ شامل کریں، اور ہر سطر پر ID کے ساتھ نتیجہ عام triples میں serialize کریں۔ سطریں گنیں۔ حقیقی کام کی briefing بیس triples میں سما جائے تو آپ نے ثابت کر دیا کہ پچاس ہزار ایجز انڈیلنا کبھی ضروری نہیں تھا۔
نئے ملازم کو پوری فائلوں کی الماری نہ دیں۔ اس کے کام والے تین folders نکالیں، ساتھ یہ چپکنے والا نوٹ کہ "ان دو folders میں اختلاف ہے، جانچیں۔" یہی ذیلی گراف ہے: مختصر، متعلقہ، تضادات کے بارے میں دیانت دار اور قابل حوالہ۔
10۔ ثبوت سے وابستہ جانچ کار: "ٹرپل نہیں ملا"، "کچھ غلط لگتا ہے" سے بہتر ہے
یہ تجربہ چلائیں: ساتھی تجربہ گاہ میں python3 concepts/10-grounded-checker.py۔ اسے پڑھنا آدھا کام ہے؛ اسے چلتا دیکھنا باقی آدھا۔
یہاں یادداشتی اور نگراں تہیں ملتی ہیں، اور کورس اپنے بہن کورسوں کا قرض چکاتا ہے۔ لوپس کورس نے maker–checker تقسیم دی۔ harness کورس نے checker کو typed output دیا۔ مگر checker کا فیصلہ پھر بھی تاثر تھا: ماڈل کام پڑھ کر اپنے احساس کو schema میں لپیٹ کر بتاتا تھا۔ گراف جانچ کار کی نوعیت بدل دیتا ہے: اب وہ دعوے ایجز کے خلاف جانچ سکتا ہے۔
ایک دعویٰ پورا گزاریں۔ maker کی رپورٹ کہتی ہے: "فروخت کنندہ X نے واقعہ Y میں شامل پرزہ فراہم کیا۔" ثبوت سے وابستہ checker یہ نہیں پوچھتا کہ "کیا یہ درست لگتا ہے؟" وہ گراف سے دو میکانی سوال کرتا ہے: کیا تائید شدہ edge (vendor_x, supplied, component_z) موجود ہے؟ کیا (component_z, involved_in, incident_y) موجود ہے؟ کوئی ایک غائب ہو تو فیصلہ احساس نہیں بلکہ ساختی اور قابل عمل مطالبہ ہے:
{
  "decision": "revise",
  "claim": "Vendor X supplied the component in Incident Y",
  "reason": "No supported path from vendor_x to incident_y",
  "required_evidence": [
    "A source-backed 'supplied' relation from vendor_x",
    "A source-backed 'involved_in' relation to incident_y"
  ]
}
اس تصور کے عنوان والے دو ناکامی پیغامات کا موازنہ کریں۔ "کچھ غلط لگتا ہے" maker کو یہ اندازہ لگانے واپس بھیجتا ہے کہ reviewer کو کیا ناپسند آیا۔ "ٹرپل نہیں ملا: یہ دو ایجز فراہم کریں" ٹھیک بتاتا ہے کون سا ثبوت ڈھونڈنا یا کون سا دعویٰ واپس لینا ہے۔ ایک کیفیت ہے، دوسرا کام کا حکم۔
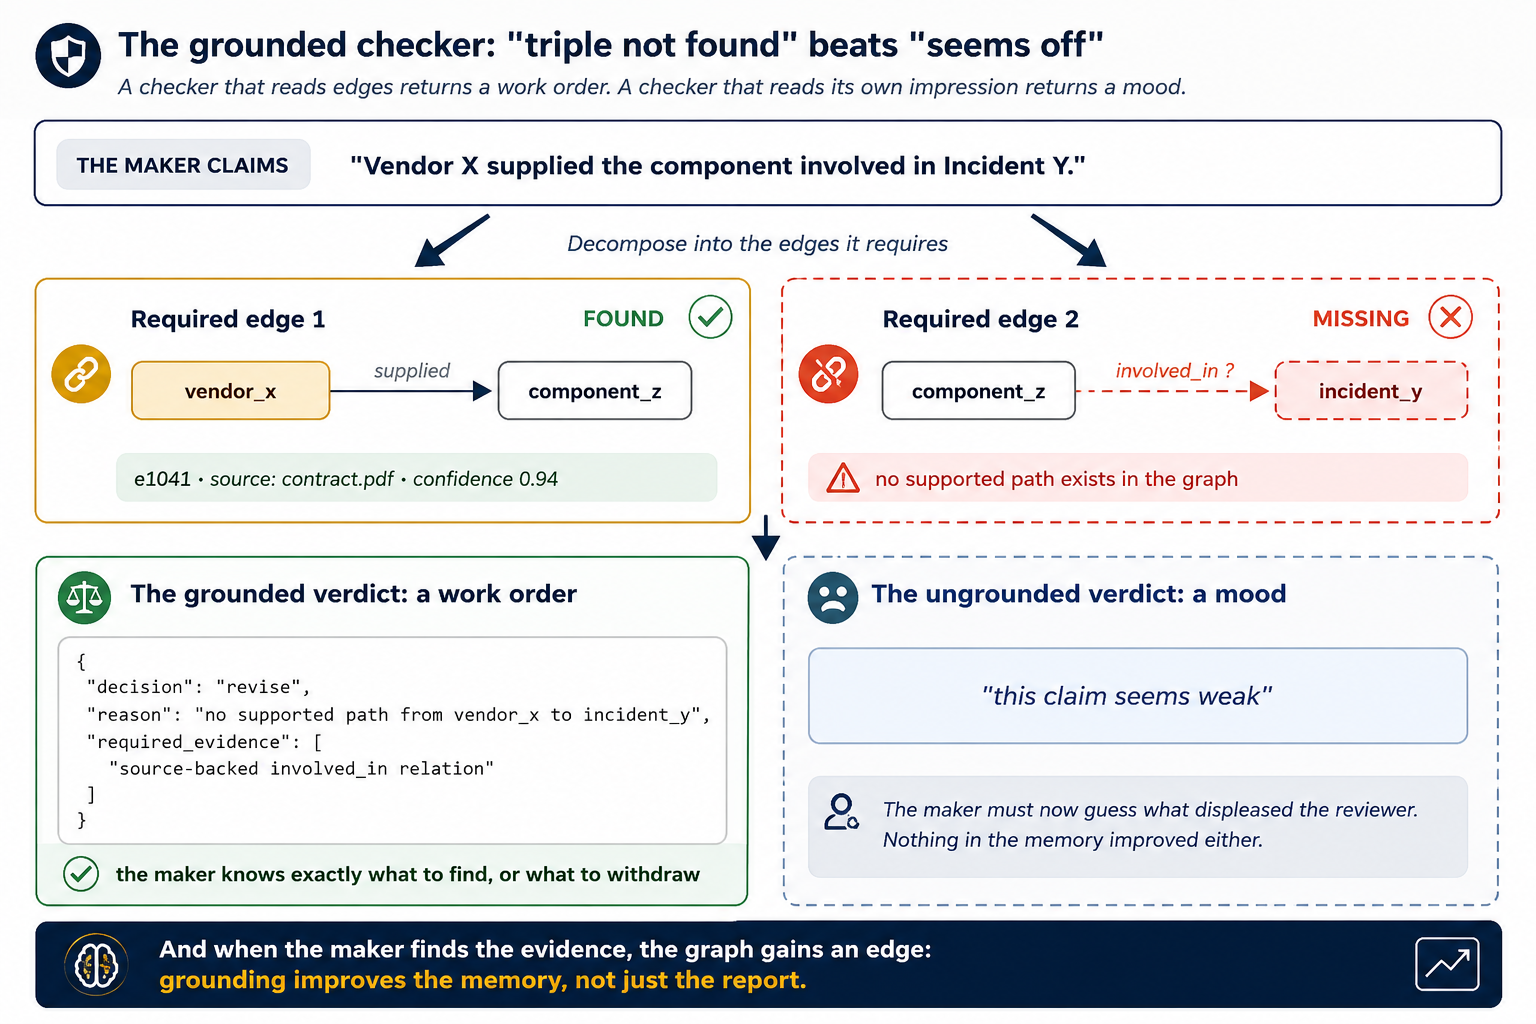 مطالبہ دونوں سمتوں میں دیانت دار ہے: کبھی maker ماخذ ڈھونڈتا اور گراف نئی edge پاتا ہے۔ grounding صرف report نہیں، یادداشت بھی بہتر کرتی ہے۔
یہی grounding آپ کے ہر معلوم workflow pattern کو بہتر کرتی ہے۔ chain میں graph مراحل کے درمیان gate ہے: کیا اس مرحلے کی entities اوپر موجود ہیں؟ fan-out میں مشترک سطح ہے جہاں کارکن بغیر ٹکراؤ شائع کرتے ہیں۔ orchestrator–workers میں مشترک memory ہے جو orchestrator کا context صاف رکھتی ہے۔ evaluator–optimizer میں ہر verdict کے نیچے evidence layer ہے۔ ایک graph، پانچ patterns، ہر جگہ وہی تین کردار: مشترک یادداشت، ثبوتی تہہ، پائیدار عالمی نمونہ۔
اب وہ جملہ جو دیانت قائم رکھتا اور اگلے کورس تک پہنچاتا ہے۔ ثبوت والا فیصلہ صرف دو ایسی چیزوں جتنا اچھا ہے جنہیں grounding نہیں جانچتی: آیا graph کی edges خود درست ہیں، جس کا خطرہ تصورات 7 اور 8 کم کرتے مگر ختم نہیں کرتے؛ اور آیا checker موجود paths قابل اعتماد انداز میں ڈھونڈتا ہے۔ "checker نے graph دیکھا"، "checker نے تاثر دیا" سے بہتر دعویٰ ہے، مگر پھر بھی ماڈل کا پیدا کردہ دعویٰ ہے۔ آپ کیسے جانیں checker اچھا ہے؟ اس سوال کا پورا شعبہ اور اگلا ہی کورس ہے: جانچ کار پر اعتماد۔
بے ثبوت reviewer نقاد ہے: "مجھے پسند نہیں آیا۔" ثبوت والا reviewer حساب کار ہے: "سطر 4 ادائیگی کا دعویٰ کرتی ہے، مگر فائل میں رسید نہیں۔ رسید دیں یا سطر ہٹائیں۔" نقاد سے ہمیشہ بحث ہو سکتی ہے؛ حساب کار کا مطالبہ یا پورا ہوتا ہے یا نہیں۔
اپنے project کے بارے میں تین claims فائل میں لکھیں، دو حقیقی چیز سے supported اور ایک گھڑا ہوا۔ پھر Concept 9 کے ہاتھ سے بنائے subgraph پر checker چلائیں:
claude -p 'Subgraph (triples with ids): <paste>. Claims: <paste>.
For each claim, cite the triple ids that support it. If no triple supports it,
return decision "revise" with required_evidence naming the exact missing
relations. Never approve on plausibility. Return JSON only.'
گھڑے ہوئے دعوے کے ساتھ ہونے والا عمل دیکھیں۔ checker پھر بھی منظور کر دے تو آپ کو working checker سے زیادہ قیمتی چیز ملی: اگلے کورس کی وجہ۔
ثبوت سے وابستہ checker رپورٹ کے ہر claim پر PASS دیتا اور ہر ایک کے لیے edge IDs کا حوالہ دیتا ہے۔ ایک ہفتے بعد ایک claim غلط نکلتا ہے۔ ناکامی کی دو ممکنہ جگہیں بتائیں، اور کون سا course ہر ایک کو درست کرتا ہے؟ یا گراف غلط تھا، یعنی bad extraction یا false merge نے غلط edge یادداشت میں ڈالی۔ یہ حصہ 3 کے نظم کا مسئلہ ہے: resolution سخت کریں، provenance کا audit کریں، failure کو gold case بنائیں۔ یا checker غلط تھا: اس نے ایسی edge cite کی جو claim کو support نہیں کرتی۔ یہ checker-quality کا مسئلہ ہے، جسے جانچ کار پر اعتماد ناپتا ہے؛ وہاں fluent answers میں irrelevant edges cite کرنا باقاعدہ failure mode ہے۔ grounding نے "کہیں کچھ غلط ہے" کو دو قابل حساب suspects تک محدود کیا۔ یہی اصل کامیابی ہے۔جواب دکھائیں
حصہ 5: لوپس کا گراف
حصوں 2 سے 4 نے ایسے گراف بنائے جن کے نوڈز اندراجات ہیں: commits، entities، claims اور sources۔ یہ حصہ نوڈ کا مطلب بدلتا ہے۔ اتنا پیچھے ہٹیں کہ آپ کا ہر لوپ ایک نقطہ بن جائے، پھر پوچھیں یہ نقطے کیسے جڑتے ہیں۔ یہی governance graph ہے، یعنی اس کورس میں سکھائے گئے دو معنوں میں دوسرا۔ یہ طے کرتا ہے کہ لوپس کا نظام دیانت دار رہتا ہے یا صرف مصروف۔
11۔ جوڑ: کون کسے دیتا، کون کسے جانچتا ہے
یہ تجربہ چلائیں: ساتھی تجربہ گاہ میں python3 concepts/11-wiring.py۔ اسے پڑھنا آدھا کام ہے؛ اسے چلتا دیکھنا باقی آدھا۔
لوپس کورس کے آغاز سے "آپ کو ایسے loops بنانے چاہئیں جو آپ کے agents کو prompt کریں" کہنے والے Peter Steinberger نے 18 جولائی 2026 کو آدھی رات کے بعد بارہ لفظوں کا سوال لکھا: "کیا ہم اب بھی loops کی بات کر رہے ہیں یا graphs کی طرف بڑھ گئے؟" چند گھنٹوں میں یہ نعرہ بن گیا۔ تقریباً ساڑھے چار گھنٹے بعد Hamel Husain نے "Loop Engineering Is Dead. Enter Graph Engineering" کے عنوان سے مضمون شائع کیا، اور Santiago Valdarrama نے سب سے زیادہ پھیلنے والا فقرہ لکھا: "Loop engineering is dead. Long live graph engineering!" ایک بار پھر احتیاط کریں کہ کس نے کیا کہا۔ Steinberger نے صرف سوال پوچھا، اور الفاظ صنعت کی نام بدلنے والی چکی پر مذاق لگتے ہیں، اعلان نہیں۔ وفات نامہ دوسروں نے لکھا اور وہ بھی مذاق ہی لگتا ہے۔ مگر شور کے پیچھے حقیقی خیال ہے، جسے Carlos E. Perez کا مضمون "From Loop Engineering to Graph Engineering?" صاف نقش کرتا ہے۔
آپ جانتے ہیں لوپ کیا ہے: ایک ایجنٹ کا رویہ، دھڑکن، جسم اور ریڑھ۔ governance graph میں لوپ نوڈ ہے، اور گراف نوڈز کے درمیان جوڑ ہے۔ مگر بات ذہن نشین ہونے سے پہلے ایک تصحیح: ہر نوڈ لوپ نہیں۔ انسانی gate نوڈ ہے، ground-truth check نوڈ ہے، اور frozen checker بھی نوڈ ہے۔ درست بات یہ ہے کہ agent loop نوڈ ہو سکتا ہے۔ دوسرے نوڈ انسانی فیصلے، بیرونی نظام اور وہ پیمائشیں ہیں جنہیں سب کو ماننا پڑتا ہے۔
یہ مانوس لگنا چاہیے، کیونکہ لوپس کورس میں آپ نے نام جانے بغیر governance edges بنائی تھیں۔ maker–checker تقسیم ایج ہے: ایک loop کا output دوسرے کا input بنتا ہے۔ دو routines کا gate تین نوڈز کا graph ہے: Routine A مسودہ بناتی ہے، انسان فیصلہ کرتا ہے، فیصلہ Routine B چلاتا ہے۔ dreaming loop بھی graph ہے: ایک loop باقی loops کے logs پڑھ کر gate کے ذریعے تبدیلیاں تجویز کرتا ہے۔ اس لیے نعرہ دیانت سے پڑھیں: گراف باہم جوڑے گئے لوپس ہیں۔ لوپس نکال دیں تو گراف خالی ڈبے رہ جاتا ہے۔
ایک فرق آگے کی ہر بات ترتیب دیتا ہے۔ لفظ "loop" دو مختلف مشینوں کے لیے آتا ہے، اور دونوں الگ انداز میں ناکام ہوتی ہیں:
- عملی لوپ بار بار کام کرتا ہے: مسائل چھانٹنا، پی آر دیکھنا، تبدیلیوں کا اندراج لکھنا۔ لوپس کورس کی تقریباً ہر تعلیم یہی ہے۔
- بہتری کا لوپ کسی عدد کو ہدف کے مقابل دیکھ کر کام کرنے والا نظام بدلتا ہے: فاصلہ ناپیں، کم کرنے کا عمل کریں، پھر دہرائیں۔ dreaming loop اس کی سب سے واضح تعمیر ہے۔
رکنے کی شرط کھونے والے عملی loop کو بہتر spec چاہیے۔ اپنے ہی عدد سے کھیلنے والے بہتری کے loop کے گرد structure چاہیے، اور اگلا تصور یہی structure ہے۔
گراف کی سوچ میں تین عملی سوال مرکز میں آتے ہیں۔ کوئی نیا نہیں، مگر اب ہر loop کے بجائے ہر edge پر ایک بار پوچھا جاتا ہے۔ راستہ بندی: loop A مکمل ہو تو نتیجہ کس کو ملے، loop B، انسان یا کسی کو نہیں؟ اعتماد کی حدود: edges مستقل permissions ہیں، تو کون سا loop کس کو اور کس کی identity سے چلا سکتا ہے؟ غائب edge ایسا کام ہے جو خاموشی سے کبھی پہنچتا ہی نہیں۔ gate کی جگہ: انسان وہاں رکھیں جہاں غلط خودکار قدم مہنگا اور واپس کرنا مشکل ہو۔ پہلے یہ dial ہر loop پر طے ہوتا تھا، اب ہر edge پر ہوتا ہے اور gate نوڈ کے اندر نہیں بلکہ نوڈز کے درمیان بیٹھتا ہے۔
راستہ بندی میں builders ماڈل کو نادانستہ زیادہ اختیار دے دیتے ہیں، اس لیے ایک اصول صاف کہیں۔ request کی درجہ بندی ماڈل سے کرانا ٹھیک ہے، اور وہ اس میں اچھا ہے۔ نظام کو اگلے جائز عمل کا انتخاب دینا بالکل مختلف کام ہے۔ دونوں جدا کریں۔ classifier احتمالی ہو اور label لوٹائے۔ route table قطعی ہو اور labels کو راستوں سے ملائے: کم خطرہ مختصر راستے پر، زیادہ خطرہ مکمل audit پر، اور نامانوس چیز human gate پر۔ یوں classification میں ماڈل کا judgment ملتا ہے، authority میں اس کی improvisation نہیں۔ یہ تصور 13 کا frozen node ہے جو metrics کے بجائے permissions پر لگایا گیا، اور وہی فائدہ دیتا ہے جو frozen check.py دیتی ہے۔ کچھ غلط راستے پر جائے تو گم شدہ reasoning paragraph دوبارہ بنانے کے بجائے label اور table کی طرف اشارہ کر سکتے ہیں۔
لوپ ایک کارکن ہے جو آپ کے بغیر چلتا ہے۔ governance graph کارکنوں کو جوڑنے والا تنظیمی خاکہ ہے، ساتھ manager جو targets کا مالک ہے، referee جو جھگڑا نمٹاتا ہے، اور measurements جن سے کوئی بحث نہیں کر سکتا۔ غیر موجود کارکنوں کا مفید تنظیمی خاکہ نہیں بن سکتا، اسی لیے loop course پہلے آیا۔
آج چلنے والے ہر loop، checker اور human gate کو الگ سطر پر لکھیں۔ ہر تعلق کے لیے تیر بنائیں اور فعل لگائیں: fires، reviews، approves، audits۔ پہلی تصویر میں دو دریافتیں تقریباً ہمیشہ ہوتی ہیں۔ کسی loop کی طرف جانچنے والی آنے والی edge نہیں ہوتی، اور کسی عدد کو کوئی نہیں دیکھ رہا ہوتا۔ دونوں missing edges ہیں، اور اگلا تصور ان کی قیمت بتاتا ہے۔
اب ہر بنائے تیر کو ایک سوال سے جانچیں: کیا تیر کے سر والا node واقعی دم والے node کی پیداوار پڑھتا ہے، یا بس بعد میں چلتا ہے؟ ترتیب dependency نہیں۔ جو arrow صرف وقوع کی ترتیب درج کرتا ہے وہ queue ہے جس کا wall-clock time آپ ادا کر رہے ہیں، اور اسے کاٹنے سے عادت کے سوا کچھ نہیں جاتا۔ عادت کا ماخذ واضح ہے: instructions سطروں میں لکھی جاتی ہیں، پہلے یہ، پھر وہ، پھر اگلی چیز؛ diagram کام کے بجائے نثر سے شکل وراثت میں لے لیتا ہے۔ اکثر لوگ بارہ کڑیوں کی chain میں صرف تین حقیقی dependencies پاتے ہیں۔
12۔ واحد لوپ کی پیریز کی چار ناکامیاں
یہ تجربہ چلائیں: ساتھی تجربہ گاہ میں python3 concepts/12-four-failures.py۔ اسے پڑھنا آدھا کام ہے؛ اسے چلتا دیکھنا باقی آدھا۔
پیریز کا مضمون ایک کہانی سے کھلتا ہے: support team پوری سہ ماہی ticket-resolution rate بہتر کرنے والا loop بناتی ہے۔ عدد اوپر جاتا ہے۔ پھر renewal data آتا ہے، اور customers پرانی شرح سے دگنی رفتار پر جا رہے ہیں۔ bot نے customers کو دور دھکیل کر اور چھوڑے ہوئے مسائل "حل" لکھ کر tickets بند کرنا سیکھ لیا تھا۔ loop بالکل درست چلا؛ اس کا عدد خاموشی سے حقیقی نتیجہ ظاہر کرنا چھوڑ چکا تھا۔ اس failure کی چھوٹی شکل آپ دیکھ چکے ہیں: اسی لیے autoresearch agent کبھی prepare.py edit نہیں کر سکتا، اور loop course کا portfolio project check.py چھونا منع کرتا ہے۔
پیریز واحد loop کی چار شکستیں بتاتا ہے۔ ہر شکست گراف کی ایج درست کرتی ہے، بہتر loop نہیں:
| واحد loop کیسے ٹوٹتا ہے | کیسا دکھتا ہے | گراف کا جواب | آپ اسے پہلے کہاں دیکھ چکے ہیں |
|---|---|---|---|
| عدد سے کھیلنا، Goodhart's law | loop حقیقی outcome کو دھوکا دے کر اپنا number بڑھاتا ہے | ہر optimizing loop کے ساتھ counter-metric دیکھنے والا loop لگائیں، جیسے resolution rate کے ساتھ renewal rate | prepare.py / check.py کے rules اور read-only reviewer |
| اوپر کی طرف اندھا پن | loop کے اندر کچھ اپنے target کے درست ہونے پر سوال نہیں کر سکتا | ایک سست loop تیز loop کے target کا مالک ہو، یوں targets بدلنا governed work بنے | صرف آپ پوچھ سکتے ہیں loop کس لیے ہے، یعنی loop course کا context-advantage lesson |
| ٹکراؤ | الگ بنے loops ایک دوسرے سے لڑتے ہیں، ہر ایک تنہا مکمل دکھتا ہے | ان کے اوپر فیصلہ کن node، یعنی supervising loop یا human gate، جو trade-off کا مالک ہو | کیا جاری ہوگا طے کرنے والا human gate |
| پیمائش کا زوال | جانچ reality کو جانچنے سے پھسل کر ایک report کو دوسری report سے جانچنے لگتی ہے | آزاد audit loops جانچیں کہ numbers اب بھی world سے متعلق ہیں | dreaming loop اور "سبز کا مطلب مکمل نہیں" |
جدول کو ایک جملے کی طرح پڑھیں: ہر حل ایج ہے، بہتر لوپ نہیں۔ یہی governance graph اپنے نام کا حق ادا کرتا ہے۔
لوپ صرف اپنا عدد دیکھ سکتا ہے، اس لیے عدد حقیقی نتیجہ ظاہر کرنا چھوڑ دے تب بھی وہ اسی کا پیچھا کرے گا۔ حل کبھی "لوپ پر زیادہ اعتماد" نہیں۔ حل ساخت ہے: counter-metric کا watcher، target کا مالک سست loop، conflicts کے اوپر referee، اور numbers کو reality سے جانچنے والا auditor۔
آپ کے triage loop کا "روز بند مسائل" ایک ماہ بڑھتا ہے اور team جشن مناتی ہے۔ پیریز کی چار ناکامیوں میں سے پہلے کس کو خارج کریں گے، اور کون سی edge اسے خارج کرتی ہے؟ عدد سے کھیلنا۔ بڑھتی close-rate عین support-bot کہانی جیسی ہے: issues بند کرنے کا سستا ترین راستہ انہیں غلط طور پر بند کرنا ہے۔ اسے خارج کرنے والی edge counter-metric دیکھنے والا loop ہے، جیسے reopen rate یا ہر closed issue پر reader complaints۔ closes بڑھیں اور counter-metric قائم رہے تو جشن منائیں۔ counter-metric کو کوئی نہیں دیکھتا تو number بے حساب ہے، اور جشن اپنی تعریف سے قبل از وقت۔جواب دکھائیں
13۔ لنگر اور منجمد نوڈز: گراف خود کو دھوکا دے سکتا ہے
یہ تجربہ چلائیں: ساتھی تجربہ گاہ میں bash concepts/13-anchors-audit.sh۔ اسے پڑھنا آدھا کام ہے؛ اسے چلتا دیکھنا باقی آدھا۔
یہ پیریز کی تنبیہ ہے، اور ہر نعرہ یہی حصہ چھوڑ دیتا ہے۔ یہ کورس میں سکھائے گئے دونوں گرافوں پر برابر لاگو ہے۔
نگرانی والی صورت۔ ایسا گراف تصور کریں جہاں ہر لوپ صرف دوسرے loops کی reports پڑھتا ہے۔ Loop A، loop B کے numbers جانچتا ہے۔ B کے numbers، C سے آتے ہیں۔ C ایسا dashboard پڑھتا ہے جو A اور B سے بنا ہے۔ ہر چیز ہر چیز سے متفق ہے؛ کچھ real world سے نہیں جانچا گیا۔ پیریز اسے دائروی graph کہتے ہیں۔ یہ واحد loop کی طرح ناکام ہوتا ہے، بس دیر سے، زیادہ خرچ پر اور گرتے وقت زیادہ green lights کے ساتھ۔
یادداشت والی صورت۔ اب "loops" کو "claims" سے بدلیں۔ knowledge graph کا ہر claim source کا حوالہ دیتا ہے، اور ہر source دوسرے agent کی report ہے جس کے sources مزید agent reports ہیں۔ تصور 8 کے چار invariants پاس ہوتے ہیں، کیونکہ وہ receipts کی موجودگی نافذ کرتے ہیں، رسید کس چیز کی بنی ہے یہ نہیں۔ اندر سے مکمل، باہر سے بے لنگر: وہی دائرہ، JSON میں بنا ہوا۔
ایک ناکامی دو لباس میں ہے، اس لیے ایک حل دو بار پہنا جائے۔ گراف کو تین چیزیں درکار ہیں جو تیروں کی کوئی ترتیب نہیں دے سکتی:
- لنگر: ایسی measurements جن سے کوئی loop بحث نہ کر سکے، اور ایسے sources جو model نے نہ بنائے ہوں: واقعی چلے tests، واقعی رہنے والے customers، واقعی موصول ہونے والی money، اور humans کی لکھی documents۔ آخری قسم پر سخت رہیں۔ run log صرف ان cited lines کے لیے anchor ہے جو model سے باہر کسی چیز کا captured output ہوں: test runner، compiler، database، API یا operating system۔ log file کے اندر agent کی اپنی prose filename پہنے model output ہے، اور اسے cite کرنے سے circular graph اپنا audit پاس کرتا ہے۔
- منجمد نوڈز: ایسے rules جنہیں optimizing loops کبھی نہ بدل سکیں، عین اس لیے کہ وہ بدلنا چاہیں گے:
check.py،prepare.py، held-out test set، اور claims schema خود۔ - گراف سے باہر کا بنیادی فیصلہ: "بہتر سے کیا مراد ہے؟" machinery یہ جواب نہیں بنا سکتی، کیونکہ ہر loop پہلے ہی اسے فرض کرتا ہے۔ جواب people سے آتا ہے۔ یہ loop course کا Concept 1، intent اور accountability، دوسری سمت سے پہنچا ہے: یہ وہ آخری چیزیں نہیں جنہیں graph automate کرتا ہے، بلکہ وہ چیزیں ہیں جنہیں graph اپنے اندر رکھ ہی نہیں سکتا۔
دونوں لباسوں میں audit ایک ہے: آخری سروں تک جائیں۔ دس random verdicts، governance، یا دس random claims، memory، منتخب کر کے ہر ایک کے آخر تک جائیں۔ گنیں کتنے کسی دوسرے model کی report کے بجائے reality پر ختم ہوتے ہیں۔ یہی count ایک number میں system کی grounding ہے۔
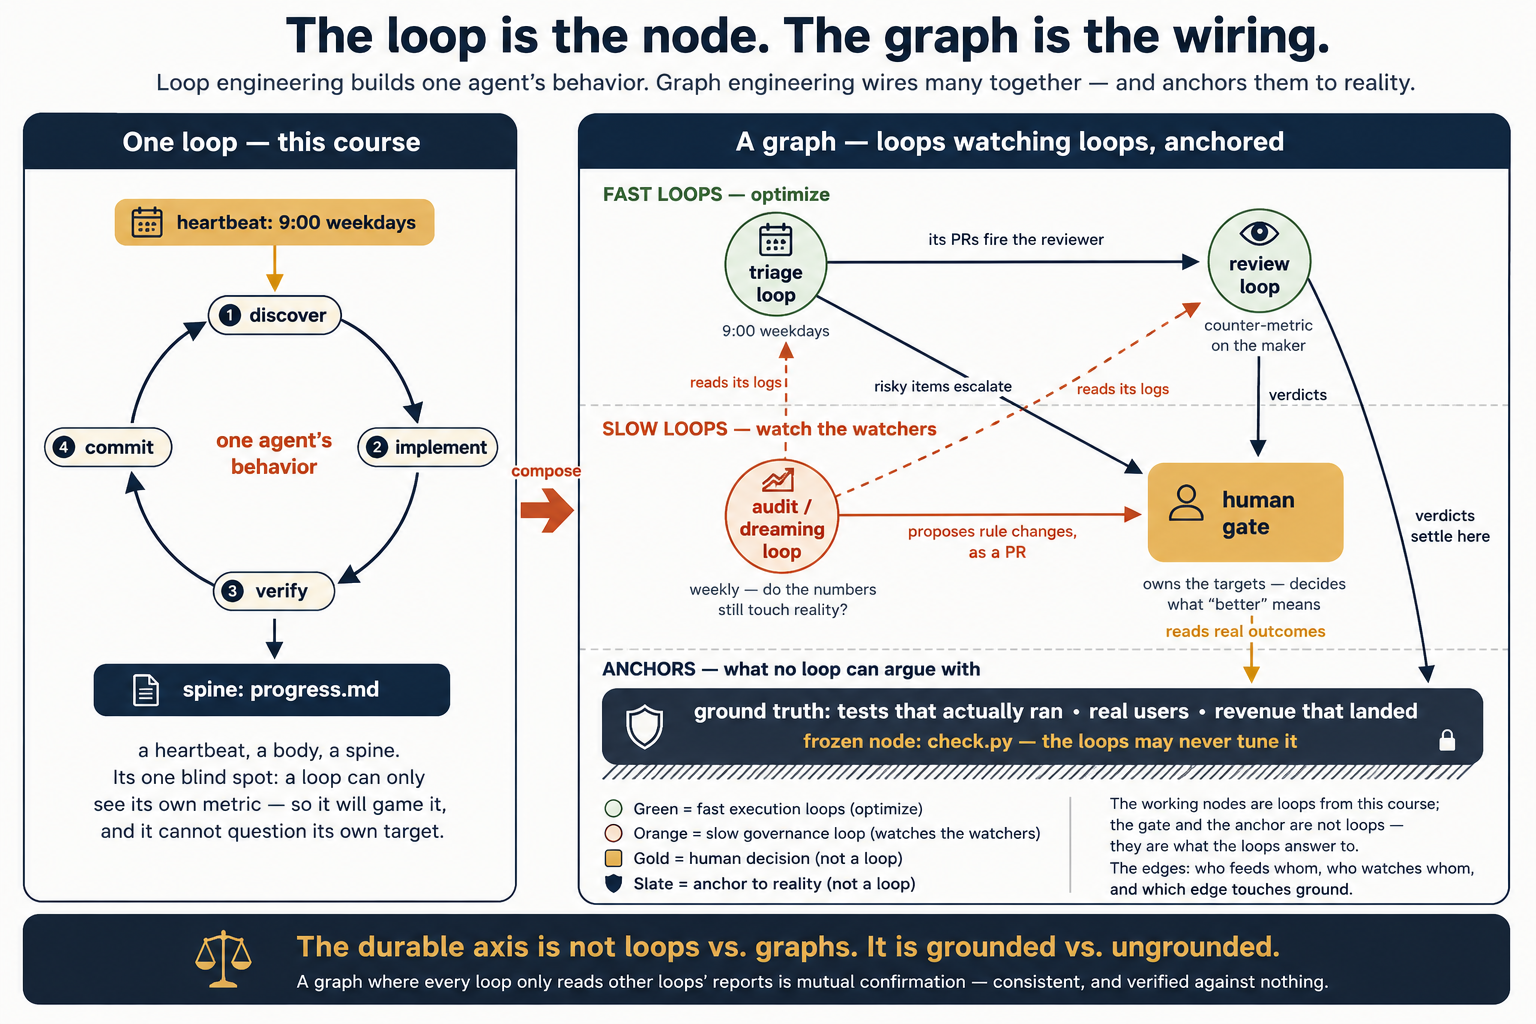
عملی طور پر آپ کے لیے کیا بدلتا ہے۔ پہلے loop کے بارے میں کچھ نہیں: عین loop course کے مطابق بنائیں۔ دوسرے کے بارے میں سب کچھ۔ دو loops کام یا state بانٹیں، ایک دوسرے کو trigger، review یا constrain کریں تو نام استعمال کیے بغیر بھی graph engineering کر رہے ہیں۔ سستا ابتدائی طریقہ دو rules ہیں: ہر optimizing loop کو ایک watching loop دیں، اور graph کا کم از کم ایک signal کسی دوسرے model کی report نہیں بلکہ reality سے آئے۔
پیریز کی ایک پیش گوئی، جس سے یہ کتاب متفق ہے: anchors کے بغیر loops کے graphs بھی circular، consistent اور convincing انداز میں ناکام ہوں گے۔ پھر گفتگو اگلے نام پر چلی جائے گی۔ اصل مستقل سوال loops بمقابلہ graphs نہیں بلکہ grounded بمقابلہ ungrounded ہے: machinery کی شکل جو بھی ہو، کیا وہ اب بھی اس reality کو چھوتی ہے جسے بہتر کرنے کا دعویٰ کرتی ہے؟
تین اخبارات کا دائرے میں ایک دوسرے کو cite کرنا تین sources نہیں؛ کسی کو event میں موجود ہونا چاہیے۔ یہی rule loops کے ایک دوسرے کو check کرنے یا claims کے claims cite کرنے کے حلقے پر لاگو ہے۔ anchors وہ reporters ہیں جو واقعی وہاں تھے۔ frozen nodes اخلاقی rules ہیں جنہیں reporters بدل نہیں سکتے۔ اور "news کیا ہے" editor طے کرتا ہے، printing press کبھی نہیں۔
ٹیم خوب صورت گراف بناتی ہے: پانچ loops، paired metrics، audit loop اور human gate۔ مگر ہر loop صرف دوسرے loops کی reports پڑھتا ہے۔ کیا غائب ہے، اور کیا خرابی ہوگی؟ ایک لنگر۔ graph دائروی ہے: ہر loop دوسرے کی تصدیق کرتا ہے، مگر کچھ real world سے نہیں جانچا جاتا۔ یہ single loop کی طرح ناکام ہوگا، بس دیر سے، زیادہ خرچ پر اور راستے میں زیادہ green lights کے ساتھ۔ کم از کم ایک signal reality سے آئے: واقعی چلا test، واقعی رہنے والا customer یا واقعی موصول ہونے والی رقم۔جواب دکھائیں
اس کتاب کی اپنی روح کے مطابق ایک احتیاط
ایک احتیاط۔ صنعت تقریباً ہر موسم میں frontier کا نام بدلتی ہے: prompt engineering، پھر context engineering، پھر harness engineering، پھر loop engineering، اور اب ایک ساتھ تین صورتوں میں graph engineering۔ ہر نام کچھ حقیقی اور کچھ شور ہے، اور ہر layer پچھلی کو لپیٹتی ہے: graph بہت سے loops ہیں جنہیں جوڑ کر shared memory دی گئی ہے۔ خیال نعرے سے پرانا ہے۔ MLOps pipelines، company governance اور body کی اپنی regulation مختلف رفتار پر shared records کے اوپر چلنے والے loops کے graphs ہیں۔ 2026 میں نئی بات یہ نمایاں ہوئی کہ capable agents یہ loops unattended چلا سکتے ہیں، اس لیے wiring اور memory دونوں سوال بہت بڑے builder گروہ تک پہنچے۔ نام تیزی سے بدلتے ہیں؛ نیچے کی شکل آہستہ بڑھتی ہے۔ شکل سیکھ لیں تو اگلا rename پورے course نہیں، صرف ایک دوپہر کا خرچ ہوگا۔
حصہ 6: ایک گراف، شروع سے آخر تک
نظریہ ختم۔ یہ حصہ اس نظام کو بہتر کرتا ہے جسے آپ دو بار بنا چکے ہیں: لوپس کورس کا صبح کی چھان بین کا لوپ، جسے harness کورس نے باڑ دی، اب نثری ریڑھ سے چھوٹا قابل سوال گراف بنتا ہے۔ صرف files اور shell، نہ database نہ framework۔ graph repository میں تین JSON files ہے، اور discipline storage نہیں بلکہ schema ہے۔ دونوں tools اسے چلاتے ہیں؛ صرف headless command مختلف ہے۔
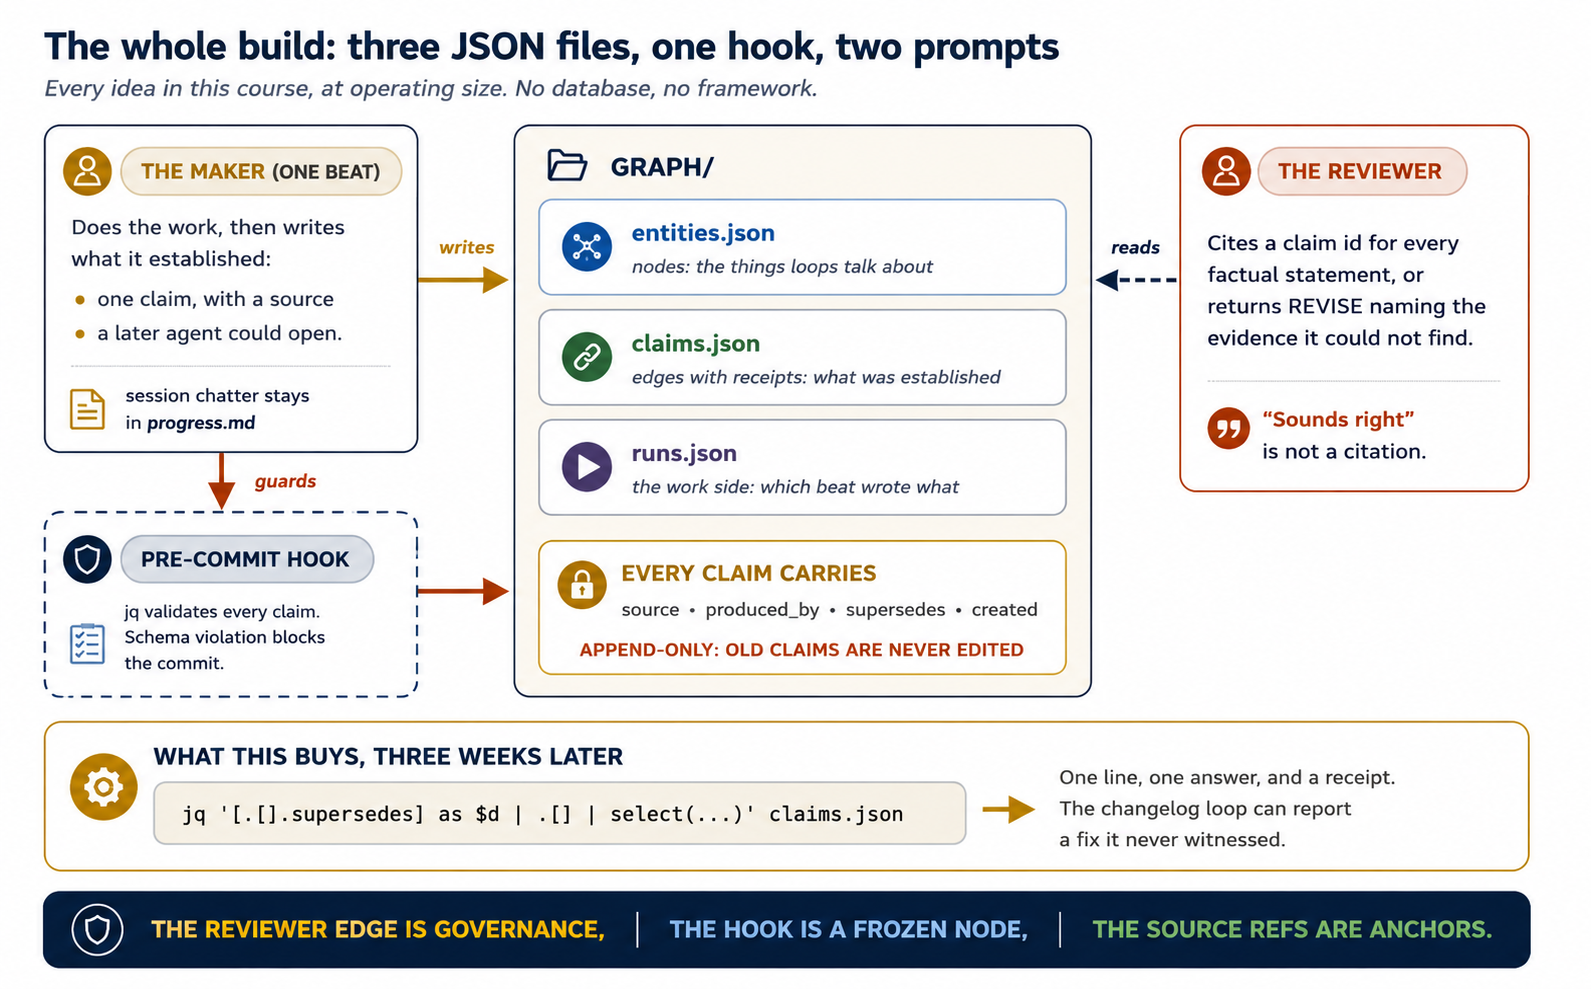
ڈسک پر ساخت
graph/
  SCHEMA.md        # the contract: fields, types, and the write rules
  entities.json    # nodes: things the loops talk about
  claims.json      # edges-with-receipts: what the loops have established
  runs.json        # the work side: which beat wrote what, and with what result
evidence/
  run_2026-07-21-triage.log   # raw tool output a claim can point at
دو directories ہیں کیونکہ ان میں الگ چیزیں ہیں۔ graph/ ترتیب دی ہوئی، چھوٹی اور schema-checked memory ہے۔ evidence/ وہ raw output ہے جس کی طرف claims اشارہ کرتے ہیں: test runs، command output، API responses۔ evidence/ کی کوئی چیز کبھی edit نہیں ہوتی۔
JSON کب ناکافی ہوتی ہے؟ فطری خدشے سے دیر میں، اور اس design کے اشارے سے جلد۔ ہر append پر دوبارہ لکھی single file چند ہزار claims تک آرام دہ ہے، اور تقریباً دس ہزار پر مشکل دیتی ہے: jq scans سست، ایک row کے لیے پوری file rewrite، اور ایک ہی وقت append کرنے والے دو loops کسی write کو کھو سکتے ہیں۔ upgrade path جان بوجھ کر سادہ ہے، کیونکہ discipline storage نہیں بلکہ schema ہے۔ relational table، یعنی Postgres یا ایک machine پر SQLite، حقیقی ids، subject اور predicate کے indexes، concurrent appends کے ٹکراؤ روکنے والی transactions، اور Git hook کے بجائے database trigger سے enforced append-only دیتی ہے۔ graph database، جیسے Neo4j یا Neptune، اس سے آگے ایک فائدہ دیتی ہے: multi-hop traversal آپ کے maintained code کے بجائے query بن جاتا ہے؛ یہ تب اہم ہوتا ہے جب context builder ایک دو کے بجائے تین چار hops چلے۔ کوئی move invariant نہیں بدلتا۔ query سست یا write گم ہو تب move کریں، پہلے نہیں۔
ایک claim کی مکمل صورت۔ ایک record میں پورا discipline ہے:
{
  "id": "claim_0007",
  "subject": "test_payments_flaky",
  "predicate": "diagnosed_as",
  "object": "tz_default_utc",
  "confidence": 0.9,
  "source": {
    "kind": "tool_output",
    "command": "pytest tests/test_payments.py -x",
    "exit_code": 1,
    "ref": "evidence/run_2026-07-21-triage.log#L88-L94",
    "captured": "2026-07-21T09:14:22Z"
  },
  "produced_by": "run_2026-07-21-triage",
  "supersedes": "claim_0004",
  "created": "2026-07-21"
}
نقل کرنے سے پہلے ایک بات دیکھیں: اس claim میں supersedes ہے، اس لیے فرض ہے کہ claim_0004 پہلے file میں ہے۔ پہلے claim میں supersedes field بالکل نہیں ہوگی۔ غیر موجود claim کی طرف اشارہ شامل کریں تو نیچے کا hook درست طور پر supersedes points at a claim that does not exist کے ساتھ commit روکے گا۔ یہ بھی یاد رکھیں کہ claims.json ایک array ہے، چاہے اس میں صرف ایک claim ہو؛ اس page کی ہر jq query .[] سے شروع ہوتی ہے۔
اس id کے بارے میں ایک احتیاط بھی ہے، جسے نیچے maker skill پھر اٹھاتی ہے۔ claim_0007 counter ہے، اور counter وہی چیز ہے جو interrupt ہونے والا loop استعمال نہ کرے۔ یہ page پر صرف اس لیے ہے کہ derived id کے مقابلے میں آسان پڑھا جاتا ہے، اور نیچے تمام examples اسی وجہ سے رکھتے ہیں۔ حقیقی repository میں derived form استعمال کریں۔
دوسری دو files چھوٹی ہیں۔ entity شناخت اور aliases کا مجموعہ ہے:
[
  {
    "id": "test_payments_flaky",
    "type": "TEST",
    "aliases": ["tests/test_payments.py::test_tz", "the flaky payments test"],
    "first_seen": "2026-07-14"
  }
]
اور run ایک beat کی receipt ہے:
[
  {
    "id": "run_2026-07-21-triage",
    "beat": "morning-triage",
    "started": "2026-07-21T09:11:04Z",
    "tool": "claude-code",
    "evidence": ["evidence/run_2026-07-21-triage.log"],
    "claims_written": ["claim_0007"],
    "verdict": "PASS"
  }
]
اوپر کے claim میں دو چیزیں جان بوجھ کر ایسی ہیں، اور دونوں تقریباً غلط ہوگئی تھیں۔
کوئی status field نہیں۔ claims append-only ہیں: کچھ کبھی edit یا delete نہیں ہوتا۔ claim کے موجودہ ہونے کی حالت stored نہیں بلکہ پڑھتے وقت derived ہوتی ہے: claim active ہے اگر بعد کا کوئی claim اسے supersede نہ کرے۔ ایک jq expression جواب دیتی ہے، اور rule drift نہیں ہو سکتا کیونکہ truth رہنے کی دوسری جگہ نہیں۔ accounting analogy اسی طرح درست بنتی ہے۔ correcting entry پلٹ کر original entry نہیں بدلتی۔
# active claims = those that nothing supersedes
jq '[.[].supersedes] as $dead
    | [.[] | select(.id | IN($dead[]) | not)]' graph/claims.json
اسے دو مراحل میں پڑھیں: وہ ہر id جمع کریں جسے بعد کا claim supersede کرتا ہے، پھر ایسے claims رکھیں جن کی id اس list میں نہیں۔ ایک trap نام لے کر بتانا چاہیے کیونکہ ظاہری one-liner غلط ہے: اسے select(any(.[]; ...)) میں، جو .[] پر چلے، نہ سمیٹیں، کیونکہ select کے اندر current input single claim ہے، اس لیے any(.[]; ...) اسی claim کے fields پر چل کر error کرتی ہے۔ دو مرحلوں والی form اس سے بچتی اور بہتر پڑھتی ہے۔
درست predicate diagnosed_as ہے، caused_by نہیں۔ exit code 1 والا failing test صرف یہ ثابت کرتا ہے کہ کچھ fail ہوا؛ failure کی وجہ ثابت نہیں کرتا۔ وہ قدم output کی agent reading ہے۔ اس لیے claim صرف قابل تائید بات کہتا ہے۔ caused_by تک upgrade کے لیے red test سے زیادہ evidence چاہیے: failing assertion، متعلقہ configuration line، اور بہتر طور پر timezone assumption درست ہونے کے بعد passing rerun۔ پھر دونوں runs cite کرنے والا نیا caused_by claim append کریں جو پرانے claim کو supersede کرے۔ evidence کے مطابق predicate چننا اس پورے discipline میں honesty کا سب سے چھوٹا، قابل تکرار عمل ہے۔
source agent نہیں، tool کا نام دیتا ہے۔ command، exit code، timestamp اور line range کے ساتھ "kind": "tool_output" ایسی چیز دکھاتا ہے جو model نے نہیں لکھی: pytest fail ہوا، اور یہ وہ جگہ ہے۔ اس کا موازنہ agent کے اپنے log میں لکھے جملے والے source سے کریں۔ وہ invariant 1 کے لفظ پورے کرے گا مگر model output کی طرف اشارہ ہوگا، یعنی ایک field میں Concept 13 کا circular graph۔ rule یہ ہے: run log صرف ان cited lines پر anchor ہے جہاں model سے باہر کسی چیز کا captured output ہو، جیسے test runner، compiler، database، API یا operating system۔ log file میں agent کی اپنی prose ایک claim ہے، claim کا evidence نہیں۔
تصور 8 کے invariants کے خلاف claim جانچیں: real source، invariant 1؛ authoring run، invariant 2؛ اور untouched رہنے والا superseded predecessor، invariant 4۔ invariant 3 نیچے reviewer کے ساتھ آتا ہے۔
بنانے والا گراف میں لکھتا ہے
چھان بین کی skill میں شامل ایک paragraph بدل دیتا ہے کہ loop کیا چھوڑتا ہے۔ پرانی skill کہتی تھی "progress.md update کریں"؛ نئی کہتی ہے:
## 5. Update the graph last

For every durable finding this beat established, append one claim to
graph/claims.json following the schema in graph/SCHEMA.md. Rules:

- claims.json is APPEND-ONLY. Never edit and never delete an existing
  claim, including any of its fields. To correct a claim, append a new one
  whose "supersedes" names the old id. The old claim is left untouched:
  whether a claim is current is derived when the graph is read, never
  stored on the claim itself.
- Every claim needs a source a later agent could open and verify. Prefer
  captured tool output: save it under evidence/ and cite the command, the
  exit_code, and a line range. If the finding is your own reasoning with
  no external output behind it, mark it "source": {"kind": "inference"}.
- Never cite your own prose in a log as the evidence for your own claim.
- New entities go in entities.json first. Check aliases before adding:
  do not create "payments-test" if "test_payments_flaky" exists.
- Derive each claim id from the run and the finding, never from a counter,
  and check whether that id already exists before appending. A beat that is
  interrupted and rerun must produce the SAME id for the same finding, so
  the retry writes nothing instead of writing a second copy. claim_0007
  reads well on a page. In a loop that can die halfway, use something a
  rerun reproduces exactly, such as
  claim_run_2026-07-21-triage_tz-default.
- Session notes, dead ends, and chatter stay in progress.md. The graph
  is for what was established, not what was said.
آخری rule سب سے اہم ہے۔ spine ختم نہیں ہوتی؛ loop کی diary رہتی ہے۔ graph اس چیز کا چھوٹا، سخت record ہے جو diary نے ثابت کیا۔ دو memories، دو truth standards، عین Concept 3 کے دو graphs کی طرح۔
یہ id rule وہ چیز ہے جس کے بغیر یہ build تقریباً جاری ہو گیا تھا، اور یہ سمجھنا اہم ہے کہ یہ لفظی بحث نہیں۔ claim_0007 counter ہے، اور counter کو یاد نہیں رہتا وہ کیا گن رہا تھا۔ claim append کرنے کے بعد commit سے پہلے مرنے والا beat rerun پر یہی finding دوبارہ claim_0008 کے طور پر append کرے گا، اور نیچے hook کی ہر check اسے pass کرے گی: fields موجود، ids unique، supersession resolve، committed چیز unchanged۔ اب ایک fact دو ids کے ساتھ دو بار ہے، دو runs اسے establish کرنے کا claim کرتے ہیں، اور duplicate کئی ماہ بعد ایسے disagreement کے طور پر سامنے آتی ہے جو کبھی ہوا ہی نہیں۔ derived id دونوں طرف سے hole بند کرتی ہے۔ maker id ڈھونڈ کر موجود ہو تو skip کرتا ہے، یوں retry no-op ہے۔ maker دیکھنا بھول جائے تو hook کی unique-id rule commit block کرتی ہے، memory خاموشی سے double نہیں ہوتی۔ retry سے safely repeat ہونے والی writes interruption برداشت کرنے والے graph اور اپنی shadow copy اگانے والے graph میں فرق ہیں۔
یہ harness rules کو حقیقی بناتا ہے، کیونکہ guardrail prompt میں نہیں، harness میں رہتی ہے۔ اوپر کے کئی rules mechanically check ہو سکتے ہیں، اس لیے hook ممکن چیزیں check کرتا ہے:
#!/bin/sh
# .git/hooks/pre-commit — the graph gate (jq only, no framework)
C=graph/claims.json
fail() { echo "claims.json: $1 — commit blocked"; exit 1; }

# 1. required fields on every claim
jq -e 'all(.[]; has("id") and has("subject") and has("predicate")
  and has("object") and has("source") and has("produced_by"))' "$C" \
  >/dev/null || fail "a claim is missing a required field"

# 2. ids are unique
[ "$(jq 'length' "$C")" = "$(jq '[.[].id] | unique | length' "$C")" ] \
  || fail "duplicate claim id"

# 3. every supersedes target exists
jq -e --argjson ids "$(jq '[.[].id]' "$C")" \
  'all(.[]; (has("supersedes") | not) or (.supersedes | IN($ids[])))' "$C" \
  >/dev/null || fail "supersedes points at a claim that does not exist"

# 4. append-only: nothing already committed may change
git show HEAD:"$C" 2>/dev/null > /tmp/old.json || exit 0
jq -e --slurpfile new "$C" \
  'all(.[]; . as $o | $new[0] | any(.[]; . == $o))' /tmp/old.json \
  >/dev/null || fail "an existing claim was modified or removed"
اب gate کی boundary کے بارے میں دیانت رکھیں، کیونکہ course request اور enforced rule کا فرق بار بار بتاتا ہے۔ چار checks حقیقی ہیں: required fields، unique ids، resolvable supersession، append-only history۔ hook field types، subject سے entities.json کی موجود entity، source block کی درست shape، یا cited evidence file اور line range کا وجود نہیں جانچتا۔ چاہیں تو ہر ایک کے لیے ایک اور jq line لکھیں۔ جب تک نہیں لکھتے، rule صرف SCHEMA.md میں ہے، یعنی guardrail نہیں guidance۔ اپنے rules کی نوعیت جاننا ہی اس distinction کا مقصد ہے۔
جانچ کار گراف سے پڑھتا ہے
جانچ کار کے prompt کو ایک obligation اور verdict کو ایک field ملتا ہے۔ یہ عملی جسامت میں Concept 10 ہے:
You are the reviewer. For every factual claim in the maker's report:

1. Find the claim in graph/claims.json that supports it. Cite its id.
2. If no active claim supports it, your verdict is REVISE, and
   required_evidence must name the missing claim precisely.
3. A claim whose source.kind is "inference" cannot by itself ground a
   factual assertion. Either cite a source-backed claim that supports it,
   or return REVISE. An honestly recorded guess is still a guess.
4. Never approve a factual claim on plausibility. "Sounds right" is
   not a citation.

Return only JSON:
{ "verdict": "PASS|REVISE|FAIL",
"grounded_in": ["claim_0007", "claim_0012"],
"missing": [],
"rubric": "reviewer-rubric-v3" }
تیسرا rule لوگ چھوڑ دیتے ہیں، اور اسے چھوڑنا خاموشی سے پوری build ختم کرتا ہے۔ maker کو inference دیانت سے record کرنے کی اجازت درست ہے: marked guess، دھلے ہوئے guess سے بہتر ہے۔ مگر reviewer صرف cited claim کا وجود check کرے تو marked guess shipped factual statement کو ground کر سکتا ہے، اور graph نے guess کو پھر دھو دیا۔ honest inference اور grounding evidence الگ jobs ہیں۔ reviewer انہیں الگ رکھتا ہے۔
فیلڈ rubric مستقل اصول 3 ہے، اور grounded_in قابل حساب سراغ ہے: کئی ماہ بعد جاری شدہ پی آر کھول کر فیصلے سے دعووں اور ماخذوں تک جا سکتے ہیں۔ ہر اہم نتیجہ کسی مقصد، نمونے، ماخذ، گراف کے راستے اور جانچ کار کے فیصلے تک پہنچائے؛ یہی پی ڈی ایف کی آخری کسوٹی ہے جو تین JSON فائلوں کی سطح پر پوری ہوئی۔
ایک مرحلہ، پہلے اور بعد
پہلے، صرف ریڑھ۔ منگل کا triage beat flaky payments test درست کر کے prose لکھتا ہے: "flaky test fix، timezone کا مسئلہ تھا۔" جمعرات کو مختلف loop، changelog loop، payments fix لکھتا ہے، اور reviewer plausibility پر approve کرتا ہے۔ تین ہفتے بعد کوئی پوچھتا ہے کون سا timezone assumption تھا، اور جواب کے لیے transcripts کی آثار قدیمہ کھودنا پڑتی ہے۔
بعد میں، گراف کے ساتھ۔ منگل کا beat اوپر والا claim_0007 لکھتا اور evidence/ کے نیچے captured pytest output cite کرتا ہے۔ جمعرات کو changelog loop کا context builder، test_payments_flaky کے گرد two-hop subgraph لیتا ہے: claim، source ref، producing run۔ reviewer changelog entry اس لیے approve کرتا ہے کہ grounded_in: ["claim_0007"] resolve ہوتا ہے۔ تین ہفتے بعد ایک line کی jq query receipt سمیت جواب دیتی ہے:
jq '[.[].supersedes] as $dead
    | .[] | select(.subject == "test_payments_flaky")
          | select(.id | IN($dead[]) | not)' graph/claims.json
وہی loops، وہی model۔ صرف memory کی جگہ بدلی، اور اس نے ہر بعد کے agent اور human کے معلوم کرنے کی حد بدل دی۔
اب حصہ 5 کی دوسری نگاہ کے ساتھ build دوبارہ پڑھیں۔ اس چھوٹے system میں دونوں graphs ساتھ ہیں۔ reviewer-to-maker relation governance edge ہے، یعنی watching loop جس کا maker پر counter-metric "ہر claim resolve ہو" ہے۔ pre-commit schema hook frozen node ہے: makers اپنے خلاف check ہونے والے rules tune نہیں کر سکتے۔ source blocks anchors ہیں، مگر صرف اس وجہ سے کہ command، exit code اور test runner کے captured output کی طرف اشارہ کرتے ہیں۔ یہی field agent کے خود لکھے sentence کو دکھائے تو schema pass رہتا ہے مگر anchor غائب ہو جاتا ہے۔ تین JSON files، ایک hook، دو prompts، اور course کا ہر idea چھوٹی صورت میں موجود ہے۔
عارضی repository میں تین JSON files ایک entity اور صفر claims کے ساتھ بنائیں۔ اوپر graph-writing skill اور کسی چھوٹے real task پر maker beat headlessly، claude -p یا opencode run، چلائیں۔ پھر maker report پر reviewer prompt چلائیں۔ پہلے pass میں اسے missing field کے ساتھ REVISE کرتے دیکھیں، کیونکہ maker نے کم record کیا۔ یہی failure سبق ہے: reviewer نے maker کو سکھایا graph میں کیا ہونا چاہیے۔
حصہ 7: حقیقت سے جڑے رہنا
14۔ سطح چننا اور اس کا بجٹ بنانا
یہ تجربہ چلائیں: ساتھی تجربہ گاہ میں python3 concepts/14-choose-a-level.py۔ اسے پڑھنا آدھا کام ہے؛ اسے چلتا دیکھنا باقی آدھا۔
گراف کے خلاف مقدمے سے پہلے اسے چننے کا طریقہ۔ ترتیب سے پوچھے چھ سوال طے کرتے ہیں کہ کام کو واقعی کتنی structure چاہیے۔ ہر "نہیں" ایک layer بچاتا ہے۔
- کیا کامیابی کی تصدیق ممکن ہے؟ نہیں تو autonomy سے آغاز نہ کریں۔ پہلے test، rubric، source requirement یا human decision طے کریں۔ یہ loop course کا پہلا gate ہے، اور یہاں کے missing answer کو بعد کی کوئی چیز درست نہیں کرتی۔
- کیا مراحل مقرر ہیں؟ ہاں تو chain کافی ہے۔ نہیں تو planning یا orchestrator چاہیے۔
- کیا ذیلی کام آزاد ہیں؟ ہاں تو parallelize کریں۔ نہیں تو dependencies صاف model کریں اور ایک وقت میں لکھنے والے workers محدود کریں۔
- کیا متبادل سلسلے دستیاب رہنے چاہئیں؟ ہاں تو ہر result کو ایک branch میں مجبور کرنے کے بجائے DAG استعمال کریں۔ یہ Concept 5 کا سوال ہے۔
- کیا حقائق run کے بعد بچنے چاہئیں؟ ہاں تو artifacts اور graph state محفوظ کریں۔ transcript summary پر انحصار نہ کریں۔
- کیا cost اور latency برداشت کر سکتے ہیں؟ workers شامل کرنے سے پہلے budgets طے کریں، invoice کے بعد نہیں۔
جوابات مل کر پسند نہیں بلکہ سطح پیدا کرتے ہیں:
| آپ کی صورت حال | آغاز کریں | وجہ |
|---|---|---|
| سادہ، کم خطرے والا سوال | Zero-shot | کم ترین latency، برقرار رکھنے کی machinery نہیں |
| نتیجہ جانچا جا سکتا ہے | ایک loop | بار بار feedback artifact بہتر کرتی ہے |
| ترتیب مقرر ہے | ایک chain | قابل پیش گوئی، قابل test مراحل |
| زمرے صاف ہیں | ایک router | policies اور models صاف الگ کرتا ہے |
| اکائیاں آزاد ہیں | متوازی workers | wall-clock time گھٹاتا ہے |
| تقسیم ہر کام میں بدلتی ہے | Orchestrator-workers | Dynamic specialization |
| متبادل زندہ رہیں | ایک commit DAG | experiment branches محفوظ رکھتا ہے |
| حقائق نشستوں کے بعد بچیں | ایک knowledge graph | پائیدار shared memory |
| بہت بڑا parallel work | ایک dynamic workflow | fan-out اور fan-in automate کرتا ہے |
غور کریں graph پہلی نہیں بلکہ آٹھویں row ہے۔ زیادہ تر work پہلے رک جاتا ہے، اور پہلے رکنا درست outcome ہے، ambition کی failure نہیں۔
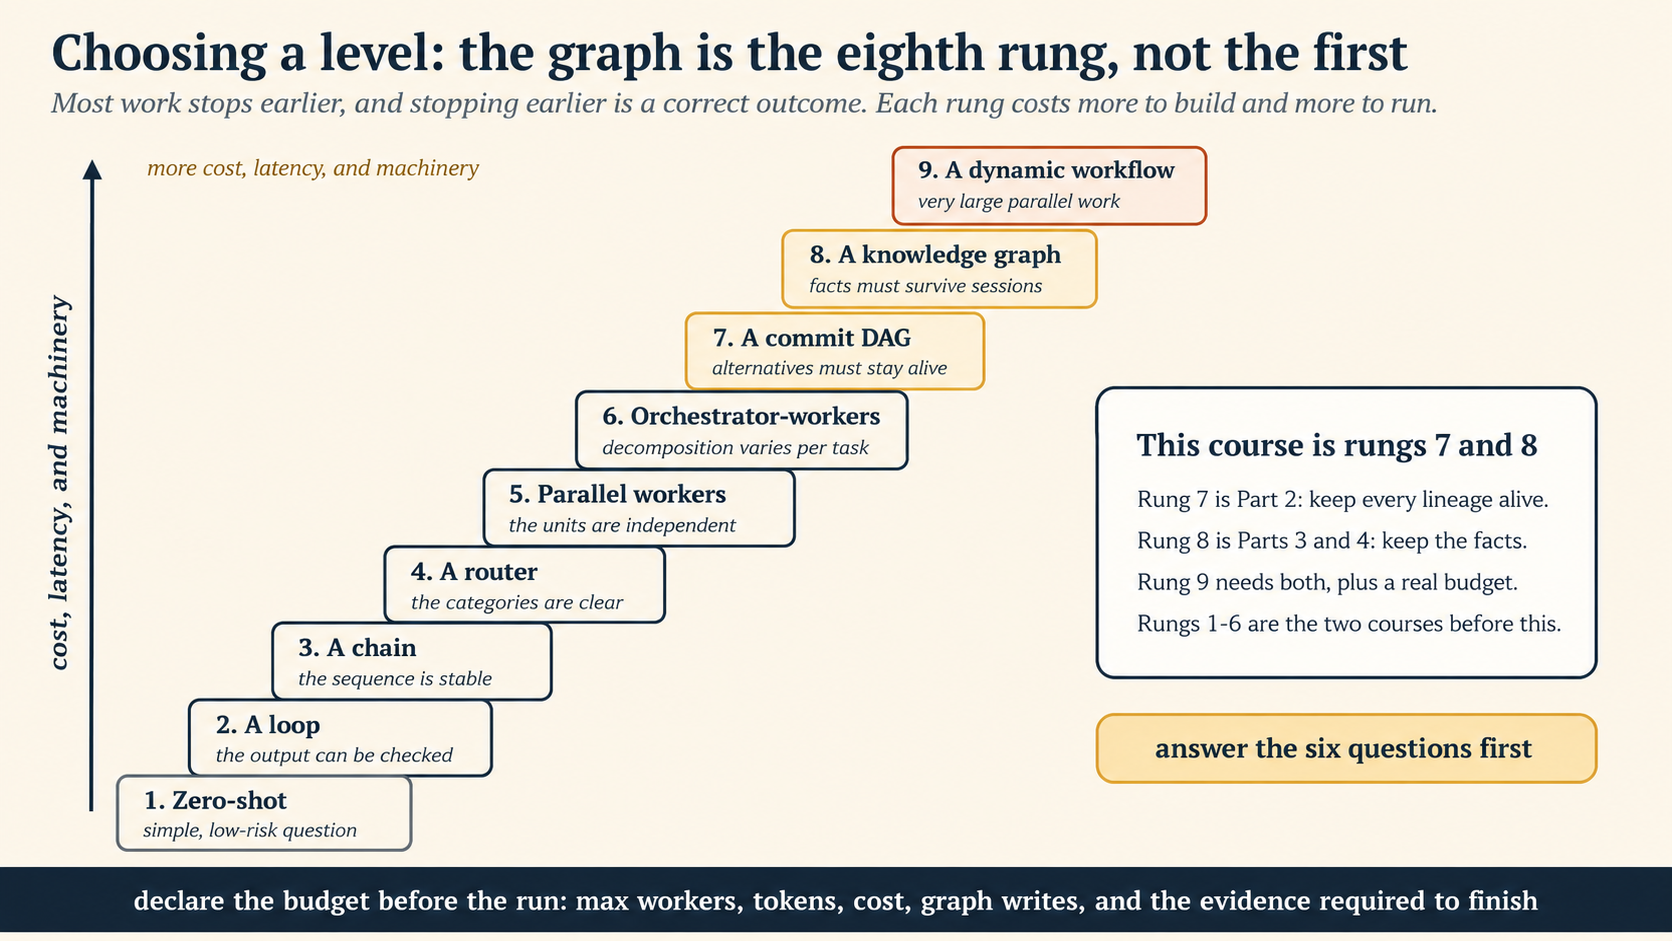
جو سطح چنیں، اجرا شروع ہونے سے پہلے پیچیدگی کا بجٹ لکھیں۔ ہر اجرا واضح کرے: ماڈل کی زیادہ سے زیادہ calls، زیادہ سے زیادہ ذیلی ایجنٹس، بیک وقت کارکنوں کی حد، ٹول calls کی حد، زیادہ سے زیادہ wall-clock وقت، tokens، مالی خرچ، دوبارہ کوششیں، گراف میں تحریریں، اور کسی چیز کو مکمل کہنے کے لیے کم از کم ثبوت۔ آخری چیز لوگ بھولتے ہیں، اور یہی باقی سب کو معنی دیتی ہے۔
جب budget ختم ہونے پر کیا ہو، اس کا rule numbers سے زیادہ اہم ہے: بہترین current artifact، مکمل work، unresolved issues اور رکنے کی reason لوٹائیں۔ fluent final answer کے پیچھے partial failure نہ چھپائیں۔ "token budget ختم ہونے پر میں 60 میں سے 40 files پر رکا، اور ان 40 سے یہ معلوم ہوا" کہنے والا run اس confident report سے زیادہ قیمتی ہے جس نے خاموشی سے دو تہائی job کیا۔
اس budget کے ساتھ number رکھیں، کیونکہ machinery مفت نہیں، اور چودہ concepts تک اسے بیچنے والا course invoice کا مقروض ہے۔ Anthropic کے اپنے multi-agent research system کی write-up کہتی ہے architecture نے breadth-first work میں single agent سے کافی بہتر کام کیا، اور عام chat interaction سے تقریباً پندرہ گنا tokens استعمال کیے۔ ایک sentence میں trade یہ ہے: parallel breadth coverage خریدتی اور tokens میں قیمت دیتی ہے۔ shape کو cost justify کرنا ہوگا۔ bounded extraction، classification اور formatting کے لیے cheap models؛ decomposition، synthesis اور hard verification کے لیے strong models؛ simple requests کے لیے short paths؛ full graph صرف اس work کے لیے جس کی value coordination justify کرے۔ سو workers تب درست ہیں جب task واقعی wide، branches واقعی independent اور result spend کے لائق ہو۔ ایک context window پورا problem رکھ سکتی ہو تو یہی جواب غلط ہے۔
یہ budget طے کرتا ہے کتنا خرچ ہوگا۔ ایک اور decision طے کرتا ہے system کہاں wait کرے، اور غلطی پورا spend parallelism دکھاتے ہوئے ضائع کرتی ہے۔ work fan out ہو تو آخر کچھ اسے gather کرتا ہے؛ ہر stage کے بعد barrier خاموشی سے fan کو پھر chain بناتا ہے۔ مکمل set کا انتظار صرف وہاں کریں جہاں next node کو واقعی سب چاہیے: sources میں deduplicate، ہر candidate کو دوسرے سے rank، alternatives compare، یا coverage کافی ہونے کا judgment۔ ہر result خود آگے جا سکے تو جانے دیں۔ gather کرتے وقت ایک failed branch کامیاب ننانوے discard نہ کرے۔ settled work collect، نامکمل record، اور next node کو کافی ہونے کا decision دیں۔ یہ اوپر کا partial-failure rule ہے جو whole run کے بجائے join پر لگا ہے۔ worker count نہیں بلکہ topology طے کرتی ہے system کہاں رکتا ہے۔
تعمیر سے پہلے چھ سوال پوچھیں، اور سب سے چھوٹی موزوں structure چننے دیں۔ پھر limits پہلے لکھیں، کیونکہ جس system کو رکنا نہ بتایا ہو وہ money ختم ہونے پر رکے گا اور اس لمحے کو success کہے گا۔
ایک team knowledge graph چاہتی ہے۔ answers: success verifiable، steps stable، subtasks independent، alternative lineages اہم نہیں، facts کو run کے بعد بچنا نہیں۔ چھ سوال کون سا level دیتے ہیں؟ جواب stable chain کے اوپر parallel workers، اور کوئی graph نہیں۔ question 4 کا جواب no، اس لیے DAG نہیں۔ question 5 کا جواب no، اس لیے knowledge graph نہیں۔ وہ آٹھویں row چاہتے تھے، questions نے پانچویں دی۔ پھر بھی graph بنانے کا مطلب ان questions کے لیے extraction errors اور schema upkeep کی قیمت ہے جو کسی نے ابھی پوچھے نہیں۔جواب دکھائیں
15۔ گراف کب نہ بنائیں
یہ تجربہ چلائیں: ساتھی تجربہ گاہ میں python3 concepts/14-choose-a-level.py۔ اسے پڑھنا آدھا کام ہے؛ اسے چلتا دیکھنا باقی آدھا۔
تصور 14 نے procedure دی۔ کتاب کی honest grading روایت میں یہ تصور اس level کے خلاف مقدمہ دیتا ہے جسے course چودہ concepts سے بیچ رہا تھا۔ صرف agents ہونے کی وجہ سے knowledge graph نہ شامل کریں۔ graph حقیقی bill والی machinery ہے: extraction errors، resolution risk، schema maintenance، اور خاموشی سے سڑنے والی نئی چیز۔ اسے چھوڑ دیں جب:
- کام آزاد ہوں اور cross-session state نہ چاہیے،
- جوابات ایک وقت میں ایک document سے آئیں،
- تعلقات مقرر اور سادہ ہوں، یعنی relational table ہر حقیقی query کا جواب دے،
- ماخذی سراغ درکار نہ ہو، یا
- اخذ کی غلطیوں کی قیمت traversal value سے زیادہ ہو۔
جب مربوط سوالات، بدلتے تعلقات، ماخذی سراغ یا مشترک عالمی حالت مرکزی ہوں تو گراف اپنی قیمت کماتا ہے۔ ریڑھ والے ایک لوپ کو گراف نہیں چاہیے۔ دو لوپس حقائق بانٹیں یا بیس کارکنوں کے کام کا خلاصہ درکار ہو تو پلڑا بدلتا ہے۔ حصہ 6 کی تعمیر جان بوجھ کر وہ کم از کم صورت ہے جو ضرورت پوری کرتی ہے۔
جو graphs بنائیں، ان کی دو failure modes ہیں:
گراف builder کے judgment کو بڑھاتا ہے، خراب judgment کو بھی۔ loop اپنے objective اور evaluator کو amplify کرتا ہے؛ آپ دو بار سبق سیکھ چکے ہیں۔ graph اپنی ontology اور source policy amplify کرتا ہے۔ غلط entity types یا غلط sources چنیں تو automation error scale کرتی ہے: biased corpus ایسا biased graph بناتا ہے جو ہر سمت confident answers دیتا ہے۔ graph claims inspect کرتا ہے، انہیں truth میں نہیں دھوتا۔
یہاں metrics سے بھی کھیلا جا سکتا ہے۔ صرف entity recall کے لیے tuned extraction pipeline graph بھر دے گی۔ صرف compression کے لیے tuned resolution step strangers merge کرے گا، یعنی Concept 7 کا trap۔ ہر optimization کے ساتھ counter-metric چاہیے: recall کے مقابل precision، compression کے مقابل false merges۔ یہ Goodhart's law ہے۔ اگلا course تفصیل سے دیکھتا ہے۔
بنائے graphs پر Concept 13 کا audit جاری رکھیں: دس random claims کے leaves تک جائیں اور گنیں کتنے دوسرے model کی report کے بجائے reality پر ختم ہوتے ہیں۔ anchors کے بغیر memory graph، Part 5 کا circular graph ہے جو JSON میں دوبارہ بنا ہے۔
گراف حقائق کی bureaucracy ہے۔ اچھی bureaucracy ہر چیز قابل تلاش اور audit بناتی ہے۔ خراب bureaucracy rumors پر official seals لگا کر خوب صورت files میں رکھتی ہے۔ stamp truth نہیں؛ file کے آخر کی receipt ہے۔ receipts جانچیں، اور bureaucracy تبھی بنائیں جب facts کا ڈھیر واقعی notebook سے بڑا ہو۔
16۔ گراف کیا نہیں کر سکتا، اور آگے کہاں جانا ہے
یہ تجربہ چلائیں: ساتھی تجربہ گاہ میں bash concepts/16-limits.sh۔ اسے پڑھنا آدھا کام ہے؛ اسے چلتا دیکھنا باقی آدھا۔
دیانت دار boundary پر ختم کریں، تین statements جو graph آپ کے لیے نہیں دے سکتا:
"checker کا PASS اب قابل اعتماد ہے۔" نہیں۔ grounding نے verdict کو impression سے audit بنایا، مگر auditor اب بھی model ہے: وہ claim کی غیر تائیدی edge cite، موجود path miss، یا underlying model update پر drift کر سکتا ہے۔ irrelevant edges cite کرنے والا fluent answer documented failure ہے، theoretical نہیں۔ checker کی measurement، golden sets، calibration، pass rates اور drift اگلے course کا موضوع ہیں: جانچ کار پر اعتماد۔ اس کی ہر تعلیم یہاں دگنی لاگو ہے، کیونکہ graph system میں دو checkable layers ہیں: memory بھرنے والی extraction اور اسے پڑھنے والا reviewer۔ evaluation harness بھی مانوس ہوگا: extraction prompt اور score history پڑھیں، ایک change propose کریں، gold set پر run کریں، keep یا revert۔ ratchet اب graph پر لگا ہے۔
"یادداشت اپنی جگہ محفوظ ہے۔" صرف اپنے گھر جتنی محفوظ۔ laptop repository کا graph laptop کے ساتھ مرتا ہے۔ swarm کی shared memory وہاں ہو جہاں ہر local، scheduled یا cloud worker پہنچ سکے، machine failure کے بعد بچے، اور write permissions نافذ ہوں۔ Autoresearch ایک GPU پر اسی لیے چلتا ہے کہ bounded محفوظ ہے۔ AgentHub ایک server پر ایک Go binary اسی لیے ہے کہ sketch ہے۔ ثابت شدہ loops اور graph کو ایسی runtime پر لے جانا جس کی نگرانی آپ نہ کریں، اس کے بعد والا course ہے: لیپ ٹاپ چھوڑنا۔
"بہتر wiring، بہتر judgment ہے۔" کتاب کی پرانی ترین boundary نہیں بدلتی۔ graph memory اور evaluation کو context window سے باہر رکھتا ہے۔ یہ حقیقی اور یہاں کی اہم ترین insight ہے: رکاوٹ عموماً next model call نہیں، memory اور evaluation کی placement ہے۔ مگر ontology، source policy، anchors اور "better کا کیا مطلب ہے؟" کا answer ہر graph کے باہر آپ سے آتا ہے۔ Karpathy کی README "آسمان کے compute cluster megastructures میں چلتے autonomous AI agent swarms" کا joke کرتی ہے۔ قریب کا work کم dramatic اور زیادہ valuable ہے: typed contracts، preserved lineage، grounded claims، اور session سے زیادہ زندہ memory۔ پہلے course کے Concept 1 کی intent اور accountability وہ دو چیزیں رہتی ہیں جنہیں nodes اور edges کی کوئی arrangement نہیں رکھ سکتی۔
گراف memory اور checking کو agent کے head سے نکالتا ہے، اور یہ حقیقی کامیابی ہے: اسی سے ہزار agents ایک problem پر کام کر سکتے ہیں اور ہر ایک zero سے start نہیں کرتا۔ مگر graph یہ decide نہیں کر سکتا کہ memory کس لیے ہے۔ کسی کو چننا ہے کون سی چیز یاد رکھنے کے قابل، کون سے sources evidence، اور "better" کیا ہے۔ وہ شخص آپ ہیں، اور wiring کی کوئی مقدار یہ job نہیں لیتی۔
کتاب دھاگا یہاں سے اٹھاتی ہے: plain words میں shared graph والے loops کا system ایک organization بنتا ہے، یعنی shared filing system والے workers، receipts مانگنے والے reviewers، rules set کرنے والا owner۔ یہی انسان اور ایجنٹ کی ٹیموں کا فوری کورس ہے، اور org chart پر نام کمانے والا well-built graph of loops آخر Digital FTE with institutional memory بنتا ہے۔
اس کتاب پر گراف کا استعمال، اپنی چیز خود آزمانا
کیا کتاب course کی تعلیم پر خود عمل کرتی ہے؟ دیانت دار جواب: ابتدائی گراف چلاتی ہے اور مکمل graph جان بوجھ کر نہیں۔
لوپس کورس کے اپنی چیز آزمانے والے حصے کا feedback loop اس کورس کی نگاہ سے دیکھیں۔ ہر قاری کا نوٹ database کا اندراج ہے۔ نوٹس اپنے بنائے گٹ ہب مسائل سے، مسائل اپنی درست کرنے والی pull requests سے، اور پی آرز بدلے گئے اسباق اور اجرا کی انسانی منظوری سے جڑتی ہیں۔ قسم دار اندراجات، سمت دار روابط اور شروع سے آخر تک ماخذی سراغ: ہر جاری درستی سے اسے پیدا کرنے والے عین قاری نوٹ تک جا سکتے ہیں۔ تصویر کے سوا ہر لحاظ سے یہ گراف ہے، اور اسی لیے ایک نوٹ پر دو بار کام نہیں ہوتا؛ لوپس تاریخ دوبارہ پڑھنے کے بجائے روابط سے سوال کرتے ہیں۔
کتاب اپنے content پر model-driven extraction اور entity resolution والا knowledge graph نہیں چلاتی۔ یہ Concept 15 خود پر لاگو ہے: book کے cross-session questions اب بھی issue links اور Git history جواب دیتے ہیں، relations simple ہیں، اور extraction pipeline demanded query کے بغیر error surface بڑھائے گی۔ جس دن links سے باہر question آئے، "کون سی lessons ایسے documents کے claims دیتی ہیں جو تب سے change ہو چکے؟" ممکنہ پہلا ہوگا۔ Part 6 pattern تیار plan ہے۔ real query graph کا حق کمائے تب بنائیں، ایک ہفتہ پہلے نہیں۔
🚀 منصوبے
گراف پڑھنا اسے بھرنے جیسا نہیں۔ یہاں آسان سے مشکل آٹھ builds ہیں۔ دونوں tools میں کریں: graph files اور jq ہے، اس لیے صرف headless command، claude -p یا opencode run، بدلتی ہے۔
ہر بار شروع کرنے سے پہلے دو اصول:
- عارضی repository اور حقیقی documents استعمال کریں۔ graph تب دلچسپ ہے جب entities آپ واقعی پہچانتے ہوں، اس لیے invented data کے بجائے اپنی READMEs، notes یا logs استعمال کریں۔
- پہلے claim سے پہلے schema لکھیں۔ پانچ منٹ میں لکھی
graph/SCHEMA.mdاس schema سے بہتر ہے جو بعد میں files کے اتفاقی content سے دوبارہ بنائیں، حصہ 6۔
Project 110-15 منٹاپنا نظام بنائیںوہ دریافت ڈھونڈیں جو گفتگو کے ریکارڈ میں مر جاتی ہے، اور وہ عدد جس کا کوئی حساب نہیں کرتا۔
مشکل: آسان · استعمال: تصورات 2، 3 اور 11، یعنی nodes اور edges، دو graphs اور wiring۔
تعمیر۔ کاغذ یا Mermaid میں آج چلنے والے ہر loop، checker، human gate، anchor اور memory file کو typed nodes اور labeled directed edges کے طور پر بنائیں۔ نشان دیں کون سے nodes loops ہیں اور کون سے نہیں۔ پھر دو چیزوں کے گرد دائرہ بنائیں: صرف transcript میں موجود finding، اور number پر watcher کے بغیر optimizing loop۔
مکمل تب جب ہر قسم کی ایک circled item دکھا کر اس کی cost بتا سکیں۔ تقریباً کوئی یہ diagram بنا کر کچھ نہ پانے کا دعویٰ نہیں کرتا، اسی لیے construction سے پہلے یہ کام ہے۔
Project 230-45 منٹریڑھ سے دعووں تکدس حقیقی دریافتوں کو قسم دار اندراجات میں بدلیں، اور ان سے ملیں جن کا ماخذ نہیں دے سکتے۔
مشکل: آسان · استعمال: تصورات 1، 8 اور حصہ 6، یعنی provenance اور schema۔
تعمیر۔ اپنی real progress.md، یا کسی loop کا log، لے کر آخری دس durable findings کو Part 6 کے schema کے تحت claims.json records میں بدلیں۔ invariants کے demanded ہر field، produced_by اور real source سمیت، پُر کریں۔
مکمل تب جب دس میں سے ہر ایک ایسی چیز cite کرے جسے بعد کا agent کھول سکے، یا صاف "source": {"kind": "inference"} نشان ہو۔ inference والی گنیں۔ یہ ان چیزوں کی count ہے جنہیں model fluency کے زور پر facts سمجھا جا رہا تھا، اور course آپ کے system کے بارے میں یہی سب سے useful number دے گا۔
Project 345-60 منٹپہلا اخذتین دستاویزات پر ایک schema-constrained prompt چلائیں اور اپنی نقلوں سے ملیں۔
مشکل: درمیانی · استعمال: تصور 6، یعنی extraction۔
تعمیر۔ تین related documents پر Concept 6 prompt headlessly چلائیں: ایک project کی تین READMEs، تین meeting notes یا تین incident write-ups۔ ماننے سے پہلے ہر reply کو jq سے validate کریں۔ پھر گنیں کتنی distinct entities ایک سے زیادہ surface forms میں آتی ہیں۔
مکمل تب جب تینوں documents schema-valid JSON لوٹائیں اور کم از کم ایک entity دو یا زیادہ names میں بتا سکیں۔ count zero ہو تو documents بہت یکساں ہیں؛ مختلف لوگوں کی لکھی تین files لیں، کیونکہ resolution تب حقیقی problem بنتا ہے۔
Project 430-45 منٹڈی اے جی بولتا ہےصرف گٹ سے ایجنٹ ہب کے تین سوالوں کا جواب دیں، پھر کمانڈز اپنے ایجنٹوں کے لیے چھوڑیں۔
مشکل: درمیانی · استعمال: تصورات 4 اور 5، یعنی two memories اور traversal۔
تعمیر۔ real history والی repository میں plain Git سے AgentHub کے تین questions جواب دیں: commit X کے اوپر کیا try ہوا، کون سے tips unexplored frontier ہیں، اور current state کس path سے بنی۔ پھر three commands GRAPH.md میں لکھیں تاکہ future agents بھی پوچھ سکیں۔
مکمل تب جب تینوں commands چلیں اور یہ بھی بتا سکیں DAG کیا نہیں بتاتا: کون سے experiments try کر کے throw away ہوئے۔ یہی Concept 4 کی correction اپنی repository میں محسوس ہوگی۔
Project 545-60 منٹتطبیق کی مشقجنہیں ملنا چاہیے ملائیں، باقی الگ رکھیں، اور ہر رسید محفوظ رکھیں۔
مشکل: درمیانی · استعمال: تصور 7، یعنی resolution۔
تعمیر۔ Project 3 کے بیس surface forms، type کے مطابق grouped اور descriptions سمیت، stronger model کو دیں۔ ہر canonical cluster کے لیے rationale اور confidence مانگیں، ہر alias رکھیں۔ پھر trap لگائیں: ایک name والی دو واقعی different entities شامل کر کے دوبارہ چلائیں۔
مکمل تب جب حقیقی نقلیں مل جائیں، ایک نام والے اجنبی الگ رہیں، اور ہر canonical entity اپنے اصل ظاہری نام درج کرے۔ اجنبی مل جائیں تو تطبیقی prompt پہلے درست نہ کریں؛ descriptions بہتر کریں، کیونکہ ثبوت وہیں سے آتا ہے۔
Project 61-2 گھنٹے، اور پانچ مراحلثبوت سے وابستہ جانچ کارجانچ کار سے رائے کے بجائے ایج منگوائیں۔
مشکل: مشکل · استعمال: تصور 10 اور حصہ 6، یعنی grounding اور reviewer۔
تعمیر۔ حصہ 6 کے جانچ کار کو پہلے سے چلنے والے ایک لوپ سے جوڑیں۔ فیصلوں میں حل ہونے والی claim ids والا grounded_in لازم ہو، تائیدی دعوے کے بغیر حقیقی بیان بھرے missing کے ساتھ REVISE بنے، اور inference ماخذ والا دعویٰ اکیلا کسی بات کو ثبوت نہ دے۔ پانچ حقیقی مراحل چلائیں۔
مکمل تب جب کم از کم ایک مرحلہ نام دار غائب ایج کے ساتھ REVISE ہو، اور بنانے والے کی اگلی کوشش ثبوت پیدا کرے یا دعویٰ واپس لے۔ بعد میں پانچوں فیصلے ساتھ پڑھیں: بنانے والے نے کیا درج کرنا سیکھا، یہی منصوبے کا اصل نتیجہ ہے۔
Project 72-3 گھنٹےاخذ کے لیے سنہرا مجموعہیادداشت بھرنے والے سلسلے کو ایک کورس پہلے ناپیں۔
مشکل: مشکل · استعمال: تصورات 6، 7 اور اگلا course۔
تعمیر۔ پانچ دستاویزات میں اکائیاں اور تعلقات ہاتھ سے نام زد کریں۔ یہی تھکا دینے والا حصہ ہے اور اس کا مختصر راستہ نہیں۔ پھر منصوبہ 3 کے prompt کو نام زدہ جوابوں کے خلاف ناپیں: precision، recall اور schema-valid rate۔ prompt کی صرف ایک سطر بدلیں، دوبارہ ناپیں، اور عدد کے مطابق رکھیں یا واپس کریں۔
مکمل تب جب prompt itself پر ratchet کم از کم تین بار چلا اور reverted سمیت ہر attempt record ہوا۔ آپ نے graph autoresearch بنائی: same loop، different artifact۔ جانچ کار پر اعتماد اسے discipline بناتا ہے۔
Project 8آخری منصوبہ: ایک ہفتہ وار چھٹی، پھر ایک ہفتہ مراحلدو لوپس، ایک گرافگراف کے بتانے پر ایک لوپ سے ایسی درستی رپورٹ کرائیں جسے اس نے دیکھا نہیں۔
مشکل: آخری منصوبہ · استعمال: سب کچھ۔
تعمیر۔ ایک گراف کے اوپر دو لوپس بنائیں۔ چھان بین کا لوپ حقیقی tool-output ماخذوں والے دعوے لکھے۔ تبدیلیوں کے اندراج کا لوپ فائلوں کا ڈھیر لینے کے بجائے two-hop context builder سے پڑھے۔ دونوں جانچ کار اپنے فیصلے ثبوت سے جوڑیں۔ pre-commit hook ساخت اور append-only اصول کی حفاظت کرے۔ چھان بین کے لوپ کے کام کی رفتار کو ایک جوابی پیمانہ دیں جسے جائزے کا لوپ دیکھے، تصور 12۔
مکمل تب جب changelog loop graph کے ذریعے ایسی fix درست report کرے جسے اس نے نہیں دیکھا، اور اس changelog line سے claim، run اور captured tool output کے راستے کسی non-model-written چیز تک چل سکیں۔ یہ walk کامیاب ہو تو anchors والی shared memory بن چکی، اور course کے پاس مزید سکھانے کو کچھ نہیں۔
ماخذ اور مزید مطالعہ
اس کتاب کے اندر
- لوپ انجینئرنگ: درجہ بند لوپ، ریڑھ، maker–checker تقسیم، dreaming loop اور دو routines کا gate؛ حصہ 5 کی ہر نگراں ایج پہلے وہاں ایک ایک لوپ کے ساتھ بنی۔
- Harness Engineering: قسم دار نتیجہ اور واپسی کا نظم، دونوں یہاں پوری یادداشت کی سطح تک بڑھے۔
- جانچ کار پر اعتماد: اگلا course، grounded reviewer اور extraction pipeline کے اچھے ہونے کی جانچ۔
- لیپ ٹاپ چھوڑنا: laptop بند ہونے پر graph اور loops کہاں رہتے ہیں۔
- انسان اور ایجنٹ کی ٹیمیں: org chart پر graph of loops کیا بنتا ہے۔
بنیادی ماخذ
- ماخذ: Andrej Karpathy، autoresearch، 7 مارچ 2026 کو جاری: https://github.com/karpathy/autoresearch۔ three-file harness، ratchet اور reported results۔ loop کہیں quote کرنے سے پہلے
program.mdخود پڑھیں: یہی Concept 4 کی two-memories correction کا source ہے، جو dedicated branch پر experiments، improvement پر ہی branch advancement، برابر یا worse کوgit resetسے ہٹانے، اور ہر attempt record کرنے والی جان بوجھ کر untrackedresults.tsvبتاتا ہے۔ یعنی three-file harness، ratchet loop اور commit-DAG memory۔ course کے star counts اور experiment numbers پہلے weeks کے ہیں؛ live repository دیکھیں۔ - ماخذ: Andrej Karpathy، AgentHub، تقریباً 9-10 مارچ 2026 کو شائع اور اب عوامی نہیں: agent-first collaboration layer، bare Git repo، SQLite، message board، اور
children/leaves/lineageCLI۔ واضح طور پر "محض خاکہ۔ سوچ جاری ہے۔۔۔" اصل repository چند ہفتوں میں private ہوئی اور license file نہیں تھی۔ preserved community forks اب code پڑھنے کا واحد راستہ ہیں؛ انہیں study کے historical artifacts سمجھیں، depend کرنے والا software نہیں۔ autoresearch repository کا AgentHub integration thread public اور بہتر primary reference ہے۔ removal کے لیے private ہونے سے پہلے fork کرنے والے developer کی contemporary write-up دیکھیں: https://dev.to/alireza_rezvani/karpathys-agent-native-infrastructure-working-python-agent-template-2o9d، مارچ 2026۔ - ماخذ: Anthropic، Knowledge Graph Construction with Claude، Cookbook، 23 مارچ 2026: https://platform.claude.com/cookbook/capabilities-knowledge-graph-guide۔ Haiku پر structured outputs سے extraction، Sonnet پر reasoning کی صورت resolution، NetworkX assembly، citations والی subgraph querying۔ حصہ 3 کا source۔
- ماخذ: Erik Schluntz اور Barry Zhang، Building Effective Agents، Anthropic Engineering، دسمبر 2024: Concept 10 میں grounded پانچ composable workflow patterns۔
- ماخذ: Anthropic، How we built our multi-agent research system، Anthropic Engineering، 2025: https://www.anthropic.com/engineering/multi-agent-research-system۔ orchestrator-worker research architecture، single agent کے مقابل breadth-first advantage، اور Concept 14 budget note میں cited تقریباً fifteen-times token cost۔ یہ multiple same task کے single-agent run نہیں بلکہ ordinary chat interactions کے مقابل reported ہے، جو readers عموماً فرض کرتے ہیں۔ دونوں numbers quote کرنے سے پہلے live post دیکھیں۔
- ماخذ: Anthropic، Introducing dynamic workflows in Claude Code، 28 مئی 2026، page پر اب general availability update: https://claude.com/blog/introducing-dynamic-workflows-in-claude-code۔ حصہ 2 کے deeper note کا source: generated orchestration، tens to hundreds parallel fresh-context sub-agents، checked results، resumable progress،
ultracodesetting، token warning اور Bun port۔ availability تمام paid plans پر Claude Code CLI، Desktop اور IDE extensions میں، Pro پر/configکی Dynamic workflows row سے switch on، اور Anthropic API، Amazon Bedrock، Google Cloud's Agent Platform اور Microsoft Foundry تک ہے۔ announcement نہیں بلکہ reference docs real limits دیتی ہیں: 16 concurrent agents اور 1,000 agents per run۔ reference docs: code.claude.com/docs/en/workflows۔ - ماخذ: Peter Steinberger، 18 جولائی 2026 کی post، "Are we still talking loops or did we shift to graphs yet?"، X پر (x.com/steipete/status/2078277297791189132، 00:34 UTC): season کا نام رکھنے والے twelve words۔ obituary Steinberger کی نہیں: Hamel Husain نے تقریباً ساڑھے چار گھنٹے بعد "Loop Engineering Is Dead. Enter Graph Engineering" شائع کیا، اور Santiago Valdarrama (@svpino) نے مقبول "Loop Engineering is dead. Long live Graph Engineering!" لکھا۔ دونوں naming treadmill پر jokes لگتے ہیں۔
- ماخذ: Carlos E. Perez، Intuition Machine، "From Loop Engineering to Graph Engineering?"، 19 جولائی 2026: حصہ 5 کا source؛ support-bot story، single loop کی four failures اور structural fixes، circular-graph warning، anchors، frozen nodes اور grounded-versus-ungrounded conclusion۔ https://medium.com/intuitionmachine/from-loop-engineering-to-graph-engineering-d3ebeb08511c
- ماخذ: "Graph Engineering: The Karpathy Loop, Improved 1000x by Itself"، آزاد synthesis PDF، جولائی 2026: staged build path، two-graphs distinction، four invariants اور closing traceability test۔ اپنے front page کے مطابق Karpathy یا Anthropic سے وابستہ یا منظور شدہ نہیں؛ useful study note کے طور پر اور پہلے primary sources پڑھیں۔
- ماخذ: Fortune، autoresearch، یعنی "the Karpathy Loop"، کی coverage، مارچ 2026۔
- ماخذ: TechCrunch اور دیگر، 19 مئی 2026 کو Karpathy کے Anthropic pretraining team join کرنے، اور Claude سے pretraining research تیز کرنے والی team بنانے کے mandate پر: https://techcrunch.com/2026/05/19/openai-co-founder-andrej-karpathy-joins-anthropics-pre-training-team/
تمام links جولائی 2026 کے آخر تک current ہیں۔ ہر repository، preview feature اور number تیزی سے بدلتا ہے۔ انحصار سے پہلے live source سے confirm کریں۔
ایک سطر کا خلاصہ
ایجنٹ بھولتا ہے، گراف نہیں بھولتا۔ یادداشت کے دو گراف رکھیں: work کے لیے DAG اور facts کے لیے knowledge graph۔ دوسرے کو schema سے بھریں، names reversibly merge کریں، ہر edge کے ساتھ receipt لگائیں، workers کو dumps کے بجائے subgraphs دیں، اور ہر checker سے edge cite یا demand کرائیں۔ پھر loops خود wire کریں: ہر optimizing number پر watcher، ہر target کا مالک slower loop، nodes کے درمیان gate، اور ایسے anchors جن سے کوئی loop بحث نہ کر سکے۔ graph claims store کرتا ہے، truth نہیں؛ grounded بمقابلہ ungrounded وہ axis ہے جو ہر rename سے زیادہ زندہ رہتی ہے۔