LLM de código abierto: tu portátil, tu servidor o clúster y la nube
Una familia de modelos, tres formas de ejecutarla. En tu portátil con Ollama. En un equipo potente con vLLM, atendiendo a 50 personas a la vez. Y en la nube mediante OpenRouter, donde viven los modelos abiertos más grandes. Las mismas herramientas, la misma idea, tres escalas.
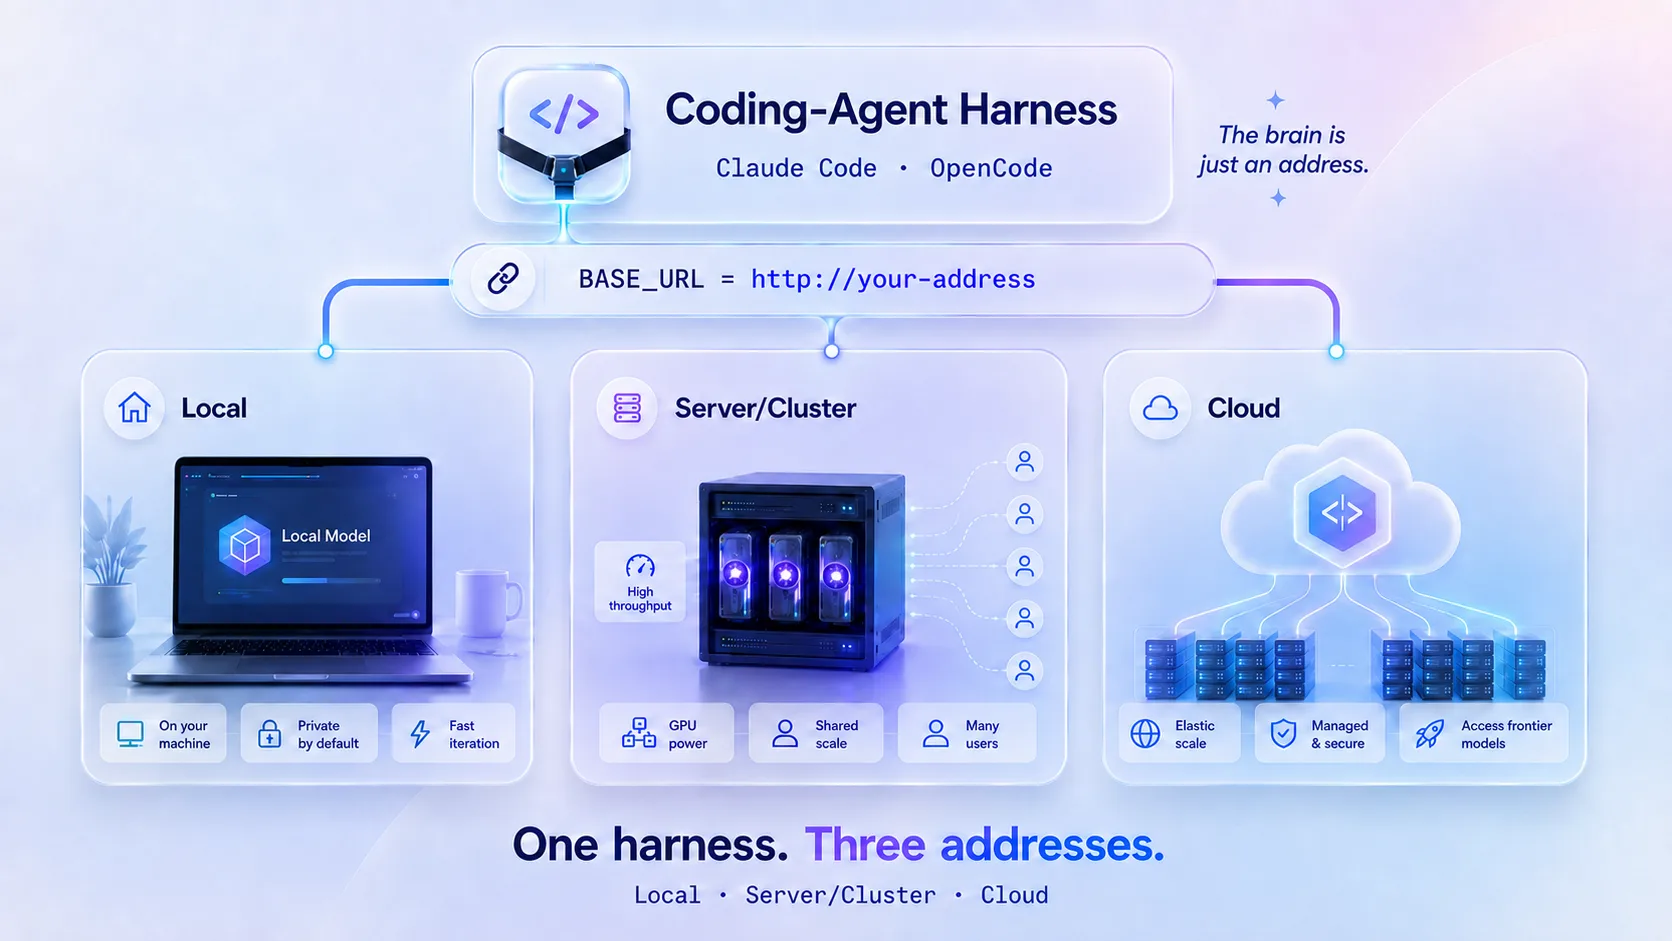
Ya has usado la IA. Escribiste en un cuadro y respondió. Esa IA no vivía en tu equipo. Se ejecutaba en grandes máquinas lejanas, propiedad de una empresa. Tú alquilabas una pequeña fracción de su tiempo.
Este curso te enseña todas las opciones que realmente tienes. Los modelos de código abierto cambiaron las reglas: los pesos del modelo se pueden descargar gratis y cualquiera puede ejecutarlos. Sin embargo, «cualquiera puede ejecutarlos» oculta una pregunta real: ¿ejecutarlos dónde? ¿En tu portátil? ¿En una máquina alquilada con una tarjeta gráfica potente? ¿O en el clúster de otra persona, porque el modelo es demasiado grande para cualquier equipo que pudieras llegar a tener?
Esos son los tres niveles del curso, cada uno con su propia parte:
| Parte | Nivel | Capa de servicio | Escala | Tú vas a… |
|---|---|---|---|---|
| 1 | Local | Ollama | Una persona, un portátil | Ejecutar un modelo en tu equipo y apuntar un agente de programación hacia él |
| 2 | Servidor/clúster | vLLM | Muchos usuarios, una máquina o tu clúster | Ofrecer el mismo Qwen3 8B a 50 solicitudes simultáneas y medir el cambio |
| 3 | Nube | OpenRouter (gateway) | Modelos de frontera que casi nadie aloja | Utilizar Kimi K3 y DeepSeek V4 Pro desde los mismos agentes de programación |
Tres niveles, tres direcciones, tres facturas. Portátil: Ollama en http://localhost:11434, sin costo. Servidor: vLLM en http://localhost:8000, con el costo del alquiler de la GPU, aproximadamente entre 0,50 y 2 USD por hora para una tarjeta de 24 GB, según el proveedor. Nube: OpenRouter en https://openrouter.ai/api, con costo por token, desde unos 0,44 USD por millón (entrada de DeepSeek V4 Pro) hasta 15 USD por millón (salida de Kimi K3) al redactar esta página. Todo lo que sigue te enseña cuándo conviene usar cada dirección. Los precios y alquileres cambian, así que consúltalos en tiempo real antes de preparar un presupuesto.
Una imagen sirve para todo el curso. Cualquier herramienta de IA tiene dos partes. Una permanece en tu equipo y realiza el trabajo práctico: el arnés. La otra es el cerebro que piensa: el modelo. El arnés accede al cerebro mediante una dirección. En la Parte 1, esa dirección es tu propio portátil. En la Parte 2, es una máquina bajo tu control con una tarjeta gráfica de verdad. En la Parte 3, es un servicio en la nube situado delante de modelos con billones de parámetros. El arnés nunca cambia. Solo cambia la dirección. Comprende esto una vez y los tres niveles se convertirán en la misma acción.
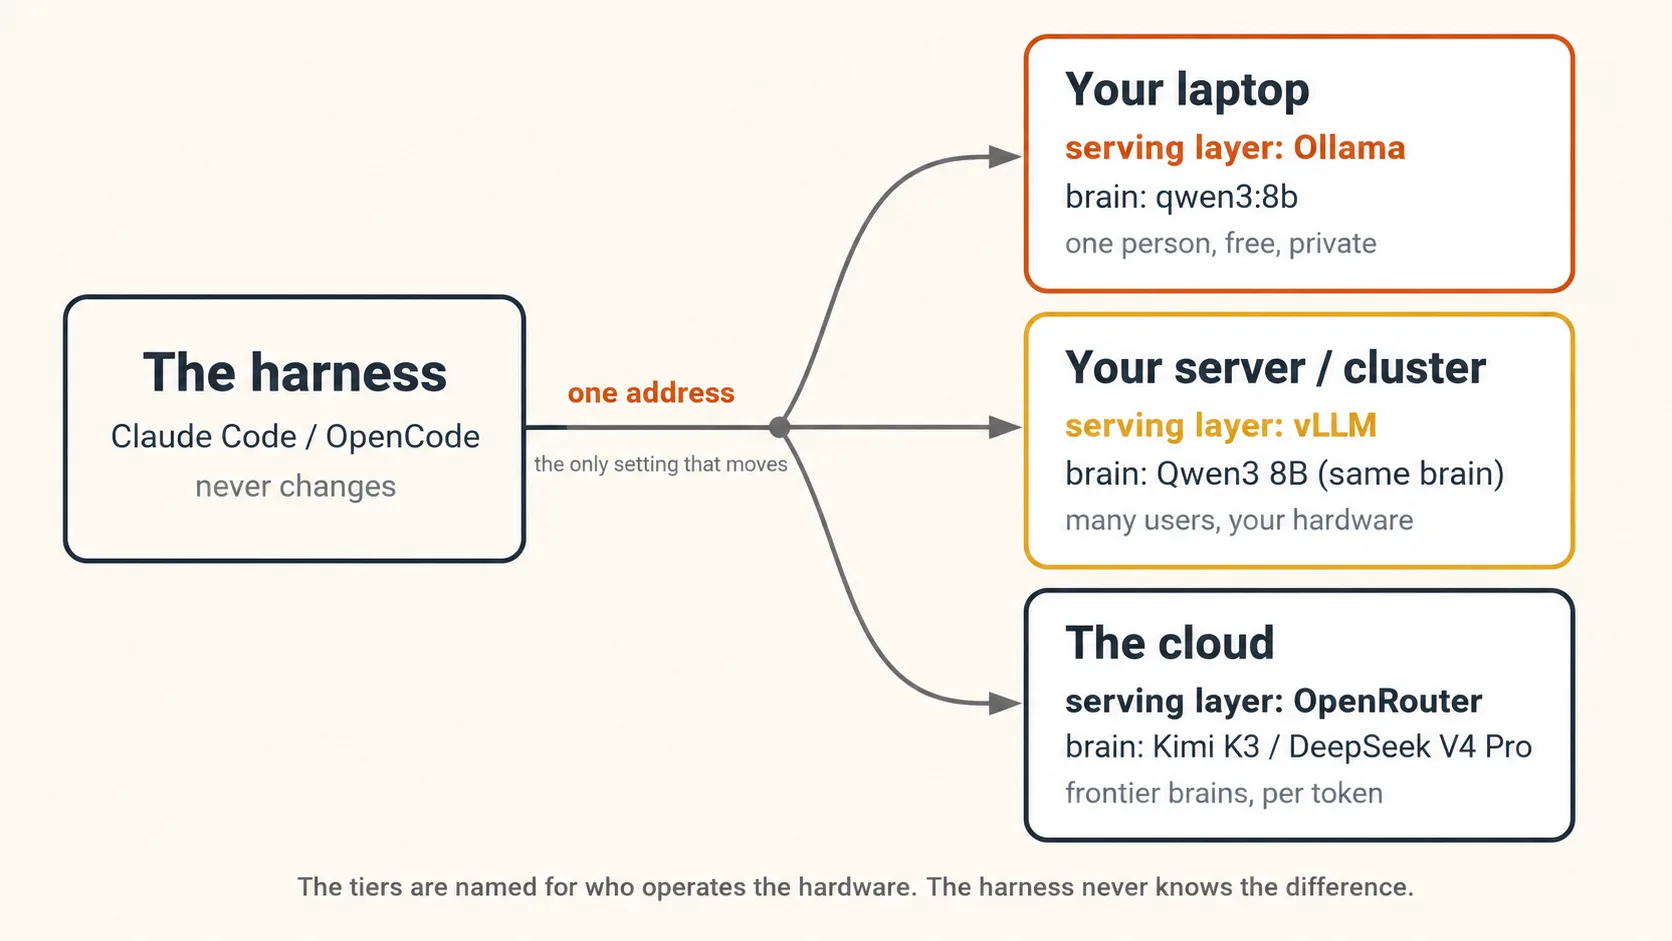
Esta es tu primera parada en Agentes generales, la sección donde elegirás la IA que manejarás durante el resto del libro. Comienzas siendo dueño del cerebro porque así la idea central de la sección se vuelve real desde el primer día: un agente es un arnés más un cerebro intercambiable. Después aprenderás a manejar bien ese agente (Programación agéntica), dirigirlo mediante una especificación escrita (Desarrollo guiado por especificaciones) y entregarle un bucle que se ejecute sin ti (Ingeniería de bucles).
Ahora, la promesa y el límite con palabras sencillas. La Parte 1 es real, gratuita y privada en cualquier equipo, aunque el trabajo de programación pesado avanza con mucha lentitud en un portátil común. Esa lentitud no es un error del curso. Aprender a verla y entender por qué aparece es una lección principal de la Parte 1. La Parte 2 necesita una máquina con una tarjeta gráfica NVIDIA, que la mayoría de los estudiantes alquila por hora a cambio de unos pocos dólares. La Parte 3 requiere una cuenta de OpenRouter con algunos dólares de saldo. Cada parte es independiente. Completa hoy la Parte 1 y vuelve al resto cuando estés preparado.
- Parte 1, conversar con un modelo local: nada más que la instalación gratuita de Ollama. Cualquiera puede hacerlo.
- Parte 1, la mitad de programación, y Partes 2 y 3: un agente de programación (Claude Code u OpenCode) ya instalado. ¿Todavía no tienes uno? El curso acelerado de Programación agéntica te ayuda a configurarlo. Puedes hacer ese curso antes o después de este.
- Solo la Parte 2: acceso a una máquina Linux con una GPU NVIDIA: aproximadamente 24 GB de memoria GPU para la versión estándar o unos 16 GB para la versión comprimida en hardware compatible (la Parte 2 muestra ambos caminos). Es normal y económico alquilar una durante una o dos horas a un proveedor de GPU en la nube.
- Solo la Parte 3: una cuenta gratuita de OpenRouter y unos pocos dólares de saldo.
Desde el primer paso puedes seguir el curso en tu propio equipo. Los comandos de esta página usan Bash para macOS, Linux y Windows mediante WSL. Si prefieres PowerShell, la documentación vigente de cada herramienta muestra la forma equivalente. En cualquier paso con un agente de programación, trabaja dentro de una carpeta git pequeña y desechable para que el agente no pueda tocar nada importante. Se aprende más al encontrar un límite por cuenta propia que al leer sobre tres límites.
Palabras clave en lenguaje sencillo
Lee esta sección una vez. Vuelve cuando alguna palabra no esté clara. Todos los conceptos siguientes vuelven a enseñarlas en contexto, así que no necesitas memorizarlas aquí.
| Término | Significado sencillo |
|---|---|
| Modelo / cerebro | La IA que realiza el razonamiento. Le envías palabras y devuelve palabras. |
| Ollama | Programa gratuito que descarga un modelo de IA y lo ejecuta en tu equipo. Está pensado para una persona. |
| vLLM | Programa gratuito que ofrece un modelo de IA a muchos usuarios a la vez. Está pensado para una máquina compartida. |
| Capa de servicio | Software que carga un modelo y responde solicitudes. Ollama y vLLM son capas de servicio. |
| OpenRouter | Gateway en la nube que coloca cientos de modelos detrás de una dirección. Los alojadores ejecutan las capas de servicio. |
| Arnés / herramienta | Programa que rodea al cerebro. Lee tus archivos, ejecuta comandos y muestra cambios. Claude Code es un arnés. |
| Agente de programación | Arnés que escribe y edita código por ti, como Claude Code u OpenCode. |
localhost | Dirección que significa «este mismo equipo». Tu máquina habla consigo misma, por lo que no necesita internet. |
| Dirección / URL base | Lugar al que la herramienta envía su trabajo. Apúntala a localhost y el trabajo permanecerá en tu equipo. |
| Llamada a herramienta | Mensaje pequeño y exacto que el modelo envía para decir «edita este archivo» o «ejecuta este comando». Son datos, no una oración. |
| Token | Unidad que un modelo lee y factura: una parte de una palabra, aproximadamente de tres a cuatro letras en inglés. |
| Ventana de contexto | Cantidad de tokens que el modelo puede contener a la vez. Si es demasiado pequeña, olvida el inicio de la tarea. |
num_ctx | Configuración de Ollama para la ventana de contexto. El valor predeterminado depende de tu equipo y suele ser muy pequeño para agentes de programación. |
| Las dos barreras | Dos requisitos que una configuración local de programación debe superar: un modelo bastante potente y hardware bastante rápido. |
| Concurrencia | Cantidad de solicitudes que llegan al mismo tiempo. Un usuario equivale a concurrencia 1; una clase, a concurrencia 50. |
| Rendimiento | Trabajo útil total por segundo, medido aquí en tokens por segundo entre todos los usuarios. |
| Procesamiento continuo por lotes | Técnica de vLLM: envía muchas solicitudes juntas a la GPU e introduce otras nuevas mientras el proceso está en marcha. |
| Modelo de pesos abiertos | Modelo cuyos pesos entrenados se pueden descargar. No siempre es «código abierto» en sentido formal: los datos de entrenamiento y algunas condiciones pueden seguir cerrados. |
| Modelo abierto de frontera | Modelo de pesos abiertos situado en la cima de las clasificaciones y tan grande que solo los clústeres pueden ofrecerlo. Kimi K3 es un ejemplo. |
| Clave de API | Cadena secreta que demuestra que una cuenta es tuya. En el nivel de nube, también determina la facturación. |
Dos capas atraviesan este curso y envejecen de formas muy distintas. Recuerda la primera. Consulta la segunda.
- La capa duradera. Un modelo puede vivir en tres escalas: tu equipo, una máquina que controlas o un clúster que alquilas. Tu herramienta accede mediante una dirección que puedes cambiar. Una capa de servicio diseñada para un usuario genera una cola bajo carga; otra diseñada para muchos no lo hace. Elegir el nivel correcto depende de la privacidad, el hardware y el costo, de maneras que primero experimentarás y después nombrarás. Esto seguirá siendo cierto mucho después de que cambien todos los comandos siguientes.
- La capa mecánica. Cada número de versión, flag, nombre de modelo, precio y configuración. Ollama, vLLM, OpenRouter y las herramientas de programación cambian con rapidez. Por eso debes tratar cada comando como un indicador hacia la documentación vigente, no como un dato que memorizar. Si el curso contradice la documentación actual, la documentación tiene razón.
Qué cubre este curso
| Concepto | Parte | Tú vas a… |
|---|---|---|
| 1 | 1 | Ejecutar un modelo en tu equipo y conversar con él en unos dos minutos |
| 2 | 1 | Aprender la idea que lo hace funcionar: el cerebro es solo una dirección |
| 3 | 1 | Hacer que el modelo actúe: apuntar un agente de programación hacia él con un comando |
| 4 | 1 | Darle una tarea de programación real y sentir dónde un cerebro local resiste o falla |
| 5 | 1 | Comprender las dos barreras: un modelo bastante potente y hardware bastante rápido |
| 6 | 1 | Examinar una llamada a herramienta real, aquello que un modelo débil hace mal |
| 7 | 1 | Decidir cuándo vale la pena poseer el cerebro |
| 8 | 2 | Ver por qué Ollama es una cocina para uno: enviarle 50 solicitudes y observar la cola |
| 9 | 2 | Ofrecer el mismo Qwen3 8B con vLLM y aprender qué significa el procesamiento continuo por lotes |
| 10 | 2 | Ejecutar las mismas 50 solicitudes contra vLLM, trazar ambas curvas y leer la diferencia |
| 11 | 2 | Conectar Claude Code y OpenCode al servidor vLLM sin necesidad de traductor |
| 12 | 2 | Decidir cuándo vale la pena usar el nivel de servidor |
| 13 | 3 | Conocer modelos abiertos de frontera que casi nadie puede alojar: Kimi K3 y DeepSeek V4 Pro |
| 14 | 3 | Utilizar ambos desde Claude Code y OpenCode mediante OpenRouter |
| 15 | 3 | Elegir entre rendimiento y precio, y seleccionar el nivel adecuado para cada trabajo |
| 16 | 3 | Colocar un router delante de los tres niveles y convertir tu política de niveles en configuración |
| A | Apéndice | Convertir el servidor de la Parte 2 en un servicio compartido con claves, presupuestos y un menú |
📚 Material didáctico
Ver la presentación completa: LLM de código abierto: tu portátil, tu servidor o clúster y la nube
Parte 1: el nivel local. Un modelo en tu propio portátil (Ollama)
La capa de servicio de esta parte es Ollama y la escala es una persona, una máquina. Todo aquí es gratuito y privado.
1. Un cerebro en tu propio equipo: comienza aquí
La forma más rápida de entenderlo es hacerlo una vez. Antes de cualquier teoría, pongamos un modelo en ejecución en tu equipo y conversemos con él. No necesitas escribir código en esta parte. Cualquiera puede hacerlo.
El programa gratuito que lo hace se llama Ollama. Descarga un modelo de IA y lo ejecuta en tu equipo. Elige la opción que corresponda a tu máquina.
- La app (Mac o Windows)
- La terminal (cualquier equipo, incluido Linux)
- Ve a ollama.com/download e instala Ollama de la forma habitual. La instalación incluye una pequeña app de chat.
- Abre la app Ollama. Se encuentra en la barra de menús (Mac) o en la bandeja del sistema (Windows).
- Elige un modelo en el selector superior. Comienza con uno pequeño, como
gemma3:4b. La primera vez que lo elijas se descargarán unos pocos gigabytes, lo que tomará algunos minutos. - Escribe una pregunta en el cuadro y presiona Intro.
Eso es todo. La respuesta provino de un modelo que se ejecuta en tu propio equipo.
Abre una terminal y ejecuta un comando. La primera vez descarga el modelo y después abre un chat:
ollama run gemma3:4b
Escribe tu pregunta y presiona Intro. Para salir del chat, escribe /bye.
Si todavía no tienes Ollama, instálalo primero desde ollama.com/download y después ejecuta el comando anterior.
¿Qué modelo debes elegir? Comienza con uno pequeño. Un modelo pequeño responde rápido y cabe en un equipo modesto. Más tarde podrás probar otros más grandes.
| Modelo | Descarga aproximada | RAM recomendada | Adecuado para |
|---|---|---|---|
gemma3:1b | menos de 1 GB | unos 4 GB | tareas pequeñas y rápidas, pero respuestas débiles |
llama3.2:3b | unos 2 GB | unos 8 GB | una primera conversación pequeña y sólida |
gemma3:4b | unos 3 GB | unos 8 GB | un modelo pequeño potente y una buena opción predeterminada |
qwen3:8b | unos 5 GB | unos 16 GB | mejores respuestas, pero necesita más memoria |
Un modelo de esa tabla importa más allá de esta parte: qwen3:8b. Este curso mantiene ese modelo constante durante las Partes 1 y 2 para que, cuando algo cambie, sepas exactamente por qué. Si cabe en tu equipo, descárgalo ahora. Si no, usa aquí uno más pequeño y alquila el hardware en la Parte 2.
Los nombres y tamaños exactos anteriores cambian a medida que se actualizan los modelos. Antes de depender de una etiqueta, consúltala en ollama.com/library. Ese hábito de comprobar la fuente vigente es la capa de «consultar» en acción.
El Concepto 1 está completo cuando: hiciste una pregunta y respondió un modelo que se ejecuta en tu propio equipo. Apaga el wifi y vuelve a preguntar. Sigue funcionando. Nada salió de tu equipo.
Vale la pena detenerse en esa última parte. El modelo se ejecuta como un pequeño programa en tu equipo y escucha en una dirección llamada localhost. Esa palabra solo significa «este mismo equipo». Tu máquina habla consigo misma. Por eso sigue funcionando sin internet.
Si solo querías una IA privada en tu propio equipo, ya la tienes. Puedes ejecutarla cuando quieras, sin conexión y gratis; nada de lo que escribas saldrá de tu equipo. Solo eso ya merece la pena.
El resto del curso hace que ese mismo modelo local actúe: leer tus archivos, escribir código y editarlos por ti. Si te interesa, continúa. Si no, ya obtuviste el beneficio.
2. La idea que hace funcionar todo: el cerebro es solo una dirección
Acabas de hacerlo. Ahora pongamos nombre a lo ocurrido, porque esta idea está debajo de todas las herramientas de IA que usarás y de los tres niveles del curso. Vale la pena avanzar despacio.
Tu herramienta de IA tiene dos partes:
- El arnés: el programa en tu equipo. Lee tus archivos, ejecuta comandos y te muestra qué cambió. Claude Code es un arnés. La app de chat de Ollama es uno más sencillo.
- El cerebro: el modelo que lee todo eso y decide qué decir o hacer.
El arnés accede al cerebro del mismo modo que tu navegador accede a un sitio web: mediante una dirección. Piensa en ella como un número de teléfono. El arnés marca un número y quien responde se encarga de pensar.
Normalmente, ese número apunta lejos, a las máquinas de una empresa. Sin embargo, solo es una configuración. Cambia el número y exactamente el mismo arnés hablará con un cerebro diferente. En el Concepto 1, el nuevo número era localhost: tu propio equipo. Por tanto, el cerebro que respondía era el de tu portátil.
Imagina una app de entrega de comida. La app del teléfono es la misma todos los días. Cambia la dirección del restaurante y esa misma app pedirá comida a otra cocina. Tu herramienta de IA es la app. La dirección es el número de teléfono. La cocina situada en esa dirección es donde el modelo prepara la respuesta.
Esta es la parte que resulta fácil interpretar mal y que será importante más adelante. El cerebro local no es una copia más pequeña del mismo cerebro que usabas antes. Es un cerebro diferente y puede ser mucho más débil. La misma app, otra cocina; la cocina nueva quizá tenga un cocinero menos hábil. Recuérdalo, porque conduce directamente al Concepto 5.
Conserva la imagen de la cocina, porque el curso visita tres. La Parte 1 es la cocina de tu propia casa. La Parte 2 es una cocina industrial que tú operas, construida para atender a un restaurante completo. La Parte 3 consiste en pedir a los mejores restaurantes del mundo, porque ninguna casa podría contener sus cocinas. La app es la misma en todo momento. Solo cambia la dirección.
Cambiaste una dirección y respondió un modelo de tu propio equipo. ¿Qué parte de la herramienta de IA cambió y cuál permaneció igual? El cerebro cambió: ahora tus palabras van a un modelo en tu propio equipo. El arnés permaneció igual: la app, los botones y la forma de hablarle. Solo cambiaste la dirección que marca.Mostrar la respuesta
3. Haz que actúe: un agente de programación con tu cerebro local
Conversar con un modelo local es un buen comienzo. Sin embargo, un agente hace más que conversar. Lee tus archivos, escribe código y ejecuta comandos por ti. Así que vamos a apuntar un agente de programación hacia el mismo cerebro local.
Este paso conecta un agente de programación con tu modelo local. Por tanto, necesitas tener Claude Code u OpenCode ya instalado. Si tienes uno, puedes continuar. Si no, instala uno primero; el curso acelerado de Programación agéntica te guía durante el proceso. El siguiente comando lo conecta e inicia. No lo instala por ti.
Hay dos formas de hacerlo. La sencilla usa un solo comando. La manual muestra las conexiones internas, algo que vale la pena ver una vez. Elige una pestaña.
- Ejecutarlo directamente
- Configurarlo a mano
Las versiones recientes de Ollama pueden conectar e iniciar un agente de programación sin que tengas que editar configuraciones. Solo necesitas un comando:
ollama launch claude
Esto configura Claude Code para que use un modelo local y lo inicia. Te preguntará qué modelo quieres usar, aunque también puedes indicar uno que ya hayas descargado:
ollama launch claude --model qwen3:8b
La otra herramienta tiene un comando equivalente: ollama launch opencode.
unknown command "launch"El comando ollama launch necesita una versión reciente de Ollama, la 0.15 o posterior. Si ves ese error, actualiza Ollama: vuelve a ejecutar el instalador desde ollama.com/download o actualízalo desde la app. Comprueba la versión con ollama --version.
Existe una pequeña skill complementaria que realiza toda la configuración y te dice la verdad sobre tu hardware antes de que inviertas tiempo. Tu agente la lee y hace el trabajo. Instálala y después pide lo siguiente con palabras cotidianas:
npx skills add panaversity/local-llm-agentic-coding --agent claude-code opencode -y
Configúrame un agente de programación para que use un modelo local. Primero comprueba mi hardware con honestidad; después guíame paso a paso y detente para pedirme aprobación antes de cualquier operación importante.
El instalador puede omitir en silencio un nombre que no reconoce, así que primero puedes obtener una vista previa con npx skills add panaversity/local-llm-agentic-coding --list.
El comando anterior solo completa algunas configuraciones por ti. A continuación verás qué completa, para que entiendas las conexiones y puedas reproducirlas en cualquier lugar. Las dos herramientas se comunican con el mismo modelo local de formas ligeramente distintas.
- Claude Code
- OpenCode
Claude Code habla con el modelo local como si hablara con Anthropic. Apúntalo a la dirección local, proporciónale un token de marcador de posición y asegúrate de que no haya una clave de API real configurada:
export ANTHROPIC_BASE_URL=http://localhost:11434   # the local address, bare host, no /v1
export ANTHROPIC_AUTH_TOKEN=ollama                 # any non-empty word; it is sent as "Bearer ollama"
export ANTHROPIC_API_KEY=                          # must be empty, or it overrides the line above
claude --model qwen3:8b                             # use a model tag you have pulled
Algunas notas breves que evitan problemas:
- La dirección está desnuda, es decir, solo contiene el host y el puerto. Claude Code añade por sí mismo el resto de la ruta. No agregues
/v1. - Debes indicar un modelo de Ollama mediante
--model, porque de lo contrario Claude Code buscará nombres de modelos que tu equipo local no tiene. - En Windows,
localhostpuede apuntar al lugar equivocado, por lo que muchas personas usanhttp://127.0.0.1:11434en su lugar. Este comportamiento cuenta con muchos informes de usuarios, aunque no se menciona en la documentación oficial.
Para conservar la configuración en cada sesión, colócala en el bloque env de ~/.claude/settings.json en lugar de volver a escribirla cada vez:
{
  "env": {
    "ANTHROPIC_BASE_URL": "http://localhost:11434",
    "ANTHROPIC_AUTH_TOKEN": "ollama",
    "ANTHROPIC_API_KEY": ""
  }
}
OpenCode habla con el modelo local como si hablara con OpenAI. Admite oficialmente los modelos locales; la forma recomendada de conectarlo consiste en describir el servidor local en un archivo llamado opencode.json. Vale la pena hacerlo a mano una vez porque deja la dirección y la correspondencia de modelos a la vista. Observa el /v1 al final. Aquí es obligatorio y constituye la única diferencia respecto a la dirección de Claude Code:
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "ollama": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Ollama (local)",
      "options": { "baseURL": "http://localhost:11434/v1" },
      "models": { "qwen3:8b": { "name": "Qwen3 8B (local)" } }
    }
  },
  "model": "ollama/qwen3:8b"
}
Coloca este contenido en opencode.json dentro de tu proyecto o en ~/.config/opencode/opencode.json para todos los proyectos. El nombre incluido en models debe ser una etiqueta que realmente hayas descargado. En Windows, usa 127.0.0.1 en lugar de localhost.
Lee las pestañas de ambas herramientas y observa la estructura. El mismo modelo, la misma máquina y el mismo puerto. Claude Code marca una dirección desnuda. OpenCode marca esa misma dirección con /v1 al final. Esa es toda la diferencia entre las dos para los modelos locales. Aprende este contraste y podrás conectar cualquier herramienta con cualquier cerebro local. Volverás a utilizarlo sin cambios en las Partes 2 y 3.
El Concepto 3 está completo cuando: el agente de programación se inició y el modelo que usa se encuentra en tu propio equipo. Hazle una pregunta pequeña. La respuesta provino de tu portátil, no de una empresa lejana.
Eso es el Concepto 2 convertido en realidad. Cambiaste la dirección a localhost y ahora exactamente el mismo agente de programación envía el trabajo al cerebro de tu equipo.
4. Ahora ponlo a prueba: dale una tarea real y observa
Que un modelo local responda una pregunta es un primer paso pequeño. Que realice un trabajo de programación de verdad es la prueba auténtica. Vamos a ejecutarla.
Trabaja en una carpeta git pequeña y desechable que contenga algo de código real, aunque sea un único script. Después, con el agente apuntando al cerebro local, pega algo como esto:
Examina esta carpeta. Encuentra una mejora pequeña y segura, realiza el cambio y muéstrame qué modificaste.
Ahora observa con atención. Ocurrirá una de dos cosas y ambas forman parte de la lección.
En un equipo potente, con una buena tarjeta gráfica y un modelo mediano, funciona. El cerebro local lee los archivos, prepara un plan, edita y muestra un cambio limpio. En ese momento, lo gratuito, privado y sin conexión se vuelve real. Es tu propia configuración en funcionamiento.
En un portátil común, sin tarjeta gráfica y con un modelo pequeño, encuentras la barrera. Cada paso puede tardar varios minutos porque el equipo lee con lentitud una enorme cantidad de texto. También es posible que la ejecución se detenga a mitad de camino por un error de llamada a herramienta. El cerebro intentó decir «edita este archivo» y se equivocó de formato.
Todavía no corrijas nada. Limítate a observar qué ocurrió y cómo se sintió a grandes rasgos. ¿Fue rápido y limpio? ¿Lento o defectuoso? Esa sensación es la materia prima del siguiente concepto.
Si la tarea avanzó con lentitud o falló, no ocurrió nada incorrecto. Acabas de encontrar el límite real de ejecutar un modelo grande en un equipo pequeño. Es útil saberlo antes de invertir dinero o tiempo. El siguiente concepto explica exactamente lo que sentiste.
El Concepto 4 está completo cuando: pediste a un cerebro local un cambio real de código y viste el resultado, ya fuera una edición limpia, una espera larga o una ejecución interrumpida.
5. Por qué resistió o falló: las dos barreras
Ahora viene la explicación, porque ya sentiste aquello que explica. Esta es la idea más importante de la Parte 1, así que la presentaremos con claridad.
Un agente de programación local debe superar dos barreras independientes. No son la misma barrera y la solución de una no ayuda con la otra.
La primera barrera es la capacidad. Cada vez que el modelo actúa, lo que ocurre en casi todos los turnos del trabajo de programación, debe escribir una llamada a herramienta válida. Eso significa expresar «edita este archivo, cambia esta línea por aquella» con el formato exacto y estricto que espera el arnés. Los modelos pequeños suelen equivocarse. Omiten la herramienta o estropean el formato y la ejecución se detiene. Un modelo más potente y entrenado para usar herramientas suele resolverlo. Un hardware más rápido no lo hace: una máquina rápida que ejecuta un modelo diminuto aún escribe llamadas a herramientas defectuosas.
La segunda barrera es el rendimiento. En cada turno, el arnés envía al modelo una instrucción larga, formada por las reglas de la herramienta y las definiciones de todo lo que puede hacer, antes de que tu tarea siquiera comience. La máquina debe leerla con rapidez. Con una tarjeta gráfica tarda un momento. Sin ella, usando solo el procesador, cada turno puede tardar minutos. Una tarjeta gráfica resuelve el problema. Un modelo más inteligente no: un modelo brillante en una máquina lenta sigue siendo terriblemente lento.
| Barrera | Qué necesita | Se resuelve con | No se resuelve con |
|---|---|---|---|
| Capacidad | Una llamada a herramienta correcta al actuar | Un modelo más potente, entrenado para herramientas | Solo hardware más rápido |
| Rendimiento | Leer la instrucción larga en pocos segundos | Una tarjeta gráfica (una GPU) | Un modelo más inteligente o pequeño |
Una aclaración sobre el tamaño antes de la siguiente tabla: no existe un número mínimo universal de parámetros que garantice un uso fiable de herramientas. El entrenamiento para herramientas, la plantilla de chat y la compatibilidad con el arnés importan tanto como el tamaño bruto; un modelo pequeño bien entrenado puede superar a otro más grande y peor entrenado. Sin embargo, entre los modelos locales comunes actuales se mantiene el patrón aproximado de que los más grandes gestionan de forma más fiable el uso de herramientas en varios pasos. Ese es el patrón que describen las tablas de esta página.
Los equipos económicos chocan con ambas barreras a la vez. Por eso un portátil común es adecuado para conversar con un modelo, pero no para ejecutar un agente de programación: las conexiones son correctas, aunque ninguna barrera se haya superado.
Acércate al interior de la cocina del Concepto 2. Dos elementos deciden cómo sale la comida: el cocinero y la estufa. El cocinero es tu modelo. La estufa es tu máquina. La capacidad pregunta si el cocinero tiene la habilidad suficiente para acertar con el pedido todas las veces. El rendimiento pregunta si la estufa es lo bastante rápida para servir en segundos, no en minutos. Un gran cocinero con una estufa lenta aún te hará esperar. Una estufa rápida con un cocinero torpe aún arruinará el plato. Necesitas ambos.
Esta es la única frase honesta que debes recordar sobre el hardware. Todo lo descrito en esta página es igual en una máquina alquilada en la nube con tarjeta gráfica: las conexiones, la configuración y las dos barreras. Solo cambia la velocidad. Una tarjeta gráfica con aproximadamente entre 16 y 24 GB de memoria convierte una configuración local en un agente de programación realmente utilizable. Esa frase también abre la puerta a la Parte 2, donde alquilarás exactamente esa máquina y harás algo que tu portátil jamás podría hacer.
Una guía aproximada sobre qué modelo corresponde a cada máquina:
| Modelo | Tamaño | Memoria necesaria | ¿Preparado para programar? |
|---|---|---|---|
llama3.2:3b | 3B | unos 8 GB | No. Bueno para conversar; estropea llamadas a herramientas. |
qwen3:8b | 8B | unos 16 GB | Aceptable para tareas sencillas |
phi4:14b | 14B | unos 12 GB | Cerca del mínimo práctico dentro de esta selección |
qwen3:30b-a3b | mezcla de 30B | entre 20 y 24 GB | El mejor equilibrio: respuestas sólidas y buena velocidad |
qwen3:32b | 32B | unos 24 GB | Potente, un poco más lento que la mezcla anterior |
La tarea se ejecutó, pero cada turno tardó cuatro minutos. Cambias a un modelo mucho más inteligente en el mismo portátil. ¿Se vuelve más rápido? No. Un turno lento corresponde a la barrera de rendimiento y un modelo más inteligente no la modifica. Incluso podría ser más lento, porque es más grande. El rendimiento se resuelve con una tarjeta gráfica, no eligiendo otro modelo. Confundir las dos barreras es precisamente el error que este concepto pretende evitar.Mostrar la respuesta
6. Mira dentro: qué es realmente una llamada a herramienta
El Concepto 5 explicó que un modelo débil «estropea sus llamadas a herramientas». Eso suena impreciso. Veamos una real, porque observarla vuelve evidente toda la idea.
Una llamada a herramienta correcta no es escritura común. Es una pequeña pieza de datos estructurados, una instrucción exacta que el arnés puede ejecutar. Tiene este aspecto:
{
  "type": "tool_use",
  "name": "edit_file",
  "input": { "path": "README.md", "old": "Hello", "new": "Hello, world" }
}
El arnés lee esos datos y edita el archivo. El modelo no escribió el cambio por sí mismo. Envió una instrucción precisa y el arnés hizo el trabajo. Eso es lo que significa en realidad «el modelo usa herramientas». Es el momento en que un modelo de chat deja de ser un cuadro de conversación y comienza a actuar.
Ahora observa qué hace un modelo demasiado débil. Envía el input como una masa de texto en lugar de un objeto real y el arnés lo rechaza con un error de validación como este:
invalid tool arguments: expected object, got string
Las palabras exactas varían según el arnés. Lo importante es la forma del fallo: los argumentos llegaron con la estructura incorrecta, así que el arnés se niega a actuar sobre ellos.
La ejecución se detiene. Nada se edita. Ese único mensaje defectuoso suele ser lo que terminó la ejecución del Concepto 4. Es la barrera de capacidad vista de cerca.
Hay otro factor que determina si esto funciona: la ventana de contexto. Es la cantidad de tokens que el modelo puede contener a la vez; un token es una parte de una palabra y la unidad que los modelos realmente cuentan. En Ollama se configura mediante num_ctx. El arnés envía esa instrucción larga en cada turno y Ollama elige una ventana predeterminada según la memoria gráfica del equipo. En la mayoría de los portátiles con menos de 24 GiB de VRAM, el valor predeterminado es de solo 4.096 tokens. Una ventana tan pequeña recorta en silencio casi toda la instrucción. Esta es la trampa: no aparece ningún error. Ollama simplemente recorta la instrucción y responde de todos modos. Por eso la conversación parece funcionar, pero las tareas de programación fallan de forma desconcertante: el modelo nunca vio la parte que explica cómo dar formato a una llamada a herramienta. Una ventana truncada es la causa más habitual de este patrón, aunque no la única; por eso debes comprobarla primero en lugar de darla por supuesta.
La solución consiste en ampliar la ventana. La recomendación actual de Ollama para agentes y herramientas de programación es de al menos 64.000 tokens. Cuando el agente esté en ejecución, puedes pedirle lo siguiente:
La ventana de contexto parece demasiado pequeña y está dañando las llamadas a herramientas. Configúrala con al menos 64.000 tokens y vuelve a intentar la tarea.
Más detalles: por qué una ventana pequeña causa fallos sin advertencia
Aumentar la ventana de contexto a 64.000 tokens o más es la solución más común para «mi agente de programación local no funciona». Puedes configurarla de varias formas: mediante un control deslizante en la configuración de la app Ollama, iniciando el servidor con OLLAMA_CONTEXT_LENGTH=64000, usando un archivo de modelo personalizado, un Modelfile con PARAMETER num_ctx 64000, o dentro de una sesión de chat mediante /set parameter num_ctx 64000. Las ventanas mayores necesitan más memoria y ollama ps muestra la ventana que recibió realmente un modelo en ejecución. Si tu configuración responde en el chat, pero falla en tareas reales, comprueba primero la ventana de contexto.
Abrir la lista de soluciones rápidas
- Responde en el chat, pero ignora instrucciones en tareas reales. Es probable que la ventana de contexto sea demasiado pequeña y haya recortado las instrucciones. Aumenta
num_ctxa 64.000 o más y vuelve a probar antes de buscar otras causas. - Cada turno tarda minutos y después agota el tiempo. La máquina es demasiado lenta para leer a tiempo la instrucción larga. Puedes aumentar el tiempo de espera mediante
export API_TIMEOUT_MS=1200000. Si aún se agota, la barrera de rendimiento te está diciendo la verdad. - Aparece un mensaje sobre una clave ausente o conectores desactivados. No causa daño. Aparece porque configuraste un token de marcador de posición y un modelo local no usa esas funciones.
No necesitas memorizar estas soluciones. El agente puede guiarte por cualquiera de ellas.
El Concepto 6 está completo cuando: has visto una llamada a herramienta real como datos estructurados y entiendes que una llamada defectuosa o una ventana de contexto demasiado pequeña puede romper un agente de programación local.
7. Cuándo vale la pena poseer el cerebro
Ya puedes ejecutarlo. La pregunta honesta es cuándo deberías hacerlo.
Alquilar un modelo grande en la nube o usar un agente de programación de la forma habitual suele ser más sencillo y, a menudo, más sensato. La ejecución local gana en casos concretos que conviene expresar con claridad:
- Privacidad. El trabajo nunca sale de tu equipo. Para tareas sensibles o reguladas, este factor puede decidirlo todo.
- Sin conexión. Sin red, cuenta ni interrupciones. Un modelo en tu disco sigue funcionando en un avión o detrás de un firewall restringido.
- Costo cuando el trabajo se ejecuta todo el día. Una solicitud individual es económica en cualquier servicio. Sin embargo, un bucle que se ejecuta cada pocos minutos durante todo el mes genera una factura distinta. Cuando el trabajo nunca se detiene, poseer el cerebro puede costar menos que la nube.
Este último punto importa dos veces en el libro. En Ingeniería de bucles construirás agentes que se ejecutan solos todo el día y comprueban su propio trabajo mientras duermes. En ese escenario, de quién es el cerebro que ejecuta el bucle y cuánto cuesta cada ejecución dejan de ser detalles y se convierten en el diseño. Acabas de aprender a poseer ese cerebro.
Hay otro detalle que debes observar y que constituye la lección silenciosa de toda esta parte. Si usaste la skill complementaria, no configuraste nada a mano. Instalaste una skill y el agente la utilizó. Esa skill es solo una carpeta con un archivo SKILL.md, la misma estructura que aprendiste en el curso acelerado de skills. Esto significa que puedes empaquetar tus propios conocimientos de igual forma y compartirlos para que cualquier agente los instale. Cuando estés listo para publicar una, gh skill publish --dry-run la comprobará frente a la especificación Agent Skills antes del envío.
La Parte 1 está completa. Posees un cerebro, conectaste dos agentes de programación y conoces las dos barreras que deciden si la configuración es utilizable. Sin embargo, observa algo sobre todo lo que construiste: la cocina atendió exactamente a un cliente. A ti. Envíale 10 solicitudes a la vez y te hará esperar en la fila. Esa fila y el software que la elimina son el tema de la Parte 2.
Parte 2: el nivel de servidor. Una máquina, muchos usuarios (vLLM)
La capa de servicio de esta parte es vLLM y la escala son muchos usuarios en una sola máquina potente. El modelo no cambia. Ese es precisamente el objetivo.
Antes de continuar, pongamos nombre a la palabra nueva sobre la que se construye esta parte: la capa de servicio. Es el software que carga un modelo en la memoria y responde a sus solicitudes. Ollama es una capa de servicio. vLLM también. En esta parte mantendrás constante el cerebro, Qwen3 8B, y cambiarás solo la capa de servicio situada debajo. Mantén todo lo demás tan fijo como permita la práctica, cambia una sola cosa y la diferencia medida pertenecerá en su gran mayoría a esa cosa. No es solo un buen método científico. Así depurarás los sistemas de agentes durante el resto de tu carrera: aísla la variable y después mide. También debes conocer la salvedad honesta: este es un experimento didáctico, no de laboratorio. Lo acompañan pequeñas diferencias en la precisión del modelo, el código del entorno de ejecución y la configuración. Por eso la afirmación describe un patrón que esperar, no un decimal que defender.
Una máquina Linux con una tarjeta gráfica NVIDIA. Para la versión estándar de precisión completa que aparece a continuación, busca aproximadamente 24 GB de memoria GPU. También puedes usar una tarjeta de 16 GB con la versión FP8 comprimida; el Concepto 9 muestra ambos caminos. Casi nadie posee una máquina así y no pasa nada: alquilar una durante una o dos horas a un proveedor de GPU en la nube cuesta unos pocos dólares, y todos los comandos siguientes son idénticos en una máquina alquilada. Si ahora no puedes alquilarla, lee igualmente esta parte. Vale la pena comprender las dos curvas finales incluso antes de poder dibujarlas.
8. La cocina para uno: envía 50 solicitudes a Ollama y observa
La Parte 1 terminó con una afirmación: tu configuración de Ollama atiende a un cliente. Vamos a demostrarlo mediante una medición, no con un eslogan.
Este es el experimento. Escribirás un pequeño script que envía muchas solicitudes al mismo tiempo a un servidor de modelos e informa dos números: cuánto tardó el lote completo y el total de tokens por segundo entre todas las solicitudes. La cantidad de solicitudes que llega a la vez se llama concurrencia. Un usuario equivale a concurrencia 1. Una clase de 50 estudiantes que presiona Intro al mismo tiempo equivale a concurrencia 50.
Ollama y vLLM responden al mismo formato estándar de solicitud, el formato compatible con OpenAI que viste en la configuración de OpenCode. Por tanto, un solo script prueba ambos. Solo cambian la dirección y el nombre del modelo. Guarda lo siguiente como bench.py:
# bench.py: fire N concurrent requests at a model server and measure throughput.
# usage: python bench.py <base_url> <model> <concurrency>
import asyncio, sys, time
import httpx

BASE_URL = sys.argv[1]        # http://localhost:11434/v1 (Ollama) or http://localhost:8000/v1 (vLLM)
MODEL = sys.argv[2]           # qwen3:8b (Ollama) or Qwen/Qwen3-8B (vLLM)
N = int(sys.argv[3])          # how many requests at once

PROMPT = "Explain in about 200 words how a bank reconciliation works."

async def one_request(client):
    r = await client.post("/chat/completions", json={
        "model": MODEL,
        "messages": [{"role": "user", "content": PROMPT}],
        "max_tokens": 300,
        "temperature": 0,
    })
    r.raise_for_status()
    return r.json()["usage"]["completion_tokens"]

async def main():
    async with httpx.AsyncClient(base_url=BASE_URL, timeout=3600) as client:
        await one_request(client)   # warm-up: load the model before timing anything
        start = time.perf_counter()
        results = await asyncio.gather(*[one_request(client) for _ in range(N)],
                                       return_exceptions=True)
        wall = time.perf_counter() - start
    ok = [r for r in results if isinstance(r, int)]
    failed = len(results) - len(ok)
    total = sum(ok)
    print(f"concurrency={N}  ok={len(ok)}  failed={failed}  tokens={total}"
          f"  time={wall:.1f}s  throughput={total/wall:.1f} tok/s")

asyncio.run(main())
Instala la única dependencia necesaria (pip install httpx), asegúrate de que Ollama esté en ejecución y de haber descargado qwen3:8b, y fija una configuración para que la ejecución sea reproducible. La cantidad de espacios paralelos de Ollama varía según la máquina y un experimento justo declara sus ajustes. Reinicia el servidor de Ollama mediante OLLAMA_NUM_PARALLEL=4 ollama serve (PowerShell: $env:OLLAMA_NUM_PARALLEL=4; ollama serve) para que tu curva y la de un compañero provengan de las mismas reglas. Después ejecuta el barrido. Hazlo en la máquina GPU que alquilaste para que la comparación de la Parte 2 sea justa: el mismo hardware para ambas capas de servicio.
python bench.py http://localhost:11434/v1 qwen3:8b 1
python bench.py http://localhost:11434/v1 qwen3:8b 5
python bench.py http://localhost:11434/v1 qwen3:8b 10
python bench.py http://localhost:11434/v1 qwen3:8b 25
python bench.py http://localhost:11434/v1 qwen3:8b 50
Ejecuta tres veces cada nivel de concurrencia y anota la mediana del rendimiento de las tres mediciones para que un fallo aislado no se convierta en tu punto de datos. Esas cinco medianas son lo que necesitas para el gráfico del Concepto 10.
Ahora interpreta lo que viste. Con concurrencia 1, todo funciona bien. Sin embargo, a medida que aumentaba, el rendimiento total apenas cambiaba, mientras que el tiempo de reloj se alargaba más y más. Con 50, es probable que el lote tardara muchos minutos. Lo que ocurrió dentro es sencillo: Ollama ejecuta en paralelo unas pocas solicitudes, los espacios OLLAMA_NUM_PARALLEL que acabas de fijar en 4, y coloca a todos los demás en una cola. La solicitud número 40 no comienza hasta que se libera un espacio. La tarjeta gráfica, la parte más cara de la máquina, pasa gran parte del lote esperando junto con la cola.
Nada de esto es un defecto de Ollama. Es una decisión de diseño honesta: Ollama está pensado para que el portátil de una persona resulte agradable. Nunca se construyó para ser un restaurante.
Esta es una cocina doméstica con un cocinero y dos estufas. Un invitado a cenar, perfecto. Con 50 invitados, 45 están en el pasillo sosteniendo una comanda. El cocinero no es perezoso ni la estufa está averiada. La cocina simplemente nunca se diseñó para una multitud.
El Concepto 8 está completo cuando: tienes cinco números de rendimiento medidos para Ollama con concurrencias de 1, 5, 10, 25 y 50, y observaste la formación de la cola con tus propios ojos.
9. La cocina industrial: ofrece el mismo cerebro con vLLM
Ahora toca la otra capa de servicio. vLLM es un programa gratuito y de código abierto con una sola tarea: ofrecer un modelo a muchos usuarios a la vez sin desperdiciar la tarjeta gráfica. Surgió de una investigación de UC Berkeley y hoy es la forma estándar en que las empresas ofrecen modelos abiertos en producción. Ollama optimiza la comodidad de una persona; vLLM optimiza el rendimiento total.
Obtiene ese rendimiento mediante dos ideas que vale la pena conocer con palabras sencillas:
- Procesamiento continuo por lotes. La tarjeta gráfica funciona mejor cuando hace muchas cosas a la vez. vLLM le entrega muchas solicitudes juntas y aquí aparece la parte inteligente: cuando una termina, otra que esperaba se desliza a su espacio mientras el proceso sigue en marcha, sin detener las demás. La tarjeta nunca queda inactiva mientras haya trabajo en la cola. Compáralo con una cola común, donde la tarjeta atiende unas pocas solicitudes, termina y después recoge las siguientes.
- Memoria paginada (PagedAttention). Cada conversación activa necesita memoria de trabajo en la tarjeta. Los servidores antiguos reservaban un bloque grande por conversación, casi siempre vacío, de modo que la tarjeta parecía «llena» mucho antes de estarlo. vLLM divide la memoria en páginas pequeñas y las entrega solo cuando hacen falta, como un sistema operativo administra la RAM. El resultado es que caben muchas más conversaciones a la vez en la misma tarjeta.
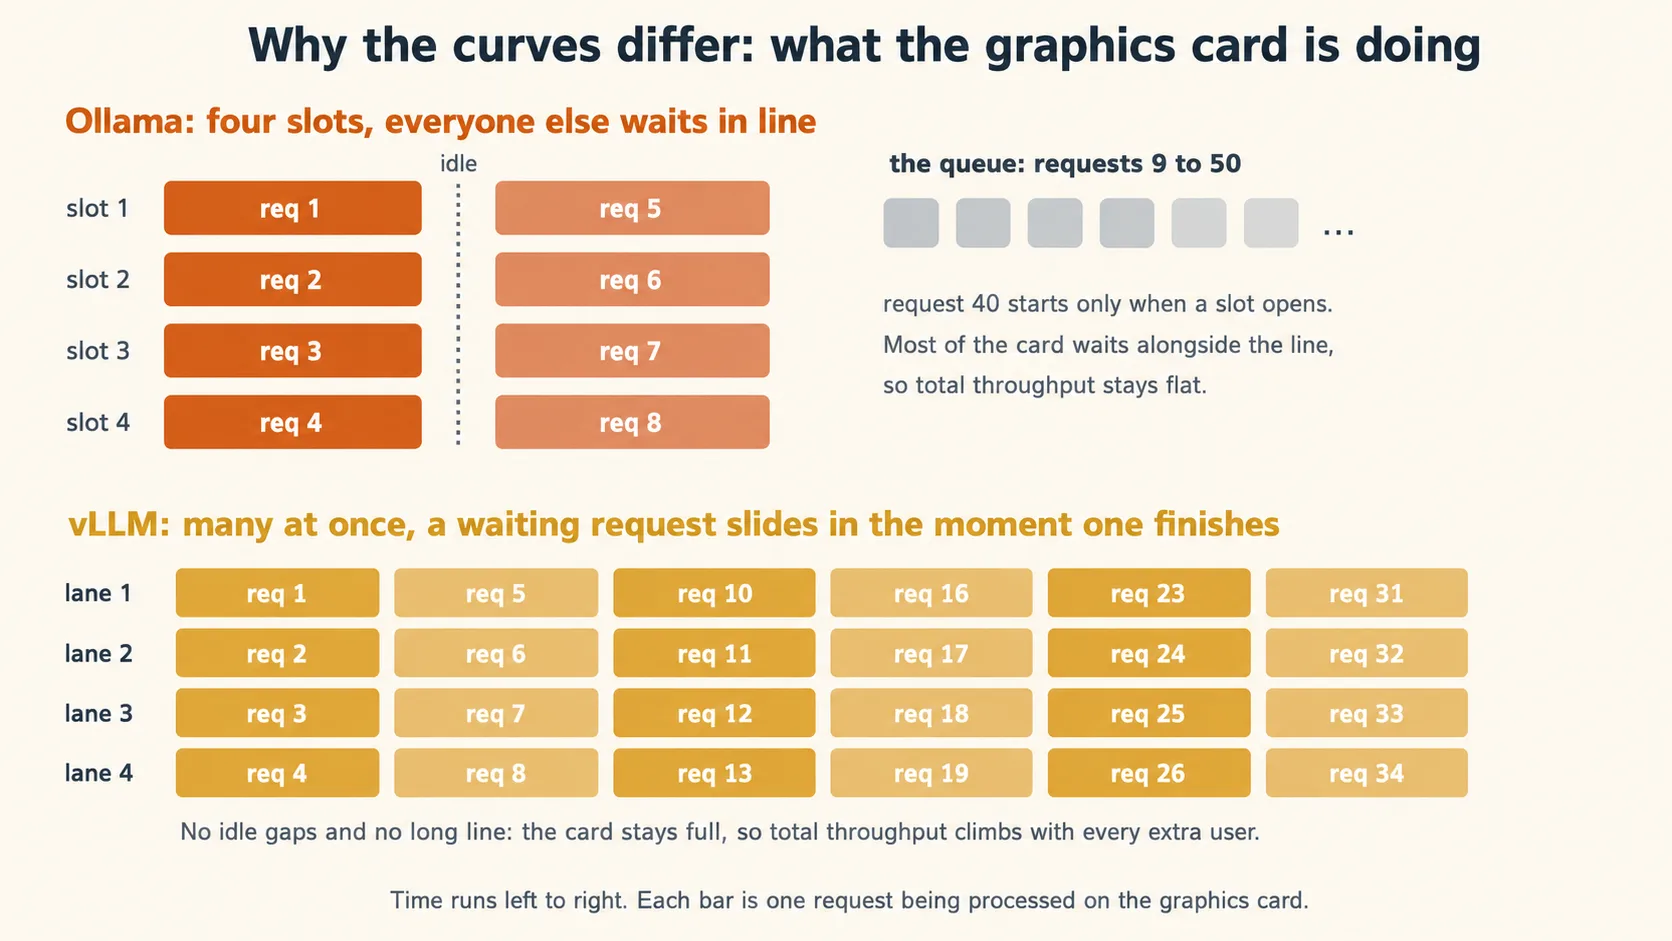
No necesitas recordar los nombres de los mecanismos. Recuerda el efecto: la tarjeta permanece llena, así que el rendimiento total aumenta cuando llegan más usuarios, en lugar de formarse una cola.
Una aclaración adicional para que los nombres de los niveles no te confundan. Esta parte ejecuta vLLM en una sola máquina, pero vLLM no se limita a ella: puede distribuir un modelo entre muchas tarjetas gráficas y entre muchas máquinas que actúan como un clúster. No es otro producto. Es el mismo software a mayor escala y es lo que ejecutan en sus propios clústeres muchos alojadores profesionales a los que alquilarás capacidad en la Parte 3. Por eso, los niveles del curso reciben su nombre de quién opera el hardware, no de lo que puede hacer el software. En la Parte 2, tú operas vLLM en un servidor. En la Parte 3, otra persona lo opera sobre 64 estufas y es muy probable que su cocina también utilice vLLM.
Ahora ejecútalo. Instala vLLM en la máquina GPU y ofrece la versión equivalente del modelo que acabas de probar. Una nota sobre los nombres: Ollama y vLLM descargan modelos de bibliotecas distintas, por lo que el mismo cerebro tiene dos nombres. qwen3:8b en la biblioteca de Ollama es Qwen/Qwen3-8B en Hugging Face, de donde vLLM obtiene los modelos. También hay una aclaración necesaria porque esta parte prometió aislar la variable. Las dos copias no son idénticas byte por byte: la etiqueta de Ollama incluye una copia comprimida, o cuantizada, de los pesos para que quepa en portátiles, mientras que vLLM descarga el original de precisión completa. Cuando el curso dice «el mismo cerebro», interprétalo con precisión: el mismo modelo Qwen3 8B en dos versiones adaptadas al servicio, con la copia de Ollama más ligera. Esa diferencia de precisión es otra variable que acompaña a tus números. No cambia el patrón de rendimiento que este experimento pretende mostrar. Para obtener la comparación más cercana, ofrece también la versión comprimida con vLLM: vllm serve Qwen/Qwen3-8B-FP8 con los mismos flags.
pip install vllm

vllm serve Qwen/Qwen3-8B \
  --enable-auto-tool-choice \
  --tool-call-parser hermes \
  --reasoning-parser qwen3
Una nota de hardware antes de ejecutarlo. La versión 8B de precisión completa necesita aproximadamente 16 GB de memoria GPU solo para los pesos, antes de contar la memoria de trabajo de las conversaciones, por lo que requiere una tarjeta de 24 GB para funcionar con comodidad. En una tarjeta de 16 GB, ofrece la versión comprimida: sustituye el nombre del modelo por Qwen/Qwen3-8B-FP8 y conserva los mismos flags. Si pip install vllm entra en conflicto con tu máquina por las versiones del controlador y CUDA, la imagen Docker oficial de vLLM es la ruta de instalación más reproducible; la documentación de vLLM explica cómo usarla.
La primera ejecución descarga el modelo y después inicia el servidor en http://localhost:8000. Los dos flags de herramientas son más importantes de lo que parecen: --enable-auto-tool-choice junto con un parser de llamadas a herramientas permite que vLLM convierta la salida del modelo en las llamadas limpias y estructuradas que viste en el Concepto 6. Si los omites, los agentes de programación fallarán en silencio, porque el servidor nunca producirá una llamada que el arnés pueda ejecutar. El nombre correcto del parser varía según la familia de modelos. hermes es el estándar para los modelos Qwen3. Consulta la documentación de llamadas a herramientas de vLLM cuando ofrezcas cualquier otro modelo.
Demuestra que está activo con una solicitud:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "Qwen/Qwen3-8B", "messages": [{"role": "user", "content": "Say hello in one line."}]}'
Observa lo que acabas de escribir: localhost, el puerto 8000 y /v1/chat/completions. Tiene la misma forma de dirección que has usado durante todo el curso. El cerebro no cambió. La cocina detrás de la dirección sí.
El Concepto 9 está completo cuando: vLLM ofrece Qwen3 8B en tu máquina y respondió a una solicitud curl; además, puedes explicar en una frase qué aportan el procesamiento continuo por lotes y la memoria paginada.
10. La revelación: las mismas 50 solicitudes, dos curvas
Todo está listo. La misma máquina. El mismo cerebro. El mismo script. Las mismas 50 solicitudes. Solo cambia la capa de servicio. Ejecuta el barrido idéntico contra vLLM:
python bench.py http://localhost:8000/v1 Qwen/Qwen3-8B 1
python bench.py http://localhost:8000/v1 Qwen/Qwen3-8B 5
python bench.py http://localhost:8000/v1 Qwen/Qwen3-8B 10
python bench.py http://localhost:8000/v1 Qwen/Qwen3-8B 25
python bench.py http://localhost:8000/v1 Qwen/Qwen3-8B 50
Observa en especial el lote con concurrencia 50. El tiempo de reloj que se alargó durante muchos minutos con Ollama debería desplomarse: el lote de 50 solicitudes suele completarse mucho antes que con la configuración fija de Ollama, con respuestas que llegan casi juntas en lugar de hacerlo por turnos.
Ahora dibuja la imagen, porque es lo único que debes llevarte de la Parte 2. Introduce tus 10 números medidos en este script, ejecuta pip install matplotlib si hace falta, y después ejecútalo:
# plot.py: tokens per second against concurrency, one line per serving layer.
import matplotlib.pyplot as plt

concurrency = [1, 5, 10, 25, 50]
ollama_tps = [0, 0, 0, 0, 0]   # your five Ollama numbers from Concept 8
vllm_tps = [0, 0, 0, 0, 0]     # your five vLLM numbers from this concept

plt.plot(concurrency, ollama_tps, marker="o", label="Ollama (qwen3:8b)")
plt.plot(concurrency, vllm_tps, marker="o", label="vLLM (Qwen/Qwen3-8B)")
plt.xlabel("Concurrent requests")
plt.ylabel("Total throughput (tokens/sec)")
plt.title("Same model, same machine, two serving layers")
plt.legend()
plt.savefig("two-curves.png", dpi=200)
Obtendrás dos curvas. La línea de Ollama debería mantenerse más o menos plana: añadir usuarios no aumenta el rendimiento, sino que alarga la cola, por lo que la porción de cada usuario disminuye. La línea de vLLM debería subir: cada usuario nuevo aumenta el rendimiento, mucho al principio y después con una curva a medida que la tarjeta gráfica se acerca a su capacidad real. Tus números exactos dependen de la tarjeta, las versiones y la configuración, y no coincidirán con los de otras personas. Las formas sí suelen coincidir y son la lección. Un hábito convierte la ejecución en evidencia, no en anécdota: anota la tarjeta, el controlador y las versiones de Ollama y vLLM junto a los números. Así, un resultado distinto en otro hardware será un hallazgo, no un misterio.
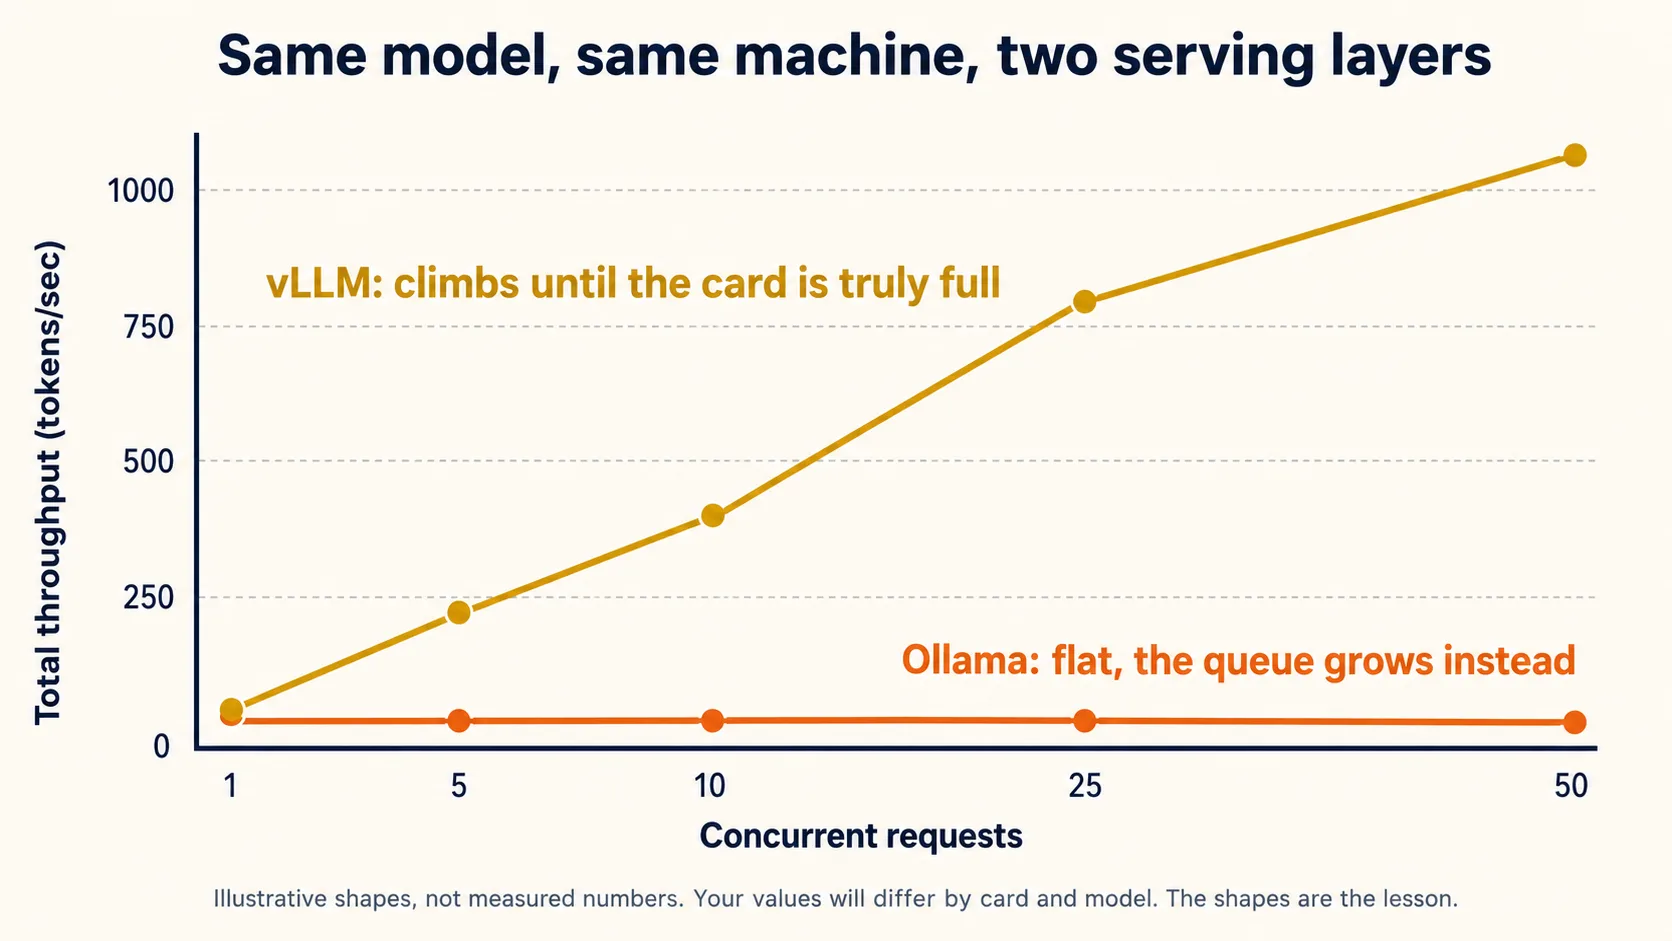
La imagen anterior muestra las formas esperadas, no mediciones reales. El gráfico que cuenta es el tuyo, creado con tus 10 números.
Ahora expresa con precisión qué representa la distancia entre las curvas. No es el hardware: la tarjeta es la misma. No es el script: las solicitudes son iguales. Tampoco es el cerebro en ningún aspecto importante: es la misma familia de modelos, con solo la diferencia de precisión señalada en el Concepto 9, otra variable que acompaña a los números. La diferencia pertenece en su gran mayoría a la capa de servicio. Mantuviste todo lo demás tan fijo como permite la práctica, cambiaste una cosa y el efecto medido es enorme. Esa es la afirmación honesta y es más que suficiente.
Un amigo ve el gráfico y dice: «Entonces vLLM hace que el modelo sea más rápido. También deberías usarlo en tu portátil». ¿Qué parte es correcta y cuál es incorrecta? Ambas partes están equivocadas, aunque de forma instructiva. vLLM no hace que el modelo sea más rápido para un usuario: con concurrencia 1, las dos curvas suelen comenzar cerca porque una sola solicitud no puede aprovechar las técnicas que mantienen llena la tarjeta. vLLM hace que la máquina sea más rápida bajo carga al atender muchas solicitudes a la vez. Tampoco ayudará a un portátil común, porque el procesamiento continuo por lotes necesita una tarjeta gráfica donde formar esos lotes. vLLM destaca justo donde Ollama nunca estuvo diseñado para llegar: una máquina potente, muchos usuarios.Mostrar la respuesta
El Concepto 10 está completo cuando: existe tu gráfico, con una curva plana y otra ascendente, y puedes explicar en una frase por qué la diferencia pertenece sobre todo a la capa de servicio.
11. Conecta tus agentes de programación al servidor
Un servidor rápido solo resulta interesante si tus herramientas pueden usarlo. Repite la acción de la Parte 1 con la tercera dirección del curso: apunta Claude Code y OpenCode hacia vLLM.
Esta es la parte que ya debería parecer casi sospechosa: las conexiones son iguales. vLLM admite los dos formatos de solicitud que usan tus agentes. Tiene la dirección de estilo OpenAI que necesita OpenCode y también implementa de forma nativa el formato Anthropic Messages que habla Claude Code, por lo que no hay ningún traductor en medio.
- Claude Code
- OpenCode
Las mismas tres configuraciones de la Parte 1, un puerto nuevo y una adición: indicas a Claude Code que cada nivel de modelo corresponde al modelo que estás ofreciendo.
export ANTHROPIC_BASE_URL=http://localhost:8000      # bare address again, no /v1
export ANTHROPIC_AUTH_TOKEN=dummy
export ANTHROPIC_API_KEY=dummy
export ANTHROPIC_DEFAULT_OPUS_MODEL=Qwen/Qwen3-8B
export ANTHROPIC_DEFAULT_SONNET_MODEL=Qwen/Qwen3-8B
export ANTHROPIC_DEFAULT_HAIKU_MODEL=Qwen/Qwen3-8B
claude
Las líneas de niveles existen porque Claude Code suele cambiar por nombre entre los modelos grandes y pequeños de Anthropic. Si asignas los tres niveles al modelo que ofreces, obtendrá Qwen3 8B sin importar cuál solicite. Estas variables proceden de la propia guía de Claude Code de vLLM, la fuente vigente que debes consultar cuando cambien.
Copia el opencode.json de la Parte 1 y cambia dos cadenas: el puerto y el nombre del modelo.
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "vllm": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "vLLM (server)",
      "options": { "baseURL": "http://localhost:8000/v1" },
      "models": { "Qwen/Qwen3-8B": { "name": "Qwen3 8B (vLLM)" } }
    }
  },
  "model": "vllm/Qwen/Qwen3-8B"
}
Observa que /v1 se conserva: OpenCode sigue hablando al estilo OpenAI y vLLM le responde. El contraste entre la dirección desnuda y /v1 de la Parte 1 se trasladó sin ningún cambio.
Después, ejecuta exactamente la tarea del Concepto 4 en tu carpeta desechable:
Examina esta carpeta. Encuentra una mejora pequeña y segura, realiza el cambio y muéstrame qué modificaste.
Si tu portátil avanzó con lentitud o falló en la Parte 1, esta ejecución es la recompensa. El mismo modelo y la misma tarea, pero con una tarjeta gráfica real detrás de una capa de servicio creada para trabajar: la barrera de rendimiento del Concepto 5 desapareció y las llamadas a herramientas fluyen porque iniciaste vLLM con los flags del parser de herramientas.
Una advertencia honesta sobre compartir. En cuanto tu máquina vLLM atienda a alguien además de ti, localhost se convertirá en la dirección real de la máquina y un servidor de modelos abierto en internet será una puerta abierta. Como mínimo, inicia vLLM con --api-key configurado con un secreto real, entrega esa clave a los usuarios y mantén la máquina detrás de las protecciones habituales de tu red. La documentación de vLLM explica cómo ofrecer el servicio de forma segura. Léela antes de que una clase lo use.
El Concepto 11 está completo cuando: al menos un agente de programación terminó una tarea real mediante tu servidor vLLM y puedes nombrar lo único que cambió desde la Parte 1, la dirección, y lo que no cambió, todo lo demás.
12. Cuándo vale la pena usar el nivel de servidor
Ahora tienes ambas curvas medidas, así que esta decisión puede ser honesta en lugar de seguir una moda.
El nivel de servidor gana cuando una máquina potente puede alimentar muchas bocas:
- Un equipo o una clase. Cincuenta estudiantes en 50 portátiles chocan con las dos barreras de la Parte 1. Si los 50 apuntan a una máquina vLLM, comparten una sola barrera ya superada. Así, un laboratorio, una empresa o una clase de PIAIC proporciona a todos un agente capaz por el precio de una GPU.
- Bucles que se ejecutan todo el día. Los agentes de Ingeniería de bucles que construirás más adelante enviarán solicitudes cada pocos minutos, sin detenerse. En una factura por token, el total crece para siempre. En tu propia GPU, cuando ya está ocupada, una solicitud adicional casi no cuesta nada; la curva ascendente muestra exactamente por qué: el rendimiento aumenta con la carga, de modo que una máquina ocupada es económica por token.
- Privacidad a escala de equipo. Es el argumento de privacidad de la Parte 1 aplicado a toda una organización: los datos permanecen en una máquina que controlas y todos reciben servicio.
Este es el límite honesto y el puente hacia la Parte 3. vLLM movió una barrera: el rendimiento. No hizo nada con la otra. Qwen3 8B detrás de vLLM responde con rapidez a 50 personas y conserva prácticamente la misma inteligencia que tenía en tu portátil, porque debajo sigue siendo el mismo cerebro. Si la tarea resulta demasiado difícil para un modelo 8B, ninguna capa de servicio podrá salvarlo. La barrera de capacidad se supera con un cerebro mayor, y los cerebros abiertos más grandes del mundo no caben en tu máquina alquilada ni en ninguna máquina que puedas llegar a poseer. Para usarlos, vuelve a cambiar la dirección.
Tu bucle de agente que funciona todo el día sigue produciendo respuestas incorrectas en tareas difíciles de refactorización. Un compañero propone pasar de Ollama a vLLM para solucionarlo. ¿Funcionará? No. Las respuestas incorrectas en tareas difíciles pertenecen a la barrera de capacidad, y la capa de servicio no la modifica: vLLM ofrece el mismo cerebro con más rapidez, no un cerebro más inteligente. Pasar a vLLM resuelve las colas y la lentitud, es decir, el rendimiento. Corregir respuestas incorrectas necesita un modelo más potente, precisamente el propósito del nivel de nube de la Parte 3. Es la tabla del Concepto 5, un nivel más arriba.Mostrar la respuesta
El Concepto 12 está completo cuando: puedes nombrar una situación en la que el nivel de servidor supere tanto al portátil como a la nube y explicar cuál de las dos barreras mueve vLLM y cuál no puede mover.
Parte 3: el nivel de nube. Modelos abiertos de frontera que casi nadie puede alojar (OpenRouter)
La capa de servicio de esta parte es el clúster de otra persona, al que se accede mediante OpenRouter. La escala corresponde a modelos tan grandes que «autoalojar» deja de ser una opción real para ti y para casi todas las empresas del planeta.
13. Pesos abiertos que no puedes levantar: Kimi K3 y DeepSeek V4 Pro
La Parte 2 terminó con un límite honesto: la barrera de capacidad se supera con un cerebro mayor. Veamos los cerebros abiertos más grandes que existen ahora y seamos sinceros sobre lo que significa «abierto» a este tamaño.
Al redactar esta página en julio de 2026, el curso usa dos modelos elegidos por motivos distintos:
- Kimi K3, de Moonshot AI, elegido por su rendimiento. Publicado en julio de 2026, es un modelo de 2,8 billones de parámetros con una ventana de contexto de un millón de tokens. Al publicarse se clasificó como el modelo de pesos abiertos más potente hasta entonces en los principales índices de capacidad, cerca de los mejores modelos cerrados. Las clasificaciones cambian cada mes, así que considera esto una instantánea fechada y consulta las tablas actuales antes de repetirlo. Los pesos son realmente abiertos. Puedes descargar cada uno.
- DeepSeek V4 Pro, de DeepSeek, elegido por su relación entre precio y rendimiento. Es un modelo de 1,6 billones de parámetros, con unos 49.000 millones activos por token, la misma ventana de contexto de un millón de tokens y licencia MIT. Su capacidad bruta está un paso por debajo de K3, pero cuesta mucho menos, y ese intercambio es precisamente la razón de incluirlo.
Un detalle conecta los niveles: cuando Moonshot publicó K3, contribuyó directamente a vLLM el código de servicio para su nuevo diseño de atención, de modo que los alojadores de todo el mundo pudieran ejecutarlo. La cocina industrial que aprendiste en la Parte 2 y las cocinas de frontera de esta parte usan, en muchos casos, el mismo software a escalas muy distintas.
Ahora, la aritmética honesta. «Pesos abiertos» significa que tienes permiso para ejecutarlos por tu cuenta, no que puedas hacerlo. Moonshot recomienda ofrecer K3 en configuraciones de 64 o más chips aceleradores que actúan como una sola máquina. DeepSeek V4 Pro es el pequeño y aun así autoalojarlo requiere un clúster de 8 a 16 GPU de centro de datos, hardware que cuesta más que una casa. Las habilidades de la Parte 2 escalan hasta modelos como Qwen3 32B o mezclas de la clase 100B en una máquina multi-GPU alquilada. No escalan hasta aquí y, fuera de equipos de infraestructura serios, casi ninguna habilidad lo hace. Para los modelos abiertos de frontera, todo el mundo alquila.
Entonces, ¿qué aporta «abierto» si alquilas de todos modos? Tres cosas reales. Sin dependencia de un proveedor: ninguna empresa puede retirar el modelo, cambiar su precio en solitario ni modificarlo en silencio, porque cualquiera con un clúster puede ofrecer los mismos pesos y existen competidores. Elección de arrendador: muchas empresas alojan los mismos pesos y compiten en precio y velocidad. Una base para tu futuro: si alguna vez importa de verdad, tú, tu país o tu empresa pueden instalar el hardware. A esta escala, los pesos abiertos significan menos «ejecútalo en casa» y más «nadie es dueño del grifo».
La competencia entre alojadores crea un problema práctico: decenas de empresas de alojamiento, cada una con sus propias cuentas, claves y facturación. OpenRouter lo resuelve como este curso te enseñó a esperar, con una dirección. Debes entender con precisión qué es, porque la tabla de niveles simplifica la realidad. OpenRouter es un gateway, un router que recibe tu solicitud y la reenvía a uno de los alojadores que realmente ofrece el modelo. El alojador opera la capa de servicio, a menudo el propio vLLM. OpenRouter opera la puerta principal: una sola cuenta, una clave de API y una página de facturación para cientos de modelos. Regístrate en openrouter.ai, añade unos pocos dólares de saldo, crea una clave y configura un límite mensual de gasto antes de cualquier otra cosa. Esa clave es un secreto y una cartera dentro de una sola cadena: nunca la pegues en código que vayas a confirmar o compartir.
La Parte 1 consistía en cocinar en casa. La Parte 2, en operar tu propia cocina industrial. La Parte 3 son los grandes restaurantes del mundo: cocinas con 64 estufas y una brigada de cocineros. Nunca construirás una en casa y tampoco hace falta. OpenRouter es la app de entrega que reúne todos esos restaurantes en un menú, con un inicio de sesión y una factura. La app de tu teléfono sigue siendo la misma.
El Concepto 13 está completo cuando: tienes una cuenta de OpenRouter, una clave y un límite de gasto configurado, y puedes explicar en una frase por qué «pesos abiertos» y «puedes autoalojarlo» dejaron de significar lo mismo a esta escala.
14. Utiliza cerebros de frontera desde los mismos dos agentes
Tercer nivel, misma acción. Estás a punto de apuntar los mismos arneses de las Partes 1 y 2 hacia los modelos abiertos más potentes del planeta, y las conexiones resultarán casi vergonzosamente familiares.
- Claude Code
- OpenCode
OpenRouter admite directamente el formato nativo de Claude Code, lo que denomina endpoint compatible con Anthropic. Por tanto, la configuración usa las mismas tres variables de la Parte 1 con una clave real en medio:
export ANTHROPIC_BASE_URL=https://openrouter.ai/api   # bare, one more time: no /v1
export ANTHROPIC_AUTH_TOKEN=sk-or-...                 # your OpenRouter key
export ANTHROPIC_API_KEY=                             # must be empty
claude --model moonshotai/kimi-k3
Una nota de higiene antes de conservar esto en algún lugar. Esa clave es una cartera. Las exportaciones del shell duran una sesión, el lugar más seguro para comenzar. Si trasladas las variables a un archivo de configuración, usa ~/.claude/settings.json dentro de tu carpeta personal, nunca un archivo de configuración del proyecto que se vaya a confirmar. Una clave subida a un repositorio git es una clave cuyo saldo gastarán desconocidos.
Los nombres de modelos en OpenRouter siguen la forma maker/model y la cadena exacta importa: moonshotai/kimi-k3 para Kimi K3 y deepseek/deepseek-v4-pro para DeepSeek V4 Pro. Un carácter incorrecto solo devuelve «model not found», así que copia los slugs desde la página del modelo en openrouter.ai en lugar de escribirlos.
El arnés de Claude Code se construye y prueba con los modelos propios de Anthropic, y OpenRouter solo garantiza compatibilidad completa con Claude Code mediante el proveedor oficial de Anthropic. Kimi K3 y DeepSeek V4 Pro hablan el formato compatible y muchas personas los manejan así con éxito, pero una llamada a herramienta aún puede comportarse de forma extraña por la compatibilidad entre el arnés y el modelo, no por tu configuración. Considera experimental esta combinación. Para seguir una ruta totalmente compatible en este ejercicio, usa la pestaña OpenCode: OpenRouter es un proveedor nativo de OpenCode sin asterisco de compatibilidad. Si quieres conservar Claude Code y suavizar estas asperezas, la comunidad creó una herramienta para ese trabajo: Claude Code Router, que se explica en el Concepto 16.
Dos hábitos que ahorran una tarde:
- Verifica a dónde van tus palabras mediante
/status. Debe mostrar la dirección de OpenRouter en la líneaAnthropic base URLy tu token como credencial activa. Confía en la comprobación, no en la suposición. - Según la documentación actual de Claude Code,
ANTHROPIC_AUTH_TOKENtiene prioridad sobre un inicio de sesión guardado de Anthropic, por lo que uno anterior no debería secuestrar tus solicitudes. Sin embargo, un inicio de sesión obsoleto aún puede activar una advertencia de conflicto de autenticación al arrancar y guías antiguas informan que puede interferir. Si/statusmuestra el endpoint equivocado o una advertencia identifica dos fuentes de credenciales, ejecuta/logoutuna vez, reinicia y vuelve a comprobar.
OpenCode conoce OpenRouter de fábrica, así que esta vez no necesitas escribir un bloque de proveedor. Dentro de OpenCode, ejecuta /connect, elige OpenRouter y pega tu clave; las versiones antiguas usan opencode auth login desde el shell. Muchos modelos de OpenRouter vienen precargados, así que puedes elegir uno mediante /models o fijarlo en opencode.json:
{
  "$schema": "https://opencode.ai/config.json",
  "model": "openrouter/deepseek/deepseek-v4-pro"
}
Sustitúyelo por openrouter/moonshotai/kimi-k3 para manejar el otro modelo. Esa es toda la configuración.
Ahora ejecuta por última vez la tarea del Concepto 4 en la misma carpeta desechable, una vez con cada modelo:
Examina esta carpeta. Encuentra una mejora pequeña y segura, realiza el cambio y muéstrame qué modificaste.
Percibe la diferencia respecto a todas las ejecuciones anteriores. No debería haber cola, lentitud ni llamadas a herramientas defectuosas: los modelos de frontera superan con margen la barrera de capacidad y ahora la barrera de rendimiento está en las 64 estufas de otra persona. Ambas barreras se superan a la vez cambiando una dirección. Si una ejecución aún tropieza, la causa también cambió: investiga la compatibilidad del modelo con tu arnés, el proveedor, el enrutamiento o el prompt, no el hardware local.
Observa también lo que sacrificaste, porque el intercambio es la lección. Por primera vez desde el Concepto 1, tus palabras salieron del equipo y, por primera vez en el curso, los tokens cuestan dinero a medida que fluyen. Después de la tarea, consulta la página de actividad de OpenRouter y observa la solicitud junto con su precio. Privado y gratuito pertenecían a la Parte 1. Esto es potente y se mide.
El agente ahora completa tareas rápidamente mediante OpenRouter. En comparación con el Concepto 1, nombra las dos cosas que sacrificaste y el hábito que te dice la verdad sobre el destino de tus palabras. Sacrificaste la privacidad, porque las palabras salen de tu equipo y pasan por un proveedor, y la gratuidad, porque cada token se descuenta de tu saldo. El hábito consiste en comprobar, no suponer: Mostrar la respuesta
/status en Claude Code o el selector de modelos en OpenCode muestra exactamente la dirección a la que van tus solicitudes. La regla de la Parte 1 sigue vigente en todos los niveles: confía en la configuración que puedes ver, no en la que recuerdas haber realizado.
El Concepto 14 está completo cuando: K3 y V4 Pro completaron cada uno una tarea de programación real mediante tu agente, /status o el selector de modelos de OpenCode confirma el destino de las solicitudes y viste una solicitud real con un precio real en la página de actividad.
15. Rendimiento o precio: elegir un modelo y un nivel
Acabas de utilizar ambos modelos de frontera. No cuestan lo mismo y elegir entre ellos es tu primera experiencia real con una decisión que tomarás constantemente a partir de ahora.
Al redactar esta página, los precios de lista aproximados son los siguientes: Kimi K3 cuesta 3 USD por millón de tokens de entrada y 15 USD por millón de tokens de salida, mientras que DeepSeek V4 Pro cuesta unos 0,44 USD de entrada y 0,87 USD de salida. Lee despacio esa diferencia: para la salida, la opción de relación precio-rendimiento es aproximadamente 17 veces más barata que la opción de rendimiento. Los precios cambian con rapidez, así que trata estos números como el curso trata cada número de versión: una instantánea para razonar y algo que debes comprobar en las páginas de OpenRouter de los modelos antes de preparar cualquier presupuesto.
Entonces, ¿cuándo vale K3 17 veces más? Cuando la tarea es tan difícil que V4 Pro fracasa y el costo del fallo es tu tiempo. Una ejecución agéntica larga que termina bien supera a cinco ejecuciones baratas cuyos problemas debes desenredar. La regla práctica a la que llegan la mayoría de los equipos es la siguiente: usa de forma predeterminada el modelo con mejor relación precio-rendimiento y escala al modelo de alto rendimiento cuando el barato demuestre ser insuficiente. Deja que los fallos reales, no las impresiones, activen el cambio. Un número modifica por completo este cálculo para los agentes: la entrada almacenada en caché. Un agente vuelve a enviar las mismas instrucciones y el mismo contexto del repositorio en cada turno, y ambos proveedores cobran una fracción mínima del precio de entrada cuando ese prefijo repetido coincide con su caché. En cargas de trabajo con bucles, la factura efectiva suele ser muy inferior al cálculo con precios de lista. Las páginas de precios explican las reglas de caché de cada proveedor. Para trabajar con agentes, lee esa sección primero, no al final.
Ahora aléjate por completo, porque te ganaste la imagen entera. Un arnés, una idea y tres niveles:
| Nivel | Capa de servicio | Cerebro en este curso | La dirección | Quién paga el cómputo | Ventaja principal |
|---|---|---|---|---|---|
| Local | Ollama | Qwen3 8B | tu localhost | ya lo pagaste (portátil) | privacidad, sin conexión, gratis, aprendizaje |
| Servidor | vLLM | Qwen3 8B, versión para servicio | una máquina que controlas | tú, por hora de GPU | muchos usuarios, bucles continuos, datos de equipo |
| Nube | OpenRouter (gateway) | Kimi K3, DeepSeek V4 Pro | openrouter.ai | tú, por token | tareas difíciles, configuración cero, frontera |
Este es el procedimiento de decisión en el orden correcto. Primero, ¿pueden salir los datos? Si no, el nivel de nube queda descartado y debes elegir entre local y servidor según cuántas personas necesiten servicio. Segundo, ¿está la tarea al alcance de un modelo abierto mediano? Si es así, el nivel se decide por economía: portátil para una persona, máquina vLLM para muchas o para bucles. Tercero, si la tarea necesita un cerebro de frontera, usa el nivel de nube y aplica la regla de este concepto: modelo barato de forma predeterminada y modelo caro tras un fallo demostrado. Tres preguntas contienen todas las conversaciones de despliegue que tendrás sobre modelos abiertos.
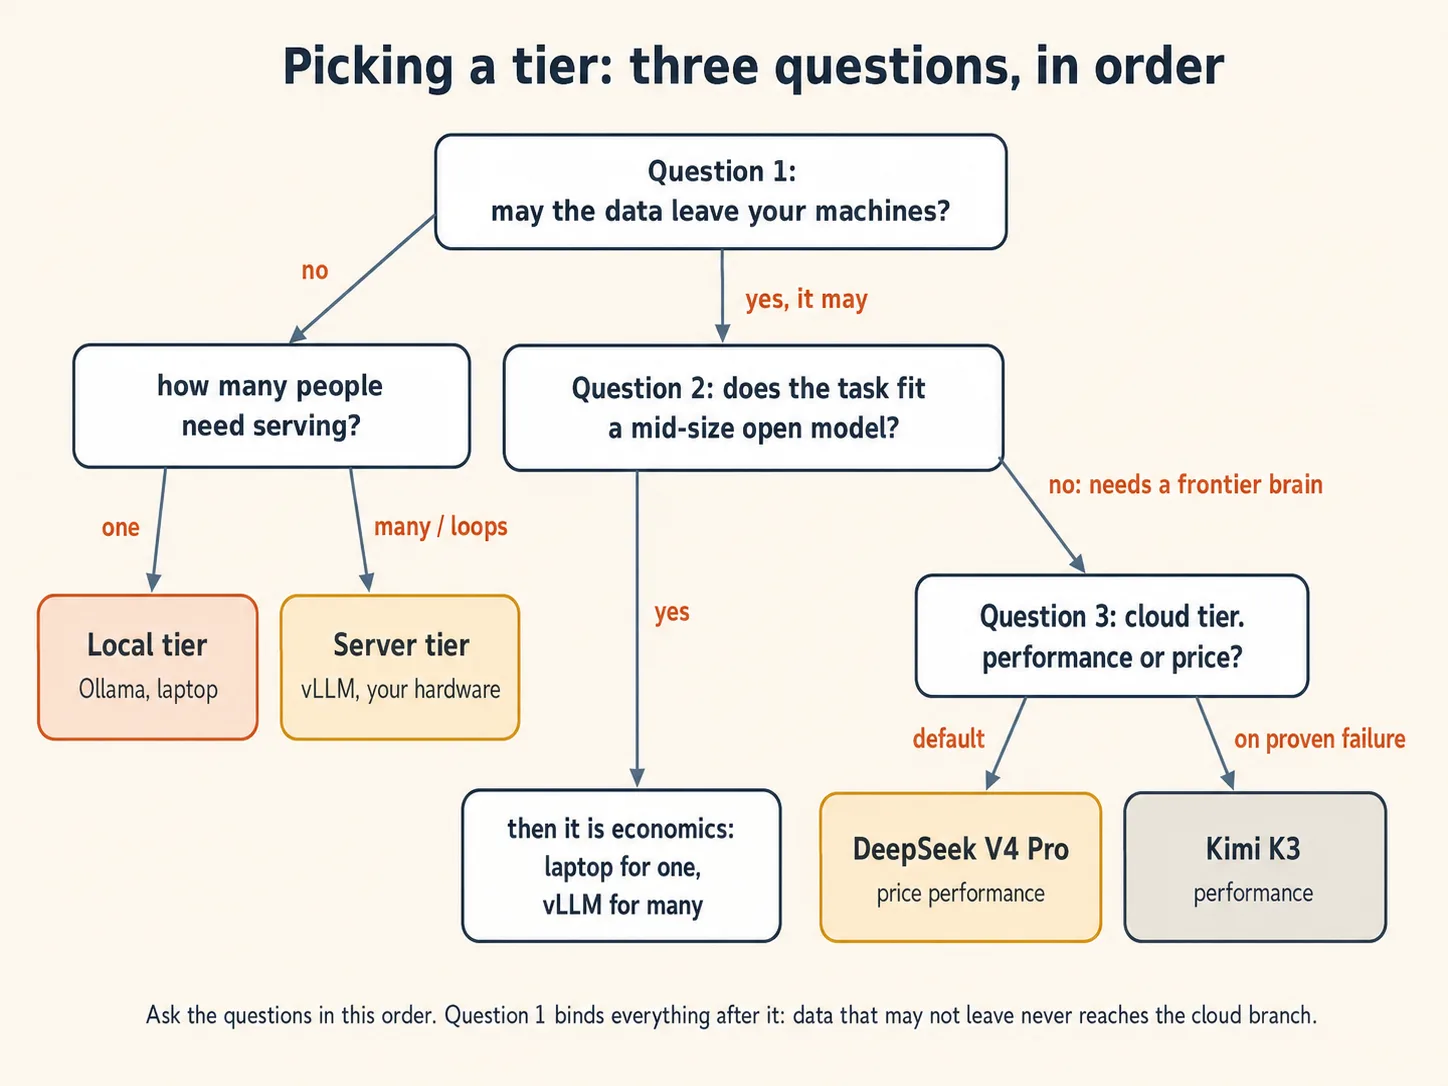
Una empresa quiere un agente que revise contratos confidenciales de clientes todo el día, todos los días. Las tareas son moderadamente difíciles, pero están dentro del alcance de un modelo mediano potente. ¿Qué nivel debe elegir y por qué están equivocados los otros dos? El nivel de servidor. La primera pregunta descarta la nube: los contratos confidenciales no deben salir de las máquinas que controla la empresa. El nivel local falla por dos motivos, la cantidad de personas que debe atender y el tiempo que debe ejecutarse: un bucle continuo para un equipo choca de inmediato con la barrera de rendimiento. Una máquina vLLM dentro de la red de la empresa supera esa barrera, conserva los datos en casa y vuelve económico por token el bucle continuo. Si después las tareas resultan demasiado difíciles para el modelo, la opción real de la empresa será un modelo abierto mayor en una máquina alquilada más grande, no la nube pública, porque la primera pregunta sigue siendo vinculante.Mostrar la respuesta
El Concepto 15 está completo cuando: puedes expresar las tres preguntas en orden y defender la elección de un nivel para una situación cuya respuesta nadie te proporcionó.
16. Un router para los tres niveles: Claude Code Router
Todo este curso se apoyó en una idea: el cerebro es solo una dirección. Existe un último paso natural y una herramienta popular de la comunidad lo da. ¿Qué ocurriría si la dirección no apuntara a un cerebro, sino a una decisión?
Claude Code Router (CCR) es una herramienta de código abierto de musistudio y uno de los proyectos con más estrellas del ecosistema de Claude Code. Ejecuta un pequeño servidor en tu equipo que habla el formato nativo de Claude Code por un lado y con muchos proveedores por el otro, traduciendo entre ambos. Apuntas Claude Code hacia él una vez y un archivo de configuración decide, solicitud por solicitud, qué cerebro responde. Tres motivos justifican conocerlo al final del curso:
- Enruta por tipo de tarea. Su bloque
Routerasigna distintos tipos de trabajo de Claude Code a diferentes modelos:defaultpara trabajo ordinario,backgroundpara tareas de mantenimiento económicas,thinkpara razonamiento difícil ylongContextpara solicitudes que superan un umbral de tokens. Vuelve a leer despacio esa lista. Es la regla del Concepto 15, usar de forma predeterminada el modelo con mejor relación precio-rendimiento y escalar en los casos difíciles, escrita como configuración en lugar de disciplina. - Abarca todos los niveles que acabas de aprender. Un proveedor en su configuración es solo un nombre, una dirección y una lista de modelos. Por eso, un archivo puede contener juntos tu portátil con Ollama, tu servidor vLLM y OpenRouter, y enrutar entre ellos.
- Suaviza las asperezas. Sus transformers (
openrouter,tooluse,enhancetooly otros) adaptan solicitudes y respuestas por proveedor, incluso añaden tolerancia a errores para las llamadas a herramientas de modelos que usan formatos poco estrictos. Es la respuesta práctica de la comunidad a la advertencia de compatibilidad del Concepto 14.
Configúralo en tres pasos. Instálalo junto a Claude Code:
npm install -g @musistudio/claude-code-router
Después crea ~/.claude-code-router/config.json. La siguiente configuración contiene todo el curso, con los tres niveles detrás de una dirección:
{
  "OPENROUTER_API_KEY": "$OPENROUTER_API_KEY",
  "Providers": [
    {
      "name": "ollama",
      "api_base_url": "http://localhost:11434/v1/chat/completions",
      "api_key": "ollama",
      "models": ["qwen3:8b"]
    },
    {
      "name": "vllm",
      "api_base_url": "http://localhost:8000/v1/chat/completions",
      "api_key": "dummy",
      "models": ["Qwen/Qwen3-8B"]
    },
    {
      "name": "openrouter",
      "api_base_url": "https://openrouter.ai/api/v1/chat/completions",
      "api_key": "$OPENROUTER_API_KEY",
      "models": ["deepseek/deepseek-v4-pro", "moonshotai/kimi-k3"],
      "transformer": { "use": ["openrouter"] }
    }
  ],
  "Router": {
    "default": "openrouter,deepseek/deepseek-v4-pro",
    "background": "ollama,qwen3:8b",
    "think": "openrouter,moonshotai/kimi-k3",
    "longContext": "openrouter,moonshotai/kimi-k3",
    "longContextThreshold": 60000
  }
}
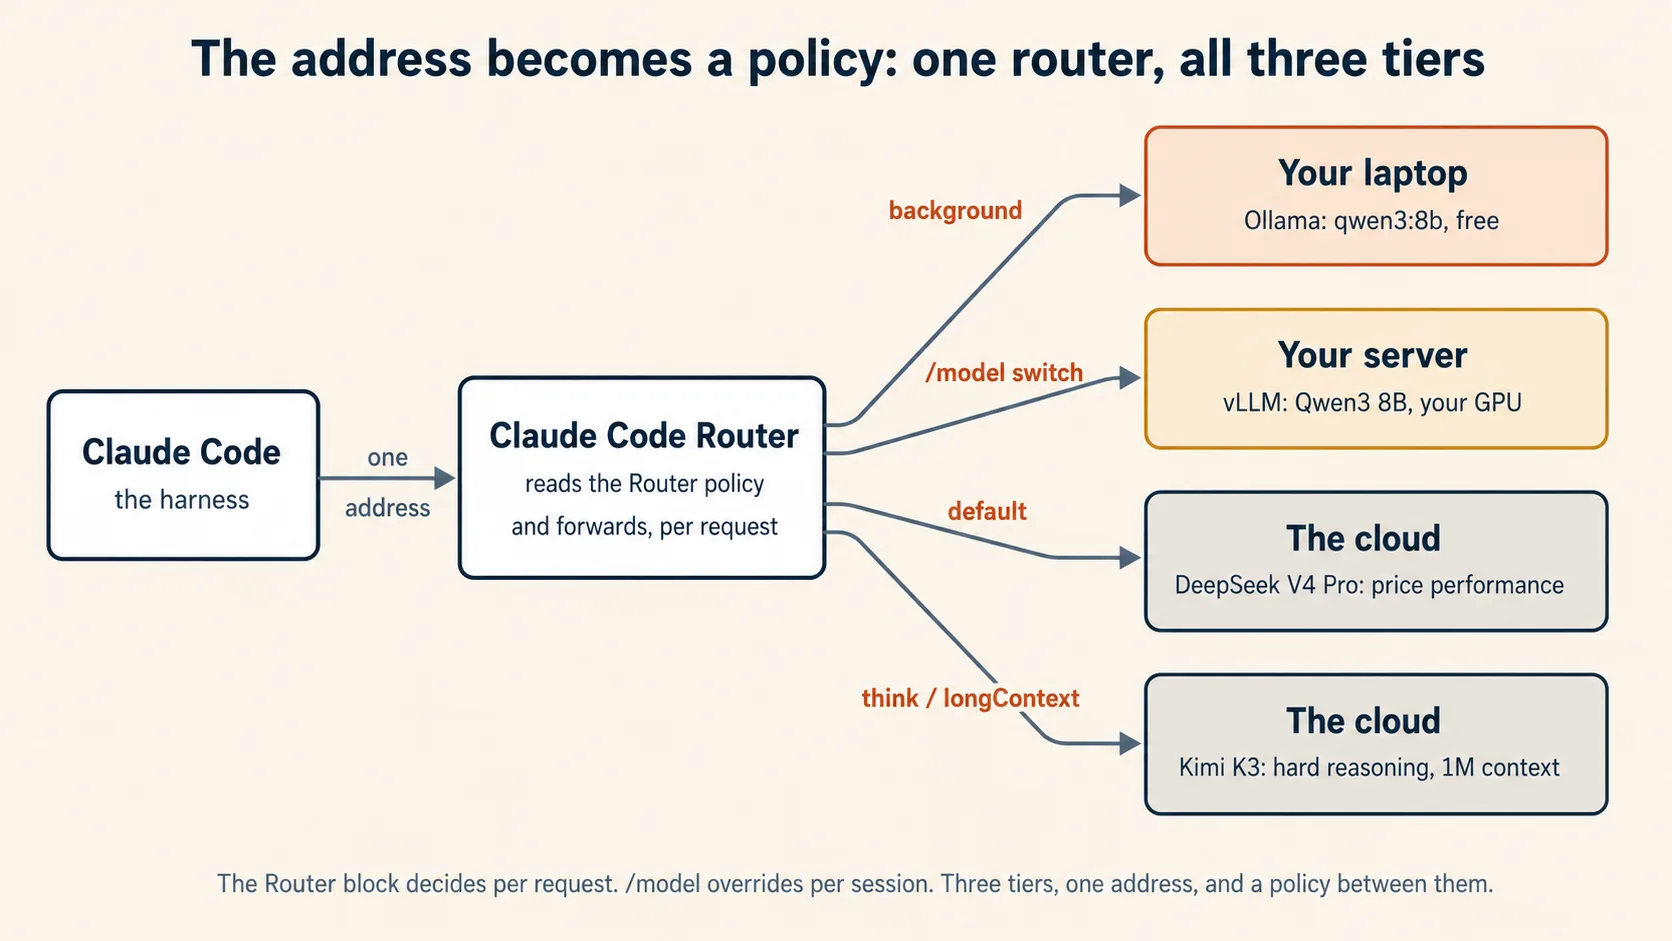
Lee el bloque Router como una política, porque eso es. El trabajo ordinario va al modelo de frontera con mejor relación precio-rendimiento. Las tareas económicas en segundo plano permanecen gratuitas en tu portátil. El razonamiento difícil y los contextos enormes escalan a Kimi K3, cuya ventana de un millón de tokens merece el espacio longContext. La sintaxis $OPENROUTER_API_KEY obtiene la clave del entorno, de modo que el secreto nunca queda en el archivo.
Después inicia Claude Code mediante el router:
ccr code
Algunos detalles mecánicos que ahorran tiempo: después de editar la configuración, ejecuta ccr restart para aplicar los cambios. Dentro de Claude Code, cambia de cerebro durante una sesión mediante /model provider,model, por ejemplo /model ollama,qwen3:8b. Si prefieres editar la configuración en una página web en lugar de JSON, ccr ui la abre.
Dos notas honestas para cerrar. En primer lugar, CCR es un proyecto comunitario, no un producto de Anthropic ni de ningún proveedor. Cambia con rapidez, sus transformers son soluciones prácticas y no garantías, y ahora cada solicitud atraviesa otra pieza de software que debes actualizar y cuyas notas de versión debes leer. En segundo lugar, no lo añadas donde no sea necesario. El servidor vLLM de la Parte 2 ya admite de forma nativa el formato de Claude Code, así que colocar un router solo delante de él no aporta nada. CCR merece su lugar cuando quieres que un Claude Code apunte a muchos cerebros a la vez y enrute según la tarea. Después de este curso, esa es exactamente la configuración sobre la que sabes razonar: tres niveles, una dirección y ahora una política que decide entre ellos.
El Concepto 16 está completo cuando: Claude Code funciona mediante el router, al menos dos niveles responden desde una sesión, para lo que puedes cambiar mediante /model provider,model y observar de dónde proviene cada respuesta, y puedes interpretar tu propio bloque Router como la política de niveles que codifica.
Pruébalo hoy a tu escala y después continúa
Completa hoy la versión real más pequeña. Instala Ollama, ejecuta un modelo y conversa con él: solo eso te proporciona una IA privada en tu equipo en dos minutos. Si escribes código, conéctale un agente de programación y siente con qué barrera chocas. Cuando puedas alquilar una GPU durante una tarde, ejecuta el experimento de 50 solicitudes y dibuja tus propias dos curvas; pocos ejercicios de este libro enseñan más por hora. Cuando una tarea derrote a todos los cerebros que puedes alojar, cambia la dirección por última vez y toma prestado un cerebro de frontera por unos centavos o dólares. Cuando otras personas necesiten lo que construiste, el Apéndice A convertirá tu servidor en un servicio que pueden compartir.
Lleva contigo el modelo mental, porque la sección se construye sobre él en orden. Tu herramienta es un arnés más un cerebro intercambiable y el cerebro es solo una dirección. La dirección puede apuntar a tu portátil, a tu servidor o a los modelos abiertos más grandes del mundo, y el arnés nunca conoce la diferencia. Dos barreras deciden qué puede hacer una configuración: la capa de servicio y el hardware mueven el rendimiento; solo un cerebro mayor mueve la capacidad. Después aprenderás a manejar bien este agente en Programación agéntica, dirigirlo con una especificación escrita en Desarrollo guiado por especificaciones y entregarle un bucle que funcione todo el día sin ti en Ingeniería de bucles. Al llegar a ese último curso, sabrás exactamente de quién debe ser el cerebro que ejecute el bucle, en qué nivel y cuánto cuesta mantenerlo en funcionamiento.
Resumen en una línea
Los modelos de código abierto se ejecutan en tres escalas y tu herramienta accede a todas de la misma forma: mediante una dirección. Ollama para una persona, vLLM para muchas y OpenRouter para los cerebros de frontera que casi nadie puede autoalojar. Mide una vez la diferencia con tus propias dos curvas y elegirás el nivel correcto durante el resto de tu carrera.
Apéndice A: construir una nube LLM pequeña
La Parte 2 te proporcionó una cocina industrial. Una cocina no es un restaurante. Este apéndice añade la puerta principal, el menú, los números de mesa y la factura para que una máquina que atiende bien a una persona pueda servir de forma segura a toda una clase.
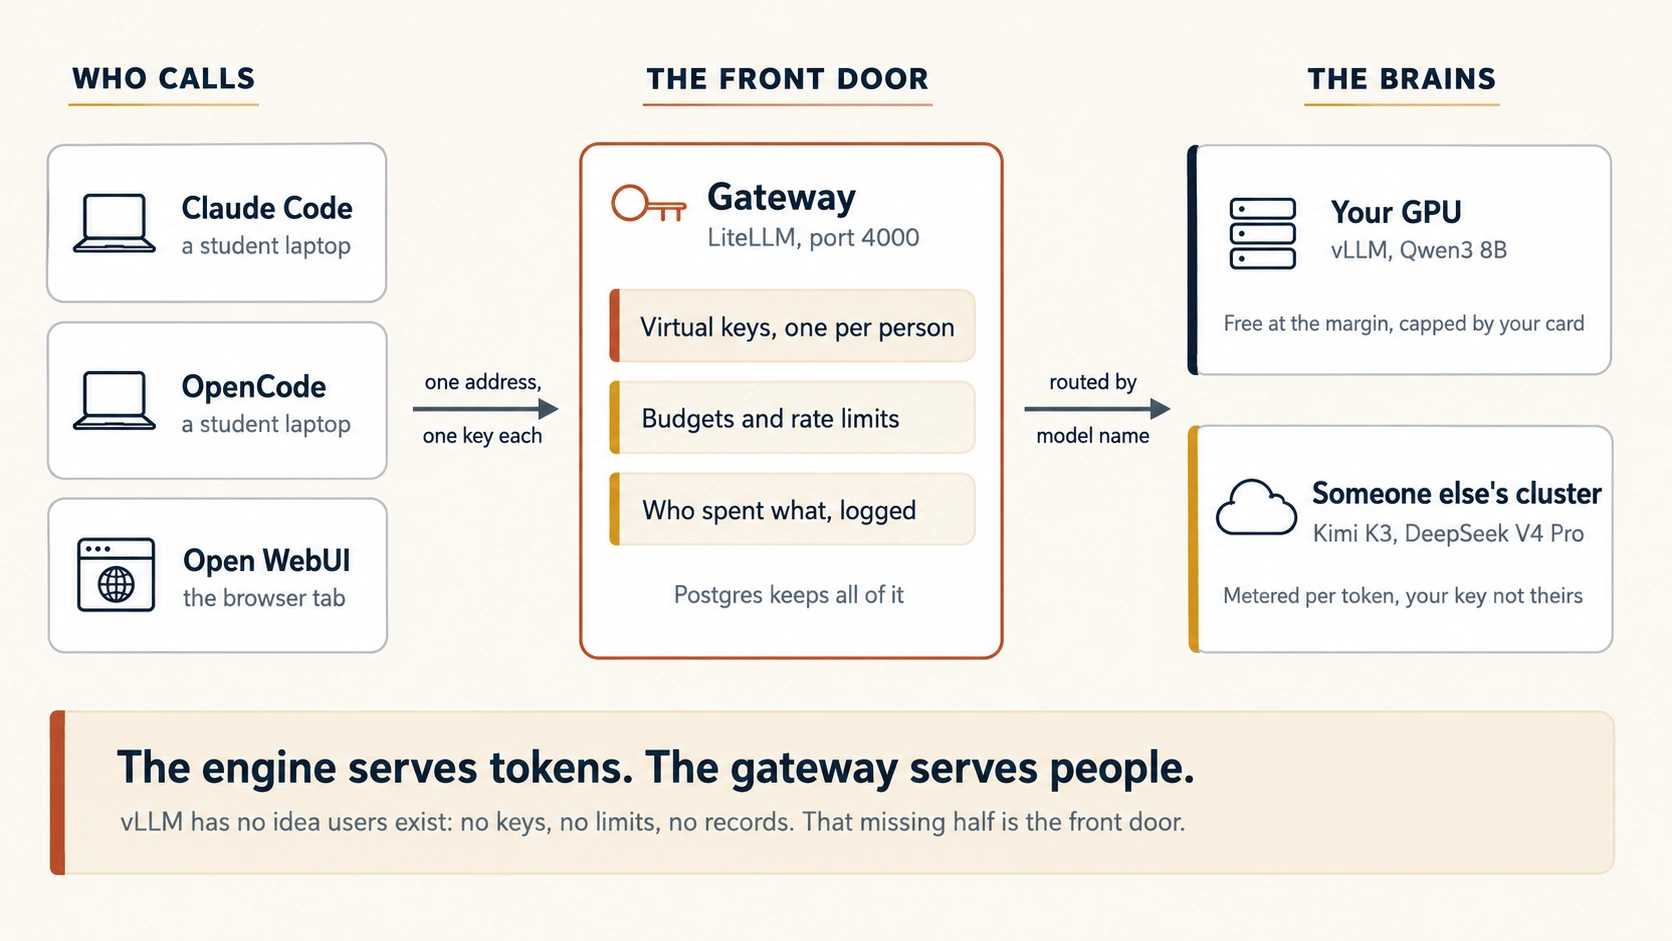
Esta es la brecha que cierra el apéndice. Al final de la Parte 2, vLLM ofrecía Qwen3 8B y tu curva de 50 solicitudes ascendía donde la de Ollama permanecía plana. Es un logro real, pero todavía no constituye un servicio. Intenta entregarlo a una clase y las preguntas aparecerán de inmediato. ¿Quién tiene permiso para usarlo? ¿Qué impide que el bucle descontrolado de un estudiante consuma la máquina durante una semana? ¿Quién gastó qué? ¿Cómo accede un estudiante a un cerebro de frontera cuando Qwen3 8B no basta, sin que tengas que entregar tu propia clave de OpenRouter a 200 personas?
Ninguna de esas preguntas trata sobre servir tokens y esa es precisamente la razón por la que vLLM no las responde. Un motor de inferencia carga un modelo y responde solicitudes. No sabe que existen usuarios. No tiene claves, cuotas, registros de gasto ni forma de negarse. Esa mitad ausente tiene un nombre y construirla es el tema del apéndice.
La idea central del curso llega hasta aquí. El cerebro es solo una dirección. En la Parte 1, la dirección era tu portátil. En la Parte 2, una máquina bajo tu control. En la Parte 3, el clúster de otra persona. En este apéndice, tú te conviertes en la dirección: construyes aquello a lo que otras personas apuntan sus agentes.
Todo lo necesario para la Parte 2, además de Docker y Docker Compose en la misma máquina GPU. Si completaste la Parte 3, ten a mano la clave de OpenRouter para el Concepto A5. Puedes leer todo el apéndice sin ejecutar nada, y vale la pena estudiar los Conceptos A1, A2 y A7 aunque nunca construyas la pila.
Dos programas, no uno. vLLM sirve los tokens. Un gateway se sitúa delante y gestiona todo lo que vLLM no hace: claves de usuario, límites de gasto, enrutamiento de modelos y registros. El gateway utilizado aquí es LiteLLM. Añade Postgres para que las claves y el gasto sobrevivan a un reinicio, y Open WebUI para que quienes no usan una terminal también puedan acceder a tu nube. Cuatro contenedores, un archivo y una tarde.
Palabras nuevas para este apéndice
| Término | Significado sencillo |
|---|---|
| Motor de inferencia | Programa que carga un modelo y responde solicitudes. vLLM es uno. Conoce los tokens, no a las personas. |
| Gateway / proxy | Programa delante del motor. Conoce a las personas: quién llama, qué puede usar y cuánto cuesta. |
| Clave virtual | Clave de API individual que emite y puede revocar tu gateway, con sus propios límites asociados. |
| Presupuesto | Tope de gasto para una clave. Cuando se agota, el gateway rechaza la solicitud en lugar de permitir que aumente la factura. |
| Límite de frecuencia | Tope de solicitudes por minuto para que un usuario activo no desplace a todos los demás. |
| Multiinquilinato | Atender a muchos usuarios separados desde hardware compartido sin que se afecten entre sí. |
| Fallback | Regla que dice «si este modelo falla o está lleno, prueba aquel otro». |
A1. Una cocina no es un restaurante
Lleva un paso más lejos la metáfora que el curso usa desde el Concepto 8. Ollama era una cocina doméstica con dos estufas. vLLM era una cocina industrial que mantiene todas las estufas encendidas. Ambas son la parte trasera del establecimiento.
Un restaurante también necesita una parte delantera. Alguien en la puerta que sepa si tienes reserva. Un menú que indique qué está disponible hoy. Un número de mesa para que la cocina sepa a dónde va cada plato. Una factura al final. Nada de eso es cocinar y una cocina brillante sin atención al público no es un restaurante. Es una cocina por la que deambulan desconocidos.
Ese es exactamente el estado de un servidor vLLM desnudo. Cualquiera que pueda acceder al puerto puede usarlo gratis y para siempre. Esto es lo que no hace; conviene leerlo despacio porque, de otro modo, tendrías que construir por tu cuenta cada elemento:
| Lo que necesitas | ¿Lo hace vLLM? |
|---|---|
| Servir tokens rápido a muchos usuarios | Sí. Es todo su trabajo y lo hace muy bien. |
| Saber quién llama | No. |
| Bloquear a alguien al alcanzar un gasto | No. |
| Impedir que un usuario desplace a los demás | En parte, mediante colas, pero no por usuario. |
| Ofrecer más de un modelo en una dirección | No. Un servidor, un modelo. |
| Usar otro modelo si este falla | No. |
| Registrar quién gastó qué | No. |
| Acceder a la nube si falla el modelo local | No. |
Cada «no» de esa tabla es trabajo del gateway.
La cocina prepara la comida. La parte delantera decide quién come, qué hay en el menú y quién paga. Construiste una cocina muy buena. Ahora necesitas una puerta.
Una pregunta razonable: ¿existe un solo programa que haga ambas cosas? Casi, y la respuesta honesta importa. El servicio es un problema de infraestructura que el mundo del código abierto resolvió muy bien. La medición, las cuotas y la facturación son un problema de producto, y es lo que realmente venden las empresas de inferencia. Por eso, las herramientas abiertas proporcionan el motor y el medidor como piezas separadas que tú ensamblas. La ventaja es que cada capa habla el mismo formato de solicitud compatible con OpenAI que has usado desde la Parte 1, así que ensamblarlas requiere configuración, no trabajo de traducción.
El Concepto A1 está completo cuando: puedes nombrar tres cosas que un servidor vLLM desnudo no puede hacer y que una clase de 50 estudiantes necesitaría el primer día.
A2. El gateway: una dirección, muchos cerebros y usuarios reales
Un gateway es un programa pequeño situado delante de uno o más servidores de modelos. Las solicitudes llegan al gateway, este decide qué hacer con ellas y después las reenvía. Es la puerta principal.
Ya utilizaste uno. OpenRouter, en la Parte 3, es un gateway: una dirección, una clave, una factura y cientos de modelos detrás, cuyo servicio real ejecutan alojadores con los que nunca contactas directamente. Este apéndice construye la misma estructura a tu escala, en tu propia máquina y contigo como operador en lugar de una empresa.
La herramienta para este trabajo es LiteLLM, un proxy de código abierto que presenta a tus usuarios el formato compatible con OpenAI y traduce hacia una larga lista de proveedores, entre ellos tu propio servidor vLLM. Cuatro características la convierten en la pieza adecuada:
- Claves virtuales. Entregas a cada estudiante una clave propia. Puedes asociarle límites, ver cuánto gastó y revocarla en cuanto termine el semestre o se pierda un portátil.
- Presupuestos y límites de frecuencia. Una clave puede llevar un tope de gasto y un límite por minuto. Cuando un bucle descontrolado alcanza el tope, el gateway rechaza la siguiente solicitud. Tu factura deja de crecer en un número que elegiste de antemano.
- Un menú de modelos en una dirección. Tu Qwen3 8B local y un modelo de frontera en la nube pueden aparecer en el mismo gateway, accesibles para los mismos estudiantes con la misma clave.
- Registros. Cada solicitud se registra contra un usuario, así que «quién gastó qué» se convierte en una consulta, no en una investigación.
Observa la estructura. El gateway no acelera nada. No cambia los tokens por segundo y añade unos pocos milisegundos propios. No es una herramienta de rendimiento. Es una herramienta de control, y el control es lo que convierte un servidor en un servicio.
Un estudiante dice que el gateway no sirve porque «vLLM ya me da una dirección compatible con OpenAI, así que puedo usarla directamente». ¿Cuál es la respuesta más sólida? Tiene razón sobre la dirección y se equivoca sobre el servicio. La dirección de vLLM funciona bien para una persona de confianza, y por eso el Concepto 11 pudo terminar allí. El gateway existe para todo lo que aparece cuando hay muchas personas: claves separadas, topes de gasto, límites de frecuencia, un menú con más de un modelo, fallbacks y un registro de quién usó qué. Ninguna es una función de velocidad, por lo que la comparación parece vacía hasta el día en que un bucle descontrolado funciona todo el fin de semana y nadie puede identificar a su propietario.Mostrar la respuesta
El Concepto A2 está completo cuando: puedes explicar en una frase qué añade un gateway que nunca añadirá un motor de inferencia y por qué no es una función de velocidad.
A3. Ponlo en marcha: toda la pila en un archivo
Cuatro contenedores. Una máquina. Un archivo.
| Contenedor | Trabajo |
|---|---|
| vllm | Ofrece Qwen3 8B en tu GPU. El mismo servidor del Concepto 9, ahora con una puerta delante. |
| litellm | El gateway. Lo único que tocarán tus usuarios. |
| postgres | Almacena claves, usuarios, presupuestos y gasto para que un reinicio no borre tu clase. |
| open-webui | Página de chat para las personas de la clase que no viven en una terminal. |
Comienza por la configuración del gateway. Guárdala como litellm-config.yaml:
model_list:
  # Your own GPU, from Part 2. Students see the name on the left.
  - model_name: qwen3-8b
    litellm_params:
      model: hosted_vllm/Qwen/Qwen3-8B
      api_base: http://vllm:8000/v1
      api_key: "not-needed"

general_settings:
  master_key: os.environ/LITELLM_MASTER_KEY
  database_url: os.environ/DATABASE_URL

litellm_settings:
  drop_params: true
Vale la pena nombrar dos detalles. model_name es el nombre que escriben tus usuarios y no tiene que coincidir con el nombre real del modelo situado debajo. Esa indirección permite cambiar el cerebro más tarde sin avisar a nadie. Además, master_key es tu contraseña administrativa para toda la nube. No es una clave de estudiante. Nunca sale de tu máquina.
Ahora, la pila. Guarda lo siguiente como docker-compose.yml:
services:
  vllm:
    image: vllm/vllm-openai:latest
    command: >
      --model Qwen/Qwen3-8B
      --enable-auto-tool-choice
      --tool-call-parser hermes
      --reasoning-parser qwen3
    volumes:
      - ./hf-cache:/root/.cache/huggingface
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: all
              capabilities: [gpu]

  postgres:
    image: postgres:16
    environment:
      POSTGRES_DB: litellm
      POSTGRES_USER: litellm
      POSTGRES_PASSWORD: ${POSTGRES_PASSWORD}
    volumes:
      - ./pgdata:/var/lib/postgresql/data

  litellm:
    # Pin the version. Read the security note below before you change this.
    image: ghcr.io/berriai/litellm:main-v1.80.5
    depends_on: [vllm, postgres]
    ports:
      - "4000:4000"
    environment:
      LITELLM_MASTER_KEY: ${LITELLM_MASTER_KEY}
      DATABASE_URL: postgresql://litellm:${POSTGRES_PASSWORD}@postgres:5432/litellm
    volumes:
      - ./litellm-config.yaml:/app/config.yaml
    command: ["--config", "/app/config.yaml", "--port", "4000"]

  open-webui:
    image: ghcr.io/open-webui/open-webui:main
    depends_on: [litellm]
    ports:
      - "3000:8080"
    environment:
      OPENAI_API_BASE_URL: http://litellm:4000/v1
      OPENAI_API_KEY: ${LITELLM_MASTER_KEY}
    volumes:
      - ./webui-data:/app/backend/data
Coloca tus dos secretos en un archivo .env junto a este, nunca dentro del archivo Compose:
LITELLM_MASTER_KEY=sk-choose-a-long-random-string
POSTGRES_PASSWORD=choose-another-long-random-string
Después inicia la pila y demuestra que funciona:
docker compose up -d

curl http://localhost:4000/v1/chat/completions \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "qwen3-8b", "messages": [{"role": "user", "content": "Say hello in one line."}]}'
Compara esa solicitud con la del Concepto 9. La misma forma, el mismo /v1/chat/completions y una línea nueva: un header Authorization. Ese único header es toda la diferencia entre un servidor y un servicio. Ahora alguien debe indicar quién es.
En marzo de 2026, el paquete LiteLLM sufrió un ataque a la cadena de suministro y se publicaron versiones maliciosas antes de retirarlas. Tu gateway contiene todas las claves y todos los registros de gasto de la nube, lo que lo convierte en el objetivo de mayor valor de la pila. Por tanto, fija una etiqueta de versión exacta, nunca sigas latest, lee las notas de la versión antes de cambiar y no expongas el gateway a internet hasta completar ambas acciones. No es una advertencia exclusiva de LiteLLM. Es lo que implica operar cualquier servicio que contenga credenciales.
Las incompatibilidades del controlador y CUDA son la causa habitual; por eso este archivo Compose usa la imagen oficial en lugar de pip install. También necesitas instalar NVIDIA Container Toolkit en el host, pues de lo contrario la GPU será invisible dentro de Docker. Si tienes una tarjeta de 16 GB, sustituye la línea del modelo por Qwen/Qwen3-8B-FP8, exactamente como en el Concepto 9.
El Concepto A3 está completo cuando: docker compose up -d inicia cuatro contenedores, la solicitud curl mediante el puerto 4000 devuelve una respuesta y la misma solicitud sin el header Authorization es rechazada.
A4. Reparte claves: presupuestos, límites y quién gastó qué
Este concepto convierte la configuración en una nube. Todo lo anterior eran tuberías.
Genera una clave para un estudiante:
curl -X POST http://localhost:4000/key/generate \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "user_id": "student-0417",
    "models": ["qwen3-8b"],
    "max_budget": 2.00,
    "budget_duration": "30d",
    "rpm_limit": 20
  }'
Lee las cuatro configuraciones, porque cada una representa una decisión intencional:
user_idvincula cada solicitud futura y cada dólar registrado con una persona. Sin este dato, el informe de uso sería un único número anónimo.modelses el menú del que puede pedir esta clave. Una clave que solo enumeraqwen3-8bno puede acceder a nada más, sin importar lo que escriba el estudiante.max_budgetjunto conbudget_durationestablece el tope. Dos dólares al mes y después el gateway empieza a rechazar solicitudes. El bucle descontrolado se detiene solo durante la noche sin despertarte.rpm_limitimpide que un estudiante entusiasta llene la cola para todos los demás.
La respuesta contiene una clave que comienza por sk-. Esa cadena es lo único que recibe el estudiante.
Este es el momento para el que existe todo el apéndice. El estudiante usa tu nube exactamente como la Parte 3 usó OpenRouter. Las mismas dos configuraciones y una dirección nueva:
# OpenCode, or anything speaking the OpenAI shape
export OPENAI_BASE_URL="http://your-server:4000/v1"
export OPENAI_API_KEY="sk-the-students-key"
El arnés nunca se entera de que algo cambió. Sigue siendo un arnés más un cerebro y una dirección, solo que ahora la dirección corresponde a una máquina dentro de tu propio edificio.
En el caso concreto de Claude Code, LiteLLM también expone un endpoint con formato Anthropic que te permitiría apuntar ANTHROPIC_BASE_URL directamente al gateway, el mismo movimiento de dirección desnuda que ya realizaste tres veces. Esa superficie cambia más rápido de lo que puede seguir esta página, así que consulta la documentación vigente de LiteLLM antes de depender de ella. Si no funciona con la versión que fijaste, Claude Code Router del Concepto 16 te llevará allí con un salto adicional y tu gateway se convertirá simplemente en otro proveedor de la configuración.
Dos comandos que usarás constantemente cuando la clase esté activa:
# What has this key spent?
curl -X GET "http://localhost:4000/key/info?key=sk-the-students-key" \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY"

# Semester over, or laptop lost.
curl -X POST http://localhost:4000/key/delete \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{"keys": ["sk-the-students-key"]}'
Cada comensal recibe un número de mesa propio con un límite de gasto asociado. La cocina no cambió. Sin embargo, ahora sabes quién está comiendo, puedes impedir que una mesa pida todo el menú y, cuando alguien se marcha, recuperas su mesa.
Emites 200 claves para estudiantes, cada una con un tope de 2 USD al mes, y todas apuntan a tu propia GPU. Un compañero pregunta por qué configuraste presupuestos si el modelo local no cuesta nada por token. ¿Cuál es la respuesta real? Hay dos respuestas y la segunda es la importante. Primero, «gratis» es incorrecto incluso en local: tu GPU tiene un rendimiento fijo, tal como mostró la curva de la Parte 2 cuando se llenó la tarjeta. Por eso, el bucle interminable de un estudiante consume la capacidad de todos los demás aunque no circule dinero. El presupuesto raciona un recurso compartido. Segundo, y aquí se dirige el Concepto A5, en cuanto añades un modelo de nube al menú, pasa dinero real por esas mismas claves. Establecer el hábito de presupuestar mientras es gratuito significa que no tendrás que construirlo con pánico el día que deje de serlo.Mostrar la respuesta
El Concepto A4 está completo cuando: una segunda persona en otra máquina ejecutó una tarea real mediante el gateway con su propia clave, consultaste cuánto gastó y después revocaste la clave.
A5. Coloca los tres niveles detrás de una puerta
Tu nube ofrece ahora un cerebro. Añade al mismo menú los otros dos niveles del curso para que un estudiante elija un nivel cambiando solo el nombre del modelo.
Amplía litellm-config.yaml:
model_list:
  # Tier 2: your own GPU. Free at the margin, capped by your hardware.
  - model_name: qwen3-8b
    litellm_params:
      model: hosted_vllm/Qwen/Qwen3-8B
      api_base: http://vllm:8000/v1
      api_key: "not-needed"

  # Tier 3: a frontier brain, rented. Your key, never theirs.
  - model_name: frontier
    litellm_params:
      model: openrouter/moonshotai/kimi-k3
      api_key: os.environ/OPENROUTER_API_KEY

  # Tier 3, the cheap end. The right default for high-volume work.
  - model_name: frontier-cheap
    litellm_params:
      model: openrouter/deepseek/deepseek-v4-pro
      api_key: os.environ/OPENROUTER_API_KEY

router_settings:
  fallbacks:
    - qwen3-8b: ["frontier-cheap"]
Acaban de ocurrir tres cosas y cada una merece una explicación.
Tu clave de OpenRouter nunca sale de la máquina. Ahora 200 estudiantes pueden acceder a Kimi K3 y ninguno posee una credencial que pueda pegar en un repositorio público. Tienen la clave de tu gateway, que puedes revocar con un comando y que no puede gastar más allá de su tope. El Concepto 14 advirtió que una clave de OpenRouter es un secreto y una cartera dentro de una cadena. Así compartes la cartera sin entregar la cadena.
La elección de nivel se convirtió en un nombre de modelo. Un estudiante que necesita un cerebro de frontera para una refactorización difícil escribe frontier en lugar de qwen3-8b. Es el procedimiento de tres preguntas del Concepto 15 convertido en una acción que una persona puede realizar en mitad de una tarea.
La línea de fallback es una política. Si tu GPU está inactiva o llena, las solicitudes para qwen3-8b pasan en silencio a frontier-cheap en lugar de fallar. Es una decisión real e intencional: comprar disponibilidad con dinero. Escríbela donde tu yo futuro pueda encontrarla, porque un fallback olvidado se convierte en una factura que no entenderás.
Ahora establece límites distintos para el menú de frontera, porque cuesta dinero real:
curl -X POST http://localhost:4000/key/generate \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "user_id": "student-0417-frontier",
    "models": ["qwen3-8b", "frontier-cheap", "frontier"],
    "max_budget": 5.00,
    "budget_duration": "30d"
  }'
Retrocede y observa lo que construiste. Una dirección. Detrás hay un modelo en hardware propio y modelos en clústeres que nadie en la sala podría poseer, ofrecidos en el mismo menú, facturados contra los mismos topes y accesibles mediante las mismas dos configuraciones. El Concepto 2 enseñó que el cerebro es solo una dirección. Esta es esa frase leída al revés: una dirección puede ocultar cualquier cantidad de cerebros y elegir entre ellos ahora es tarea del archivo de configuración de alguien. Del tuyo.
Tu fallback envía las solicitudes fallidas de Todas las solicitudes que habrían sido gratuitas se ejecutaron en un modelo de nube de pago durante unas 60 horas, y el servicio siguió funcionando a la perfección, precisamente por eso nadie lo notó. Los fallbacks intercambian dinero por disponibilidad en silencio y el silencio es el peligro. Añade dos cosas: una alerta cuando el contenedor vLLM no esté saludable y una alerta de gasto en el gateway. La solución no consiste en eliminar el fallback, sino en asegurarse de que avise a alguien cuando dure más de unos minutos.qwen3-8b a frontier-cheap. La máquina GPU se reinicia para actualizar un controlador un viernes por la tarde y nadie lo nota hasta el lunes. ¿Qué ocurrió durante el fin de semana y qué deberías añadir?Mostrar la respuesta
El Concepto A5 está completo cuando: una clave accede por nombre tanto a tu modelo local como a uno de frontera y puedes explicar qué obtiene tu regla de fallback y cuánto cuesta.
A6. Obsérvalo: tres números que indican si está saludable
Un servicio que nadie observa es un servicio que falla en silencio. vLLM publica sus propias métricas en http://localhost:8000/metrics, en el formato que lee Prometheus. La imagen habitual consiste en Prometheus recopilándolas y Grafana dibujándolas.
No necesitas eso el primer día. Sí debes saber qué tres números importan, porque muestran qué falla antes de que lo haga un estudiante:
- Profundidad de la cola: cuántas solicitudes esperan. Es el número más útil y convierte el experimento de la Parte 2 en un indicador en tiempo real. Un valor cercano a cero significa que la máquina funciona con comodidad. Si aumenta y permanece alto, agotaste la GPU y necesitas una segunda tarjeta, un modelo más pequeño o un límite honesto para la clase.
- Tiempo hasta el primer token: cuánto espera un usuario antes de que aparezca algo. El rendimiento puede parecer maravilloso mientras cada persona vive una experiencia terrible. Este es el número que sienten los estudiantes y exactamente aquello que oculta el total de tokens por segundo.
- Memoria GPU en uso. La memoria se llena antes que el cómputo y, cuando lo hace, el rendimiento cae antes de que algo parezca averiado. Un modelo que consume en silencio toda la memoria de un nodo degrada la experiencia de todos mientras cada contenedor aún informa que está saludable.
Dos elementos acompañan esas métricas. El panel de gasto del gateway, donde detectas una factura inesperada pronto en lugar de al final del mes. Y una comprobación de salud sencilla en ambos contenedores, porque a las tres de la madrugada quieres que una máquina responda «¿está activo?», no recibir un mensaje de un estudiante.
La profundidad de la cola es la fila en la puerta. El tiempo hasta el primer token es cuánto espera cada comensal por su comida. La memoria GPU indica qué tan llena está la cocina. El dueño de un restaurante que solo observa el total de comidas servidas será el último en saber que el lugar se desmorona.
El Concepto A6 está completo cuando: abriste /metrics en tu contenedor vLLM con tus propios ojos y puedes nombrar cuál de los tres números comprobarías primero si un estudiante dice «hoy se siente lento».
A7. Cuándo vale la pena y cuándo debes avanzar
Esta es la contabilidad honesta, con el mismo espíritu que los Conceptos 7, 12 y 15.
Construye una nube pequeña cuando:
- Tienes muchos usuarios y un presupuesto. Una clase, un campamento intensivo, un departamento o una empresa pequeña. Una GPU para 50 personas es la configuración capaz más barata que cualquiera de ellas tendrá; el gateway convierte «50 personas» en algo seguro en lugar de caótico.
- Los datos no pueden salir. Es la primera pregunta del Concepto 15 respondida a escala organizacional, con un elemento adicional importante para una institución: un registro de auditoría que muestre quién accedió a qué.
- Quieres una dirección estable delante de un mundo cambiante. Los modelos, precios y proveedores cambian cada pocas semanas. Si los estudiantes apuntan al gateway, absorbes ese movimiento en un archivo de configuración en vez de pedir a 200 personas que cambien sus ajustes.
- Los bucles se ejecutan todo el día. Los agentes de Ingeniería de bucles que conocerás después envían solicitudes para siempre. En una factura por token, el total nunca deja de crecer. En una GPU que ya posees y saturaste, una solicitud más casi no añade costo.
No construyas una cuando:
- Eres una sola persona. Tú eres toda la parte delantera del restaurante. Usa vLLM directamente, justo como mostró el Concepto 11, y omite este apéndice.
- Tu tráfico es pequeño y ocasional. Las GPU inactivas cuestan lo mismo que las ocupadas. Por debajo de un volumen diario real, alquilar mediante la Parte 3 gana tanto en dinero como en tus fines de semana, por una gran diferencia.
- Nadie se responsabiliza. Este es el fallo que nadie planifica. Una nube pequeña es un servicio y los servicios necesitan una persona responsable cuando fallan. Si no existe, el sistema morirá la primera vez que se interrumpa durante un festivo y todos perderán la confianza.
Cuándo avanzar más allá de Docker Compose. La pila Compose anterior es un servicio real que puede atender a una cantidad sorprendente de estudiantes, pero es una máquina con una unidad de cada componente. No tiene escalado automático ni una segunda copia de nada. Cuando la superes, no reescribes: trasladas las mismas piezas a Kubernetes. Conviene conocer dos rutas por nombre. vLLM production stack proporciona un Helm chart con métricas, paneles y reutilización de caché ya conectados. KubeAI va más lejos y administra modelos como recursos de Kubernetes, ejecuta vLLM y Ollama por debajo e incluye una interfaz de chat, por lo que gran parte de este apéndice se reduce a dos instalaciones de Helm. Ninguna sustituye al gateway porque ninguna proporciona claves y presupuestos por usuario. Esa capa permanece exactamente donde la colocaste.
El límite honesto es el mismo con el que terminó la Parte 2. Un gateway no mueve ninguna barrera. No mejora el rendimiento ni vuelve más inteligente al cerebro. Hace que un cerebro rápido sea compartible, una victoria diferente y, a menudo, la que decide si una sala llena de personas puede usar la IA.
Un departamento quiere un servicio de IA privado para 40 empleados. Alguien propone pasar directamente a Kubernetes con escalado automático y servicio multinodo «para no tener que rehacerlo después». ¿Cuál es el argumento en contra? Cuarenta usuarios caben cómodamente dentro de la capacidad de una GPU detrás de Docker Compose, así que Kubernetes no aporta nada hoy, pero cuesta semanas de configuración y una carga operativa permanente. La ruta de actualización tampoco es una reescritura: los mismos contenedores, la misma configuración del gateway y el mismo modelo pasan a Helm charts cuando la carga lo justifique. Construye lo que funciona este mes, mide el tráfico real y deja que la medición decida cuándo avanzar. La pregunta correcta no es «¿lo superaremos?», sino «¿quién estará de guardia cuando falle?».Mostrar la respuesta
El Concepto A7 está completo cuando: puedes defender ambos lados para tu propia situación y nombrar aquello que un gateway no mejora.
El Apéndice A en una frase
Un motor de inferencia sirve tokens y un gateway sirve personas. Una nube LLM pequeña solo es esos dos programas más un lugar donde guardar las claves. Constrúyela cuando muchas bocas compartan un presupuesto. Observa lo que realmente hiciste: para todos los que apuntan a tu dirección, ahora tú eres la nube.
Referencias
Estas son las fuentes principales de los comandos de la página. Cambian con rapidez, así que consulta la documentación vigente antes de depender de cualquier flag, precio o versión.
Parte 1: local (Ollama)
- Ollama, la app de escritorio (descargar un modelo y conversar con él, sin terminal). https://ollama.com/blog/new-app y https://ollama.com/download
- Ollama,
ollama launch(un comando para conectar e iniciar un agente de programación con un modelo local). https://ollama.com/blog/launch y https://docs.ollama.com/integrations/claude-code - Ollama, compatibilidad con la API de Anthropic (el endpoint nativo que permite configurar sin proxy). https://ollama.com/blog/claude
- Ollama, longitud del contexto y
num_ctx, para los valores predeterminados según la VRAM y la recomendación de 64K para agentes de programación. https://docs.ollama.com/context-length - Claude Code, variables de entorno, para
ANTHROPIC_BASE_URL,ANTHROPIC_AUTH_TOKENyAPI_TIMEOUT_MS. https://code.claude.com/docs/en/env-vars - OpenCode, proveedores, para el bloque de proveedor de
opencode.jsony el endpoint compatible con OpenAI. https://opencode.ai/docs/providers/ - El instalador de skills y los comandos
gh skillde GitHub CLI para instalar y publicar skills. https://skills.sh/docs
Parte 2: servidor (vLLM)
- vLLM, página principal de documentación (instalación,
vllm servey servidor compatible con OpenAI). https://docs.vllm.ai - vLLM, llamadas a herramientas, para
--enable-auto-tool-choicey el parser de llamadas de cada familia de modelos. https://docs.vllm.ai/en/latest/features/tool_calling/ - vLLM, integración con Claude Code, para la compatibilidad con Anthropic Messages y las variables
ANTHROPIC_DEFAULT_*_MODEL. https://docs.vllm.ai/en/latest/serving/integrations/claude_code/ - Qwen, guía de despliegue con vLLM, para ofrecer modelos Qwen3 y los parsers recomendados. https://qwen.readthedocs.io/en/latest/deployment/vllm.html
Parte 3: nube (OpenRouter)
- OpenRouter, integración con Claude Code, para las variables de entorno y el endpoint compatible con Anthropic. https://openrouter.ai/docs/cookbook/coding-agents/claude-code-integration
- OpenRouter, página del modelo Kimi K3, para el slug, el precio y los proveedores vigentes. https://openrouter.ai/moonshotai/kimi-k3
- OpenRouter, página del modelo DeepSeek V4 Pro, para el slug, el precio y los proveedores vigentes. https://openrouter.ai/deepseek/deepseek-v4-pro
- Moonshot AI, blog técnico de Kimi K3, para la arquitectura, la ventana de contexto y las recomendaciones de servicio. https://www.kimi.com/blog/kimi-k3
- DeepSeek, precios de la API, para las tarifas actuales de V4 Pro y el precio de aciertos de caché. https://api-docs.deepseek.com
Concepto 16: Claude Code Router
- Claude Code Router, para instalar el router, la configuración de
ProvidersyRouter, los transformers y los comandosccr. https://github.com/musistudio/claude-code-router
Apéndice A: nube LLM pequeña
- LiteLLM, documentación del servidor proxy, para el archivo de configuración, las claves virtuales, los presupuestos y los límites de frecuencia. https://docs.litellm.ai/docs/simple_proxy
- LiteLLM, claves virtuales, para
/key/generate,/key/info,/key/deletey el acceso a modelos por clave. https://docs.litellm.ai/docs/proxy/virtual_keys - LiteLLM, presupuestos y límites de frecuencia, para
max_budget,budget_durationyrpm_limit. https://docs.litellm.ai/docs/proxy/users - LiteLLM, fiabilidad y fallbacks, para las reglas de fallback de
router_settings. https://docs.litellm.ai/docs/proxy/reliability - vLLM, despliegue con Docker, para la imagen oficial
vllm/vllm-openaiy los flags del entorno de ejecución de GPU. https://docs.vllm.ai/en/latest/deployment/docker.html - vLLM, métricas de producción, para el endpoint de Prometheus, la profundidad de la cola y el tiempo hasta el primer token. https://docs.vllm.ai/en/latest/serving/metrics.html
- vLLM, pila de producción, el Helm chart con enrutamiento, métricas y paneles para la ruta de actualización a Kubernetes. https://github.com/vllm-project/production-stack
- KubeAI, operador de inferencia de IA para Kubernetes, para administrar modelos como recursos de Kubernetes sobre vLLM y Ollama. https://www.kubeai.org
- Open WebUI, documentación, para la interfaz de chat y la conexión a un endpoint compatible con OpenAI. https://docs.openwebui.com
- NVIDIA, guía de instalación de Container Toolkit, necesaria para acceder a la GPU desde Docker. https://docs.nvidia.com/datacenter/cloud-native/container-toolkit/latest/install-guide.html