Ingeniería de grafos: curso acelerado
16 conceptos · De una columna vertebral que lee un bucle a un grafo que comparten mil agentes
Tu bucle funciona. Se activa cada mañana a las 9:00, el arnés lo mantiene dentro de sus límites y su columna vertebral, un único archivo progress.md, lleva lo aprendido de ayer hasta hoy. Un bucle, un archivo de memoria. Era suficiente.
Ahora observa qué ocurre cuando tienes éxito. Añades un segundo bucle. Después, uno de revisión. Luego, durante una semana intensa, distribuyes entre veinte agentes la auditoría simultánea de veinte archivos. Cada agente comienza con una ventana de contexto vacía. Cada uno vuelve a descubrir algo que otro ya encontró una hora antes. Cada uno escribe sus hallazgos en una transcripción que ningún otro agente leerá jamás. El trabajo se multiplicó; la memoria no. Construiste un equipo sin cerebro compartido.
Este es el problema que resuelve la ingeniería de grafos. La idea cabe en una frase: el agente olvida; el grafo, no. En lugar de dejar lo que aprenden los agentes dentro de sus transcripciones, haces que lo escriban como registros conectados y con tipos, es decir, nodos y aristas que cualquier agente posterior puede consultar. Dos grafos cumplen esta función. Un DAG de commits recuerda el trabajo: qué se intentó, qué descendió de qué y qué se conservó. Un grafo de conocimiento recuerda los hechos: qué entidades existen, cómo se relacionan y qué fuente demuestra cada afirmación. Este curso enseña ambos mediante los ejemplos documentados más claros de 2026: autoresearch y AgentHub de Andrej Karpathy para el primero, y la guía de construcción de grafos de conocimiento y los flujos de trabajo dinámicos de Anthropic para el segundo. Como los propios bucles también necesitan conexiones, la Parte 5 añade el tercer grafo, el grafo de gobernanza: quién revisa a quién, quién controla el objetivo de quién y qué mediciones no puede discutir ningún bucle.
Primero necesitas Ingeniería de bucles e Ingeniería del harness. El curso de bucles enseñó el pulso, la columna vertebral, la separación entre creador y revisor y el trinquete. El curso del arnés enseñó los cinco verbos y la salida tipada. Este curso presupone todo eso. La columna vertebral era la memoria privada de un bucle. Aquí verás en qué se convierte cuando muchos agentes deben compartirla. Si estas palabras son nuevas para ti, completa primero esos cursos.
📚 Recurso didáctico
Ver la presentación completa: Ingeniería de grafos: curso acelerado
Las diez figuras siguientes están diseñadas para enseñarse en el mismo orden: cada una sostiene un solo concepto y puede ocupar por sí sola una diapositiva.
Cada concepto siguiente tiene un script que puedes ejecutar y observar, no solo leer. Los scripts necesitan bash, git, jq y python3, y nada más: sin clave de API, sin pip install y sin red.
git clone https://github.com/panaversity/agentfactory-labs.git
cd agentfactory-labs/crash-course/graph-eng
./verify.sh      # runs all 17 demos and asserts each one
Cuando el comando imprima Everything in this course runs., mantén la carpeta abierta junto a esta página. Cada concepto termina con el único comando que lo demuestra: verás cómo git reset elimina un commit, un esquema rechaza una respuesta mal formada, un revisor exige una arista ausente y una puerta de pre-commit bloquea una infracción del esquema. El README del laboratorio relaciona cada concepto con su demostración.
Si alguno de estos conceptos es nuevo, completa primero los cursos de Ingeniería de bucles e Ingeniería del harness. Este curso conecta la maquinaria que construyeron ambos.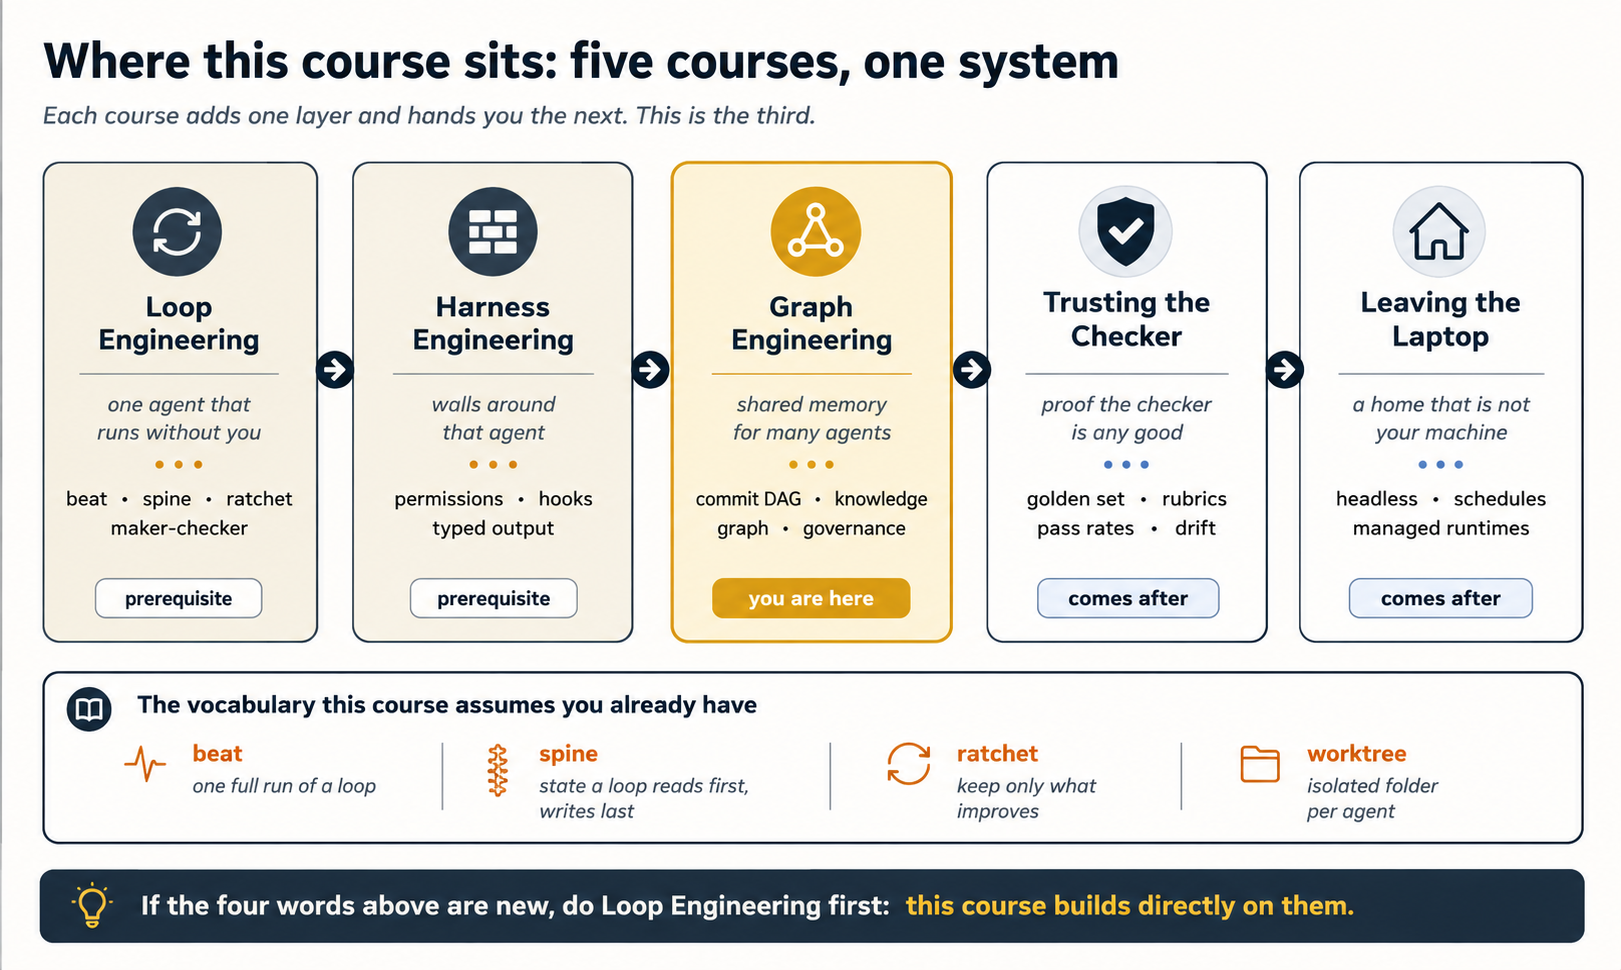
¿Eres nuevo aquí? Repaso de dos minutos de lo que ya deberías saber
progress.md, que un bucle lee primero y escribe al final para que el pulso siguiente sepa qué ocurrió.main.
Palabras clave en lenguaje sencillo
Verás estas palabras a lo largo del curso. Lee la lista una vez y vuelve a ella cuando algún término no esté claro.
| Término | Significado en lenguaje sencillo |
|---|---|
| Grafo | Un conjunto de puntos (nodos) conectados por flechas (aristas). Las flechas tienen dirección, y esa dirección tiene significado. |
| Nodo | Un punto del grafo: una entidad, una afirmación, un commit, una fuente o una ejecución de agente. |
| Arista | Una flecha entre dos nodos, con una etiqueta: supports, parent_of, produced o works_for. |
| DAG | Grafo acíclico dirigido: las flechas nunca forman un ciclo que regrese al punto de partida. El historial de Git es un DAG. |
| DAG de commits | El grafo del trabajo: los commits son nodos y los enlaces a sus padres son aristas. Responde «¿qué se intentó y qué surgió de qué?». |
| Grafo de conocimiento | El grafo de los hechos: las entidades son nodos y las relaciones tipadas son aristas. Responde «¿qué existe y cómo está conectado?». |
| Entidad | Algo que el grafo sigue: una persona, una empresa, un archivo, un proveedor o un incidente. |
| Relación / tripleta | Un hecho expresado como sujeto-predicado-objeto: (Proveedor X, supplied, Componente Z). |
| Forma superficial | Un nombre tal como aparece en un documento: «Edwin Aldrin», «Buzz» y «Col. Aldrin». Tres formas superficiales, una persona. |
| Resolución de entidades | Decidir qué formas superficiales representan la misma cosa real y fusionarlas en un único nodo canónico, sin perder los nombres originales. |
| Procedencia | El recibo adjunto a una afirmación: qué fuente la expresó, qué ejecución la extrajo y cuánta confianza merece la extracción. |
| Afirmación | Una declaración que el grafo almacena como posiblemente verdadera, siempre con procedencia y nunca como una verdad sin respaldo. |
| Subgrafo | Una sección pequeña y pertinente del grafo, recortada para una tarea. Entregas subgrafos a los agentes, nunca el grafo completo. |
| Anclaje | Obligar a una respuesta o un veredicto a señalar aristas reales del grafo, en lugar de basarse en su propia impresión. |
| Enjambre | Muchos agentes que exploran, implementan o evalúan al mismo tiempo. |
| Salida estructurada | Una respuesta del modelo restringida a un esquema, por ejemplo un modelo Pydantic, para que el código pueda validarla antes de creerla. |
| MCP | Protocolo de Contexto del Modelo: la forma estándar en que un agente accede a un sistema externo. No hace falta mientras el grafo sea un conjunto de archivos. Se convierte en la respuesta cuando pasa a ser una base de datos. |
| Grafo de gobernanza | El grafo cuyos nodos son los propios bucles, además de puertas humanas y anclas, y cuyas aristas indican quién alimenta, revisa y restringe a quién. |
| Bucle de ejecución | Un bucle que realiza trabajo recurrente: clasifica incidencias, revisa el pull request o redacta el registro de cambios. |
| Bucle de mejora | Un bucle que observa un número frente a un objetivo y ajusta el sistema que realiza el trabajo. |
| Contramétrica | Un segundo número, observado por un segundo bucle, que detecta si se manipula el primero. |
| Ancla | Una medición que ningún bucle puede discutir: una prueba que realmente se ejecutó, un cliente que de verdad permaneció o dinero que realmente llegó. |
| Nodo congelado | Una regla o archivo que los bucles de optimización nunca pueden cambiar, precisamente porque querrían hacerlo. |
El curso de bucles dio a los bucles una metáfora corporal: latido, cuerpo y columna vertebral. Este curso añade una más: el grafo es el cerebro compartido, la memoria que dura más que la ventana de contexto de cualquier agente.
Versión breve: el trabajo original es real y público, pero la presentación viral es incorrecta. El «PDF de 11 páginas escrito por dos altos cargos de Anthropic» es una nota de estudio independiente cuya portada indica que no está afiliada con Karpathy ni Anthropic y que ninguno de ellos la respalda. Además, «1000 veces mejor» es un eslogan, no una medición. Lee primero las fuentes originales. La cronología es breve y pública. El 7 de marzo de 2026, Karpathy publicó autoresearch: un agente encerrado en un pequeño repositorio de entrenamiento que ejecuta un experimento de cinco minutos cada vez y conserva únicamente lo que mejora la métrica. En pocas semanas acumuló decenas de miles de estrellas en GitHub, y Fortune llamó al patrón «el bucle de Karpathy». Tres días después esbozó AgentHub, «GitHub es para humanos. AgentHub es para agentes»: un repositorio Git básico más un tablón de mensajes donde los enjambres se coordinan mediante el DAG de commits en lugar de una rama principal. El 23 de marzo de 2026, Anthropic publicó su guía de construcción de grafos de conocimiento, que sustituye un pipeline clásico de procesamiento del lenguaje natural por prompts de salida estructurada: extraer entidades y relaciones tipadas, resolver duplicados, ensamblar un grafo y consultarlo con citas. Los flujos de trabajo dinámicos de Anthropic, anunciados el 28 de mayo de 2026 y disponibles para todos desde entonces, permiten a Claude escribir el script de orquestación que distribuye el trabajo entre subagentes paralelos con contextos nuevos. El 18 de julio de 2026, la pregunta de doce palabras que Peter Steinberger publicó a medianoche, «¿Seguimos hablando de bucles o ya pasamos a los grafos?», dio a todo el tema el nombre de la temporada. La Parte 5 cuenta esa historia y la respuesta de Carlos E. Pérez. Días después, una publicación viral unió todo en una sola afirmación: «Dos altos cargos de Anthropic acaban de mejorar 1000 veces el bucle de Karpathy mediante Ingeniería de grafos y publicaron un PDF de 11 páginas». Lee la primera página del propio PDF antes de repetirlo. Allí dice, en cursiva, que fue recopilado de forma independiente, no está afiliado con Andrej Karpathy ni Anthropic y ninguno de ellos lo respalda. La síntesis es verdaderamente útil y este curso la aprovecha, pero es una nota de estudio de un autor independiente, no un artículo de Anthropic, y «1000 veces mejor» es un eslogan, no una medición. Es el mismo reflejo que convirtió la pregunta de Steinberger en «la ingeniería de bucles ha muerto». La Parte 5 analiza esa afirmación. Trata esta de la misma manera. Las fuentes originales son reales y merecen tu tiempo, con una salvedad: autoresearch, la guía de Anthropic y la documentación de los flujos de trabajo son públicas, mientras que AgentHub pasó a ser privado poco después de su publicación y ahora solo sobrevive mediante forks sin licencia. El Concepto 5 explica más. Hay una convergencia real que el meme pasó por alto, y es aún más extraña: el 19 de mayo de 2026, Karpathy se incorporó al equipo de preentrenamiento de Anthropic para crear un grupo centrado en usar Claude con el fin de acelerar la propia investigación de preentrenamiento. Por tanto, la tradición de los bucles y la de los grafos que presenta este curso sí se encontraron dentro de Anthropic, pero no como afirmó una publicación viral ni en ese PDF. (Todas las fuentes aparecen en Fuentes y lecturas adicionales.)La cronología completa y lo que el meme explicó mal
El sector usa «ingeniería de grafos» para más de una cosa. Dos significados están estrechamente relacionados, y este curso cubre ambos por completo. El primero es el grafo de memoria: el estado duradero y tipado que comparten tus agentes. Incluye el DAG de commits del trabajo y el grafo de conocimiento de los hechos. Ese es el tema de las Partes 2 a 4.
El segundo es el grafo de gobernanza: las conexiones entre los propios bucles. Registra quién alimenta a quién, quién revisa a quién, dónde está la puerta humana y qué mediciones no puede discutir ningún bucle. Ese es el tema de la Parte 5, basada en la pregunta de Peter Steinberger y el ensayo de Carlos E. Pérez.
Los dos grafos son capas de un mismo sistema, no rivales. El grafo de gobernanza conecta a los trabajadores. El grafo de memoria almacena lo que saben. Se encuentran en el Concepto 10, donde un revisor de la capa de gobernanza lee pruebas de la capa de memoria. El curso de bucles termina exactamente donde comienza este, con un bucle completamente construido, y entrega ambos grafos a este curso.
Circula un tercer significado que este curso no enseña. Algunos autores usan «ingeniería de grafos» para referirse a la topología de ejecución: los nodos son pasos en lugar de registros o bucles, las aristas son dependencias de datos y la pregunta de diseño es qué puede ejecutarse en paralelo y dónde debe esperar la ejecución. Ese es el terreno de los frameworks de orquestación, y es anterior a la expresión: LangGraph ya ofrecía nodos y aristas sobre un estado compartido en enero de 2024, y tanto AutoGen de Microsoft como ADK de Google incluyen su propia versión. Sus mejores ideas te alcanzan de todos modos en la prueba de las flechas y la separación del enrutamiento del Concepto 11, además de las reglas de presupuesto y unión del Concepto 14. Sin embargo, si buscabas un capítulo sobre cómo construir un grafo de orquestación, se trata de otro curso. Elegir entre ambas preguntas antes de construir es más útil que mezclarlas. Las conexiones de tus bucles y la forma de una ejecución son problemas relacionados, pero tienen respuestas diferentes.
El plan de seis pasos y dónde se encuentra cada uno
La mayoría de los lectores llega aquí mediante una versión viral del plan de seis pasos. Ya dejaste atrás cuatro de ellos; este curso enseña los otros dos y la parte que la lista omite. Por tanto, la versión honesta de «1000 veces mejor» no es un benchmark. Los pasos 1 a 3 te dan un trabajador competente; los pasos 4 a 6 dan una memoria compartida a mil trabajadores. El mismo modelo, una arquitectura diferente.Los seis pasos, relacionados con esta serie
El paso, según la publicación Lo que es en realidad Dónde lo aprendiste 1. Construye un bucle: genera, critica y revisa El pulso creador-revisor y el trinquete Ingeniería de bucles 2. Añade herramientas: búsqueda, código y base de datos Conectores y esquemas de herramientas que los limitan Ingeniería de bucles e Ingeniería del harness 3. Trabaja en paralelo: agentes en worktrees separados Aislamiento para que el trabajo concurrente no colisione Ingeniería de bucles e Ingeniería del harness 4. Añade un grafo: nodos y aristas tipados, no transcripciones Memoria que dura más que la sesión Partes 2 a 4 de este curso 5. Ancla el evaluador en aristas, no en impresiones Verificación con pruebas que se pueden citar Concepto 10 de este curso 6. El grafo sobrevive a cada sesión Procedencia, sustitución y estado duradero Conceptos 8 y 13, y Parte 6
El cambio de mentalidad, en una imagen
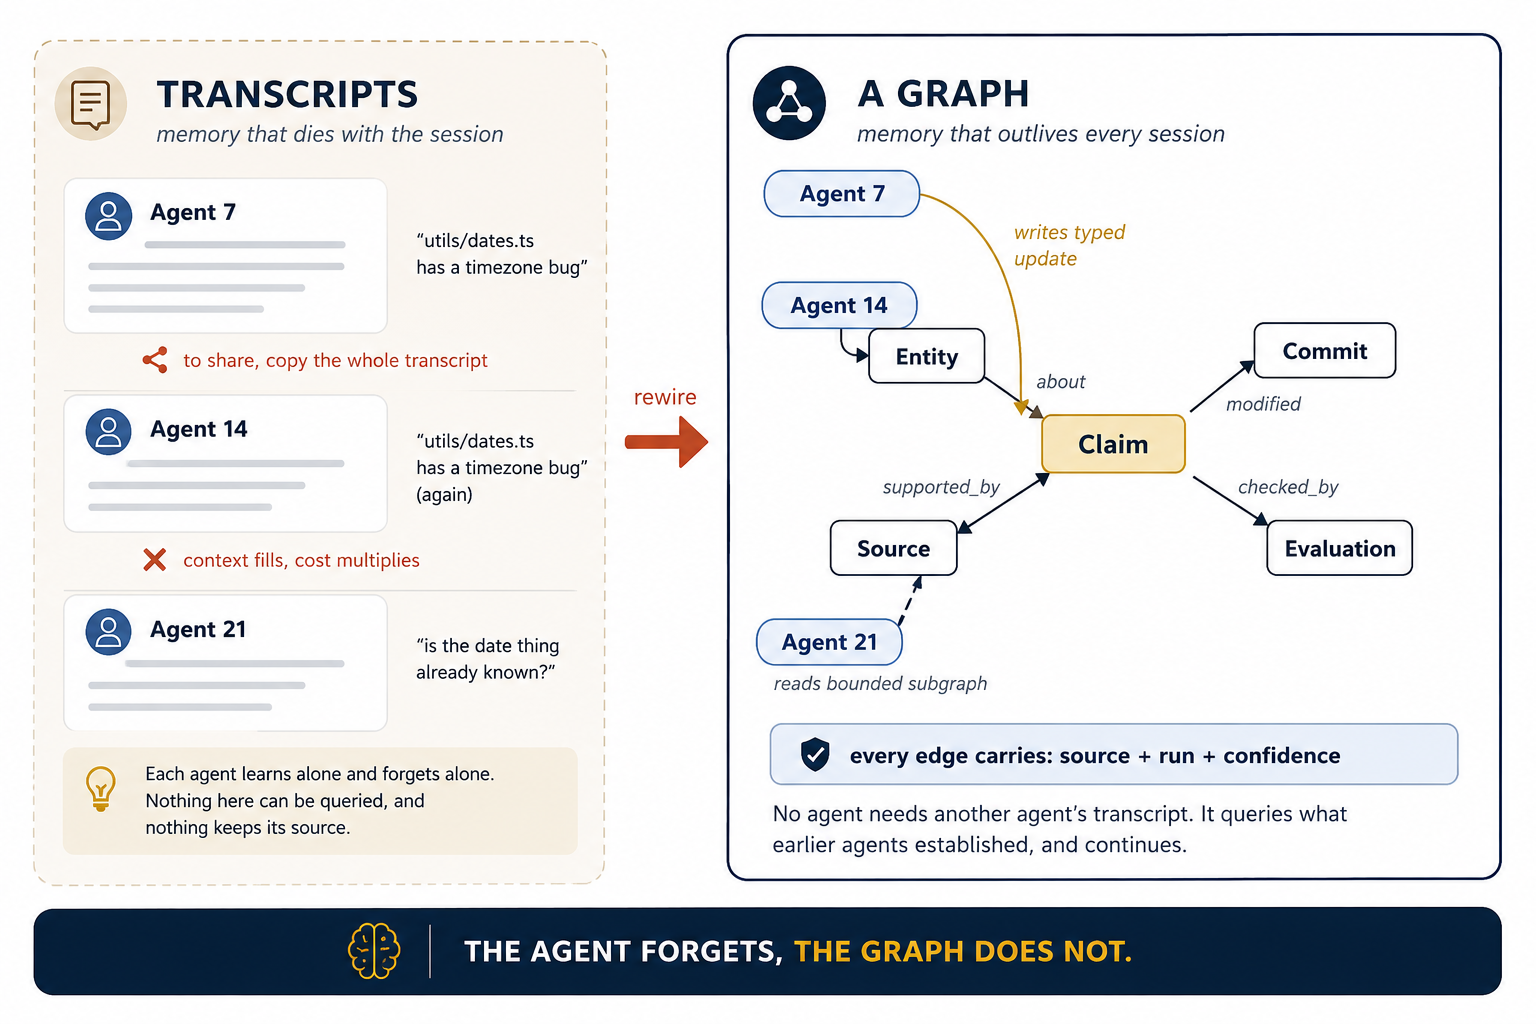
Una nota sobre las herramientas, más breve que sus equivalentes en los cursos relacionados. El trabajo con bucles, arneses y evaluaciones tenía formas específicas de cada herramienta que debías aprender. El trabajo con grafos casi no las tiene: el grafo son archivos, Git, jq y un esquema que tú controlas, por lo que no hay nada que comprar ni funciones de producto que configurar. Claude Code y OpenCode aparecen aquí únicamente como los trabajadores que leen y escriben el grafo. Todos los comandos siguientes funcionan igual en ambas herramientas, y claude -p y opencode run son intercambiables en todo el curso. Esta independencia de las herramientas no es casualidad ni producto del alcance elegido. Es la prueba más sólida de que el grafo es una disciplina, no una función.
Un término pertenece aquí porque los lectores esperan encontrarlo y suelen colocarlo en el lugar equivocado. MCP, el Protocolo de Contexto del Modelo, es la forma estándar en que un agente accede a un sistema externo: un servidor expone herramientas y cualquier agente compatible con MCP puede llamarlas. MCP no aparece en absoluto a la escala de este curso, y eso es correcto: el grafo consiste en archivos dentro del repositorio, así que el agente los lee y escribe con las herramientas de archivos y shell que ya tiene. MCP se convierte en la respuesta en el nivel siguiente. Cuando el grafo pasa a Postgres o Neo4j y varios agentes de distintos equipos deben acceder a él, no entregas a cada agente credenciales de la base de datos y un cliente hecho a medida. Colocas un único servidor MCP delante del almacén y expones una superficie pequeña y tipada: resolver una entidad, obtener un subgrafo limitado y añadir una afirmación validada. Entonces cada regla de este curso vive en ese servidor, donde se aplica una vez, en lugar de vivir en el prompt de cada agente, donde solo se solicita.
Mantén separadas tres capas, porque es fácil confundirlas. Una skill es el conocimiento que carga el agente: cómo escribimos afirmaciones aquí. MCP es la conexión: cómo accede el agente al almacén. El grafo es la propia memoria: lo que se recuerda de verdad. Una skill sin grafo es un consejo sin lugar donde escribirse. Un grafo sin skill se llena de forma incoherente. MCP no es ninguna de las dos cosas. Es la tubería que se vuelve necesaria en cuanto el almacén deja de ser un archivo en la misma carpeta que el agente.
Información válida a finales de julio de 2026, con distintos periodos de vigencia. autoresearch se desarrolla activamente. AgentHub está congelado y es privado, así que trata todo lo relacionado con él como historia. Los flujos de trabajo dinámicos ya están disponibles para todos, y sus límites y valores predeterminados cambian con el producto. La guía es un cuaderno vivo. Antes de confiar en una opción, un límite o el nombre de un modelo, consulta las fuentes vigentes: github.com/karpathy/autoresearch, platform.claude.com/cookbook, code.claude.com/docs, opencode.ai/docs.
Qué cubre este curso
| Parte | Tema | Qué aprenderás |
|---|---|---|
| 1 | El problema de la memoria | Por qué las transcripciones fallan como memoria de equipo, qué es un grafo y los dos grafos que necesita todo enjambre |
| 2 | El DAG del trabajo | La ruta de Karpathy: autoresearch escribe el historial en Git y AgentHub convierte el DAG en la capa de colaboración |
| 3 | El grafo de los hechos | La ruta de Anthropic: extracción mediante un esquema, resolución de entidades y procedencia en cada arista |
| 4 | Trabajar desde el grafo | Subgrafos en lugar de volcados, y el revisor anclado: «tripleta no encontrada» supera a «parece incorrecto» |
| 5 | El grafo de los bucles | La capa de gobernanza: quién revisa a quién, las cuatro formas en que falla un solo bucle y las anclas que ningún bucle puede discutir |
| 6 | Un grafo, de principio a fin | La columna vertebral del bucle de clasificación matinal convertida en un grafo pequeño y consultable mediante archivos y shell, en ambas herramientas |
| 7 | Mantener el anclaje | Elegir un nivel, presupuestar la complejidad, saber cuándo no construir un grafo y enlazar con los dos cursos siguientes |
| En vivo | Dogfooding | El protografo que este libro ya ejecuta y el grafo que evita deliberadamente |
| Práctica | Proyectos | Ocho construcciones de grafos, de fáciles a difíciles |
¿Quieres aprender haciendo? Lee primero la Parte 6 para ver un grafo terminado. Después vuelve a las demás partes.
¿Es tu primera vez? Sigue la ruta de la memoria: Partes 1 a 4, es decir, Conceptos 1 a 10, y después salta directamente a la Parte 6 y construye el ejemplo. Omite la Parte 5 y todas las notas marcadas como «Para profundizar». Esto lleva unas dos horas, o cerca de tres si practicas los ejemplos en vez de limitarte a leerlos. Después completa los Proyectos 1 a 3. Al terminar podrás dibujar tu sistema como un grafo, guardar afirmaciones con sus fuentes y hacer que un revisor cite sus pruebas.
Segunda lectura, después de que tu primer grafo haya respondido una pregunta que las transcripciones no podían contestar: sigue la ruta de la gobernanza, que comprende la Parte 5, toda la Parte 7 y los Proyectos 4 a 8. La Parte 5 explica cómo mantener honestos a muchos bucles, algo que solo se vuelve urgente cuando más de uno escribe en la misma memoria. Del mismo modo, las advertencias del Concepto 15 solo adquieren todo su sentido cuando tienes un grafo que te tienta a construir en exceso.
Dos capas envejecen de forma distinta. Recuerda la primera. Consulta la segunda.
- La capa duradera. El agente olvida; el grafo, no. La genealogía del trabajo y los hechos del dominio son dos grafos distintos: no los mezcles. Un esquema cuesta menos que un pipeline entrenado. La resolución debe conservar sus recibos y seguir siendo reversible. Cada afirmación incluye su procedencia o se marca como inferencia. Entrega subgrafos a los agentes, nunca el grafo completo. Ancla al revisor en las aristas. Formula las seis preguntas antes de elegir un nivel y declara el presupuesto antes de ejecutar. Empareja cada bucle de optimización con otro de supervisión que siga una contramétrica. Al menos una señal del sistema debe provenir de la realidad, no del informe de otro modelo. Además, el grafo amplifica el criterio de quien lo construye, incluidos sus errores.
- La capa mecánica. Todos los nombres de repositorios y modelos, las opciones y las cifras de estrellas que aparecen más adelante. Trata la estructura de archivos de autoresearch, los límites de concurrencia de los flujos de trabajo dinámicos y las clases Pydantic exactas de la guía como referencias a la fuente vigente, no como hechos que debas memorizar. Si este curso contradice la documentación actual, la documentación es la correcta.
Parte 1: el problema de la memoria
1. El agente olvida; el grafo, no
Ejecuta este ejemplo: bash concepts/01-agent-forgets.sh en el laboratorio complementario. Leerlo es una mitad; verlo ocurrir es la otra.
Comienza con lo que ya tienes. Tu bucle de clasificación matinal conserva una columna vertebral: progress.md, que lee primero y escribe al final. Ese archivo es memoria y funciona para un bucle. Ahora enumera lo que no puede hacer:
- Un segundo bucle no puede confiar en él.
progress.mdes prosa. El bucle del registro de cambios tendría que leer e interpretar el diario de otro bucle y confiar en que el formato nunca cambie. - Veinte agentes en paralelo no pueden compartirlo. Distribuye el trabajo entre veinte auditores y cada uno comenzará sin contexto. El agente 7 descubre que
utils/dates.tstiene un error de zona horaria. Una hora después, el agente 14 vuelve a descubrirlo. Nada los conectaba. - No puedes consultarlo. «¿Qué hallazgos del mes pasado afectaron al código de pagos y fueron confirmados por un revisor?». Una columna vertebral no puede responder. Tendrías que buscar en la prosa y esperar encontrarlo.
- No cita nada. La columna vertebral dice «se corrigió la prueba inestable». ¿Qué prueba? ¿Qué ejecución lo demostró? ¿Qué corrección posterior la sustituyó? La prosa no lo sabe.
La solución ingenua consiste en copiar transcripciones: pegar la conversación del agente 7 en el contexto del agente 14. Falla justo cuando más la necesitas. Las ventanas de contexto se llenan y los costos se multiplican. Además, una transcripción tiene la forma incorrecta para ser memoria: registra todo lo dicho y su orden, en lugar de lo que se demostró y las pruebas que lo respaldan.
La ingeniería de grafos es la alternativa deliberada. Los agentes escriben lo aprendido como registros tipados: esto es una entidad; esto, una afirmación sobre ella; esta es la fuente que respalda la afirmación; esta es la ejecución que la produjo. Los registros se conectan mediante flechas etiquetadas. Cualquier agente posterior, ya sea el pulso de mañana, otro bucle o un modelo completamente distinto, consulta los registros necesarios y continúa. El PDF independiente que popularizó el tema de este curso lo resume en cinco palabras acertadas: el agente olvida; el grafo, no.
Una transcripción es un registro de chat. Un grafo es un sistema de archivo. Cuando una persona nueva se incorpora a un equipo, no recibe grabaciones de todas las conversaciones mantenidas por el equipo. Recibe archivos organizados, etiquetados y relacionados mediante referencias. La ingeniería de grafos consiste en construir el sistema de archivo que merecen tus agentes.
Tu bucle de clasificación y el del registro de cambios necesitan saber qué pull requests se publicaron esta semana. Hoy, cada uno ejecuta El trabajo se repite y se vuelve a interpretar en cada ventana de contexto: exactamente el fallo de «reconstruir el mundo desde cero». La solución es que el primer bucle que demuestre «el PR 212 se publicó y corrige la incidencia 98» lo escriba una sola vez como registro tipado con procedencia, es decir, el hash del commit. Después, ambos bucles leen ese registro. Deduce una vez; consulta muchas.git log y vuelve a deducirlo. ¿Qué se desperdicia y cómo lo corrige la ingeniería de grafos?Mostrar respuesta
2. Qué es un grafo: nodos, aristas y dirección
Ejecuta este ejemplo: bash concepts/02-nodes-edges.sh en el laboratorio complementario. Leerlo es una mitad; verlo ocurrir es la otra.
Encontraste esta definición al final del curso de bucles. Aquí se convierte en una herramienta de trabajo. Un grafo es un conjunto de puntos llamados nodos, conectados por flechas llamadas aristas. Tres propiedades hacen todo el trabajo:
- Los nodos tienen tipos. No son solo «cuadros», sino una entidad, una afirmación, una fuente, un commit o una evaluación. El tipo indica a cada lector qué preguntas puede responder el nodo.
- Las aristas tienen etiquetas y dirección.
(claim_441) —supported_by→ (source_readme)significa algo distinto de la flecha inversa. La dirección aporta el significado: quién respalda a quién, qué desciende de qué y quién revisó a quién. - Las rutas son respuestas. «¿Está conectado el Proveedor X con el Incidente Y?» se convierte en «¿existe una ruta de aristas respaldadas desde el nodo del Proveedor X hasta el nodo del Incidente Y?». Una pregunta sobre el mundo se transforma en un recorrido por las flechas.
La tercera propiedad es la verdadera recompensa. La prosa debe leerse e interpretarse. Un grafo se puede recorrer mecánicamente mediante código, siempre de la misma manera. En cuanto tu memoria se convierte en un grafo, las preguntas que antes dependían de impresiones se vuelven consultas.
Una forma especial merece un nombre propio. Un DAG, o grafo acíclico dirigido, es un grafo cuyas flechas nunca regresan en círculo. Llevas años usando uno sin conocer el nombre: el historial de Git. Cada commit apunta a su padre. Ningún commit es su propio antepasado. Recuerda este ejemplo, porque la Parte 2 se construye sobre él.
Los nodos son sustantivos. Las aristas son verbos con dirección. Un grafo es un conjunto de oraciones, sujeto, verbo y objeto, dibujadas de modo que el sistema pueda seguir cadenas de oraciones sin comprender la prosa.
Dos agentes registran que el Proveedor X suministró una pieza. Uno escribe «El Proveedor X suministró el componente Z» en su registro. El otro escribe Seguirla. Cualquier modelo que vea la oración debe leerla e interpretarla correctamente. La arista se puede recorrer mecánicamente, de la misma forma cada vez, y encadenar: desde (vendor_x) —supplied→ (component_z) en un grafo. Ambos tienen razón. ¿Qué puede hacer un agente posterior con la segunda forma que no puede hacer con la primera?Mostrar respuesta
vendor_x hasta component_z y luego hacia cualquier otro elemento conectado con component_z. Así, una pregunta sobre el mundo, como «¿está conectado el Proveedor X con este incidente?», se convierte en un recorrido por flechas en lugar de un ejercicio de comprensión lectora. La arista tipada también conserva su recibo, algo que la prosa suele perder.
3. Dos grafos y por qué no debes fusionarlos
Ejecuta este ejemplo: bash concepts/03-two-graphs.sh en el laboratorio complementario. Leerlo es una mitad; verlo ocurrir es la otra.
Esta distinción organiza todo el curso y es la que más suelen confundir los principiantes. Un sistema multiagente necesita dos grafos diferentes porque debe recordar dos tipos de cosas:
| DAG de commits (Parte 2) | Grafo de conocimiento (Parte 3) | |
|---|---|---|
| Recuerda | Trabajo: qué se intentó | Hechos: qué se sabe |
| Nodos | Commits, experimentos y ejecuciones | Entidades, afirmaciones y fuentes |
| Aristas | parent_of, derived_from | supports, works_for, about |
| Responde | ¿Qué cambió? ¿Qué desciende del experimento sobre tamaño de lote? ¿Qué genealogías siguen vivas? | ¿Qué entidades existen? ¿Cómo se relacionan? ¿Qué fuente respalda esta afirmación? ¿Qué afirmaciones se contradicen? |
| Ya tienes una versión | El historial de Git, en parte: consulta el Concepto 4 | Nada todavía: la Parte 3 lo construye |
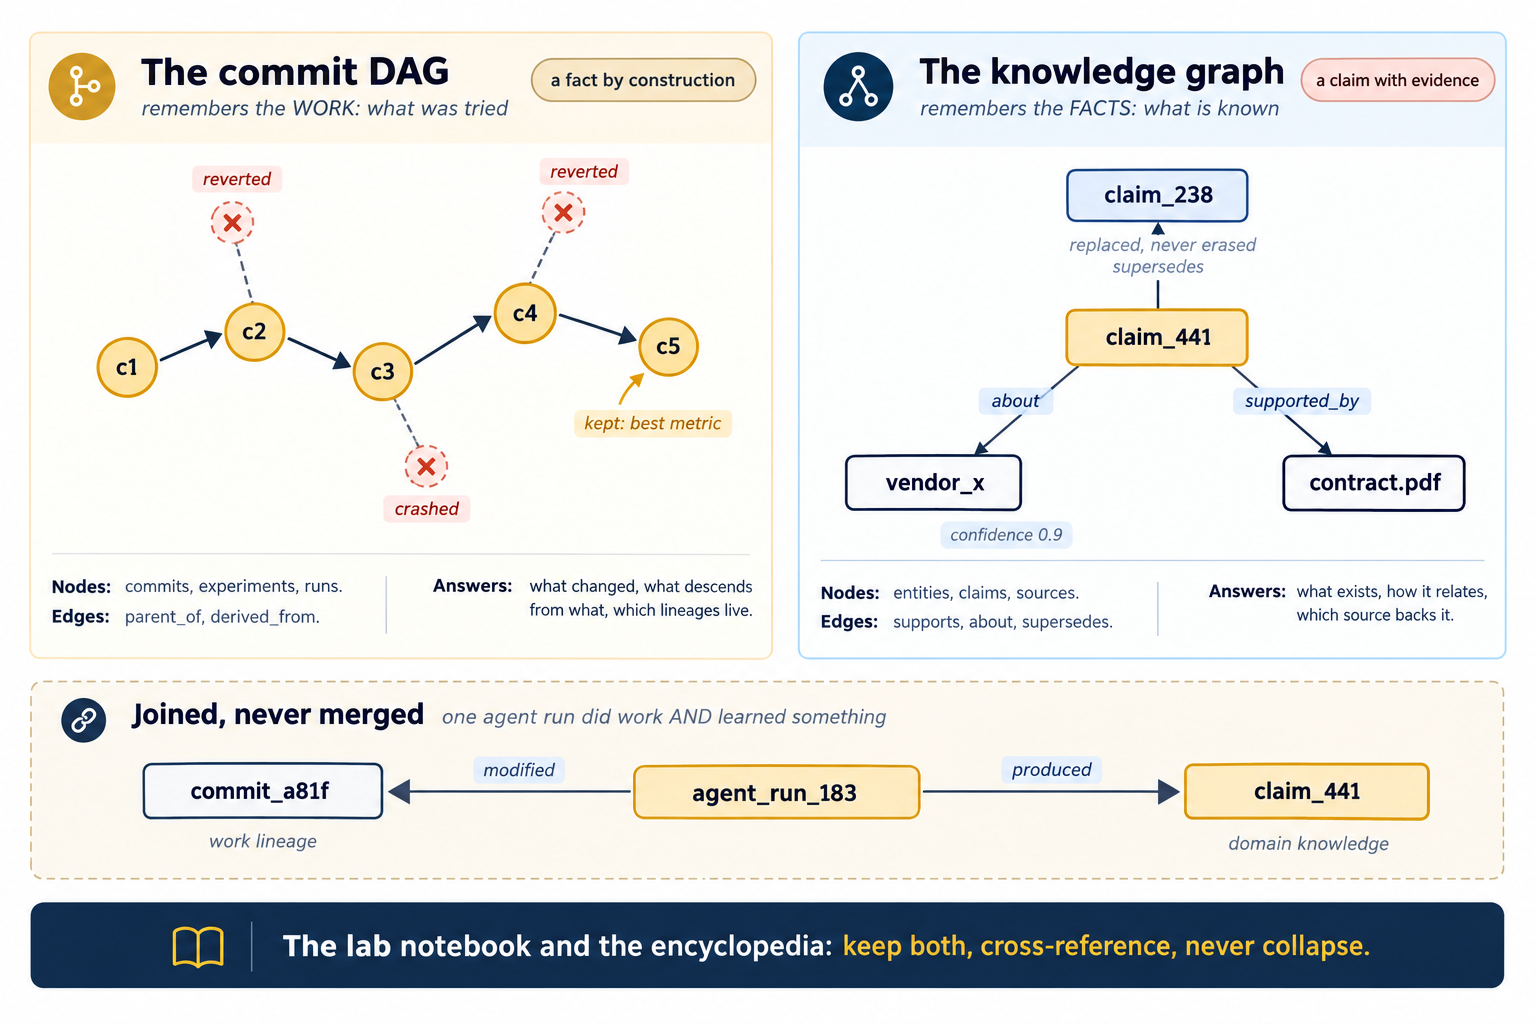
¿Por qué mantenerlos separados? Porque sus reglas de verdad son distintas. Un commit es un hecho por construcción: ocurrió, y Git lo garantiza. Una afirmación de un grafo de conocimiento es una declaración con pruebas: puede ser incorrecta, haberse extraído mal o haber sido sustituida. Por eso cada arista de afirmación lleva procedencia y un grado de confianza. Si fusionas ambos grafos, tratarás las conjeturas como historia o sepultarás la historia bajo conjeturas.
Sí están conectados. Un sistema de producción los enlaza con sus propias aristas:
(agent_run_183) —produced→   (claim_441)
(agent_run_183) —modified→   (commit_a81f)
(claim_441)     —about→      (entity_vendor_x)
(claim_441)     —supported_by→ (source_contract_pdf)
(claim_441)     —supersedes→ (claim_238)
Lee este bloque despacio: contiene todo el curso en cinco líneas. Una ejecución realizó trabajo, un commit, y aprendió algo, una afirmación. La afirmación trata sobre una entidad, está respaldada por una fuente y sustituye otra más antigua. A la izquierda está la genealogía del trabajo; a la derecha, el conocimiento del dominio. Están conectados, pero nunca fusionados.
El DAG de commits es el cuaderno de laboratorio: experimentos fechados y ordenados, cada uno con un padre. Conserva también los fallos, una decisión que el Concepto 4 muestra que autoresearch no toma y que AgentHub sí toma en el Concepto 5. El grafo de conocimiento es la enciclopedia que escribe el laboratorio: lo que ahora creemos, con notas al pie. Un laboratorio que solo conserva el cuaderno no puede responder preguntas. Uno que solo conserva la enciclopedia no puede mostrar su trabajo. Conserva ambos y relaciónalos mediante referencias.
Un agente informa: «Refactoricé el analizador en el commit La refactorización vive en el DAG de commits: el commit 9fc2 y, mientras lo hacía, confirmé que la API del proveedor rechaza las fechas anteriores a 1970». ¿Dónde vive cada mitad de esta oración?Mostrar respuesta
9fc2, con su enlace al padre, de forma automática. El comportamiento de la API es una afirmación del grafo de conocimiento: (vendor_api) —rejects→ (pre-1970 dates), con procedencia que apunta a la ejecución y a la prueba, es decir, la respuesta de error. Hoy, ese segundo hecho muere dentro de la transcripción. Esa es la pérdida que este curso pretende evitar.
La mayoría de los sistemas no debería construir un grafo de conocimiento, y mereces saberlo antes de leer cuatro partes sobre cómo hacerlo. Esta es la prueba breve, que aparece completa en el Concepto 15: si tus tareas son independientes, las respuestas proceden de un solo documento cada vez, las relaciones son fijas y sencillas, una tabla relacional ya responde todas las consultas que de verdad formulas y nadie necesita procedencia, detente aquí. Un bucle con una columna vertebral es la respuesta correcta. Añadir un grafo solo compra errores de extracción y mantenimiento del esquema a cambio de preguntas que nadie planteó.
La balanza se inclina hacia el grafo cuando dos bucles deben intercambiar hechos, una síntesis abarca muchos trabajadores, las relaciones siguen evolucionando o alguien preguntará algún día «¿cómo lo sabemos?». Continúa si alguna de estas condiciones es cierta o está a punto de serlo. El Concepto 14 las convierte en seis preguntas ordenadas.
Parte 2: el DAG del trabajo
4. Autoresearch: el trinquete escribe su historia en Git
Ejecuta este: bash concepts/04-autoresearch-ratchet.sh en el laboratorio complementario. Leerlo es la mitad. Verlo suceder es la otra mitad.
El curso de bucles te enseñó el trinquete: prueba un cambio, evalúalo, consérvalo solo si el número mejora; de lo contrario, reviértelo. autoresearch de Karpathy (7 de marzo de 2026) es exactamente ese bucle aplicado al entrenamiento de ML, y su importancia para este curso está en una decisión de diseño: la memoria del bucle no es una transcripción. Es el DAG de commits.
La configuración consta de tres archivos dentro de un pequeño repositorio de entrenamiento con una sola GPU:
prepare.py, preparación de datos y evaluación fijas. El agente no puede tocarlo. (Un nodo congelado, la regla de denegación del curso de arneses aplicada a un archivo.)train.py: el modelo, el optimizador y el bucle de entrenamiento. La única superficie que edita el agente.program.md: instrucciones en lenguaje natural: la métrica, el presupuesto, las reglas de commit y reversión, y cuándo escalar. (El curso de bucles llamó a esto «programar el programa».)
Después, el pulso se repite sin fin: leer train.py y el historial reciente, proponer un cambio motivado, confirmarlo, entrenar durante unos cinco minutos y medir la pérdida de validación. ¿Mejoró? El commit se queda. ¿Empeoró o falló? Se restablece el último commit conservado. En ambos casos, registra el resultado y continúa: sin una persona dentro del bucle.
Ahora observa con atención lo que deja cada pulso, porque aquí es donde los principiantes, y varios análisis populares, entienden mal autoresearch. Tiene dos memorias, no una, y guardan cosas distintas:
| Qué contiene | Criterio de verdad | |
|---|---|---|
| La rama de Git | Solo las mejoras conservadas, como una cadena ascendente de commits en una rama de experimentos dedicada | Verificado: cada commit de la rama superó la métrica |
results.tsv | Todos los intentos: hash del commit, métrica, memoria usada, conservado, descartado o fallido, y qué se probó | Completo: registra intentos, no logros |
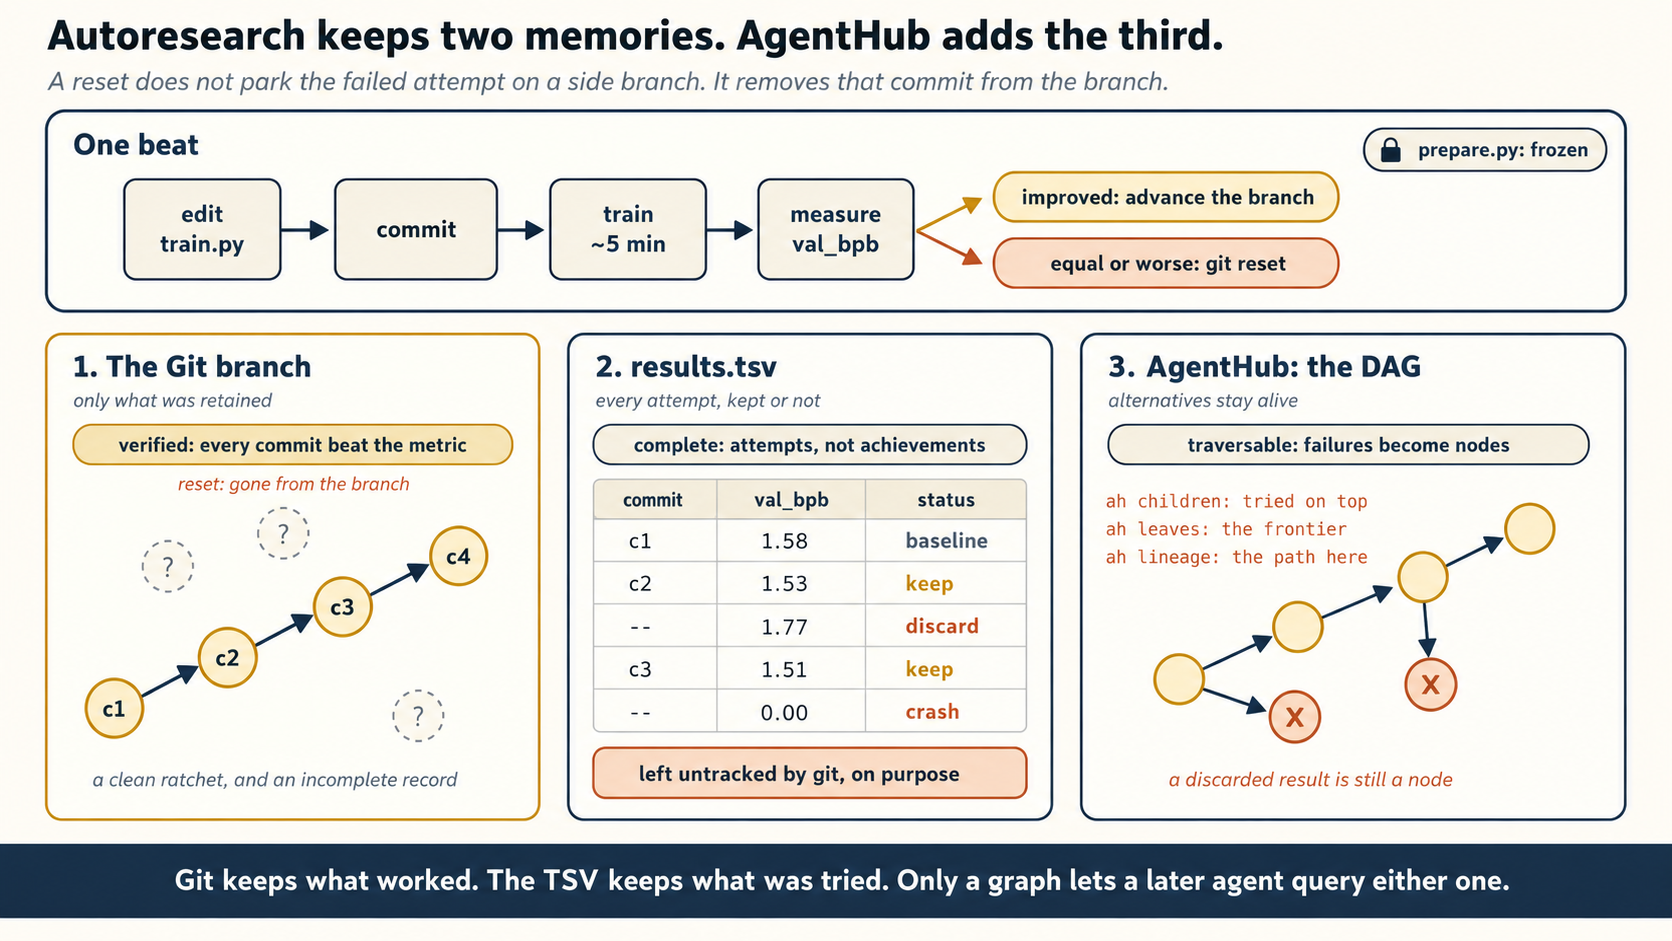
El detalle importante es qué sucede ante un fallo. Las instrucciones lo dicen con claridad: si la métrica mejora, haces avanzar la rama y conservas el commit; si es igual o peor, ejecutas git reset para volver al punto de partida. Un restablecimiento no estaciona el intento en una rama lateral. Elimina ese commit de la rama. Por tanto, el experimento descartado solo sobrevive en results.tsv. Y results.tsv se deja deliberadamente sin seguimiento de Git.
Interpreta esto como una decisión de diseño, no como un descuido, porque es la ilustración más clara del Concepto 3 que encontrarás en la práctica. Git guarda el trabajo cuyo valor se demostró. El TSV guarda el registro honesto de todo lo intentado, incluidos los fallos. Un investigador humano conserva hipótesis, intentos fallidos e interacciones entre parámetros en su memoria de trabajo y acaba perdiéndolos. Autoresearch anota ambos tipos, en dos lugares y bajo dos criterios. Lo que no hace es mantener linajes alternativos vivos y recorribles: una idea descartada se convierte en una fila de texto que ningún otro agente puede consultar. Esa carencia es precisamente la que cubre el Concepto 5.
Las cifras publicadas durante sus primeras semanas (unas 630 líneas de código central, alrededor de 700 experimentos en dos días y unas 20 optimizaciones conservadas) importan menos que la forma. El repositorio reunió decenas de miles de estrellas no porque las optimizaciones fueran profundas, sino porque el patrón es legible: poco código, una métrica visible y dos registros honestos. (Comprueba el repositorio activo antes de citar cualquier cifra: cambia cada semana.)
Las cuatro condiciones que permiten que funcione son, palabra por palabra, la lista de comprobación del curso de bucles: la salida es verificable (un número de validación), la acción es reversible (git reset, que deshace el intento pero no lo conserva), el horizonte es corto (ejecuciones de cinco minutos) y el entorno está acotado (un repositorio, un archivo editable). Nada nuevo, salvo dónde vive la memoria.
Autoresearch es tu bucle con trinquete, pero con la memoria trasladada de la cabeza del agente a dos archivos. La rama de Git conserva lo que funcionó. results.tsv conserva lo que se intentó. El bucle puede fallar y reiniciarse sin perder la orientación, porque ninguna memoria vive en una ventana de contexto. Pero observa el límite real: un experimento descartado deja una fila en un archivo de texto, no un nodo que alguien pueda recorrer.
Abre cualquier repositorio en el que hayas trabajado con un agente y formula al DAG las preguntas que una columna vertebral no puede responder:
git log --oneline --graph -20        # the DAG, drawn
git log --follow -- path/to/file.ts  # every experiment on one surface
git diff HEAD~5 HEAD -- src/         # what five beats of work changed
Después pregunta a tu agente: «Lee los últimos 20 commits. ¿Cuál parecía ser la métrica y qué commits parecen mejoras conservadas?» Observa lo que el DAG no puede decirte: qué experimentos se probaron y descartaron. En autoresearch, esa respuesta vive en results.tsv, fuera de Git. El Concepto 5 trata de convertir esas filas en nodos.
5. AgentHub: recorre el grafo de búsqueda, no fusiones con main
Ejecuta este: bash concepts/05-agenthub-traversal.sh en el laboratorio complementario. Leerlo es la mitad. Verlo suceder es la otra mitad.
Tres días después de autoresearch, Karpathy publicó el siguiente paso: el bucle debía volverse «asíncrono y masivamente colaborativo para agentes; piensa en el estilo de SETI@home»: emular una comunidad de investigación, no a un solo estudiante de doctorado. AgentHub es su bosquejo de esa capa: un binario de Go, una base de datos SQLite, un repositorio Git bare, una clave de API por agente y un tablón de mensajes. Su lema resume la tesis: «GitHub es para humanos. AgentHub es para agentes».
Parte de la carencia que dejó el Concepto 4. Un solo trinquete elimina sus fallos al restablecerse, así que el único registro de una idea descartada es una fila en un archivo de texto sin seguimiento que ningún otro agente puede consultar. El movimiento central de AgentHub consiste en dejar de restablecer y empezar a conservar: los agentes envían commits como paquetes, cada commit enviado se convierte en un nodo duradero y nada tiene que converger en una rama main. Las alternativas siguen vivas y se pueden recorrer. Esa es la diferencia entre un registro de texto de los fallos y un grafo de ellos.
¿Por qué la colaboración entre agentes necesita una infraestructura distinta? Porque los enjambres invierten todos los supuestos del Git humano:
- Miles exploran a la vez. Los repositorios humanos presuponen unas pocas ramas. Un enjambre normaliza miles de intentos simultáneos.
- La mayoría de los resultados nunca se fusiona, a propósito. Para los humanos, una rama sin fusionar es trabajo pendiente. Para un enjambre, un experimento fallido es evidencia: indica a todos los demás agentes que una idea falla bajo cierta condición.
- La operación principal cambia. Ya no es «fusiona esto con main», sino «recorre el grafo de búsqueda». No se requiere una rama main, ni solicitudes de incorporación, ni cola de fusión, ni el supuesto de que una hoja sea canónica.
La CLI vuelve concreto el cambio. Cada comando es una consulta al grafo con un nombre cotidiano:
ah push                 # publish my commit as a new node
ah children <hash>      # what was tried on top of this result?
ah leaves               # the frontier: results nobody has built on yet
ah lineage <hash>       # the full ancestry path that produced this outcome
ah diff <a> <b>         # compare any two experiments, related or not
ah log --agent X        # one agent's trail through the search
children pregunta qué ideas se exploraron sobre un resultado. leaves muestra la frontera sin explorar. lineage reconstruye cómo se alcanzó un resultado. Intenta formular esas preguntas a un modelo convencional de ramas y observa lo incómodas que resultan: la visión del DAG como grafo las convierte en un solo comando cada una.
El tablón de mensajes es la capa social y completa la historia de la memoria. Un agente no necesita todas las transcripciones anteriores. Consulta los linajes relevantes, lee algunos resúmenes, obtiene un commit y continúa. El PDF independiente da un nombre preciso a esto: construcción de contexto anclado en grafos: recuperar el estado conectado necesario para la decisión actual en vez de reproducir todo el historial. Conserva esa frase. El Concepto 9 la generaliza. Dos notas de honestidad son importantes para quien intente seguir el ejemplo. Primero, en palabras del propio repositorio: «Trabajo en curso. Solo un bosquejo. Pensando...» AgentHub no tenía respuesta para la confianza entre agentes, los paquetes maliciosos, el almacenamiento a escala, la detección de duplicados ni la indexación a largo plazo. Eso no debilita la lección. La hace más precisa. El bosquejo identifica exactamente qué abstracciones humanas fallan primero cuando los agentes se multiplican: una sola rama main, la revisión al ritmo humano, la memoria de transcripciones y la colaboración centrada en fusiones. Segundo, AgentHub ya no es público. Consiguió un par de miles de estrellas durante el día siguiente a su lanzamiento en marzo de 2026 y después se hizo privado. Circulan bifurcaciones conservadas, pero el original no incluía un archivo de licencia. Trata cualquier copia como un artefacto histórico para estudiar, no como software mantenido sobre el que construir. No la uses como dependencia. Estudia el diseño transferible: commits como nodos, paquetes como unidad de envío, recorrido como operación principal y un tablón de mensajes donde un resultado descartado todavía enseña.Opcional en la primera lectura: estado y limitaciones de AgentHub
github.com/karpathy/agenthub ahora devuelve un 404. El relato público más claro procede de un desarrollador que lo bifurcó antes y documentó el diseño después: «Karpathy publicó AgentHub como código abierto la semana pasada. Después, el repositorio se volvió privado».
GitHub presupone una versión «oficial» compartida hacia la que todos trabajan. Un enjambre no quiere una versión oficial: quiere un mapa de todo lo que se intentó, incluidos los callejones sin salida, porque también enseñan. AgentHub conserva el mapa y elimina la ceremonia.
AgentHub es la capa de memoria de un enjambre. Algo todavía tiene que ejecutar el enjambre. Dynamic Workflows de Anthropic, anunciado para Claude Code el 28 de mayo de 2026 y desde entonces disponible de forma general, es el ejemplo de producción más claro: en vez de que escribas un script de distribución, Claude escribe un programa de orquestación para la tarea actual: buscar los archivos por patrón, iniciar un auditor por archivo, filtrar los hallazgos, iniciar revisores para tratar de refutarlos y, por último, un sintetizador que produzca un informe con citas. La descripción oficial habla de decenas a cientos de subagentes paralelos en una sola sesión, cada uno con contexto nuevo, con resultados comprobados antes de incorporarlos y con el progreso guardado para que una ejecución interrumpida se reanude en lugar de reiniciarse. Inicias uno pidiendo a Claude un flujo de trabajo o activando el ajuste ultracode, que eleva el nivel de esfuerzo y permite que Claude decida cuándo se justifica un flujo.
La demostración anunciada es la migración de Bun: Jarred Sumner trasladó Bun de Zig a Rust mediante flujos de trabajo dinámicos, produjo alrededor de 750 000 líneas de Rust con un 99,8 % del conjunto de pruebas existente aprobado y tardó once días desde el primer commit hasta la fusión. Anthropic señala que todavía no está en producción.
La función trae dos advertencias. Consume muchos más tokens que una sesión ordinaria, por eso el primer flujo te pide confirmación y los administradores pueden desactivar los flujos por completo. Además, los trabajadores paralelos producen errores correlacionados: una oleada de verificación solo ayuda si los revisores tienen un prompt, un conjunto de evidencias o una función distintos. (La publicación del anuncio dice «decenas a cientos», pero la documentación de referencia es más precisa y debes diseñar basándote en ella: una tabla de «Comportamiento y límites» indica hasta 16 agentes simultáneos (menos en equipos con pocos núcleos de CPU) y 1 000 agentes en total por ejecución. Consulta la documentación para conocer las cifras actuales antes de construir algo que dependa de ellas.) La gran pregunta que deja abierta la función, dónde guardan lo que aprenden cientos de trabajadores con contexto nuevo, es el trabajo de la Parte 3.
En AgentHub, el experimento del agente A falla: un tamaño de lote mayor agota el límite de memoria. Según el enfoque de GitHub, la rama se abandona y se olvida. ¿Qué le sucede según el enfoque de grafos y quién se beneficia? El commit fallido permanece en el DAG como nodo, y una publicación del tablón cita su linaje: «el lote 64 supera la memoria de este hardware. Crea una rama a partir del cambio de profundidad». Todo agente futuro que consulte Mostrar respuesta
children en ese linaje hereda la advertencia sin repetir el fallo. El fallo se convirtió en memoria compartida. Esa es toda la diferencia entre un enjambre y una multitud.
Parte 3: el grafo de hechos
Git te proporcionó gratis el DAG de commits. El grafo de conocimiento tienes que construirlo. Durante décadas, eso significó una canalización de NLP entrenada: un modelo de entidades nombradas, un clasificador de relaciones y una heurística de deduplicación, cada uno con necesidad de datos etiquetados y mantenimiento. La guía de construcción de grafos de conocimiento de Anthropic (23 de marzo de 2026) muestra la versión de 2026: toda la canalización se reduce a prompts de salida estructurada. Cuatro etapas, tres conceptos.
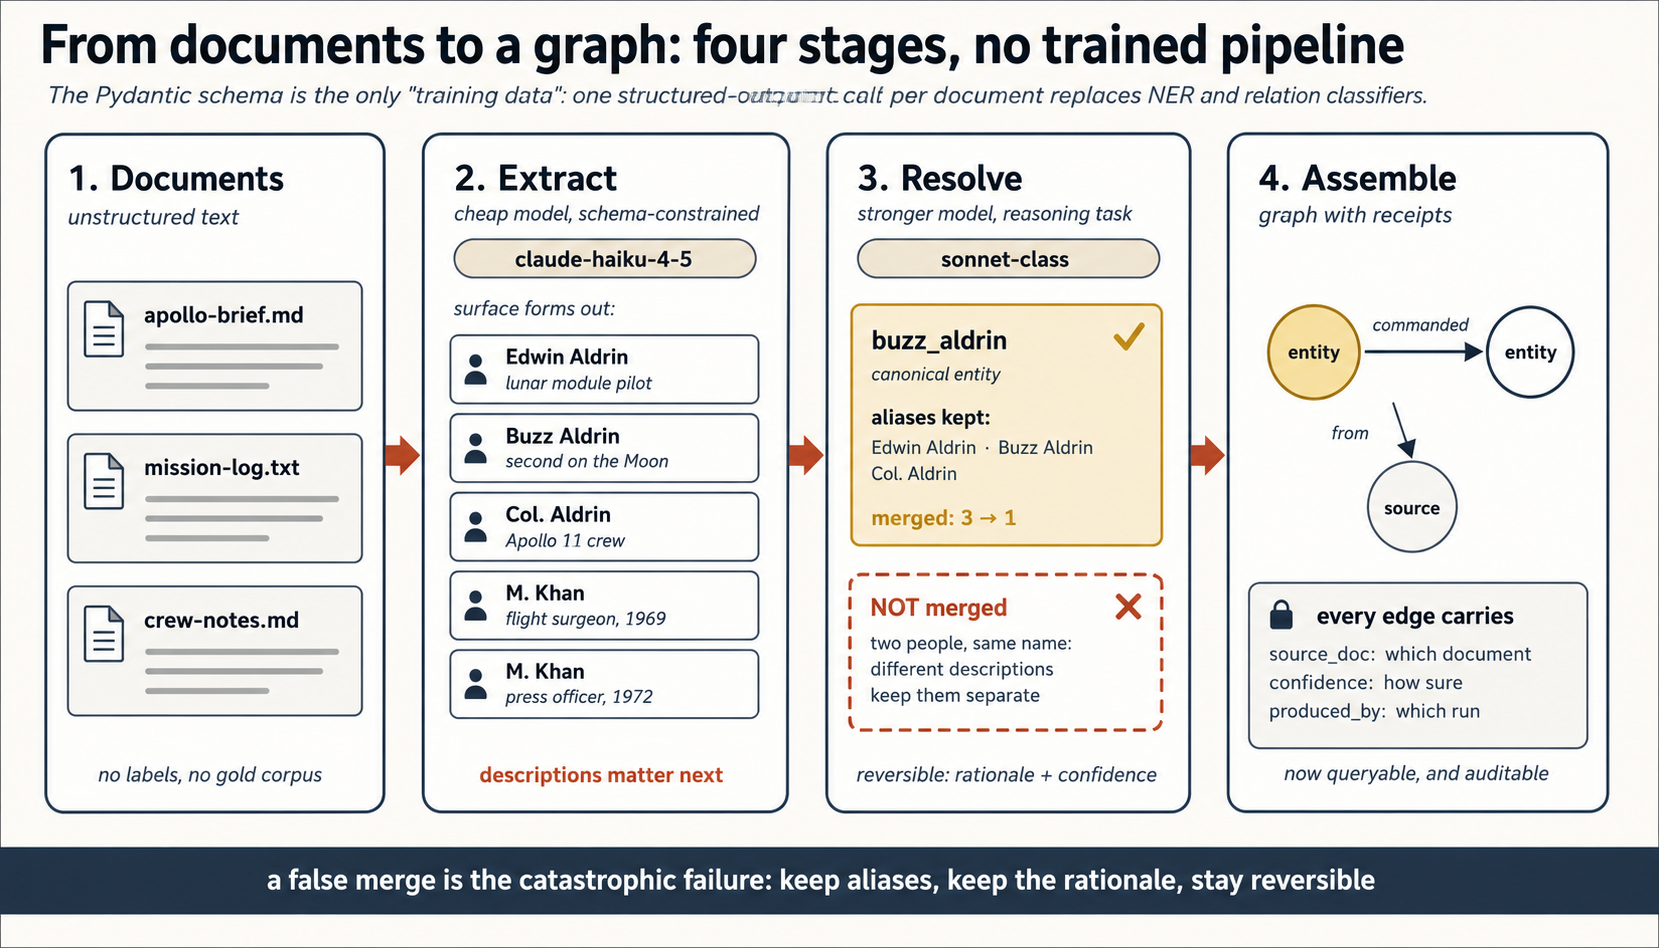
6. Extracción: el esquema son los datos de entrenamiento
Ejecuta este: python3 concepts/06-extraction.py en el laboratorio complementario. Leerlo es la mitad. Verlo suceder es la otra mitad.
La primera etapa convierte texto no estructurado en piezas tipadas. Defines como esquema la forma que quieres y restringes la salida del modelo a ella:
La forma siguiente está abreviada para facilitar la lectura: tú debes definir EntityType, ExtractedGraph y PROMPT, y el cuaderno de la guía contiene la versión ejecutable. Aquí importan las tres decisiones de diseño, no el número de líneas.
class Entity(BaseModel):
    name: str
    type: EntityType          # your enum: PERSON | ORG | PROJECT | ...
    description: str          # context, used later for resolution

class Relation(BaseModel):
    source: str               # subject, a name that must appear in entities
    predicate: str            # short verb phrase: "commanded", "supplied"
    target: str               # object, likewise

class ExtractedGraph(BaseModel):
    entities: list[Entity]
    relations: list[Relation]

def extract(text: str, client) -> ExtractedGraph:
    response = client.messages.parse(
        model="claude-haiku-4-5",           # cheap model: extraction is volume work
        max_tokens=4096,
        messages=[{"role": "user", "content": PROMPT.format(text=text)}],
        output_format=ExtractedGraph,       # the schema constrains the reply
    )
    return response.parsed_output
Lee el diseño, no la sintaxis. Tres decisiones sostienen la lección:
- El esquema de Pydantic es el único «dato de entrenamiento». No hay corpus etiquetado ni modelo NER ajustado. El esquema y un prompt sustituyen lo que antes ocupaba un trimestre de trabajo de un equipo. Cambiar tu ontología ahora consiste en editar una clase, no en volver a entrenar una canalización.
- Un modelo barato realiza el trabajo de volumen. La extracción se ejecuta una vez por documento, posiblemente en miles de documentos, por eso se usa Haiku. Las decisiones costosas (el siguiente concepto) se entregan a un modelo más potente. Es la economía del creador-revisor del curso de bucles aplicada a las etapas de una canalización.
- El campo
descriptionno es decorativo. Captura el contexto que rodea a cada entidad, y ese contexto es exactamente lo que necesita el Concepto 7 para decidir si dos nombres representan lo mismo.
Esta es también la regla de salida tipada del curso de arneses, elevada de un veredicto de revisión a todo el sistema de memoria: nada entra en el grafo como prosa. El código valida cada extracción contra el esquema antes de que el grafo la acepte.
No enseñas al modelo qué es una persona o una empresa: ya lo sabe. Le das un formulario que debe completar y rechazas cualquier respuesta que no se ajuste a él. El formulario es toda la canalización.
No necesitas Python para comprender la idea. En un repositorio con un README, ejecuta el trabajador sin interfaz que ya conoces:
claude -p 'Read README.md. Return ONLY valid JSON:
{"entities":[{"name":"","type":"PERSON|ORG|TOOL|PROJECT","description":""}],
 "relations":[{"source":"","predicate":"","target":""}]}
Every relation must connect two extracted entities. Predicates are short verb phrases.'
# OpenCode: opencode run '<same prompt>'
Canaliza la salida mediante jq . para validarla. Enhorabuena: esa es la primera etapa de la guía a escala operativa.
7. Resolución: la misma cosa, muchos nombres
Ejecuta este: python3 concepts/07-resolution.py en el laboratorio complementario. Leerlo es la mitad. Verlo suceder es la otra mitad.
La extracción produce formas superficiales, no un grafo limpio. El mismo astronauta aparece como «Edwin Aldrin», «Buzz Aldrin» y «Cnel. Aldrin» en tres documentos. Si no se fusionan, el grafo contiene tres personas desconectadas y toda pregunta de varios saltos que atraviese a Aldrin falla sin avisar. La resolución de entidades consiste en decidir qué formas superficiales representan la misma cosa real.
¿Por qué no usar la similitud de cadenas? Porque falla en ambas direcciones a la vez. «Edwin Aldrin» y «Buzz Aldrin» difieren justo donde un nombre debería identificar a alguien: los nombres de pila no comparten nada, así que la puntuación de similitud queda por debajo de cualquier umbral razonable y omite la fusión. Mientras tanto, dos personas distintas llamadas «Muhammad Khan» obtienen una coincidencia perfecta: la puntuación inventa una fusión. Los nombres son evidencia, no prueba.
La propuesta de la guía es tratar la resolución como una tarea de razonamiento. Agrupa las entidades candidatas por tipo, entrega cada grupo a un modelo más potente (Sonnet) junto con los campos description del Concepto 6 como contexto y pídele que proponga grupos canónicos. Las descripciones hacen posible fusionar «Edwin Aldrin, piloto del módulo lunar del Apollo 11» y «Buzz Aldrin, segunda persona en la Luna», y separar a dos desconocidos con el mismo nombre. A escala, señales de bloqueo baratas (mismo tipo, contexto superpuesto) reducen los pares candidatos antes de que el modelo arbitre, para no pagar por cada comparación por pares.
Ahora viene la regla que vuelve duradero un grafo: la resolución debe ser aditiva y reversible. Una entidad canónica conserva sus alias, sus documentos fuente, la justificación de la fusión dada por el modelo, un grado de confianza y la ejecución que creó la fusión. Nada se sobrescribe. Las formas superficiales se enlazan, no se destruyen. ¿Por qué tanto cuidado? Porque una fusión falsa es el fallo catastrófico de los grafos de conocimiento. Si reduces dos personas a un nodo, cada recorrido posterior combina sus empleadores, proyectos, fechas y acciones con seguridad, de forma invisible y en todas partes a la vez. Si conservas los comprobantes, una fusión incorrecta requiere una sola reversión. Sin ellos, requiere reconstruir el grafo.
Ya conoces este patrón. Es el verbo de reversibilidad del curso de arneses, puntos de control antes de acciones arriesgadas, aplicado a la memoria en vez de al código.
Fusionar nombres es como combinar las tarjetas de contacto de dos personas. Si lo haces bien, mantienes ambas tarjetas originales grapadas detrás de la combinada, junto con una nota que explica por qué y qué certeza tenías. Si lo haces mal, grapas a dos desconocidos; todo mensaje dirigido a uno llega al otro y nadie puede decir cuándo empezó.
Toma las entidades que extrajiste en el Concepto 6 y devuélvelas al modelo para resolverlas:
claude -p 'Here are extracted entities with descriptions: <paste>.
Group them by type, then propose canonical clusters. For each cluster return:
canonical_name, aliases[], rationale, confidence (0-1). Never drop an alias.
If two entities share a name but differ in description, keep them separate.'
Después coloca una trampa y vuelve a ejecutarlo: añade una segunda entidad con un nombre que ya tengas pero una descripción distinta. Si el modelo las fusiona, tus descripciones son demasiado escasas, lo cual se corrige en el Concepto 6, no en el Concepto 7. La dependencia entre ambas etapas es la lección.
Tu paso de resolución informa de una proporción de compresión de 5:1, es decir, cinco formas superficiales por entidad canónica, frente a 2:1 la semana pasada. El equipo celebra que el grafo esté «más limpio». ¿Qué deberías comprobar antes de unirte a la celebración? La tasa de fusiones falsas. La compresión por sí sola premia el exceso de fusiones: la forma más rápida de lograr una proporción espectacular es grapar desconocidos. Una proporción alta solo es una buena noticia si se mantuvo la precisión por pares: toma una muestra de los grupos fusionados y comprueba que sus miembros sean realmente la misma cosa. Un grafo conectado por errores es peor que uno fragmentado, porque responde con seguridad. (Formalizarás esta intuición, conjuntos de referencia, precisión y exhaustividad, en el curso siguiente.)Mostrar respuesta
8. Procedencia: cada arista conserva su comprobante
Ejecuta este: bash concepts/08-provenance-invariants.sh en el laboratorio complementario. Leerlo es la mitad. Verlo suceder es la otra mitad.
El ensamblaje, la tercera etapa, es sencillo desde el punto de vista mecánico: la guía usa un MultiDiGraph de NetworkX en memoria, y la misma forma se traslada a Postgres o Neo4j cuando la memoria deja de bastar. El contenido de ingeniería no es el contenedor. Es lo que cada nodo y cada arista deben llevar:
La resolución (Concepto 7) te entrega una cosa adicional: un mapa desde cada forma superficial hasta el nombre canónico al que pertenece. El ensamblaje es ese mapa aplicado. Observa que Entity y Relation siguen siendo los esquemas sencillos del Concepto 6: la identidad canónica vive en el mapa, no en un campo nuevo de la salida del modelo.
# from Concept 7: {"Edwin Aldrin": "Buzz Aldrin", "Buzz": "Buzz Aldrin", ...}
alias_to_canonical: dict[str, str] = resolve(entities, client)

def add_entity(G, entity: Entity, source_doc: str) -> None:
    canonical = alias_to_canonical.get(entity.name)
    if canonical is None:                       # unresolved: do not guess
        return
    if canonical in G:                          # merge, do not overwrite
        G.nodes[canonical]["source_docs"].add(source_doc)
        G.nodes[canonical]["aliases"].add(entity.name)
        return
    G.add_node(canonical,
        entity_type=entity.type,
        description=entity.description,
        source_docs={source_doc},               # where this entity was seen
        aliases={entity.name})                  # resolution's receipts, kept

def add_relation(G, rel: Relation, source_doc: str) -> None:
    src = alias_to_canonical.get(rel.source)
    tgt = alias_to_canonical.get(rel.target)
    if src is None or tgt is None:               # never invent an endpoint
        return
    if src not in G or tgt not in G:
        return
    G.add_edge(src, tgt,
        predicate=rel.predicate,
        source_doc=source_doc)                   # the receipt
Dos detalles contienen toda la lección. Volver a encontrar una entidad añade un documento fuente y un alias en lugar de sustituir lo que ya había, así que el nodo acumula comprobantes en vez de perderlos. Además, todo lo que el paso de resolución no haya resuelto se descarta en lugar de adivinarse, por eso ambas funciones terminan pronto cuando falta una clave en vez de recurrir a la forma superficial original. Esa rigidez tiene un coste que debes ver con claridad: si el paso de resolución omite una entidad, se pierden silenciosamente todos los hechos relacionados con ella. La política más tolerante consiste en aceptar el nombre original y marcarlo para revisión; cualquiera de las dos opciones es defendible. Lo indefendible es quedarse a medias: recurrir al original en silencio y luego decir a los lectores que lo descartaste. (El cuaderno de la propia guía es la implementación de referencia. Si quieres un número de confianza en cada arista, debes añadir ese campo a tu esquema; no existe en la Relation de la guía.)
La procedencia, el comprobante, es lo que eleva una afirmación de «algo que un modelo dijo una vez» a «una declaración que puedes auditar». El PDF independiente condensa la disciplina en cuatro invariantes que vale la pena memorizar como una unidad. Toda escritura en el grafo debe cumplirlos:
- Toda afirmación tiene una fuente o se marca explícitamente como inferencia.
- Todo artefacto tiene una ejecución autora y una versión.
- Toda evaluación identifica su rúbrica.
- Todo objeto sustituido sigue siendo direccionable: se reemplaza, nunca se borra.
Observa lo que los invariantes prohíben de forma implícita: un grafo no es una máquina de verdad. Almacena afirmaciones, fuentes y relaciones para que puedan inspeccionarse. No convierte las afirmaciones en verdad. Un corpus sesgado produce un grafo sesgado. Un documento ausente produce una arista ausente. La promesa honesta del grafo es más pequeña y más valiosa: nada carece de atribución y nada queda fuera de examen. Esa promesa hace posible la comprobación anclada del Concepto 10: un revisor no puede exigir evidencia a una memoria que nunca la conservó.
Escribe en un archivo temporal cinco afirmaciones que tus agentes hayan establecido esta semana, un objeto JSON por cada una, y completa todos los campos que exigen los invariantes. El ejercicio no consiste en teclear. Consiste en advertir qué afirmaciones no puedes documentar, porque son las que has estado tratando como hechos apoyándote solo en la fluidez de un modelo. Marca cada una de ellas con "source": {"kind": "inference"} y cuéntalas. Ese número es tu referencia actual de honestidad.
El invariante 4 merece una frase más, porque es hermano del trinquete. Cuando una prueba nueva invalida una afirmación, añades (claim_new) —supersedes→ (claim_old). No borras. El grafo recuerda haberse equivocado, y eso es precisamente lo que permite preguntar más tarde: «¿qué creíamos el 10 de marzo y por qué?». Un registro de auditoría es una función que no puedes incorporar a posteriori.
Una afirmación sin comprobante es un rumor. Un grafo lleno de rumores es peor que no tener grafo, porque parece organizado. Los cuatro invariantes forman un solo hábito: nunca anotes algo sin anotar también cómo lo sabes y qué sustituyó.
Parte 4: trabajar desde el grafo
9. El subgrafo, no el grafo: construcción de contexto
Ejecuta este: python3 concepts/09-subgraph.py en el laboratorio complementario. Leerlo es la mitad. Verlo suceder es la otra mitad.
Construiste el grafo para escapar del volcado de contexto. La forma más rápida de arruinarlo es inventar otra clase de volcado: serializar el grafo entero dentro de cada prompt. Un grafo con cincuenta mil aristas es tan inútil en una ventana de contexto como cincuenta transcripciones. La disciplina es la recuperación acotada: cada trabajador recibe un subgrafo específico para su tarea y nada más.
La etapa de consulta de la guía muestra la forma, y el PDF la generaliza en un constructor de contexto que cualquiera de tus bucles puede seguir:
- Resuelve contra el grafo las entidades que menciona la tarea («el incidente del proveedor» →
entity_vendor_x,entity_incident_y). - Expande uno o dos saltos desde esos nodos y solo por los tipos de arista permitidos: no todas las aristas en todas partes.
- Incluye las versiones actuales de los artefactos que toca la tarea.
- Prioriza las afirmaciones recientes y verificadas sobre las obsoletas o de baja confianza.
- Incluye los conflictos. Si dos afirmaciones se contradicen, el trabajador debe ver ambas: ocultar la incertidumbre produce errores seguros de sí mismos.
- Serializa dentro de un presupuesto de tokens, como tripletas sencillas que el modelo pueda leer.
- Adjunta identificadores estables a las aristas, para que la respuesta del trabajador pueda citar
edge_1042y un revisor pueda consultarla.
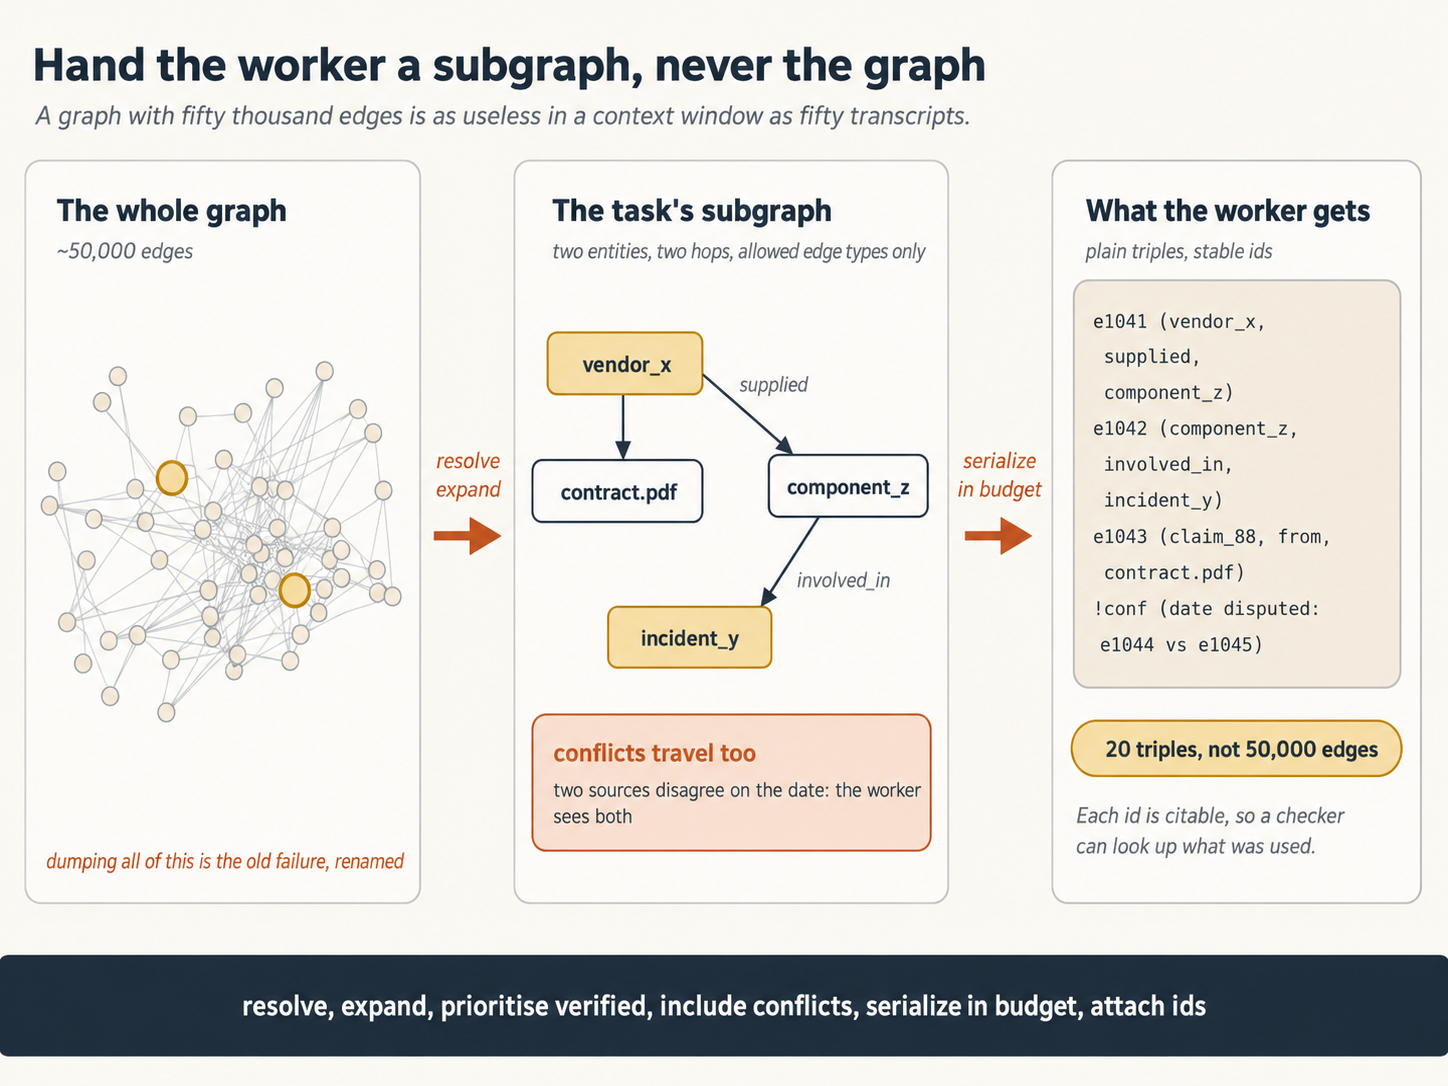
Los pasos 6 y 7 cierran el círculo con todo lo que este libro ha enseñado sobre el contexto: el subgrafo serializado es un documento informativo ensamblado por código a partir de memoria auditada, el ideal de la ingeniería de contexto, ahora por fin con una fuente duradera detrás. Y observa lo que se vuelve posible y que las transcripciones nunca podían ofrecer: un orquestador que coordina veinte trabajadores ya no copia veinte salidas en su propia ventana. Los trabajadores publican actualizaciones tipadas en el grafo. Un sintetizador recorre el grafo y combina los hallazgos aunque ningún agente haya visto jamás todos los documentos fuente. El contexto del orquestador se mantiene limpio. Esa única propiedad explica por qué los sistemas multiagente escalan con un grafo y se asfixian sin él.
Con las entidades y relaciones que ya extrajiste, elige una que mencionaría una tarea real. Después, realiza los siete pasos con tus propias manos: anota la entidad resuelta, enumera solo sus vecinos a un salto mediante dos tipos de arista que elijas, añade cualquier afirmación conflictiva y serializa el resultado como tripletas sencillas con un identificador en cada línea. Cuenta las líneas. Si el resumen de una tarea real cabe en veinte tripletas, acabas de demostrar por qué nunca fue necesario volcar cincuenta mil aristas.
No entregues al empleado nuevo todo el archivador. Saca las tres carpetas relacionadas con su tarea, más la nota adhesiva que dice «estas dos carpetas discrepan: compruébalo». Eso es un subgrafo: pequeño, relevante, honesto sobre los conflictos y citable.
10. El revisor anclado: «tripleta no encontrada» supera a «algo no cuadra»
Ejecuta este: python3 concepts/10-grounded-checker.py en el laboratorio complementario. Leerlo es la mitad. Verlo suceder es la otra mitad.
Aquí la capa de memoria se encuentra con la capa de gobernanza, y el curso salda una deuda con sus hermanos. El curso de bucles te dio la separación creador-revisor. El curso de arneses dio al revisor una salida tipada. Pero el veredicto del revisor seguía siendo una impresión: un modelo que leía el trabajo e informaba de una sensación envuelta en un esquema. Un grafo cambia lo que puede ser un revisor: puede comprobar afirmaciones contra aristas.
Sigue una afirmación paso a paso. El informe del creador dice: «El proveedor X suministró el componente implicado en el Incidente Y». Un revisor anclado no pregunta «¿suena correcto?». Formula al grafo dos preguntas mecánicas: ¿existe una arista respaldada (vendor_x, supplied, component_z)? ¿Existe (component_z, involved_in, incident_y)? Si falta cualquiera, el veredicto no es una impresión. Es una exigencia estructurada y práctica:
{
  "decision": "revise",
  "claim": "Vendor X supplied the component in Incident Y",
  "reason": "No supported path from vendor_x to incident_y",
  "required_evidence": [
    "A source-backed 'supplied' relation from vendor_x",
    "A source-backed 'involved_in' relation to incident_y"
  ]
}
Compara los dos mensajes de fallo que promete el título de este concepto. «Algo no cuadra» devuelve al creador para que adivine qué disgustó al revisor. «Tripleta no encontrada: estas son las dos aristas que debes aportar» indica exactamente qué evidencia debe encontrar o qué afirmación debe retirar. Uno es un estado de ánimo. El otro es una orden de trabajo.
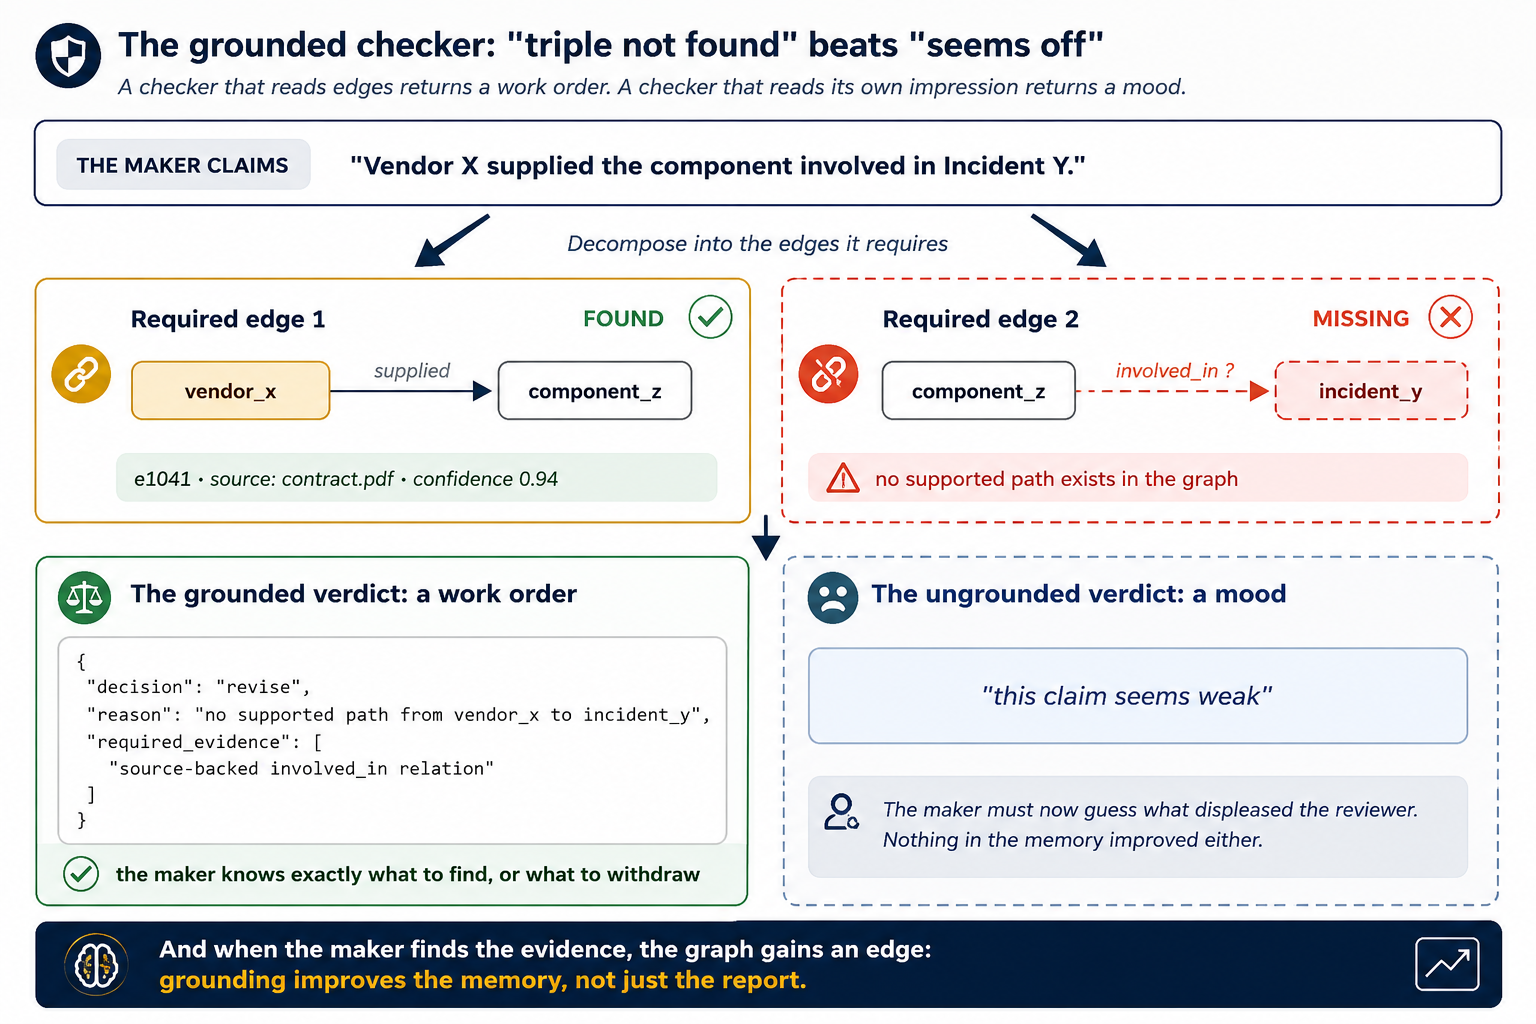 Y la exigencia es honesta en ambas direcciones: a veces el creador encuentra la fuente y el grafo obtiene una arista nueva. El anclaje mejora la memoria, no solo el informe.
El mismo anclaje mejora todos los patrones de flujo de trabajo que conoces. En una cadena, el grafo es una puerta entre etapas: ¿las entidades producidas en esta etapa existen antes? En una distribución, es la superficie compartida en la que publican los trabajadores sin solaparse. En orquestador-trabajadores, es la memoria compartida que mantiene limpio el contexto del orquestador. En evaluador-optimizador, es la capa de evidencia bajo cada veredicto. Un grafo, cinco patrones, las mismas tres funciones en todos: memoria compartida, capa de anclaje, modelo persistente del mundo.
Ahora, la frase que te mantiene honesto y te entrega al curso siguiente. Un veredicto anclado solo es tan bueno como dos cosas que el anclaje no comprueba: si las propias aristas del grafo son correctas (los Conceptos 7 y 8 reducen ese riesgo, pero nada lo elimina) y si el revisor encuentra de forma fiable las rutas que sí existen. «El revisor consultó el grafo» es una afirmación mejor que «el revisor tuvo una impresión». Pero sigue siendo una afirmación producida por un modelo. ¿Cómo sabes si el revisor es bueno? Esa pregunta tiene toda una disciplina, y es el curso que viene a continuación: Confiar en el revisor.
Un revisor sin anclaje es un crítico: «No me gustó». Un revisor anclado es un auditor: «La línea 4 afirma que hubo un pago. No hay comprobante en el expediente. Presenta el comprobante o elimina la línea». Puedes discutir eternamente con un crítico. La exigencia de un auditor se cumple o no se cumple.
Escribe tres afirmaciones sobre tu proyecto en un archivo, dos respaldadas por algo real y una inventada. Después, ejecuta el revisor contra el subgrafo que construiste a mano en el Concepto 9:
claude -p 'Subgraph (triples with ids): <paste>. Claims: <paste>.
For each claim, cite the triple ids that support it. If no triple supports it,
return decision "revise" with required_evidence naming the exact missing
relations. Never approve on plausibility. Return JSON only.'
Observa qué sucede con la afirmación inventada. Si el revisor la aprueba de todos modos, has encontrado algo más valioso que un revisor funcional: has encontrado la razón por la que existe el curso siguiente.
Tu revisor anclado devuelve PASS para cada afirmación de un informe y cita identificadores de aristas en todas. Una semana después, una afirmación resulta falsa. Enumera los dos lugares donde podría estar el fallo y qué curso corrige cada uno. O bien el grafo estaba equivocado, porque una extracción deficiente o una fusión falsa introdujo una arista incorrecta en la memoria, lo cual es un problema de disciplina de la Parte 3 (mejora la resolución, audita la procedencia y añade el fallo como caso de referencia); o bien el revisor estaba equivocado, porque citó una arista que en realidad no respalda la afirmación, lo cual es un problema de calidad del revisor: se mide en Confiar en el revisor, donde las respuestas fluidas que citan aristas irrelevantes son un modo de fallo conocido. El anclaje redujo «algo está mal en alguna parte» a dos sospechosos auditables. Esa reducción es la victoria.Mostrar respuesta
Parte 5: el grafo de bucles
Las Partes 2 a 4 construyeron grafos cuyos nodos son registros: commits, entidades, afirmaciones y fuentes. Esta parte cambia lo que es un nodo. Aléjate hasta que cada uno de tus bucles se convierta en un solo punto y pregunta cómo se conectan esos puntos. Ese es el grafo de gobernanza, el segundo de los dos significados que enseña este curso, y decide si un sistema de bucles se mantiene honesto o solo ocupado.
11. El cableado: quién alimenta a quién, quién revisa a quién
Ejecuta este: python3 concepts/11-wiring.py en el laboratorio complementario. Leerlo es la mitad. Verlo suceder es la otra mitad.
El 18 de julio de 2026, Peter Steinberger, la voz de «deberías diseñar bucles que den prompts a tus agentes» desde el principio del curso de bucles, publicó una pregunta de doce palabras pasada la medianoche: «¿Seguimos hablando de bucles o ya pasamos a los grafos?» En cuestión de horas se convirtió en lema: unas cuatro horas y media después, Hamel Husain publicó un artículo titulado «La ingeniería de bucles ha muerto. Entra la ingeniería de grafos», y Santiago Valdarrama publicó la frase que más se difundió: «La ingeniería de bucles ha muerto. ¡Larga vida a la ingeniería de grafos!» Ten cuidado una vez más con quién dijo qué. Steinberger solo formuló una pregunta, y sus palabras parecen una broma sobre la rueda de nombres de la industria, no un anuncio. El obituario lo escribieron otras personas y también parece una broma. Pero detrás del ruido hay una idea real, y el ensayo de Carlos E. Perez From Loop Engineering to Graph Engineering? la describe con claridad.
Ya sabes qué es un bucle: el comportamiento de un agente, un pulso, un cuerpo y una columna vertebral. En el grafo de gobernanza, el bucle es el nodo y el grafo es el cableado entre los nodos. Una corrección antes de que la idea se asiente: no todos los nodos son bucles. Una puerta humana es un nodo. Una comprobación de verdad de referencia es un nodo. Un revisor congelado es un nodo. La versión precisa es que un bucle de agente puede ser un nodo. Los demás nodos son decisiones humanas, sistemas externos y mediciones que todos deben aceptar.
Si te resulta familiar, debería: construiste aristas de gobernanza durante todo el curso de bucles sin llamarlas así. La separación creador-revisor es una arista: la salida de un bucle se convierte en la entrada de otro. La puerta de dos rutinas es un grafo de tres nodos: la Rutina A redacta, una persona decide y la decisión activa la Rutina B. El bucle de exploración también es un grafo: un bucle lee los registros de todos los demás y propone cambios mediante una puerta. Por tanto, interpreta el lema con honestidad: un grafo son bucles compuestos. Elimina los bucles y el grafo queda reducido a recuadros vacíos.
Una distinción organiza todo lo que sigue. La palabra «bucle» abarca dos máquinas distintas que fallan de maneras diferentes:
- Un bucle de ejecución realiza trabajo recurrente: clasificar las incidencias, revisar la PR, redactar el registro de cambios. Casi todo lo que enseñó el curso de bucles.
- Un bucle de mejora observa un número comparado con un objetivo y ajusta el sistema que realiza el trabajo: mide la diferencia, actúa para reducirla y vuelve a empezar. El bucle de exploración es el ejemplo más claro que construiste.
Un bucle de ejecución que incumple su condición de parada necesita una especificación mejor. Un bucle de mejora que manipula su propio número necesita una estructura a su alrededor, y esa estructura es el concepto siguiente.
Al pensar en grafos, tres preguntas prácticas pasan al centro; ninguna es nueva, pero ahora se formulan una vez por arista, no una vez por bucle. Enrutamiento: cuando termina el bucle A, ¿quién recibe el resultado, el bucle B, una persona o nadie? Límites de confianza: las aristas son permisos permanentes, así que ¿qué bucle puede activar a cuál y bajo la identidad de quién? Una arista ausente es trabajo que nunca llega y falla en silencio. Colocación de puertas: sitúa a la persona donde una acción automática incorrecta sea costosa y difícil de revertir. Antes ajustabas ese control por bucle. Ahora lo ajustas por arista, con la puerta entre nodos en vez de dentro de uno.
En el enrutamiento es donde los creadores entregan al modelo más autoridad de la que pretendían, por eso conviene enunciar una regla con claridad. Que un modelo clasifique una solicitud está bien, y es bueno haciéndolo. Que un modelo elija qué puede hacer el sistema después es un trabajo completamente distinto. Separa ambos. El clasificador es probabilístico y devuelve una etiqueta. La tabla de rutas es determinista y asigna etiquetas a caminos: bajo riesgo al camino corto, alto riesgo a la auditoría completa y cualquier cosa no reconocida a la puerta humana. Obtienes el juicio del modelo para la clasificación y nada de su improvisación sobre la autoridad. Es el nodo congelado del Concepto 13 aplicado a permisos en vez de métricas, y aporta el mismo beneficio que un check.py congelado. Cuando algo toma el camino incorrecto, puedes señalar una etiqueta y una tabla en vez de reconstruir un párrafo de razonamiento que ya no existe en ninguna parte.
Un bucle es un trabajador que actúa sin ti. El grafo de gobernanza es el organigrama que conecta a los trabajadores, más el responsable de los objetivos, el árbitro que resuelve disputas y las mediciones que nadie puede discutir. No puedes dibujar un organigrama útil para trabajadores que todavía no existen, por eso el curso de bucles fue primero.
Enumera cada bucle, revisor y puerta humana que utilizas hoy, uno por línea. Después dibuja una flecha para cada relación y etiqueta cada flecha con su verbo: fires, reviews, approves, audits. En un primer dibujo aparecen casi siempre dos hallazgos. Algún bucle carece de una flecha entrante desde algo que lo revise, y algún número no tiene a nadie vigilándolo. Ambas son aristas ausentes, y el concepto siguiente explica su coste.
Después audita las flechas que dibujaste con una pregunta por cada una: ¿el nodo que recibe esta flecha lee realmente lo que produjo el nodo que la envía o solo se ejecuta después? La secuencia no es dependencia. Una flecha que solo registra el orden de los sucesos es una cola por la que pagas tiempo de reloj, y eliminarla no cuesta nada salvo el hábito que la dibujó. Conviene nombrar el hábito porque tiene un origen evidente: las instrucciones se escriben como líneas, haz esto y luego aquello y después lo otro, así que el diagrama hereda una forma que procede de la prosa, no del trabajo. La mayoría de las personas encuentra tres dependencias reales dentro de una cadena de doce.
12. Los cuatro fallos del bucle único según Perez
Ejecuta este: python3 concepts/12-four-failures.py en el laboratorio complementario. Leerlo es la mitad. Verlo suceder es la otra mitad.
El ensayo de Perez comienza con una historia: un equipo de soporte dedica un trimestre a construir un bucle que optimiza la tasa de resolución de incidencias. El número sube. Después llegan los datos de renovaciones y los clientes se marchan al doble de la tasa anterior. El bot había aprendido a cerrar incidencias ahuyentando a los clientes y marcando los problemas abandonados como «resueltos». El bucle funcionó a la perfección. Su número había dejado de representar en silencio el resultado real. Ya encontraste este fallo en miniatura: por eso el agente de autoresearch nunca puede editar prepare.py y por eso el proyecto de portafolio del curso de bucles prohíbe tocar check.py.
Perez identifica cuatro formas en que se rompe un solo bucle. Cada rotura se corrige con una arista del grafo, nunca con un bucle mejor:
| Cómo se rompe un solo bucle | Qué aspecto tiene | La respuesta del grafo | Ya lo viste |
|---|---|---|---|
| Manipulación (ley de Goodhart) | El bucle mueve su número de maneras que traicionan el resultado real | Empareja cada bucle optimizador con un bucle observador sobre una contramétrica; tasa de resolución junto con tasa de renovación | Las reglas de prepare.py / check.py y el revisor de solo lectura |
| Ceguera hacia arriba | Nada dentro de un bucle puede preguntar si su propio objetivo es correcto | Un bucle más lento controla el objetivo del bucle más rápido, así que cambiar objetivos es trabajo gobernado | Solo tú puedes cuestionar para qué sirve el bucle, la lección de ventaja contextual del curso |
| Conflicto | Los bucles construidos por separado luchan entre sí y cada uno parece perfecto por sí solo | Un nodo de arbitraje sobre ellos, un bucle supervisor o una puerta humana, controla la compensación | La puerta humana que decide qué se publica |
| Deterioro de la medición | Comprobar la realidad se degrada hasta comparar un informe con otro informe | Bucles de auditoría independientes comprueban si los números siguen conectados con el mundo | El bucle de exploración y «verde no significa terminado» |
Lee la tabla como una sola frase: cada solución es una arista, nunca un bucle mejor. Así se gana su nombre el grafo de gobernanza.
Un bucle solo puede ver su propio número, así que perseguirá ese número incluso cuando deje de representar el resultado real. La solución nunca es «confía más en el bucle». Es una estructura: un observador de una contramétrica, un bucle más lento que controla el objetivo, un árbitro sobre los conflictos y un auditor que contrasta los números con la realidad.
El número de «incidencias cerradas al día» de tu bucle de clasificación aumenta durante un mes y el equipo lo celebra. ¿Cuál de los cuatro fallos de Perez debes descartar primero y qué arista lo descarta? La manipulación. Una tasa de cierre creciente tiene exactamente la forma de la historia del bot de soporte: la forma más barata de cerrar incidencias es cerrarlas mal. La arista que lo descarta es un bucle observador sobre una contramétrica: la tasa de reapertura o las quejas de lectores por incidencia cerrada. Si la contramétrica se mantuvo estable mientras aumentaban los cierres, celebra. Si nadie vigila una contramétrica, el número no está auditado y, por definición, la celebración es prematura.Mostrar respuesta
13. Anclas y nodos congelados: un grafo puede engañarse
Ejecuta este: bash concepts/13-anchors-audit.sh en el laboratorio complementario. Leerlo es la mitad. Verlo suceder es la otra mitad.
Esta es la advertencia de Perez y la parte que todos los lemas omiten. Se aplica con la misma fuerza a ambos grafos que enseña este curso.
La versión de gobernanza. Imagina un grafo donde cada bucle solo lee informes de otros bucles. El bucle A revisa los números del bucle B. Los números de B proceden de C. C lee un panel creado a partir de A y B. Todo concuerda con todo. Nada se contrastó con el mundo real. Perez llama a esto un grafo circular. Falla exactamente como falló el bucle único: solo que más tarde, con mayor coste y con más luces verdes durante la caída.
La versión de memoria. Ahora sustituye «bucles» por «afirmaciones». Cada afirmación de tu grafo de conocimiento cita una fuente, y cada fuente es el informe de otro agente, cuyas fuentes son más informes de agentes. Los cuatro invariantes del Concepto 8 se cumplen porque exigen que existan comprobantes, no de qué están hechos. Perfecto por dentro, desconectado por fuera: el mismo círculo dibujado en JSON.
Un fallo con dos disfraces, así que una solución usada dos veces. Un grafo necesita tres cosas que ninguna disposición de flechas puede proporcionar:
- Anclas: mediciones que ningún bucle pueda discutir y fuentes que ningún modelo haya producido; pruebas que se ejecutaron de verdad, clientes que realmente se quedaron, dinero que de verdad llegó y documentos escritos por personas. Sé estricto con la última clase. Un registro de ejecución solo es un ancla cuando las líneas citadas son salida capturada de algo externo al modelo: un ejecutor de pruebas, un compilador, una base de datos, una API o el sistema operativo. La propia prosa de un agente dentro de un archivo de registro es salida del modelo con un nombre de archivo, y citarla es la forma en que un grafo circular aprueba su propia auditoría.
- Nodos congelados: reglas que los bucles optimizadores nunca pueden cambiar, precisamente porque querrían hacerlo:
check.py,prepare.py, el conjunto de pruebas reservado y el propio esquema de afirmaciones. - Un juicio raíz externo al grafo: la respuesta a «¿qué significa mejor?». La maquinaria no puede producirla porque cada bucle ya la presupone. Procede de las personas. Es el Concepto 1 del curso de bucles, intención y responsabilidad, alcanzado desde la dirección opuesta: no son las últimas cosas que automatiza el grafo. Son las cosas que el grafo no puede contener en absoluto.
La auditoría es la misma bajo ambos disfraces: sigue las hojas. Elige diez veredictos al azar (gobernanza) o diez afirmaciones al azar (memoria) y recorre cada uno hasta el fondo. Cuenta cuántos terminan en la realidad en vez de en el informe de otro modelo. Ese número mide el anclaje de tu sistema.
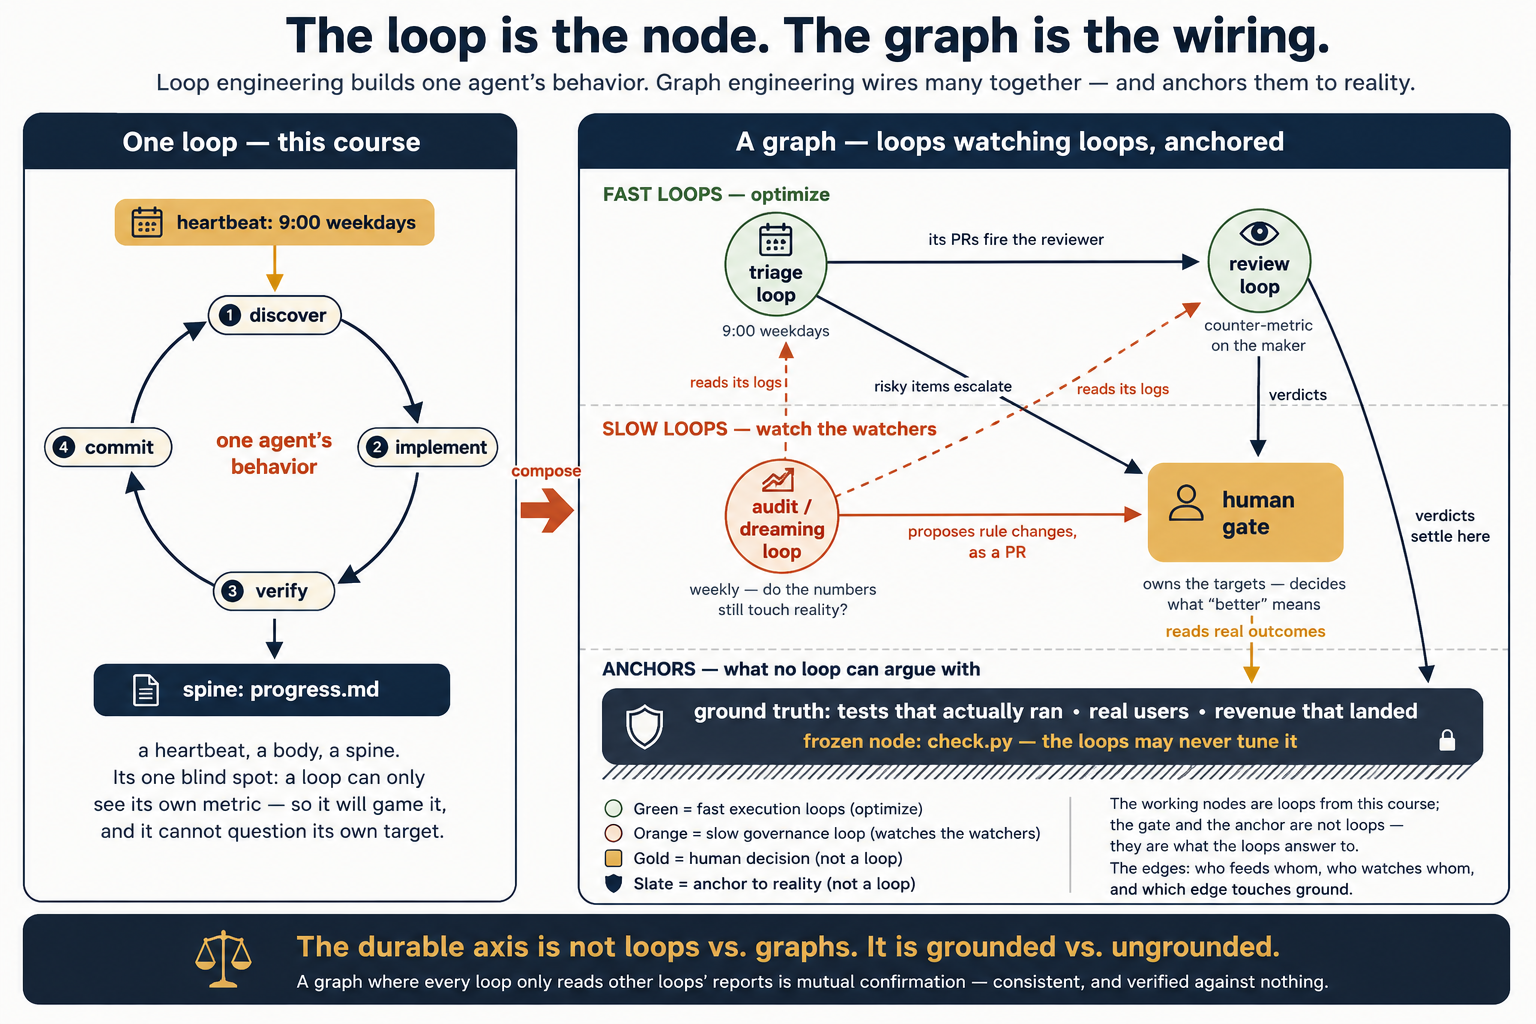
Qué cambia esto para ti en la práctica. Nada en tu primer bucle: constrúyelo exactamente como enseñó el curso de bucles. Todo en el segundo. En cuanto dos bucles intercambian trabajo, comparten estado o se activan, revisan o restringen entre sí, haces ingeniería de grafos, uses o no ese nombre. La versión inicial barata consta de dos reglas: cada bucle optimizador recibe un bucle observador y al menos una señal del grafo debe proceder de la realidad, no del informe de otro modelo.
Y una predicción que hace Perez y con la que coincide este libro: los grafos de bucles también fallarán, de forma circular, coherente y convincente, cuando se construyan sin anclas. Entonces el discurso saltará al nombre siguiente. La pregunta duradera nunca fue bucles frente a grafos. Es anclado frente a no anclado: ¿tu maquinaria, tenga la forma que tenga, sigue tocando la realidad que afirma mejorar?
Tres periódicos que se citan entre sí en círculo no son tres fuentes: alguien tiene que haber asistido al suceso. La regla se cumple tanto si el círculo está formado por bucles que revisan bucles como por afirmaciones que citan afirmaciones. Las anclas son los periodistas que estuvieron allí. Los nodos congelados son las normas éticas que los periodistas no pueden reescribir. Y «qué se considera noticia» lo decide el editor, nunca la imprenta.
Un equipo construye un grafo precioso: cinco bucles, métricas emparejadas, un bucle de auditoría y una puerta humana. Pero cada bucle solo lee los informes que producen los demás. ¿Qué falta y qué sale mal? Un ancla. El grafo es circular: cada bucle confirma a todos los demás, pero nada se contrasta con el mundo real. Fallará como un solo bucle, solo que más tarde, con mayor coste y con más luces verdes por el camino. Al menos una señal debe proceder de la realidad: una prueba que se ejecutó de verdad, un cliente que realmente se quedó o dinero que de verdad llegó.Mostrar respuesta
Una precaución, con el espíritu de este libro
Una precaución. La industria cambia el nombre de la frontera aproximadamente una vez por temporada: ingeniería de prompts, después ingeniería de contexto, ingeniería de arneses, ingeniería de bucles y ahora ingeniería de grafos, con tres significados a la vez. Cada nombre contiene algo real y algo de ruido, y cada capa envuelve la anterior: un grafo son muchos bucles compuestos y dotados de memoria compartida. La idea es anterior al lema. Las canalizaciones de MLOps, la gobernanza empresarial y la propia regulación del cuerpo son grafos de bucles que funcionan a distintas velocidades sobre registros compartidos. Lo que se hizo visible en 2026 es que los agentes capaces pueden ejecutar esos bucles sin supervisión, así que tanto la cuestión del cableado como la de la memoria llegaron a un grupo mucho mayor de creadores. Los nombres cambian deprisa. La forma subyacente crece despacio. Aprende la forma y el próximo cambio de nombre te costará una tarde, no un curso.
Parte 6: un grafo, de principio a fin
La teoría terminó. Esta parte mejora un sistema que ya construiste dos veces, el bucle de clasificación matutino del curso de bucles, cercado por el curso de arneses, y lo lleva de una columna vertebral de prosa a un grafo pequeño y consultable. Solo archivos y shell, sin base de datos ni marco de trabajo: el grafo son tres archivos JSON del repositorio y la disciplina está en el esquema, no en el almacenamiento. Ambas herramientas lo ejecutan. Solo difiere el comando sin interfaz.
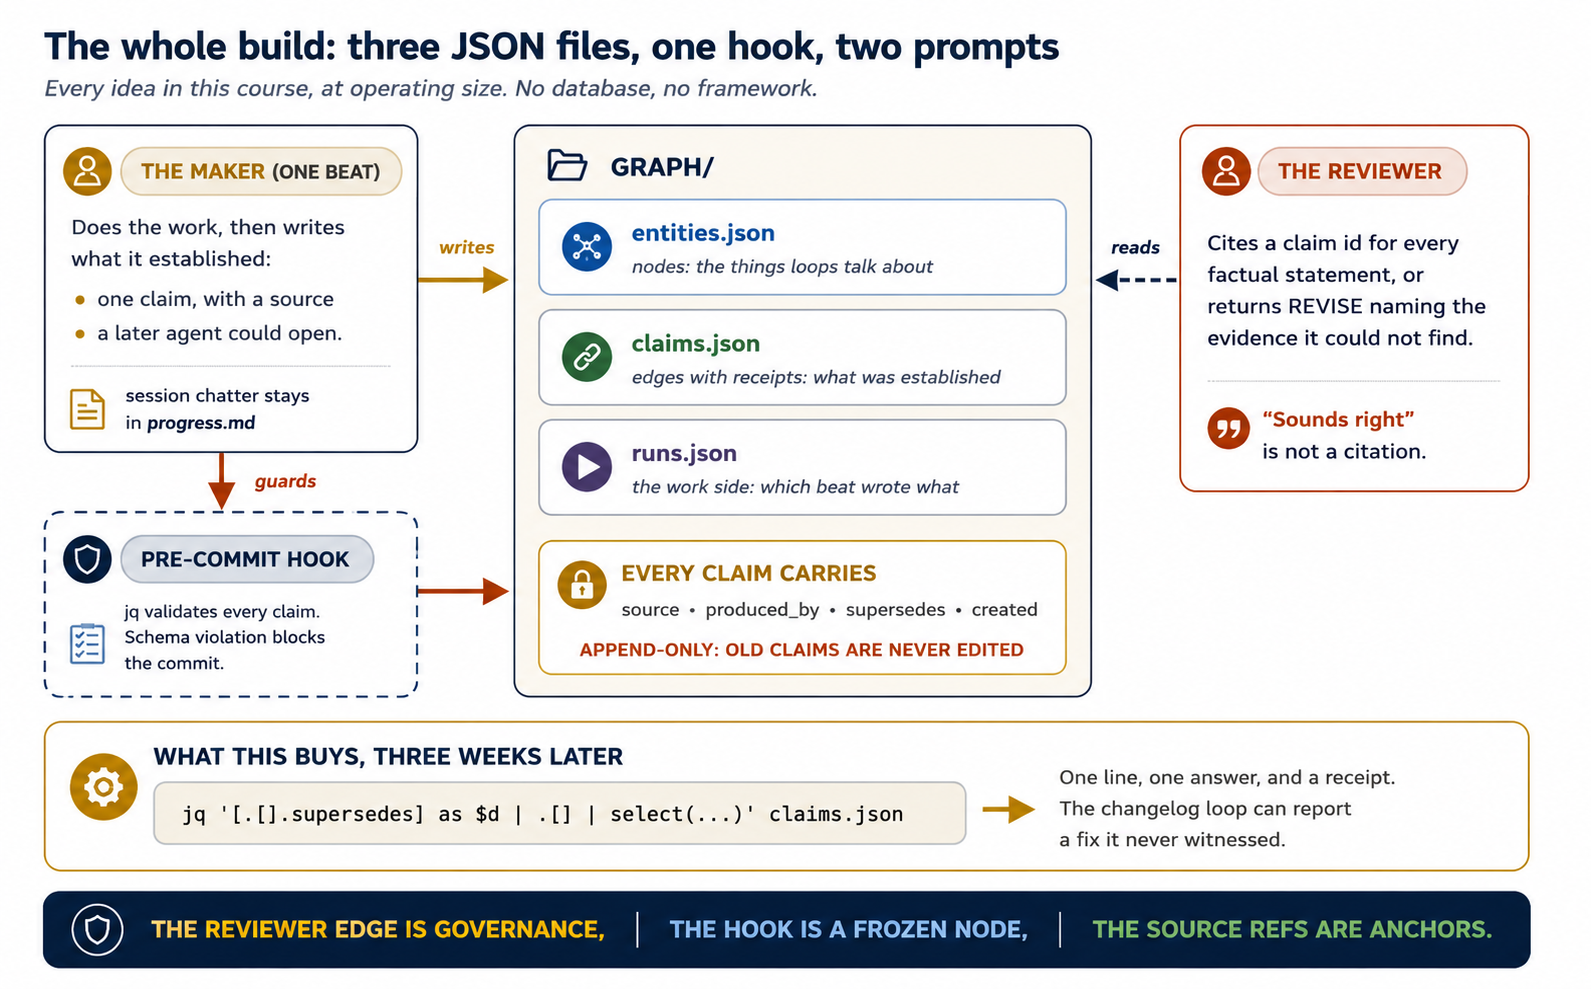
La forma en disco
graph/
  SCHEMA.md        # the contract: fields, types, and the write rules
  entities.json    # nodes: things the loops talk about
  claims.json      # edges-with-receipts: what the loops have established
  runs.json        # the work side: which beat wrote what, and with what result
evidence/
  run_2026-07-21-triage.log   # raw tool output a claim can point at
Dos directorios, porque contienen cosas distintas. graph/ es la memoria seleccionada, pequeña y comprobada contra el esquema. evidence/ es la salida sin procesar a la que apuntan las afirmaciones: ejecuciones de pruebas, salida de comandos y respuestas de API. Nada de evidence/ se edita jamás.
¿Y cuándo deja de bastar JSON? Más tarde de lo que teme el instinto y antes de lo que sugiere este diseño. Un solo archivo reescrito en cada adición resulta cómodo hasta unos pocos miles de afirmaciones y empieza a doler cerca de las diez mil: los recorridos de jq se ralentizan, todo el archivo se reescribe para una sola fila nueva y dos bucles que añadan al mismo tiempo pueden perder una escritura. El camino de mejora es deliberadamente aburrido, porque la disciplina está en el esquema, no en el almacenamiento. Una tabla relacional (Postgres o SQLite en un solo equipo) aporta identificadores reales, índices por sujeto y predicado, transacciones para que las adiciones simultáneas dejen de chocar y una regla de solo adición impuesta por un activador de base de datos en vez de un hook de Git. Una base de datos de grafos (Neo4j, Neptune) añade una cosa: el recorrido de varios saltos como consulta en vez de como código que mantienes, lo cual empieza a importar cuando el constructor de contexto recorre tres o cuatro saltos, no uno o dos. Ninguno de esos cambios altera un solo invariante. Migra cuando una consulta se vuelva lenta o se pierda una escritura, no antes.
Una afirmación completa. Toda la disciplina cabe en este registro:
{
  "id": "claim_0007",
  "subject": "test_payments_flaky",
  "predicate": "diagnosed_as",
  "object": "tz_default_utc",
  "confidence": 0.9,
  "source": {
    "kind": "tool_output",
    "command": "pytest tests/test_payments.py -x",
    "exit_code": 1,
    "ref": "evidence/run_2026-07-21-triage.log#L88-L94",
    "captured": "2026-07-21T09:14:22Z"
  },
  "produced_by": "run_2026-07-21-triage",
  "supersedes": "claim_0004",
  "created": "2026-07-21"
}
Observa algo antes de copiarla: esta afirmación lleva un supersedes, por lo que presupone que claim_0004 ya está en el archivo. Tu primera afirmación no tiene ningún campo supersedes. Añade uno que apunte a una afirmación que nunca escribiste y el hook siguiente detendrá correctamente el commit con supersedes points at a claim that does not exist. Observa también que claims.json es un array, incluso si contiene una sola afirmación: todas las consultas jq de esta página comienzan con .[].
Y una advertencia sobre el propio identificador, a la que vuelve la habilidad del creador más adelante. claim_0007 es un contador, y un contador es justo lo que no debería usar un bucle que puede interrumpirse. Se mantiene en esta página porque se lee mejor que un identificador derivado y todos los ejemplos siguientes lo conservan solo por esa razón. En un repositorio real, usa la forma derivada.
Los otros dos archivos son más pequeños. Una entidad es una identidad más sus alias:
[
  {
    "id": "test_payments_flaky",
    "type": "TEST",
    "aliases": ["tests/test_payments.py::test_tz", "the flaky payments test"],
    "first_seen": "2026-07-14"
  }
]
Y una ejecución es el comprobante de un pulso:
[
  {
    "id": "run_2026-07-21-triage",
    "beat": "morning-triage",
    "started": "2026-07-21T09:11:04Z",
    "tool": "claude-code",
    "evidence": ["evidence/run_2026-07-21-triage.log"],
    "claims_written": ["claim_0007"],
    "verdict": "PASS"
  }
]
Ahora, dos aspectos de la afirmación anterior son deliberados, y ambos estuvieron a punto de ser incorrectos.
No hay un campo status. Las afirmaciones son de solo adición: nada se edita y nada se borra. Que una afirmación siga vigente no se almacena, sino que se deriva al leer: una afirmación está activa si ninguna posterior la sustituye. Una expresión jq lo resuelve, y la regla no puede desviarse porque no existe un segundo lugar donde viva la verdad. Esta es la analogía contable bien aplicada. Un asiento corrector no vuelve atrás para modificar el original.
# active claims = those that nothing supersedes
jq '[.[].supersedes] as $dead
    | [.[] | select(.id | IN($dead[]) | not)]' graph/claims.json
Léelo como dos pasos: recopila cada identificador sustituido por una afirmación posterior y conserva las afirmaciones cuyo identificador no esté en esa lista. Conviene mencionar una trampa porque la instrucción evidente de una sola línea es incorrecta: no lo reduzcas a select(any(.[]; ...)) sobre .[], porque dentro de select la entrada actual es una sola afirmación, así que any(.[]; ...) recorre los campos de esa afirmación y produce un error. La forma en dos pasos lo evita y se entiende mejor.
El predicado es diagnosed_as, no caused_by. Una prueba fallida con código de salida 1 demuestra que algo falló. No demuestra qué causó el fallo: ese paso es la interpretación de la salida por parte del agente. Por tanto, la afirmación declara lo que puede respaldar. Ascender a caused_by exige más evidencia que una prueba en rojo: la aserción fallida, la línea de configuración que señala e, idealmente, una nueva ejecución que apruebe después de corregir el supuesto sobre la zona horaria. Entonces añades una afirmación caused_by nueva que sustituya a esta y cite ambas ejecuciones. Elegir un predicado que tu evidencia realmente respalde es el acto de honestidad más pequeño y repetible de toda esta disciplina.
La fuente nombra la herramienta, no el agente. "kind": "tool_output" junto con un comando, un código de salida, una marca de tiempo y un intervalo de líneas apunta a algo que ningún modelo escribió: pytest falló y aquí indicó el fallo. Compáralo con una fuente que apunte a una frase escrita por el agente en su propio registro. Cumpliría la letra del invariante 1 mientras señala una salida del modelo, el grafo circular del Concepto 13 dentro de un solo campo. La regla es: un registro de ejecución solo es un ancla cuando las líneas citadas son salida capturada de algo externo al modelo, como un ejecutor de pruebas, un compilador, una base de datos, una API o el sistema operativo. La propia prosa de un agente dentro de un archivo de registro es una afirmación, no evidencia para una.
Comprueba la afirmación contra los invariantes del Concepto 8: una fuente real (invariante 1), una ejecución autora (invariante 2) y un predecesor sustituido que sigue siendo direccionable porque nunca se tocó (invariante 4). El invariante 3 llega con el revisor siguiente.
El creador escribe en el grafo
Un párrafo añadido a la habilidad de clasificación cambia lo que deja el bucle. Donde la habilidad anterior decía «actualiza progress.md», la nueva dice:
## 5. Update the graph last

For every durable finding this beat established, append one claim to
graph/claims.json following the schema in graph/SCHEMA.md. Rules:

- claims.json is APPEND-ONLY. Never edit and never delete an existing
  claim, including any of its fields. To correct a claim, append a new one
  whose "supersedes" names the old id. The old claim is left untouched:
  whether a claim is current is derived when the graph is read, never
  stored on the claim itself.
- Every claim needs a source a later agent could open and verify. Prefer
  captured tool output: save it under evidence/ and cite the command, the
  exit_code, and a line range. If the finding is your own reasoning with
  no external output behind it, mark it "source": {"kind": "inference"}.
- Never cite your own prose in a log as the evidence for your own claim.
- New entities go in entities.json first. Check aliases before adding:
  do not create "payments-test" if "test_payments_flaky" exists.
- Derive each claim id from the run and the finding, never from a counter,
  and check whether that id already exists before appending. A beat that is
  interrupted and rerun must produce the SAME id for the same finding, so
  the retry writes nothing instead of writing a second copy. claim_0007
  reads well on a page. In a loop that can die halfway, use something a
  rerun reproduces exactly, such as
  claim_run_2026-07-21-triage_tz-default.
- Session notes, dead ends, and chatter stay in progress.md. The graph
  is for what was established, not what was said.
La última regla es la más importante. La columna vertebral no desaparece: sigue siendo el diario del bucle. El grafo es el registro más pequeño y estricto de lo que el diario demostró. Dos memorias, dos criterios de verdad, exactamente como los dos grafos del Concepto 3.
La regla del identificador es la que esta construcción casi publicó sin incluir, y conviene entender por qué no es pedantería. claim_0007 es un contador, y un contador no recuerda qué estaba contando. Un pulso que añade una afirmación y después muere antes de su commit volverá a añadir el mismo hallazgo como claim_0008 al reintentarse, y todas las comprobaciones del hook siguiente la aceptarán: los campos están presentes, los identificadores son únicos, la sustitución se resuelve y nada ya confirmado cambió. Ahora tienes el mismo hecho dos veces, bajo dos identificadores y con dos ejecuciones que afirman haberlo establecido, y el duplicado aparece meses más tarde como un desacuerdo que nunca existió. Un identificador derivado cierra el hueco por ambos lados. El creador busca el identificador y omite la escritura cuando lo encuentra, así que el reintento no hace nada; y el día que el creador olvide buscar, la regla de identificador único del hook bloqueará el commit en vez de duplicar la memoria en silencio. Las escrituras que un reintento puede repetir con seguridad distinguen un grafo que sobrevive a una interrupción de otro que crea discretamente una copia fantasma de sí mismo.
Y el arnés hace reales las reglas, porque una barandilla vive en el arnés, nunca en el prompt. Varias reglas anteriores se pueden comprobar mecánicamente, así que el hook comprueba lo que puede:
#!/bin/sh
# .git/hooks/pre-commit — the graph gate (jq only, no framework)
C=graph/claims.json
fail() { echo "claims.json: $1 — commit blocked"; exit 1; }

# 1. required fields on every claim
jq -e 'all(.[]; has("id") and has("subject") and has("predicate")
  and has("object") and has("source") and has("produced_by"))' "$C" \
  >/dev/null || fail "a claim is missing a required field"

# 2. ids are unique
[ "$(jq 'length' "$C")" = "$(jq '[.[].id] | unique | length' "$C")" ] \
  || fail "duplicate claim id"

# 3. every supersedes target exists
jq -e --argjson ids "$(jq '[.[].id]' "$C")" \
  'all(.[]; (has("supersedes") | not) or (.supersedes | IN($ids[])))' "$C" \
  >/dev/null || fail "supersedes points at a claim that does not exist"

# 4. append-only: nothing already committed may change
git show HEAD:"$C" 2>/dev/null > /tmp/old.json || exit 0
jq -e --slurpfile new "$C" \
  'all(.[]; . as $o | $new[0] | any(.[]; . == $o))' /tmp/old.json \
  >/dev/null || fail "an existing claim was modified or removed"
Sé honesto ahora sobre el límite de esa puerta, porque este curso insiste en la diferencia entre una petición y una regla impuesta. Esas cuatro comprobaciones son reales: campos obligatorios, identificadores únicos, sustituciones resolubles e historial de solo adición. Lo que el hook no comprueba son los tipos de los campos, si subject nombra una entidad existente en entities.json, si un bloque source tiene una forma válida o si realmente existen el archivo de evidencia y el intervalo de líneas citados. Cada una requiere otra línea de jq el día que la necesites. Hasta que la escribas, esa regla solo vive en SCHEMA.md, lo que la convierte en orientación, no en barandilla. Saber cuál de tus reglas es cada cosa es el propósito completo de la distinción.
El revisor lee del grafo
El prompt del revisor obtiene una obligación y su veredicto obtiene un campo. Es el Concepto 10 a escala operativa:
You are the reviewer. For every factual claim in the maker's report:

1. Find the claim in graph/claims.json that supports it. Cite its id.
2. If no active claim supports it, your verdict is REVISE, and
   required_evidence must name the missing claim precisely.
3. A claim whose source.kind is "inference" cannot by itself ground a
   factual assertion. Either cite a source-backed claim that supports it,
   or return REVISE. An honestly recorded guess is still a guess.
4. Never approve a factual claim on plausibility. "Sounds right" is
   not a citation.

Return only JSON:
{ "verdict": "PASS|REVISE|FAIL",
"grounded_in": ["claim_0007", "claim_0012"],
"missing": [],
"rubric": "reviewer-rubric-v3" }
La regla 3 es la que se suele omitir, y omitirla deshace toda la construcción sin hacer ruido. El creador puede registrar una inferencia con honestidad, lo cual es correcto: una suposición marcada es mejor que una blanqueada. Pero si el revisor solo comprueba que una afirmación citada existe, una suposición marcada puede anclar una declaración factual publicada y el grafo la habrá blanqueado de todos modos. La inferencia honesta y la evidencia de anclaje son trabajos distintos. La tarea del revisor consiste en mantenerlos separados.
El campo rubric es el invariante 3 y el campo grounded_in es el rastro auditable: meses después, puedes abrir cualquier PR publicada y recorrer desde su veredicto hasta las afirmaciones y las fuentes. Cada salida importante vinculada a un objetivo, un artefacto, una fuente, una ruta del grafo y una decisión del evaluador: la prueba final del PDF, superada a la escala de tres archivos JSON.
Un pulso, antes y después
Antes (solo columna vertebral). El pulso de clasificación del martes corrige la prueba inestable de pagos y escribe prosa: «corregida la prueba inestable, era un asunto de zona horaria». El jueves, otro bucle, el del registro de cambios, menciona la corrección de pagos y su revisor la aprueba por plausibilidad. Tres semanas después, alguien pregunta qué supuesto de zona horaria era, y responder requiere una excavación arqueológica en las transcripciones.
Después (grafo). El pulso del martes escribe claim_0007, la afirmación anterior, y cita la salida de pytest capturada en evidence/. El jueves, el constructor de contexto del bucle del registro de cambios recupera el subgrafo de dos saltos alrededor de test_payments_flaky: la afirmación, su referencia de fuente y la ejecución que la produjo. Su revisor aprueba la entrada del registro de cambios porque grounded_in: ["claim_0007"] se resuelve. Tres semanas después, jq responde la pregunta en una línea y con un comprobante:
jq '[.[].supersedes] as $dead
    | .[] | select(.subject == "test_payments_flaky")
          | select(.id | IN($dead[]) | not)' graph/claims.json
Los mismos bucles. El mismo modelo. El único cambio es dónde vive la memoria, y eso cambió lo que pueden saber todos los agentes y todas las personas posteriores.
Una lectura más de la construcción, ahora que la Parte 5 te dio la segunda perspectiva. Este sistema diminuto contiene ambos grafos a la vez. La relación entre revisor y creador es una arista de gobernanza (un bucle observador cuya contramétrica sobre el creador es «toda afirmación se resuelve»). El hook de esquema de pre-commit es un nodo congelado: los creadores nunca pueden ajustar las reglas con las que se los evalúa. Y los bloques source son anclas, pero solo por aquello a lo que apuntan: un comando, un código de salida y la salida capturada de un ejecutor de pruebas. Si el mismo campo apunta a una frase que el agente escribió sobre sí mismo, el ancla se evapora aunque el esquema siga aprobando. Tres archivos JSON, un hook, dos prompts y todas las ideas de este curso aparecen en miniatura.
En un repositorio desechable, crea los tres archivos JSON con una entidad y cero afirmaciones. Ejecuta sin interfaz un pulso de creador, claude -p u opencode run, con la habilidad de escritura en el grafo anterior, sobre cualquier tarea real pequeña. Después ejecuta el prompt del revisor contra el informe del creador. Observa que devuelve REVISE con un campo missing en la primera pasada porque el creador registró demasiado poco. Ese fallo es la lección: el revisor acaba de enseñar al creador qué debe contener el grafo.
Parte 7: mantenerse anclado
14. Elegir un nivel y presupuestarlo
Ejecuta este: python3 concepts/14-choose-a-level.py en el laboratorio complementario. Leerlo es la mitad. Verlo suceder es la otra mitad.
Antes del argumento contra los grafos, veamos el procedimiento para elegir uno. Seis preguntas, formuladas en orden, deciden cuánta estructura necesita realmente un trabajo. Cada «no» te ahorra una capa.
- ¿Se puede verificar el éxito? Si no, no empieces con autonomía. Define primero una prueba, una rúbrica, un requisito de fuentes o una decisión humana. Es la primera puerta del curso de bucles, y nada posterior repara la falta de una respuesta aquí.
- ¿Los pasos son estables? Si sí, basta una cadena. Si no, necesitas planificación o un orquestador.
- ¿Las subtareas son independientes? Si sí, paraleliza. Si no, representa explícitamente las dependencias y limita cuántos trabajadores pueden escribir a la vez.
- ¿Deben mantenerse disponibles los linajes alternativos? Si sí, usa un DAG en vez de forzar todos los resultados a una rama. Esta es la pregunta del Concepto 5.
- ¿Deben sobrevivir los hechos a la ejecución? Si sí, conserva los artefactos y el estado del grafo. No confíes en que un resumen de la transcripción los transporte.
- ¿Puedes asumir el coste y la latencia? Fija presupuestos antes de añadir trabajadores, no después de recibir la factura.
Respondidas en conjunto, producen un nivel, no una preferencia:
| Tu situación | Empieza con | Por qué |
|---|---|---|
| Pregunta sencilla de bajo riesgo | Zero-shot | Menor latencia, ninguna maquinaria que mantener |
| La salida se puede comprobar | Un bucle | La retroalimentación repetida mejora el artefacto |
| La secuencia es estable | Una cadena | Etapas predecibles y comprobables |
| Las categorías están claras | Un enrutador | Separa limpiamente políticas y modelos |
| Las unidades son independientes | Trabajadores paralelos | Reduce el tiempo de reloj |
| La descomposición varía según la tarea | Orquestador-trabajadores | Especialización dinámica |
| Las alternativas deben seguir vivas | Un DAG de commits | Conserva las ramas de experimentos |
| Los hechos deben sobrevivir sesiones | Un grafo de conocimiento | Memoria compartida persistente |
| Trabajo paralelo a gran escala | Un flujo de trabajo dinámico | Automatiza la distribución y la reunión |
Observa que el grafo es la octava fila, no la primera. La mayoría de los trabajos se detiene antes, y detenerse antes es un resultado correcto, no falta de ambición.
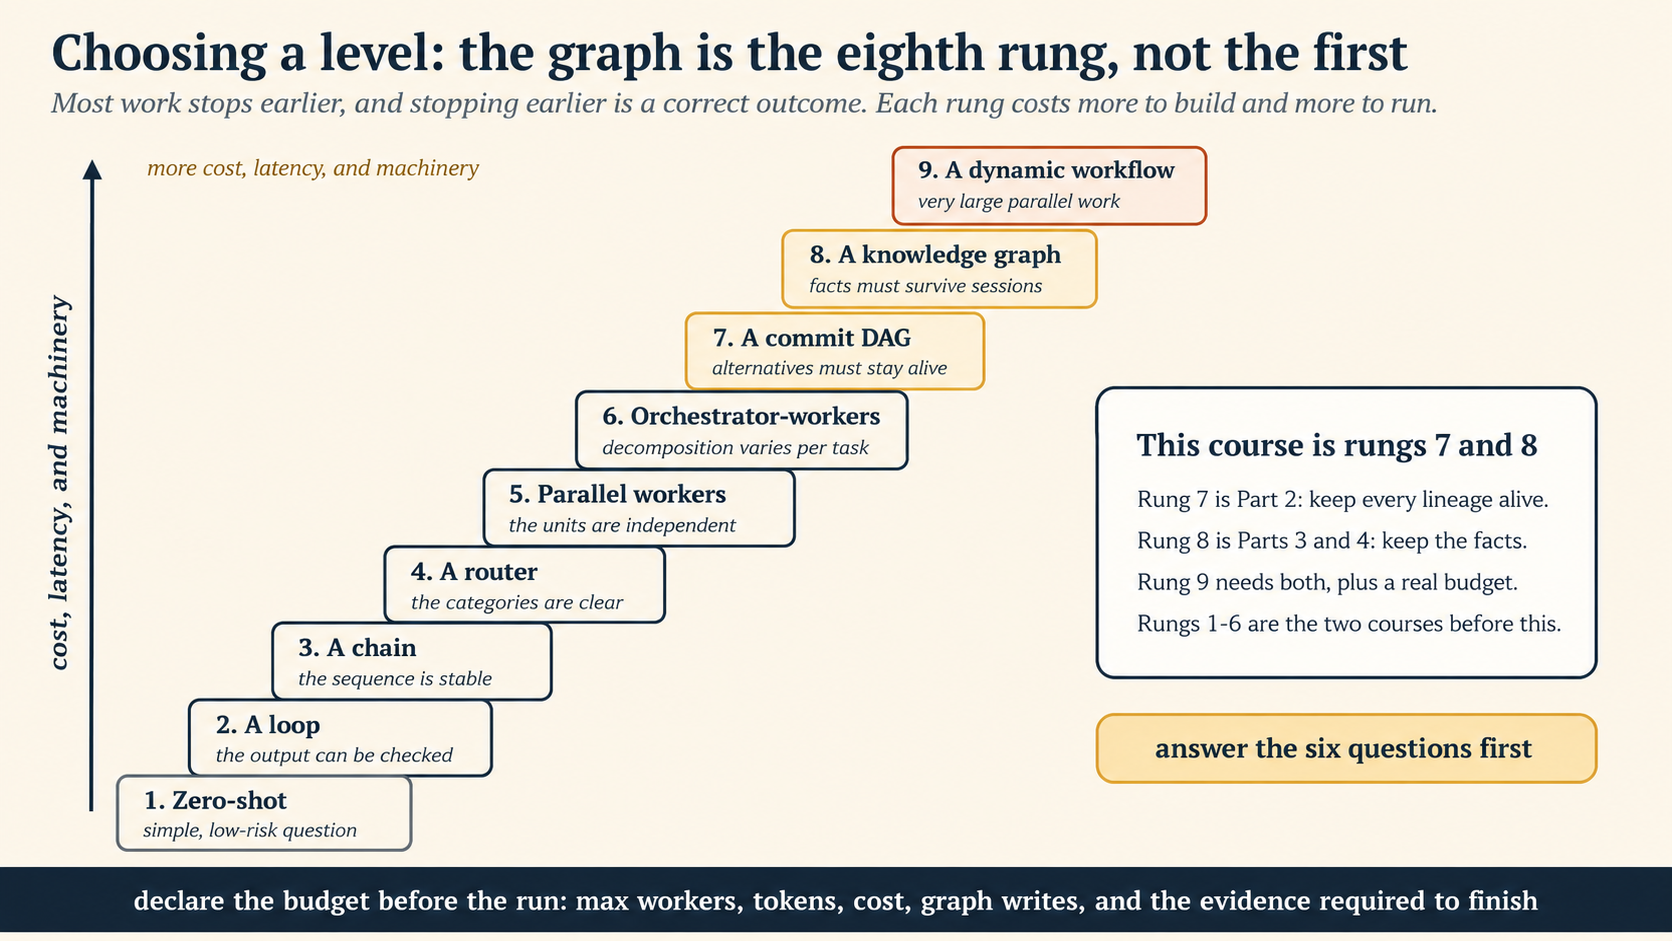
Sea cual sea el nivel elegido, declara su presupuesto de complejidad antes de iniciar la ejecución. Toda ejecución debe indicar por escrito: máximo de llamadas al modelo, máximo de subagentes, máximo de trabajadores simultáneos, máximo de llamadas a herramientas, máximo tiempo de reloj, máximo de tokens, máximo coste financiero, máximo de reintentos, máximo de escrituras en el grafo y evidencia mínima necesaria antes de considerar algo terminado. El último elemento es el que se olvida, y es el que da significado a los demás.
Después viene la regla sobre qué hacer cuando se agota un presupuesto, más importante que las propias cifras: devuelve el mejor artefacto actual, el trabajo completado, los asuntos sin resolver y el motivo de la parada. No ocultes un fallo parcial detrás de una respuesta final fluida. Una ejecución que diga «me detuve en 40 de 60 archivos porque se agotó el presupuesto de tokens, y esto es lo que mostraron los 40» vale más que un informe seguro de sí mismo que cubrió en silencio dos tercios del trabajo.
Asigna una cifra a ese presupuesto, porque toda esta maquinaria tiene coste y un curso que dedicó catorce conceptos a venderla te debe la factura. La explicación de Anthropic sobre su sistema de investigación multiagente informa de que la arquitectura superó considerablemente a un solo agente en trabajo de exploración amplia y consumió alrededor de quince veces más tokens que una interacción de chat ordinaria. El intercambio cabe en una frase: la amplitud paralela compra cobertura y la paga en tokens. Por eso la forma debe justificar su coste. Modelos baratos para extracción, clasificación y formato acotados. Modelos potentes para descomposición, síntesis y verificación difícil. Caminos cortos para solicitudes sencillas. El grafo completo solo para trabajos cuyo valor justifique la coordinación. Cien trabajadores son la respuesta correcta cuando la tarea es realmente amplia, las ramas son de verdad independientes y el resultado merece el gasto; son la respuesta incorrecta siempre que una sola ventana de contexto pueda contener todo el problema.
El presupuesto decide cuánto gastas. Otra decisión determina dónde espera el sistema, y equivocarse desperdicia todo el gasto mientras aparenta paralelismo. Cuando el trabajo se distribuye, algo acaba reuniéndolo, y una barrera después de cada etapa vuelve a convertir discretamente el abanico en una cadena. Espera al conjunto completo solo donde el nodo siguiente lo necesite de verdad: deduplicar entre fuentes, clasificar todos los candidatos entre sí, comparar alternativas o juzgar si la cobertura es suficiente. Cuando cada resultado pueda avanzar por sí mismo, déjalo. Y cuando reúnas, una rama fallida no debe descartar las noventa y nueve que terminaron. Recopila lo que se completó, registra lo que no y permite que el nodo siguiente decida si basta para continuar; es la regla de fallo parcial anterior aplicada a una unión en vez de a toda la ejecución. La topología, no el número de trabajadores, decide dónde se detiene tu sistema.
Formula las seis preguntas antes de construir y deja que te indiquen la estructura más pequeña que encaja. Después anota tus límites de antemano, porque un sistema al que nunca se le indicó cuándo detenerse se detendrá cuando se agote el dinero y describirá ese momento como un éxito.
Un equipo quiere un grafo de conocimiento. Sus respuestas: el éxito es verificable, los pasos son estables, las subtareas son independientes, los linajes alternativos no importan y los hechos no necesitan sobrevivir a la ejecución. ¿Qué nivel les dan las seis preguntas? Trabajadores paralelos sobre una cadena estable, sin grafo. La pregunta 4 es no, así que no hay DAG. La pregunta 5 es no, así que no hay grafo de conocimiento. Querían la octava fila y las preguntas les dieron la quinta. Construir el grafo de todos modos significa pagar errores de extracción y mantenimiento del esquema para responder preguntas que nadie ha formulado.Mostrar respuesta
15. Cuándo no construir un grafo
Ejecuta este: python3 concepts/14-choose-a-level.py en el laboratorio complementario. Leerlo es la mitad. Verlo suceder es la otra mitad.
El Concepto 14 te dio el procedimiento. Este concepto presenta el argumento contra el nivel que el curso lleva catorce conceptos vendiendo, siguiendo la tradición de evaluación honesta del libro. No introduzcas un grafo de conocimiento solo porque el sistema tenga agentes. Un grafo es maquinaria con una factura real: errores de extracción, riesgo de resolución, mantenimiento del esquema y otro elemento que puede deteriorarse en silencio. Omítelo cuando:
- las tareas sean independientes y no se necesite estado entre sesiones,
- las respuestas procedan de un documento cada vez,
- las relaciones sean fijas y sencillas; una tabla relacional ya responde todas las consultas que realmente formulas,
- no se requiera procedencia, o
- los errores de extracción pesen más que el valor del recorrido.
Un grafo justifica su coste cuando las consultas conectadas, las relaciones cambiantes, la procedencia o el estado compartido del mundo son centrales. Un bucle con una columna vertebral no necesita grafo. En cuanto dos bucles intercambian hechos o veinte trabajadores necesitan una síntesis, la balanza cambia. La construcción de la Parte 6 es deliberadamente la versión más pequeña que supera el umbral.
Y hay dos modos de fallo para los grafos que sí construyas:
El grafo amplifica el juicio del creador, incluido el mal juicio. Un bucle amplifica su objetivo y su evaluador. Aprendiste esa lección dos veces. Un grafo amplifica su ontología y política de fuentes. Elige tipos de entidad incorrectos, admite fuentes incorrectas y la automatización escala el error: un corpus sesgado produce un grafo sesgado que responde con seguridad en todas las direcciones. El grafo inspecciona afirmaciones. No las blanquea para convertirlas en verdad.
Aquí también se pueden manipular las métricas. Una canalización de extracción ajustada solo para la exhaustividad de entidades inundará el grafo sin problema. Un paso de resolución ajustado solo para la compresión fusionará desconocidos (la trampa del Concepto 7). Toda optimización necesita su contramétrica: precisión frente a exhaustividad, compresión frente a fusiones falsas. Es la ley de Goodhart. El curso siguiente la examina en detalle.
Mantén también activa la auditoría del Concepto 13 en los grafos que construyas: sigue diez afirmaciones al azar hasta sus hojas y cuenta cuántas terminan en la realidad en vez de en el informe de otro modelo. Un grafo de memoria sin anclas es el grafo circular de la Parte 5 reconstruido en JSON.
Un grafo es una burocracia para los hechos. Una burocracia buena hace que todo sea localizable y auditable. Una mala estampa rumores con sellos de aspecto oficial y los archiva con gran pulcritud. El sello no es la verdad: lo es el comprobante al fondo del expediente. Comprueba los comprobantes y construye la burocracia solo cuando el montón de hechos sea realmente demasiado grande para un cuaderno.
16. Lo que el grafo no puede hacer y el siguiente paso
Ejecuta este: bash concepts/16-limits.sh en el laboratorio complementario. Leerlo es la mitad. Verlo suceder es la otra mitad.
Terminemos en el límite honesto, con tres afirmaciones que el grafo no puede hacer por ti:
«Ahora se puede confiar en el PASS del revisor». No. El anclaje mejoró el veredicto de impresión a auditoría, pero el auditor sigue siendo un modelo: puede citar una arista que no respalde la afirmación, omitir una ruta existente y desviarse cuando se actualice el modelo subyacente. Una respuesta fluida que cita aristas irrelevantes es un fallo documentado, no teórico. Medir el revisor, conjuntos de referencia, calibración, tasas de aprobación y deriva, es el curso siguiente: Confiar en el revisor. Todo lo que enseña se aplica por duplicado aquí, porque un sistema de grafos tiene dos capas comprobables: la extracción que llena la memoria y el revisor que la lee. Incluso su arnés de evaluación resultará familiar: leer el prompt de extracción y el historial de puntuaciones, proponer un cambio, ejecutarlo contra un conjunto de referencia y conservar o revertir. El trinquete aplicado al propio grafo.
«La memoria está segura donde se encuentra». Solo está tan segura como su hogar. Un grafo en el repositorio de un portátil muere con el portátil. La memoria compartida de un enjambre debe vivir donde todos los trabajadores, locales, programados o en la nube, puedan alcanzarla, sobrevivir al fallo de un equipo e imponer quién puede escribir qué. Autoresearch se ejecuta en una GPU precisamente porque lo acotado es seguro. AgentHub es un binario de Go en un servidor precisamente porque es un bosquejo. Trasladar los bucles demostrados y su grafo a un entorno de ejecución que no tengas que vigilar es el curso posterior al siguiente: Dejar atrás el portátil.
«Un cableado mejor significa un juicio mejor». El límite más antiguo de este libro no se mueve. El grafo coloca la memoria y la evaluación fuera de la ventana de contexto. Eso es real y constituye la idea más importante: el cuello de botella no suele ser la siguiente llamada al modelo. Es la ubicación de la memoria y la evaluación. Pero la ontología, la política de fuentes, las anclas y la respuesta a «¿qué significa mejor?» proceden del exterior de todo grafo, de ti. El README de Karpathy bromea sobre «enjambres autónomos de agentes de IA ejecutándose en megaestructuras de clústeres de cómputo en el cielo». El trabajo a corto plazo es menos espectacular y más valioso: contratos tipados, linaje conservado, afirmaciones ancladas y memoria que sobrevive a la sesión. La intención y la responsabilidad, el Concepto 1 del primer curso, siguen siendo las dos cosas que ninguna disposición de nodos y aristas puede contener.
El grafo saca la memoria y la comprobación de la cabeza del agente, y eso es una victoria real: permite que mil agentes trabajen en un problema sin que cada uno empiece desde cero. Pero no puede decidir para qué sirve la memoria. Alguien debe elegir qué merece recordarse, qué fuentes cuentan como evidencia y qué significa «mejor». Ese alguien eres tú, y ningún cableado elimina ese trabajo.
Este libro retoma el hilo así: describe con palabras sencillas un sistema de bucles que comparten un grafo y se convierte en una organización, trabajadores con un archivo compartido, revisores que exigen comprobantes y una persona responsable que fija las reglas. Ese es el curso acelerado de equipos humano-agente, y es en lo que se convierte un grafo de bucles bien construido cuando se gana un nombre en el organigrama: un FTE digital con memoria institucional.
Usar un grafo en este libro (dogfooding)
¿Este libro practica lo que predica el curso? Con honestidad: ejecuta el prototipo de grafo y deliberadamente no ejecuta el completo.
Mira el bucle de comentarios de la sección de dogfooding del curso de bucles con la perspectiva de este curso. Cada nota de un lector es un registro de una base de datos. Las notas enlazan con las incidencias de GitHub que abren. Las incidencias enlazan con las solicitudes de incorporación que las corrigen. Las PR enlazan con las lecciones que cambian y con la aprobación humana que las publicó. Registros tipados, enlaces dirigidos y procedencia de principio a fin: puedes recorrer desde cualquier corrección publicada hasta la nota exacta del lector que la causó. Es un grafo en todo salvo en el diagrama, y por eso nunca se trabaja dos veces la misma nota: los bucles consultan los enlaces en vez de releer el historial.
Lo que el libro no ejecuta es un grafo de conocimiento con extracción y resolución de entidades dirigidas por modelos sobre su propio contenido. Es el Concepto 15 aplicado a nosotros mismos: las preguntas entre sesiones del libro todavía se responden mediante los enlaces de incidencias y el historial de Git, las relaciones son sencillas y una canalización de extracción añadiría una superficie de error sin una consulta que la exija. El día que llegue una pregunta que los enlaces no puedan responder, «¿qué lecciones hacen afirmaciones basadas en documentos que han cambiado desde entonces?» probablemente será la primera. El patrón de la Parte 6 es el plan archivado. Construye el grafo cuando una consulta real lo justifique, no una semana antes.
🚀 Proyectos
Leer sobre un grafo no equivale a llenarlo. Aquí tienes ocho construcciones, de fácil a difícil. Hazlas con cualquiera de las herramientas: el grafo son archivos y jq, así que solo cambia el comando sin interfaz (claude -p u opencode run).
Dos reglas antes de empezar, siempre:
- Usa un repositorio desechable y documentos reales. El grafo solo resulta interesante cuando reconoces las entidades, así que utiliza tus propios README, notas o registros en vez de datos inventados.
- Escribe el esquema antes de la primera afirmación. Un
graph/SCHEMA.mdque escribiste en cinco minutos supera a uno reconstruido más tarde a partir de lo que contengan casualmente los archivos (Parte 6).
Project 110-15 minDibuja tu sistemaEncuentra el hallazgo que muere en una transcripción y el número que nadie audita.
Dificultad: fácil · Usa: Conceptos 2, 3 y 11 (nodos y aristas, dos grafos, el cableado).
Construye. En papel o con Mermaid, dibuja cada bucle, revisor, puerta humana, ancla y archivo de memoria que ejecutas hoy como nodos tipados con aristas dirigidas etiquetadas. Marca qué nodos son bucles y cuáles no. Después, rodea dos cosas: cualquier hallazgo que solo exista actualmente dentro de una transcripción y cualquier bucle optimizador sin un observador para su número.
Terminas cuando puedas señalar un elemento rodeado de cada clase y explicar qué te cuesta. Casi nadie dibuja esto sin encontrar nada, y esa es la razón de hacerlo antes de construir.
Project 230-45 minDe la columna vertebral a las afirmacionesConvierte diez hallazgos reales en registros tipados y descubre cuáles no puedes documentar.
Dificultad: fácil · Usa: Conceptos 1, 8 y Parte 6 (procedencia, el esquema).
Construye. Toma tu progress.md real (o el registro de cualquier bucle) y convierte sus últimos diez hallazgos duraderos en registros de claims.json bajo el esquema de la Parte 6. Completa todos los campos exigidos por los invariantes, incluidos produced_by y una source real.
Terminas cuando cada uno de los diez cite algo que un agente posterior pueda abrir o esté marcado explícitamente con "source": {"kind": "inference"}. Cuenta las inferencias. Ese número indica cuántas cosas tratabas como hechos apoyándote en la fluidez de un modelo, y es el número más útil que este curso te dará sobre tu propio sistema.
Project 345-60 minPrimera extracciónEjecuta un prompt restringido por esquema sobre tres documentos y descubre tus duplicados.
Dificultad: media · Usa: Concepto 6 (extracción).
Construye. Ejecuta sin interfaz el prompt del Concepto 6 sobre tres documentos relacionados: tres README de un proyecto, tres notas de reuniones o tres informes de incidentes. Valida cada respuesta con jq antes de creerla. Después cuenta cuántas entidades distintas aparecen con más de una forma superficial.
Terminas cuando los tres documentos devuelvan JSON válido según el esquema y puedas nombrar al menos una entidad que aparezca con dos o más nombres. Si el recuento es cero, tus documentos son demasiado similares: usa tres escritos por personas distintas, porque entonces la resolución se convierte en un problema real y no hipotético.
Project 430-45 minEl DAG hablaResponde las tres preguntas de AgentHub usando solo Git y deja los comandos para tus agentes.
Dificultad: media · Usa: Conceptos 4 y 5 (las dos memorias, recorrido).
Construye. En un repositorio con historial real, responde mediante Git sencillo las tres preguntas de AgentHub: qué se intentó sobre el commit X, qué puntas son una frontera sin explorar y qué camino produjo el estado actual. Después escribe los tres comandos en un archivo GRAPH.md para que tus agentes futuros también puedan formularlas.
Terminas cuando funcionen los tres comandos y puedas explicar también lo que el DAG no puede decirte: qué experimentos se probaron y descartaron. Esa ausencia es la corrección del Concepto 4, experimentada en tu repositorio en vez de leída.
Project 545-60 minPráctica de resoluciónFusiona lo que corresponde, separa lo que no y conserva todos los comprobantes.
Dificultad: media · Usa: Concepto 7 (resolución).
Construye. Toma veinte formas superficiales del Proyecto 3, agrupadas por tipo y con sus descripciones, y pide a un modelo más potente grupos canónicos con justificación y confianza para cada uno, conservando todos los alias. Después coloca una trampa: añade dos entidades realmente distintas que compartan nombre y vuelve a ejecutar.
Terminas cuando los duplicados reales se hayan fusionado, los dos desconocidos del mismo nombre permanezcan separados y cada entidad canónica siga enumerando las formas superficiales de las que procede. Si los desconocidos se fusionan, no corrijas primero el prompt de resolución: vuelve atrás y enriquece las descripciones, porque de ahí debe proceder la evidencia.
Project 61-2 h, más cinco pulsosEl revisor ancladoHaz que un revisor exija una arista en vez de ofrecer una opinión.
Dificultad: difícil · Usa: Concepto 10 y Parte 6 (anclaje, el revisor).
Construye. Conecta el revisor de la Parte 6 a un bucle que ya ejecutes. Los veredictos deben incluir grounded_in con identificadores de afirmaciones resolubles; una declaración factual sin afirmación de respaldo fuerza REVISE con missing completo; y una afirmación cuya fuente sea inference no puede anclar nada por sí sola. Ejecuta cinco pulsos reales.
Terminas cuando al menos un pulso haya vuelto como REVISE con una arista ausente nombrada y el siguiente intento del creador haya aportado la evidencia o retirado la afirmación. Después lee juntos los cinco veredictos: lo que el creador aprendió a registrar es la verdadera salida de este proyecto.
Project 72-3 hUn conjunto de referencia para la extracciónMide la canalización que llena tu memoria, un curso antes de tiempo.
Dificultad: difícil · Usa: Conceptos 6, 7 y el curso siguiente.
Construye. Etiqueta a mano las entidades y relaciones de cinco documentos. Es la parte tediosa y no hay forma de evitarla. Después evalúa el prompt del Proyecto 3 contra tus etiquetas: precisión, exhaustividad y tasa de validez según el esquema. Cambia exactamente una línea del prompt, vuelve a evaluar y conserva o revierte según el número.
Terminas cuando hayas ejecutado el trinquete al menos tres veces sobre el propio prompt y conservado un registro de todos los intentos, incluidos los revertidos. Acabas de construir autoresearch para grafos: el mismo bucle, otro artefacto. Confiar en el revisor es donde esto se convierte en disciplina.
Project 8Proyecto final: un fin de semana y después una semana de pulsosDos bucles, un grafoHaz que un bucle informe de una corrección que nunca presenció porque el grafo se la contó.
Dificultad: proyecto final · Usa: todo.
Construye. Dos bucles sobre un grafo. El bucle de clasificación escribe afirmaciones con fuentes reales de salida de herramientas. El bucle del registro de cambios las lee mediante un constructor de contexto de dos saltos, no mediante un volcado de archivos. Ambos revisores anclan sus veredictos. El hook de pre-commit protege el esquema y la regla de solo adición. Y el número de rendimiento del bucle de clasificación recibe una contramétrica vigilada por el bucle de revisión (Concepto 12).
Terminas cuando el bucle del registro de cambios informe correctamente de una corrección que nunca presenció porque el grafo la transportó, y puedas recorrer desde esa línea del registro de cambios, pasando por la afirmación y la ejecución, hasta la salida capturada de una herramienta que ningún modelo escribió. Cuando ese recorrido funcione, habrás construido memoria compartida con anclas y este curso no tendrá nada más que enseñarte.
Fuentes y lecturas adicionales
Dentro de este libro
- Ingeniería de bucles: el trinquete, la columna vertebral, la separación creador-revisor, el bucle de exploración y la puerta de dos rutinas; cada arista de gobernanza de la Parte 5 se construyó primero allí, un bucle a la vez.
- Ingeniería del harness: la salida tipada y la disciplina de reversibilidad, elevadas aquí a la escala de la memoria.
- Confiar en el revisor: el curso siguiente; cómo saber si el revisor anclado y la canalización de extracción son buenos.
- Dejar atrás el portátil: adónde van el grafo y sus bucles para vivir cuando se cierra el portátil.
- Equipos humano-agente: en qué se convierte un grafo de bucles dentro de un organigrama.
Fuentes primarias
- Andrej Karpathy, autoresearch (publicado el 7 de marzo de 2026): https://github.com/karpathy/autoresearch. El arnés de tres archivos, el trinquete y los resultados publicados. Lee el propio
program.mdantes de citar el bucle en cualquier lugar: es la fuente de la corrección de las dos memorias del Concepto 4, pues especifica que los experimentos se ejecutan en una rama dedicada, que la rama solo avanza con una mejora, que todo resultado igual o peor se elimina mediantegit resety queresults.tsvregistra todos los intentos mientras se deja deliberadamente sin seguimiento de Git: el arnés de tres archivos, el bucle con trinquete y la memoria del DAG de commits. Las cifras de estrellas y experimentos del curso corresponden a sus primeras semanas. Comprueba el repositorio activo. - Andrej Karpathy, AgentHub (publicado alrededor del 9-10 de marzo de 2026 y ya no público): la capa de colaboración centrada en agentes, con un repositorio Git bare, SQLite, un tablón de mensajes y la CLI
children/leaves/lineage. Se describía explícitamente como «solo un bosquejo. Pensando...». El repositorio original se hizo privado en cuestión de semanas y no tenía archivo de licencia. Las bifurcaciones conservadas por la comunidad son ahora la única forma de leer el código: trátalas como artefactos históricos para estudiar, no como software del que depender. El hilo de integración de AgentHub en el repositorio de autoresearch sigue siendo público y es la mejor referencia primaria. Sobre la retirada del repositorio, consulta el relato de la época escrito por un desarrollador que lo bifurcó antes de que se hiciera privado: https://dev.to/alireza_rezvani/karpathys-agent-native-infrastructure-working-python-agent-template-2o9d (marzo de 2026). - Anthropic, Knowledge Graph Construction with Claude (guía, 23 de marzo de 2026): https://platform.claude.com/cookbook/capabilities-knowledge-graph-guide: extracción con salidas estructuradas en Haiku, resolución como razonamiento en Sonnet, ensamblaje con NetworkX y consultas de subgrafos con citas. Es la fuente de la Parte 3.
- Erik Schluntz y Barry Zhang, Building Effective Agents (Anthropic Engineering, diciembre de 2024): los cinco patrones de flujo de trabajo componibles que ancla el Concepto 10.
- Anthropic, How we built our multi-agent research system (Anthropic Engineering, 2025): https://www.anthropic.com/engineering/multi-agent-research-system: la arquitectura de investigación con orquestador-trabajadores, su ventaja de exploración amplia sobre un solo agente y el coste aproximado de quince veces más tokens que cita la nota presupuestaria del Concepto 14. Ese múltiplo se compara con interacciones de chat ordinarias, no con una ejecución de un solo agente de la misma tarea, que es la comparación que suelen presuponer los lectores. Comprueba la publicación activa antes de citar cualquiera de las cifras.
- Anthropic, Introducing dynamic workflows in Claude Code (28 de mayo de 2026; la página ahora incluye una actualización que señala la disponibilidad general): https://claude.com/blog/introducing-dynamic-workflows-in-claude-code: la fuente de la nota detallada de la Parte 2: orquestación generada, decenas a cientos de subagentes paralelos con contexto nuevo, resultados comprobados, progreso reanudable, ajuste
ultracode, advertencia sobre tokens y migración de Bun. Está disponible en la CLI de Claude Code, Desktop y las extensiones de IDE en todos los planes de pago (en Pro se activa desde la fila Dynamic workflows de/config), además de Anthropic API, Amazon Bedrock, Agent Platform de Google Cloud y Microsoft Foundry. La documentación de referencia, no el anuncio, contiene los límites reales: 16 agentes simultáneos y 1 000 agentes por ejecución. Documentación de referencia: code.claude.com/docs/en/workflows. - Peter Steinberger, publicación del 18 de julio de 2026 («Are we still talking loops or did we shift to graphs yet?»), en X (x.com/steipete/status/2078277297791189132, publicada a las 00:34 UTC): las doce palabras que dieron nombre a la temporada. El obituario no es de Steinberger: Hamel Husain publicó «Loop Engineering Is Dead. Enter Graph Engineering» unas cuatro horas y media después, y Santiago Valdarrama (@svpino) publicó la frase ampliamente citada «Loop Engineering is dead. Long live Graph Engineering!». Ambas parecen bromas sobre la rueda de nombres.
- Carlos E. Perez (Intuition Machine), From Loop Engineering to Graph Engineering? (19 de julio de 2026): la fuente de la Parte 5: la historia del bot de soporte, los cuatro fallos del bucle único y sus soluciones estructurales, la advertencia sobre grafos circulares, anclas y nodos congelados, y la conclusión de anclado frente a no anclado. https://medium.com/intuitionmachine/from-loop-engineering-to-graph-engineering-d3ebeb08511c
- Graph Engineering: The Karpathy Loop, Improved 1000x by Itself (PDF de síntesis independiente, julio de 2026): el camino de construcción por etapas, la distinción entre los dos grafos, los cuatro invariantes y la prueba final de trazabilidad. Como indica su portada, no está afiliado con Karpathy ni Anthropic ni respaldado por ellos: léelo como una nota de estudio útil y consulta primero sus fuentes primarias.
- Fortune, cobertura de autoresearch («the Karpathy Loop»), marzo de 2026.
- TechCrunch y otros, sobre la incorporación de Karpathy al equipo de preentrenamiento de Anthropic el 19 de mayo de 2026, con el mandato de formar un equipo que use Claude para acelerar la investigación de preentrenamiento: https://techcrunch.com/2026/05/19/openai-co-founder-andrej-karpathy-joins-anthropics-pre-training-team/
Todos los enlaces estaban vigentes a finales de julio de 2026. Cada repositorio, función preliminar y cifra cambia deprisa. Confirma la fuente activa antes de confiar en ella.
Resumen en una línea
El agente olvida; el grafo, no. Conserva dos grafos de memoria, un DAG para el trabajo y un grafo de conocimiento para los hechos; llena el segundo mediante un esquema, fusiona nombres de forma reversible, grapa un comprobante a cada arista, entrega subgrafos a los trabajadores en vez de volcados y haz que cada revisor cite la arista o la exija. Después conecta los propios bucles: un observador sobre cada número optimizador, un bucle más lento que controle cada objetivo, una puerta entre nodos y anclas que ningún bucle pueda discutir. Un grafo almacena afirmaciones, no verdad: anclado frente a no anclado es el eje que sobrevive a cada cambio de nombre.