Open Source LLMs: Aap Ka Laptop, Aap Ka Server/Cluster aur Cloud
Aik model family, usay run karne ke teen tareeqe. Aap ke laptop par Ollama ke saath. vLLM wali taqatwar machine par, jo aik saath 50 logon ko serve karti hai. Aur OpenRouter ke zariye cloud mein, jahan sab se bare open models rehte hain. Wohi tools, wohi idea, teen scales.
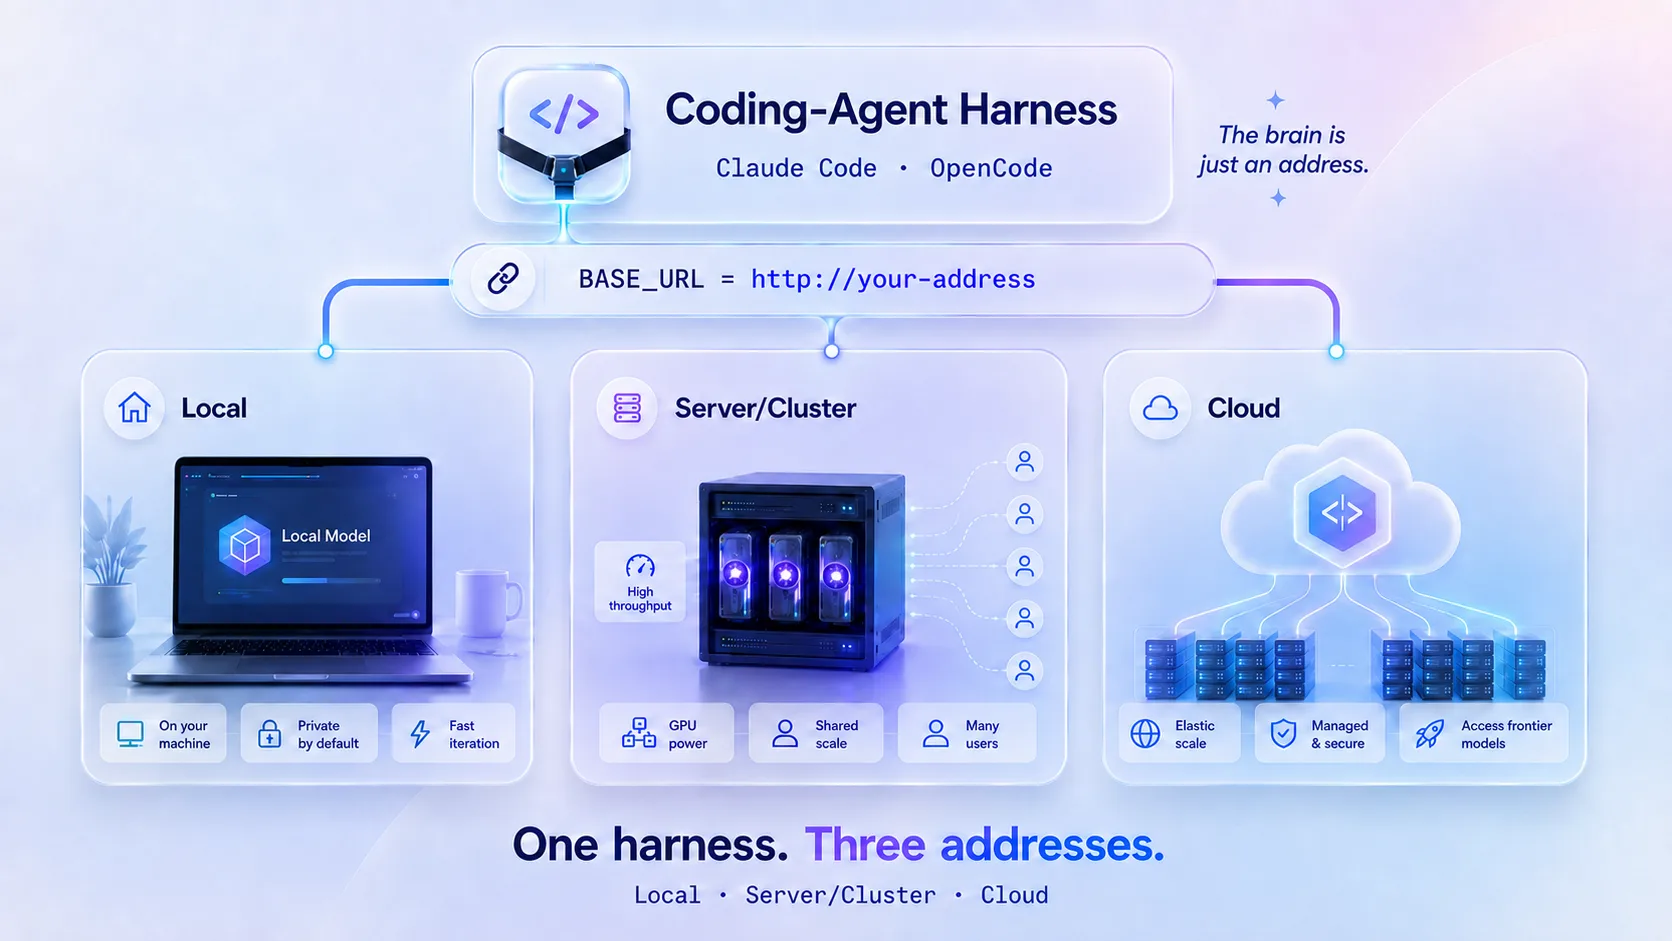
Aap ne pehle AI ka use kiya hai. Aap ne box mein type kiya aur us ne jawab diya. Woh AI aap ke computer mein nahin rehta tha. Woh door kisi company ki bari machines par run hota tha. Aap us ke waqt ka chhota hissa rent kar rahe the.
Yeh course aap ko dastiyab choices ki poori range sikhata hai. Open source models ne khel badla diya: model weights free download kiye ja sakte hain aur koi bhi unhein run kar sakta hai. Lekin "koi bhi run kar sakta hai" aik asal question chhupata hai: unhein kahan run karein? Apne laptop par? Taqatwar graphics card wali rented machine par? Ya kisi aur ke cluster par, kyunke model itna bara hai ke woh aap ke kisi bhi mumkin hardware mein nahin aa sakta?
Yahi is course ke teen tiers hain aur har tier ka apna part hai:
| Part | Tier | Serving layer | Scale | Aap kya kareinge |
|---|---|---|---|---|
| 1 | Local | Ollama | Aik shakhs, aik laptop | Apne computer par model run karke coding agent ko us se joreinge |
| 2 | Server/Cluster | vLLM | kai users, aik machine ya aap ka cluster | usi Qwen3 8B ko 50 concurrent requests par serve karke tabdeeli measure kareinge |
| 3 | Cloud | OpenRouter (gateway) | Frontier models jinhein taqreeban koi host nahin kar sakta | unhi coding agents se Kimi K3 aur DeepSeek V4 Pro chalayenge |
Teen tiers, teen addresses, teen bills. Laptop: http://localhost:11434 par Ollama, koi cost nahin. Server: http://localhost:8000 par vLLM, GPU rental ki cost; provider ke mutabiq 24 GB card ke liye taqreeban $0.50 se $2 har hour. Cloud: https://openrouter.ai/api par OpenRouter, token ke hisab se cost; yeh page likhte waqt har million input tokens taqreeban $0.44 (DeepSeek V4 Pro) se har million output tokens $15 (Kimi K3) tak. Neeche aap seekhenge ke har address kab sahi choice hai. Prices aur rentals badalte hain, is liye budget banane se pehle live check karein.
Poore course ke liye aik picture kaam karti hai. Har AI tool ke do parts hote hain. Aik part aap ki machine par rehta hai aur hands-on kaam karta hai: harness. Doosra part sochne wala brain hai: model. Harness aik address par brain tak pohanchta hai. Part 1 mein address aap ka laptop hai. Part 2 mein woh real graphics card wali aap ke control ki machine hai. Part 3 mein woh trillions of parameters wale models ke aage khari cloud service hai. Harness kabhi nahin badalta. Sirf address badalta hai. Isay aik baar samjhein aur teeno tiers aik hi move ban jate hain.
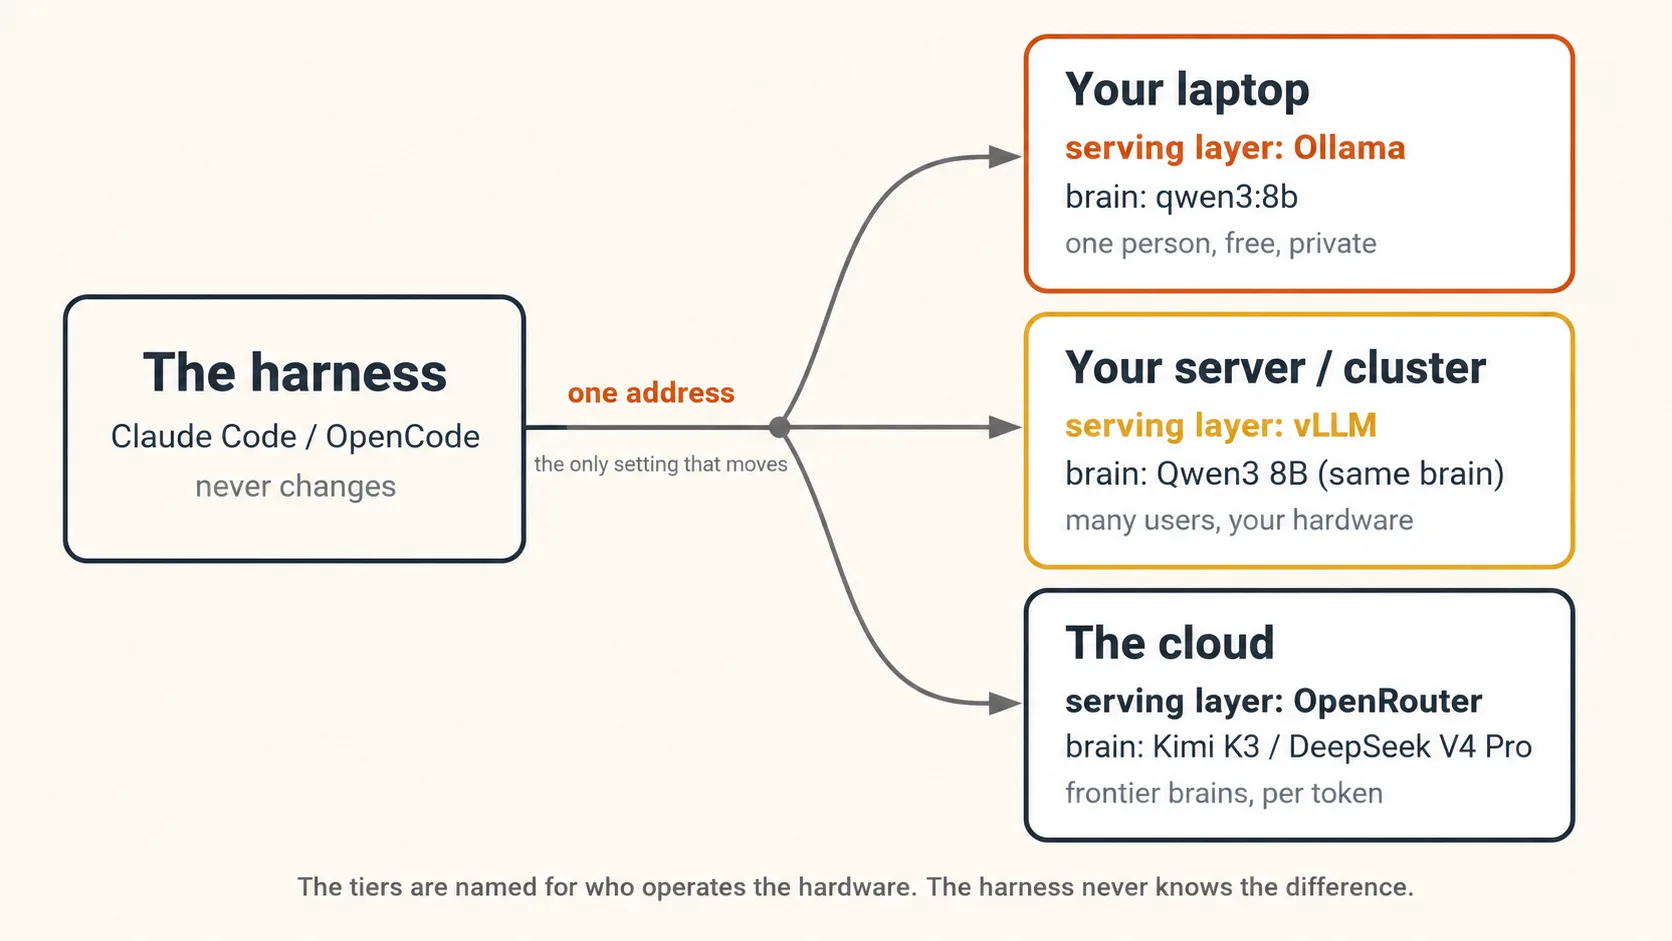
Yeh General Agents mein aap ka pehla stop hai, jahan aap woh AI chunte hain jisay baqi kitab mein chalayenge. Aap brain ko own karne se shuru karte hain, kyunke is se section ka asal idea pehle din se haqeeqat ban jata hai: agent aik harness aur badle ja sakne wale brain ka majmua hai. Is ke baad agent ko achi tarah chalana (Agentic Coding), likhi hui spec se usay direction dena (Spec-Driven Development) aur usay aap ke bina run hone wala loop dena (Loop Engineering) seekhenge.
Ab seedhi zaban mein honest promise aur honest limit. Part 1 kisi bhi machine par real, free aur private hai, halanke aam laptop par bhari coding work bahut aahista chalta hai. Yeh slowness course ka bug nahin hai. Usay dekhna aur wajah samajhna Part 1 ki asal lesson hai. Part 2 ke liye NVIDIA graphics card wali machine chahiye, jisay zyada tar students kuch dollars mein hour ke hisab se rent karte hain. Part 3 ke liye kuch dollars credit wala OpenRouter account chahiye. Har part mustaqil hai. Aaj Part 1 karein aur tayyar hone par baqi parts ke liye lautein.
- Part 1, local model se chat: sirf free Ollama install. Koi bhi kar sakta hai.
- Part 1 ka coding half aur Parts 2 aur 3: pehle se installed coding agent (Claude Code ya OpenCode). Abhi nahin hai? Agentic Coding crash course usay setup karwata hai. Woh course is ke pehle ya baad mein kar sakte hain.
- sirf Part 2: NVIDIA GPU wali Linux machine tak access: standard build ke liye taqreeban 24 GB GPU memory ya compatible hardware par compressed build ke liye taqreeban 16 GB (Part 2 dono paths dikhata hai). Cloud GPU provider se aik-do hours ke liye rent karna aam aur sasta hai.
- sirf Part 3: free OpenRouter account aur kuch dollars credit.
Pehle step se apne computer par saath chala sakte hain. Is page ke commands Bash mein hain, jo macOS, Linux aur WSL ke zariye Windows par kaam karte hain. PowerShell use karne par har tool ke live docs mein matching form dekhein. Coding-agent wale har step mein chhote throwaway git folder ke andar kaam karein, taake agent aap ki kisi aham cheez ko touch na kar sake. Sirf parhi hui teen limits ke muqable mein khud saamna ki hui aik limit zyada sikhati hai.
Asaan zaban mein key words
Isay abhi aik baar parhein. Koi word unclear lage, to wapas ayein. Neeche har concept inhein context mein phir sikhata hai, is liye yahan yaad karne ki zaroorat nahin.
| Term | asaan matlab |
|---|---|
| Model / brain | Asal mein sochne wala AI. Aap words bhejte hain aur woh words lautata hai. |
| Ollama | Free program jo AI model download karke aap ke computer par run karta hai. Aik shakhs ke liye bana hai. |
| vLLM | Free program jo AI model ko kai users ke liye aik saath serve karta hai. Shared machine ke liye bana hai. |
| Serving layer | Model load karke requests ka jawab dene wala software. Ollama aur vLLM dono serving layers hain. |
| OpenRouter | Cloud gateway jo saikron models ko aik address ke peeche rakhta hai. Peeche ke hosts serving layers chalate hain. |
| Harness / tool | Brain ke charon taraf program. Woh aap ki files parhta, commands run karta aur changes dikhata hai. Claude Code aik harness hai. |
| Coding agent | Harness jo aap ke liye code likhta aur edit karta hai: Claude Code ya OpenCode. |
localhost | aisa address jis ka matlab "yahi computer" hai. Aap ki machine khud se baat karti hai, is liye internet ki zaroorat nahin. |
| Address / base URL | Tool apna work jahan bhejta hai. Usay localhost par point karein aur work aap ki machine par rehta hai. |
| Tool call | chhota exact message jis se model kehta hai "is file ko edit karein" ya "yeh command run karein". Yeh data hai, sentence nahin. |
| Token | Model ke parhne aur billing ki unit: word ka aik hissa, English ke taqreeban teen se char letters. |
| Context window | Model aik baar mein kitne tokens sambhal sakta hai. Bahut chhota ho, to task ki shuruaat bhool jata hai. |
num_ctx | Context window ki Ollama setting. Default aap ki machine par munhasir hai aur coding agents ke liye aksar bahut chhota hota hai. |
| Do walls | Local coding setup ko do cheezen clear karni hain: kaafi strong model aur kaafi fast hardware. |
| Concurrency | aik waqt par aane wali requests ki number. Aik user ki concurrency 1 hai. Classroom ki concurrency 50 hai. |
| Throughput | har second kul useful work, yahan sabhi users ke combined tokens per second mein measured. |
| Continuous batching | vLLM ki technique: kai requests ko GPU mein saath bhejna aur darmiyan mein nai requests ko khali slots mein daalna. |
| Open-weight model | Aisa model jis ke trained weights download kiye ja sakte hain. Formal matlab mein hamesha "open source" nahin: training data aur kuch terms closed reh sakte hain. |
| Frontier open model | Charts ke top par open-weight model, jo itna bara hai ke sirf clusters usay serve kar sakte hain. Kimi K3 aik example hai. |
| API key | Secret string jo sabit karti hai ke account aap ka hai. Cloud tier mein billing bhi isi se hoti hai. |
Is course mein do layers saath chalti hain aur bahut alag speed se purani hoti hain. Pehli yaad rakhein. Doosri lookup karein.
- Mustaqil layer. Model teen scales par reh sakta hai: aap ki machine, aap ke control ki machine ya rented cluster. Tool badle ja sakne wale address par us tak pohanchta hai. Aik user ke liye bani serving layer load mein queue banati hai, kai users wali nahin. Sahi tier privacy, hardware aur cost par depend karta hai, jinhein aap pehle mehsoos aur phir naam denge. Neeche ke har command ke badalne ke baad bhi yeh sach rahega.
- Mechanical layer. Har version number, flag, model name, price aur setting. Ollama, vLLM, OpenRouter aur coding tools tezi se badalte hain. Is liye har command ko live docs ka pointer maanein, yaad rakhne ke qabil fact nahin. Course aur current docs mein disagreement ho, to docs sahi hain.
Yeh course kya cover karta hai
| Concept | Part | Aap kya kareinge |
|---|---|---|
| 1 | 1 | Taqreeban do minutes mein apne computer par model run karke us se chat kareinge |
| 2 | 1 | Woh aik idea seekhenge jo sab chalata hai: brain sirf aik address hai |
| 3 | 1 | Model se kaam karwayeinge: aik command se coding agent ko us se joreinge |
| 4 | 1 | Real coding task de kar mehsoos kareinge ke local brain kahan tikta ya tootta hai |
| 5 | 1 | Do walls samjheinge: kaafi strong model aur kaafi fast hardware |
| 6 | 1 | Real tool call ke andar dekhenge, jisay weak model ghalat karta hai |
| 7 | 1 | Tay kareinge ke brain own karna kab sahi hai |
| 8 | 2 | Dekhenge Ollama one-person kitchen kyun hai: 50 requests bhej kar queue banate dekhenge |
| 9 | 2 | Usi Qwen3 8B ko vLLM se serve karke continuous batching ka matlab seekhenge |
| 10 | 2 | Wohi 50 requests vLLM ko bhej kar dono curves plot aur difference parhenge |
| 11 | 2 | Claude Code aur OpenCode ko vLLM server se joreinge, translator ki zaroorat nahin |
| 12 | 2 | Tay kareinge ke server tier kab sahi hai |
| 13 | 3 | Frontier open models jaanenge jinhein taqreeban koi self-host nahin kar sakta: Kimi K3, DeepSeek V4 Pro |
| 14 | 3 | OpenRouter ke zariye dono ko Claude Code aur OpenCode se chalayenge |
| 15 | 3 | Performance aur price mein chun kar har job ke liye sahi tier tay kareinge |
| 16 | 3 | Teeno tiers ke aage aik router rakh kar tier policy ko config mein badalenge |
| A | Appendix | Part 2 server ko keys, budgets aur aik menu wali shared service mein badalenge |
📚 Teaching Aid
Poori presentation dekhein: Open Source LLMs: Aap Ka Laptop, Aap Ka Server/Cluster aur Cloud
Part 1: Local tier. Aap ke laptop par model (Ollama)
Is part ki serving layer Ollama hai aur scale aik shakhs, aik machine hai. Yahan sab free aur private hai.
1. Apne computer par brain: yahan se shuru karein
Isay samajhne ka sab se tez tareeqa aik baar karna hai. Is liye theory se pehle apne computer par model run karke us se baat karein. Is part ke liye code likhne ki zaroorat nahin. Koi bhi isay kar sakta hai.
Yeh karne wala free program Ollama hai. Woh AI model download karke aap ke computer par run karta hai. Apni machine wala tareeqa chunein.
- App (Mac ya Windows)
- Terminal (Linux samet koi computer)
- ollama.com/download par jayein aur aam tareeqe se Ollama install karein. Is mein aik chhoti chat app shamil hai.
- Ollama app kholein. Woh Mac ke menu bar ya Windows system tray mein rehti hai.
- Upar selector se model chunein.
gemma3:4bjaise chhote model se shuru karein. Pehli baar chunne par kuch GB download honge, jis mein kuch minutes lagenge. - Box mein question type karke Enter dabayein.
Bas itna hi. Answer aap ke computer par run ho rahe model se aya hai.
Terminal khol kar aik command run karein. Woh pehli baar model download karti hai, phir chat khol deti hai:
ollama run gemma3:4b
Question type karke Enter dabayein. Chat chhorne ke liye /bye type karein.
Ollama abhi nahin hai, to pehle ollama.com/download se install karein aur phir upar wala command run karein.
Kaun sa model chunein? Chhote se shuru karein. Chhota model tez jawab deta hai aur aam machine mein fit hota hai. Baad mein bare models try kar sakte hain.
| Model | Approximate download | Comfortable RAM | kis ke liye acha hai |
|---|---|---|---|
gemma3:1b | 1 GB se kam | taqreeban 4 GB | chhota aur tez, lekin weak answers |
llama3.2:3b | taqreeban 2 GB | taqreeban 8 GB | aik solid, chhoti first chat |
gemma3:4b | taqreeban 3 GB | taqreeban 8 GB | Strong chhota model, acha default |
qwen3:8b | taqreeban 5 GB | taqreeban 16 GB | behtar answers, zyada memory chahiye |
Table ka aik model is part se aage bhi important hai: qwen3:8b. Course Part 1 aur Part 2 mein isay constant rakhta hai, taake tabdeeli hone par wajah saaf ho. Machine mein fit hota hai, to abhi pull karein. Nahin, to yahan chhota model use karein aur Part 2 mein hardware rent karein.
Models update hone par upar ke exact names aur sizes badalte hain. Kisi tag par munhasir hone se pehle ollama.com/library par check karein. Live source check karne ki aadat hi "look it up" layer ko laagu karti hai.
Concept 1 tab done hai jab: aap ne question poocha aur apne computer par run ho rahe model ne jawab diya. Wifi off karke phir poochein. Woh phir bhi kaam karta hai. Kuch bhi computer se bahar nahin gaya.
Aakhri baat par kuch der rukna sahi hai. Model aap ki machine par chhote program ki tarah run hota hai aur localhost naam wale address par listen karta hai. Is ka matlab "yahi computer" hai. Aap ki machine khud se baat kar rahi hai. Is liye internet off hone par bhi kaam chalta hai.
Agar aap sirf apne computer par private AI chahte the, to woh mil gaya. Isay kabhi bhi offline aur free run kar sakte hain; type kiya kuch bhi computer se bahar nahin jata. Sirf yeh jaanna bhi mufeed hai.
Baqi course usi local model se kaam karwata hai: files parhna, code likhna aur aap ke liye edit karna. Yeh interesting lage, to aage parhein. Nahin, to bhi aap ko win mil chuki hai.
2. Sab chalane wala aik idea: brain sirf aik address hai
Aap ne abhi isay kar liya. Ab jo hua us ka naam rakhein, kyunke yeh idea aap ke har AI tool aur course ke teeno tiers ke neeche hai. Isay aahista samajhna zaroori hai.
Aap ke AI tool ke do parts hain:
- Harness: aap ki machine ka program. Woh files parhta, commands run karta aur tabdeeli dikhata hai. Claude Code aik harness hai. Ollama chat app us se zyada saada harness hai.
- Brain: woh model jo sab parh kar tay karta hai ke kya kehna ya karna hai.
Harness usi tarah address se brain tak pohanchta hai jaise browser website tak pohanchta hai. Isay phone number samjhein. Harness number dial karta hai aur doosri taraf jawab dene wala sochta hai.
Aam tor par yeh number door company ki machines ki taraf jata hai. Lekin yeh sirf setting hai. Number badlein aur wohi harness ab doosre brain se baat karta hai. Concept 1 mein naya number localhost tha: aap ki apni machine. Is liye jawab dene wala brain aap ke laptop wala tha.
Food delivery app ki tasawwur karein. Phone ki app har din wohi rehti hai. Restaurant address badlein aur wohi app doosri kitchen se order karti hai. Aap ka AI tool app hai. Address phone number hai. Us address wali kitchen mein model answer banata hai.
Yeh part aasani se ghalat samjha jata hai aur aage ja kar important hoga. Local brain pehle wale brain ki chhoti copy nahin hai. Woh alag brain hai aur bahut weak ho sakta hai. App wohi, kitchen doosri, jahan cook kam skilled ho sakta hai. Isay yaad rakhein. Yeh seedhe Concept 5 tak jata hai.
Kitchen wali picture yaad rakhein, kyunke course teen kitchens tak jata hai. Part 1 aap ke ghar ki kitchen hai. Part 2 aap ki chalayi industrial kitchen hai, jo poore restaurant ko serve karne ke liye bani hai. Part 3 duniya ke best restaurants se order karna hai, kyunke un ki kitchen kisi ghar mein nahin aa sakti. App poore waqt wohi rehti hai. Sirf address badalta hai.
Aap ne aik address badla aur apne computer ke model ne answer diya. AI tool ka kaun-sa part badla aur kaun-sa wohi raha? Brain badla: ab words aap ke computer wale model ko jate hain. Harness wohi raha: app, buttons aur us se baat karne ka tareeqa. Aap ne sirf dial hone wala address badla.Answer dekhein
3. Is se kaam karwayein: local brain par coding agent
Local model se chat achi shuruaat hai. Lekin agent sirf chat nahin karta. Woh files parhta, code likhta aur aap ke liye commands run karta hai. Is liye coding agent ko usi local brain se jorein.
Yeh step coding agent ko local model se jorta hai. Is liye Claude Code ya OpenCode pehle se installed chahiye. Koi aik hai, to ready hain. Nahin, to pehle install karein; Agentic Coding crash course poora process dikhata hai. Neeche wala command usay connect aur launch karta hai. Woh agent install nahin karta.
Yeh karne ke do tareeqe hain. Asaan tareeqa aik command hai. Manual tareeqa neeche ki wiring dikhata hai, jisay aik baar dekhna mufeed hai. Tab chunein.
- Bas run karein
- haath se setup karein
Ollama ke recent versions settings edit kiye bina coding agent connect aur launch kar sakte hain. Aik command:
ollama launch claude
Yeh Claude Code ko local model use karne ke liye setup karke start karta hai. Yeh aap se model poochega, ya pehle pull kiya hua model name de sakte hain:
ollama launch claude --model qwen3:8b
Doosre tool ke liye matching command hai: ollama launch opencode.
unknown command "launch" dikheollama launch ke liye recent Ollama, version 0.15 ya naya chahiye. Error dikhe, to Ollama update karein: ollama.com/download se installer phir run karein ya app se update karein. Version ollama --version se check karein.
Chhoti companion skill poora setup karti hai aur waqt lagane se pehle hardware ki sachai batati hai. Agent usay parh kar kaam karta hai. Install karein, phir aam words mein kahein:
npx skills add panaversity/local-llm-agentic-coding --agent claude-code opencode -y
mujhe local model par coding agent chalane ke liye setup karein. Pehle hardware ko honestly check karein, phir step by step guide karein aur kisi bare action se pehle approval ke liye rukein.
Installer anjaan name ko chup chaap skip kar sakta hai, is liye pehle npx skills add panaversity/local-llm-agentic-coding --list se preview kar sakte hain.
Upar wala command kuch settings bharta hai. Ab dekhein ke woh kya bharta hai, taake wiring samjhein aur kahin bhi kar saken. Dono tools usi local model se thore alag tareeqe se baat karte hain.
- Claude Code
- OpenCode
Claude Code local model se aise baat karta hai jaise Anthropic se kar raha ho. Usay local address par point karein, placeholder token dein aur pakka karein ke real API key set nahin hai:
export ANTHROPIC_BASE_URL=http://localhost:11434   # the local address, bare host, no /v1
export ANTHROPIC_AUTH_TOKEN=ollama                 # any non-empty word; it is sent as "Bearer ollama"
export ANTHROPIC_API_KEY=                          # must be empty, or it overrides the line above
claude --model qwen3:8b                             # use a model tag you have pulled
Kuch chhote notes pareshani bachate hain:
- Address bare hai, sirf host aur port. Claude Code baqi path khud jorta hai.
/v1na jorein. - Ollama model ko
--modelse naam dena hoga, warna Claude Code aise model names dhoondega jo local machine mein nahin hain. - Windows par
localhostghalat jagah point kar sakta hai, is liye kai loghttp://127.0.0.1:11434use karte hain. Yeh official docs ke bajaye users ke zariye widely reported hai.
Har session mein settings rakhne ke liye unhein har baar type karne ke bajaye env block mein ~/.claude/settings.json ke andar rakhein:
{
  "env": {
    "ANTHROPIC_BASE_URL": "http://localhost:11434",
    "ANTHROPIC_AUTH_TOKEN": "ollama",
    "ANTHROPIC_API_KEY": ""
  }
}
OpenCode local model se aise baat karta hai jaise OpenAI se kar raha ho. Woh officially local models support karta hai. Supported tareeqa local server ko opencode.json file mein describe karna hai. Isay aik baar haath se karna mufeed hai, kyunke address aur model mapping samne dikhte hain. Aakhir mein /v1 dekhein. Yahan yeh required hai aur Claude Code address se sirf difference hai:
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "ollama": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Ollama (local)",
      "options": { "baseURL": "http://localhost:11434/v1" },
      "models": { "qwen3:8b": { "name": "Qwen3 8B (local)" } }
    }
  },
  "model": "ollama/qwen3:8b"
}
Isay project ke opencode.json mein ya sabhi projects ke liye ~/.config/opencode/opencode.json mein rakhein. models ke neeche model name aisa tag hona chahiye jisay aap ne sach mein pull kiya hai. Windows par 127.0.0.1 use karein, localhost nahin.
Dono tool tabs parh kar shape dekhein. Wohi model, wohi machine, wohi port. Claude Code bare address dial karta hai. OpenCode usi address ke aakhir mein /v1 lagata hai. Local models ke liye dono mein bas yahi difference hai. Yeh contrast seekh lein, phir kisi tool ko kisi local brain se jor sakte hain. Parts 2 aur 3 mein isay bina tabdeeli phir use kareinge.
Concept 3 tab done hai jab: coding agent shuru ho gaya aur us ka model aap ke computer wala hai. Us se chhota question poochein. Answer aap ke laptop se aya, door company se nahin.
Yeh Concept 2 ko real banata hai. Aap ne address ko localhost kiya aur wohi coding agent ab work aap ke computer ke brain ko bhejta hai.
4. Ab push karein: real task dein aur dekhein
Local model ka question answer karna chhota first step hai. Local model ka real coding work karna asal test hai. Is liye usay run karein.
Thora real code wali chhoti throwaway git folder mein kaam karein, chahe sirf aik script ho. Agent ko local brain par point karke aisa prompt paste karein:
is folder ko dekhein. Aik chhota safe improvement dhoondein, change karein aur dikhayein ke kya badla.
Ab ghor se dekhein. Do mein se aik baat hogi aur dono lesson hain.
Strong machine par, yani ache graphics card aur mid-size model ke saath, yeh kaam karta hai. Local brain files parhta, plan banata, edit karta aur clean change dikhata hai. Us pal free, offline aur private asal banate hain. Yeh aap ka setup hai aur kaam kar raha hai.
Aam laptop par, yani graphics card ke bina chhote model ke saath, wall mehsoos hoti hai. Har step mein minutes lag sakte hain, kyunke machine bahut sara text aahista parhti hai. Ya run darmiyan mein bad tool call error ke saath ruk sakta hai. Brain ne "is file ko edit karein" kehna chaha, lekin format ghalat kar diya.
Abhi kuch fix na karein. Bas dekhein ke kya hua aur kaisa laga. Fast aur clean? Ya slow ya broken? Wohi feeling agle concept ka raw material hai.
Task aahista chala ya toota, to kuch ghalat nahin hua. Aap ne chhoti machine par bara model run karne ki honest limit dekhi. Money ya time lagane se pehle yeh jaanna real aur useful hai. Agla concept wohi feeling samjhata hai.
Concept 4 tab done hai jab: aap ne local brain se real code change manga aur result dekha, chahe clean edit, lamba wait ya broken run mila.
5. Woh kyun chala ya toota: do walls
Ab explanation, kyunke aap ne woh cheez mehsoos kar li jisay yeh samjhata hai. Part 1 ka sab se important idea saaf zaban mein samjhein.
Local coding agent ko do alag walls clear karni hoti hain. Woh aik wall nahin hain aur aik ka fix doosre ke liye kuch nahin karta.
Pehli wall capability hai. Jab model act karta hai, aur coding work mein taqreeban har turn par karta hai, to usay valid tool call likhni hoti hai. Yani "is file ko edit karein, is line ko us line se badlein" us exact strict format mein kehna jisay harness expect karta hai. Chhote models aksar isay ghalat karte hain. Tool skip kar dete hain ya format bigar dete hain, phir run ruk jata hai. Tool use ke liye trained strong model aam tor par isay fix karta hai. Faster hardware nahin: fast machine par tiny model phir bhi broken tool calls likhta hai.
Doosri wall throughput hai. Har turn mein harness aap ke task ke shuru hone se pehle model ko lambi instruction bhejta hai, jis mein tool rules aur woh jo kar sakta hai un ki definitions hoti hain. Machine ko sab tezi se parhna parta hai. Graphics card ke saath aik moment lagta hai. Us ke bina sirf processor par har turn minutes le sakta hai. Graphics card isay fix karta hai. Smarter model nahin: slow machine par brilliant model bhi bahut slow hai.
| Wall | Kya chahiye | Kis se fix hoti hai | Kis se fix nahin hoti |
|---|---|---|---|
| Capability | Act karte waqt sahi tool call | Tool use trained strong model | sirf faster hardware |
| Throughput | lambi instruction ko seconds mein parhna | Graphics card (GPU) | Smarter, smaller model |
Neeche ki table se pehle size par honest note: reliable tool use ke liye universal parameter-count floor nahin hai. Tool-use training, chat template aur harness fit raw size jitne important hain. Achi tarah trained chhota model kharab trained bare model ko hara sakta hai. Phir bhi aaj ke common local models mein rough pattern hai ke bare models multi-step tool use ko zyada reliably handle karte hain. Is page ki tables wohi pattern batati hain.
Cheap machines dono walls aik saath miss karti hain. Is liye aam laptop model se chat ke liye thik hai, coding agent run karne ke liye nahin: wiring sahi hai, lekin koi wall clear nahin hui.
Concept 2 ki kitchen ke andar zoom karein. Meal do cheezen tay karti hain: cook aur stove. Cook model hai. Stove machine hai. Capability poochti hai ke cook har baar sahi order banane ke liye skilled hai ya nahin. Throughput poochti hai ke stove minutes ke bajaye seconds mein serve karne jitna fast hai ya nahin. Slow stove par great cook phir bhi wait karata hai. Fast stove par clumsy cook dish phir bhi bigarta hai. Dono chahiye.
Hardware par aik honest sentence yaad rakhein. Is page ki har cheez graphics card wali rented cloud machine par wohi hai: wiring, settings, do walls. Sirf speed badalti hai. Taqreeban 16 se 24 GB memory wala graphics card local setup ko sach mein usable coding agent bana deta hai. Yahi Part 2 ka doorway hai, jahan waisi machine rent karke woh kareinge jo laptop kabhi nahin kar sakta.
Kaun-sa model kis machine mein fit hota hai, us ki rough guide:
| Model | Size | zaroori memory | Coding work ke liye ready? |
|---|---|---|---|
llama3.2:3b | 3B | taqreeban 8 GB | nahin. Chat ke liye acha, tool calls bigarta hai. |
qwen3:8b | 8B | taqreeban 16 GB | Simple tasks ke liye thik |
phi4:14b | 14B | taqreeban 12 GB | is lineup mein practical floor ke aas paas |
qwen3:30b-a3b | 30B mix | taqreeban 20 se 24 GB | Best balance: strong answers, phir bhi quick |
qwen3:32b | 32B | taqreeban 24 GB | Strong, upar wale mix se thora slow |
Task run hua, lekin har turn mein four minutes lage. Usi laptop par bahut smarter model laga dete hain. Kya woh fast hoga? Nahin. Slow turn throughput wall hai aur smarter model usay nahin badalta. Smarter model bara hone ke wajah aur slow bhi ho sakta hai. Throughput graphics card se fix hoti hai, model choice se nahin. Dono walls ko milana wohi ghalti hai jisay yeh concept rokta hai.Answer dekhein
6. Andar dekhein: tool call asal mein kya hai
Concept 5 ne kaha weak model "tool calls bigarta hai". Yeh vague lagta hai. Real tool call dekhein, kyunke usay dekh kar poori baat saaf hoti hai.
Healthy tool call aam writing nahin hai. Yeh structured data ka chhota piece, exact instruction hai jisay harness execute kar sakta hai. Woh aisi dikhti hai:
{
  "type": "tool_use",
  "name": "edit_file",
  "input": { "path": "README.md", "old": "Hello", "new": "Hello, world" }
}
Harness isay parh kar file edit karta hai. Model ne change khud nahin likha. Us ne precise instruction bheji aur harness ne kaam kiya. "Model tools use karta hai" ka asal matlab yahi hai. Isi moment chat model chat box se act karne wali cheez banta hai.
Ab dekhein ke bahut weak model kya karta hai. Woh input ko real object ke bajaye text blob ki tarah bhejta hai aur harness usay aise validation error se reject karta hai:
invalid tool arguments: expected object, got string
Exact wording harness ke mutabiq badalti hai. Failure ka shape important hai: arguments ghalat structure mein aye, is liye harness un par act karne se mana karta hai.
Run ruk jata hai. Kuch edit nahin hota. Yahi aik bigra message aksar Concept 4 wala run khatam karta hai. Yeh capability wall ko paas se dekhna hai.
Aik aur cheez tay karti hai ke yeh kaam karega ya nahin: context window. Yeh model ke aik baar mein rakhne wale tokens ki number hai; token word ka piece aur models ki asal counting unit hai. Ollama mein isay num_ctx set karta hai. Harness har turn lambi instruction bhejta hai aur Ollama aap ki machine ki graphics memory se default window chunta hai. Zyada tar laptops mein 24 GiB se kam VRAM hone par default sirf 4,096 tokens hai. Itni chhoti window zyada tar instruction ko chup chaap kaat deti hai. Trap yeh hai: koi error nahin ata. Ollama instruction trim karke phir bhi answer deta hai. Chat thik lagta hai, lekin coding tasks confusing tareeqe se fail hote hain, kyunke model ne tool-call format batane wala part dekha hi nahin. Truncated window is pattern ka sab se common cause hai, par akela nahin. Is liye pehle isay check karein, assume nahin.
Fix window bari karna hai. Agents aur coding tools ke liye Ollama ki current guidance kam-se-kam 64,000 tokens hai. Agent run hone par us se bas keh sakte hain:
Context window bahut chhoti laga rahi hai aur tool calls tora rahi hai. Isay kam-se-kam 64,000 par set karke task phir try karein.
gehrai se: chhoti window bina warning cheezen kyun torti hai
Context window ko 64,000 tokens ya zyada karna "mera local coding agent broken hai" ka sab se common fix hai. Isay kai tareeqon se set kar sakte hain: Ollama app settings mein slider, server ko OLLAMA_CONTEXT_LENGTH=64000 se shuru karke, custom model file (Modelfile mein PARAMETER num_ctx 64000) ya chat session mein /set parameter num_ctx 64000 se. Bari windows ko zyada memory chahiye aur ollama ps dikhata hai ke running model ko asal mein kaun si window mili. Setup chat answer karta lekin real tasks fail karta hai, to pehle context window check karein.
Quick fix list kholein
- Chat answer karta hai, lekin real tasks ki instructions ignore karta hai. Context window shayad bahut chhoti hai, is liye instructions kata gayin. Doosre causes dhoondne se pehle
num_ctxko 64,000 ya zyada karke retest karein. - har turn minutes leta hai, phir timeout hota hai. Machine lambi instruction waqt par parhne ke liye slow hai.
export API_TIMEOUT_MS=1200000se timeout barha sakte hain. Phir bhi timeout ho, to throughput wall sach bata rahi hai. - Missing key ya connectors off hone ka message. Harmless hai. Aap ne placeholder token set kiya hai aur local model woh features use nahin karta, is liye dikhta hai.
Inhein yaad karne ki zaroorat nahin. Agent kisi bhi fix mein guide kar sakta hai.
Concept 6 tab done hai jab: aap ne real tool call ko structured data ki tarah dekha aur samajhte hain ke bigri call ya bahut chhoti context window local coding agent ko torti hai.
7. Brain own karna kab sahi hai
Ab isay run kar sakte hain. Honest question hai ke kab karna chahiye.
Cloud mein bara model rent karna ya coding agent ko normal tareeqe se use karna aam tor par asaan aur aksar smarter hai. Is liye local kuch specific cases mein jeetta hai, jinhein saaf samajhna sahi hai:
- Privacy. Work machine se bahar nahin jata. Sensitive ya regulated kaam mein yahi decision tay kar sakta hai.
- Offline. Network, account ya outage nahin. Disk wala model plane ya locked-down firewall ke peeche bhi kaam karta hai.
- Cost, jab work poora din chale. kisi service par single request sasti hai. Lekin poore month har few minutes chalane wala loop alag bill hai. Work kabhi na ruke, to brain own karna cloud se sasta ho sakta hai.
Aakhri baat kitab mein do baar important hai. Loop Engineering mein aise agents banayeinge jo poora din khud run aur aap ke sote waqt apna work check karte hain. Wahin kis ka brain loop chalata hai aur har run kitna cost karta hai, detail nahin design bana jata hai. Aap ne abhi woh brain own karna seekha.
Aik aur baat dekhein, jo is poore part ki quiet lesson hai. Companion skill use ki, to haath se setup nahin kiya. Aap ne skill install ki aur agent ne use kiya. Skill sirf SKILL.md file wali folder hai, wohi shape jo skills crash course mein seekhi. Yani apne knowledge ko waise package aur kisi agent ke install karne ke liye share kar sakte hain. Publish karne ke liye ready hon, to gh skill publish --dry-run ship karne se pehle Agent Skills spec ke against check karta hai.
Part 1 poora hai. Aap brain own karte hain, do coding agents ko us se jor chuke hain aur usability tay karne wali do walls jante hain. Lekin banayi hui cheez par ghor karein: kitchen ne thik aik customer ko serve kiya. Aap ko. Aik saath 10 requests bhejein aur woh line mein wait karayegi. Wohi line aur usay hatane wala software Part 2 hai.
Part 2: Server tier. Aik machine, kai users (vLLM)
Is part ki serving layer vLLM hai aur scale aik taqatwar machine par kai users hai. Model nahin badalta. Yahi poora point hai.
Sab se pehle is part ka naya word naam dein: serving layer. Yeh model ko memory mein load aur requests ka answer dene wala software hai. Ollama serving layer hai. vLLM serving layer hai. Is part mein brain constant, Qwen3 8B, rakhte hain aur neeche ki sirf serving layer badalte hain. Practice jitna mumkin banaye, baqi sab fixed rakhein, aik cheez badlein aur measured difference zyada tar usi ka hoga. Yeh sirf good science nahin. Poore career mein agent systems aise debug kareinge: variable isolate karein, phir measure karein. Honest caveat bhi saath hai: yeh teaching experiment hai, laboratory nahin. Model precision, runtime code aur configuration ke chhote differences saath aate hain, is liye claim expected pattern hai, defend karne wala decimal nahin.
NVIDIA graphics card wali Linux machine. Neeche ke standard full-precision build ke liye taqreeban 24 GB GPU memory rakhein ya compressed FP8 build ke saath 16 GB card use karein; Concept 9 dono paths dikhata hai. Taqreeban kisi ke paas aisi machine nahin hoti aur yeh thik hai: cloud GPU provider se aik do hours rent karne mein kuch dollars lagte hain aur har command rented machine par bilkul waisi hi hai. Abhi rent nahin kar sakte, to bhi part parhein. Aakhir ki do curves khud draw karne se pehle bhi samajhne ke qabil hain.
8. Aik shakhs ki kitchen: Ollama par 50 requests bhej kar dekhein
Part 1 aik claim par khatam hua: Ollama setup aik customer serve karta hai. Isay slogan nahin, measurement se prove karein.
Experiment yeh hai. Chhoti script likhenge jo model server par kai requests aik waqt par bhej kar do numbers report karti hai: poora batch kitna waqt leta hai aur sabhi requests ka combined total tokens per second. Aik saath aane wali requests ki number concurrency hai. Aik user ki concurrency 1 hai. Aik saath Enter dabate 50 students ki classroom concurrency 50 hai.
Ollama aur vLLM aik standard request format, OpenCode config wala OpenAI-compatible format, answer karte hain. Is liye aik script dono test karti hai. Sirf address aur model name badalte hain. Isay bench.py ki shakal mein save karein:
# bench.py: fire N concurrent requests at a model server and measure throughput.
# usage: python bench.py <base_url> <model> <concurrency>
import asyncio, sys, time
import httpx

BASE_URL = sys.argv[1]        # http://localhost:11434/v1 (Ollama) or http://localhost:8000/v1 (vLLM)
MODEL = sys.argv[2]           # qwen3:8b (Ollama) or Qwen/Qwen3-8B (vLLM)
N = int(sys.argv[3])          # how many requests at once

PROMPT = "Explain in about 200 words how a bank reconciliation works."

async def one_request(client):
    r = await client.post("/chat/completions", json={
        "model": MODEL,
        "messages": [{"role": "user", "content": PROMPT}],
        "max_tokens": 300,
        "temperature": 0,
    })
    r.raise_for_status()
    return r.json()["usage"]["completion_tokens"]

async def main():
    async with httpx.AsyncClient(base_url=BASE_URL, timeout=3600) as client:
        await one_request(client)   # warm-up: load the model before timing anything
        start = time.perf_counter()
        results = await asyncio.gather(*[one_request(client) for _ in range(N)],
                                       return_exceptions=True)
        wall = time.perf_counter() - start
    ok = [r for r in results if isinstance(r, int)]
    failed = len(results) - len(ok)
    total = sum(ok)
    print(f"concurrency={N}  ok={len(ok)}  failed={failed}  tokens={total}"
          f"  time={wall:.1f}s  throughput={total/wall:.1f} tok/s")

asyncio.run(main())
Aik zaroori dependency install karein (pip install httpx), pakka karein ke Ollama qwen3:8b pull karke run ho raha hai aur run reproducible banane ke liye aik setting pin karein. Ollama ke parallel slots machine ke mutabiq badalte hain aur fair experiment apni settings batata hai. Ollama server ko OLLAMA_NUM_PARALLEL=4 ollama serve se restart karein (PowerShell: $env:OLLAMA_NUM_PARALLEL=4; ollama serve), taake aap ki aur classmate ki curve same rules se aye. Phir sweep run karein. Isay rented GPU machine par karein, taake Part 2 comparison fair ho: dono serving layers ke liye same hardware.
python bench.py http://localhost:11434/v1 qwen3:8b 1
python bench.py http://localhost:11434/v1 qwen3:8b 5
python bench.py http://localhost:11434/v1 qwen3:8b 10
python bench.py http://localhost:11434/v1 qwen3:8b 25
python bench.py http://localhost:11434/v1 qwen3:8b 50
Har concurrency level teen baar run karke teeno throughput ki median likhein, taake one-off hiccup data point na bane. Concept 10 ke plot ke liye woh paanch medians chahiye.
Ab result parhein. Concurrency 1 par thik tha. Barhane par total throughput taqreeban nahin badla, lekin wall-clock time lamba hota gaya. 50 par batch ne shayad kai minutes liye. Andar simple baat hui: Ollama kuch requests parallel run karta hai, yani OLLAMA_NUM_PARALLEL slots jinhein abhi 4 pin kiya, aur baqi sab ko queue mein rakhta hai. Request number 40 slot khulne tak shuru nahin hoti. Machine ka sab se expensive part, graphics card, batch ka zyada tar waqt queue ke saath wait karta hai.
Yeh Ollama ki flaw nahin hai. Yeh honest design choice hai: Ollama aik shakhs ke laptop ko comfortable banane ke liye bana hai. Restaurant banane ke liye kabhi nahin bana.
Yeh aik cook aur do burners wali home kitchen hai. Aik dinner guest, behtar. 50 guests hon, to 45 order slip le kar hallway mein khare hain. Cook lazy nahin aur stove broken nahin. Kitchen crowd ke liye design hi nahin hui.
Concept 8 tab done hai jab: Ollama par concurrency 1, 5, 10, 25 aur 50 ke paanch measured throughput numbers hain aur aap ne queue ko apni aankhon se banate dekha.
9. Industrial kitchen: usi brain ko vLLM se serve karein
Ab doosri serving layer. vLLM aik free open source program hai jis ka aik kaam hai: graphics card waste kiye bina model ko kai users ke liye aik saath serve karna. Yeh UC Berkeley research se aya aur ab companies ke open models production mein serve karne ka standard tareeqa hai. Ollama aik shakhs ki comfort optimize karta hai, vLLM total throughput.
Woh throughput do ideas se milta hai, jinhein simple words mein jaanna useful hai:
- Continuous batching. Graphics card kai kaam aik saath karne mein best hai. Is liye vLLM kai requests saath bhejta hai. Clever part yeh hai: aik request khatam hote hi waiting request doosron ko roke bina darmiyan stream mein us ki slot mein ati hai. Queue mein work ho, to card idle nahin rehta. Is ka muqabla us queue se karein jahan card kuch requests serve karke khatam karta, phir agli uthata hai.
- Paged memory (PagedAttention). Har active conversation ko card ki working memory chahiye. Purane servers har conversation ke liye bara block reserve karte the, jo zyada tar empty rehta. Is liye card sach mein full hone se pehle "full" dikhta tha. vLLM memory ko chhoti pages mein kaat kar sirf zaroorat par deta hai, jaise operating system RAM manage karta hai. Result: same card par aik saath bahut zyada conversations fit hoti hain.
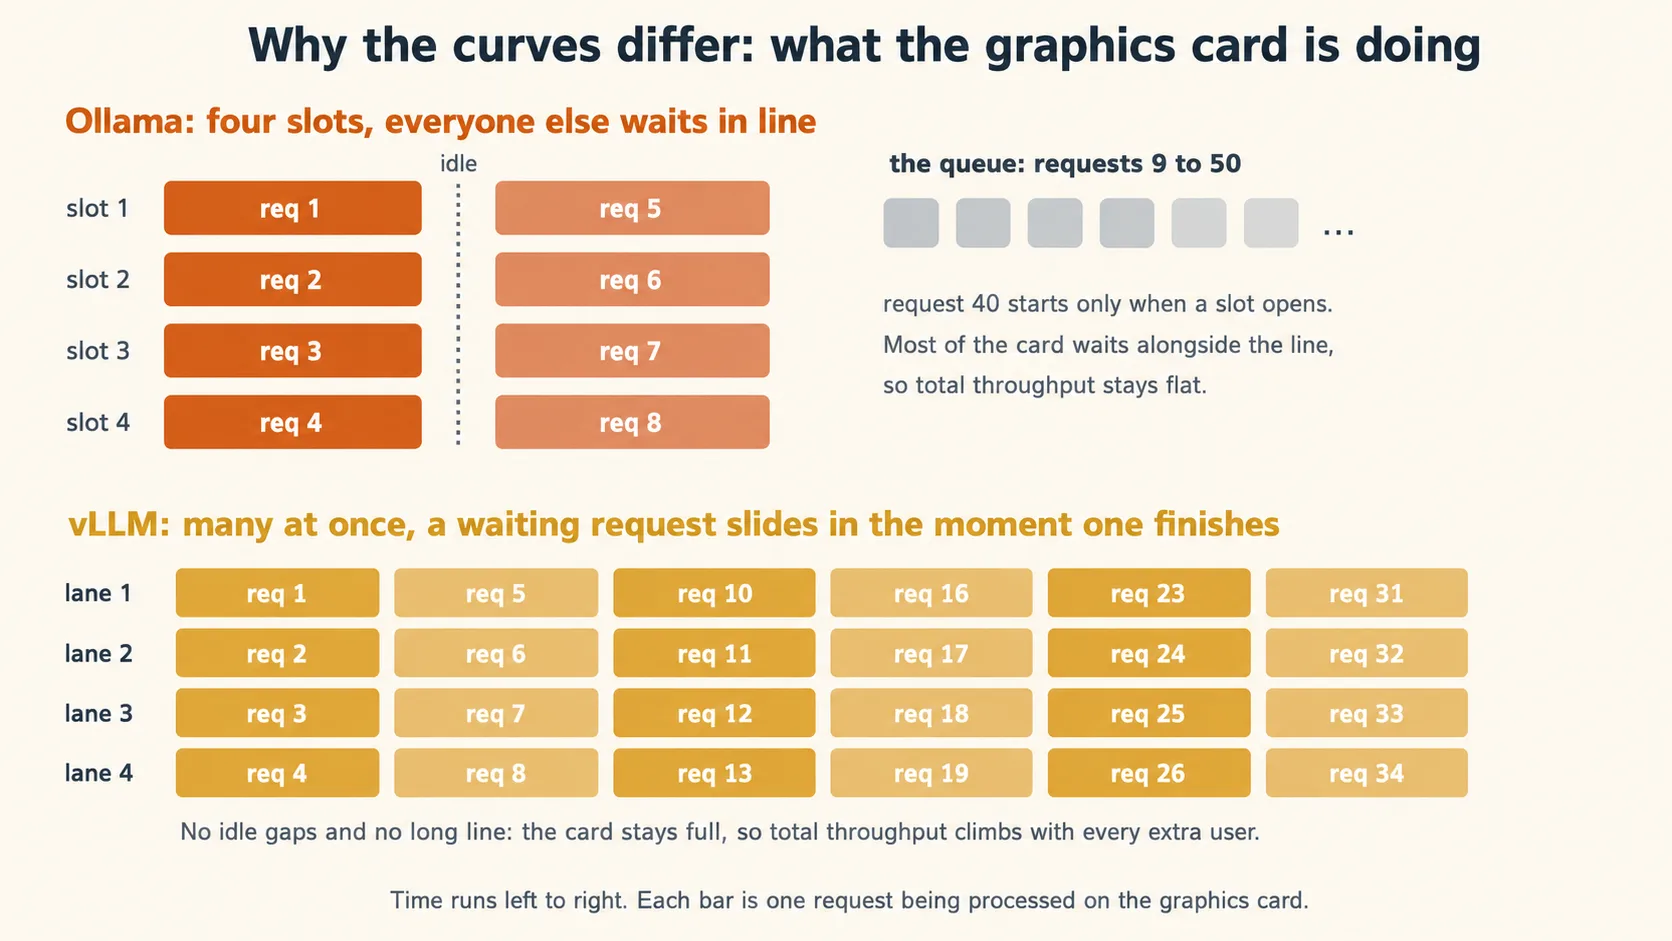
Mechanism names yaad rakhne ki zaroorat nahin. Effect yaad rakhein: card full rehta hai, is liye zyada users aane par total throughput barhta hai, queue nahin banti.
Aik aur baat, taake tier names mislead na karein. Yeh part vLLM ko single machine par run karta hai, lekin vLLM wahin nahin rukta: woh aik model ko kai graphics cards aur cluster ki tarah kaam karti kai machines mein phaila sakta hai. Yeh alag product nahin, bara scale wala same software hai. Part 3 mein rent kiye kai professional hosts apne clusters par yahi chalate hain. Is liye tiers ke naam hardware kaun operate karta hai se aate hain, software kya kar sakta hai us se nahin. Part 2 mein aik server par vLLM operator aap hain. Part 3 mein 64 stoves par koi aur operator hai aur kaafi mumkin hai ke un ki kitchen bhi vLLM chalati ho.
Ab run karein. GPU machine par vLLM install karke abhi test kiye model ka counterpart serve karein. Names par note: Ollama aur vLLM alag libraries se models download karte hain, is liye same brain ke do names hain. Ollama library mein qwen3:8b, Hugging Face par Qwen/Qwen3-8B hai, jahan se vLLM models leta hai. Variable isolate karne ke promise ki wajah se honest note bhi hai. Dono copies byte-for-byte same nahin: Ollama tag weights ki compressed (quantized) copy deta hai taake laptops mein fit ho; vLLM full-precision original download karta hai. Is liye "same brain" ko precise parhein: same Qwen3 8B model ke do serving-specific builds, Ollama wali lighter copy. Precision difference numbers ke saath chalane wala aik aur variable hai, lekin experiment ka throughput pattern nahin badalta. Closest match ke liye vLLM side par compressed build bhi serve karein: same flags ke saath vllm serve Qwen/Qwen3-8B-FP8.
pip install vllm

vllm serve Qwen/Qwen3-8B \
  --enable-auto-tool-choice \
  --tool-call-parser hermes \
  --reasoning-parser qwen3
Run se pehle hardware note. Full-precision 8B build ko sirf weights ke liye taqreeban 16 GB GPU memory chahiye, conversation working memory se pehle. Comfortable run ke liye taqreeban 24 GB card chahiye. 16 GB card par compressed build serve karein: model name Qwen/Qwen3-8B-FP8 karein aur same flags rakhein. pip install vllm driver aur CUDA versions par machine se larta hai, to official vLLM Docker image sab se reproducible install path hai; vLLM docs usay cover karte hain.
First run model download karke server ko http://localhost:8000 par start karta hai. Do tool flags dikhne se zyada important hain: tool-call parser ke saath --enable-auto-tool-choice vLLM ko model output se Concept 6 ki clean structured tool calls banane deta hai. unhein chhorein aur coding agents chup chaap fail honge, kyunke server harness ke execute karne ke qabil tool call nahin banayega. Sahi parser name model family ke mutabiq badalta hai. hermes Qwen3 models ka standard hai. Doosra model serve karne par vLLM tool calling docs check karein.
Aik request se prove karein ke yeh up hai:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "Qwen/Qwen3-8B", "messages": [{"role": "user", "content": "Say hello in one line."}]}'
Abhi type kiye content ko dekhein. localhost, port 8000, /v1/chat/completions. Yeh poore course wala address shape hai. Brain nahin badla. Address ke peeche kitchen badli.
Concept 9 tab done hai jab: vLLM machine par Qwen3 8B serve karke curl request answer karta hai aur aap aik-aik sentence mein continuous batching aur paged memory ka benefit bata sakte hain.
10. Reveal: wohi 50 requests, do curves
Sab tayyar hai. Same machine. Same brain. Same script. Same 50 requests. Sirf serving layer alag hai. vLLM par wohi sweep run karein:
python bench.py http://localhost:8000/v1 Qwen/Qwen3-8B 1
python bench.py http://localhost:8000/v1 Qwen/Qwen3-8B 5
python bench.py http://localhost:8000/v1 Qwen/Qwen3-8B 10
python bench.py http://localhost:8000/v1 Qwen/Qwen3-8B 25
python bench.py http://localhost:8000/v1 Qwen/Qwen3-8B 50
Khaasa tor par concurrency 50 batch dekhein. Ollama par kai minutes tak phaila wall-clock time collapse hona chahiye: 50-request batch pinned Ollama configuration se kaafi jaldi poora hota hai aur answers qiston ke bajaye paas-paas aate hain.
Ab picture draw karein, kyunke Part 2 se yahi aik cheez saath rakhni hai. Is script mein apne 10 measured numbers dalein (pip install matplotlib agar needed ho) aur run karein:
# plot.py: tokens per second against concurrency, one line per serving layer.
import matplotlib.pyplot as plt

concurrency = [1, 5, 10, 25, 50]
ollama_tps = [0, 0, 0, 0, 0]   # your five Ollama numbers from Concept 8
vllm_tps = [0, 0, 0, 0, 0]     # your five vLLM numbers from this concept

plt.plot(concurrency, ollama_tps, marker="o", label="Ollama (qwen3:8b)")
plt.plot(concurrency, vllm_tps, marker="o", label="vLLM (Qwen/Qwen3-8B)")
plt.xlabel("Concurrent requests")
plt.ylabel("Total throughput (tokens/sec)")
plt.title("Same model, same machine, two serving layers")
plt.legend()
plt.savefig("two-curves.png", dpi=200)
Aap ko do curves milti hain. Ollama line taqreeban flat rehni chahiye: users jorne se throughput nahin barhta, zyada tar queue lambi hoti hai, is liye har user ka share ghatta hai. vLLM line climb karni chahiye: har naya user throughput jorta hai, pehle tezi se, phir graphics card ke sach mein full hone par jhukti hai. Exact numbers card, versions aur settings par depend karte hain aur kisi doosre se match nahin honge. Shapes aksar match kareingi, aur shapes hi lesson hain. Aik habit run ko anecdote ke bajaye evidence banati hai: numbers ke paas card, driver, Ollama aur vLLM versions likhein, taake alag hardware ka alag result mystery nahin, finding ho.
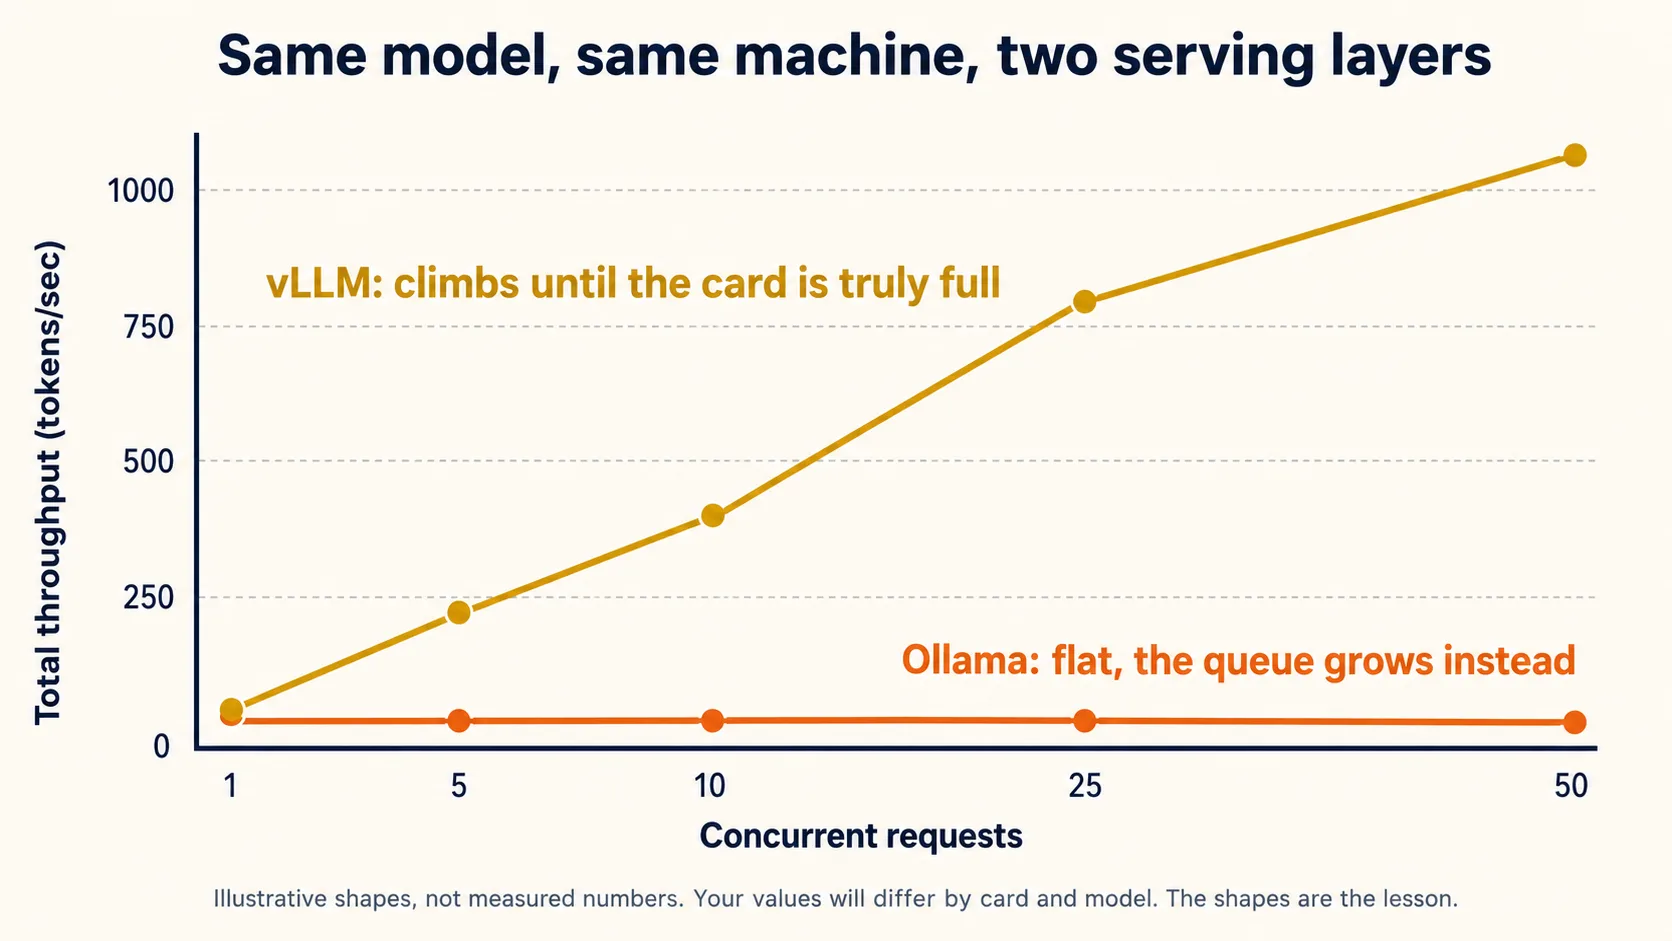
Upar ki picture expected shapes dikhati hai, real measurements nahin. Aap ke 10 numbers se bana aap ka chart hi aham hai.
Ab curves ke gap ko precisely kahein. Hardware nahin: same card. Script nahin: same requests. Important sense mein brain nahin: same model family, sirf Concept 9 wala precision difference, jo numbers ke saath chalane wala aik aur variable hai. Gap zyada tar serving layer ka hai. Practice jitna allow karti hai, baqi sab fixed rakh, aik cheez badli aur measured effect bahut bara hai. Yahi honest claim hai aur kaafi se zyada strong hai.
Friend chart dekh kar kehta hai: "to vLLM model ko fast banata hai. Laptop par bhi use karna chahiye." Sentence mein kya sahi aur kya ghalat hai? Dono halves ghalat hain, aur us se lesson milta hai. Aik user ke liye vLLM model ko fast nahin banata: concurrency 1 par curves aksar paas se shuru hoti hain, kyunke single request card full rakhne wali techniques use nahin kar sakti. vLLM load mein machine ko fast banata hai, kai requests saath serve karke. Woh aam laptop ki madad bhi nahin karta, kyunke continuous batching ke liye graphics card chahiye. vLLM wahin shine karta hai jahan Ollama kabhi jane ke liye design nahin hua: aik strong machine, kai users.Answer dekhein
Concept 10 tab done hai jab: chart maujood hai, aik curve flat aur aik climbing hai, aur aik sentence mein bata sakte hain ke gap zyada tar serving layer ka kyun hai.
11. Coding agents ko server se jorein
Fast server tabhi interesting hai jab tools usay use kar saken. Is liye Part 1 wala move course ke teesre address par dohrayein: Claude Code aur OpenCode ko vLLM par point karein.
Ab yeh taqreeban suspicious lagna chahiye: wiring wohi hai. vLLM dono agents ke request formats bolta hai. OpenCode wala OpenAI-style address aur Claude Code ka native Anthropic Messages format dono implement karta hai, is liye darmiyan mein translator nahin hai.
- Claude Code
- OpenCode
Part 1 wali teen settings, naya port aur aik addition: Claude Code ko batayein ke har model tier served model par map hota hai.
export ANTHROPIC_BASE_URL=http://localhost:8000      # bare address again, no /v1
export ANTHROPIC_AUTH_TOKEN=dummy
export ANTHROPIC_API_KEY=dummy
export ANTHROPIC_DEFAULT_OPUS_MODEL=Qwen/Qwen3-8B
export ANTHROPIC_DEFAULT_SONNET_MODEL=Qwen/Qwen3-8B
export ANTHROPIC_DEFAULT_HAIKU_MODEL=Qwen/Qwen3-8B
claude
Model tier lines is liye hain kyunke Claude Code aam tor par Anthropic ke bare aur chhote models mein name se switch karta hai. Teeno tiers ko served model par map karne ka matlab hai ke woh jo bhi maange, Qwen3 8B paye. Yeh variables vLLM ki Claude Code guide se aate hain; drift hone par wohi live source check karein.
Part 1 ka opencode.json copy karke do strings badlein: port aur model name.
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "vllm": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "vLLM (server)",
      "options": { "baseURL": "http://localhost:8000/v1" },
      "models": { "Qwen/Qwen3-8B": { "name": "Qwen3 8B (vLLM)" } }
    }
  },
  "model": "vllm/Qwen/Qwen3-8B"
}
Ghor karein ke /v1 rehta hai: OpenCode ab bhi OpenAI style bolta hai aur vLLM answer karta hai. Part 1 ka bare muqable mein /v1 contrast bina change ke aa gaya.
Phir throwaway folder mein Concept 4 wala exact task run karein:
is folder ko dekhein. Aik chhota safe improvement dhoondein, change karein aur dikhayein ke kya badla.
Part 1 mein laptop slow ya broken tha, to yeh payoff hai. Same model, same task, lekin work ke liye bani serving layer ke peeche real graphics card: Concept 5 ki throughput wall chali gayi aur tool calls flow karti hain, kyunke vLLM ko tool-parser flags se start kiya.
Sharing par honest note. vLLM machine aap ke ilawa kisi ko serve kare, to localhost machine ka real address banta hai aur internet par open model server open door hai. Kam-se-kam vLLM ko real secret wali --api-key se start karein, users ko key dein aur machine ko network ki usual protections ke peeche rakhein. vLLM docs safe serving cover karte hain. Classroom use se pehle parhein.
Concept 11 tab done hai jab: kam-se-kam aik coding agent ne vLLM server se real task poora kiya aur Part 1 se badli aik cheez, address, aur na badli cheez, baqi sab, bata sakte hain.
12. Server tier kab sahi hai
Ab dono measured curves hain, is liye decision fashionable ke bajaye honest ho sakta hai.
Server tier tab jeetta hai jab aik strong machine kai mouths serve kar sake:
- Team ya classroom. 50 laptops par 50 students Part 1 ki dono walls hit karte hain. Aik vLLM machine par point kiye 50 students aik cleared wall share karte hain. Lab, company ya PIAIC classroom aik GPU ki price par sab ko capable agent aise deta hai.
- poora din chalane wale loops. aage Loop Engineering mein banaye agents hamesha har few minutes requests bhejenge. Per-token bill hamesha barhti hai. Apni GPU pehle se busy ho, to aik aur request taqreeban koi extra cost nahin jorti. Climbing curve wajah dikhati hai: load ke saath throughput barhta hai, is liye busy machine ki per-token cost kam hai.
- Team scale par privacy. Part 1 ka privacy argument poori organization ke liye: data aap ke control ki machine par rehta hai aur sab ko service milti hai.
Ab honest limit, jo Part 3 ka bridge hai. vLLM ne aik wall move ki: throughput. Doosri ko nahin chhua. vLLM ke peeche Qwen3 8B 50 logon ko jaldi answer karta hai aur laptop jitna hi smart hai, kyunke neeche same brain hai. Task 8B model ke liye hard ho, to koi serving layer nahin bacha sakti. Capability wall bare brain se clear hoti hai aur duniya ke sab se bare open brains rented machine ya aap ki kisi future single machine mein fit nahin hote. Un ke liye address aik baar aur badlein.
Poora din chalane wala agent loop hard refactoring tasks par wrong answers deta rehta hai. Colleague usay fix karne ke liye Ollama se vLLM par jane ko kehta hai. Kya woh kaam karega? Nahin. Hard tasks par wrong answers capability wall hain aur serving layer usay touch nahin karti: vLLM same brain ko fast serve karta hai, smarter brain nahin. vLLM par jane se queues aur slowness, yani throughput, fix hote hain. Wrong answers fix karne ke liye strong model chahiye, jis ke liye Part 3 ka cloud tier hai. Yeh Concept 5 ki table aik tier upar hai.Answer dekhein
Concept 12 tab done hai jab: aisi situation bata sakte hain jahan server tier laptop aur cloud dono se behtar hai, aur keh sakte hain vLLM kaun si wall move karta aur kaun si nahin.
Part 3: Cloud tier. Frontier open models jinhein taqreeban koi self-host nahin kar sakta (OpenRouter)
Is part ki serving layer kisi aur ka cluster hai, jis tak OpenRouter se pohanchte hain. Scale aise bare models hain ke aap ke aur duniya ki taqreeban har company ke liye "self-host" real option nahin rehta.
13. Aise open weights jinhein utha nahin sakte: Kimi K3 aur DeepSeek V4 Pro
Part 2 honest limit par khatam hua: capability wall bare brain se clear hoti hai. Ab maujooda sab se bare open brains dekhein aur is size par "open" ka matlab honestly samjhein.
July 2026 mein yeh page likhte waqt course do models use karta hai, alag reasons ke liye chune gaye:
- Kimi K3, Moonshot AI ka, performance ke liye chuna gaya. July 2026 mein release hua 2.8 trillion parameter model, one million token context window ke saath. Release par major capability indexes mein ab tak ka strongest open-weight model tha, best closed models ke paas. Rankings monthly badalti hain, is liye dated snapshot maanein aur dohrane se pehle current leaderboards check karein. Weights sach mein open hain. Har koi download kar sakta hai.
- DeepSeek V4 Pro, DeepSeek ka, price performance ke liye chuna gaya. 1.6 trillion parameter model, taqreeban 49 billion active per token, same one million token context window aur MIT license ke saath. Raw capability mein K3 se aik step neeche aur use mein bahut cheaper hai; yahi trade isay yahan lata hai.
Aik detail tiers ko jorti hai: Moonshot ne K3 release karte waqt us ki nai attention design ka serving code seedhe vLLM mein contribute kiya, taake hosts har jagah chala saken. Part 2 ki industrial kitchen aur is part ki frontier kitchens aksar alag scales par same software hain.
Ab honest arithmetic. "Open weights" ka matlab hai aap khud run kar sakte hain; yeh nahin ke aap ke paas capability hai. Moonshot K3 ko 64 ya zyada accelerator chips ki configurations par one machine ki tarah serve karne ka mashwara deta hai. DeepSeek V4 Pro chhota model hai, phir bhi self-host karne mein 8 se 16 datacenter GPUs ka cluster lagta hai, hardware jis ki cost house se zyada hai. Part 2 skills Qwen3 32B jaise models ya rented multi-GPU box par 100B-class mixture tak scale hoti hain. Is se aage nahin, aur serious infrastructure teams ke bahar taqreeban kisi ke paas yeh skills nahin hotin. Frontier open models sab rent karte hain.
Agar rent hi karna hai, to "open" kya deta hai? Teen real cheezen. No lock-in: aik company model nahin hata sakti, akele reprice ya silently change nahin kar sakti, kyunke cluster wala koi bhi same weights serve kar sakta hai aur competitors karte hain. Landlord choice: kai companies same weights host karke price aur speed par compete karti hain. Future floor: sach mein matter kare, to aap, mulk ya company hardware khara kar sakte hain. Is scale par open weights ka matlab "ghar par run karein" kam aur "tap par kisi aik ka ownership nahin" zyada hai.
Hosts ki competition practical problem banati hai: dozens hosting companies, sab ke apne accounts, keys aur billing. OpenRouter isay course ke expected tareeqe se solve karta hai: aik address. Precise rahen, kyunke tier table simplify karti hai. OpenRouter aik gateway hai, router jo request receive karke asal model serve karne wale host ko forward karta hai. Host serving layer operate karta hai, aksar vLLM. OpenRouter front door operate karta hai: hundreds models ke liye aik account, aik API key, aik billing page. Openrouter.ai par sign up, kuch dollars credit, key create aur sab se pehle monthly spend limit set karein. Key aik string mein secret aur wallet hai: commit ya share hone wale code mein paste na karein.
Part 1 ghar mein cooking tha. Part 2 apni industrial kitchen chalana. Part 3 duniya ke great restaurants hain: 64 stoves aur cooks ki brigade wali kitchens. Aap ghar mein nahin banayeinge aur zaroorat bhi nahin. OpenRouter delivery app hai jis mein sabhi restaurants aik menu par, aik login aur bill ke saath hain. Phone app poore waqt wohi hai.
Concept 13 tab done hai jab: OpenRouter account, key aur spend limit set hai, aur aik sentence mein bata sakte hain ke is scale par "open weights" aur "aap self-host kar sakte hain" same claim kyun nahin rahe.
14. Unhi do agents se frontier brains chalayein
Teesra tier, wohi move. Parts 1 aur 2 ke exact harnesses ko zameen ke strongest open models par point kareinge aur wiring taqreeban sharmnaak had tak familiar lagegi.
- Claude Code
- OpenCode
OpenRouter Claude Code ka native format seedhe bolta hai, jisay woh Anthropic-compatible endpoint kehta hai. Setup Part 1 wale teen variables hain, darmiyan mein real key:
export ANTHROPIC_BASE_URL=https://openrouter.ai/api   # bare, one more time: no /v1
export ANTHROPIC_AUTH_TOKEN=sk-or-...                 # your OpenRouter key
export ANTHROPIC_API_KEY=                             # must be empty
claude --model moonshotai/kimi-k3
Isay kahin persist karne se pehle hygiene note. Key wallet hai. Shell exports aik session rehte hain, shuruaat ki safe jagah. Variables settings file mein le jayein, to home folder ka ~/.claude/settings.json use karein, project ki committed settings file kabhi nahin, kyunke git repository mein pushed key strangers kharch kareinge.
OpenRouter model names maker/model shape follow karte hain aur exact string matter karti hai: Kimi K3 ke liye moonshotai/kimi-k3, DeepSeek V4 Pro ke liye deepseek/deepseek-v4-pro. Aik wrong character sirf "model not found" lautata hai, is liye slugs type karne ke bajaye openrouter.ai model page se copy karein.
Claude Code harness Anthropic ke models ke against build aur test hua hai, aur OpenRouter full Claude Code compatibility sirf Anthropic first-party provider ke saath guarantee karta hai. Kimi K3 aur DeepSeek V4 Pro compatible format bolte hain aur kai log unhein kamyabi se chalate hain, lekin harness-model fit ki wajah se tool calls ajeeb tareeqe se fail ho sakti hain; yeh setup ki ghalti nahin. Pairing ko experimental maanein. Exercise ka fully supported path chahiye, to OpenCode tab use karein: OpenRouter native OpenCode provider hai, compatibility asterisk ke bina. Claude Code rakh kar edges smooth karne hon, to community ne isi job ka tool banaya: Concept 16 mein Claude Code Router.
Do habits aik evening bachati hain:
/statusse verify karein ke words kahan ja rahe hain.Anthropic base URLline par OpenRouter address aur token active credential dikhna chahiye. Check par bharosa karein, assumption par nahin.- Claude Code current docs ke mutabiq
ANTHROPIC_AUTH_TOKENsaved Anthropic login se pehle ata hai, is liye past login requests hijack nahin karna chahiye. Lekin stale login startup par auth-conflict warning trigger kar sakta hai aur older guides interference report karti hain./statuswrong endpoint dikhaye ya conflict warning do credential sources bataye, to/logoutaik baar run, restart aur phir check karein.
OpenCode OpenRouter ko out of the box janta hai, is liye provider block nahin likhna. OpenCode ke andar /connect run, OpenRouter select aur key paste karein; older versions shell se opencode auth login use karte hain. Kai OpenRouter models preloaded hain, is liye /models se chun sakte ya opencode.json mein pin kar sakte hain:
{
  "$schema": "https://opencode.ai/config.json",
  "model": "openrouter/deepseek/deepseek-v4-pro"
}
Doosre ko chalane ke liye openrouter/moonshotai/kimi-k3 lagayein. Bas yahi poori configuration hai.
Ab same throwaway folder mein Concept 4 task aakhri baar, dono models se aik-aik baar run karein:
is folder ko dekhein. Aik chhota safe improvement dhoondein, change karein aur dikhayein ke kya badla.
Pehle runs se difference mehsoos karein. Queue, crawl ya broken tool calls nahin hone chahiye: frontier models capability wall ko bare margin se clear karte hain aur throughput wall kisi aur ke 64 stoves par hai. Aik address badal kar dono walls aik saath clear. Run phir bhi stumble kare, to cause bhi move hua: local hardware nahin, model-harness fit, provider, routing ya prompt investigate karein.
Jo chhora us par bhi ghor karein, kyunke trade lesson hai. Concept 1 ke baad pehli baar words machine se bahar gaye aur course mein pehli baar tokens flow karte waqt money cost karte hain. Task ke baad OpenRouter activity page dekhein aur price wali request dikhai degi. Private aur free Part 1 the. Yeh powerful aur metered hai.
Agent ab OpenRouter se tasks jaldi complete karta hai. Concept 1 ke muqable mein chhori do cheezen aur words ka destination sach batane wali aik habit batayein. Aap ne privacy chhori, kyunke words machine se nikal kar provider tak jate hain, aur free chhora, kyunke har token credit se meter hota hai. Habit check karna hai, assume nahin: Claude Code mein Answer dekhein
/status ya OpenCode model picker exact address dikhata hai. Part 1 ka rule har tier par hai: visible setting par bharosa karein, yaad wale setup par nahin.
Concept 14 tab done hai jab: K3 aur V4 Pro dono ne agent se real coding task complete kiya, /status ya OpenCode model picker requests ka destination confirm karta hai aur activity page par real price wali real request dekhi hai.
15. Performance ya price: model aur tier chunna
Aap ne dono frontier models chalaye. Un ki cost same nahin aur choice woh decision hai jo ab lagatar lenge.
Yeh page likhte waqt list prices taqreeban: Kimi K3 ke liye $3 per million input tokens aur $15 per million output tokens, DeepSeek V4 Pro ke liye taqreeban $0.44 input aur $0.87 output. Gap aahista parhein: output mein price-performance choice performance choice se taqreeban 17 guna cheaper hai. Prices tezi se badalti hain, is liye numbers ko version number ki tarah maanein: reasoning ka snapshot, aur budget se pehle models ke OpenRouter pages par live check.
To K3 17 guna zyada kab sahi hai? Jab task itni hard ho ke V4 Pro fail kare aur failure ki cost aap ka time ho. Aik successful lamba agentic run un paanch cheap runs se behtar hai jinhein suljhana pare. Teams ka working rule: price-performance model default rakhein, cheap model insufficient prove hone par performance model tak escalate karein, aur vibes nahin, real failures escalation trigger karein. Agents ke liye aik number poori calculation badalta hai: cached input. Agent har turn same instructions aur repository context phir bhejta hai, aur repeated prefix cache hit kare to dono providers input price ka tiny fraction charge karte hain. Loop-style workloads mein effective bill aksar list-price math se bahut kam hoti hai. Pricing pages har provider ke caching rules samjhati hain. Agent work mein woh section pehle parhein, aakhir mein nahin.
Ab poora zoom out karein, kyunke full picture earned hai. Aik harness, aik idea, teen tiers:
| Tier | Serving layer | Is course ka brain | Address | Compute kaun pay karta hai | Kis mein jeetta hai |
|---|---|---|---|---|---|
| Local | Ollama | Qwen3 8B | aap ka localhost | pehle pay kar chuke (laptop) | privacy, offline, free, learning |
| Server | vLLM | Qwen3 8B, serving-specific build | aap ke control ki machine | aap, GPU hour ke hisab se | kai users, all-day loops, team data |
| Cloud | OpenRouter (gateway) | Kimi K3, DeepSeek V4 Pro | openrouter.ai | aap, per token | hardest tasks, zero setup, frontier |
Decision procedure, questions ke order mein. Pehla, kya data bahar ja sakta hai? Nahin, to cloud tier bahar; kitne logon ko service chahiye us ke mutabiq local ya server chunein. Doosra, kya task mid-size open model ki reach mein hai? Haan, to tier economics hai: aik ke liye laptop, kai users ya loops ke liye vLLM machine. Teesra, kya task ko frontier brain chahiye? To cloud tier aur concept ka rule: cheap model default, proven failure par expensive. Teen questions mein open-model deployment ki har conversation fit hoti hai.
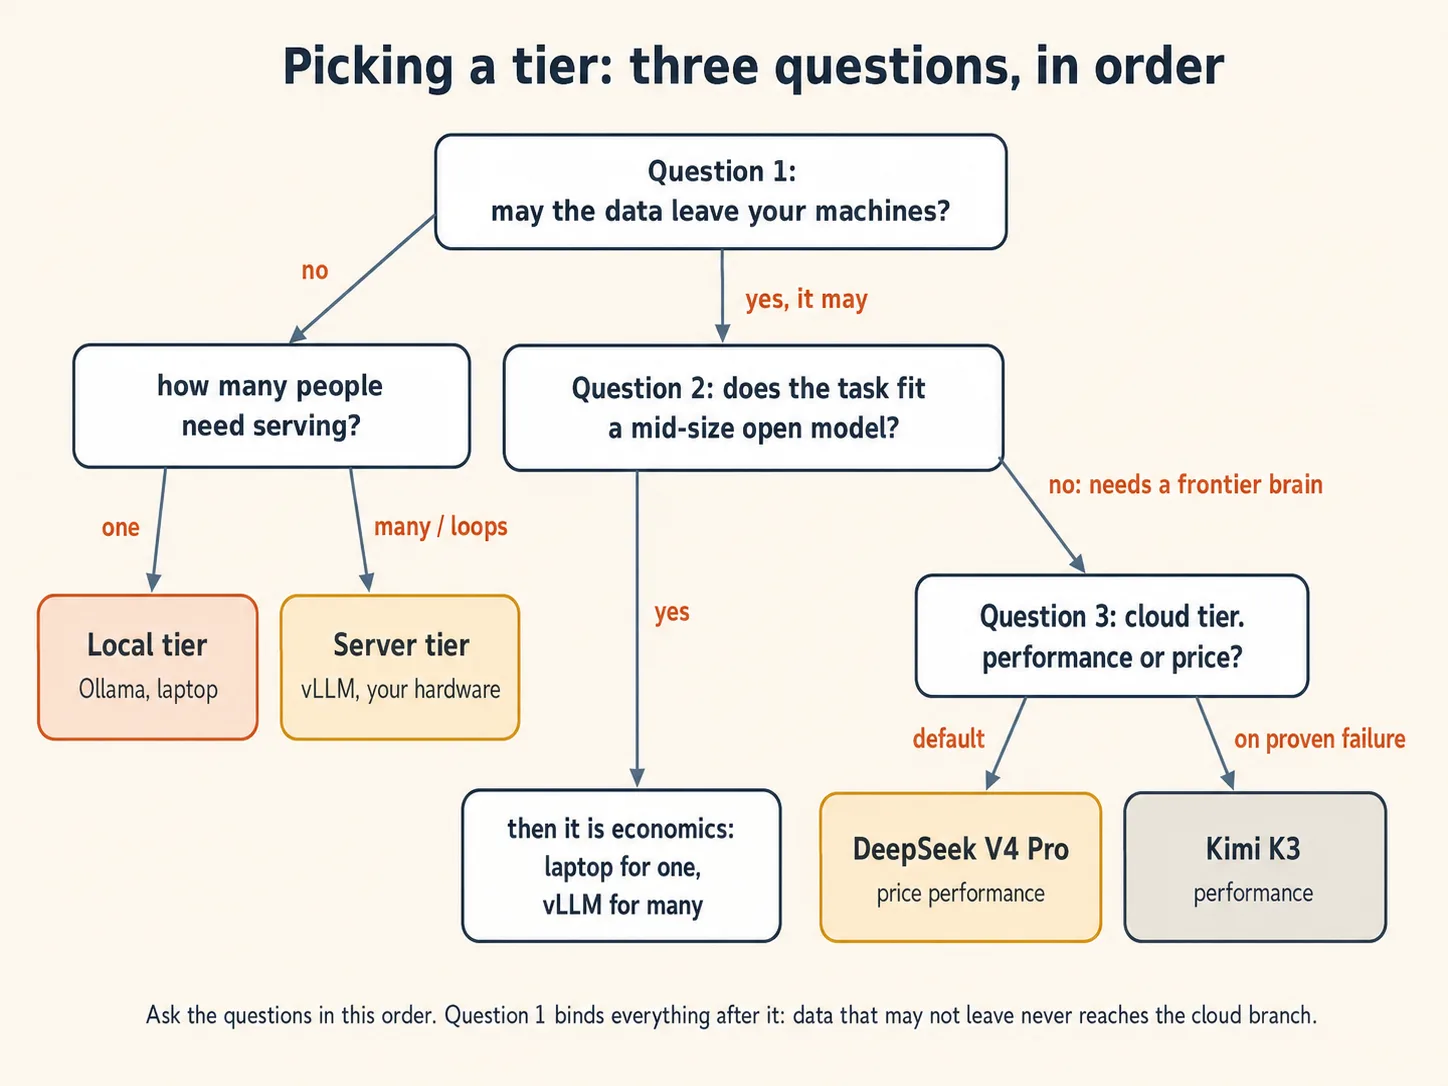
Firm ko agent chahiye jo confidential client contracts har din poora din review kare. Tasks moderately hard hain, lekin strong mid-size model ki reach mein hain. Kaun-sa tier aur baqi dono ghalat kyun? Server tier. Question one cloud hatata hai: confidential contracts firm ke control wali machines se bahar nahin jane chahiye. Laptop tier do reasons se fail: kitne people serve karne hain aur din mein kitni der run karna hai. Team ke liye all-day loop foran throughput wall hit karta hai. Firm network ke andar vLLM machine throughput clear karti, data ghar rakhti aur all-day loop ko per token cheap banati hai. Tasks model ke liye hard prove hon, to real choice bigger rented box par bara open model hai, public cloud nahin, kyunke question one ab bhi bind karta hai.Answer dekhein
Concept 15 tab done hai jab: teen questions order mein bata sakte hain aur us scenario ke tier choice ko defend kar sakte hain jis ka answer kisi ne nahin diya.
16. Teeno tiers ke liye aik router: Claude Code Router
Is course ki bunyad aik idea thi: brain sirf address hai. Natural last step hai aur popular community tool usay karta hai. Kya hoga agar address aik brain nahin, decision ki taraf point kare?
Claude Code Router (CCR) musistudio ka open source tool aur Claude Code ecosystem ke sab se zyada starred projects mein aik hai. Woh machine par chhota server chalata hai, aik taraf Claude Code ka native format aur doosri taraf kai providers se baat karke darmiyan mein translate karta hai. Claude Code ko aik baar point karein, phir config file har request par tay karti hai kaun-sa brain answer de. Course ke aakhir mein isay janne ke teen reasons hain:
- Task type se route karta hai.
Routerblock Claude Code ke alag work ko models par map karta hai: ordinary work ke liyedefault, cheap housekeeping ke liyebackground, hard reasoning ke liyethink, token threshold clear requests ke liyelongContext. List phir aahista parhein. Yeh Concept 15 ka rule hai, price-performance default aur hard cases mein escalation, discipline ke bajaye config mein. - Seekhe hue har tier tak jata hai. Config mein provider sirf name, address aur model list hai. Is liye aik file Ollama laptop, vLLM server aur OpenRouter ko saath rakh kar route kar sakti hai.
- Rough edges smooth karta hai. Transformers (
openrouter,tooluse,enhancetoolaur doosre) provider ke mutabiq requests aur responses adapt karte hain, loosely formatted tool calls mein error tolerance bhi jorte hain. Yeh Concept 14 ki compatibility caution ka community working answer hai.
Teen steps mein setup karein. Claude Code ke paas install karein:
npm install -g @musistudio/claude-code-router
Phir ~/.claude-code-router/config.json banayein. Yeh config poore course ke teeno tiers aik address ke peeche rakhti hai:
{
  "OPENROUTER_API_KEY": "$OPENROUTER_API_KEY",
  "Providers": [
    {
      "name": "ollama",
      "api_base_url": "http://localhost:11434/v1/chat/completions",
      "api_key": "ollama",
      "models": ["qwen3:8b"]
    },
    {
      "name": "vllm",
      "api_base_url": "http://localhost:8000/v1/chat/completions",
      "api_key": "dummy",
      "models": ["Qwen/Qwen3-8B"]
    },
    {
      "name": "openrouter",
      "api_base_url": "https://openrouter.ai/api/v1/chat/completions",
      "api_key": "$OPENROUTER_API_KEY",
      "models": ["deepseek/deepseek-v4-pro", "moonshotai/kimi-k3"],
      "transformer": { "use": ["openrouter"] }
    }
  ],
  "Router": {
    "default": "openrouter,deepseek/deepseek-v4-pro",
    "background": "ollama,qwen3:8b",
    "think": "openrouter,moonshotai/kimi-k3",
    "longContext": "openrouter,moonshotai/kimi-k3",
    "longContextThreshold": 60000
  }
}
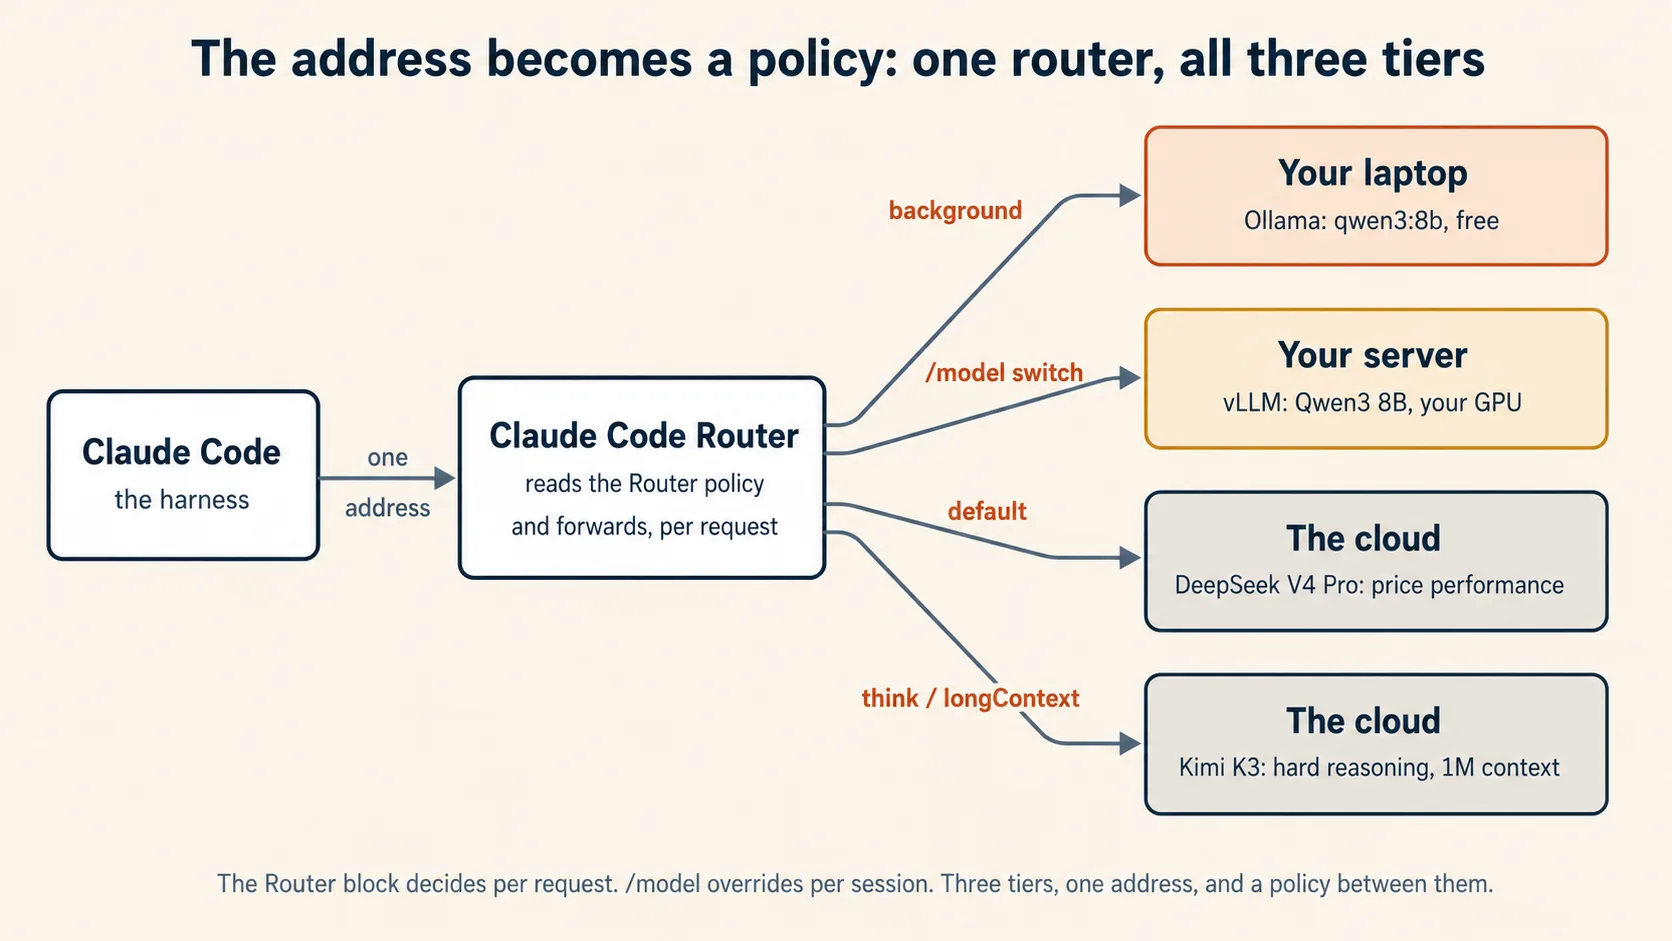
Router block ko policy ki tarah parhein, kyunke wohi hai. Ordinary work price-performance frontier model par jata hai. Cheap background chores laptop par free rehte hain. Hard reasoning aur huge contexts Kimi K3 par escalate hote hain, jis ki one million token window longContext slot earn karti hai. $OPENROUTER_API_KEY syntax environment se key leti hai, is liye secret file mein nahin baithta.
Phir router ke zariye Claude Code start karein:
ccr code
Kuch mechanics waqt bachate hain: config edit ke baad changes apply karne ke liye ccr restart run karein. Claude Code ke andar /model provider,model se session ke darmiyan brains switch karein, jaise /model ollama,qwen3:8b. JSON ki jagah web page mein config edit karna pasand ho, to ccr ui kholta hai.
Aakhir mein do honest notes. Pehla, CCR community project hai, Anthropic ya provider ka product nahin. Tezi se badalta hai, transformers guarantees nahin working fixes hain aur har request ab aik aur software se jati hai jisay update aur release notes parhna chahiye. Doosra, jahan zaroorat nahin wahan na jorein. Part 2 vLLM server Claude Code format native bolta hai, is liye sirf us ke aage router kuch nahin deta. CCR tab sahi hai jab aik Claude Code ko kai brains par aik saath task ke mutabiq route karna ho. Course ke baad yahi setup samajhte hain: teen tiers, aik address aur un ke darmiyan policy.
Concept 16 tab done hai jab: Claude Code router se run karta hai, one session mein kam-se-kam do tiers answer karte hain (/model provider,model se switch karke source dekhein), aur apne Router block ko encoded tier policy ki tarah parh sakte hain.
Aaj apne scale par try karein, phir aage barhein
Aaj sab se chhota real version karein. Ollama install, model run aur chat karein: sirf itna do minutes mein private on-machine AI deta hai. Code likhte hain, to coding agent connect karke hit hone wali wall mehsoos karein. Afternoon ke liye GPU rent kar saken, to 50-request experiment aur apni curves banayein: kitab mein kam exercises aik hour mein zyada sikhati hain. Task har host ho sakne wale brain ko hara de, to aakhri baar address badal kar cents ya dollars mein frontier brain borrow karein. Doosre logon ko banaya work chahiye, to Appendix A server ko shared service banata hai.
Mental model aage rakhein, kyunke section order mein isi par banta hai. Tool harness aur swappable brain hai, aur brain sirf address. Address laptop, server ya duniya ke biggest open models par point kar sakta hai, harness difference nahin janta. Do walls setup ki had tay karti hain: serving layer aur hardware throughput move karte hain, sirf bara brain capability. Ab Agentic Coding mein agent chalana, Spec-Driven Development mein written spec se direct karna aur Loop Engineering mein all-day unattended loop dena seekhenge. Last course tak jaanenge kis ka brain kaun-se tier par loop chalaye aur keep-running cost kya hai.
One-line summary
Open source models teen scales par run hote hain aur tool aik address ke zariye teeno tak pohanchta hai. Aik person ke liye Ollama, kai ke liye vLLM, aur un frontier brains ke liye OpenRouter jinhein taqreeban koi self-host nahin kar sakta. Apni do curves se difference aik baar measure karein aur career bhar sahi tier chuneinge.
Appendix A: Mini LLM cloud banayein
Part 2 ne aap ko industrial kitchen di. Kitchen restaurant nahin hoti. Yeh appendix front door, menu, table numbers aur bill jorta hai, taake aik person ko achi tarah serve karne wali machine poori class ko safely serve kar sake.
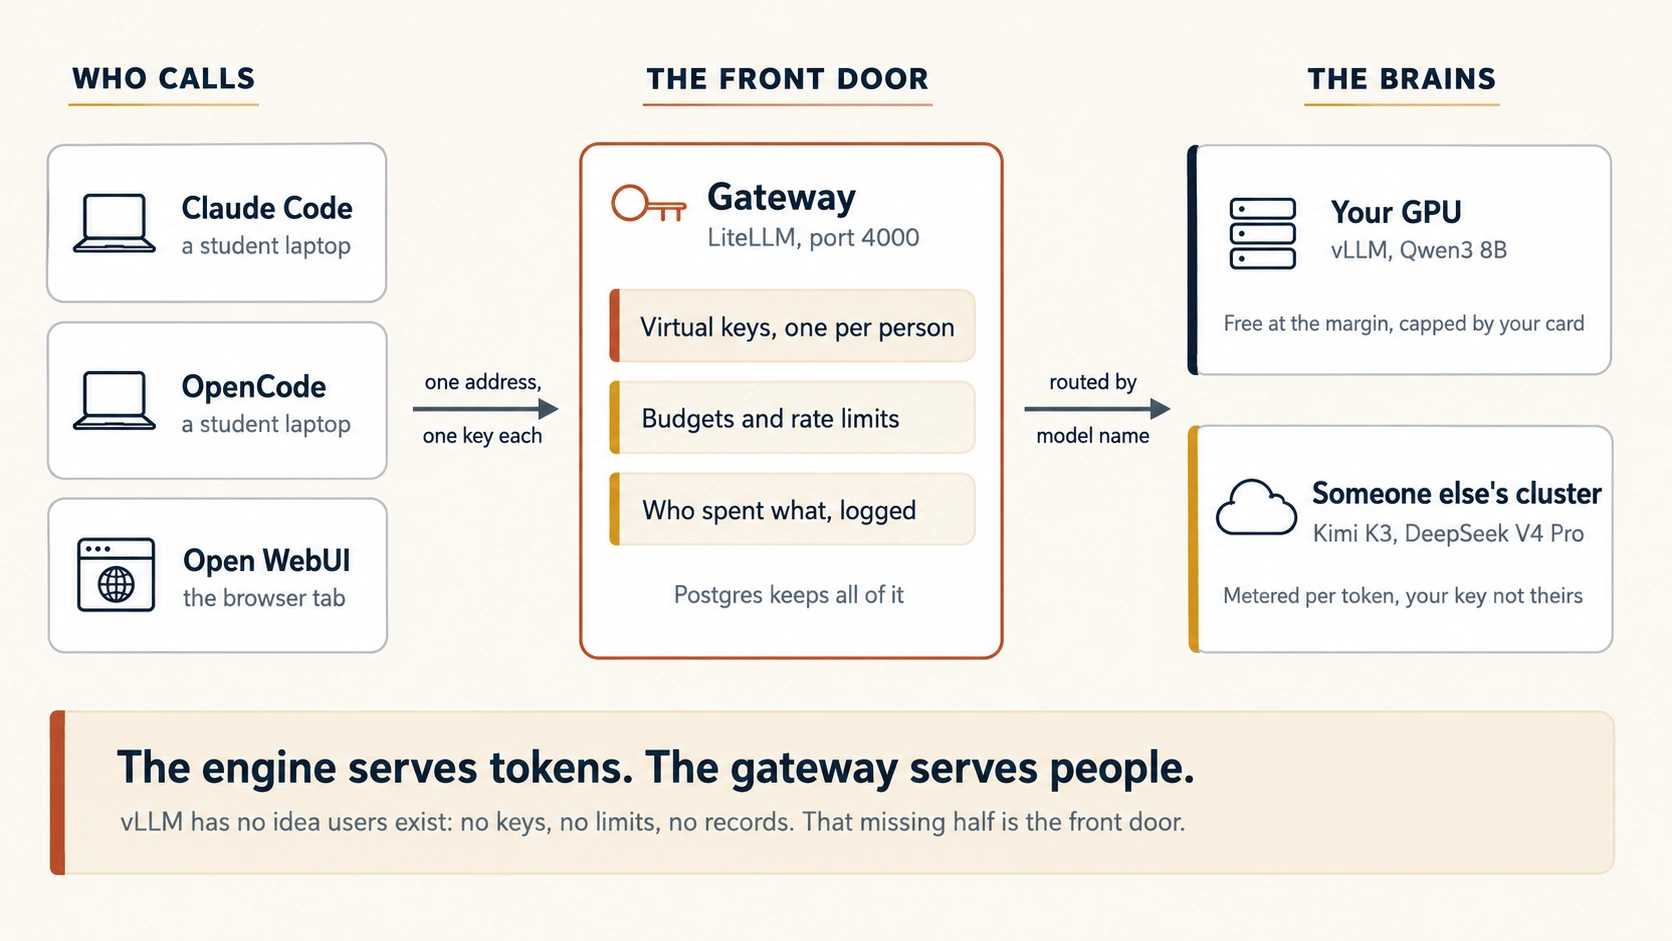
Yeh appendix jis gap ko close karta hai, woh yeh hai. Part 2 ke aakhir mein vLLM Qwen3 8B serve kar raha tha aur aap ki fifty-request curve wahan charh rahi thi jahan Ollama ki flat ho gayi thi. Yeh real achievement hai, lekin abhi service nahin hai. Isay class ko dene ki koshish karein to questions foran shuru hote hain. Isay use karne ki permission kise hai? Aik student ke runaway loop ko poori machine aik week tak kha jane se kya rokta hai? Kis ne kitna spend kiya? Jab Qwen3 8B kaafi na ho, to student frontier brain tak kaise pohanche, bina aap ki apni OpenRouter key do sau logon ko diye?
In mein se koi question tokens serve karne ke baare mein nahin hai, aur thik isi wajah se vLLM un ka answer nahin deta. Inference engine model load karke requests ka answer deta hai. Usay users ke hone ka pata nahin. Us ke paas keys, quotas, spending records ya mana karne ka tareeqa nahin. Us missing half ka aik naam hai, aur usay banana hi is appendix ka mauzu hai.
Course ka aik idea yahan tak chalta hai. Brain sirf address hai. Part 1 mein address aap ka laptop tha. Part 2 mein woh aap ki control ki machine thi. Part 3 mein kisi aur ka cluster tha. Is appendix mein aap address banate hain: woh cheez banate hain jis ki taraf doosre log apne agents point karte hain.
Part 2 ki har cheez, saath mein usi GPU machine par Docker aur Docker Compose. Part 3 kiya hai, to Concept A5 ke liye apni OpenRouter key paas rakhein. Bina kuch run kiye poora appendix parh sakte hain, aur stack kabhi na banayein tab bhi Concepts A1, A2 aur A7 parhna mufeed hai.
Aik nahin, do programs. vLLM tokens serve karta hai. Us ke aage gateway baithta hai aur woh sab handle karta hai jo vLLM nahin karta: user keys, spending limits, model routing aur logs. Yahan use kiya gateway LiteLLM hai. Postgres jorein taake restart ke baad keys aur spending bani rahen, aur Open WebUI jorein taake terminal use na karne wale log bhi aap ka cloud use kar saken. Four containers, one file, one afternoon.
Is appendix ke naye words
| Term | Asaan meaning |
|---|---|
| Inference engine | Woh program jo model load karke requests ke answer deta hai. vLLM aik inference engine hai. Yeh tokens janta hai, logon ko nahin. |
| Gateway / proxy | Engine ke aage wala program. Yeh logon ke baare mein janta hai: kaun call kar raha hai, kya use kar sakta hai aur cost kya hai. |
| Virtual key | Per-person API key jo aap ka gateway issue aur revoke karta hai, aur jis ke apne limits hote hain. |
| Budget | Key ki spending cap. Is ke khatam hone par gateway bill barhane ki jagah request refuse kar deta hai. |
| Rate limit | Requests per minute ki cap, taake aik busy user baqi sab ko bahar na kar de. |
| Multi-tenancy | Shared hardware se kai alag users ko serve karna, bina unhein aik-doosre ko affect karne diye. |
| Fallback | Rule jo kehta hai, "agar yeh model fail ya full ho, to us ki jagah woh wala try karein." |
A1. Kitchen restaurant nahin hoti
Concept 8 se course jis metaphor ko use karta aya hai, usay aik step aage le jayein. Ollama do burners wali home kitchen thi. vLLM industrial kitchen thi jo har burner ko jalta rakhti hai. Yeh dono ghar ka back hain.
Restaurant ko front of house bhi chahiye. Door par koi jo jane ke reservation hai ya nahin. Menu jo bataye ke aaj kya available hai. Table number, taake kitchen ko pata ho har dish kahan jati hai. Aakhir mein bill. In mein se kuch bhi cooking nahin hai, aur bina front of house ki shandar kitchen restaurant nahin hoti. Woh kitchen hai jis mein strangers bhatak kar andar aa jate hain.
Bare vLLM server ki haalat thik yahi hai. Port tak pohanchne wala koi bhi person isay free mein hamesha use kar sakta hai. Yeh kya nahin karta, usay aahista parhna mufeed hai, kyunke har item woh cheez hai jo warna aap ko khud banani paregi:
| Aap ko kya chahiye | Kya vLLM yeh karta hai? |
|---|---|
| Aik saath kai users ko tezi se tokens serve karna | Haan. Yahi is ka poora kaam hai aur yeh is mein excellent hai. |
| Yeh jaanna ke kaun call kar raha hai | Nahin. |
| Spending limit par kisi ko roka dena | nahin. |
| aik user ko baqi sab ko bahar karne se rokna | kuch had tak queueing se, lekin per user nahin. |
| aik address par aik se zyada model offer karna | nahin. One server, one model. |
| is ke fail hone par doosre model par fallback karna | nahin. |
| kis ne kitna spend kiya, record karna | nahin. |
| Local model fail hone par cloud model tak pohanchna | nahin. |
Us table ka har "nahin" gateway ka kaam hai.
Kitchen khana banati hai. Front of house tay karta hai kaun khaye, menu mein kya hai aur pay kaun kare. Aap ne bahut achi kitchen banayi hai. Ab aap ko door chahiye.
Is point par fair question hai: kya koi aik program dono karta hai? Taqreeban, aur honest answer matlab rakhta hai. Serving infrastructure problem hai, aur open source world ne isay bahut achi tarah solve kiya hai. Metering, quotas aur billing product problem hai, aur inference companies asal mein yahi bechti hain. Is liye open tools engine aur meter alag pieces mein dete hain, aur aap unhein assemble karte hain. Achi baat yeh hai ke yahan har layer wohi OpenAI-compatible request shape bolti hai jisay Part 1 se use kar rahe hain, is liye assembly ka matlab configuration hai, translation work nahin.
Concept A1 tab done hai jab: bare vLLM server ki teen aisi cheezen bata saken jin ki fifty students ki class ko day one par zaroorat hogi.
A2. Gateway: aik address, kai brains, real users
Gateway aik chhota program hai jo aik ya zyada model servers ke aage baithta hai. Requests gateway par ati hain, gateway tay karta hai un ke saath kya karna hai aur phir unhein aage bhejta hai. Yeh front door hai.
Aap aik pehle hi use kar chuke hain. Part 3 ka OpenRouter gateway hai: aik address, aik key, aik bill, us ke peeche hundreds of models aur actual serving aise hosts karte hain jinhein aap direct contact nahin karte. Yeh appendix wohi shape apne scale par, apni machine par banata hai, jahan company ki jagah operator aap hain.
Is kaam ke liye yahan LiteLLM hai, aik open source proxy jo users se OpenAI-compatible shape mein baat karta hai aur bahar providers ki lambi list ke liye translate karta hai, jis mein aap ka apna vLLM server bhi hai. Char cheezen isay sahi piece banati hain:
- Virtual keys. Har student ko apni key issue karte hain. Us par limits laga sakte hain, us ka spend dekh sakte hain aur semester khatam hone ya laptop khone par foran revoke kar sakte hain.
- Budgets aur rate limits. Key mein spending cap aur per-minute limit ho sakti hai. Runaway loop cap hit kare, to gateway agli request refuse kar deta hai. Aap ka bill us number par barhna rok deta hai jisay pehle chuna tha.
- Aik address par models ka menu. Aap ka local Qwen3 8B aur frontier cloud model dono aik hi gateway par dikh sakte hain, aur wohi students usi key se dono tak pohanch sakte hain.
- Records. Har request user ke against log hoti hai, is liye "kis ne kitna spend kiya" investigation nahin, query hai.
Is ka shape notice karein. Gateway kisi cheez ko faster nahin banata. Yeh tokens per second ke baare mein kuch nahin badalta aur apne kuch milliseconds jorta hai. Yeh performance tool bilkul nahin. Yeh control tool hai, aur control hi server ko service mein badalta hai.
Student kehta hai gateway bekar hai kyunke "vLLM mujhe pehle hi OpenAI-compatible address deta hai, is liye main wohi use kar sakta hun." Sab se strong reply kya hai? Address ke baare mein woh sahi aur service ke baare mein ghalat hain. vLLM address aik trusted person ke liye thik kaam karta hai, aur isi wajah Concept 11 wahan ruk sakta tha. Gateway us har cheez ke liye hai jo kai logon ke aate hi samne ati hai: separate keys, spending caps, rate limits, aik se zyada models ka menu, fallbacks aur kis ne kya use kiya us ka record. In mein se koi speed feature nahin hai, is liye comparison us day tak khali lagta hai jab runaway loop poore weekend chalta rahe aur koi na bata sake ke woh kis ka tha.Answer dekhein
Concept A2 tab done hai jab: aik sentence mein bata saken ke gateway kya jorta hai jo inference engine kabhi nahin dega, aur yeh speed feature kyun nahin hai.
A3. Isay khara karein: poora stack aik file mein
Four containers. One machine. One file.
| Container | Kaam |
|---|---|
| vllm | Aap ke GPU par Qwen3 8B serve karta hai. Concept 9 wala hi server, ab us ke aage door hai. |
| litellm | Gateway. Yahi aik cheez hai jisay aap ke users kabhi touch karte hain. |
| postgres | Keys, users, budgets aur spending store karta hai, taake restart aap ki class ko wipe na kare. |
| open-webui | Aap ki class mein terminal use na karne wale logon ke liye chat page. |
Gateway ki apni config se shuru karein. Isay litellm-config.yaml ki shakal mein save karein:
model_list:
  # Your own GPU, from Part 2. Students see the name on the left.
  - model_name: qwen3-8b
    litellm_params:
      model: hosted_vllm/Qwen/Qwen3-8B
      api_base: http://vllm:8000/v1
      api_key: "not-needed"

general_settings:
  master_key: os.environ/LITELLM_MASTER_KEY
  database_url: os.environ/DATABASE_URL

litellm_settings:
  drop_params: true
Wahan do details ke naam jaanna mufeed hai. model_name woh naam hai jo aap ke users type karte hain, aur us ka neeche wale real model name se match karna zaroori nahin: yahi indirection aap ko baad mein bina kisi ko bataye brain swap karne deta hai. Aur master_key poore cloud ka aap ka admin password hai. Yeh student key nahin. Yeh aap ki machine se kabhi bahar nahin jata.
Ab stack. Isay docker-compose.yml ki shakal mein save karein:
services:
  vllm:
    image: vllm/vllm-openai:latest
    command: >
      --model Qwen/Qwen3-8B
      --enable-auto-tool-choice
      --tool-call-parser hermes
      --reasoning-parser qwen3
    volumes:
      - ./hf-cache:/root/.cache/huggingface
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: all
              capabilities: [gpu]

  postgres:
    image: postgres:16
    environment:
      POSTGRES_DB: litellm
      POSTGRES_USER: litellm
      POSTGRES_PASSWORD: ${POSTGRES_PASSWORD}
    volumes:
      - ./pgdata:/var/lib/postgresql/data

  litellm:
    # Pin the version. Read the security note below before you change this.
    image: ghcr.io/berriai/litellm:main-v1.80.5
    depends_on: [vllm, postgres]
    ports:
      - "4000:4000"
    environment:
      LITELLM_MASTER_KEY: ${LITELLM_MASTER_KEY}
      DATABASE_URL: postgresql://litellm:${POSTGRES_PASSWORD}@postgres:5432/litellm
    volumes:
      - ./litellm-config.yaml:/app/config.yaml
    command: ["--config", "/app/config.yaml", "--port", "4000"]

  open-webui:
    image: ghcr.io/open-webui/open-webui:main
    depends_on: [litellm]
    ports:
      - "3000:8080"
    environment:
      OPENAI_API_BASE_URL: http://litellm:4000/v1
      OPENAI_API_KEY: ${LITELLM_MASTER_KEY}
    volumes:
      - ./webui-data:/app/backend/data
Apni do secrets is ke paas .env file mein rakhein, compose file mein kabhi nahin:
LITELLM_MASTER_KEY=sk-choose-a-long-random-string
POSTGRES_PASSWORD=choose-another-long-random-string
Phir isay up karke sabit karein ke yeh kaam karta hai:
docker compose up -d

curl http://localhost:4000/v1/chat/completions \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "qwen3-8b", "messages": [{"role": "user", "content": "Say hello in one line."}]}'
Us request ko Concept 9 wali request ke paas dekhein. Same shape, same /v1/chat/completions, aik nai line: Authorization header. Yahi single header server aur service ke darmiyan poora difference hai. Ab kisi ko batana parta hai ke woh kaun hai.
March 2026 mein LiteLLM package supply chain attack ka target bana aur malicious releases hataye jane se pehle bahar chali gayin. Aap ka gateway cloud ki har key aur har spending record rakhta hai, is liye yeh stack ka highest-value target hai. Is liye exact version tag pin karein, latest kabhi track na karein, move karne se pehle release notes parhein aur dono kaam karne tak gateway ko public internet se door rakhein. Yeh LiteLLM-specific warning nahin hai. Credentials rakhne wali koi bhi service run karne ka yahi matlab hai.
Driver aur CUDA mismatches aam cause hain, aur isi wajah compose file pip install ki jagah official image use karti hai. Host par NVIDIA Container Toolkit bhi installed chahiye, warna Docker ke andar GPU dikhai nahin dega. 16 GB card hai, to Concept 9 ki tarah model line ko Qwen/Qwen3-8B-FP8 se swap karein.
Concept A3 tab done hai jab: docker compose up -d four containers ko up kare, port 4000 se curl answer lautaye aur Authorization header ke bina wohi request refuse ho.
A4. Keys baantein: budgets, limits aur kis ne kitna spend kiya
Yahi concept isay cloud banata hai. Is se pehle ki har cheez plumbing thi.
Aik student ke liye key generate karein:
curl -X POST http://localhost:4000/key/generate \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "user_id": "student-0417",
    "models": ["qwen3-8b"],
    "max_budget": 2.00,
    "budget_duration": "30d",
    "rpm_limit": 20
  }'
Charon settings parhein, kyunke har aik decision hai jo aap jaan boojh kar le rahe hain:
user_idhar future request aur har logged dollar ko aik person se jorta hai. Is ke bina usage report aik bara anonymous number hai.modelswoh menu hai jis se yeh key order kar sakti hai. Sirfqwen3-8blist karne wali key kisi aur cheez tak nahin pohanch sakti, chahe student kuch bhi type kare.max_budgetke saathbudget_durationcap hai. Two dollars a month, phir gateway refuse karna shuru karta hai. Runaway loop raat mein, aap ko jagaye bina, apne aap ruk jata hai.rpm_limitaik enthusiastic student ko baqi sab ke liye queue bharne se rokta hai.
Response aisi key ke saath lautta hai jo sk- se shuru hoti hai. Student ko sirf wohi string milti hai. Aur kuch nahin.
Ab woh moment jis ke liye yeh poora appendix hai. Student aap ka cloud thik usi tarah use karta hai jaise Part 3 ne OpenRouter use kiya tha. Wohi two settings, naya address:
# OpenCode, or anything speaking the OpenAI shape
export OPENAI_BASE_URL="http://your-server:4000/v1"
export OPENAI_API_KEY="sk-the-students-key"
Harness ko kabhi pata nahin chalta ke kuch badla hai. Yeh ab bhi harness plus brain plus address hai, aur ab address aap ki apni building ki aik machine hai.
Khaasa tor par Claude Code ke liye LiteLLM Anthropic-format endpoint bhi expose karta hai, jis se ANTHROPIC_BASE_URL ko direct apne gateway par point kar sakte hain, wohi bare-address move jo teen baar pehle kar chuke hain. Woh surface is page ke track kar sakne se faster move karta hai, is liye us par munhasir hone se pehle live LiteLLM docs check karein. Pinned version par yeh kaam na kare, to Concept 16 ka Claude Code Router aik extra hop se wahan pohancha deta hai aur gateway us ki config mein sirf aik aur provider bana jata hai.
Class live hone ke baad yeh two commands lagatar use kareinge:
# What has this key spent?
curl -X GET "http://localhost:4000/key/info?key=sk-the-students-key" \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY"

# Semester over, or laptop lost.
curl -X POST http://localhost:4000/key/delete \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{"keys": ["sk-the-students-key"]}'
Har diner ko spending limit ke saath apna table number milta hai. Kitchen bilkul nahin badli. Lekin ab jante hain kaun kha raha hai, aik table ko poora menu order karne se rok sakte hain aur kisi ke jane par us ki table wapas le sakte hain.
Aap two hundred student keys issue karte hain, har aik par two dollars a month ki cap hai aur sabhi aap ke apne GPU ki taraf point karti hain. Colleague poochta hai local model ki per token koi cost nahin, to budgets ki pareshani kyun li. Real answer kya hai? Two answers hain aur doosra important hai. Pehla, local mein bhi "free" ghalat hai: aap ke GPU ki fixed throughput hai, thik jaisa Part 2 ki curve ne card bharne par dikhaya tha, is liye money move na hone par bhi aik student ka endless loop baqi sab ki capacity spend kar raha hai. Budget shared resource ko ration karta hai. Doosra, aur Concept A5 yahin jata hai, menu mein cloud model jorte hi unhi keys se real money flow hota hai. Free rehte hue budget habit set karne ka matlab hai ke free hona band hone wale din panic mein isay nahin bana rahe.Answer dekhein
Concept A4 tab done hai jab: alag machine par doosre person ne apni key se aap ke gateway ke through real task run kiya, aap ne dekha ke us ne kitna spend kiya aur baad mein key revoke kar di.
A5. Teeno tiers aik door ke peeche rakhein
Aap ka cloud abhi one brain offer karta hai. Ab course ke doosre two tiers ko usi menu mein jorein, taake student model name badal kar tier chune aur kuch nahin.
litellm-config.yaml extend karein:
model_list:
  # Tier 2: your own GPU. Free at the margin, capped by your hardware.
  - model_name: qwen3-8b
    litellm_params:
      model: hosted_vllm/Qwen/Qwen3-8B
      api_base: http://vllm:8000/v1
      api_key: "not-needed"

  # Tier 3: a frontier brain, rented. Your key, never theirs.
  - model_name: frontier
    litellm_params:
      model: openrouter/moonshotai/kimi-k3
      api_key: os.environ/OPENROUTER_API_KEY

  # Tier 3, the cheap end. The right default for high-volume work.
  - model_name: frontier-cheap
    litellm_params:
      model: openrouter/deepseek/deepseek-v4-pro
      api_key: os.environ/OPENROUTER_API_KEY

router_settings:
  fallbacks:
    - qwen3-8b: ["frontier-cheap"]
Abhi three things hui hain aur har aik apna sentence deserve karti hai.
Aap ki OpenRouter key machine se kabhi bahar nahin jati. Two hundred students ab Kimi K3 tak pohanch sakte hain aur un mein se kisi ke paas aisa credential nahin jo public repository mein paste ho sake. Un ke paas aap ki gateway key hai, jisay one command mein revoke kar sakte hain aur jo apni cap se aage spend nahin kar sakti. Concept 14 ne warn kiya tha ke OpenRouter key aik string mein secret aur wallet dono hai. String diye bina wallet share karne ka yahi tareeqa hai.
Tier choice model name ban gayi. Hard refactor ke liye frontier brain chahne wala student frontier type karta hai, qwen3-8b ki jagah. Yeh Concept 15 ki three-question procedure ko aisi cheez mein badalta hai jisay person task ke darmiyan sach mein kar sakta hai.
Fallback line policy hai. Aap ka GPU down ya full ho, to qwen3-8b ki requests fail hone ki jagah chup chaap frontier-cheap par jati hain. Yeh real trade hai jisay aap jaan boojh kar chun rahe hain: money se khareedi availability. Isay aisi jagah likhein jahan future self paye, kyunke bhoola hua fallback aisa bill hai jisay samajh nahin payenge.
Ab frontier menu ko alag limits dein, kyunke us ki cost real money hai:
curl -X POST http://localhost:4000/key/generate \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "user_id": "student-0417-frontier",
    "models": ["qwen3-8b", "frontier-cheap", "frontier"],
    "max_budget": 5.00,
    "budget_duration": "30d"
  }'
Peeche hat kar dekhein ke kya banaya. One address. Us ke peeche aap ke apne hardware par model aur aise clusters ke models jinhein room mein koi kabhi own nahin kar sakta, same menu par offer hote hain, same caps ke against billed hote hain aur same two settings se pohanchte hain. Concept 2 ne sikhaya tha ke brain sirf address hai. Yeh usi sentence ko ulta parhna hai: aik address kitne bhi brains chhupa sakta hai, aur un ke darmiyan choice ab kisi ki config file hai. Aap ki.
Aap ka fallback failed Taqreeban sixty hours tak har woh request jo free hoti, paid cloud model par run hui aur service perfectly kaam karti rahi, aur thik isi wajah se kisi ko pata nahin chala. Fallbacks silently money ko availability se trade karte hain, aur silence hi danger hai. Two things add karein: vLLM container unhealthy hone par alert aur gateway par spending alert. Fix fallback hatana nahin hai. Yeh yaqeen karna hai ke kuch minutes se longer fallback kisi ko bataye.qwen3-8b requests ko frontier-cheap par bhejta hai. Friday evening ko driver update ke liye GPU machine reboot hoti hai aur Monday tak kisi ko pata nahin chalta. Weekend mein kya hua aur kya add karna chahiye?Answer dekhein
Concept A5 tab done hai jab: aik key local model aur frontier model dono tak name se pohanche aur samjha saken ke fallback rule kya khareedta hai aur us ki cost kya hai.
A6. Isay watch karein: health batane wale three numbers
Jis service ko koi watch nahin kar raha, woh quietly fail hoti hai. vLLM apne numbers http://localhost:8000/metrics par us format mein publish karta hai jisay Prometheus parhta hai, aur standard picture Prometheus ka unhein collect karna aur Grafana ka unhein draw karna hai.
Day one par is ki zaroorat nahin. Yeh jaanna zaroori hai ke kaun se three numbers matter karte hain, kyunke student se pehle woh batate hain ke ghalat kya hai:
- Queue depth: kitni requests wait kar rahi hain. Yeh aap ka single most useful number hai, aur Part 2 experiment live gauge ban gaya hai. Near zero ka matlab machine aasani se chal rahi hai. Charh kar upar rehne ka matlab GPU khatam ho gaya, aur second card, smaller model ya class par honest limit ka waqt hai.
- Time to first token: kuch dikhai dene se pehle user kitni der wait karta hai. Har individual person ka experience kharab hone par bhi throughput wonderful dikh sakta hai. Students asal mein yahi number feel karte hain aur total tokens-per-second figure thik isi ko chhupata hai.
- Use mein GPU memory. Compute se pehle memory bharti hai aur bharne par, kuch broken dikhne se pehle performance girti hai. Node ki sari memory quietly use karta model sab ka experience degrade karta hai, jabke har container ab bhi healthy report karta hai.
Un ke saath two things aur baithti hain. Gateway ka apna spending dashboard, jahan unexpected bill ko month end ki jagah jaldi pakarte hain. Aur dono containers par plain health check, kyunke "kya yeh up hai" aisa question hai jis ka answer machine se three in the morning chahiye, student ke message se nahin.
Queue depth door ki line hai. Time to first token woh time hai jitna har diner food ke liye wait karta hai. GPU memory batati hai kitchen kitni full hai. Sirf total meals served dekhta restaurant owner sab se aakhir mein janta hai ke jagah bikhar rahi hai.
Concept A6 tab done hai jab: apni aankhon se vLLM container par /metrics load kiya ho aur bata saken ke student ke "aaj slow feel ho raha hai" kehne par three numbers mein pehle kaun-sa check kareinge.
A7. Yeh kab worthwhile hai aur kab graduate karna hai
Concepts 7, 12 aur 15 ki spirit mein honest accounting.
Mini cloud tab banayein jab:
- Aap ke paas kai users aur aik budget hai. Classroom, bootcamp, department, small company. Fifty people ko serve karta one GPU un mein se kisi ko milne wala cheapest capable setup hai, aur gateway "fifty people" ko chaotic ki jagah safe banata hai.
- Data bahar nahin ja sakta. Concept 15 ka first question organizational scale par answered, saath mein institution ke liye matter karne wala extra piece: kis ne kya access kiya dikhane wali audit trail.
- Moving world ke aage one stable address chahiye. Models, prices aur providers har few weeks badalte hain. Students gateway par point karein, to two hundred logon se settings badalwane ki jagah config file mein woh churn absorb karte hain.
- Loops poore day run karte hain. Baad mein milne wale Loop Engineering agents hamesha requests fire karte hain. Per-token bill par woh addition kabhi nahin rukta. Pehle se owned aur saturated GPU par aik aur request ki extra cost taqreeban kuch nahin hai.
Isay tab na banayein jab:
- Aap one person hain. Poora front of house aap hain. Concept 11 ki tarah direct vLLM use karein aur yeh appendix skip karein.
- Traffic chhota aur occasional hai. Idle GPUs ki cost busy ones jitni hi hai. Real daily traffic volume se neeche Part 3 ke through rent karna money aur weekends dono par jeetta hai, aur bahut bare margin se jeetta hai.
- Koi isay own nahin karta. Yeh woh failure hai jisay koi plan nahin karta. Mini cloud service hai aur tootne par services ko responsible person chahiye. Woh person maujood na ho, to holiday par pehli baar down hote hi cheez mar jati hai aur sab ka trust khatam hota hai.
Docker Compose se aage kab graduate karein. Upar ka compose stack real service hai aur hairat angez tadaad mein students ko carry karega, lekin yeh har cheez ki aik copy wali one machine hai. Is mein autoscaling aur kisi cheez ki second copy nahin. Isay outgrow karne par rewrite nahin karte: same pieces ko Kubernetes par move karte hain. Two paths ke names jaanna mufeed hai. vLLM production stack metrics, dashboards aur cache reuse pehle se wired Helm chart deta hai. KubeAI aage ja kar models ko Kubernetes resources ki tarah manage karta hai, neeche vLLM aur Ollama run karta hai aur chat UI bundle karta hai, is liye is appendix ka bara hissa two Helm installs mein collapse ho jata hai. In mein se koi gateway replace nahin karta, kyunke koi per-user keys aur budgets nahin karta. Woh layer thik wahin rehti hai jahan rakhi thi.
Honest limit, aur wohi jis par Part 2 khatam hua. Gateway kisi wall ko move nahin karta. Yeh throughput improve nahin karta aur brain ko smarter nahin banata. Yeh fast brain ko shareable banata hai, jo alag tarah ki win hai aur aksar wohi tay karti hai ke room bhar log AI use kar payenge ya nahin.
Department forty staff ke liye private AI service chahta hai. Koi direct autoscaling aur multi-node serving wale Kubernetes par jane ka proposal deta hai, "taake baad mein dobara na karna pare." Is ke against argument kya hai? Forty users usay comfortably fit hote hain jisay Docker Compose ke peeche one GPU serve kar sakta hai, is liye Kubernetes aaj setup ke weeks aur permanent operational burden ki cost par kuch nahin khareedta. Upgrade path rewrite bhi nahin: load justify kare to wohi containers, wohi gateway config aur wohi model Helm charts par move hote hain. Is month kaam karne wali cheez banayein, real traffic measure karein aur measurement ko decide karne dein ke graduate kab karna hai. Sahi question "kya isay outgrow kareinge" nahin balki "is ke tootne par on call kaun hai" hai.Answer dekhein
Concept A7 tab done hai jab: apni situation ke liye dono sides argue kar saken aur gateway ki improve na ki jane wali one thing bata saken.
Appendix A aik line mein
Inference engine tokens serve karta hai aur gateway logon ko serve karta hai, aur mini LLM cloud sirf woh two programs aur keys rakhne ki jagah hai. Isay tab banayein jab kai mouths aik budget share karein. Aur notice karein ke asal mein kya kiya hai: aap ke address par point karne wale har person ke liye ab aap cloud hain.
References
Is page ke commands ke primary sources yeh hain. Woh tezi se move karte hain, is liye kisi specific flag, price ya version par depend hone se pehle live docs check karein.
Part 1: Local (Ollama)
- Ollama, desktop app (model download aur chat karein, terminal ke bina). https://ollama.com/blog/new-app aur https://ollama.com/download
- Ollama,
ollama launch(local model par coding agent wire aur launch karne ke liye one command). https://ollama.com/blog/launch aur https://docs.ollama.com/integrations/claude-code - Ollama, Anthropic API compatibility (native endpoint jo no-proxy setup possible banata hai). https://ollama.com/blog/claude
- Ollama, context length aur
num_ctx, VRAM-based defaults aur coding agents ke liye 64K guidance. https://docs.ollama.com/context-length - Claude Code, Environment variables,
ANTHROPIC_BASE_URL,ANTHROPIC_AUTH_TOKENaurAPI_TIMEOUT_MSke liye. https://code.claude.com/docs/en/env-vars - OpenCode, Providers,
opencode.jsonprovider block aur OpenAI-compatible endpoint ke liye. https://opencode.ai/docs/providers/ - Skills installer aur GitHub CLI
gh skillcommands, skills install aur publish karne ke liye. https://skills.sh/docs
Part 2: Server (vLLM)
- vLLM, documentation home (installing,
vllm serveaur OpenAI-compatible server). https://docs.vllm.ai - vLLM, Tool calling,
--enable-auto-tool-choiceaur per model family tool-call parser ke liye. https://docs.vllm.ai/en/latest/features/tool_calling/ - vLLM, Claude Code integration, Anthropic Messages support aur
ANTHROPIC_DEFAULT_*_MODELvariables ke liye. https://docs.vllm.ai/en/latest/serving/integrations/claude_code/ - Qwen, vLLM deployment guide, Qwen3 models serve karne aur recommended parsers ke liye. https://qwen.readthedocs.io/en/latest/deployment/vllm.html
Part 3: Cloud (OpenRouter)
- OpenRouter, Claude Code integration, environment variables aur Anthropic-compatible endpoint ke liye. https://openrouter.ai/docs/cookbook/coding-agents/claude-code-integration
- OpenRouter, Kimi K3 model page, live slug, price aur providers ke liye. https://openrouter.ai/moonshotai/kimi-k3
- OpenRouter, DeepSeek V4 Pro model page, live slug, price aur providers ke liye. https://openrouter.ai/deepseek/deepseek-v4-pro
- Moonshot AI, Kimi K3 technical blog, architecture, context window aur serving recommendations ke liye. https://www.kimi.com/blog/kimi-k3
- DeepSeek, API pricing, current V4 Pro rates aur cache-hit pricing ke liye. https://api-docs.deepseek.com
Concept 16: Claude Code Router
- Claude Code Router, router install karne,
ProvidersaurRouterconfig, transformers aurccrcommands ke liye. https://github.com/musistudio/claude-code-router
Appendix A: Mini LLM cloud
- LiteLLM, proxy server documentation, config file, virtual keys, budgets aur rate limits ke liye. https://docs.litellm.ai/docs/simple_proxy
- LiteLLM, virtual keys,
/key/generate,/key/info,/key/deleteaur per-key model access ke liye. https://docs.litellm.ai/docs/proxy/virtual_keys - LiteLLM, budgets aur rate limits,
max_budget,budget_durationaurrpm_limitke liye. https://docs.litellm.ai/docs/proxy/users - LiteLLM, reliability aur fallbacks,
router_settingsfallback rules ke liye. https://docs.litellm.ai/docs/proxy/reliability - vLLM, Docker deployment, official
vllm/vllm-openaiimage aur GPU runtime flags ke liye. https://docs.vllm.ai/en/latest/deployment/docker.html - vLLM, production metrics, Prometheus endpoint, queue depth aur time to first token ke liye. https://docs.vllm.ai/en/latest/serving/metrics.html
- vLLM, production stack, Kubernetes upgrade path ke routing, metrics aur dashboards wala Helm chart. https://github.com/vllm-project/production-stack
- KubeAI, Kubernetes ke liye AI inference operator, vLLM aur Ollama par models ko Kubernetes resources ki tarah manage karne ke liye. https://www.kubeai.org
- Open WebUI, documentation, chat interface aur OpenAI-compatible endpoint se connect karne ke liye. https://docs.openwebui.com
- NVIDIA, Container Toolkit installation guide, Docker ke andar GPU access ke liye required. https://docs.nvidia.com/datacenter/cloud-native/container-toolkit/latest/install-guide.html