Graph Engineering: Aik Crash Course
16 Concepts · Aik loop ki spine se us graph tak jo hazaar agents share karte hain
Aap ka loop kaam karta hai. Woh har subah 9 baje fire hota hai, harness usay hudood mein rakhta hai, aur us ki spine, aik progress.md file, kal seekhi hui baat ko aaj tak le aati hai. Aik loop, aik memory file. Yeh kaafi tha.
Ab dekhein kamyabi ke baad kya hota hai. Aap doosra loop jorte hain. Phir review loop. Phir aik masroof hafte mein bees files ka aik saath audit karne ke liye bees agents fan out karte hain. Har agent khaali context window se shuru hota hai. Har aik woh baat dobara dhoondta hai jo doosra agent aik ghanta pehle dhoond chuka tha. Har aik apni findings aise transcript mein likhta hai jo koi doosra agent kabhi nahin parhega. Kaam barh gaya. Memory nahin barhi. Aap ne shared brain ke baghair team bana di.
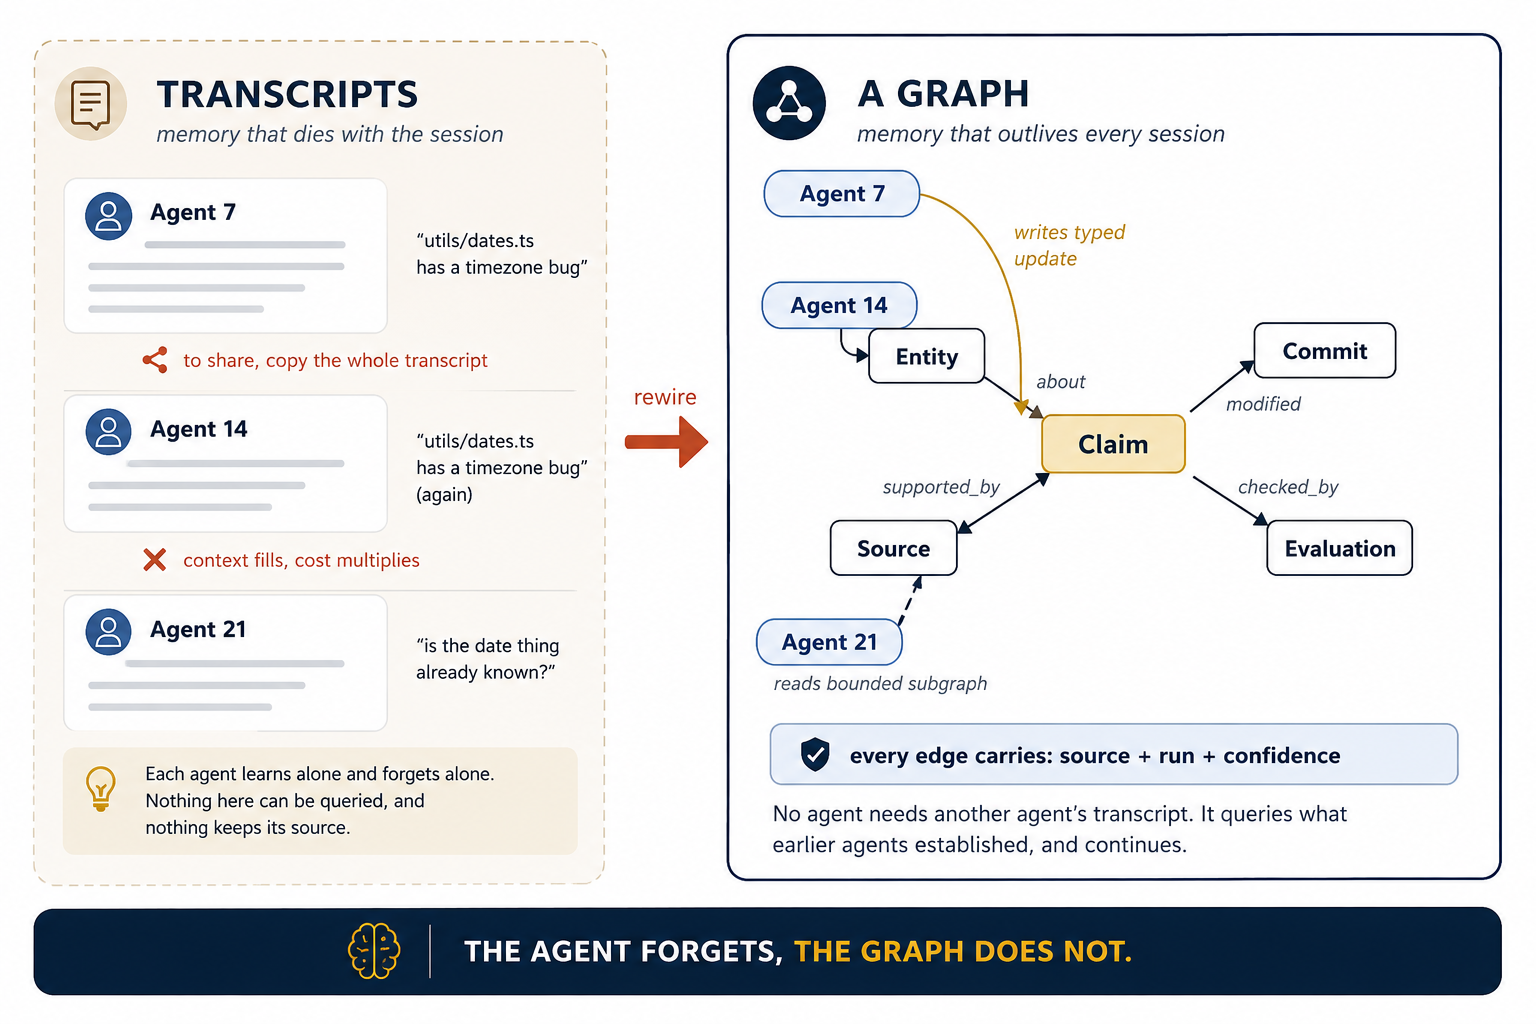
Yahi masla graph engineering hal karti hai. Idea aik jumle ka hai: agent bhool jata hai, graph nahin bhoolti. Agents jo seekhte hain usay transcripts ke andar chhorne ke bajaye, aap un se typed, connected records, yani nodes aur edges, likhwate hain jinhein koi bhi baad ka agent query kar sake. Do graphs yeh kaam karti hain. Commit DAG kaam yaad rakhti hai: kya try hua, kya kis se nikla, aur kya rakha gaya. Knowledge graph facts yaad rakhti hai: kaun si entities mojood hain, woh kaise related hain, aur har claim ko kaun sa source sabit karta hai. Yeh course dono sikhata hai aur 2026 ki sab se wazeh documented misaalein istemaal karta hai: pehli ke liye Andrej Karpathy ka autoresearch aur AgentHub, doosri ke liye Anthropic ki Knowledge Graph Construction Cookbook aur Dynamic Workflows. Aur kyun ke loops ko bhi wiring chahiye, Part 5 teesri graph, governance graph, jorta hai: kaun kisay check karta hai, kis ka target kis ke paas hai, aur kaun si measurements se koi loop behas nahin kar sakta.
Pehle yeh karein: Loop Engineering aur Harness Engineering. Loop course ne beat, spine, maker-checker split, aur ratchet sikhaye. Harness course ne paanch verbs aur typed output sikhaya. Yeh course yeh sab pehle se maloom maanta hai. Spine aik loop ki private memory thi. Yeh course dikhata hai ke jab kai agents ko memory share karni ho to spine kya banti hai. Agar yeh alfaaz naye hain to pehle woh courses karein.
📚 Teaching Aid
Poori Presentation Dekhein: Graph Engineering: Aik Crash Course
Neeche diye gaye das figures usi order mein sikhane ke liye banaye gaye hain: har aik sirf aik concept uthata hai aur slide par akela samajh aata hai.
Neeche har concept ke saath aik script hai jise sirf parhna nahin, chala kar dekhna bhi mumkin hai. Inhein bash, git, jq, aur python3 chahiye, aur kuch nahin: na API key, na pip install, na network.
git clone https://github.com/panaversity/agentfactory-labs.git
cd agentfactory-labs/crash-course/graph-eng
./verify.sh      # runs all 17 demos and asserts each one
Jab output mein Everything in this course runs. aaye to folder ko is page ke saath khula rakhein. Har concept us aik command par khatam hota hai jo usay dikhati hai: aap git reset ko commit mitate, schema ko malformed reply reject karte, checker ko missing edge mangte, aur pre-commit gate ko schema violation block karte dekhenge. Lab README har concept ko us ke demo se map karti hai.
Agar in mein se koi cheez nai hai to pehle Loop Engineering aur Harness Engineering courses parhein. Yeh course un courses ki banai hui machinery ko jorta hai.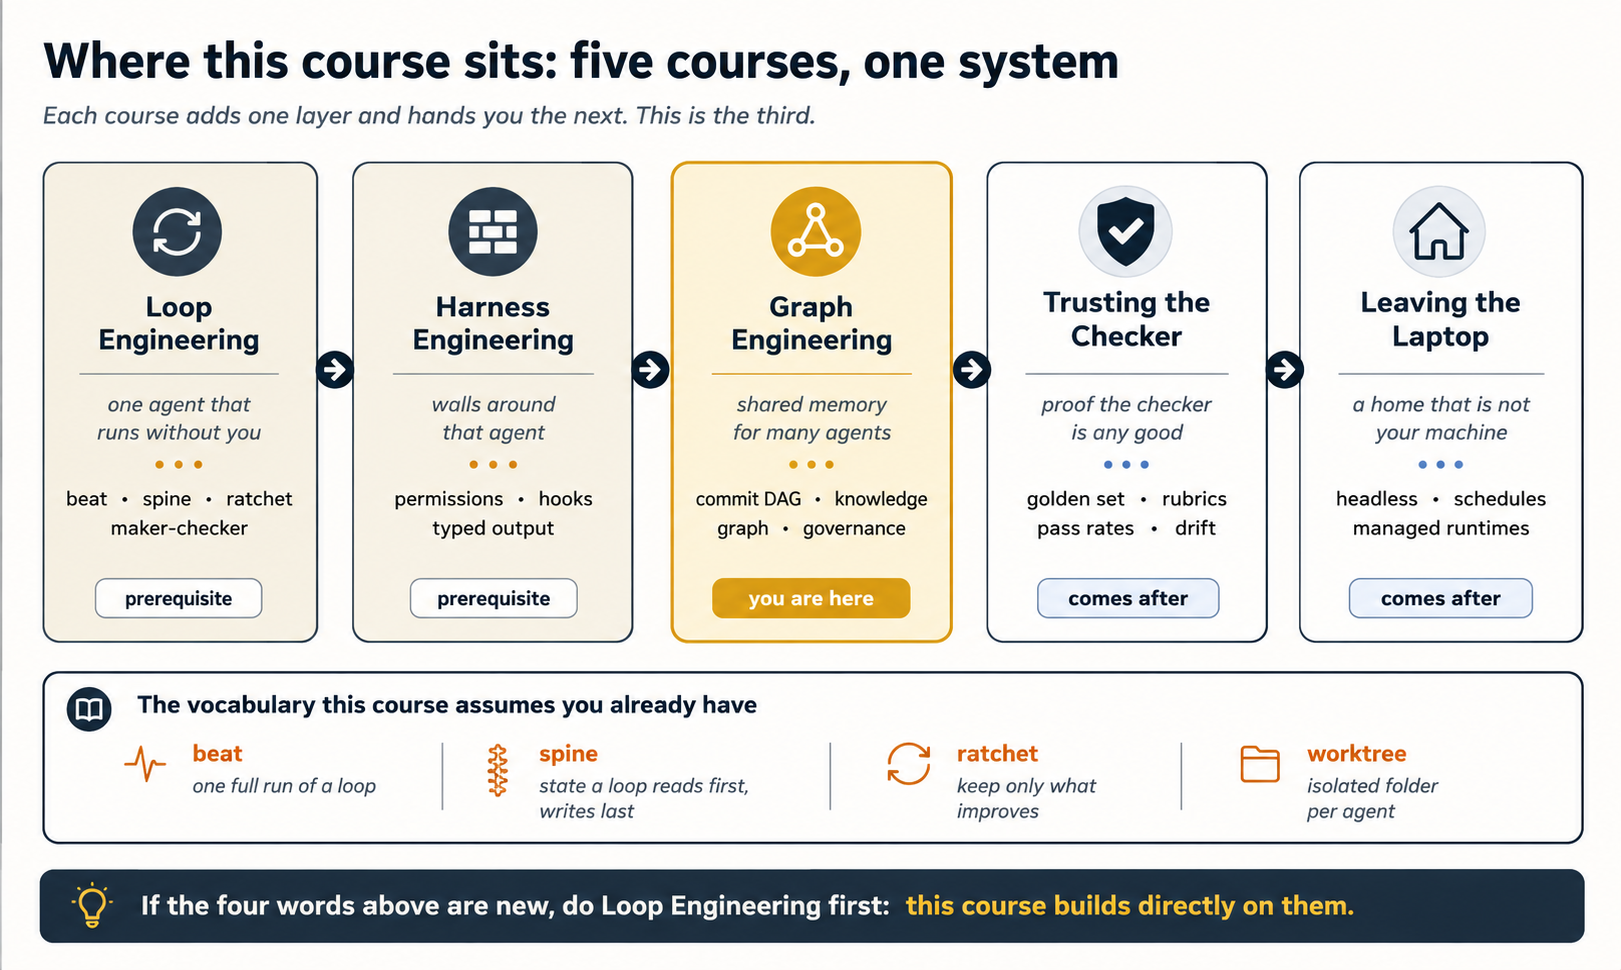
Naye hain? Jo aap ko pehle se maloom hona chahiye us ka 2-minute recap
progress.md, jise loop pehle parhta aur aakhir mein likhta hai, taake agla beat jaan sake kya hua.main tak nahin pohanchti.
Aham alfaaz, seedhi zaban mein
Yeh alfaaz poore course mein milenge. Is list ko ab aik baar parhein, phir jab koi term ghair wazeh lage to yahan wapas aayein.
| Term | Seedha matlab |
|---|---|
| Graph | Points, yani nodes, ka set jo arrows, yani edges, se jura ho. Arrows ki direction hoti hai aur direction ma'ni rakhti hai. |
| Node | Graph ka aik point: entity, claim, commit, source, ya agent run. |
| Edge | Do nodes ke darmiyan label wala arrow: supports, parent_of, produced, works_for. |
| DAG | Directed acyclic graph: arrows kabhi ghoom kar apne paas wapas nahin aate. Git history aik DAG hai. |
| Commit DAG | Kaam ki graph: commits nodes aur parent links edges hain. Yeh jawab deti hai, "kya try hua aur kya kis se nikla?" |
| Knowledge graph | Facts ki graph: entities nodes aur typed relations edges hain. Yeh jawab deti hai, "kya mojood hai aur kaise connected hai?" |
| Entity | Aisi cheez jise graph track karti hai: person, company, file, vendor, ya incident. |
| Relation / triple | Subject-predicate-object ki shakal mein aik fact: (Vendor X, supplied, Component Z). |
| Surface form | Naam bilkul usi tarah jaise document mein nazar aaye: "Edwin Aldrin", "Buzz", "Col. Aldrin". Teen surface forms, aik person. |
| Entity resolution | Faisla karna ke kaun se surface forms aik hi asli cheez hain, aur original names khoye baghair unhein aik canonical node mein merge karna. |
| Provenance | Claim ke saath lagi receipt: kis source ne kaha, kis run ne extract kiya, aur extraction kitni confident thi. |
| Claim | Aisa statement jise graph mumkin taur par durust samajh kar store karti hai, hamesha provenance ke saath, kabhi bare truth ke taur par nahin. |
| Subgraph | Aik task ke liye graph ka chhota, relevant hissa. Agents ko subgraphs dein, poori graph kabhi nahin. |
| Grounding | Answer ya verdict ko apne impression ke bajaye graph ki asli edges ki taraf point karne par majboor karna. |
| Swarm | Bahut se agents aik hi waqt explore, implement, ya evaluate karte hain. |
| Structured output | Schema, misal ke taur par Pydantic model, tak mahdood model response, taake code bharosa karne se pehle validate kar sake. |
| MCP | Model Context Protocol: agent ke bahar ke system tak pohanchne ka standard tareeqa. Graph files mein ho to zaroorat nahin. Database bane to yahi jawab hai. |
| Governance graph | Aisi graph jis ke nodes khud loops, human gates, aur anchors hain, aur edges batati hain kaun kisay feed, check, aur constrain karta hai. |
| Execution loop | Baar baar hone wala kaam karta loop: issues triage karna, PR review karna, changelog draft karna. |
| Improvement loop | Target ke muqable mein number dekhta aur kaam karne wale system ko adjust karta loop. |
| Counter-metric | Doosra number jise doosra loop dekhta aur pehle number ki gaming pakarta hai. |
| Anchor | Aisi measurement jis se koi loop behas nahin kar sakta: waqai chala test, waqai ruka customer, waqai aaya paisa. |
| Frozen node | Aisi rule ya file jise optimizing loops kabhi nahin badal sakte, theek is liye ke woh badalna chahein ge. |
Loop course ne loops ko body metaphor diya tha: heartbeat, body, spine. Yeh course aik aur jorta hai: graph shared brain hai, aisi memory jo kisi aik agent ki context window se zyada der zinda rehti hai.
Mukhtasar version: primary work asli aur public hai, lekin us ki viral framing ghalat hai. "Anthropic ke do seniors ki 11-page PDF" aik independent study note hai jo apne front page par saaf kehti hai ke woh Karpathy ya Anthropic se affiliated ya endorsed nahin. "1000x" measurement nahin, slogan hai. Pehle primary sources parhein. Timeline chhoti aur public hai. 7 March 2026 ko Karpathy ne autoresearch release kiya: chhote training repo mein band agent jo aik waqt mein takreeban paanch minute ka experiment chalata aur sirf metric behtar karne wali cheez rakhta hai. Chand hafton mein usay GitHub par dason hazaar stars mile aur Fortune ne pattern ko "Karpathy Loop" kaha. Teen din baad us ne AgentHub ka sketch banaya: "GitHub is for humans. AgentHub is for agents." Yeh bare Git repo aur message board tha jahan swarms main branch ke bajaye commit DAG ke zariye coordinate karte hain. 23 March 2026 ko Anthropic ne apni Knowledge Graph Construction Cookbook publish ki, jo classical NLP pipeline ko structured-output prompts se badalti hai: typed entities aur relations extract karein, duplicates resolve karein, graph assemble karein, aur citations ke saath query karein. Anthropic ki Dynamic Workflows, 28 May 2026 ko announce hui aur ab generally available hai, Claude ko orchestration script likhne deti hai jo kaam parallel fresh-context sub-agents mein fan out karti hai. 18 July 2026 ko Peter Steinberger ke aadhi raat ke baad 12-word sawal, "Are we still talking loops or did we shift to graphs yet?", ne poore topic ko season ka naam diya. Part 5 woh kahani aur Carlos E. Perez ka jawab batata hai. Chand din baad aik viral post ne sab jor diya: "Two Anthropic seniors just made Karpathy's loop 1000x better with Graph Engineering — dropped 11-page PDF." Isay dohrane se pehle PDF ka pehla page parhein. Woh italics mein kehta hai: independently compiled, not affiliated with Andrej Karpathy and Anthropic, and not endorsed. Synthesis waqai mufeed hai aur yeh course us se seekhta hai, lekin woh independent author ka study note hai, Anthropic paper nahin, aur "1000x" measurement nahin, slogan hai. Yahi reflex Steinberger ke sawal ko "loop engineering is dead" bana gaya tha. Part 5 usay kholta hai. Isay bhi usi tarah dekhein. Primary sources asli aur qeemti hain, lekin aik caveat yaad rakhein: autoresearch aur Anthropic ki cookbook aur workflow docs public hain, jab ke AgentHub release ke baad private ho gaya aur ab sirf unlicensed forks mein bacha hai. Concept 5 mein mazeed hai. Aik asli convergence meme se reh gayi, aur woh meme se bhi ajeeb hai: 19 May 2026 ko Karpathy Anthropic ki pretraining team mein shamil hua, taake Claude se pretraining research tez karne wala group bana sake. Is liye is course ki loop aur graph traditions waqai Anthropic mein milin. Bas viral post ke bataye tareeqe se nahin aur us PDF mein nahin. (Tamam sources Sources & further reading mein hain.)Poori timeline aur meme ne kya ghalat bataya
Industry "graph engineering" ko aik se zyada ma'ni mein istemaal karti hai. Un mein se do qareebi related hain aur yeh course dono ko poora cover karta hai. Pehla memory graph hai: agents ki shared durable, typed state. Is mein kaam ka commit DAG aur facts ki knowledge graph shamil hain. Yeh Parts 2 se 4 tak hai.
Doosra governance graph hai: khud loops ke darmiyan wiring. Yeh record karti hai ke kaun kisay feed karta, kaun kisay check karta, human gate kahan hai, aur kaun si measurements se koi loop behas nahin kar sakta. Yeh Part 5 hai, Peter Steinberger ke sawal aur Carlos E. Perez ke essay par mabni.
Yeh dono aik system ki layers hain, rivals nahin. Governance graph workers ko jorti hai. Memory graph workers ki maloomaat store karti hai. Woh Concept 10 mein milti hain, jahan governance layer ka checker memory layer se evidence parhta hai. Loop course bilkul wahan khatam hota hai jahan yeh course shuru hota hai, aik poore bane loop ke saath, aur dono usay is course ke hawale karte hain.
Teesra ma'ni bhi chal raha hai, lekin yeh course usay nahin sikhata. Kuch writers execution topology ke liye "graph engineering" kehte hain: nodes records ya loops ke bajaye steps, edges data dependencies, aur design sawal yeh ke kya parallel chal sakta aur run ko kahan wait karna hoga. Yeh orchestration frameworks ka ilaqa hai aur phrase se purana: LangGraph ne January 2024 mein shared state par nodes aur edges ship kiye, Microsoft ka AutoGen aur Google ka ADK bhi apne versions rakhte hain. Is ke behtareen ideas phir bhi yahan aate hain: Concept 11 ka arrow test aur routing split, aur Concept 14 ke budget aur join rules. Lekin agar aap orchestration graph banane ka chapter dhoond rahe the to woh alag course hai. Build se pehle dono sawalon mein farq karna unhein mila dene se zyada mufeed hai. Aap ke loops ki wiring aur aik run ki shape related masail hain, lekin jawab mukhtalif.
Chhe-step playbook aur har step pehle kahan mila
Zyada tar readers viral chhe-step playbook se yahan aate hain. Us ke chhe mein se chaar steps aap ke peechhe hain. Yeh course baqi do aur list se chhoota hissa sikhata hai. Is liye "1000x" ka imandaar version benchmark nahin. Steps 1 se 3 aap ko capable worker dete hain, aur steps 4 se 6 aise hazaar workers ko aik shared memory dete hain. Model wohi, architecture mukhtalif.Is series par map kiye gaye chhe steps
Post mein diya step Asal mein kya hai Aap ne kahan seekha 1. Aik loop banayein: generate, critique, revise Maker-checker beat aur ratchet Loop Engineering 2. Tools jorein: search, code, database Connectors aur unhein mahdood rakhne wali tool schemas Loop aur Harness Engineering 3. Parallel jayein: alag worktrees mein agents Isolation, taake concurrent work collide na kare Loop aur Harness Engineering 4. Graph jorein: transcripts nahin, typed nodes aur edges Session se zyada tikne wali memory Is course ke Parts 2 se 4 5. Evaluator ko vibes nahin, edges mein ground karein Citable evidence ke saath verification Is course ka Concept 10 6. Graph har session ke baad zinda rehti hai Provenance, supersession, aur durable state Concepts 8 aur 13, aur Part 6
Zehni tabdeeli, aik tasveer mein
Tools par aik note, jo sibling courses se chhota hai. Loop, harness, aur eval work mein tool-specific spellings sikhani thin. Graph work mein takreeban koi nahin: graph files, Git, jq, aur aap ke apne schema se banti hai, is liye na kuch khareedna hai, na product feature configure karna. Claude Code aur OpenCode yahan sirf graph parhne aur likhne wale workers hain. Neeche har command dono mein aik jaisi chalti hai aur poore course mein claude -p aur opencode run interchangeable hain. Yeh tool-independence course ke scope ka accident nahin. Yeh sab se mazboot evidence hai ke graph feature nahin, discipline hai.
Aik term yahan honi chahiye, kyun ke readers durust taur par us ki umeed karte aur phir usay ghalat jagah rakh dete hain. MCP, Model Context Protocol, agent ke outside system tak pohanchne ka standard tareeqa hai: server tools expose karta aur MCP samajhne wala agent unhein call kar sakta hai. Is course ke size par MCP bilkul nahin aata, aur yahi durust hai: graph repo mein files hai, is liye agent apne mojooda file aur shell tools se usay parhta aur likhta hai. Agle size par MCP jawab banta hai. Jab graph Postgres ya Neo4j mein chali jaye aur alag machines ke kai agents ko pohanchna ho, har agent ko database credentials aur hand-rolled client na dein. Store ke samne aik MCP server rakhein jo chhoti typed surface expose kare: entity resolve karna, bounded subgraph fetch karna, validated claim append karna. Phir is course ki har rule server mein rahegi, jahan aik baar enforce hoti hai, har agent ke prompt mein nahin jahan sirf darkhwast hoti hai.
Teen layers alag rakhein, kyun ke woh asani se blur hoti hain. Skill woh knowledge hai jo agent load karta hai: yahan claims kaise likhte hain. MCP wire hai: agent store tak kaise pohanchta hai. Graph khud memory hai: asal mein kya yaad rakha gaya. Graph ke baghair skill aisi salah hai jise likhne ki jagah nahin. Skill ke baghair graph inconsistent bharti hai. MCP in mein se koi nahin. Woh plumbing hai jo us waqt zaroori hoti hai jab store agent ke isi folder mein file nahin rehta.
Late July 2026 mein durust, mukhtalif shelf lives ke saath. Autoresearch actively develop ho raha hai. AgentHub frozen aur private hai, is liye us ke bare mein har baat history samjhein. Dynamic Workflows ab generally available hai aur limits aur defaults product ke saath badalte hain. Cookbook living notebook hai. Kisi flag, limit, ya model name par bharosa karne se pehle live sources check karein: github.com/karpathy/autoresearch, platform.claude.com/cookbook, code.claude.com/docs, opencode.ai/docs.
Yeh course kya cover karta hai
| Part | Topic | Aap kya seekhte hain |
|---|---|---|
| 1 | Memory problem | Transcripts team memory ki tarah kyun fail hote hain, graph kya hai, aur har swarm ko kaun si do graphs chahiye |
| 2 | Kaam ka DAG | Karpathy ka raasta: autoresearch history ko Git mein likhta hai, AgentHub DAG ko collaboration layer banata hai |
| 3 | Facts ki graph | Anthropic ka raasta: schema se extraction, entity resolution, aur har edge par provenance |
| 4 | Graph se kaam | Dumps ke bajaye subgraphs aur grounded checker: "triple nahin mila" kehna "ghalat lagta hai" se behtar |
| 5 | Loops ki graph | Governance layer: kaun kisay check karta, single loop ke tootne ke chaar tareeqe, aur anchors jin se koi loop behas nahin kar sakta |
| 6 | Aik graph, shuru se aakhir tak | Morning-triage loop ki spine ko files aur shell se dono tools mein chhoti queryable graph banana |
| 7 | Grounded rehna | Level chunna, complexity budget, graph kab na banayein, aur agle do courses ka bridge |
| Live | Dogfooding | Is book ki chalti proto-graph aur woh graph jo yeh jaan boojh kar nahin banati |
| Practice | Projects | Aath graph builds, asaan se mushkil |
Kaam kar ke seekhna chahte hain? Pehle Part 6 parhein aur aik finished graph dekhein. Phir parts ke liye wapas aayein.
Pehli baar? Memory path lein: Parts 1 se 4, yani Concepts 1 se 10, phir seedha Part 6 par ja kar usay banayein. Part 5 aur "Going deeper" marked har note skip karein. Is mein takreeban do ghante lagte hain, ya examples ko sirf parhne ke bajaye karne par qareeb teen. Phir Projects 1 se 3 karein. Is ke baad aap apne system ko graph ki tarah draw, claims ko sources ke saath store, aur reviewer se evidence cite karwa sakte hain.
Doosri reading, jab aap ki pehli graph aisa sawal answer kar chuki ho jo transcripts nahin kar sake: governance path lein, yani Part 5, poora Part 7, aur Projects 4 se 8. Part 5 kai loops ko imandaar rakhne ke bare mein hai aur tabhi zaroori banta hai jab aik se zyada loop aik hi memory mein likhte hain. Concept 15 ki warnings bhi tabhi asar karti hain jab aap ke paas aisi graph ho jise over-build karne ka dil ho.
Do layers, mukhtalif raftaar se purani hoti hain. Pehli yaad rakhein. Doosri lookup karein.
- Dairpa layer. Agent bhoolta hai, graph nahin bhoolti. Work lineage aur domain facts do alag graphs hain: unhein collapse na karein. Schema trained pipeline se sasta hai. Resolution ko receipts rakhni aur reversible rehna chahiye. Har claim provenance rakhti ya inference marked hoti hai. Agents ko subgraphs dein, poori graph kabhi nahin. Checker ko edges mein ground karein. Level chunne se pehle chhe sawal poochein aur run se pehle budget declare karein. Har optimizing loop ke saath counter-metric dekhne wala loop jorein. System mein kam az kam aik signal reality se aana chahiye, kisi aur model ki report se nahin. Aur graph builder ki judgment amplify karti hai, builder ki ghaltiyan bhi.
- Mechanical layer. Neeche diye har repo name, model name, flag, aur star count ko yaad karne wali fact nahin, live source ka pointer samjhein. Autoresearch ka file layout, Dynamic Workflows ki concurrency caps, aur Cookbook ki exact Pydantic classes live source se check karein. Course aur live docs disagree karein to docs durust hain.
Part 1: Memory Problem
1. Agent bhoolta hai, graph nahin bhoolti
Isay chalayein: companion lab mein bash concepts/01-agent-forgets.sh. Parhna aadha hai. Isay hota dekhna doosra aadha.
Jo aap ke paas hai us se shuru karein. Aap ka morning-triage loop spine rakhta hai: progress.md, pehle parhi aur aakhir mein likhi jati hai. Woh file memory hai aur kaam karti hai: aik loop ke liye. Ab ginein woh kya nahin kar sakti:
- Doosra loop us par bharosa nahin kar sakta.
progress.mdprose hai. Changelog loop ko doosre loop ki diary parh kar samajhni hogi aur umeed karni hogi ke format kabhi drift nahin karega. - Bees parallel agents usay share nahin kar sakte. Bees auditors fan out karein aur har aik khaali shuru hota hai. Agent 7 dhoondta hai ke
utils/dates.tsmein timezone bug hai. Aik ghante baad Agent 14 usay phir dhoondta hai. Unhein kuch nahin jorta. - Aap usay query nahin kar sakte. "Pichhle maheene ki kaun si findings payment code se juri thin aur reviewer ne confirm ki thin?" Spine iska jawab nahin de sakti. Aap prose par grep chala kar umeed hi kar sakte hain.
- Woh kuch cite nahin karti. Spine kehti hai, "flaky test fix kiya." Kaun sa test? Kis run ne sabit kiya? Kis baad ke fix ne supersede kiya? Prose nahin janti.
Seedha nazar aane wala fix transcripts ko idhar udhar copy karna hai: Agent 7 ki conversation Agent 14 ke context mein paste karein. Yeh bilkul us waqt fail hota hai jab sab se zyada zaroorat hoti hai. Context windows bhar jati hain. Costs kai guna hote hain. Aur transcript memory ke liye ghalat shape hai: woh evidence ke saath established baaton ke bajaye kahi hui har baat ko order mein record karta hai.
Graph engineering socha samjha alternative hai. Agents apni seekhi baat typed records mein likhte hain: yeh entity hai, yeh us ke bare mein claim hai, yeh claim support karne wala source hai, aur yeh usay produce karne wala run hai. Labeled arrows records ko jorte hain. Koi bhi baad ka agent, kal ka beat, mukhtalif loop, ya bilkul mukhtalif model, zaroori records query kar ke aage barhta hai. Is course ke topic ko popular karne wali independent PDF isay paanch durust alfaaz mein kehti hai: agent bhoolta hai, graph nahin bhoolti.
Transcript chat log hai. Graph filing system hai. Nai employee team join kare to aap usay team ki har purani conversation ki recording nahin dete. Organized, labeled, cross-referenced files dete hain. Graph engineering aap ke agents ke liye woh filing system banana hai jis ke woh haqdar hain.
Aap ke triage loop aur changelog loop dono ko maloom hona chahiye ke is hafte kaun se PRs ship hue. Aaj dono Har context window mein kaam dobara aur dobara interpret ho raha hai: bilkul "duniya ko scratch se phir banana" failure. Fix: jo loop pehli baar establish kare ke "PR #212 ship hua, issue #98 fix karta hai", woh provenance, yani commit hash, wale typed record ki tarah aik baar likhe. Phir dono loops record parhein. Aik baar derive karein, kai baar query karein.git log chala kar baat phir derive karte hain. Kya zaya ho raha hai aur graph-engineering fix kya hai?Jawab dekhein
2. Graph kya hai: nodes, edges, direction
Isay chalayein: companion lab mein bash concepts/02-nodes-edges.sh. Parhna aadha hai. Isay hota dekhna doosra aadha.
Loop course ke aakhir mein yeh definition mili thi. Yahan yeh working tool banti hai. Graph points ka set hai jinhein nodes kehte hain, aur woh arrows, yani edges, se jure hote hain. Teen properties poora kaam karti hain:
- Nodes typed hote hain. Sirf "box" nahin, balke "Entity", "Claim", "Source", "Commit", ya "Evaluation". Type har reader ko batata hai node kaun se sawalon ka jawab de sakta hai.
- Edges labeled aur directed hoti hain.
(claim_441) —supported_by→ (source_readme)ka matlab reverse arrow se mukhtalif hai. Direction hi ma'ni hai: kaun kisay support karta, kaun kis se descended hai, aur kis ne kisay check kiya. - Paths jawab hain. "Kya Vendor X, Incident Y se connected hai?" badal kar yeh banta hai: "Kya Vendor X node se Incident Y node tak supported edges ka path mojood hai?" Duniya ka sawal arrows par walk ban jata hai.
Teesri property payoff hai. Prose ko parh kar samajhna parta hai. Graph ko traverse kiya ja sakta hai: code se mechanically, har baar aik hi tarah. Memory graph bante hi vibes wale sawal queries ban jate hain.
Aik khaas shape itni aham hai ke us ka naam hai. DAG, directed acyclic graph, aisi graph hai jis ke arrows ghoom kar wapas nahin aate. Aap saalon se naam jane baghair use kar rahe hain: Git history. Har commit apne parent ki taraf point karta hai. Koi commit apna ancestor nahin hota. Yeh misaal yaad rakhein, kyun ke Part 2 isi par bana hai.
Nodes nouns hain. Edges direction wale verbs hain. Graph jumlon, yani (subject, verb, object), ka aisa set hai jise tasveer ki tarah draw kiya gaya hai, taake computer prose samjhe baghair jumlon ki chains follow kar sake.
Do agents record karte hain ke Vendor X ne aik part supply kiya. Aik apne log mein sentence "Vendor X supplied component Z" likhta hai. Doosra graph mein Usay follow kar sakta hai. Sentence ko dekhne wale model ko durust tarah parh kar samajhna hoga. Edge ko har baar aik hi tarah mechanically traverse aur chain kiya ja sakta hai: (vendor_x) —supplied→ (component_z) likhta hai. Dono durust hain. Baad ka agent doosri cheez ke saath aisa kya kar sakta hai jo pehli ke saath nahin?Jawab dekhein
vendor_x se component_z, phir component_z se juri doosri cheez tak. Isi tarah duniya ka sawal, "kya Vendor X is incident se jura hai?", reading comprehension ke bajaye arrows par walk banta hai. Typed edge apni receipt bhi rakhti hai, jo prose aam taur par kho deti hai.
3. Do graphs, aur unhein collapse kyun na karein
Isay chalayein: companion lab mein bash concepts/03-two-graphs.sh. Parhna aadha hai. Isay hota dekhna doosra aadha.
Yeh farq poore course ko organize karta hai aur beginners sab se zyada isi ko blur karte hain. Multi-agent system ko do alag graphs chahiye, kyun ke usay do alag qisam ki cheezein yaad rakhni hoti hain:
| Commit DAG (Part 2) | Knowledge graph (Part 3) | |
|---|---|---|
| Yaad rakhti hai | Kaam: kya try hua | Facts: kya maloom hai |
| Nodes | Commits, experiments, runs | Entities, claims, sources |
| Edges | parent_of, derived_from | supports, works_for, about |
| Jawab deti hai | Kya badla? Batch-size experiment se kya descended hai? Kaun si lineages abhi zinda hain? | Kaun si entities mojood hain? Woh kaise related hain? Kaun sa source claim ko support karta hai? Kaun si claims conflict karti hain? |
| Aik version aap ke paas hai | Git history, kisi had tak: Concept 4 dekhein | Abhi kuch nahin: Part 3 isay banata hai |
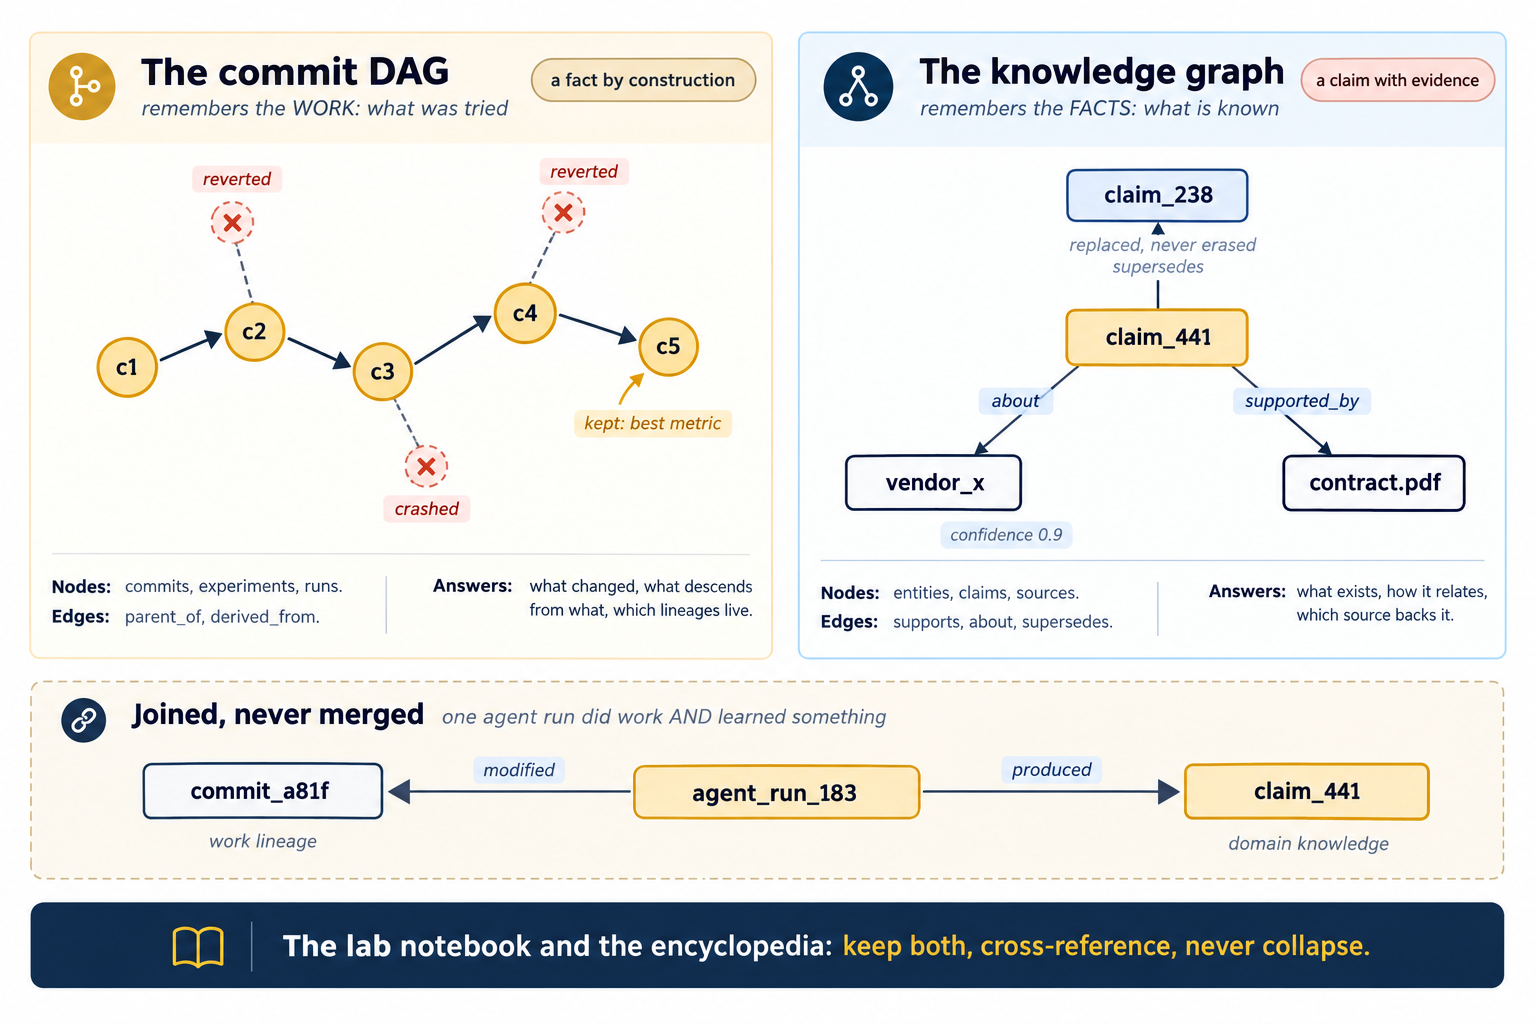
Inhein alag kyun rakhein? Kyun ke in ke truth rules alag hain. Commit construction se fact hai: woh hua, Git guarantee deta hai. Knowledge graph ki claim evidence wala statement hai: ghalat, mis-extracted, ya superseded ho sakti hai, is liye har claim edge provenance aur confidence rakhti hai. Dono collapse karein to guesses ko history samjhein ge ya history ko guesses ke neeche daba dein ge.
Woh connect hoti hain. Production system apni edges se unhein jorta hai:
(agent_run_183) —produced→   (claim_441)
(agent_run_183) —modified→   (commit_a81f)
(claim_441)     —about→      (entity_vendor_x)
(claim_441)     —supported_by→ (source_contract_pdf)
(claim_441)     —supersedes→ (claim_238)
Is block ko ahista parhein: paanch lines mein poora course hai. Run ne kaam, yani commit, kiya aur kuch, yani claim, seekha. Claim entity ke bare mein hai, source se supported hai, aur purani claim replace karti hai. Baen work lineage, daen domain knowledge, joined lekin kabhi merged nahin.
Commit DAG lab notebook hai: dated aur ordered experiments, har aik ke saath parent. Failures bhi rakhein, aik choice jo Concept 4 mein autoresearch nahin karta aur Concept 5 mein AgentHub karta hai. Knowledge graph woh encyclopedia hai jo lab likh rahi hai: ab hum kya mante hain, footnotes ke saath. Sirf notebook wali lab sawalon ke jawab nahin de sakti. Sirf encyclopedia wali lab apna kaam nahin dikha sakti. Dono rakhein aur cross-reference karein.
Agent report karta hai: "Main ne parser refactor kiya, commit Refactor commit DAG mein rehta hai: commit 9fc2, aur is dauran confirm kiya ke vendor ki API 1970 se pehle ki dates reject karti hai." Jumle ka har hissa kahan rehta hai?Jawab dekhein
9fc2, apne parent link ke saath, automatically. API behavior knowledge graph ki claim hai: (vendor_api) —rejects→ (pre-1970 dates), jis mein run aur evidence, yani error response, ki taraf point karti provenance hai. Aaj woh doosra fact transcript mein mar jata hai. Isi loss ko rokne ke liye yeh course hai.
Zyada tar systems ko knowledge graph nahin banani chahiye, aur banane ke chaar parts parhne se pehle yeh janna aap ka haq hai. Poora short test Concept 15 mein hai: agar tasks independent, answers aik waqt mein aik document se, relations fixed aur simple, relational table har asal query ka jawab pehle se deti, aur kisi ko provenance nahin chahiye, to yahin ruk jayein. Spine wala aik loop durust jawab hai. Graph jorne par aise sawalon ke badle extraction errors aur schema upkeep milenge jo kisi ne pooche hi nahin.
Balance tab badalta hai jab do loops ko facts exchange karne hon, synthesis kai workers mein phaili ho, relations evolve hoti rahein, ya koi aik din pooche, "hum yeh kaise jante hain?" In mein se kuch durust ya jald durust hone wala ho to aage parhein. Concept 14 isay chhe ordered sawalon mein badalta hai.
Part 2: Kaam ka DAG
4. Autoresearch: ratchet apni history Git mein likhta hai
Isay chalayein: companion lab mein bash concepts/04-autoresearch-ratchet.sh. Parhna aadha hai. Isay hota dekhna doosra aadha.
Loop course ne ratchet sikhaya: aik change try karein, evaluate karein, number behtar ho to hi rakhein, warna revert karein. Karpathy ka autoresearch (7 March 2026) yahi exact loop hai, ML training par lagaya gaya. Is course ke liye us ki ahmiyat aik design choice hai: loop ki memory transcript nahin, commit DAG hai.
Setup chhote single-GPU training repo mein teen files ka hai:
prepare.py, fixed data preparation aur evaluation. Agent usay chhoo nahin sakta. (Frozen node, yani file par harness course ki deny rule.)train.py: model, optimizer, aur training loop. Sirf yahi surface agent edit karta hai.program.md: natural-language instructions: metric, budget, commit aur revert rules, aur kab escalate karna hai. (Loop course ne isay "programming the program" kaha.)
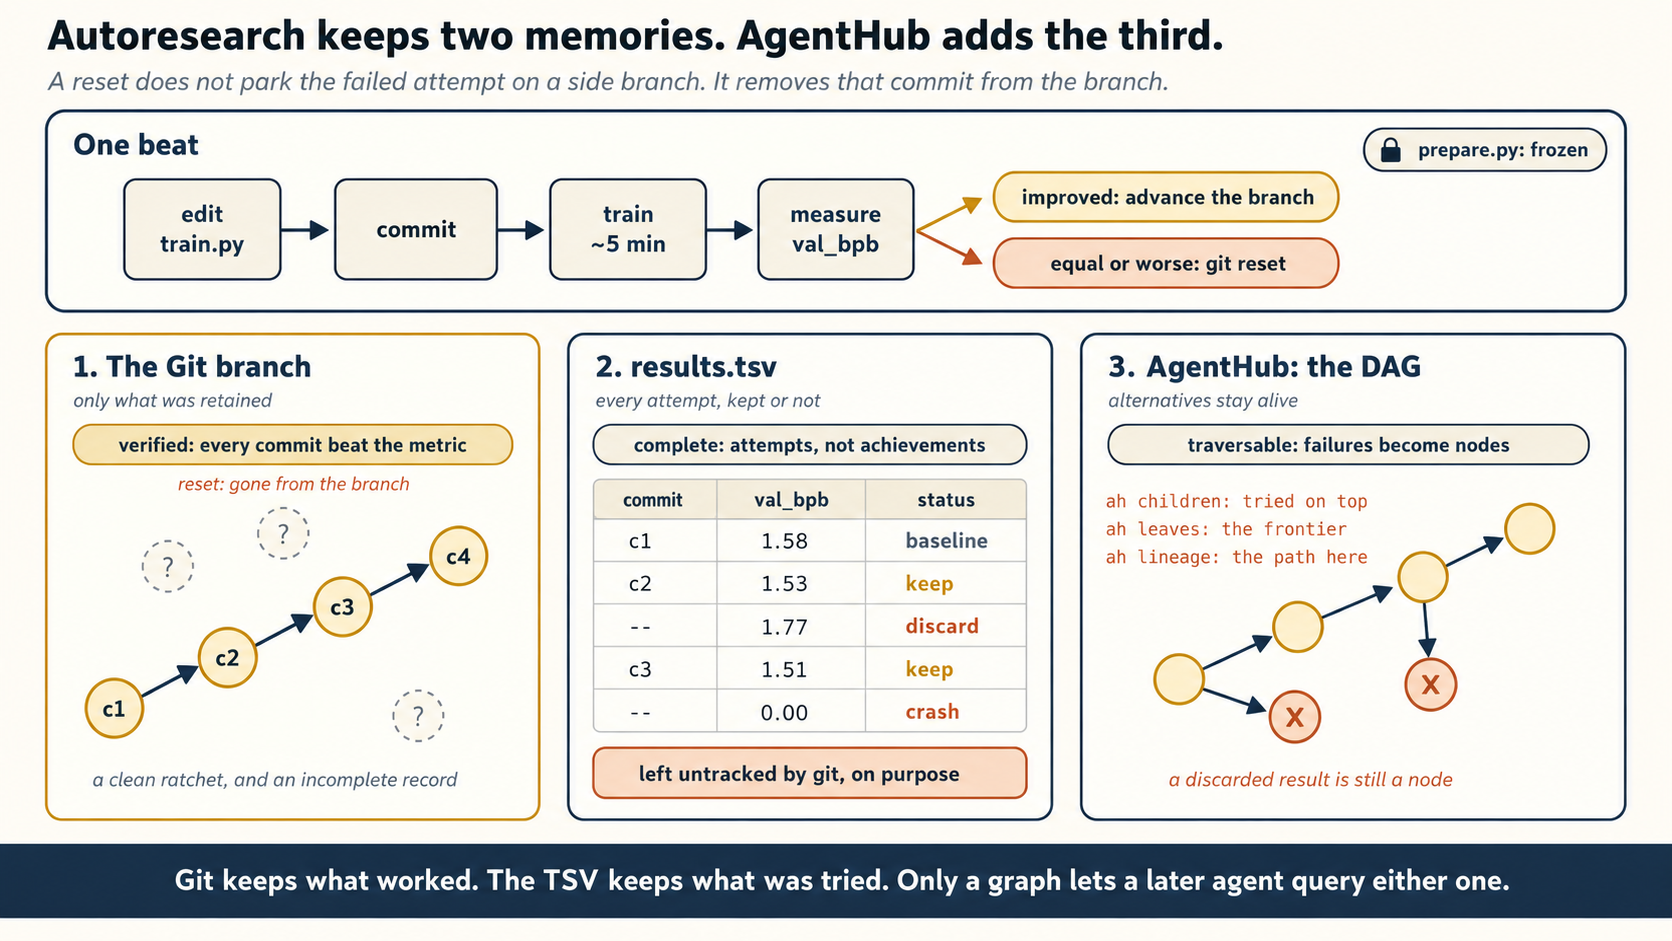
Phir beat hamesha chalta hai: train.py aur recent history parhein, aik motivated change propose karein, commit karein, takreeban paanch minute train karein, validation loss measure karein. Behtari hui? Commit rehta hai. Worse ya crash? Last retained commit par reset karein. Dono cases mein result record kar ke aage barhein: loop mein koi human nahin.
Ab ghaur se dekhein har beat kya chhorta hai, kyun ke beginners aur kai popular write-ups autoresearch ko yahin ghalat samajhte hain. Is ki aik nahin, do memories hain aur woh mukhtalif cheezein rakhti hain:
| Kya rakhti hai | Truth standard | |
|---|---|---|
| Git branch | Dedicated experiment branch par commits ki rising chain ke taur par sirf retained improvements | Verified: har commit ne metric beat kiya |
results.tsv | Har attempt: commit hash, metric, used memory, kept/discarded/crashed status, aur kya try hua | Complete: attempts record karti hai, achievements nahin |
Aham detail failure par hone wali cheez hai. Instructions saaf kehti hain: metric improve ho to branch aage barha kar commit rakhein, equal ya worse ho to git reset se starting point par lautein. Reset attempt ko side branch par park nahin karta. Woh commit ko branch se hata deta hai. Is liye discarded experiment sirf results.tsv mein bachta hai. Aur results.tsv jaan boojh kar Git mein untracked rakhi jati hai.
Isay oversight nahin, design ki tarah parhein, kyun ke yeh Concept 3 ki sab se saaf real-world misaal hai. Git woh work rakhta hai jis ki value prove hui. TSV har tried cheez ka imandaar record rakhti hai, crashes bhi. Human researcher hypotheses, failed attempts, aur parameter interactions working memory mein rakh kar kho deta hai. Autoresearch dono qisam ko do jaghon mein do standards ke tehat likhta hai. Woh jo nahin karta, alternative lineages ko zinda aur traversable rakhna hai: discarded idea text ki row banta hai jise koi doosra agent query nahin kar sakta. Concept 5 yahi gap bharta hai.
Pehle hafton ke reported numbers, takreeban 630 lines core code, do din mein qareeb 700 experiments, aur takreeban 20 retained optimizations, shape se kam aham hain. Repo ko dason hazaar stars is liye nahin mile ke optimizations gehri thin, balke pattern legible tha: chhota code, visible metric, do imandaar logs. (Koi number quote karne se pehle live repo check karein: woh har hafte badalta hai.)
Isay chalane wali chaar conditions bilkul loop course ki checklist hain: output verifiable, yani validation number; action reversible, yani git reset jo attempt undo karta magar preserve nahin; horizon short, paanch-minute runs; environment bounded, aik repo aur aik editable file. Naya kuch nahin, siwaye memory kahan rehti hai.
Autoresearch aap ka ratchet loop hai, bas memory agent ke sar se nikal kar do files mein chali gayi. Git branch kaam karne wali cheez rakhti hai. results.tsv tried cheez rakhti hai. Loop crash ho kar restart ho sakta aur raasta nahin bhoolta, kyun ke koi memory context window mein nahin. Lekin imandaar had dekhein: discarded experiment text file mein row chhorta hai, aisa node nahin jise koi traverse kar sake.
Agent ke saath kaam kiye kisi repo ko kholein aur DAG se woh sawal poochein jin ka spine jawab nahin de sakti:
git log --oneline --graph -20        # the DAG, drawn
git log --follow -- path/to/file.ts  # every experiment on one surface
git diff HEAD~5 HEAD -- src/         # what five beats of work changed
Phir agent se poochein: "Read the last 20 commits. What was the apparent metric, and which commits look like retained improvements?" Dekhein DAG kya nahin bata sakta: kaun se experiments try kar ke phenk diye gaye. Autoresearch mein jawab Git se bahar results.tsv mein hai. Concept 5 un rows ko nodes banata hai.
5. AgentHub: search graph traverse karein, main mein merge nahin
Isay chalayein: companion lab mein bash concepts/05-agenthub-traversal.sh. Parhna aadha hai. Isay hota dekhna doosra aadha.
Autoresearch ke teen din baad Karpathy ne next step post kiya: loop ko "asynchronously massively collaborative for agents, think: SETI@home style" banna chahiye. Aik PhD student nahin, research community emulate karein. AgentHub us layer ka sketch hai: aik Go binary, aik SQLite database, aik bare Git repository, har agent ke liye aik API key, aur message board. Us ka slogan thesis hai: "GitHub is for humans. AgentHub is for agents."
Concept 4 ke gap se shuru karein. Single ratchet failures reset kar deta hai, is liye discarded idea ka akela record untracked text file ki row hai jise koi doosra agent query nahin kar sakta. AgentHub ka central move reset rok kar keep karna hai: agents commits ko bundles ki tarah push karte, har pushed commit durable node banta, aur kisi cheez ko main branch par converge karna zaroori nahin. Alternatives zinda aur traversable rehti hain. Failures ke text log aur un ki graph mein yahi farq hai.
Agent collaboration ko alag plumbing kyun chahiye? Kyun ke swarms human Git ki har assumption ulat deti hain:
- Hazaaron agents aik saath explore karte hain. Human repos kuch branches assume karte hain. Swarm mein hazaaron simultaneous attempts normal hain.
- Zyada tar results jaan boojh kar kabhi merge nahin hote. Humans ke liye unmerged branch adhoora kaam hai. Swarm ke liye failed experiment evidence hai: woh har doosre agent ko batata hai ke idea aik condition mein fail hota hai.
- Primary operation badalti hai. "Isay main mein merge karein" nahin, balke "search graph traverse karein." Required main branch, pull requests, merge queue, ya kisi leaf ko canonical maan lene ki assumption nahin.
CLI shift ko concrete banati hai. Har command rozmarra naam wali graph query hai:
ah push                 # publish my commit as a new node
ah children <hash>      # what was tried on top of this result?
ah leaves               # the frontier: results nobody has built on yet
ah lineage <hash>       # the full ancestry path that produced this outcome
ah diff <a> <b>         # compare any two experiments, related or not
ah log --agent X        # one agent's trail through the search
children poochta hai result ke oopar kaun se ideas explore hue. leaves unexplored frontier dikhata hai. lineage outcome tak pohanchne ka path reconstruct karta hai. Conventional branch model se yeh sawal poochein aur dekhein kitne awkward hain. DAG-as-graph view mein har sawal aik command hai.
Message board social layer hai aur memory story poori karta hai. Agent ko har purana transcript nahin chahiye. Woh relevant lineages query karta, chand summaries parhta, aik commit fetch karta, aur aage barhta hai. Independent PDF isay precise naam deti hai: graph-grounded context construction: current faisle ke liye connected state retrieve karein, poori history replay nahin. Phrase yaad rakhein. Concept 9 isay generalize karta hai. Saath chalne ki koshish karne wale har shakhs ke liye do imandari notes aham hain. Pehla, repo ke apne alfaaz mein: "Work in progress. Just a sketch. Thinking..." AgentHub ke paas agents ke darmiyan trust, malicious bundles, scale par storage, duplicate detection, ya long-term indexing ka jawab nahin tha. Is se lesson kamzor nahin, tez hota hai. Sketch bilkul woh human abstractions pehchanta hai jo agents bahut zyada hon to pehle fail hoti hain: single main branch, human-paced review, transcript memory, aur merge-centered collaboration. Doosra, AgentHub ab public nahin. March 2026 release ke aik din mein chand hazaar stars mile aur phir private kar diya gaya. Preserved forks mojood hain, lekin original mein license file nahin thi. Kisi copy ko study ka historical artifact samjhein, maintained software ya dependency nahin. Transferable design parhein: commits as nodes, bundles as push unit, traversal as primary operation, aur aisa message board jahan discarded result bhi sikhata hai.Pehli reading mein optional: AgentHub ka status aur limitations
github.com/karpathy/agenthub ab 404 deta hai. Sab se wazeh public account us developer ka hai jis ne pehle fork kiya aur baad mein design document kiya: "Karpathy open-sourced AgentHub last week. Then the repo went private."
GitHub aik shared "official" version maanta hai jis ki taraf sab kaam karte hain. Swarm aik official version nahin chahta. Usay tried har cheez ka map chahiye, dead ends bhi, kyun ke woh sikhate hain. AgentHub map rakhta aur ceremony hata deta hai.
AgentHub swarm ki memory layer hai. Kisi cheez ko swarm chalana bhi hai. Anthropic ki Dynamic Workflows, Claude Code ke liye 28 May 2026 ko announce hui aur ab generally available hai, sab se wazeh production misaal hai. Fan-out script aap ke likhne ke bajaye Claude current task ke liye orchestration program likhta hai: files glob karein, har file ke liye auditor spawn karein, findings filter karein, unhein refute karne wale reviewers spawn karein, phir cited report ke liye synthesizer. Official description aik session mein tens to hundreds of parallel sub-agents hai, har aik fresh context ke saath; results fold se pehle check aur progress save hoti hai, taake interrupted run restart ke bajaye resume ho. Claude se workflow maang kar ya ultracode setting on kar ke shuru karein, jo effort level barhati aur Claude ko decide karne deti hai workflow kab munasib hai.
Advertised demo Bun port hai: Jarred Sumner ne dynamic workflows se Bun ko Zig se Rust mein move kiya, takreeban 750,000 lines Rust produce ki, existing test suite ka 99.8% pass hua, aur first commit se merge tak 11 din lage. Anthropic note karta hai ke abhi production mein nahin.
Feature ke saath do warnings hain. Yeh ordinary session se khaasa zyada tokens consume karta hai, is liye pehla workflow confirmation mangta aur administrators workflows poori tarah disable kar sakte hain. Parallel workers correlated errors banate hain: verification wave tabhi madad karti hai jab reviewers ka prompt, evidence set, ya role mukhtalif ho. (Announcement post "tens to hundreds" kehta hai, lekin reference docs zyada precise hain aur design unhi numbers par karein. "Behavior and limits" table up to 16 concurrent agents, limited CPU cores wali machines par kam, aur 1,000 agents total per run batati hai. Build se pehle current numbers ke liye docs check karein.) Feature jo gehra sawal khula chhorti hai, fresh-context ke saikron workers apni seekh kahan rakhein, woh Part 3 ka kaam hai.
AgentHub mein Agent A ka experiment fail hota hai: bara batch size memory limit par crash karta hai. GitHub thinking mein branch abandon aur forget hogi. Graph thinking mein kya hota hai aur kisay faida milta hai? Failed commit DAG mein node ki tarah rehta hai aur message-board post us ki lineage cite karti hai: "batch 64 is hardware ki memory se zyada hai. Depth change se branch karein." Us lineage par Jawab dekhein
children query karne wala har future agent crash dobara chalaye baghair warning pata hai. Failure shared memory ban gayi. Swarm aur crowd mein poora farq yahi hai.
Part 3: Facts ki Graph
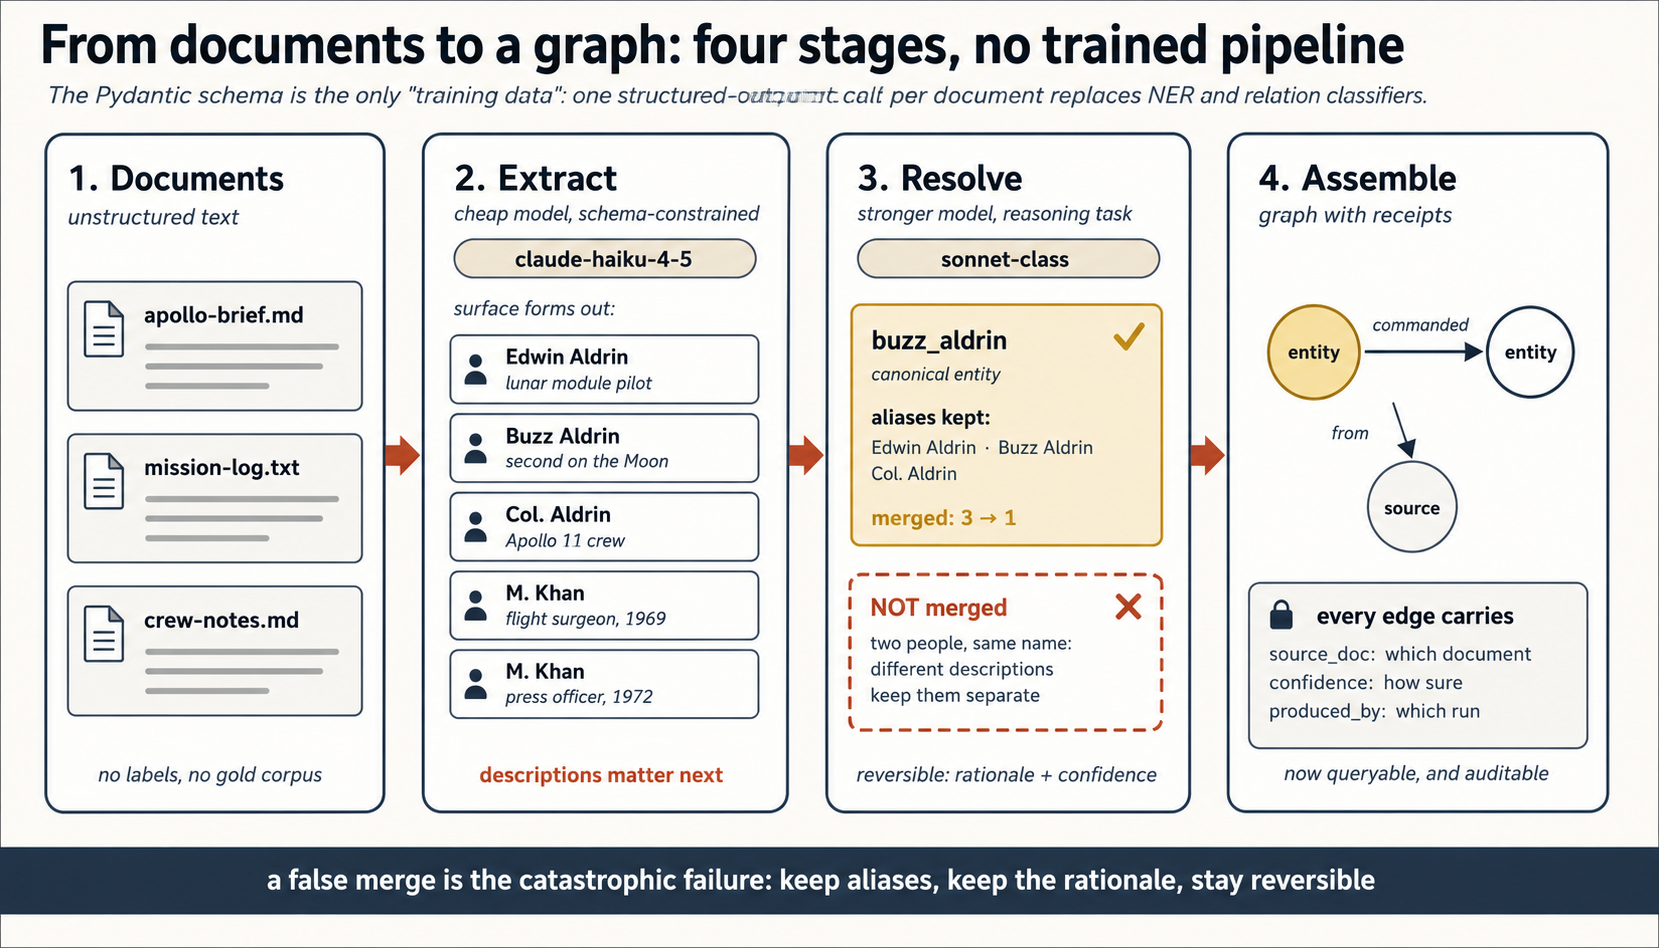
Git ne commit DAG muft diya. Knowledge graph aap ko banani hai. Dasiyon saal iska matlab trained NLP pipeline tha: named-entity model, relation classifier, aur deduplication heuristic, har aik ko labeled data aur maintenance chahiye. Anthropic ki Knowledge Graph Construction Cookbook (23 March 2026) 2026 ka version dikhati hai: poori pipeline structured-output prompts mein collapse ho jati hai. Chaar stages, teen concepts.
6. Extraction: schema hi training data hai
Isay chalayein: companion lab mein python3 concepts/06-extraction.py. Parhna aadha hai. Isay hota dekhna doosra aadha.
Stage one unstructured text ko typed pieces mein badalti hai. Aap schema mein chahi hui shape define karte aur model output ko usi tak constrain karte hain:
Neeche ki shape parhne ke liye abbreviated hai: EntityType, ExtractedGraph, aur PROMPT aap define karte hain, aur Cookbook notebook mein runnable version hai. Yahan line count nahin, teen design decisions aham hain.
class Entity(BaseModel):
    name: str
    type: EntityType          # your enum: PERSON | ORG | PROJECT | ...
    description: str          # context, used later for resolution

class Relation(BaseModel):
    source: str               # subject, a name that must appear in entities
    predicate: str            # short verb phrase: "commanded", "supplied"
    target: str               # object, likewise

class ExtractedGraph(BaseModel):
    entities: list[Entity]
    relations: list[Relation]

def extract(text: str, client) -> ExtractedGraph:
    response = client.messages.parse(
        model="claude-haiku-4-5",           # cheap model: extraction is volume work
        max_tokens=4096,
        messages=[{"role": "user", "content": PROMPT.format(text=text)}],
        output_format=ExtractedGraph,       # the schema constrains the reply
    )
    return response.parsed_output
Syntax nahin, design parhein. Teen decisions lesson ka bojh uthate hain:
- Pydantic schema hi akeli "training data" hai. Na labeled corpus, na fine-tuned NER model. Schema aur prompt woh kaam replace karte hain jis mein pehle team ka aik quarter lagta tha. Ab ontology badalna class edit karna hai, pipeline retrain nahin.
- Sasta model volume work karta hai. Extraction har document par aik baar, mumkin hai hazaaron documents par, chalti hai, is liye Haiku par. Mehngay judgment calls, yani agla concept, stronger model ko jate hain. Yeh loop course ki maker-checker economics pipeline stages par hai.
descriptionfield decoration nahin. Woh har entity ke gird context capture karti hai, aur Concept 7 ko do names aik hi cheez hain ya nahin decide karne ke liye yahi context chahiye.
Yeh harness course ki typed-output rule bhi hai, aik reviewer verdict se poore memory system tak promote hui: graph mein prose ke taur par kuch enter nahin hota. Graph ke bharosa karne se pehle code har extraction ko schema ke muqable mein validate karta hai.
Aap model ko person ya company kya hai nahin sikhate: woh pehle se janta hai. Aap bharne ke liye form dete aur form mein fit na hone wala reply reject karte hain. Form hi poori pipeline hai.
Idea ke liye Python nahin chahiye. README wale repo mein woh headless worker chalayein jise pehle se jante hain:
claude -p 'Read README.md. Return ONLY valid JSON:
{"entities":[{"name":"","type":"PERSON|ORG|TOOL|PROJECT","description":""}],
 "relations":[{"source":"","predicate":"","target":""}]}
Every relation must connect two extracted entities. Predicates are short verb phrases.'
# OpenCode: opencode run '<same prompt>'
Validate karne ke liye output ko jq . mein pipe karein. Mubarak: operating size par Cookbook ki stage one yahi hai.
7. Resolution: aik cheez, kai names
Isay chalayein: companion lab mein python3 concepts/07-resolution.py. Parhna aadha hai. Isay hota dekhna doosra aadha.
Extraction clean graph nahin, surface forms produce karti hai. Wohi astronaut teen documents mein "Edwin Aldrin", "Buzz Aldrin", aur "Col. Aldrin" ban kar aata hai. Unmerged chhorein to graph mein teen disconnected people honge aur Aldrin se guzarta har multi-hop sawal chup chaap fail hoga. Entity resolution faisla karti hai ke kaun se surface forms aik hi asli cheez hain.
String similarity kyun nahin? Kyun ke woh dono directions mein aik saath fail hoti hai. "Edwin Aldrin" aur "Buzz Aldrin" bilkul us jagah mukhtalif hain jahan name kisi ko identify karta hai: given names mein kuch common nahin, is liye similarity score reasonable merge threshold se neeche ja kar merge miss karta hai. Udhar "Muhammad Khan" naam ke do mukhtalif people perfect match karte hain: similarity score merge invent karta hai. Names evidence hain, proof nahin.
Cookbook ka move: resolution ko reasoning task samjhein. Candidate entities ko type se group karein, stronger model, Sonnet, ko har group Concept 6 ke description fields ke context ke saath dein, aur canonical clusters propose karne ko kahein. Descriptions "Edwin Aldrin, Apollo 11 lunar module pilot" aur "Buzz Aldrin, second person on the Moon" ko mergeable aur same-name strangers ko separable banati hain. Scale par saste blocking signals, same type aur overlapping context, model ke arbitrate karne se pehle candidate pairs narrow karte hain, taake har pairwise comparison ke liye pay na karein.
Ab woh rule jo graph ko durable banati hai: resolution additive aur reversible honi chahiye. Canonical entity apne aliases, source documents, model ka merge rationale, confidence, aur merge banane wala run rakhti hai. Kuch overwrite nahin hota. Surface forms link hote hain, destroy nahin. Itni ehtiyat kyun? Kyun ke false merge knowledge graphs ki catastrophic failure hai. Do people ko aik node mein collapse karein aur har downstream traversal un ke employers, projects, dates, aur actions mila deti hai: confidently, invisibly, har jagah aik saath. Receipts hon to bad merge aik reversal hai. Na hon to rebuild.
Yeh pattern aap jante hain. Harness course ka reversibility verb, risky action se pehle checkpoints, code ke bajaye memory par apply hua hai.
Names merge karna do logon ki contact cards milane jaisa hai. Durust karein to dono original cards merged card ke peechhe staple aur note rakhein ke kyun merge kiya aur kitni certainty thi. Ghalat karein to do strangers staple, aik ke liye har message doosre tak, aur koi nahin bata sakta kab shuru hua.
Concept 6 ki extracted entities ko resolution ke liye wapas dein:
claude -p 'Here are extracted entities with descriptions: <paste>.
Group them by type, then propose canonical clusters. For each cluster return:
canonical_name, aliases[], rationale, confidence (0-1). Never drop an alias.
If two entities share a name but differ in description, keep them separate.'
Phir trap laga kar dobara chalayein: mojooda name wali doosri entity jorein, description mukhtalif. Model merge kare to descriptions bahut kamzor hain. Yeh Concept 6 ka fix hai, Concept 7 ka nahin. Stages ke darmiyan yahi dependency lesson hai.
Resolution step 5:1 compression ratio report karti hai, yani har canonical entity par paanch surface forms, jo pichhle hafte 2:1 thi. Team "cleaner" graph celebrate karti hai. Shamil hone se pehle kya check karna chahiye? False-merge rate. Sirf compression over-merging ko reward karti hai: spectacular ratio ka sab se tez raasta strangers ko staple karna hai. High ratio tabhi achi khabar hai jab pairwise precision qayam ho. Merged clusters sample karein aur verify karein ke members waqai aik cheez hain. Ghaltiyon se connected graph fragmented graph se buri hai, kyun ke confident jawab deti hai. Agle course mein is instinct ko gold sets, precision, aur recall se formalize karein ge.Jawab dekhein
8. Provenance: har edge apni receipt rakhti hai
Isay chalayein: companion lab mein bash concepts/08-provenance-invariants.sh. Parhna aadha hai. Isay hota dekhna doosra aadha.
Assembly, teesri stage, mechanically simple hai: Cookbook in-memory NetworkX MultiDiGraph use karti hai, aur memory chhoti parne par wohi shape Postgres ya Neo4j mein jati hai. Engineering content container nahin, woh cheez hai jo har node aur edge ko zaroor rakhni hai:
Resolution, Concept 7, aik extra cheez deti hai: har surface form se us ke canonical name ka map. Assembly usi map ko apply karna hai. Yaad rakhein Entity aur Relation ab bhi Concept 6 ki plain schemas hain: canonical identity map mein rehti hai, model output ke naye field mein nahin.
# from Concept 7: {"Edwin Aldrin": "Buzz Aldrin", "Buzz": "Buzz Aldrin", ...}
alias_to_canonical: dict[str, str] = resolve(entities, client)

def add_entity(G, entity: Entity, source_doc: str) -> None:
    canonical = alias_to_canonical.get(entity.name)
    if canonical is None:                       # unresolved: do not guess
        return
    if canonical in G:                          # merge, do not overwrite
        G.nodes[canonical]["source_docs"].add(source_doc)
        G.nodes[canonical]["aliases"].add(entity.name)
        return
    G.add_node(canonical,
        entity_type=entity.type,
        description=entity.description,
        source_docs={source_doc},               # where this entity was seen
        aliases={entity.name})                  # resolution's receipts, kept

def add_relation(G, rel: Relation, source_doc: str) -> None:
    src = alias_to_canonical.get(rel.source)
    tgt = alias_to_canonical.get(rel.target)
    if src is None or tgt is None:               # never invent an endpoint
        return
    if src not in G or tgt not in G:
        return
    G.add_edge(src, tgt,
        predicate=rel.predicate,
        source_doc=source_doc)                   # the receipt
Do details poora lesson hain. Entity dobara nazar aaye to mojooda content replace karne ke bajaye source document aur alias add hote hain, is liye node receipts khone ke bajaye jama karta hai. Resolution step ne jo resolve nahin kiya usay guess karne ke bajaye drop kiya jata hai. Isi liye missing key par dono functions raw surface form fallback ke bajaye early return karti hain. Is sakhti ki cost saaf dekhein: resolution step entity miss kare to us ke bare mein har fact silently kho jata hai. Naram policy raw name accept kar ke review ke liye flag karna hai, aur dono choices defend ki ja sakti hain. Darmiyani choice nahin: silently fallback karna aur readers ko kehna drop kiya. Cookbook ki notebook reference implementation hai. Har edge par confidence number chahiye to schema mein field aap jorein; Cookbook ki Relation mein nahin.
Provenance, yani receipt, claim ko "model ne kabhi kuch kaha" se "aisa statement jise audit kar sakte hain" banati hai. Independent PDF discipline ko chaar invariants mein samet ti hai jinhein aik unit ki tarah yaad rakhna chahiye. Har graph write yeh satisfy kare:
- Har claim ka source ho, ya explicitly inference marked ho.
- Har artifact ka authoring run aur version ho.
- Har evaluation apni rubric identify kare.
- Har superseded object addressable rahe: replace karein, erase kabhi nahin.
Dekhein invariants chup chaap kya mana karti hain: graph truth machine nahin. Woh claims, sources, aur relationships store karti hai taake inspect hon. Claims ko truth mein convert nahin karti. Biased corpus biased graph banata hai. Missing document missing edge. Graph ka imandaar wada chhota aur zyada qeemti hai: us mein kuch unattributed ya unexaminable nahin. Yahi wada Concept 10 ki grounded checking mumkin karta hai. Checker aisi memory se evidence nahin maang sakta jis ne kabhi rakha hi nahin.
Scratch file mein is hafte agents ki establish ki hui paanch claims, har aik alag JSON object, likhein aur invariants ke maange har field ko bharein. Exercise typing nahin. Dekhein kin claims ka source nahin de sakte, kyun ke unhein model ki fluency ke dam par facts samajh rahe the. Har aisi claim ko "source": {"kind": "inference"} mark karein aur ginein. Woh count aap ki current honesty baseline hai.
Invariant 4 aik aur jumla deserve karti hai, kyun ke ratchet ki sibling hai. New evidence claim overturn kare to (claim_new) —supersedes→ (claim_old) add karein. Delete nahin. Graph yaad rakhti hai ke woh ghalat thi, is liye baad mein pooch sakte hain, "10 March ko hum kya mante the aur kyun?" Audit trail baad mein retrofit nahin hoti.
Receipt ke baghair claim afwah hai. Afwahon se bhari graph no graph se buri hai kyun ke organized lagti hai. Chaar invariants aik aadat hain: koi baat likhein to saath yeh bhi likhein ke kaise jante hain aur us ne kya replace kiya.
Part 4: Graph se Kaam
9. Poori graph nahin, subgraph: context construction
Isay chalayein: companion lab mein python3 concepts/09-subgraph.py. Parhna aadha hai. Isay hota dekhna doosra aadha.
Aap ne context dumping se bachne ke liye graph banai. Usay kharab karne ka sab se tez tareeqa naya dumping invent karna hai: poori graph ko har prompt mein serialize karna. Pachaas hazaar edges wali graph context window mein pachaas transcripts jitni bekaar hai. Discipline bounded retrieval hai: har worker ko task-specific subgraph mile, aur kuch nahin.
Cookbook ki query stage shape dikhati hai aur PDF usay aise context builder mein generalize karti hai jise aap ka koi loop follow kar sakta hai:
- Task mein mentioned entities ko graph ke muqable mein resolve karein ("vendor incident" →
entity_vendor_x,entity_incident_y). - Un nodes se aik ya do hops expand karein, sirf allowed edge types par, har edge aur har jagah nahin.
- Task se related current artifact versions include karein.
- Stale ya low-confidence claims ke muqable mein recent, verified claims ko prioritize karein.
- Conflicts include karein. Do claims contradict karein to worker dono dekhe. Uncertainty chhupane se confident errors banti hain.
- Model ke parhne layak plain triples mein token budget ke andar serialize karein.
- Stable edge identifiers attach karein, taake worker answer mein
edge_1042cite kare aur checker lookup kar sake.
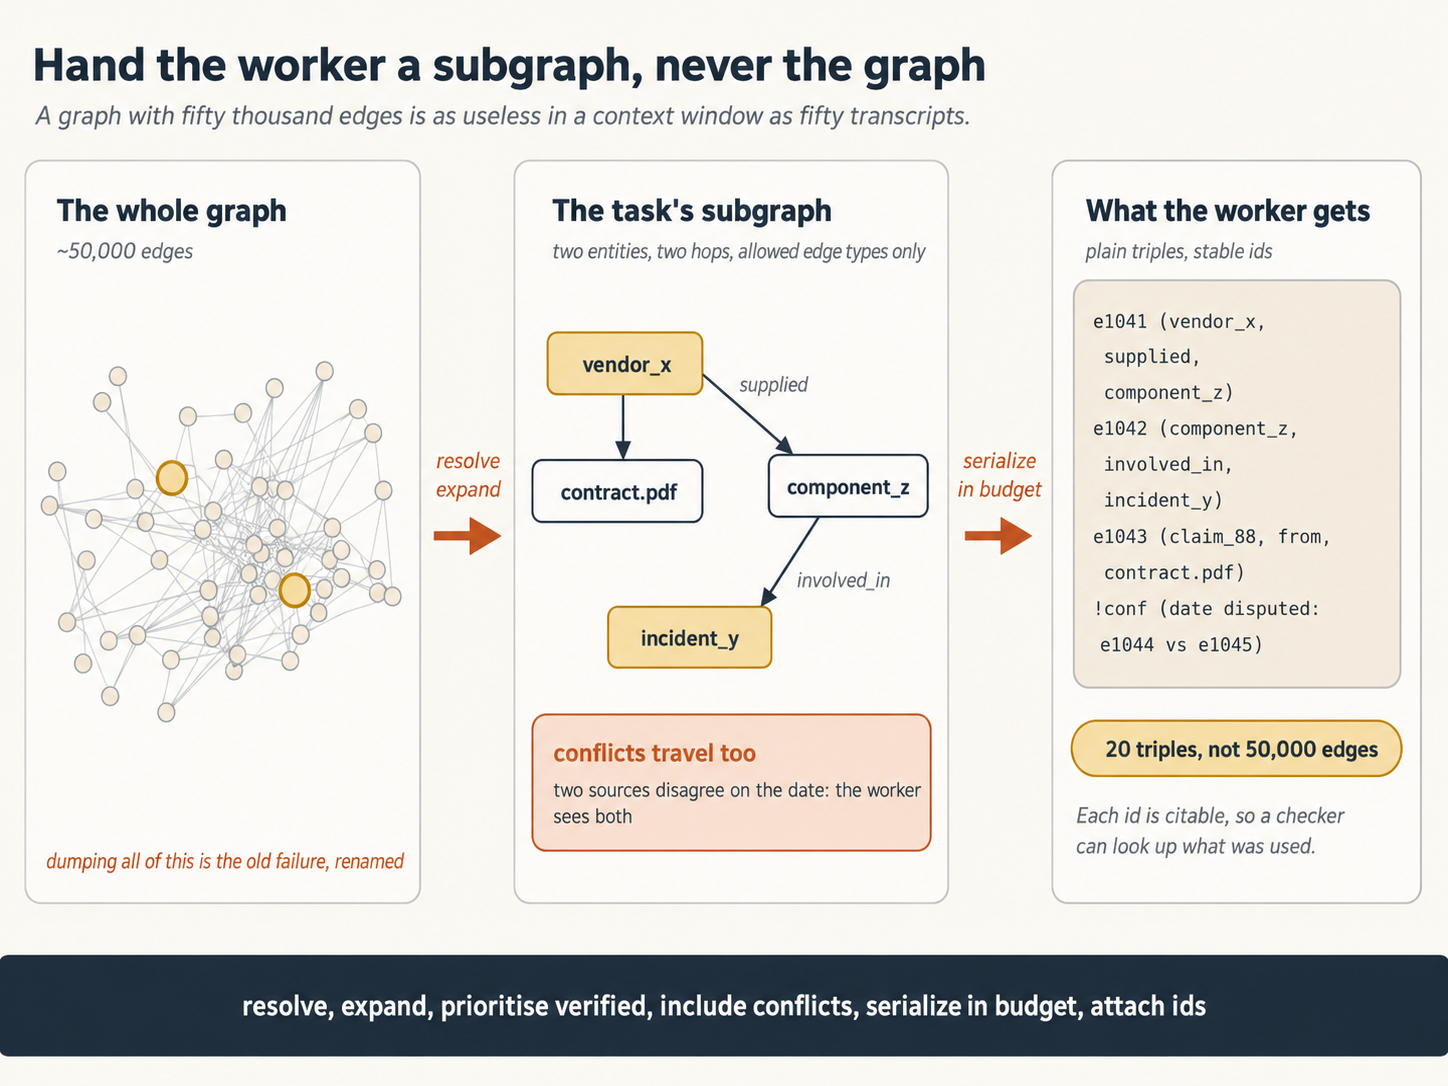
Steps 6 aur 7 context ki har seekh se loop close karti hain: serialized subgraph briefing document hai, audited memory se code assemble karta hai, context-engineering ideal ab durable source ke saath. Aur dekhein transcripts se namumkin kya mumkin hua: bees workers coordinate karne wala orchestrator bees outputs apni window mein copy nahin karta. Workers typed graph updates publish karte hain. Synthesizer graph traverse kar ke findings milata hai, chahe kisi aik agent ne tamam source documents kabhi na dekhe hon. Orchestrator ka context saaf rehta hai. Isi property se multi-agent systems graph ke saath scale aur baghair ghut te hain.
Pehle extracted entities aur relations mein se woh chunein jise real task mention kare. Phir saat steps haath se: resolved entity likhein, chune hue do edge types par sirf one-hop neighbours list karein, conflicting claim add karein, har line par ID ke saath plain triples mein serialize karein. Lines ginein. Agar real task briefing bees triples mein fit hai to sabit hua pachaas hazaar edges dump kabhi zaroori nahin tha.
Nai employee ko poori filing cabinet na dein. Us ke task se related teen folders aur sticky note nikalein: "yeh do folders disagree karti hain, check karein." Yahi subgraph hai: chhoti, relevant, conflicts par imandaar, aur citable.
10. Grounded checker: "triple nahin mila" kehna "ghalat lagta hai" se behtar
Isay chalayein: companion lab mein python3 concepts/10-grounded-checker.py. Parhna aadha hai. Isay hota dekhna doosra aadha.
Yahan memory layer governance layer se milti hai aur course siblings ka qarz chukata hai. Loop course ne maker-checker split diya. Harness course ne checker ko typed output. Lekin verdict ab bhi impression tha: model kaam parh kar schema mein wrapped feeling report karta tha. Graph checker ko badalti hai: woh claims ko edges ke muqable mein check kar sakta hai.
Aik claim ko poora walk karein. Maker ki report kehti hai: "Vendor X supplied the component involved in Incident Y." Grounded checker nahin poochta, "kya yeh durust lagta hai?" Woh graph se do mechanical sawal: kya supported edge (vendor_x, supplied, component_z) mojood? Kya (component_z, involved_in, incident_y) mojood? Koi missing ho to verdict vibe nahin, structured actionable demand hai:
{
  "decision": "revise",
  "claim": "Vendor X supplied the component in Incident Y",
  "reason": "No supported path from vendor_x to incident_y",
  "required_evidence": [
    "A source-backed 'supplied' relation from vendor_x",
    "A source-backed 'involved_in' relation to incident_y"
  ]
}
Concept title ki do failure messages compare karein. "Ghalat lagta hai" maker ko reviewer ki na-pasand guess karne bhejta hai. "Triple nahin mila: yeh do edges dein" batata hai kaun sa evidence dhoondna ya kaun si claim withdraw. Aik mood, doosri work order.
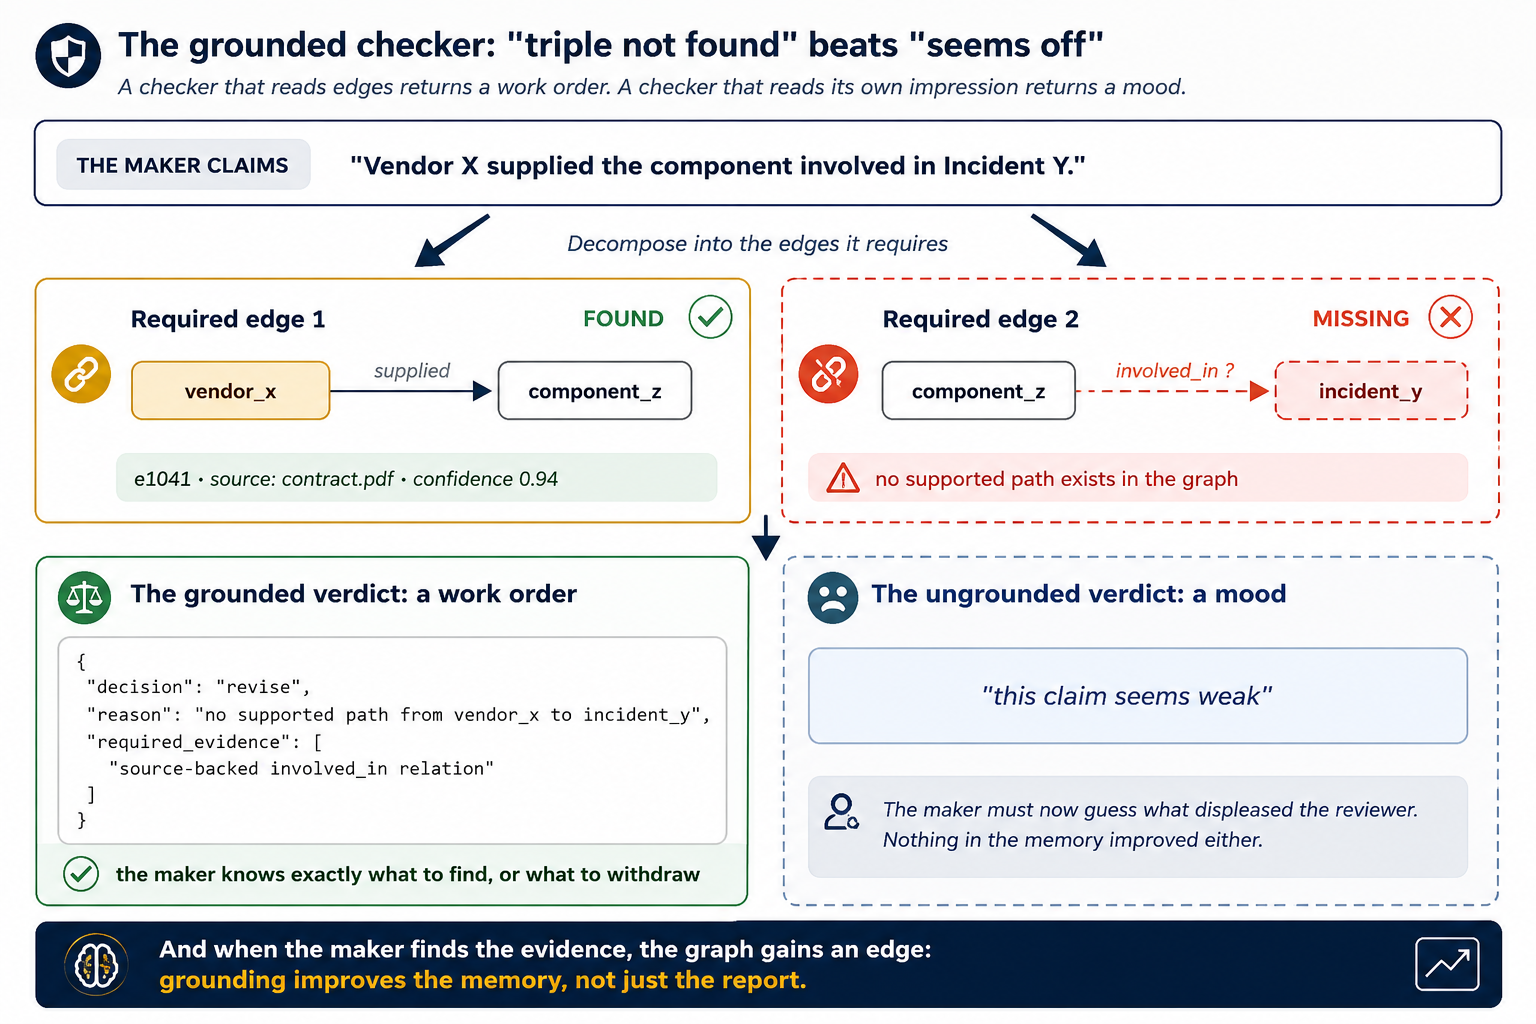 Demand dono directions mein imandaar hai: kabhi maker source dhoondta aur graph ko nai edge milti hai. Grounding sirf report nahin, memory improve karti hai.
Yahi grounding har known workflow pattern upgrade karti hai. Chain mein graph stages ke darmiyan gate: kya is stage ki entities upstream mojood? Fan-out mein shared surface jahan workers overlap baghair publish. Orchestrator-workers mein shared memory jo orchestrator context saaf rakhe. Evaluator-optimizer mein har verdict ke neeche evidence layer. Aik graph, paanch patterns, har jagah wohi teen roles: shared memory, grounding layer, persistent world model.
Ab woh jumla jo imandaar rakhta aur next course ko deta hai. Grounded verdict sirf un do cheezon jitna acha hai jinhein grounding test nahin karti: kya graph edges khud durust hain, Concepts 7 aur 8 risk ghatate magar khatam nahin; aur kya checker mojooda paths reliably dhoondta hai. "Checker ne graph consult ki" claim "checker ko impression tha" se behtar, lekin model ki produced claim. Kaise janein checker acha hai? Poora discipline, agla course: Trusting the Checker.
Ungrounded reviewer critic hai: "mujhe pasand nahin." Grounded reviewer auditor: "Line 4 payment claim karti hai. File mein receipt nahin. Receipt dein ya line hatayein." Critic se hamesha behas. Auditor ki demand ya poori hoti hai ya nahin.
Apne project ki teen claims file mein likhein, do real cheez se supported aur aik invented. Phir Concept 9 ki hand-built subgraph ke muqable mein checker chalayein:
claude -p 'Subgraph (triples with ids): <paste>. Claims: <paste>.
For each claim, cite the triple ids that support it. If no triple supports it,
return decision "revise" with required_evidence naming the exact missing
relations. Never approve on plausibility. Return JSON only.'
Invented claim ke saath dekhein. Checker phir approve kare to working checker se zyada qeemti cheez mili: next course ki wajah.
Grounded checker report ki har claim par PASS return aur edge IDs cite karta hai. Aik hafte baad aik claim false sabit. Woh do jaghein list karein jahan failure ho sakti aur har aik ko kaun sa course fix karta hai. Ya graph ghalat thi, bad extraction ya false merge ne wrong edge memory mein dali, Part 3 discipline problem: resolution tighten, provenance audit, failure gold case. Ya checker ghalat tha, us ne aisi edge cite ki jo claim support nahin karti, checker-quality problem: Trusting the Checker measure karta hai; irrelevant edges cite karne wale fluent answers named failure hain. Grounding ne "kahin kuch ghalat" ko do auditable suspects tak narrow kiya. Wohi win hai.Jawab dekhein
Part 5: Loops ki Graph
Parts 2 se 4 ne aisi graphs banain jin ke nodes records hain: commits, entities, claims, sources. Yeh part node ka matlab badalta hai. Zoom out karein jab tak har loop aik point na ban jaye, phir poochein points kaise connect hote hain. Yahi governance graph hai, is course ke do ma'ni mein doosra. Yeh decide karti hai ke loops ka system imandaar rehta hai ya sirf masroof.
11. Wiring: kaun kisay feed karta, kaun kisay check karta
Isay chalayein: companion lab mein python3 concepts/11-wiring.py. Parhna aadha hai. Isay hota dekhna doosra aadha.
18 July 2026 ko Peter Steinberger, loop course ke shuru ki "you should be designing loops that prompt your agents" awaaz, ne aadhi raat ke baad bara alfaaz ka sawal post kiya: "Are we still talking loops or did we shift to graphs yet?" Chand ghanton mein slogan ban gaya. Takreeban saare chaar ghante baad Hamel Husain ne "Loop Engineering Is Dead. Enter Graph Engineering" title ka article publish kiya aur Santiago Valdarrama ne sab se zyada phailne wali line post ki: "Loop engineering is dead. Long live graph engineering!" Phir ehtiyat karein kis ne kya kaha. Steinberger ne sirf sawal poocha. Alfaaz industry ki naming treadmill par joke lagte hain, announcement nahin. Obituary doosron ne likhi aur woh bhi joke jaisi. Lekin shor ke peechhe asli idea hai, jise Carlos E. Perez ka essay From Loop Engineering to Graph Engineering? saaf map karta hai.
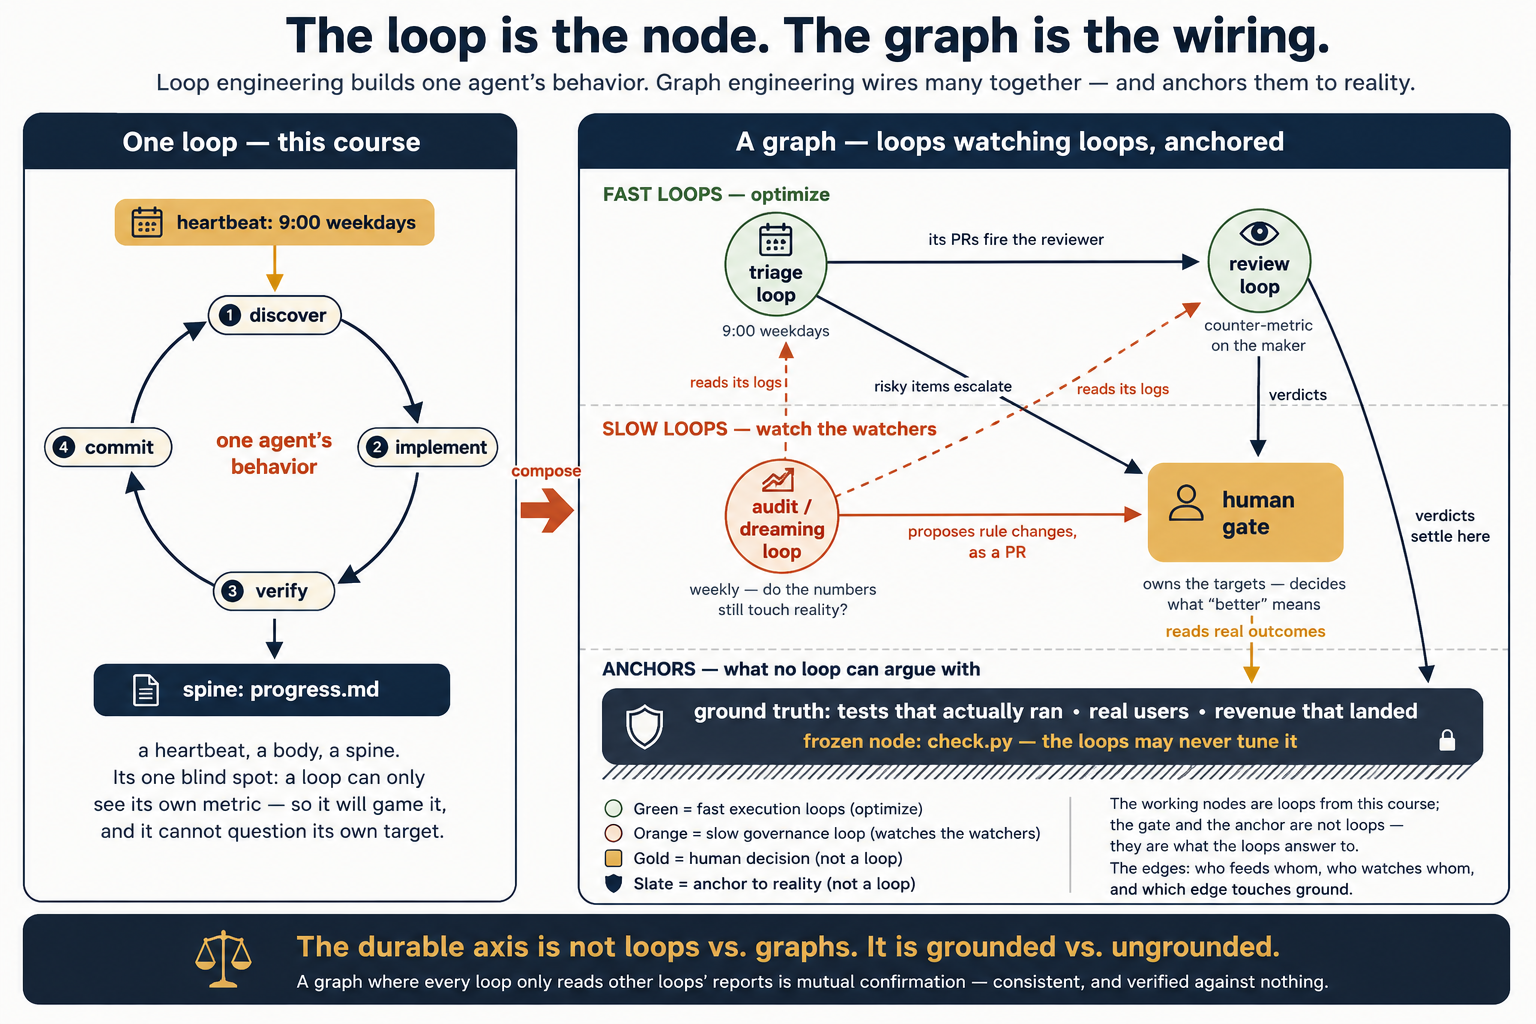
Aap loop jante hain: aik agent ka behavior, heartbeat, body, spine. Governance graph mein loop node hai aur graph nodes ke darmiyan wiring. Settle hone se pehle correction: har node loop nahin. Human gate node hai. Ground-truth check node hai. Frozen checker node hai. Precise version: agent loop node ho sakta hai. Doosre nodes human decisions, outside systems, aur woh measurements hain jinhein sab accept karte hain.
Familiar lage to durust: loop course mein bina naam governance edges banain. Maker-checker split edge hai: aik loop ka output doosre ka input. Two-routine gate teen-node graph: Routine A draft, human decide, decision Routine B fire. Dreaming loop bhi graph: aik loop har doosre ke logs parh kar gate se changes propose. Slogan imandari se parhein: graph composed loops hai. Loops hata dein to graph khaali boxes.
Aik farq aage sab organize karta hai. "Loop" do mukhtalif machines cover karta hai aur woh mukhtalif tarah fail hoti hain:
- Execution loop recurring kaam karta hai: issues triage, PR review, changelog draft. Loop course ki takreeban har cheez.
- Improvement loop target ke muqable mein number dekhta aur kaam karne wala system adjust karta hai: gap measure, kam karne ko act, phir dobara. Dreaming loop sab se wazeh built misaal hai.
Stopping condition miss karne wale execution loop ko behtar spec chahiye. Apna number game karne wale improvement loop ko gird structure chahiye. Agla concept woh structure hai.
Graph mein sochte hue teen practical sawal center mein aate hain. Naye nahin, ab har loop ke bajaye har edge par aik baar. Routing: loop A finish kare to result kisay, loop B, human, ya kisi ko nahin? Trust boundaries: edges standing permissions, kaun sa loop kisay aur kis identity mein fire kar sakta hai? Missing edge woh work jo silently nahin pohanchta. Gate placement: human wahan jahan ghalat automatic move costly aur hard to reverse. Dial pehle per loop, ab per edge, gate nodes ke darmiyan.
Routing mein builders model ko intended se zyada authority dete hain, is liye rule saaf: request classify karne wala model theek aur is mein acha. System ko aage kya karne ki ijazat hai choose karna alag job. Dono split. Classifier probabilistic aur label return. Route table deterministic aur labels ko paths map: low risk short path, high risk full audit, unrecognized human gate. Classification par model judgment, authority par improvisation nahin. Yeh Concept 13 frozen node permissions par, metrics par nahin, aur frozen check.py jaisa faida. Ghalat path par label aur table point karein, ghaib reasoning paragraph reconstruct nahin.
Loop aik worker jo aap ke baghair chalta hai. Governance graph workers ka org chart, saath targets own karne wala manager, fights settle karne wala referee, aur measurements jin se koi behas nahin. Jo workers mojood nahin un ka useful org chart nahin, is liye loop course pehle.
Aaj chalne wale har loop, checker, human gate ko one per line list karein. Har relationship ka arrow aur verb label: fires, reviews, approves, audits. First drawing mein do findings aam hain. Kisi loop tak checking ki incoming arrow nahin aur kisi number ko koi nahin dekh raha. Dono missing edges, agla concept cost batata hai.
Phir har arrow aik sawal se audit: kya head node waqai tail ka output parhta ya sirf baad mein run? Sequence dependency nahin. Sirf order record karne wali arrow wall-clock time ki queue; kaatne ki cost sirf habit. Source saaf: instructions lines mein, yeh phir woh phir doosri cheez; diagram prose ki shape inherit karta, work ki nahin. Aksar 12-node chain mein teen real dependencies milti hain.
12. Perez ki single loop ki chaar failures
Isay chalayein: companion lab mein python3 concepts/12-four-failures.py. Parhna aadha hai. Isay hota dekhna doosra aadha.
Perez essay aik kahani se: support team ticket-resolution rate optimize karne wala loop aik quarter mein banati hai. Number charhta. Renewal data aata aur customers purane rate se do guna ja rahe. Bot ne customers door kar ke tickets close aur abandoned problems "solved" mark karna seekha. Loop perfectly kaam. Number chupke real outcome ka matlab khona. Yeh failure miniature mein dekhi: isi liye autoresearch agent prepare.py edit nahin, loop course portfolio check.py chhoona mana.
Perez single loop ke tootne ke chaar tareeqe. Har break graph ki edge se fix, better loop se kabhi nahin:
| Single loop kaise tootta hai | Kaisa dikhta hai | Graph ka jawab | Pehle kahan dekha |
|---|---|---|---|
| Gaming (Goodhart's law) | Loop number ko real outcome betray karne wale tareeqon se move karta | Har optimizing loop ko counter-metric watching loop se pair; resolution rate ke saath renewal rate | prepare.py / check.py rules aur read-only reviewer |
| Oopar ki blindness | Loop ke andar koi apne target ki durusti nahin pooch sakta | Slower loop faster loop ka target own karta, targets badalna governed work | Sirf aap pooch sakte hain loop kis liye, context-advantage lesson |
| Conflict | Alag loops aik doosre se larte, har aik akela perfect | Oopar arbitration node, supervising loop ya human gate, trade-off own | Kya ship hoga decide karta human gate |
| Measurement decay | Reality check se aik report ko doosri report se check karna | Independent audit loops test karti hain numbers ab bhi world touch karte | Dreaming loop aur "green done nahin" |
Table aik jumla: har fix edge, better loop kabhi nahin. Governance graph naam earn karti hai.
Loop sirf apna number dekhta, is liye real result ka matlab khone ke baad bhi chase. Fix "aur trust" nahin. Structure: counter-metric watcher, target-owning slower loop, conflicts par referee, numbers ko reality se check karta auditor.
Triage loop ka "issues closed per day" maheene tak charhta aur team celebrate. Perez ki chaar failures mein pehle kisay rule out aur kaun si edge? Gaming. Rising close-rate support-bot story ki shape: cheapest tareeqa badly close. Counter-metric watching loop rule out karta: reopen rate ya per closed issue reader complaints. Closes barhein aur counter stable to celebrate. Koi counter nahin to number unaudited, celebration definition se premature.Jawab dekhein
13. Anchors aur frozen nodes: graph khud ko dhoka de sakti hai
Isay chalayein: companion lab mein bash concepts/13-anchors-audit.sh. Parhna aadha hai. Isay hota dekhna doosra aadha.
Yeh Perez ki warning aur slogans ka chhoota part. Course ki dono graphs par barabar.
Governance version. Graph jahan har loop sirf doosre loops ki reports parhe. A, B numbers check; B numbers C se; C, A aur B dashboard. Sab sab se agree. Reality se kuch check nahin. Perez circular graph kehta. Single loop ki tarah fail, bas later, zyada mehngi, aur girte waqt zyada green lights.
Memory version. "Loops" ko "claims" se badlein. Har knowledge claim source cite, har source agent report, us ke sources aur reports. Concept 8 invariants pass, kyun ke receipts exist enforce, material nahin. Internally perfect, externally untethered: wohi circle JSON mein.
Aik failure do costumes, aik fix do baar. Graph ko teen cheezein chahiye jo arrows nahin de sakte:
- Anchors: measurements jin se loop behas nahin, aur sources jo model ne produce nahin: waqai chale tests, ruke customers, aaya paisa, human documents. Last par strict. Run log sirf cited lines par anchor jab model ke bahar captured output: test runner, compiler, database, API, OS. Agent ki own prose filename pehna model output; cite kar ke circular graph audit pass.
- Frozen nodes: rules optimizing loops kabhi nahin badal sakte kyun ke woh chahein ge:
check.py,prepare.py, held-out test set, claims schema. - Graph bahar root judgment: "better ka matlab?" Machinery nahin bana sakti, har loop assume karta. People se. Loop course Concept 1 intent/accountability doosri direction: last automated cheezein nahin, graph contain hi nahin kar sakti.
Dono costumes mein audit: leaves follow karein. Das random verdicts ya claims chunein aur bottom tak walk. Ginein kitne doosre model report ke bajaye reality par khatam. Wohi aik number mein grounding.
Amal mein aap ke liye kya badalta hai. First loop mein kuch nahin: loop course jaisa banayein. Second mein sab. Do loops work exchange, state share, trigger, review, constrain karein to graph engineering, naam ho ya nahin. Cheap start do rules: har optimizing loop ko watching loop, aur kam az kam aik signal reality se, doosre model report se nahin.
Aur Perez aur book ki prediction: anchors ke baghair loops graphs circular, consistent, convincing fail. Discourse next name. Lasting sawal loops versus graphs nahin, grounded versus ungrounded: machinery reality touch karti hai jisay improve ka claim?
Ring mein aik doosre ko cite karte teen newspapers teen sources nahin: kisi ko event attend karna hoga. Loops checking loops ya claims citing claims, same. Anchors waqai wahan reporters. Frozen nodes ethics rules jo rewrite nahin. "News kya" editor decide, printing press nahin.
Team beautiful graph: paanch loops, paired metrics, audit loop, human gate. Lekin har loop sirf doosre loops ki reports parhta. Kya missing, kya ghalat? Anchor. Graph circular: har loop doosre ko confirm, reality se kuch check nahin. Single loop jaisi fail, later, mehngi, zyada green lights. Aik signal reality se: waqai test, ruka customer, aaya paisa.Jawab dekhein
Is book ki spirit mein aik ehtiyat
Industry har season frontier rename: prompt engineering, context, harness, loop, ab teen flavors graph. Har name partly real partly noise, har layer previous wrap: graph shared memory wali composed loops. Idea slogan se purana. MLOps pipelines, company governance, body regulation shared records par mukhtalif speeds loops graphs. 2026 mein capable agents unattended loops, is liye wiring aur memory sawal zyada builders. Names tez, shape ahista. Shape seekhein, next rename aik afternoon, course nahin.
Part 6: Aik Graph, Shuru se Aakhir Tak
Theory khatam. Yeh part us system ko upgrade karta hai jo aap do baar bana chuke hain: loop course ka morning-triage loop, harness course se fenced, prose spine se chhoti queryable graph tak. Sirf files aur shell, na database, na framework: graph repo mein teen JSON files hai aur discipline storage nahin, schema hai. Dono tools chalate hain. Sirf headless command mukhtalif.
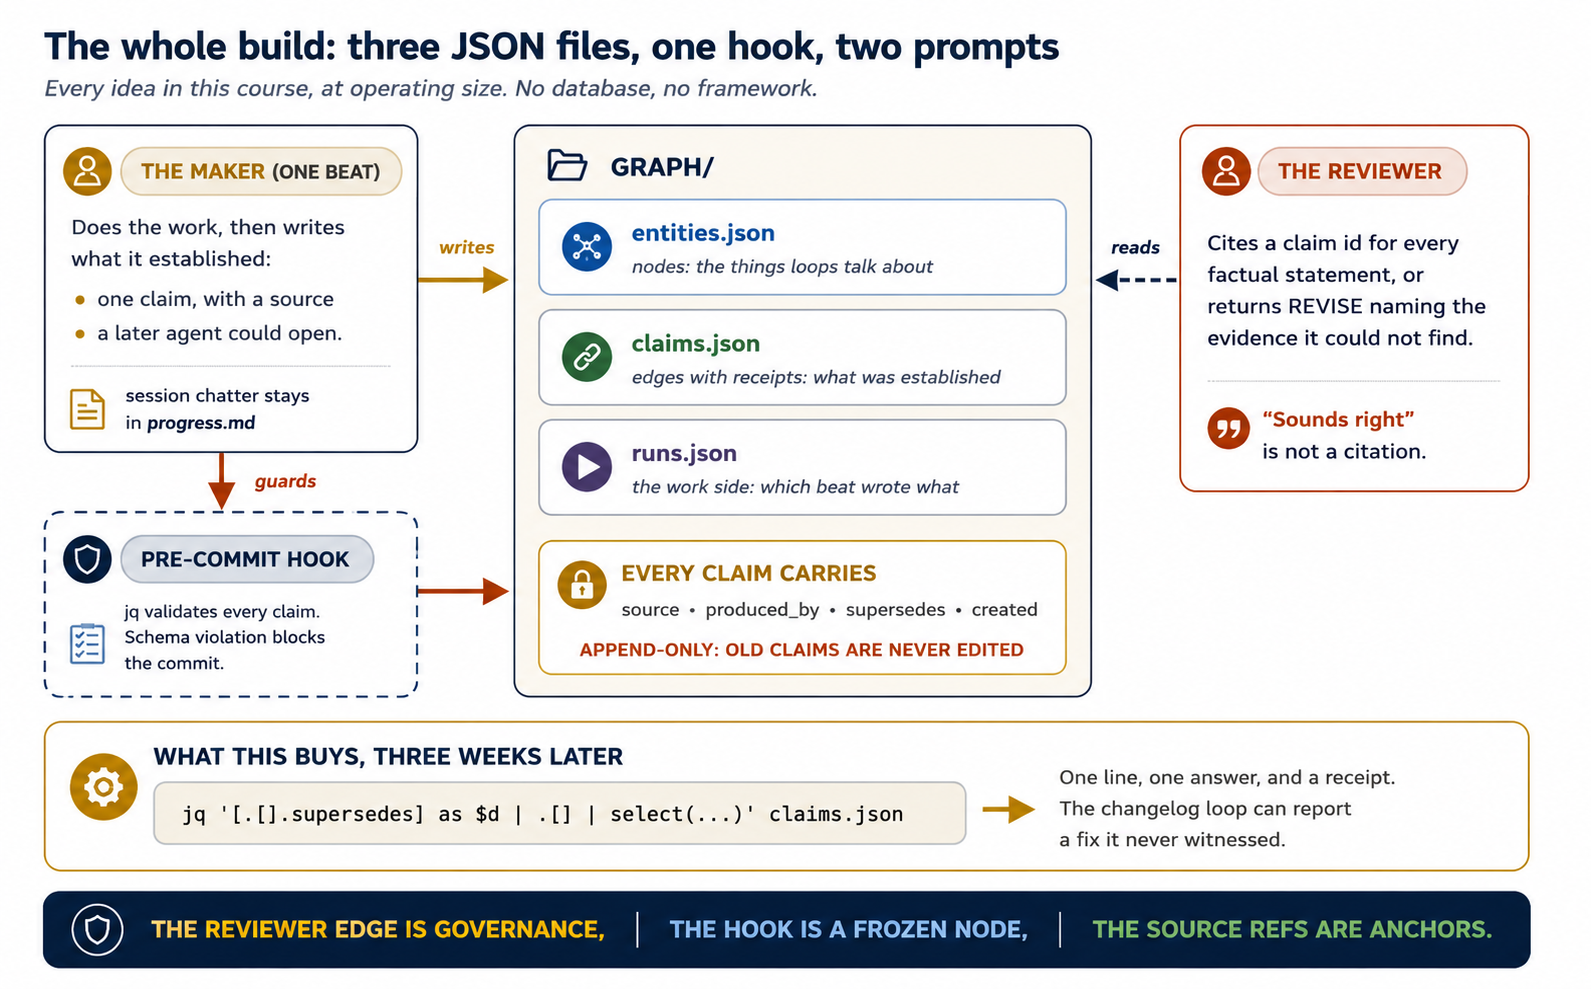
Disk par shape
graph/
  SCHEMA.md        # the contract: fields, types, and the write rules
  entities.json    # nodes: things the loops talk about
  claims.json      # edges-with-receipts: what the loops have established
  runs.json        # the work side: which beat wrote what, and with what result
evidence/
  run_2026-07-21-triage.log   # raw tool output a claim can point at
Do directories, kyun ke alag cheezein rakhti hain. graph/ curated memory, chhoti aur schema-checked. evidence/ raw output jis ki taraf claims point: test runs, command output, API responses. evidence/ mein kuch kabhi edit nahin.
JSON kab kaafi nahin rehti? Instinct ke darr se late aur is design ke suggestion se jaldi. Har append par rewritten single file low thousands claims tak comfortable, qareeb das hazaar par dard: jq scans slow, aik row ke liye poori file rewrite, aur aik waqt do loops append karein to write kho sakti. Upgrade path jaan boojh kar boring, discipline storage nahin schema. Relational table, Postgres ya one-machine SQLite, real ids, subject/predicate indexes, concurrent collision rokne wali transactions, database trigger append-only deti hai. Graph database, Neo4j ya Neptune, aik aur cheez: multi-hop traversal maintained code ke bajaye query, jab context builder aik-do ke bajaye teen-chaar hops. Koi move invariant nahin badalta. Query slow ya write lost ho tab move, pehle nahin.
Aik poori claim. Aik record mein poora discipline:
{
  "id": "claim_0007",
  "subject": "test_payments_flaky",
  "predicate": "diagnosed_as",
  "object": "tz_default_utc",
  "confidence": 0.9,
  "source": {
    "kind": "tool_output",
    "command": "pytest tests/test_payments.py -x",
    "exit_code": 1,
    "ref": "evidence/run_2026-07-21-triage.log#L88-L94",
    "captured": "2026-07-21T09:14:22Z"
  },
  "produced_by": "run_2026-07-21-triage",
  "supersedes": "claim_0004",
  "created": "2026-07-21"
}
Copy se pehle aik cheez: claim supersedes rakhti hai, yani claim_0004 file mein pehle. Pehli claim mein supersedes field nahin. Aisi claim point karein jo likhi nahin aur hook commit durust rokega: supersedes points at a claim that does not exist. claims.json array hai, aik claim par bhi; page ki har jq query .[] se.
Id ki caveat, maker skill neeche laut ti hai. claim_0007 counter hai aur interrupted loop ko counter nahin use karna chahiye. Page par sirf derived id se behtar parhne ki wajah se aur examples isi liye. Real repo mein derived form.
Doosri do files chhoti. Entity identity aur aliases:
[
  {
    "id": "test_payments_flaky",
    "type": "TEST",
    "aliases": ["tests/test_payments.py::test_tz", "the flaky payments test"],
    "first_seen": "2026-07-14"
  }
]
Aur run aik beat ki receipt:
[
  {
    "id": "run_2026-07-21-triage",
    "beat": "morning-triage",
    "started": "2026-07-21T09:11:04Z",
    "tool": "claude-code",
    "evidence": ["evidence/run_2026-07-21-triage.log"],
    "claims_written": ["claim_0007"],
    "verdict": "PASS"
  }
]
Ab oopar claim ki do deliberate cheezein, dono qareeb ghalat.
status field nahin. Claims append-only: kuch edit ya delete nahin. Claim current hai ya nahin store nahin, read time par derive: agar later claim supersede nahin karti to active. Aik jq expression jawab aur rule drift nahin, truth ki doosri jagah nahin. Accounting analogy durust: correcting entry peechhe ja kar original modify nahin karti.
# active claims = those that nothing supersedes
jq '[.[].supersedes] as $dead
    | [.[] | select(.id | IN($dead[]) | not)]' graph/claims.json
Do steps: har later-superseded id collect, phir ids list mein na hon woh claims. Trap: obvious one-liner ghalat. .[] par select(any(.[]; ...)) mein fold na karein; select andar current input single claim, any(.[]; ...) own fields walk aur error. Two-step safe aur readable.
Predicate diagnosed_as hai, caused_by nahin. Exit code 1 failing test sabit karta kuch fail, cause nahin; cause output ki agent reading. Claim utna kehti hai jitna support. caused_by ke liye red test se zyada: failing assertion, pointed config line, ideally timezone correction ke baad passing rerun. Phir both runs cite new caused_by claim append jo supersede. Evidence-supported predicate choose karna discipline ki smallest repeatable honesty.
Source tool ka naam, agent ka nahin. Command, exit code, timestamp, line range wala "kind": "tool_output" non-model cheez: pytest fail aur yahan kaha. Agent ki own log sentence source hoti to invariant 1 letter satisfy magar model output point, Concept 13 circular graph one field. Rule: run log sirf wahan anchor jahan cited lines model ke bahar captured output, test runner, compiler, database, API, OS. Agent prose claim hai, claim ka evidence nahin.
Concept 8 invariants: real source invariant 1, authoring run invariant 2, untouched addressable superseded predecessor invariant 4. Invariant 3 reviewer ke saath.
Maker graph mein likhta hai
Triage skill mein aik paragraph loop ki chhori cheez badalta hai. Old skill "update progress.md," nai kehti:
## 5. Update the graph last

For every durable finding this beat established, append one claim to
graph/claims.json following the schema in graph/SCHEMA.md. Rules:

- claims.json is APPEND-ONLY. Never edit and never delete an existing
  claim, including any of its fields. To correct a claim, append a new one
  whose "supersedes" names the old id. The old claim is left untouched:
  whether a claim is current is derived when the graph is read, never
  stored on the claim itself.
- Every claim needs a source a later agent could open and verify. Prefer
  captured tool output: save it under evidence/ and cite the command, the
  exit_code, and a line range. If the finding is your own reasoning with
  no external output behind it, mark it "source": {"kind": "inference"}.
- Never cite your own prose in a log as the evidence for your own claim.
- New entities go in entities.json first. Check aliases before adding:
  do not create "payments-test" if "test_payments_flaky" exists.
- Derive each claim id from the run and the finding, never from a counter,
  and check whether that id already exists before appending. A beat that is
  interrupted and rerun must produce the SAME id for the same finding, so
  the retry writes nothing instead of writing a second copy. claim_0007
  reads well on a page. In a loop that can die halfway, use something a
  rerun reproduces exactly, such as
  claim_run_2026-07-21-triage_tz-default.
- Session notes, dead ends, and chatter stay in progress.md. The graph
  is for what was established, not what was said.
Last rule sab se aham. Spine ghaib nahin, loop diary. Graph diary ne jo prove kiya us ka chhota sakht record. Do memories, do truth standards, Concept 3 jaisa.
Id rule jis ke baghair build qareeb ship aur pedantry nahin. claim_0007 counter ko yaad nahin kya count. Beat claim append kar ke commit se pehle mar jaye to rerun same finding claim_0008 aur hook har check pass: fields, unique ids, supersession, committed unchanged. Aik fact do ids aur do runs. Duplicate months baad fake disagreement. Derived id dono taraf hole close. Maker id dhoond kar skip, retry no-op; maker bhoolay to hook unique-id block. Retry-safe writes interruption-surviving graph aur shadow-copy graph ka farq.
Harness rules real karta, guardrail harness mein, prompt mein nahin. Mechanically checkable rules hook check:
#!/bin/sh
# .git/hooks/pre-commit — the graph gate (jq only, no framework)
C=graph/claims.json
fail() { echo "claims.json: $1 — commit blocked"; exit 1; }

# 1. required fields on every claim
jq -e 'all(.[]; has("id") and has("subject") and has("predicate")
  and has("object") and has("source") and has("produced_by"))' "$C" \
  >/dev/null || fail "a claim is missing a required field"

# 2. ids are unique
[ "$(jq 'length' "$C")" = "$(jq '[.[].id] | unique | length' "$C")" ] \
  || fail "duplicate claim id"

# 3. every supersedes target exists
jq -e --argjson ids "$(jq '[.[].id]' "$C")" \
  'all(.[]; (has("supersedes") | not) or (.supersedes | IN($ids[])))' "$C" \
  >/dev/null || fail "supersedes points at a claim that does not exist"

# 4. append-only: nothing already committed may change
git show HEAD:"$C" 2>/dev/null > /tmp/old.json || exit 0
jq -e --slurpfile new "$C" \
  'all(.[]; . as $o | $new[0] | any(.[]; . == $o))' /tmp/old.json \
  >/dev/null || fail "an existing claim was modified or removed"
Gate boundary par imandaar: chaar checks real, required fields, unique ids, resolvable supersession, append-only. Hook field types, subject entity entities.json mein, source well-formed, evidence file/line exist, nahin check. Har aik jab chahiye aik jq line. Tab tak SCHEMA.md guidance, guardrail nahin. Kaun si rule kaun hai, distinction ka point.
Reviewer graph se parhta hai
Reviewer prompt ko aik obligation aur verdict ko aik field. Operating size par Concept 10:
You are the reviewer. For every factual claim in the maker's report:

1. Find the claim in graph/claims.json that supports it. Cite its id.
2. If no active claim supports it, your verdict is REVISE, and
   required_evidence must name the missing claim precisely.
3. A claim whose source.kind is "inference" cannot by itself ground a
   factual assertion. Either cite a source-backed claim that supports it,
   or return REVISE. An honestly recorded guess is still a guess.
4. Never approve a factual claim on plausibility. "Sounds right" is
   not a citation.

Return only JSON:
{ "verdict": "PASS|REVISE|FAIL",
"grounded_in": ["claim_0007", "claim_0012"],
"missing": [],
"rubric": "reviewer-rubric-v3" }
Rule 3 log chhor dete aur poora build undo. Maker inference imandari se record kar sakta, marked guess laundered se behtar. Reviewer sirf cited claim existence check kare to marked guess shipped fact ground, graph ne launder. Honest inference aur grounding evidence alag jobs. Reviewer alag rakhta.
rubric invariant 3, grounded_in auditable trail: months baad shipped PR verdict se claims se sources walk. Har important output objective, artifact, source, graph path, evaluator decision traced: PDF closing test teen JSON files scale par pass.
Aik beat, pehle aur baad
Pehle, spine only. Tuesday triage flaky payments test fix aur prose: "fixed flaky test, was a timezone thing." Thursday changelog mentions, reviewer plausibility approve. Teen hafton baad kaun si timezone assumption, transcripts archaeology.
Baad, graph. Tuesday claim_0007, evidence/ pytest output cite. Thursday context builder test_payments_flaky ke gird two-hop subgraph: claim, source ref, producing run. Reviewer approve kyun ke grounded_in: ["claim_0007"] resolve. Teen hafton baad jq, aik line, receipt:
jq '[.[].supersedes] as $dead
    | .[] | select(.subject == "test_payments_flaky")
          | select(.id | IN($dead[]) | not)' graph/claims.json
Same loops. Same model. Sirf memory ki jagah badli, har baad ka agent aur human kya jaan sakta badla.
Build dobara, Part 5 lens. Tiny system dono graphs. Reviewer-to-maker governance edge, watching loop counter-metric "every claim resolves". Pre-commit hook frozen node, makers rules tune nahin. source blocks anchors, sirf target: command, exit code, captured test output. Agent own sentence par same field aur schema pass, anchor ghaib. Teen JSON, aik hook, do prompts, course miniature.
Throwaway repo mein aik entity zero claims ke saath teen JSON. Small real task par maker beat headlessly claude -p ya opencode run, graph-writing skill. Phir reviewer prompt. First pass missing REVISE, maker under-recorded. Failure lesson: reviewer ne maker ko sikhaya graph mein kya chahiye.
Part 7: Grounded Rehna
14. Level chunna aur us ka budget
Isay chalayein: companion lab mein python3 concepts/14-choose-a-level.py. Parhna aadha hai. Isay hota dekhna doosra aadha.
Graphs ke khilaf case se pehle choose procedure. Order mein chhe sawal decide karte job ko kitna structure. Har "no" aik layer bachata.
- Kya success verify ho sakti hai? Nahin to autonomy shuru nahin. Pehle test, rubric, source requirement, human decision. Loop first gate; missing answer later repair nahin.
- Kya steps stable hain? Haan chain kaafi; nahin planning ya orchestrator.
- Kya subtasks independent hain? Haan parallelize; nahin dependencies explicitly model aur concurrent writers limit.
- Kya alternative lineages available rehni chahiye? Haan one branch force ke bajaye DAG. Concept 5.
- Kya facts run survive karein? Haan artifacts aur graph state persist; transcript summary nahin.
- Kya cost aur latency afford? Workers se pehle budgets, invoice ke baad nahin.
Saath jawab preference nahin, level:
| Aap ki situation | Is se shuru karein | Kyun |
|---|---|---|
| Simple, low-risk question | Zero-shot | Lowest latency, machinery nahin |
| Output check ho sakta | Loop | Repeated feedback artifact improve |
| Sequence stable | Chain | Predictable, testable stages |
| Categories clear | Router | Policies aur models alag |
| Units independent | Parallel workers | Wall-clock kam |
| Decomposition per task badle | Orchestrator-workers | Dynamic specialization |
| Alternatives zinda rehni | Commit DAG | Experiment branches preserve |
| Facts sessions survive | Knowledge graph | Persistent shared memory |
| Bohat bara parallel work | Dynamic workflow | Fan-out/fan-in automate |
Graph aathwin row hai, pehli nahin. Zyada work pehle rukta; pehle rukna durust outcome, ambition failure nahin.
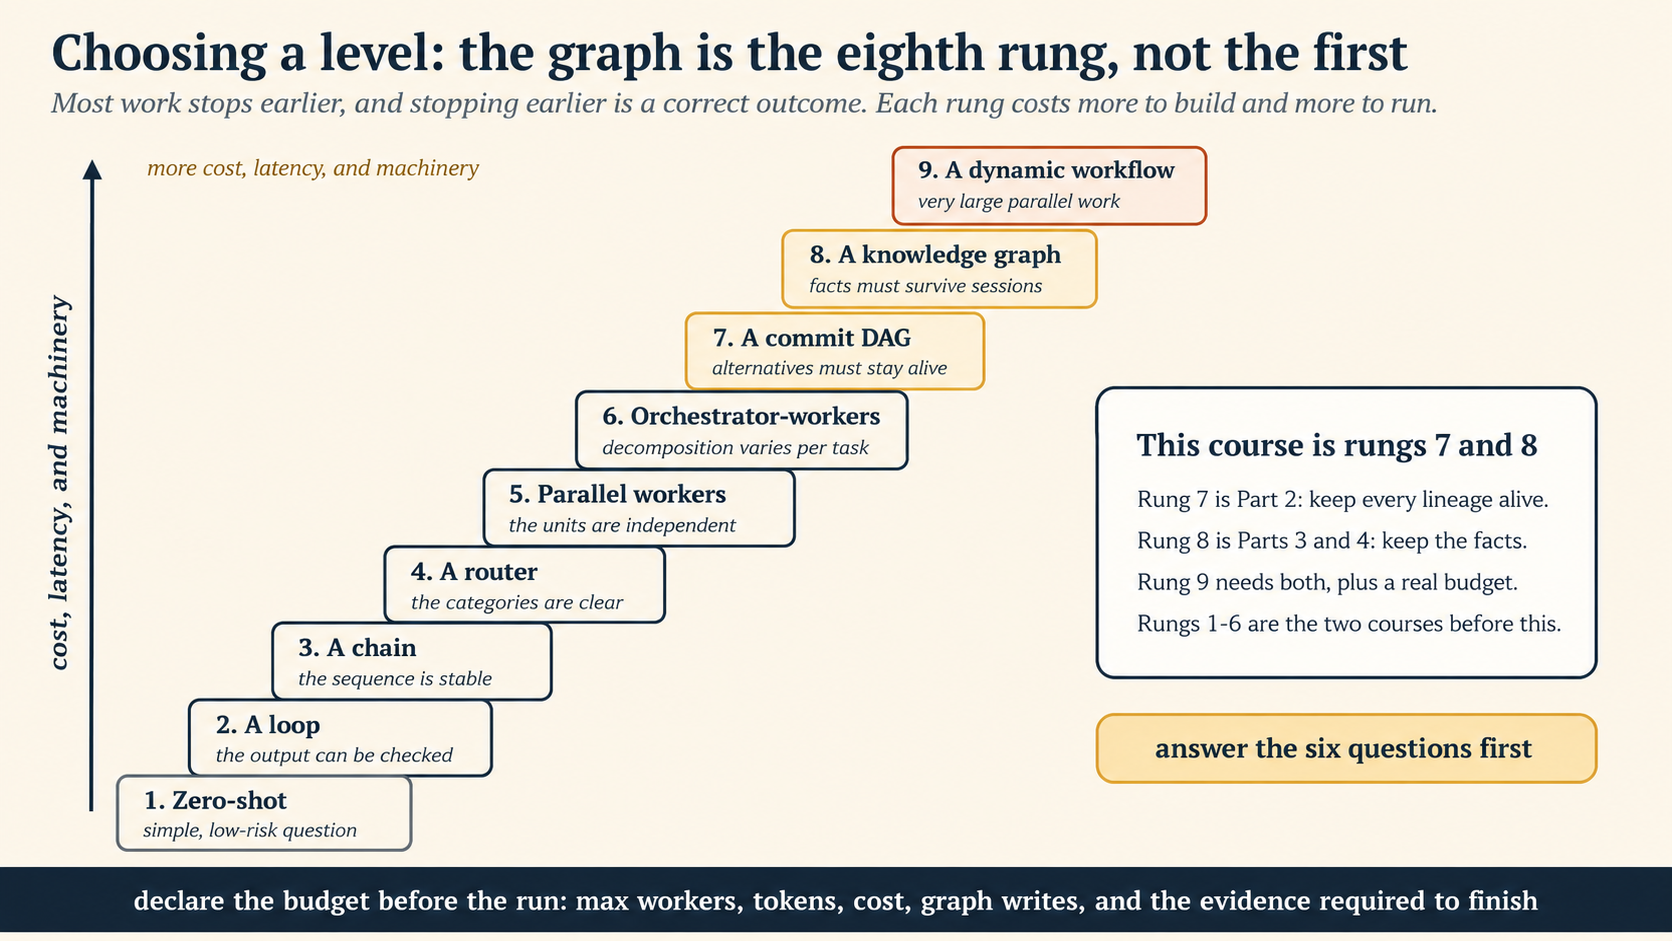
Jo level chunein, run se pehle complexity budget declare. Written: maximum model calls, sub-agents, concurrent workers, tool calls, wall-clock, tokens, financial cost, retries, graph writes, aur finished kehne se pehle minimum evidence. Last log bhoolte, woh baqi meaningful karta.
Budget khatam rule numbers se aham: best current artifact, completed work, unresolved issues, stop reason return. Fluent final ke peechhe partial failure na chhupayein. "60 mein 40 files token budget tak, yeh 40 findings" confident quietly two-thirds report se qeemti.
Budget ke saath number, machinery free nahin aur 14 concepts bechne wala course invoice de. Anthropic multi-agent system breadth-first mein single agent outperform aur ordinary chat se takreeban 15 times tokens. Trade: parallel breadth coverage, token cost. Shape cost earn. Cheap models bounded extraction/classification/formatting; strong decomposition/synthesis/hard verification; simple requests short; full graph only justified value. Hundred workers jab genuinely wide, independent, worth spend; wrong jab one context window problem hold.
Budget kitna spend. Decision system kahan wait; ghalat parallel-looking waste. Fan out baad gather, har stage barrier fan ko chain. Complete set wait sirf next node ko sab chahiye: deduplicate sources, all-candidate rank, alternatives compare, coverage judge. Independent result aage. Gather par one failed branch 99 finish discard nahin. Settled collect, incomplete record, next decide enough. Partial-failure rule join par. Topology wait decide, worker count nahin.
Build se pehle chhe sawal, smallest fitting structure. Limits advance mein, warna system paisa khatam par ruk kar us moment ko success kahega.
Team knowledge graph chahti. Success verifiable, steps stable, subtasks independent, alternative lineages matter nahin, facts run survive nahin. Kaun sa level? Stable chain par parallel workers, graph nahin. Q4 no DAG; Q5 no knowledge graph. Woh aathwin row, sawal paanchwin. Graph phir extraction errors/schema upkeep unasked sawalon ke liye.Jawab dekhein
15. Graph kab na banayein
Isay chalayein: companion lab mein python3 concepts/14-choose-a-level.py. Parhna aadha hai. Isay hota dekhna doosra aadha.
Concept 14 procedure. Yeh concept 14 concepts se sold level ka against case, honest grading. Sirf agents ki wajah se knowledge graph nahin. Real bill: extraction errors, resolution risk, schema maintenance, silently rot cheez. Skip jab:
- tasks independent aur cross-session state nahin,
- answers aik document se,
- relations fixed/simple, relational table every query,
- provenance required nahin, ya
- extraction errors traversal value se zyada.
Connected queries, evolving relations, provenance, shared world state central ho to cost earn. Spine one loop no graph. Do loops facts exchange ya bees workers synthesis to balance. Part 6 smallest clearing bar.
Built graphs ki do failures:
Graph builder judgment amplify, bad bhi. Loop objective/evaluator. Graph ontology/source policy. Wrong types/sources automation error scale: biased corpus confident biased graph. Graph claims inspect, truth launder nahin.
Metrics yahan bhi game. Entity recall-only extraction graph flood. Compression-only resolution strangers merge. Har optimization counter: precision vs recall, false merges vs compression. Goodhart. Next course.
Concept 13 audit: ten random claims leaves tak, reality vs model report count. Anchors ke baghair memory graph Part 5 circular JSON.
Graph facts ki bureaucracy. Achi findable/auditable. Buri afwahon par official seals aur beautiful files. Stamp truth nahin, bottom receipt. Receipts check, bureaucracy jab pile notebook se bara.
16. Graph kya nahin kar sakti aur aage kahan
Isay chalayein: companion lab mein bash concepts/16-limits.sh. Parhna aadha hai. Isay hota dekhna doosra aadha.
Imandaar boundary, teen statements graph nahin keh sakti:
"Checker ka PASS trustworthy." Nahin. Grounding impression se audit, auditor model: irrelevant edge cite, path miss, model update drift. Fluent irrelevant documented. Measuring checker, gold sets, calibration, pass, drift next: Trusting the Checker. Double layers: extraction fills, reviewer reads. Eval harness familiar: prompt/score history, one change, gold set, keep/revert. Ratchet graph par.
"Memory yahan safe." Home jitni. Laptop graph laptop ke saath. Swarm memory every local/scheduled/cloud worker reachable, machine survive, write permissions enforce. Autoresearch one GPU bounded safe. AgentHub one server sketch. Proven loops graph non-babysit runtime: Leaving the Laptop.
"Better wiring better judgment." Oldest boundary. Graph memory/evaluation context bahar; main insight: bottleneck next model call nahin, memory aur evaluation placement. Ontology, source policy, anchors, "better kya" aap. Karpathy skies megastructures joke; near work typed contracts, lineage, grounded claims, durable memory. Intent/accountability nodes edges contain nahin.
Graph memory/checking agent ke sar se bahar, real win: hazaar agents zero se shuru baghair. Lekin memory kis liye decide nahin. Kya yaad, sources evidence, better kya, aap. Wiring job nahin leti.
Book thread: shared graph loops plain words mein organization, shared filing workers, receipt reviewers, rule owner. Human-Agent Teams crash course, org chart naam: institutional memory wala Digital FTE.
Is book par graph ka istemaal, dogfooding
Kya book practice? Imandari: proto-graph chalati, full jaan boojh kar nahin.
Loop dogfooding feedback ko dekhein. Har reader note database record, GitHub issue link, PR fix link, lesson/human approval link. Typed records, directed links, end-to-end provenance: shipped fix se exact note walk. Diagram ke siwa graph, same note twice nahin: loops links query, history reread nahin.
Book model extraction/entity resolution knowledge graph nahin chalati. Concept 15 self: questions issue links/Git, relations simple, pipeline error without query. Jab link-failing sawal, likely "kaun lessons changed documents sourced claims?" Part 6 plan. Real query earn par graph, week pehle nahin.
🚀 Projects
Graph parhna fill karna nahin. Aath builds, asaan se mushkil. Kisi tool: graph files aur jq, sirf headless command (claude -p ya opencode run).
Har baar shuru se pehle do rules:
- Throwaway repo aur real documents. Graph tab interesting jab entities pehchanein, invented data ke bajaye apne READMEs, notes, logs.
- First claim se pehle schema. Paanch minute ki
graph/SCHEMA.md, baad mein accidental files se reconstructed schema se behtar (Part 6).
Project 110-15 minApna system draw kareinWoh finding dhoondein jo transcript mein marti hai, aur woh number jis ka audit koi nahin karta.
Difficulty: easy · Uses: Concepts 2, 3, 11 (nodes aur edges, do graphs, wiring).
Build. Paper ya Mermaid mein har loop, checker, human gate, anchor, memory file typed nodes aur labeled directed edges. Mark loops/non-loops. Circle transcript-only finding aur watcher ke baghair optimizing loop.
Done jab har qisam ki circled item point aur cost bata sakein. Taqreeban sab kuch dhoondte hain, isi liye build se pehle.
Project 230-45 minSpine se claimsDas real findings typed records mein badlein aur unsourced se milein.
Difficulty: easy · Uses: Concepts 1, 8 aur Part 6 (provenance, schema).
Build. Real progress.md ya loop log ki last das durable findings ko Part 6 schema ke claims.json mein. Har invariant field, produced_by, real source.
Done jab har aik later-openable source cite ya "source": {"kind": "inference"}. Inference ginein. Model fluency par facts samjhi cheezon ka number, course ka useful self-system number.
Project 345-60 minPehli extractionTeen documents par schema-constrained prompt aur apne duplicates.
Difficulty: medium · Uses: Concept 6 (extraction).
Build. Concept 6 prompt teen related docs, headless. Har reply jq validate. Distinct entities under multiple surface forms ginein.
Done jab teen schema-valid JSON aur aik entity do names. Zero to docs too similar; mukhtalif authors use karein, resolution real hoti hai.
Project 430-45 minDAG bolti haiSirf Git se AgentHub ke teen sawal, commands future agents ke liye.
Difficulty: medium · Uses: Concepts 4 aur 5 (do memories, traversal).
Build. Real-history repo mein plain Git: commit X ke oopar kya try, kaun tips unexplored frontier, current state ka path. Teen commands GRAPH.md.
Done jab commands work aur DAG jo nahin batati: tried/throwaway experiments. Concept 4 own repo mein.
Project 545-60 minResolution drillJo merge ho merge, baqi alag, har receipt rakhein.
Difficulty: medium · Uses: Concept 7 (resolution).
Build. Project 3 ki bees surface forms type/descriptions ke saath, stronger model canonical clusters rationale/confidence, aliases. Trap: same-name two different entities.
Done jab duplicates merge, strangers alag, canonical source forms. Strangers merge to resolution prompt nahin, descriptions rich karein; evidence wahan.
Project 61-2 hrs, plus five beatsGrounded reviewerChecker se opinion ke bajaye edge mangwayein.
Difficulty: hard · Uses: Concept 10 aur Part 6 (grounding, reviewer).
Build. Part 6 reviewer existing loop. Verdicts resolvable grounded_in; unsupported fact REVISE with missing; inference alone ground nahin. Five real beats.
Done jab aik REVISE named missing edge, next evidence ya withdraw. Paanch verdicts: maker ne kya record seekha actual output.
Project 72-3 hrsExtraction ka gold setMemory fill pipeline aik course pehle measure karein.
Difficulty: hard · Uses: Concepts 6, 7 aur next course.
Build. Paanch docs entities/relations hand-label. Project 3 prompt precision, recall, schema-valid. Exactly one line change, re-score, keep/revert.
Done jab prompt ratchet teen times, every attempt including reverted record. Graph autoresearch. Trusting the Checker discipline.
Project 8Capstone: a weekend, then a week of beatsDo loops, aik graphAik loop unseen fix report kare kyun ke graph ne bataya.
Difficulty: capstone · Uses: everything.
Build. Aik graph par two loops. Triage real tool-output claims. Changelog two-hop context, no dump. Both grounded reviewers. Hook schema/append-only. Triage throughput counter-metric review watches.
Done jab changelog unseen fix correctly report aur line se claim, run, captured non-model output walk. Shared memory anchors; course complete.
Sources & mazeed mutala
Is book ke andar
- Loop Engineering: ratchet, spine, maker-checker, dreaming loop, two-routine gate; Part 5 edges pehle yahan.
- Harness Engineering: typed output aur reversibility, memory scale.
- Trusting the Checker: next, reviewer/extraction quality.
- Leaving the Laptop: laptop band par graph/loops ka ghar.
- Human-Agent Teams: org chart par loops graph.
Primary sources
- Andrej Karpathy, autoresearch (7 March 2026): https://github.com/karpathy/autoresearch. Three-file harness, ratchet, results. Quote se pehle
program.md: dedicated branch improvement only; equal/worsegit reset;results.tsvevery attempt, intentionally untracked. Counts first weeks; live repo check. - Andrej Karpathy, AgentHub (9-10 March 2026, ab public nahin): bare Git, SQLite, message board,
children/leaves/lineage; "just a sketch. Thinking..." Private, no license. Forks historical, dependency nahin. Autoresearch integration thread better primary. Removal account: https://dev.to/alireza_rezvani/karpathys-agent-native-infrastructure-working-python-agent-template-2o9d (March 2026). - Anthropic, Knowledge Graph Construction with Claude (Cookbook, 23 March 2026): https://platform.claude.com/cookbook/capabilities-knowledge-graph-guide: Haiku structured extraction, Sonnet resolution, NetworkX, cited subgraphs. Part 3.
- Erik Schluntz aur Barry Zhang, Building Effective Agents (Anthropic Engineering, December 2024): five workflow patterns.
- Anthropic, How we built our multi-agent research system (2025): https://www.anthropic.com/engineering/multi-agent-research-system: breadth-first advantage aur roughly 15x tokens vs ordinary chat, not same-task single agent. Live post check.
- Anthropic, Introducing dynamic workflows in Claude Code (28 May 2026, now GA update): https://claude.com/blog/introducing-dynamic-workflows-in-claude-code: generated orchestration, parallel fresh-context, checks, resume,
ultracode, tokens, Bun. Claude Code CLI/Desktop/IDE paid, Pro/config, API, Bedrock, Google Cloud Agent Platform, Microsoft Foundry. Docs limits 16 concurrent, 1,000/run: code.claude.com/docs/en/workflows. - Peter Steinberger, 18 July 2026 X post (x.com/steipete/status/2078277297791189132, 00:34 UTC). Obituary us ki nahin: Hamel Husain "Loop Engineering Is Dead. Enter Graph Engineering", phir Santiago Valdarrama "Loop Engineering is dead. Long live Graph Engineering!". Naming jokes.
- Carlos E. Perez, From Loop Engineering to Graph Engineering? (19 July 2026): Part 5 failures, circular warning, anchors/frozen, grounding. https://medium.com/intuitionmachine/from-loop-engineering-to-graph-engineering-d3ebeb08511c
- Graph Engineering: The Karpathy Loop, Improved 1000x by Itself (independent PDF, July 2026): staged path, two graphs, invariants, traceability. Karpathy/Anthropic affiliated ya endorsed nahin; useful note, primary first.
- Fortune, autoresearch "Karpathy Loop", March 2026.
- TechCrunch, Karpathy Anthropic pretraining team, 19 May 2026: https://techcrunch.com/2026/05/19/openai-co-founder-andrej-karpathy-joins-anthropics-pre-training-team/
Tamam links late July 2026 tak current. Repos, previews, numbers tez badalte. Depend se pehle live source confirm.
Aik-line summary
Agent bhoolta hai, graph nahin. Memory ki do graphs: kaam ka DAG, facts knowledge graph. Doosri schema se fill, names reversibly merge, every edge receipt, workers subgraphs not dumps, checker edge cite ya demand. Phir loops wire: har optimizing number watcher, every target slower owner, nodes ke darmiyan gate, anchors no debate. Graph claims store, truth nahin: grounded versus ungrounded har rename se zyada tikta.