Context Layer बनाना: एक Worker के Store से पूरी Workforce के Corpus तक का Crash Course
15 Concepts · Onyx, MCP और चार source classes · आपके agent ने बनाया, हाथ से नहीं
AI Searchable Context ने एक Worker के लिए उसका अपना store बनाया था। यह course वह corpus बनाता है जिसे पूरी workforce पढ़ती है।
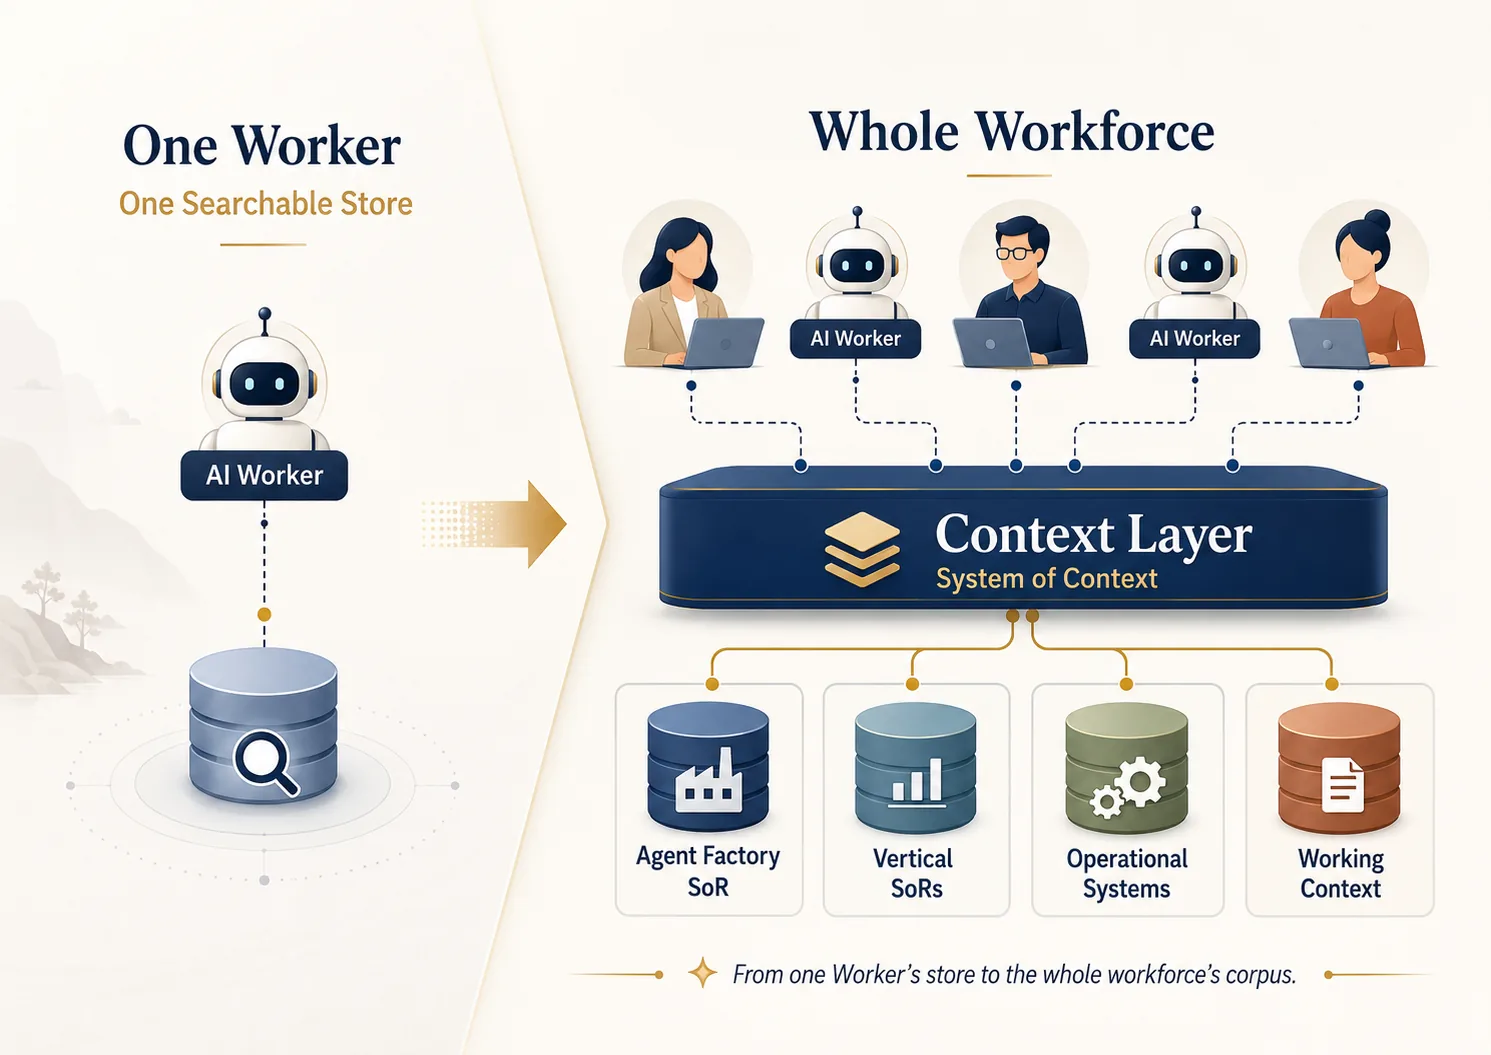
AI Searchable Context में आपने एक Worker को उसका अपना store दिया था: आपके documents, chunks में बाँटे हुए, embedded, meaning से searchable, और आपके control वाले एक Neon Postgres में रखे हुए। आपने उसे MCP tool में भी wrap किया था ताकि दूसरे agents उसे call कर सकें।
लेकिन वह अब भी एक bounded store था, जिसकी boundary आपने ख़ुद बनाई थी। उसमें हर document आपने चुना था। आपने तय किया था कि वहाँ कौन पहुँच सकता है। उसमें ऐसी कोई चीज़ नहीं आई थी जो आपने ख़ुद न रखी हो।
अब किसी customer की building में प्रवेश कीजिए।
उनके बीस साल के working papers SharePoint में हैं। Engagement letters email में हैं। कोई decision क्यों लिया गया, इसका कारण chat thread और यात्रा कर रहे manager के दिमाग़ में है। Current balances ऐसे system में हैं जो हर घंटे बदलता है। इसमें से कुछ भी आपका store नहीं है। काम पूरा करने के लिए यह सब ज़रूरी है।
यह course वह layer बनाता है जो इन सभी तक पहुँचती है, और इसे एक ऐसे सवाल के आसपास बनाता है जो कोई असली company सच में पूछेगी।
Northstar Services बीस प्रतिशत discount चाहती है, अभी invoice चाहती है, और implementation revenue इसी quarter में recognise करना चाहती है। क्या यह हो सकता है?
यह एक customer का एक वाक्य है, लेकिन एक सवाल नहीं है। यह sales का सवाल, accounting का सवाल, live-state का सवाल और email में सुनी हुई एक बात है। सही answer के लिए इन चारों को अलग रखना ज़रूरी है। Course के अंत तक Worker इसका सही answer देगा। Citations के साथ। Current facts को live fetch करके। Email को authority नहीं बल्कि evidence मानकर। और दो professional decisions को एक उत्साही "हाँ" में मिलाने के बजाय अलग रखकर।
अगर ये नए हों, तो पहले तीन शब्द समझिए। Connector वह हिस्सा है जो किसी source system को पढ़ता है और उसके content की copy को current रखता है। Indexing उस copy को इस तरह store करना है कि उसे search किया जा सके। Permission inheritance का मतलब हर document के access rules को उसके home system से हर search result तक साथ ले जाना है, ताकि reader केवल वही देखे जिसे वह पहले से खोल सकता है।
एक idea इस पूरे course को समझा देता है। पिछले course का एक सवाल था: क्या सही chunk context window में है? इस course के तीन सवाल हैं, और हर concept उन्हीं के लिए है। Layer से लौटने वाली हर चीज़ के लिए पूछें:
यह कहाँ से आई? क्या यह व्यक्ति इसे देख सकता है? क्या यही नियम अभी भी लागू है?
Search box इनमें से किसी सवाल का answer नहीं देता। Context layer हर item के लिए, हर बार, तीनों का answer देता है। यही पूरा अंतर है, और इसीलिए यह एक course है, केवल config file नहीं।
| शब्द | सीधा अर्थ |
|---|---|
| System of Record | वह system जो किसी चीज़ का official record रखता है। अगर कोई copy उससे अलग है, तो copy ग़लत है |
| Vertical | एक profession या industry, जैसे accounting, law या sales engineering। यह general-purpose का उलटा है |
| Authority class | यह किस तरह का statement है और इसलिए उसका कितना weight है: law, standard, contract, policy, transaction, guidance, message या example |
| Working context | Company की रोज़मर्रा की सामग्री: email, chat, drafts और files। असली और उपयोगी, लेकिन कभी rule नहीं |
| Connector | वह हिस्सा जो एक source system को पढ़ता है और उसके content की copy को current रखता है |
| Sync | Connector का एक run, जो पिछली बार के बाद हुए changes fetch करता है |
| Index | Layer की रखी searchable copy, ताकि चीज़ें जल्दी मिल सकें |
| Corpus | सभी connected sources में मौजूद पूरा content जिसे layer search कर सकती है |
| Fixture | Practice के लिए बनाई गई नक़ली लेकिन realistic file, ताकि असली data risk में न पड़े |
| Document Set | Connectors का named group, जो बताता है कि search किन sources में देख सकती है |
| Onyx Agent | Onyx के अंदर configured assistant, जिसके पास instructions, knowledge और tools होते हैं |
| Action | ऐसा tool जिसे Onyx Agent call कर सकता है, जैसे आपकी अपनी search या live lookup |
| Canonical | किसी बनाई हुई copy के बजाय original और official copy |
| Projection | Governed content की searchable copy, जो केवल इसलिए रखी जाती है कि Worker original को ढूँढ सके |
| Stable ID | किसी rule का permanent नाम, ताकि copy उसके original की ओर point कर सके |
| Superseded | नए version से replace हो चुका और अब लागू rule नहीं रहा |
| Gateway | Onyx के आगे बैठा आपका code, जो तय करता है कि यह व्यक्ति क्या search कर सकता है |
| Packet | एक सवाल के लिए इकट्ठा किए गए rules, facts और evidence का bundle |
| Envelope | किसी item के साथ लगे labels: वह कहाँ से आया, उसका version और आप उसे क्यों देख सकते हैं |
| Provenance | किसी information के origin की पूरी कहानी |
बाक़ी हर नया शब्द वहीं समझाया गया है जहाँ वह पहली बार आता है।
यह course मानता है कि आपने AI Searchable Context पूरा किया है। आपके पास Neon और pgvector पर working RAG होना चाहिए। आपको chunking और embedding worker का अर्थ पता होना चाहिए। Eval set से retrieval quality judge करने में भी सहज होना चाहिए। उस Neon project को रखें। यहाँ आप उसकी infrastructure और retrieval skills फिर इस्तेमाल करेंगे। लेकिन साफ़ समझें कि उसने क्या बनाया था और क्या नहीं, क्योंकि यही अंतर इस course का विषय है।
उस course ने एक bounded retrieval store बनाया था: documents, chunks, embeddings, search function, answer function और eval set। उसने सिखाया कि documents searchable knowledge कैसे बनते हैं। उसने उस store को professional authority नहीं दी थी। उसमें authority classes, jurisdictions, effective periods या supersession links नहीं हैं। इसलिए Concept 10 में आप मौजूदा structure के साथ एक छोटा governed schema जोड़ेंगे, और Concept 10 उसी तक पहुँचने का रास्ता बनाता है। यह course यह भी मानता है कि आपने Claude Code या OpenCode को plan mode में drive करने के लिए Agentic Coding, और MCP के लिए Skills & Connectors किया है।
इस build के पीछे concept page The System of Context है। अगर पहले argument समझना चाहते हैं, तो उसे पढ़ें। यह course factory floor है, और Northstar वही worked example है जिसे वह page अलग-अलग हिस्सों में समझाता है।
यहाँ पूरा system एक page पर है। हर concept के साथ आगे बढ़ते हुए आप इसी map को पूरा करेंगे:
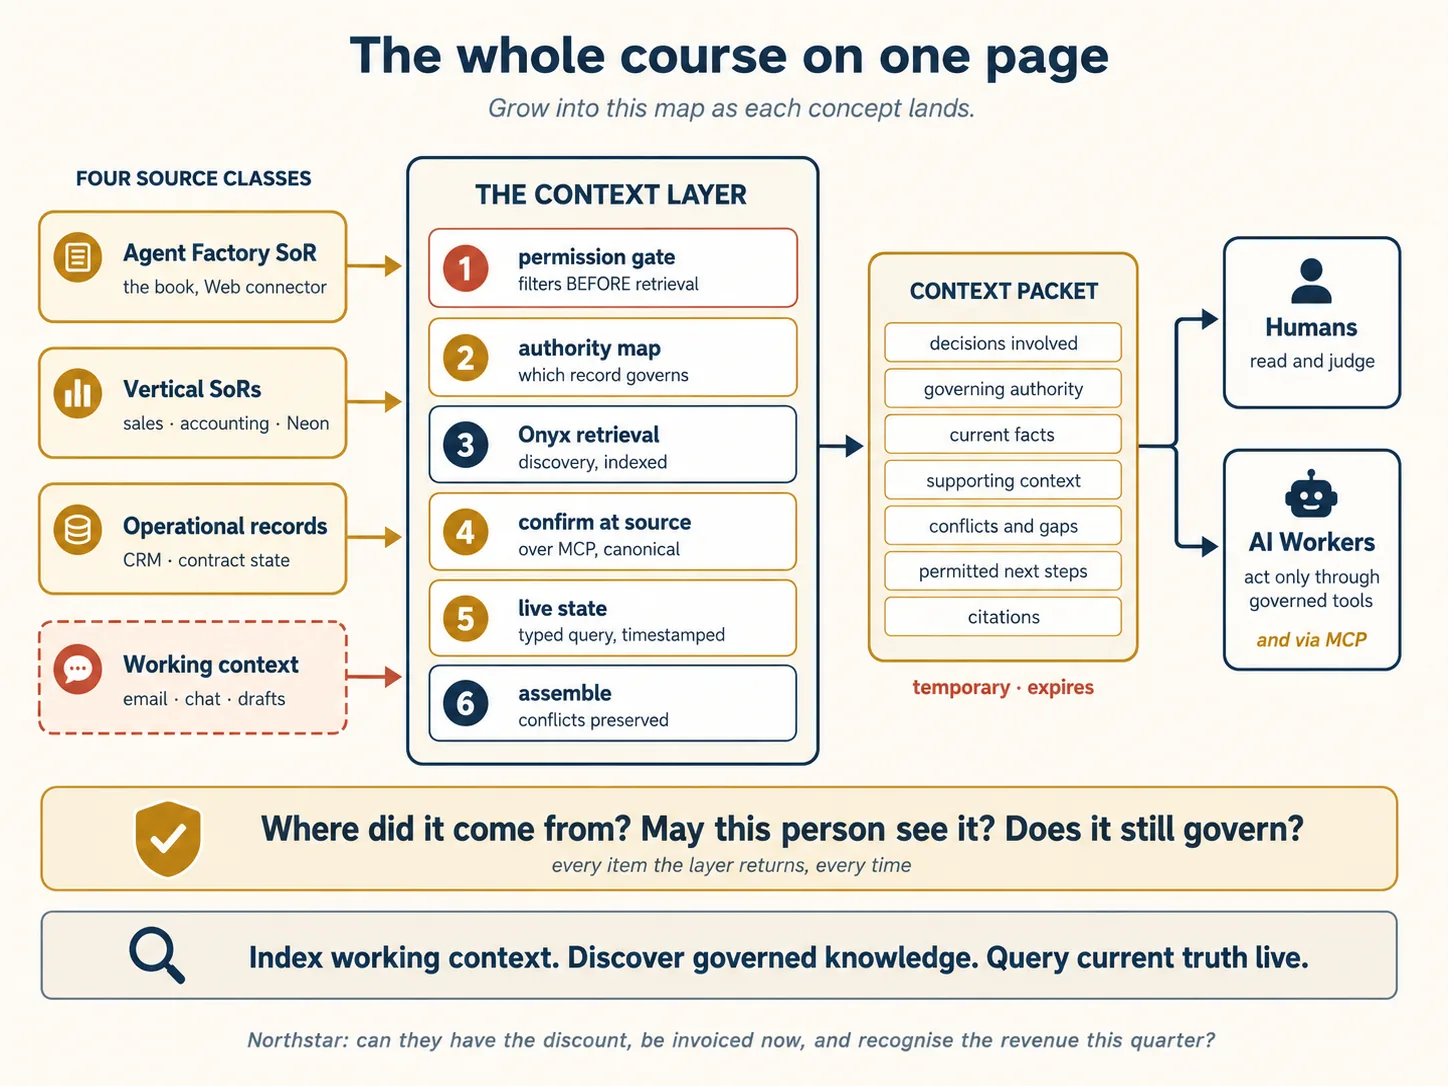
यह course क्या cover करता है
| Part | Topic | आप क्या सीखते हैं |
|---|---|---|
| 1 | Foundations | Scope की छलाँग, चार source classes, Onyx Standard, एक model और search baseline |
| 2 | आपका पहला corpus | Shared method के रूप में किताब, Northstar fixtures, Document Sets, chunker और permission gate |
| 3 | Governed हिस्सा | MCP पर आपका Neon record, discovery बनाम confirmation और live state |
| 4 | Routing और citing | Prompt से पहले लिखा authority map, सात-section packet और वे conflicts जिन्हें मिलाना नहीं है |
| 5 | Northstar case | पूरा end-to-end build, फिर उसे जानबूझकर तोड़ने के चार तरीक़े |
| 6 | इसे साबित करें | आठ eval dimensions, और answer देने वाले model को ख़ुद grading क्यों नहीं करनी चाहिए |
| 7 | इसे serve और operate करें | हर external Worker के लिए एक gateway, फिर connector health, upgrades और definition of done |
एक running Onyx Standard deployment जिसमें चारों source classes connected और अलग रहेंगी। Shared method के रूप में Agent Factory की किताब ख़ुद index होगी। Northstar के दो Vertical records, sales और accounting, एक उपयोगी तरीक़े से disagree करेंगे। Current customer state के लिए live MCP server होगा। आपका अपना Neon record MCP पर serve होगा और कभी crawl नहीं किया जाएगा। Versioned authority-map.yaml बताएगी कि किस सवाल को कौन-सा record govern करता है। Context Router हर बार citations के साथ वही सात sections लौटाएगा। आपका लिखा permission gate ऐसे role के साथ test होगा जिसका सही answer कुछ नहीं है। Eval set आठ dimensions पर score होगा। और Context Gateway MCP endpoint authorized external Workers को उसी identity और permission boundary के साथ shared corpus query करने देगा।
इसे कैसे पढ़ें। Parts 1 और 2 के साथ Part 5 का Northstar build पूरा system है। इसे पढ़ने में लगभग दो घंटे और keyboard पर कुछ घंटे लगेंगे। Parts 3 और 4 इसे केवल working नहीं बल्कि trustworthy बनाते हैं, और दोनों ज़रूरी हैं: Part 5 हर concept को सच में चलाता है। पहले build और बाद में उसका कारण पढ़ना चाहते हैं? Part 5 से शुरू करें।
📚 शिक्षण सहायता
इस course की slideshow तैयार की जा रही है।
अपना environment एक बार setup करें
आप जो कुछ बनाएँगे वह एक folder में है, और पहले से wired है।
context-layer-base.zip download करें
इसे unzip करें। अंदर पूरा Northstar case connect होने के लिए तैयार है, governance files भरने के लिए तैयार हैं, और तीन MCP server skeletons हैं जिनके मुश्किल हिस्से TODO से marked हैं:
fixtures/          two governed records, live state, working context
                   plus PLANTED.md, the answer key for Part 5
governance/        authority map, model register, permission matrix,
                   production gates, boundary contract
mcp/               vertical_sor, customer_state, context_gateway
prompts/           the Context Router instruction file
evals/             ten cases, scored on eight dimensions
scripts/           the governed schema for your existing Neon project
AGENTS.md          the standing rules your agent reads every session
.env.example       every credential this course needs, and nowhere else to put them
cd context-layer-base
cp .env.example .env
इस course में पिछले course से ज़्यादा credentials हैं, और इनमें से हर एक single commit में customer का trust खोने का रास्ता है।
| Secret | यह क्या खोलता है |
|---|---|
| Neon pooled connection string | आपका governed record |
| Model provider API key | आपका model spend |
| Onyx admin login | पूरा corpus |
| Onyx API key | उस key की access के अनुसार search |
| Onyx MCP token | Optional, केवल Part 7 में native-endpoint comparison के लिए |
| Context Gateway tokens | हर role के लिए एक, server-side mapped। यही permission boundary है |
Onyx admin login को छोड़कर इनमें से हर secret .env में रहता है, जिसे .gitignore पहले से exclude करती है। Admin login आपके password manager में होना चाहिए। इनमें से कुछ भी committed file, paste किए prompt या किसी classmate के लिए screenshot किए terminal output में नहीं होना चाहिए।
अपने agent को साफ़ बताएँ: credentials environment से पढ़ें, commit की जाने वाली file में कभी न लिखें और कभी print न करें। Approve करने से पहले diff check करें।
शुरू करने से पहले cost। अगर आपने पिछला course किया है, तो कुछ नहीं।
| चीज़ | Cost |
|---|---|
| Onyx Community Edition | free, MIT core |
| Neon | free tier, credit card की ज़रूरत नहीं |
| Model provider | इस course के लिए free tier काफ़ी है |
कितना समय लगेगा। Parts 1 और 2 को पढ़ने में लगभग दो घंटे और keyboard पर दो या तीन घंटे लगेंगे। Concept 4 की install में लगभग बीस मिनट waiting है, जिसमें ज़्यादातर image pulls हैं। Part 5 का Northstar build एक लंबा दिन लेता है, और अगर यह आपका पहला MCP server है तो उससे भी ज़्यादा। इसे एक sitting में पूरा करने की कोशिश न करें। अच्छा split है: पहले Onyx और connectors, फिर governed record और उसके दो MCP servers, और अंत में gateway व Router। हर group अपने-आप में एक lesson है। तीनों को एक शाम में भरने से लोग यह मान लेते हैं कि वे इसमें अच्छे नहीं हैं।
Folder के अलावा machine पर तीन चीज़ें चाहिए। Docker, क्योंकि Onyx containers के set के रूप में चलता है। Python वाले हिस्से के लिए uv। और आपका agent। इसे folder के अंदर खोलें:
cd context-layer-base
claude
cd context-layer-base
opencode
शुरू करने से पहले एक warning, क्योंकि यह तय करती है कि आप इसे कहाँ चलाएँगे।
Onyx असली infrastructure है। Standard deployment एक साथ लगभग बारह containers शुरू करती है: web frontend, API backend, nginx proxy, Postgres, search index, Redis, object storage, दो model servers (एक indexing और एक inference के लिए), code interpreter और background sync workers।
इसके लिए कई gigabytes RAM चाहिए। बाकी सब open रखकर modest laptop पर यह comfortable नहीं है। Class में इसे संभालने के तीन तरीक़े हैं, preference के क्रम में:
| तरीक़ा | किसके लिए बेहतर | Cost |
|---|---|---|
| आपकी institution का चलाया एक shared lab instance | पूरी cohort, सबके लिए reachable एक Onyx से connect करना | एक machine, एक बार |
| Local minimal deployment, केवल एक connector | वह week जब internals देखने और code पढ़ने की ज़रूरत हो | आपकी अपनी RAM |
| Onyx Cloud trial | एक cohort week या ऐसा laptop जो इसे चला नहीं सकता | 14-day trial, card नहीं |
Internals वाला week local करें, भले बाकी सबके लिए lab instance इस्तेमाल करें। Sync चलते समय connector का code पढ़ना ऐसा lesson है जो कोई hosted service नहीं दे सकती।
Part 1: Foundations
कुछ install करने से पहले चार ideas समझें।
आपका पिछला store छोटा और safe था, क्योंकि उसमें सब कुछ आपके control में था। Company के sources ऐसे नहीं होते। वे चार प्रकार के होते हैं, और उन्हें आपस में मिलाना इस build की सबसे महँगी ग़लती है। आप Onyx इस्तेमाल करेंगे। वह चीज़ें ढूँढने में अच्छा है और यह तय करने में ख़राब कि सच क्या है। Onyx के दो install modes भी हैं, जिनमें से एक चुपचाप उन हिस्सों को बंद कर देता है जिनके बारे में यह course है।
1. Scope की छलाँग: एक store से सबके sources तक
इसे पढ़ते समय Northstar का सवाल याद रखें, क्योंकि आपका पिछला build इसे छू भी नहीं सकता था।
क्या Northstar को बीस प्रतिशत discount मिल सकता है, अभी invoice हो सकता है, और revenue इसी quarter में recognise किया जा सकता है?
आपके Postgres store में कुछ नहीं जानता कि Northstar क्या है। वह नहीं जानता कि किसने क्या approve किया, acceptance कब आई या पिछले मंगलवार sales manager ने email में क्या कहा। यह आपके build की कमी नहीं है। यह अलग तरह का system है।
आपके store में चार properties थीं जिन पर शायद आपने ध्यान नहीं दिया, क्योंकि उनके बारे में सोचने की ज़रूरत नहीं पड़ी।
उसमें सब कुछ आपने लिखा था। हर document आपके docs/ folder से आया। ऐसी कोई चीज़ नहीं आई जो आपने न रखी हो। उसका एक reader था। आपका app जो allow करता था, store भी वही allow करता था। उसमें truth का एक प्रकार था। हर चीज़ आपका लिखा document थी और सबका weight बराबर था। उसमें live balance, signed obligation या email में किसी की opinion नहीं थी। कोई content ऐसे नए version से चुपचाप replace भी नहीं हुआ था जिसे आपने देखा न हो। और वह construction से current था, क्योंकि केवल आपका worker उसे लिखता था।
Company connect करते ही ये चारों properties एक साथ चली जाती हैं।
अब content उनका है, जिसमें कुछ ग़लत और कुछ superseded है। अब first-year junior और partner वही सवाल पूछते हैं, लेकिन उनके answers अलग होने चाहिए। अब corpus में signed contract, policy memo, chat message और live invoice status हैं, जिनका weight बहुत अलग है। Tuesday को index किया document Wednesday को कोई ऐसा व्यक्ति replace कर सकता है जो आपको कभी बताएगा भी नहीं।
Northstar इन चारों को concrete बनाता है। Contract और CRM उनके हैं। Discount पर account executive और VP को अलग answers मिलने चाहिए। Signed contract, policy memo, email और live approval status का weight बहुत अलग है। Worker answer compose कर ही रहा हो, तभी approval status बदल सकती है।
यही scope jump है, और इसीलिए build का shape अलग है।
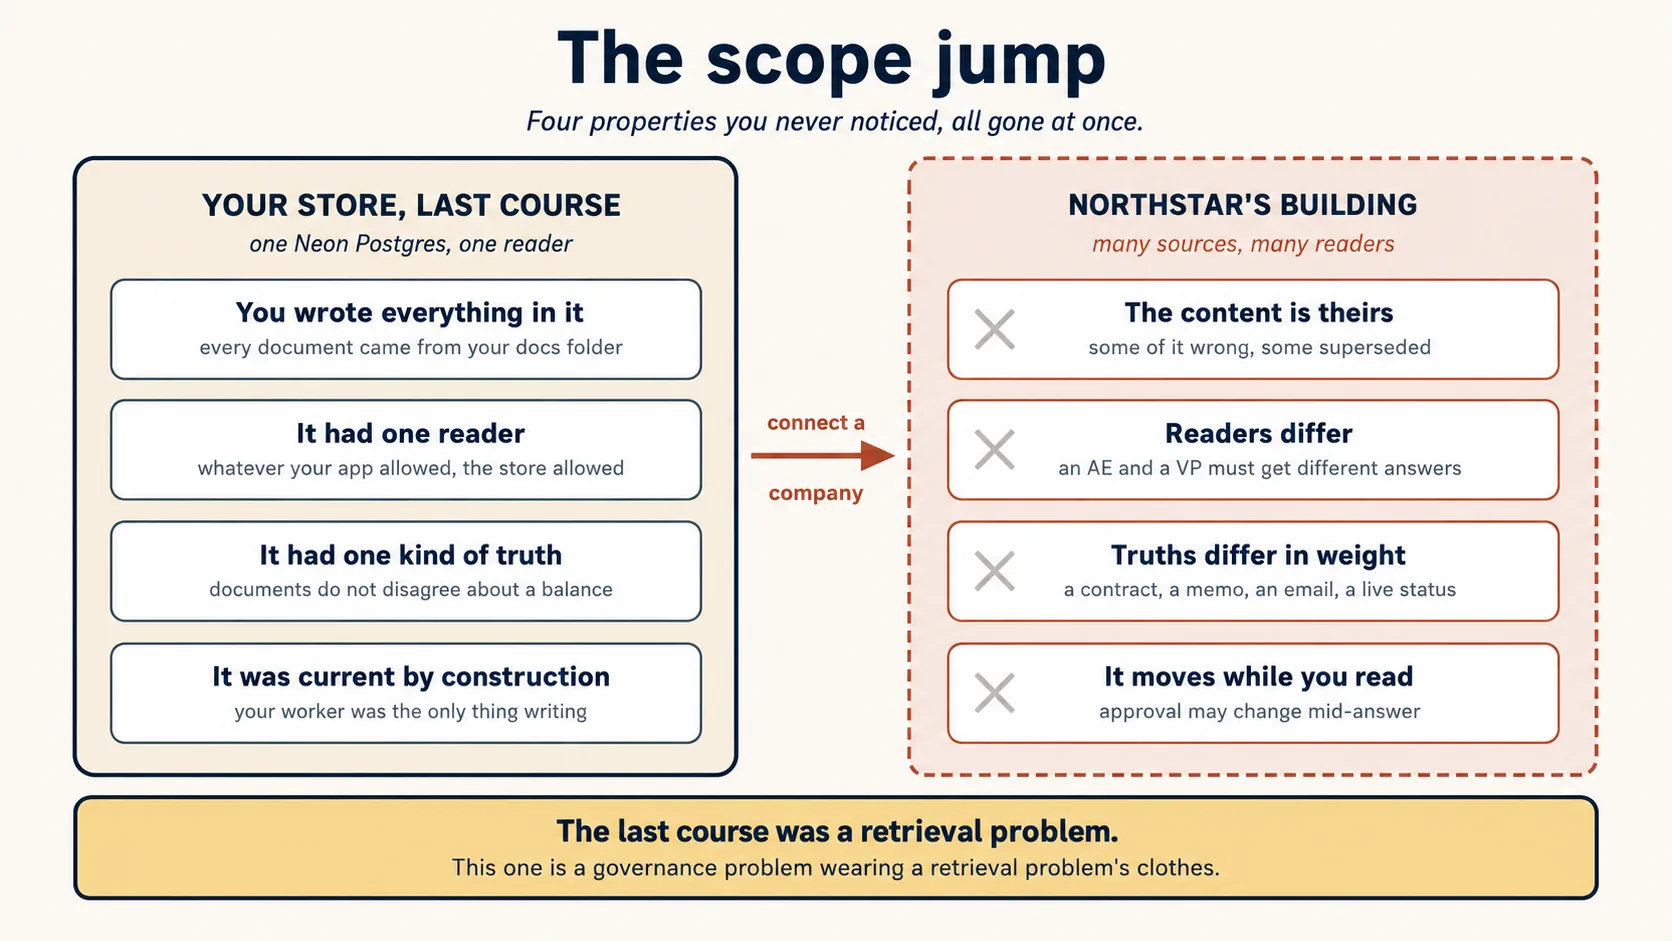
पिछला course retrieval problem था। यह governance problem है जिसने retrieval problem के कपड़े पहने हैं।
इसमें आपका काम हमेशा जैसा ही है: आप agent को direct करते हैं और उसके output को judge करते हैं। लेकिन judgment बदल जाता है। अब आप मुख्य रूप से यह नहीं पूछ रहे कि सही chunk मिला या नहीं। आप पूछ रहे हैं कि क्या हर returned item बताता है कि वह कहाँ से आया, क्या इस reader को वह मिलना चाहिए, और क्या किसी चीज़ ने confirm किया कि वह अभी भी लागू है।
2. चार source classes और उनके आने के अलग तरीक़े
इस build की सबसे महँगी single mistake हर connected system को बिना फ़र्क़ वाली एक pile मानना है। कुछ connect करने से पहले उन्हें चार classes में बाँटें, क्योंकि class तय करती है कि content कैसे fetch होगा और Worker उसके साथ क्या कर सकता है।
| Class | Examples | यह कैसे आता है | क्या Worker इसे cite कर सकता है? |
|---|---|---|---|
| Agent Factory System of Record | Shared method और standards | Discovery के लिए Web-indexed, canonical page को cite किया जाता है | हाँ, shared method के रूप में |
| Vertical Systems of Record | आपके Neon record में Northstar के sales और accounting rules | Discovery के लिए indexed, फिर MCP पर confirmed | हाँ, governing rule के रूप में |
| Customer operational records | ERP, CRM, ledger, contract system | Live typed query, कभी indexed नहीं | हाँ, अपने current state के लिए, timestamp के साथ |
| Customer working context | Email, chat, files, project trackers | Permission-aware indexing | क्या कहा या किया गया उसके evidence के रूप में, rule के रूप में कभी नहीं |
इस table से दो बातें याद रखें।
पहली तीनों अलग सवालों पर authoritative हैं। Vendor की एक आम line कहती है कि traditional record "केवल data store करता है" जबकि context layer उसकी interpretation करती है। Finance director के सामने इसे न दोहराएँ। उनका ERP transactional integrity, approval limits और audit trail enforce करता है, और इन्हीं controls की वजह से business operate कर सकता है। Gap seriousness की नहीं बल्कि scope की है: record अपने domain के बारे में complete है और उसके आसपास के profession पर silent है।
केवल चौथी class में governing professional authority नहीं है। यह precision ध्यान रखें। Email और chat अक्सर access controls, retention rules, privacy policy, legal holds और records-management requirements से governed होते हैं। उनके पास professional question settle करने की authority नहीं होती।
यही वह class भी है जिस पर सब पहले search tool point करते हैं। इसीलिए इतने pilots fluent answers बनाते हैं जिनके पीछे कुछ नहीं होता।
Glean चौथी class और तीसरी class के कई systems के लिए native connectors देता है। जिन systems को वह cover नहीं करता उनके लिए Indexing API देता है। आप custom datasource define करते हैं, content, metadata और permissions वाले documents push करते हैं, फिर admin console में उसे activate करते हैं।
Glean आपकी चार classes तय नहीं करता। वह हर datasource को KNOWLEDGE_HUB, EMAIL, MESSAGING, CRM, TICKETS और कई दूसरी categories से tag करता है, लेकिन ये categories ranking और page पर result rendering tune करती हैं। इनमें से कोई नहीं बताती कि source को governing rule के रूप में cite किया जा सकता है या नहीं। हर source की class और इसलिए Worker उसे किस रूप में cite कर सकता है, अब भी आपका design decision है। Onyx आपको यह महसूस कराता है क्योंकि separation आप हाथ से बनाते हैं। Glean इसे skip करने देता है, और इसी कारण कई Glean deployments भी flat pile बन जाती हैं।
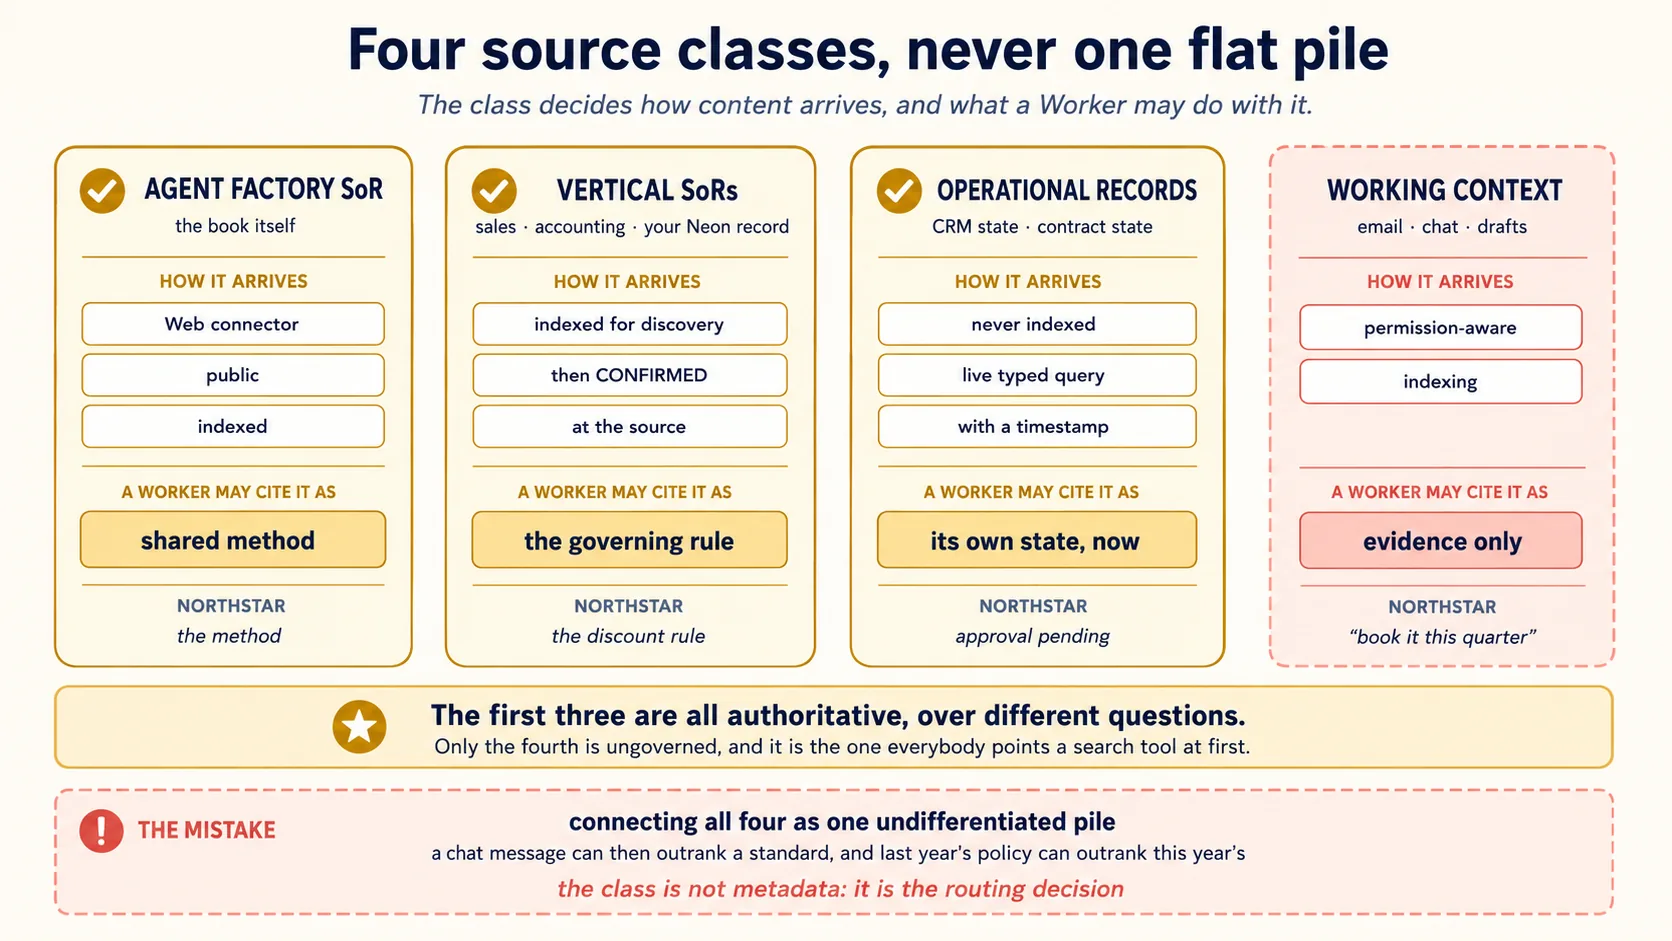
चार classes के पक्ष में पूरा argument और पहली तीन अलग questions पर authoritative क्यों हैं, यह Authority is scoped across many records में है।
आप जिस profession में भी काम करते हों, पहला connector run होने से पहले अपने असली sources के लिए यह table लिखें। Concept 12 में यही routing map बनेगी।
3. Onyx क्या है और क्या नहीं है
Onyx अपने आपको आपके docs, apps और लोगों से connected open-source AI chat कहता है। यह course इसे System of Context का open reference implementation मानता है। यह framing हमारी है, उनकी नहीं। Onyx कई sources connect करता है, synchronised copies रखता है, meaning और keyword से search करता है, cited answers लौटाता है, और agents व actions expose करता है। इसका core MIT-licensed और सच में self-hostable है। इस course में इसे चुनने का यही पूरा कारण है। आप connector code पढ़ सकते हैं, sync run देख सकते हैं और permission check कहाँ fire होती है यह देख सकते हैं। यह real companies में real scale पर चलता है, इसलिए यहाँ सीखी चीज़ें interview में पहचानी जाएँगी।
यह तीन चीज़ें नहीं है, और हर एक उस चीज़ से map होती है जिसे आप ख़ुद बनाएँगे।
यह आपका System of Record नहीं है। Onyx finding के लिए copies रखता है। आपका governed record citing के लिए originals रखता है। यही एक नियम है: layer authority को carry करती है, hold नहीं करती। इसे उलटा कर दें तो corpus current दिख सकता है, जबकि Worker ऐसे index से पिछले साल का rule quote कर रहा होगा जिसे update कभी मिला ही नहीं।
यह permission system नहीं है। जिस edition में support हो वहाँ यह permissions inherit करता है, लेकिन आपके profession के controls को ख़ुद enforce नहीं करता। Part 2 में इसे गंभीरता से लिया जाएगा।
यह answer नहीं है। Retrieval hit एक pointer है। वह कहता है: यहाँ देखें। Pointer को answer बनाने के लिए दूसरा step चाहिए, और Concept 10 वही call है।
और एक चीज़ जो Onyx नहीं है, लेकिन Onyx की किसी भी चीज़ से जल्दी आपका build तोड़ सकती है:
आपका Worker language model पर चलता है। Retrieval से कुछ न मिलने पर वह अपने knowledge से professional question का answer देगा। Output grounded answer जैसा ही दिखेगा। कहीं कोई error नहीं आएगी।
Model के पास source नहीं, weights होते हैं। उसके answer के पीछे कोई register row नहीं है: publisher, authority class, jurisdiction, version या effective period नहीं, और उसके अंदर एक statement को correct करने का रास्ता नहीं। Plausibility provenance नहीं है।
Build करते समय तीन quiet leaks पर नज़र रखें:
- Gap fill। Retrieval कुछ उपयोगी नहीं लौटाता और model फिर भी answer देता है।
- Drifting paraphrase। Model सही rule retrieve करता है और restate करते हुए threshold या condition खो देता है।
- Persistent memory। Sessions के बीच facts carry करने वाला model ऐसा unversioned store बन गया जिसका owner कोई नहीं है।
Fix prompt नहीं, structural है। Missing evidence packet का explicit field है, और governing source न ढूँढ पाने वाला Worker आगे बढ़ने के बजाय escalate करता है। पूरा argument concept page में है।
Complete तब है जब: आप बिना देखे बता सकें कि इन तीनों में से हर एक किस सवाल का answer देता है। Confirmation call किस समस्या को fix करती है। Permission gate किस समस्या को fix करता है। और आपका Neon record index के बाहर क्यों रहता है।
Glean सबसे जाना-पहचाना commercial System of Context है। आप इसे यहाँ deploy नहीं करेंगे, फिर भी इस पर एक घंटा देना उपयोगी है।
इसके दो कारण हैं। पहला, Glean ने current enterprise AI market में system of context phrase को popular किया है और इसे अपनी enterprise data layer का नाम बनाया है। यह किताब phrase को जानबूझकर अपनाती है, ताकि graduate buyer के office में वही language बोले जिसे buyer पहले से इस्तेमाल करता है। Glean ने term coin किया या नहीं, यह अलग सवाल है और यहाँ claim करने लायक नहीं। दूसरा, market ने इसी product के ज़रिए इस layer की price तय की है। Company "enterprise AI search", "work assistant", "AI knowledge layer" या "enterprise context platform" माँग सकती है। ये सब इसी category की ओर इशारा करते हैं, और सामने बैठे व्यक्ति ने लगभग निश्चित रूप से Glean demo देखा होगा।
इसलिए उसके product pages को doctrine की तरह नहीं, diagnostic की तरह पढ़ें। एक सवाल पूछें:
इस course की architecture के कौन-से हिस्से product सच में implement करता है, और कौन-से हिस्से चुपचाप आपके लिए छोड़ देता है?
यह सवाल उसकी connector list, permission model, citation format और action surface पर लगाएँ। आपको वही चार source classes, वही permission problem और वही discovery-versus-confirmation gap मिलेगा जिसके आसपास आप build करने वाले हैं।
पढ़ते समय एक habit रखें। Category के नाम बार-बार और अलग analysts ने एक ही समय पर बदले हैं: insight engines, cognitive search, enterprise AI search, generative AI knowledge management। Layer सीखें, logo नहीं। शुरुआत के तीन सवाल list के हर product name से ज़्यादा समय तक रहेंगे। Graduation के समय market में जो भी होगा, आप उसे इन्हीं से judge करेंगे।
अब आगे अधिकांश concepts के अंत में छोटा Glean में note होगा। वह बताता है कि commercial product में वही idea कैसा दिखता है, और उससे भी उपयोगी बात: Glean आपके लिए कौन-से हिस्से करता है और कौन-से दोनों products पर आपके design work रहते हैं। आपसे Glean account की उम्मीद नहीं है। आपसे meeting में यह साफ़ बताने की उम्मीद है कि दोनों में क्या common है और कहाँ अलग हैं।
फिर Onyx ही क्यों, Glean क्यों नहीं?
इस सवाल के honest answer में तीन हिस्से हैं, और केवल पहला products के बारे में है।
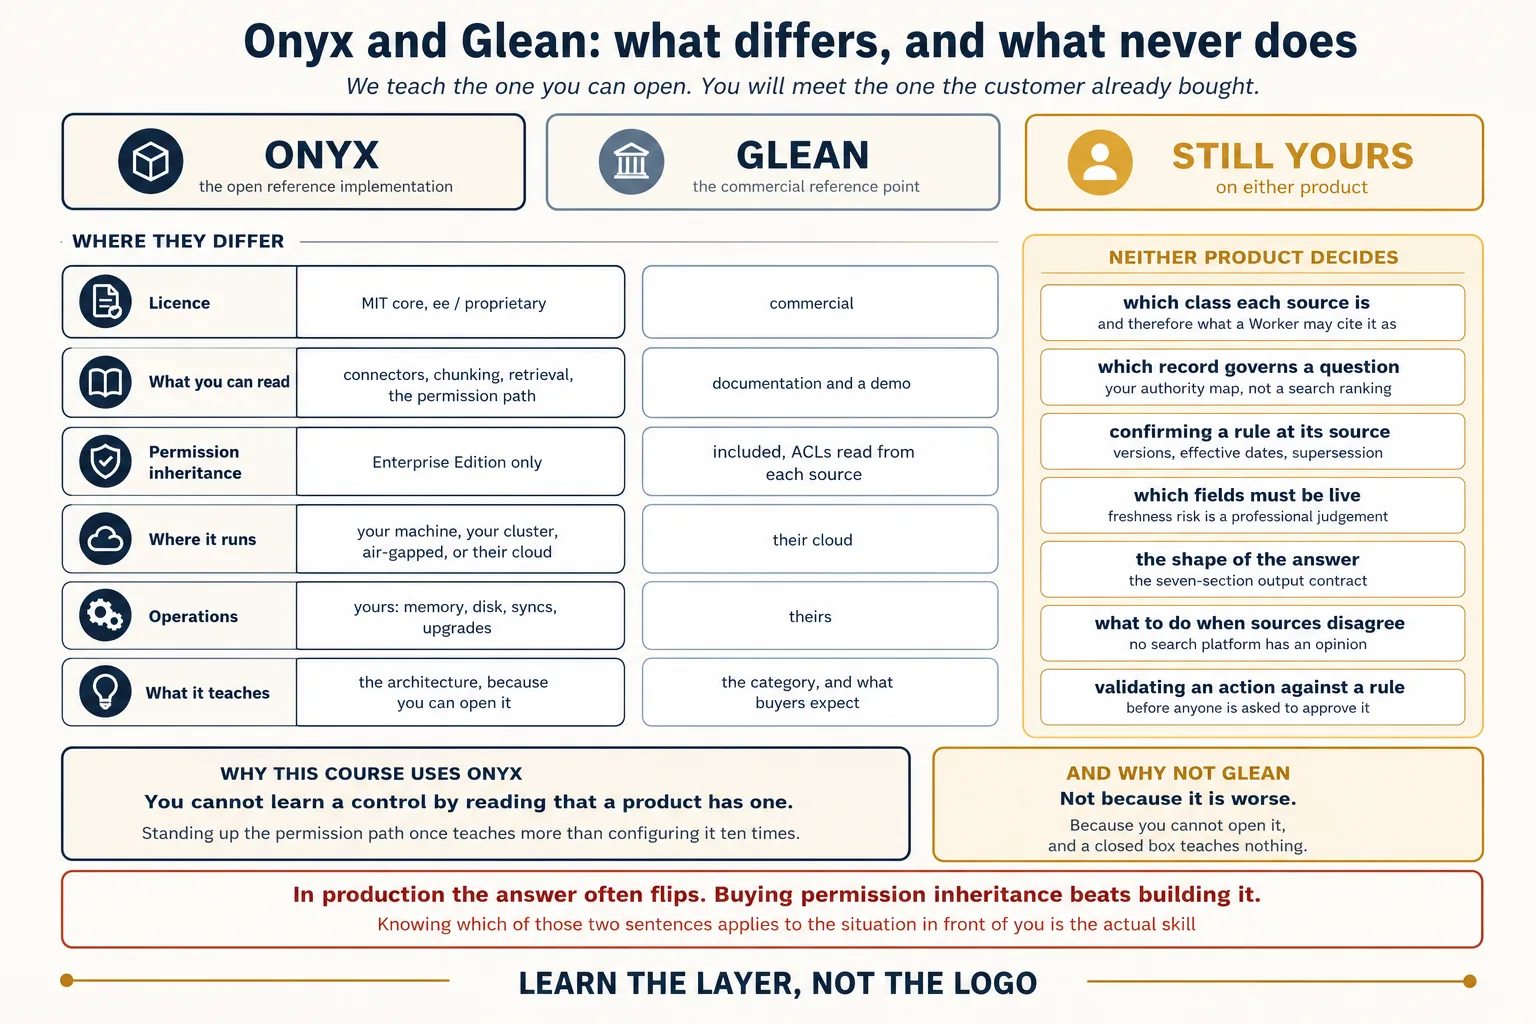
पहला, product में control होने की बात पढ़कर आप control नहीं सीख सकते। Glean का permission model Concept 9 में आपके बनाए model से बेहतर है। वह invisible भी है। आप configure करते हैं, वह काम करता है, और week के अंत में जानते हैं कि permissions हुईं लेकिन यह नहीं कि fail होने पर क्या होता है। ऐसा path एक बार imperfect तरीक़े से खड़ा करना जिसमें किसी role को कुछ नहीं मिलता, अच्छे path को दस बार configure करने से ज़्यादा सिखाता है।
दूसरा, closed box architecture नहीं सिखाता। इस course का हर concept ऐसी चीज़ है जिसे Onyx में जाकर देखा जा सकता है। Connector code पढ़ सकते हैं। Chunker को बारह controls फेंकते देख सकते हैं। Search को stale branch पर point करके perfect citations के साथ ग़लत answer आते देख सकते हैं। Product page से यह कुछ नहीं मिलता।
तीसरा, और students अक्सर यही चूकते हैं: इस course का अधिकांश हिस्सा product के बारे में है ही नहीं। ऊपर सुनहरा column देखें। आपकी बनाई सात चीज़ें न Onyx तय करता है न Glean, क्योंकि वे platform features नहीं बल्कि professional judgements हैं। Source किस class का है। Question को कौन-सा record govern करता है। Rule अभी current है या नहीं। दो sources disagree करें तो क्या करना है। Glean पर बना course यही सात चीज़ें सिखाएगा; केवल इनके नीचे की तीन चीज़ें कम दिखाई देंगी।
Customer को Glean कब इस्तेमाल करना चाहिए?
अक्सर। इसे साफ़ कहें, क्योंकि उलटा दिखावा पहली meeting में client का trust खो देगा।
अगर company को अगले quarter तक दर्जन भर SaaS systems में permission inheritance चाहिए, तो उसे ख़रीदना बनाने से कहीं बेहतर है। अगर platform team नहीं है, hosted self-hosted से बेहतर है। अगर उन्होंने Glean पहले से ख़रीदा है, तो आपका काम migration proposal देना नहीं है। आपका काम उनके governed record को उससे connect करना और बताना है कि current setup तीन में से किन सवालों का सच में answer देता है। Rebuild से यह बेहतर पहली conversation है, और केवल layer समझने वाला व्यक्ति यह conversation कर सकता है।
पूरे course का rule:
हम वह सिखाते हैं जिसे आप खोल सकते हैं। आप वह deploy करेंगे जिसे customer पहले से ख़रीद चुका है। Architecture दोनों में वही है, और केवल वही हिस्सा आपका है।
4. Standard install करें, Lite नहीं
Onyx के Lite और Standard deployment modes हैं, और ग़लत choice एक दिन बर्बाद कर देगी।
Lite छोटा chat interface है। वह vector index, background connector workers और वह पूरी infrastructure disable कर देता है जिसे यह course सिखाने के लिए बना है। Standard चुनें।
Installer Docker Compose से deploy करता है और mode पूछता है। Exact script बदलती रहती है, इसलिए guess करने के बजाय agent से current documentation पढ़वाएँ:
Current official Onyx Quickstart और Resourcing pages पढ़ें। इस machine के Docker CPU, RAM और free disk को documentation की requirements से check करें। इस course के लिए latest stable Onyx Community Edition को Standard mode में install करें और localhost से bind करें। Exact Onyx version, install method, ports और persistent data location को
README.mdमें record करें। Lite न चुनें। कोई container start करने से पहले plan और resource check दिखाएँ।
Plan में Standard और persistent data location दोनों हों तभी approve करें। Startup के बाद:
Running Onyx containers और logs inspect करें। Report करें कि कौन-सी services healthy हैं, UI किस port पर है और कौन-सी errors repeat हो रही हैं। Cause explain किए और exact command दिखाए बिना कुछ restart या recreate न करें।
Docker को कम memory मिलने पर Onyx Standard की search और indexing services restart, stall या health checks fail करती हैं। हर symptom configuration bug जैसा दिखता है।
उस machine पर config debug करने में एक घंटा न लगाएँ जिसे Docker के लिए केवल 4 GB मिला है।
Local lab के लिए useful Standard target कम-से-कम 4 virtual CPUs और 10 GB RAM है। 8 CPUs और 16 GB comfortable है। हमेशा resources पहले confirm करें।
Plan पढ़ें। Container list माँगने का कारण trivia नहीं है। Plan के बाद आपको तीन containers का नाम पता होना चाहिए। Memory खाने वाला vector index। First start पर slow model server। और background sync workers, जहाँ silently failing connector छिपता है। बाद में यही तीन आपको surprise करेंगे।
ध्यान रखें: first start कई gigabytes images pull करता है और model server को ready होने में कुछ minutes लगते हैं। यह expected है, hang नहीं। Stack चलने के बाद भी search कुछ न लौटाए तो लगभग हमेशा कारण यह है कि किसी connector की first sync पूरी नहीं हुई, न कि कुछ broken है। Container loop में restart हो तो configuration से पहले memory check करें।
Complete तब है जब: आप web interface खोल सकते हैं, first admin user से login कर सकते हैं, और वह single command जानते हैं जो पूरी चीज़ बंद करके disk reclaim करती है।
आपको कुछ install नहीं करना। Glean managed service के रूप में चलता है, या तो अपनी infrastructure पर या आपके GCP/AWS account के single-tenant deployment में। दूसरे model में भी Glean ही उसे deploy और patch करता है। इसलिए यह पूरा concept गायब हो जाता है, साथ ही container list, memory calculation और Part 7 की disk monitoring भी।
यही trade है, और इसे साफ़ कहना चाहिए। आप operations ख़रीदकर हटा देते हैं, और code पढ़ने की ability भी। एक बार Onyx खड़ा कर चुका student जानता है कि vector index की cost क्या है और sync चुपचाप कहाँ fail होती है। केवल hosted product इस्तेमाल करने वाला student दोनों नहीं जानता, और simplicity का vendor claim मान लेगा।
एक model, जानबूझकर चुना गया
Onyx context platform को language model से अलग रखता है। Admin Panel में एक capable provider configure करें और visible list छोटी रखें: आप context layer evaluate करने आए हैं, दस chat models compare करने नहीं। फिर agent से governance/model-register.md लिखवाएँ। इसमें provider, model, date, data-processing assumption, उसे कौन देख सकता है और उसे क्यों चुना, यह record होता है। एक field और रखें:
Replacement test। Stronger model tool use और answer composition सुधारता है। वह missing connector, wrong authority routing, stale operational facts या broken permission boundary repair नहीं कर सकता। ये context-layer failures हैं और कोई model upgrade इन्हें नहीं छूता। इस sentence को register में लिखें ताकि pressure में future-you इसे न भूले।
Tune करने से पहले search baseline
पिछले course ने retrieval के नीचे की machinery सिखाई थी ताकि आप उसे judge कर सकें। अब Onyx उस machinery को package करता है। Embedding models तुरंत swap न करें और हर experimental option enable न करें, क्योंकि embedding model बदलने पर full re-index करना पड़ता है। यह cosmetic toggle नहीं है। Stable defaults से शुरू करें और governance/search-baseline.md में Onyx version, embedding model, reranking configuration, baseline date, eval set version और reason record करें।
पिछले course का rule context-layer form में भी लागू है: retrieval changes evaluate होते हैं, admire नहीं। Onyx SQL छिपाता है। वह evidence की ज़रूरत नहीं हटाता।
/init run करें और output को चार lines तक trim करें। आप किस Onyx instance की ओर point कर रहे हैं। सभी credentials environment में रहते हैं, repo में कभी नहीं। इस course में कोई real customer data connect नहीं होगा। और एक hard rule पूरा लिखें:
ऐसा source कभी connect न करें जिसे मैंने इस session में explicitly approve नहीं किया।
Connector किसी का data copy करने की standing instruction है। उसे destructive SQL जितना review चाहिए।
Part 2: आपका पहला corpus
अब आप real content connect करेंगे और देखेंगे कि उसके साथ क्या होता है।
आप इस किताब से शुरू करेंगे, क्योंकि यह public है और permission नहीं माँगती। फिर Northstar नाम का fake customer बनाकर उसकी files connect करेंगे। ध्यान से देखेंगे कि search index ने क्या रखा और चुपचाप क्या फेंक दिया। फिर course की सबसे महत्वपूर्ण चीज़ बनाएँगे: ऐसा check जो तय करे कि हर व्यक्ति क्या ढूँढ सकता है।
हम एक छोटी synthetic company बनाएँगे: दो governed records, दो operational snapshots और email व chat वाला working-context folder। Synthetic होना जानबूझकर है, और Concept 8 समझाता है कि यह shortcut क्यों नहीं है।
5. पहले shared method, फिर customer connect करें
उस source से शुरू करें जिसे कोई permission नहीं चाहिए। Onyx का Web connector base URL के नीचे pages crawl करता है, reachable links follow करता है, text clean करता है और citation के लिए source metadata रखता है।
| Field | Value |
|---|---|
| Connector type | Web |
| Name | AF-SOR-PUBLIC |
| Base URL | https://agentfactory.panaversity.org/docs/getting-started |
| Source class | Agent Factory System of Record |
| Permission basis | Public |
हाँ, आप इसी किताब को index कर रहे हैं। यही उद्देश्य है। Agent Factory System of Record असली, public और governed source है। यही एक class है जिसे पहले दिन एक भी permission question के बिना connect किया जा सकता है।
हर governed source पर लागू एक बात। Index Worker को method ढूँढने में मदद करता है। Citation को original page फिर खोलना चाहिए।
Web-indexed chunk stable web address का pointer है, उसका replacement नहीं। यही find-then-confirm shape आप Concept 10 में ठीक से बनाएँगे।
अब customer। Northstar fixtures base folder में पहले से हैं, इसलिए उन्हें generate नहीं बल्कि connect करें। कुछ connect करने से पहले fixtures/ खोलकर पढ़ें कि उसमें क्या है:
| Folder | इसमें क्या है |
|---|---|
sales-sor/ | तीन governed sales rules, हर एक का stable ID, version और effective date। Discount rule account executive को 15 प्रतिशत तक allow करता है |
accounting-sor/ | चार governed accounting rules, जिनमें एक जानबूझकर superseded file कहती है कि revenue acceptance के बजाय billing पर recognise होता है |
operational/ | दो JSON records: approval pending, acceptance not received। इन्हें कभी index नहीं किया जाता |
working-context/ | तीन emails और दो chat threads। एक thread claim करता है कि finance ऐसी बात पर agree है जिसे कोई governed source support नहीं करता |
fixtures/PLANTED.md चारों planted inconsistencies की list है। उस file को index न करें, और Part 5 तक उसे ध्यान से न पढ़ने की कोशिश करें। वही answer key है।
अगर अपना corpus generate करना चाहें या testing के लिए दूसरा corpus चाहिए, तो यह prompt equivalent output बनाता है:
Northstar Services नाम के synthetic customer के लिए
fixtures/folder बनाएँ।
fixtures/sales-sor/के नीचे छोटा governed sales record बनाएँ: discount-authority rule जो कहे कि पंद्रह प्रतिशत से ज़्यादा discount के लिए VP Sales approval चाहिए, साथ में qualification method और proposal policy। Front matter में हर rule को stable ID, version और effective date दें।
fixtures/accounting-sor/के नीचे छोटा governed accounting record बनाएँ: implementation-revenue rule जो कहे कि revenue customer acceptance पर recognise होता है, साथ में दो supporting entries और वही front matter। फिर एक superseded file जोड़ें जो कहे कि revenue billing पर recognise होता है, earlier effective date और superseded-by link के साथ।
fixtures/operational/के नीचे दो JSON records बनाएँ: opportunity जिसमें twenty percent discount requested और approval pending हो, और contract जिसमें signature complete व acceptance not received हो।
fixtures/working-context/के नीचे तीन emails और दो chat threads बनाएँ। Sales manager का एक email कहे, "finance is fine with booking it this quarter", जिसे कोई governed source support नहीं करता।अंत में
fixtures/PLANTED.mdलिखें जिसमें जानबूझकर बनाई हर inconsistency listed हो, ताकि बाद में check किया जा सके कि system उन्हें ढूँढता है। उस file को index न करें।
Folders को एक नहीं, अलग-अलग connectors के रूप में connect करें:
| Connector | Source class | अलग क्यों |
|---|---|---|
VERTICAL-SALES-SOR | Vertical record | Discount authority को govern करता है |
VERTICAL-ACCOUNTING-SOR | Vertical record | Revenue recognition को govern करता है |
CUSTOMER-WORKING-CONTEXT | Working context | केवल evidence, authority कभी नहीं |
आप customer की material index करने वाले हैं। वह उन्हीं की रहती है।
Northstar के emails, chat threads और governed rules भी customer instance में customer content हैं। वे shared vertical record में migrate नहीं होते जिसे आप client से client तक ले जाते हैं। ऐसा करना contamination होगा: आपके profession का record किसी company की private material रखने लगेगा और फिर उसे कहीं और नहीं ले जाया जा सकेगा।
Material केवल promotion law से ऊपर जाती है: pattern तीन या ज़्यादा customers में repeat हो, de-identify किया जाए, promotion review pass करे, और आपकी expert उसे अपनी voice में फिर लिखे। यह authorship है, copying नहीं।
Connect करते समय यह rule रखें: customer की दुनिया अंदर आती है। कुछ बाहर नहीं जाता।
ध्यान दें कि उस table में क्या नहीं है। Operational JSON बिल्कुल connect नहीं होती। Concept 11 में उसे live serve किया जाएगा, और उसका कारण उस पूरे concept का विषय है।
ध्यान रखें: text के अलावा connector हर document के साथ वास्तव में क्या carry करता है। Local folder का file connector path और modified time देखता है, लेकिन कौन पढ़ सकता है इसके बारे में कुछ नहीं। Real SharePoint या Drive का connector access rules समेत बहुत कुछ देखता है। यही asymmetry Concept 8 का पूरा विषय है, और folder पर इसे देखना सबसे सस्ता तरीका है।
यह भी देखें: sync complete report करे लेकिन search कुछ न लौटाए, तो आम तौर पर पीछे indexing अभी चल रही होती है। Wait करके फिर search करें। Connector error दिखाए लेकिन search काम करे, तो old content index में रह गया है। यही Part 7 का trap है। Permission change propagate होने में भी थोड़ा समय लगता है, इसलिए access restrict करने के बाद document कुछ seconds visible रह सकता है।
Document Sets: search scope, legal ladder नहीं
Connector बताता है कि content कहाँ से आया। Document Set connectors के named group के लिए Onyx का term है। इससे बताया जाता है कि कोई particular search या Agent किन sources में देख सकता है।
| Document Set | इसमें क्या है | उद्देश्य |
|---|---|---|
AF Shared Method | AF-SOR-PUBLIC | Architecture और doctrine |
Sales Authority | VERTICAL-SALES-SOR | Governed sales rules |
Accounting Authority | VERTICAL-ACCOUNTING-SOR | Governed accounting rules |
Customer Working Context | CUSTOMER-WORKING-CONTEXT | Supporting evidence |
Northstar Cross-Domain | चारों | पूरा lab corpus |
ये तीन काम करते हैं। Scope visible बनाते हैं। Agent को केवल task के लिए ज़रूरी sources में search करने देते हैं। Cross-domain testing से पहले single domain में test करने देते हैं, जिससे routing bug और retrieval bug अलग दिखते हैं। एक warning:
Document Set search scope है, authority hierarchy नहीं। यह बताता है कि कहाँ देखा जा सकता है। क्या govern करता है, यह नहीं बताता।
क्या govern करता है, यह अलग file बताती है जो Concept 12 में आएगी।
Complete तब है जब: केवल Sales Authority scope में search करके revenue recognition पर कुछ वापस न मिले। इसका मतलब scope काम कर रहा है, और बाद में इससे routing bug व retrieval bug अलग पहचानेंगे।
6. Sync देखें और समझें कि chunker ने क्या फेंका
पिछले course से आप chunking जानते हैं, जहाँ dials size और overlap थे और stake recall था। यहाँ दूसरा stake है, और बड़ा है।
Governed record की entry अपने साथ बारह चीज़ें रखती है। Stable ID। Domain। Authority class। Jurisdiction। Version। Effective date। Approval status। Applicability conditions। Owner। Superseded-by link। Required checker। Permission boundary।
Generic indexing pipeline sentence बचा लेती है।
Revenue may be recognised when control transfers.
Words बच जाते हैं। बारहों controls चले जाते हैं, और retrieved text में कहीं नहीं दिखता कि वे missing हैं।
Worker अब छह चीज़ें नहीं बता सकता। Statement को कौन-सा standard govern करता है। वह इस contract type पर लागू है या नहीं। Current है या नहीं। इस country पर लागू है या नहीं। वह authority है या केवल explanation। और कौन-से exceptions answer बदलेंगे।
इसे अपने corpus पर देखें:
fixtures/accounting-sor/से वह rule लें जिसके front matter में version और effective date है। पहले raw document दिखाएँ, फिर exact दिखाएँ कि index में उसका एक chunk कैसा है: chunk text और उसके साथ stored हर field। साफ़ बताएँ कि कौन-से document-level facts chunk तक नहीं पहुँचे।
Complete तब है जब: एक chunk उठाकर उसके parent document के बारे में ऐसी true चीज़ बता सकें जो केवल chunk पढ़ने वाला Worker कभी नहीं जानेगा। यह gap Onyx का bug नहीं है। Concept 10 में confirmation step होने का यही कारण है।
Glean की Indexing API documents के साथ structured metadata attach करने देती है, और उसका knowledge graph लोगों, content और processes के relationships रखता है जिन्हें plain chunker फेंक देता है। इसलिए यह gap यहाँ Onyx से narrow है।
Narrow होना closed होना नहीं है। जब तक आप effective date, jurisdiction और superseded-by link fields नहीं देते और Worker को उन्हें check करना नहीं सिखाते, कोई product इन्हें नहीं जानता। बारहों controls दोनों cases में आपको carry करने हैं।
7. Search करें और देखें कि क्या मिला
Corpus में ऐसा सवाल search करें जिसका answer दो documents में फैला हो। Results उनके scores और sources के साथ दिखाएँ, फिर वही सवाल Onyx chat से answer करें ताकि attached citations दिखें।
अब discipline। हर result से तीन सवाल ज़ोर से पूछें, जब तक reflex न बन जाए:
यह कहाँ से आया? Onyx इसमें अच्छा है और citation सामने है। Check करें कि वह पहचाने हुए document की ओर point करता है।
क्या यह व्यक्ति इसे देख सकता है? अभी honest answer है कि सब कुछ सबको दिखता है, क्योंकि केवल आप user हैं और source folder है। यह thought चार minutes के लिए रखें।
क्या यह अभी भी govern करता है? Onyx नहीं बता सकता। उसे ऐसा document मिला जो words से match करता है। Document current है या नहीं, यह ऐसा सवाल है जिसका answer similarity score नहीं दे सकती। Try करें: Concept 5 में connect की superseded accounting file का topic search करें और देखें कौन-सा version वापस आता है।
Retrieval hit pointer है, answer नहीं। Parts 3 और 4 का हर हिस्सा pointers को ऐसे answers में बदलने के लिए है जिनका आप बचाव कर सकें।
यह किन items पर लागू है, इसमें precise रहें। Governed knowledge के पास वापस जाने के लिए original होता है, इसलिए उसका hit pointer है। Working context के पास ऐसा original नहीं: Tuesday को manager ने जो कहा उसका canonical version नहीं, और retrieved email ही item है। Working context को honest दूसरे दो सवाल रखते हैं: क्या यह व्यक्ति इसे देख सकता है, और क्या इसे rule के बजाय evidence के रूप में carry किया जा रहा है।
Complete तब है जब: superseded accounting file का topic search करके देख चुके हों कि कौन-सा version पहले आया। जो भी आया हो, अब आप जानते हैं कि Onyx ने currency के आधार पर यह decision नहीं लिया।
8. Permission inheritance और Community Edition की सीमा
यह course का सबसे महत्वपूर्ण और सबसे ज़्यादा skip किया जाने वाला concept है, क्योंकि इसे skip करने से लगभग छह weeks तक सब आसान हो जाता है।
Document के access rules उसके home system में रहते हैं। Private channel private है। Restricted folder restricted है। जब आपकी layer document copy करे, तो access rules भी साथ copy करे और हर query के समय पूछने वाले specific व्यक्ति के लिए उन्हें फिर check करे। Permission inherit होती है, invent नहीं। यह केवल privacy नहीं बल्कि control का सवाल क्यों है, इसे Permission comes before the model में समझाया गया है।
इसे ग़लत करें तो leak से भी ख़राब चीज़ बनती है: ऐसा system जो leak करने में helpful है। Junior reasonable सवाल पूछता है और first-ranked friendly summary में compensation memo पाता है जिसे वह कभी खोल नहीं सकता था। किसी ने attack नहीं किया। Layer ने बस wrong rules पर अपना काम किया।
Onyx Community Edition connectors, indexing, retrieval, citations, agents और actions सीखने के लिए काफ़ी है। अपने-आप में यह users के बीच production permission fidelity demonstrate करने के लिए काफ़ी नहीं है।
Onyx documentation बाहरी systems से user permissions inherit करने वाले permission-sync connectors, user groups, RBAC और group-based permissions को self-hosted Community Edition नहीं बल्कि Onyx Cloud और Enterprise Edition features बताती है। External systems से permission inheritance चाहने वाले deployments को Enterprise पर जाने का reason भी बताया गया है।
इसलिए pure Community Edition lab में हर student वही corpus देखता है। आप ऐसा demo stage नहीं कर सकते जिसमें restricted role पूछे और सही तौर पर कुछ न पाए। अगर cohort setup table वाला Onyx Cloud trial चलाती है, तो कर सकते हैं। एक week देकर real access-control sync को वह काम अपने-आप करते देखना उपयोगी है जिसे अब आप हाथ से करेंगे।
यह वह concept है जहाँ commercial product साफ़ तौर पर आगे है, और defensive होने के बजाय यह कहना चाहिए।
Glean हर connected system से content के साथ access-control list पढ़ता है और source पर already existing permissions enforce करता है। अगर Drive में file नहीं खोल सकते या Slack channel नहीं पढ़ सकते, तो वह results में नहीं आती और आपके लिए लिखे answer तक नहीं पहुँचती। उसकी Indexing API आपके content के लिए भी यही model देती है, जहाँ हर document पर per-user और per-group permissions और verification के लिए checkdocumentaccess endpoint है।
इसलिए Glean में इसे configure करते हैं। Onyx Community Edition में इसे build करते हैं, और वही Concept 9 है।
एक बार build करना बेहतर education है। ख़रीदना आम तौर पर बेहतर production decision है। सामने की situation पर दोनों में से कौन-सा sentence लागू है, यह जानना असली skill है।
इसे handle करने के तीन तरीक़े हैं, और यह course पहला चुनता है।
अपने boundary पर permission check ख़ुद enforce करें। Code आप लिखते हैं, इसलिए पूरा control आपका है। Access check implement करना उसे configure करने से बहुत ज़्यादा सिखाता है। यही Concept 9 है।
ee/ code पढ़ें। MIT न होने पर भी यह source-available है। Deploy किए बिना study करें कि real source से ACL inheritance वास्तव में कैसे implement होती है।
एक lab के लिए trial या licence इस्तेमाल करें। एक week, एक demonstration, फिर Community Edition पर वापस।
इससे एक non-negotiable rule निकलता है।
जब तक deployment Concept 9 का permission test set pass न करे, real corpus connect न करें। Employer की drive नहीं, client का system नहीं, अपना inbox भी नहीं। Permission के लिए कभी test न हुई layer partial system नहीं, बल्कि तेज़ system है जो wrong rules की ओर point कर रहा है।
9. Gate ख़ुद बनाएँ और ऐसे role से test करें जिसे कुछ नहीं मिलता
Community Edition per-user documents gate नहीं करेगी, इसलिए retrieval के सामने एक layer ऊपर gate बनाएँ। Production में भी यह सही जगह है: अपने boundary पर आप prove कर सकते हैं कि क्या हुआ।
लिखने से पहले एक honesty note। आप इन fixtures पर permissions invent करने वाले हैं, जो अभी सीखे rule का उलटा है। यह lab की property है, design की नहीं। Local folder inherit करने के लिए access rules carry नहीं करता, इसलिए किसी को वे state करने होंगे। Real deployment में source system यह काम करता है। यहाँ tagging उस inheritance की stand-in है जिसे Community Edition पर demonstrate नहीं कर सकते, और governance/production-gates.md में लिखेंगे कि वह अभी owed है।
Shape simple है, और order सब कुछ है।
1. Resolve identity        who is asking
2. Resolve permissions     what may this identity see, per source
3. Filter eligible docs    remove everything else, BEFORE retrieval
4. Retrieve and rank       search only what remains
5. Assemble the answer     with citations
6. Resolve action rights   separately, at the tool boundary
Unsafe order natural लगता है। सब retrieve करें। सब model को दें। फिर model को कहें कि reader जो नहीं देख सकता उसका mention न करे।
Model context के अंदर hidden passage hidden नहीं है।
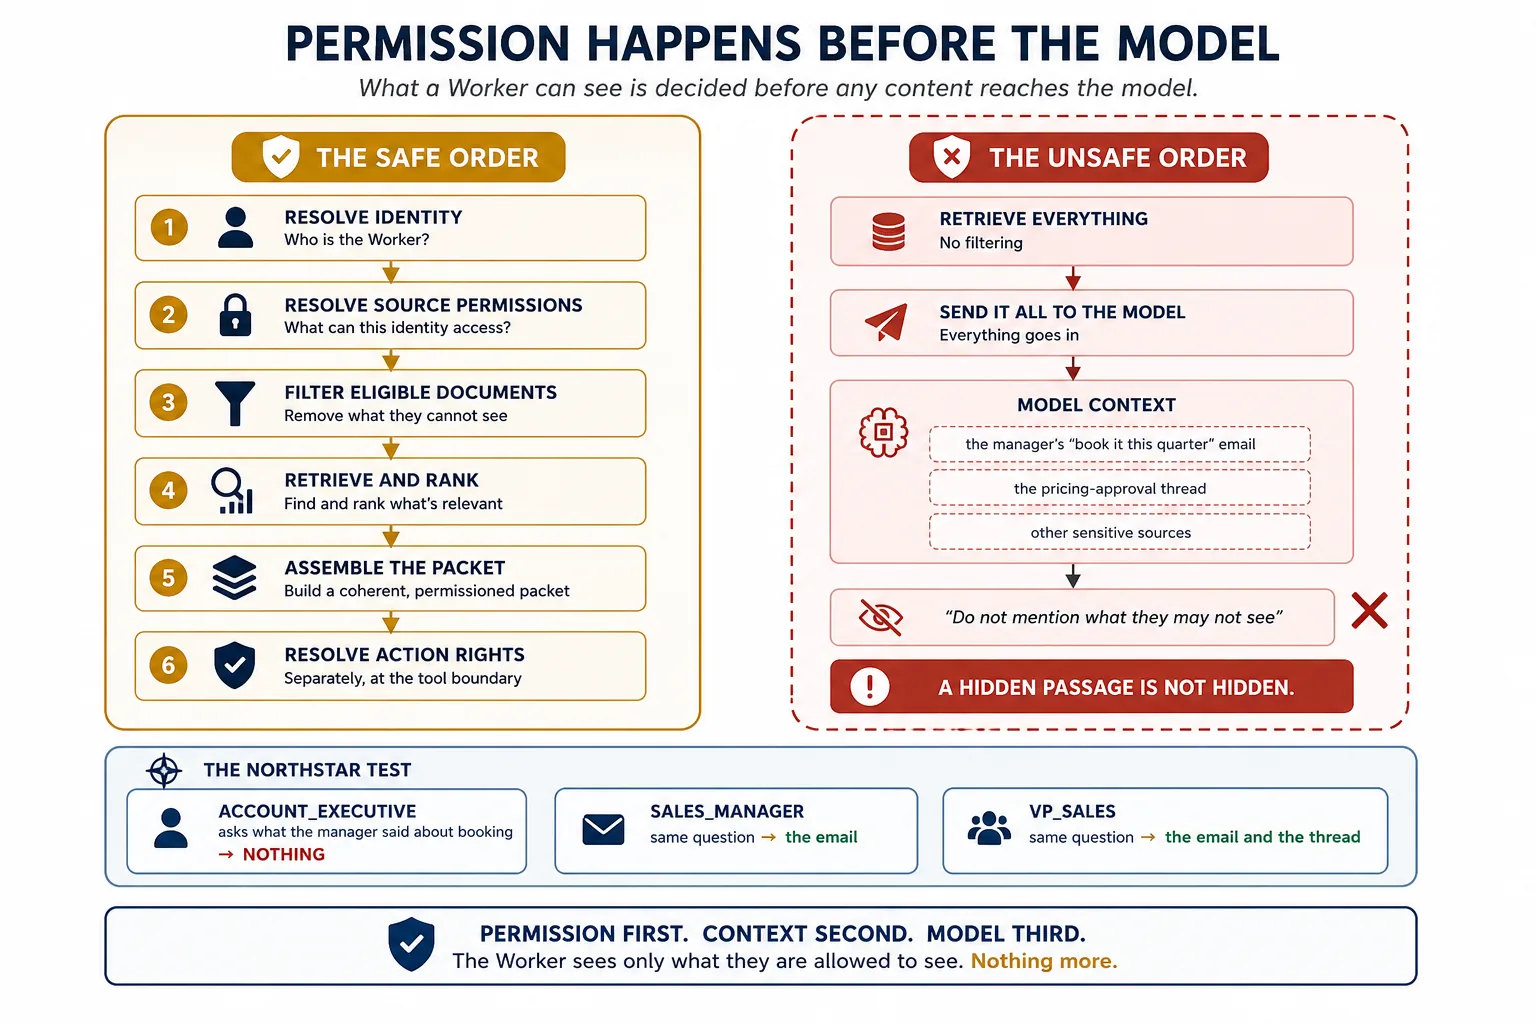
इसे बनाएँ:
governance/permission-matrix.csv हर source की row के साथ पहले से आती है। यही file gate enforce करता है और बाद में reviewer को दी जाती है।
Onyx retrieval के सामने access layer जोड़ें। Northstar-side के तीन roles define करें:
account_executive,sales_managerऔरvp_sales। हर fixture को उस minimum role से tag करें जो उसे पढ़ सकता है। Discount-authority rule तीनों पढ़ सकते हैं। Pricing-approval thread और manager का "book it this quarter" email केवलsales_managerऔर उससे ऊपर पढ़ सकते हैं। फिरsearch(query, role)function लिखें। Onyx call करने से पहले eligible document set को role से filter करें, बाद में कभी नहीं। हर result के साथ source और उस role को उसे देखने की अनुमति मिलने का reason लौटाएँ। Code path दिखाएँ जहाँ filtering होती है और prove करें कि कोई ineligible document model तक नहीं पहुँचता।
फिर वह test जो किसी retrieval benchmark से ज़्यादा मायने रखता है:
Permission test set बनाएँ: हर role और हर question के लिए एक row, जिसमें source में उस role को क्या दिखना चाहिए, layer ने क्या लौटाया और pass/fail record हो। महत्वपूर्ण Northstar case शामिल करें:
account_executiveके रूप में पूछें "sales manager ने इस quarter booking के बारे में क्या कहा", जहाँ सही answer कुछ भी नहीं है। Test run करके table दिखाएँ।
Complete तब है जब: तीनों roles बिल्कुल वही लौटाएँ जो वे देख सकते हैं, और manager के email के बारे में पूछने वाला account_executive कुछ न पाए। जो layer कभी nothing return नहीं करती, वह test नहीं हुई।
देखें इस एक test ने क्या protect किया। Manager का email वही hearsay है जिस पर पूरा Northstar case घूमता है। उसे retrieve कर सकने वाला account executive अपने manager की opinion को finance decision की तरह quote कर सकता है।
फिर दो बातें लिखें: lab में आज क्या true है और production में अब भी क्या चाहिए।
पहले governance/permission-matrix.csv। हर source की row। इसमें कौन पढ़ सकता है, permission कैसे enforce है और production-ready है या नहीं, यह record होता है:
source,student,teacher,production_employee,permission_mechanism,production_ready
Agent Factory SoR,read,read,read,public,yes
Sales fixture,read,read,not applicable,class-authorized,no
Accounting fixture,read,read,not applicable,class-authorized,no
Operational fixture,read,read,not applicable,synthetic MCP,no
Working context fixture,read,read,not applicable,synthetic files,no
और governance/production-gates.md, यानी security reviewer को दी जाने वाली list:
# Production permission gates
- [ ] Source permissions are synchronised or enforced before retrieval.
- [ ] Individual identity reaches live MCP and API tools.
- [ ] Search, chat, Agents, and external MCP clients enforce the same boundary.
- [ ] Revoked source access disappears within the accepted time window.
- [ ] A red-team test proves one user cannot retrieve another user's document.
- [ ] Connector credentials are encrypted and operationally protected.
दोनों लिखने का मतलब Community Edition limitation अब explicitly open gate है, hidden assumption नहीं। यही lab और liability का अंतर है।
अधिकांश domains में permission failure privacy problem है। Regulated profession में यह और नीचे तक जाता है। Precise रहना ज़रूरी है, क्योंकि loose argument ग़लत है।
Segregation of duties visibility नहीं बल्कि ability के combinations के बारे में है: journal entry create और approve दोनों करना, transaction originate और reconcile दोनों करना। Read access अकेले आम तौर पर ऐसा combination नहीं है। Context layer ने "segregation of duties तोड़ दी" claim करने पर controller के सामने argument हार जाएँगे।
Real exposure एक layer नीचे है। Access control वह foundation है जिस पर बाकी control environment खड़ा है। इसलिए auditors weak IT general controls को ऊपर के application controls पर doubt का reason मानते हैं। Firm की periodic access review certify करती है कि named user के पास specific entitlements हैं। आपकी layer उसे ऐसा content देती है जिसकी permission इन entitlements ने कभी नहीं दी। कुछ चोरी नहीं हुआ, documented rule formally नहीं टूटा, लेकिन review अब ऐसी picture certify कर रही है जो true नहीं है।
इसलिए यही argument करें, जो accurate भी है और stronger भी। Entitlement model के बाहर effective access देने वाली context layer एक control नहीं तोड़ती। वह उन सभी को certify करने वाली review को चुपचाप invalid कर देती है।
Part 3: Governed हिस्सा
Search pointer देती है, answer नहीं।
इस part में दूसरा half जोड़ेंगे। आपके Neon database को rules की छोटी governed table मिलेगी, हर rule के साथ version और date। फिर उसे tool के रूप में serve करेंगे, ताकि Worker index में मिले rule को original से पूछ सके: क्या यह अब भी rule है? Approval मिली या नहीं जैसे live numbers हर बार fresh पूछे जाते हैं।
10. अपना record MCP पर serve करें और two-call pattern बनाएँ
अब तक सब कुछ indexed discovery half था। इसमें governed knowledge भी है, क्योंकि आपने दो Vertical records और किताब index की है। लेकिन यह सब searchable copy के रूप में आया, और copy pointer है।
अब canonical और live half आता है, और उसका behavior बिल्कुल अलग है।
पहले record को authority दें
आपके Neon project में documents, chunks और embeddings हैं। उसमें अभी ऐसा rule नहीं है जिसे controller को cite किया जा सके, क्योंकि पिछले course को उसकी ज़रूरत नहीं थी। मौजूदा structure के साथ छोटा governed schema जोड़ें। इसी bootstrap पर बाकी part निर्भर है:
Base folder के scripts/ में required schema है। Prompt run करने से पहले उसे पढ़ें, ताकि आप देखी हुई चीज़ approve करें।
हमारे existing Neon project की
devbranch परgovernedschema औरruletable बनाएँ। Columns:stable_id,domain(sales या accounting),authority_class,jurisdiction,version,effective_from,effective_to,approval_status,superseded_by,ownerऔरbody।fixtures/से Northstar के sales और accounting rules load करें, जिसमें superseded accounting rule काsuperseded_bylink current rule की ओर हो। Branch commit करने से पहले rows दिखाएँ।
इनमें नौ columns Concept 6 के बारह controls हैं, जो अब description नहीं बल्कि real हैं।
दोनों professions एक table में domain column से separated हैं। इससे demonstration server simple रहता है। Concept 12 की routing भी visible काम करती है, क्योंकि कुछ confirm करने से पहले Worker को domain चुनना होगा।
फिर इसे serve करें
Northstar का accounting rule कहता है कि implementation revenue customer acceptance पर recognise होता है। उसका version और effective date है, और fixtures में अलग बात कहने वाली superseded file है। इस concept का हर हिस्सा इसलिए है कि Worker सही rule cite करे।
पिछले course का store पहले से चल रहा है: Neon पर छोटा Postgres, pgvector enabled, आपके documents और वह dev branch जिस पर आपने build किया। यहाँ उसमें कुछ नहीं बदलता। बदलता है कि उस तक कौन पहुँचता है।
यह crawl करने वाला folder नहीं है। किसी connector को इस पर point न करें। यह ऐसा source है जिससे पूछा जाता है। वैसे ही जैसे पिछले course के Part 6 में किया था।
Base folder का mcp/vertical_sor/ FastMCP skeleton है, जिसमें तीन tools stub हैं और मुश्किल हिस्से TODO से marked हैं। पहले पढ़ें, फिर agent से भरवाएँ।
Neon-hosted governed record को
vertical-sorनाम के FastMCP server में wrap करें। हर tooldomainargument ले, sales या accounting, ताकि एक server दोनों professions demonstrate करे। तीन read-only tools हों, और ध्यान रखें live customer state इनमें नहीं है:
search_rules(domain, query)candidate rules उनके stable IDs के साथ लौटाता हैconfirm_rule(domain, stable_id)authority class, jurisdiction, version, effective period, approval status और superseded-by link के साथ full current entry लौटाता हैvalidate_action(domain, action)proposed action को उस domain के rules से check करके blocking rule के साथ approved या refused लौटाता है Environment से pooled Neon connection string लें, read-only role से connect करें, और stateless mode में Streamable HTTP पर serve करें। इसका मतलब requests के बीच MCP session नहीं रखा जाता, इसलिए हर request को पिछले request के बिना answer किया जा सकता है। Code लिखने से पहले tool list और docstrings दिखाएँ।
एक server क्यों, दो क्यों नहीं। Production में हर profession का record अलग party के owned अलग system में हो सकता है, और domain argument future split की जगह है। Crash course में एक server path clear रखता है। दोनों professions के लिए rule confirm करने की exactly एक जगह है। Onyx की indexed copies उसकी projections हैं। Projection searchable copy है जो original ढूँढने के लिए रहती है। हर projected chunk stable_id, domain और version रखता है, ताकि confirmation call के पास lookup key हो।
Plan में दो Neon details check करें, क्योंकि दोनों lab में work और production में damage करती हैं। Server को -pooler host वाली pooled connection string इस्तेमाल करनी चाहिए, क्योंकि context layer कई short-lived connections खोलती है और direct endpoint उसके लिए नहीं है। Tables-owning role के बजाय read-only role से connect होना चाहिए। तब कोई tool argument उस record को बदल नहीं सकता जिसे उसे cite करना है।
Stateless HTTP FastMCP में constructor argument नहीं बल्कि run-time argument है। FastMCP("vertical-sor", stateless_http=True) FastMCP 2.x में valid था, 3.x में TypeError देता है, और model को 2.x form याद आने की संभावना ज़्यादा है। Current form:
from fastmcp import FastMCP

mcp = FastMCP("vertical-sor")

if __name__ == "__main__":
    mcp.run(transport="http", host="127.0.0.1", port=8101, stateless_http=True)
Server bare host के बजाय /mcp पर answer करता है। Client connect न होने पर यही detail एक घंटा लेती है। Plan approve करने से पहले agent से current FastMCP documentation के विरुद्ध दोनों check करवाएँ।
Branch habit रखें। इस course में record schema बदलते समय Neon branch पर काम और preview करें। Stale-copy demonstration के लिए branch सबसे सस्ता तरीका है। Record fork करें। Fork को जानबूझकर out-of-date होने दें। Discovery को उस पर point करें। फिर branch discard करें।
Tool list देखें। Naive design में जहाँ एक call होती, वहाँ search_rules और confirm_rule दो calls हैं, और यही split point है।
Discovery पूछती है: relevant information कहाँ हो सकती है? वह recall, similarity और speed के लिए optimise करती है। Output pointer है।
Confirmation पूछती है: इस decision पर officially कौन-सा source लागू है? वह domain, authority class, jurisdiction, version, effective date और approval status check करती है। Output answer है।
इसलिए sequence fixed है और उलटा कभी नहीं चलता:
search discovers → you route → the record confirms → the Worker cites
Discovery के लिए governed pages index करना useful है। Rule बिल्कुल न ढूँढ पाने वाला student copy ढूँढने वाले से बदतर है। Copy पर reliance कभी नहीं होना चाहिए। Doctrine Discovery is not confirmation है।
अब दोनों calls wire करें।
governing_rule(question)लिखें जोsearch_rulescall करे, top candidate का stable ID लेकर उस परconfirm_rulecall करे और confirmed entry लौटाए। Confirmed entry superseded हो तो link follow करके successor confirm करे। फिर वह failure demonstrate करें जिसे यह रोकता है। पूरे case के central rule का use करें: record की Neon branch बनाएँ, default branch पर implementation-revenue rule acceptance से billing में बदलें ताकि branch stale हो जाए,search_rulesको stale branch पर point करें जबकिconfirm_rulecurrent branch पर रहे, और पूछें Northstar का revenue कब recognise हो सकता है। दोनों answers side by side दिखाएँ। बाद में branch delete करें।
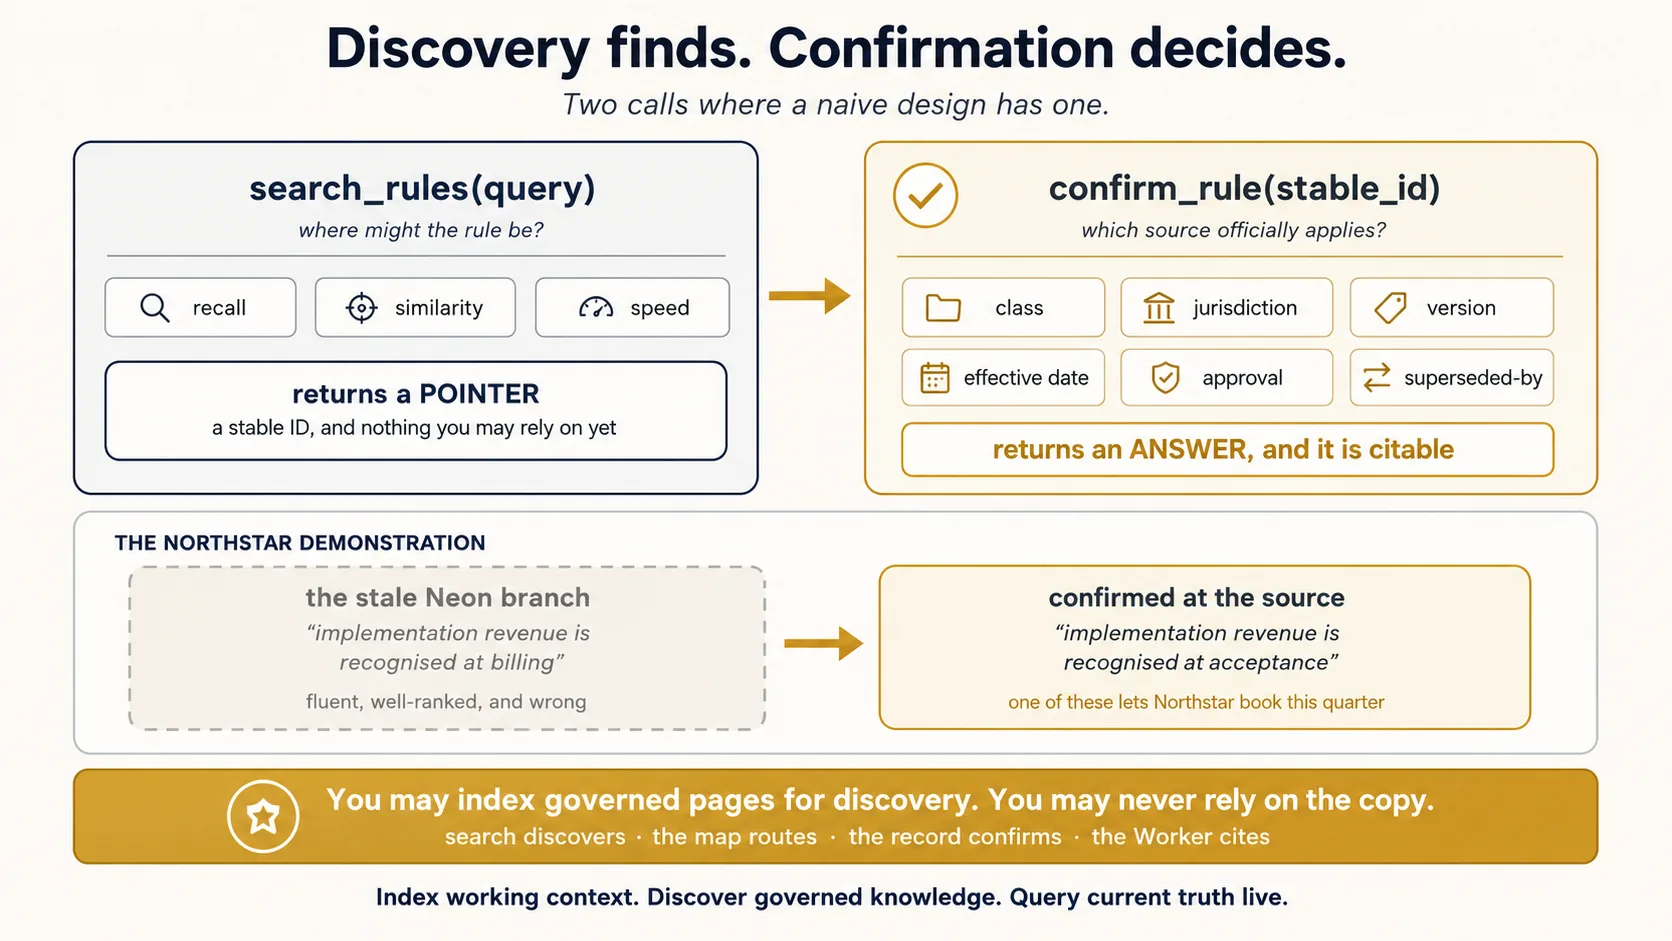
Complete तब है जब: stale branch को confidence से billing पर answer करते और confirmation call को उसे acceptance पर correct करते देख चुके हों।
इनमें से एक answer Northstar को इसी quarter revenue book करने देता है और दूसरा नहीं। यही पूरा अंतर इस course का विषय है। यह demonstration course की सबसे valuable चीज़ है।
यहाँ product आपके लिए यह काम नहीं करता, और page का सबसे important note यही है।
Glean बहुत अच्छी indexing और retrieval करता है, और एक currency signal रखता है: owner page verify कर सकता है, result badge दिखाता है कि किसने और कब verify किया, और dead page deprecate हो सकता है। यह document से attached human reminder है। यह आपके profession की authority classes, jurisdictions, effective periods या supersession links नहीं हैं, क्योंकि वे governed record की properties हैं, search platform की नहीं। इसलिए Glean deployment superseded rule को perfect citations, full permission fidelity और green verified badge के साथ लौटाकर भी ग़लत हो सकती है।
Confirmation call दोनों products पर आपको बनानी है। Glean Agents remote MCP server पर आपके confirm_rule tool तक Onyx Agent की तरह पहुँच सकते हैं, हालांकि writing के समय यह path beta में है और single-step selection के बजाय agent के plan-and-execute step में रहता है। Design में कुछ नहीं बदलता।
11. Live state हर बार पूछी जाती है
Balances, approval status, open items, current versions। इनमें से कुछ authored नहीं, कुछ stable नहीं, और सब exact हैं। इन्हें index करने का मतलब ऐसी चीज़ की rough ageing copy बनाना है जिसकी पूरी value current होने में है।
Rule एक sentence में है और हर engagement के design record में होना चाहिए:
अगर stale value conclusion, permission, payment, filing या customer action बदल सकती है, तो उसे live fetch करें।
तीन retrieval modes, यानी पूरी layer की compressed doctrine:
| Information | उस तक कैसे पहुँचते हैं |
|---|---|
| Working context | Permission-aware indexing |
| Governed knowledge | Discovery index, reliance से पहले confirmed |
| Current records और actions | MCP या API पर live typed query |
Working context index करें। Governed knowledge discover करें। Current truth live query करें।
एक source को अक्सर दो modes चाहिए। Contract document index होता है ताकि clauses मिलें। फिर contract system live query होता है ताकि मिला version अभी active है यह confirm हो।
Format और length कुछ तय नहीं करते। Freshness risk सब तय करता है।
कुछ connected systems के लिए Glean केवल indexed copy पर निर्भर होने के बजाय query time पर fresh data fetch कर सकता है, जो इसका कुछ हिस्सा automatically cover करता है।
कुछ, सब नहीं। आपके profession में कौन-से fields freshness-critical हैं, यह judgement कोई platform नहीं कर सकता, और यही आपने ऊपर design record में लिखा। Decision rule products के बीच आपके साथ जाता है।
Northstar के दो operational records को
vertical-sorसे अलग customer-state server पर serve करें:get_opportunityapproval status लौटाए औरget_contract_stateacceptance status। इन्हें अलग रखना चार source classes को physical बनाता है, क्योंकि Vertical record rules govern करता है और operational record state own करता है। फिर "क्या revenue recognise किया जा सकता है" दो बार पूछें: एक बार indexed snapshot से answer दें और दूसरी बार live call से। दोनों के बीच acceptance को not-received से received करें। Timestamps के साथ दोनों answers दिखाएँ।
Complete तब है जब: indexed और live answers disagree करें, और आप ठीक बता सकें कि controller के सामने कौन-सा रखा जाएगा।
Part 4: Routing और citing
Customer का एक सवाल अक्सर साथ छिपे कई professional questions होता है।
यह part Worker को उन्हें अलग करना, हर सवाल को उसे govern करने वाले record तक भेजना और लौटने वाली हर चीज़ label करना सिखाता है। सबसे मुश्किल habit भी यहीं है। दो sources disagree करें तो दोनों दिखाएँ। उन्हें एक comfortable sentence में smooth न करें।
12. Authority routing: इस सवाल को कौन-सा record govern करता है
Professional work कई तरह के questions पूछता है: क्या decide होना चाहिए, कौन-सा action permitted है, कौन-सा checker लागू है, कौन-सा evidence missing है। लेकिन context assemble करने के लिए ज़्यादातर evidence requests तीन forms में आती हैं, और हर एक का path अलग है।
| सवाल | Source | Path | क्या वापस आता है |
|---|---|---|---|
| Rule क्या है? | System of Record | Discovery, फिर confirmation | Class, jurisdiction और version के साथ cited governed truth |
| Number क्या है? | उसे own करने वाला system | Typed query | एक exact current value, timestamp के साथ |
| इस case के बारे में क्या कहा गया? | Working context | Permission-aware retrieval | Evidence, governing rule कभी नहीं |
जो Worker नहीं जानता कि वह कौन-सा सवाल पूछ रहा है, वह तीनों का answer एक तरीक़े से देगा और तीसरा path चुपचाप पहले दो को निगल जाएगा।
एक step और है, जो customer के एक से ज़्यादा governed records चलाने पर सबसे पहले आता है। Mid-sized firm के accounting, sales और HR records हो सकते हैं, तीन अलग लोगों के बनाए, और इनमें से कोई आपका नहीं। इसलिए routing पहले resolve करती है कि यह question किस profession का है, फिर उसके अंदर कौन-सा source है। Revenue recognise हो सकता है या नहीं, यह accounting question है, भले उसके सारे words sales conversation से आए हों।
Prompt से पहले map लिखें
Model को first-ranked chunk देखकर invent नहीं करना चाहिए कि कौन-सा source govern करता है। इसलिए routing table versioned artifact है जिसे पहले लिखते, review करते और रखते हैं। Base folder में governance/authority-map.yaml empty routes के साथ आती है। इसे भरें:
version: 1
updated_at: 2026-07-31

routes:
  shared_method:
    questions: [architecture, Agent Factory doctrine, implementation method]
    governing_source: AF-SOR-PUBLIC

  sales.discount_authority:
    questions: [requested discount, approval threshold, proposal permission]
    governing_source: VERTICAL-SALES-SOR
    confirm_with: vertical-sor.confirm_rule(domain=sales)
    current_state_tool: customer-state.get_opportunity

  accounting.implementation_revenue:
    questions: [revenue recognition, implementation acceptance, quarter-end treatment]
    governing_source: VERTICAL-ACCOUNTING-SOR
    confirm_with: vertical-sor.confirm_rule(domain=accounting)
    current_state_tool: customer-state.get_contract_state

rules:
  - working_context may support what was said or requested, but never governs a professional conclusion
  - indexed governed knowledge is discovered, then confirmed at the source before it is relied on
  - current state must be confirmed live before any action
  - conflicts are surfaced, never silently merged
  - missing authority or evidence becomes an explicit gap
इसमें हर name आपने पहले बनाया है: Concept 5 के connectors, Concepts 10 और 11 के tools। यह deliberate है। जिस routing map के sources किसी callable चीज़ तक resolve नहीं होते, वह diagram है, router नहीं।
File simple है क्योंकि job simple है। यह एक vague company question को named professional decisions में बदलती है, हर decision के named governing source के साथ। Production में map governed registry या Vertical SoR में रह सकती है। Course YAML इस्तेमाल करता है ताकि decision पहले hour से inspectable और versioned हो।
ऐसा
route(question)function बनाएँ जोgovernance/authority-map.yamlपढ़े, question को professional decisions में classify करे और हर decision के governing व current-state sources बताए। Routing decision को reason के साथ structured data के रूप में return करें, केवल tool call न करें। फिर Northstar question पर run करके routing table दिखाएँ ताकि केवल answers नहीं, reasoning भी check की जा सके।
ध्यान रखें: तुरंत act करने के बजाय decision return करना इसे reviewable बनाता है। केवल answers देने वाला router audit नहीं हो सकता।
Complete तब है जब: Northstar question कम-से-कम दो routed decisions बनाए, एक sales और एक accounting, और retrieval से पहले दोनों governing source बताएँ।
13. Provenance और citation envelope
Layer से लौटने वाला हर material item एक envelope carry करता है: text के साथ चलने वाले labels जो बताते हैं वह कहाँ से आया और उस पर reliance की जा सकती है या नहीं। इसके बिना packet text की pile है। इसके साथ packet reviewable evidence है।
| Field | क्यों ज़रूरी है |
|---|---|
| Source system | बताता है information का owner कौन है |
| Stable ID | Reviewer को exact item फिर fetch करने देता है |
| Authority class | Law, standard, contract, policy, transaction, guidance, message या example |
| Scope | कौन-से question, customer, jurisdiction और case को govern करता है |
| Version और effective period | Retired rules को चुपचाप वापस आने से रोकता है |
| Retrieved या synchronised at | बताता है item कितना fresh था |
| Permission basis | बताता है इस reader को item क्यों मिल सकती थी |
और fluent answer को honest रखने वाला rule:
Worker कोई भी permitted, task-relevant supporting context पढ़ सकता है। वह supporting context को answer govern करने वाले rule के रूप में कभी पेश नहीं कर सकता।
Email इस बात का evidence हो सकता है कि client ने कुछ माँगा। Prior working paper इस बात का evidence हो सकता है कि firm ने पिछले साल कुछ कैसे treat किया। इनमें से कोई requirement नहीं है।
Packet एक output contract है
Onyx Agent configured assistant है: behavior की instructions, searchable knowledge और callable tools यानी Actions। Northstar Context Router नाम का Agent बनाएँ।
अब वह हिस्सा जिसे ग़लत करना आसान है, और जो चुपचाप Concept 9 undo कर देगा।
Obvious move Northstar Cross-Domain को सीधे Agent से attach करना है, और वह तुरंत काम करता है। इससे दो retrieval paths बनते हैं, जिनमें एक अभी बनाए gate के आसपास से निकल जाता है:
SAFE     user  ->  permission gate  ->  filtered Onyx search
BYPASS   user  ->  Onyx Agent  ->  the whole attached Document Set
Agent का attached knowledge उसका searchable scope बनता है। Cross-domain set attach करने पर Agent किसी के लिए भी उसमें सब पढ़ सकता है, gate चाहे कुछ भी कहे।
इसलिए Router के साथ कोई role-sensitive knowledge attach नहीं होगा। उसे केवल Actions मिलेंगे।
उसे exactly पाँच Actions दें, और कुछ नहीं:
| Action | क्या करता है |
|---|---|
search_permitted_context(query) | आपका gateway। Action की credential से caller role resolve करता है, allowed Document Sets या tags apply करता है, फिर Onyx search call करता है |
confirm_rule(domain, stable_id) | vertical-sor से canonical confirmation |
get_opportunity(id) | Customer-state server से timestamp वाला live opportunity state |
get_contract_state(id) | उसी server से timestamp वाला live contract state |
validate_action(domain, action) | Proposal को governing rules से check करता है |
ऐसा
search_permitted_contextAction बनाएँ जो Onyx search API wrap करे। वह Action की configured credential से role पढ़े, tool argument से कभी नहीं। उस role से permitted Document Sets और tags derive करे, उन्हें search filters की तरह apply करे और उसके बाद query issue करे। Results के साथ हर result permitted होने का reason लौटाएँ। फिर Northstar Context Router बनाएँ जिसके साथ कोई Document Set attach न हो, केवल यह Action और चार MCP tools हों।
Role comparison कहाँ run करते हैं यह matter करता है। Action एक configured credential और इसलिए एक role carry करता है, इसलिए single Router वही question दो अलग लोगों की तरह नहीं पूछ सकता। यह wiring की property है, design gap नहीं, और हर host में यही constraint है। Gate को gateway पर prove करें, जहाँ identity सच में resolve होती है:
Gateway से ऐसी चीज़ माँगें जिसे केवल
vp_salesदेख सकता है, एक बारvp_salestoken से और एक बारaccount_executivetoken से, और दोनों results side by side दिखाएँ। फिर Router को Action के through वही question answer करते दिखाएँ, और बताएँ Router किस role की तरह बोल रहा है तथा आप यह कैसे जानते हैं।
नीचे का rule एक sentence है, वही पहले वाला rule एक layer ऊपर:
सारी indexed retrieval gateway से गुजरती है। अगर कोई component उसके बिना search कर सकता है, तो gate decoration है।
Default रूप से Glean agent उसे invoke करने वाले user की identity पर चलता है, इसलिए केवल वही देख और कर सकता है जिसकी user को पहले से permission है। अभी हाथ से बंद किया bypass उसी form में नहीं आता। Glean agent identity भी देता है, जहाँ agent user की identity borrow करने के बजाय administrator की granted scoped service credentials पर चलता है। Direction ध्यान रखें। यह unattended agent की reach administrator scope तक narrow करता है, widen नहीं।
दो चीज़ें अब भी आपकी हैं। सात-section output contract, क्योंकि fixed reviewable shape design decision है जिसे product impose नहीं करता। और authority routing, क्योंकि revenue question accounting का है, sales का नहीं, यह professional knowledge है, platform feature नहीं।
अब Router को prompts/context-router.md instruction file दें, जो इस fixed shape पर end हो:
Return exactly these sections:

## Decisions involved
## Governing authority
## Current facts
## Supporting context
## Conflicts and gaps
## Permitted next steps
## Citations
ये सात sections ही context packet हैं, और fixed shape दिखने से ज़्यादा काम करती है।
Onyx में Context Packet नाम का database object नहीं है। आप इसे एक task के stable output contract के रूप में implement करते हैं। Shape कभी नहीं बदलती, इसलिए reviewer seconds में answer scan कर सकता है। Eval harness हर section अलग check कर सकता है। Missing section silently absent नहीं बल्कि visible होता है। Empty Conflicts and gaps का मतलब router ने check करके कुछ नहीं पाया। Heading ही न हो तो उसने देखा ही नहीं।
Packet design से temporary है। Current facts बदल सकते हैं। Reader permissions बदल सकती हैं। Applicable version supersede हो सकता है। इसलिए इसे cache नहीं बल्कि हर बार rebuild किया जाता है।
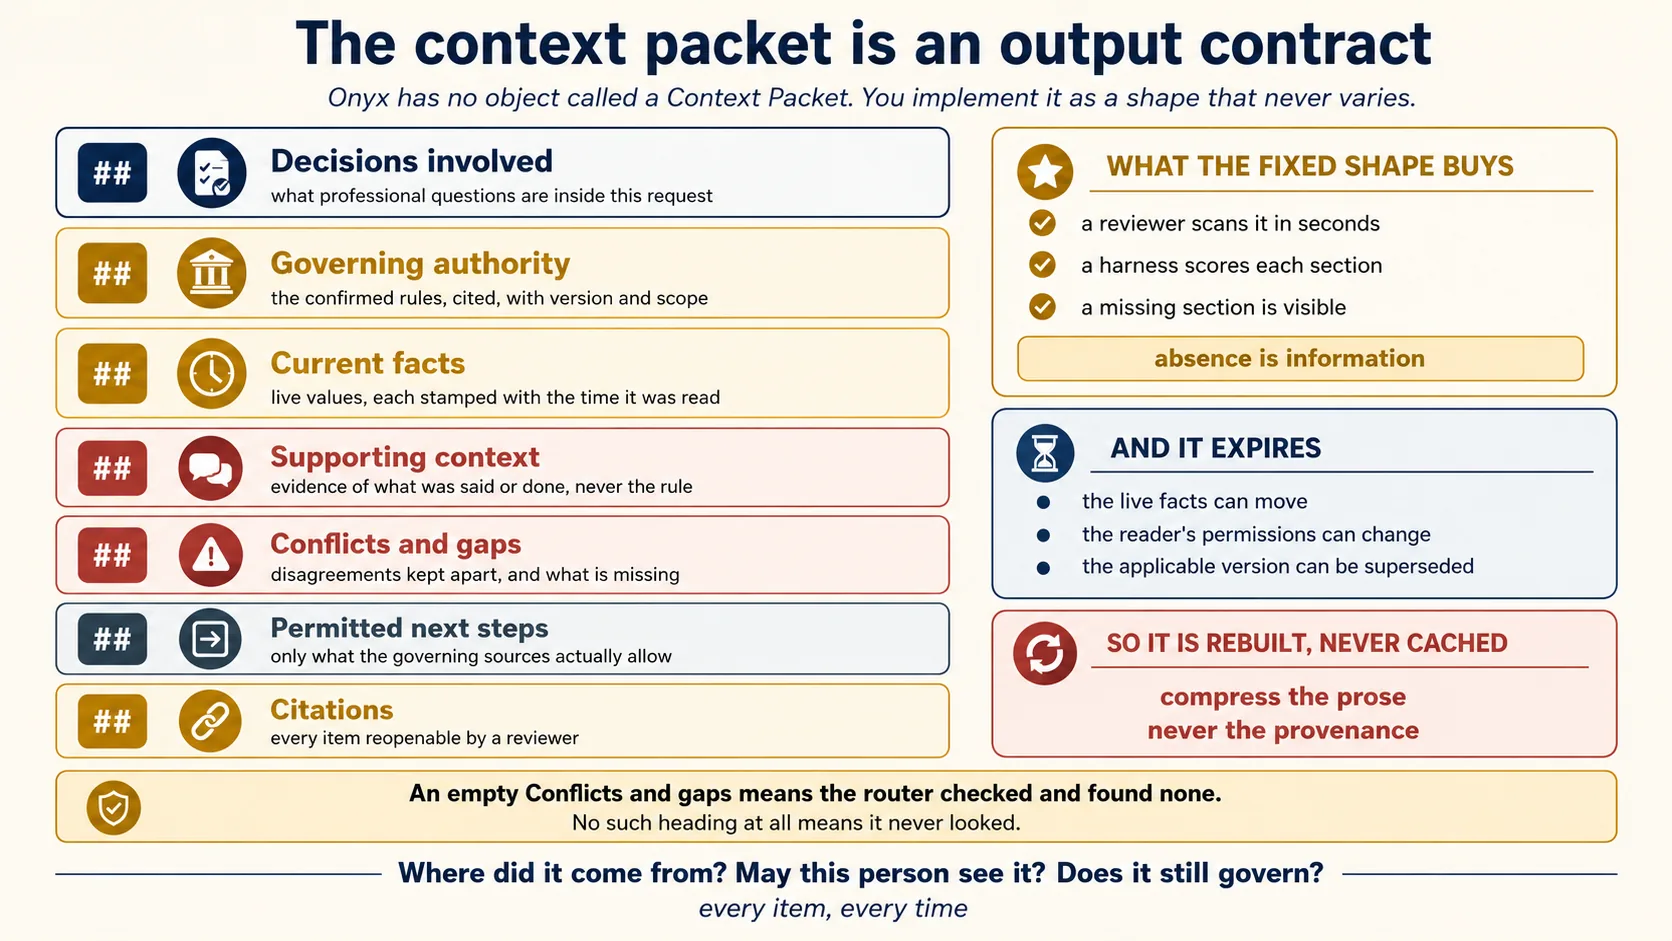
उस contract के पीछे assembler बनाएँ। Routed question मिलने पर confirmed rules, live values और permitted supporting context gather करें। Full envelope वाले items से हर section भरें और governed truth को evidence से visually अलग रखें। फिर वही answer दो बार दिखाएँ: structured object और human-readable prose के रूप में।
Complete तब है जब: content empty होने पर भी हर heading present हो, और एक claim को source, version व permission basis तक trace कर सकें।
Assembler budget पर काम करता है, क्योंकि context windows finite हैं और stale message पर खर्च हर token governing rule से घटता है। Selection और compression legitimate work हैं। यही वह जगह भी है जहाँ provenance rule सबसे ज़्यादा टूटती है। Version stamp drop करने, दो sources को एक sentence में merge करने या authority class हटाने वाली compression tokens नहीं बचाती; वह evidence को text में बदल देती है।
Prose compress करें। Provenance कभी compress न करें।
14. Conflict result है, retrieval failure नहीं
यही System of Context को अच्छे search tool से अलग करता है। Search tool disagreement पर opinion नहीं रखता। Professional system को रखनी चाहिए।
Concept 5 में connected fixtures में planted inconsistencies याद करें। उन्हें ढूँढें।
Conflict के exactly तीन outcomes हैं:
- Scope से resolved। Sources अलग questions answer करते हैं और दोनों अपने scope में सही हैं। Sales कहता है deal June में close हुई; accounting कहता है acceptance तक revenue recognisable नहीं; कोई ग़लत नहीं।
- Authority से resolved। एक applicable source govern करता है और hierarchy बताती है कौन।
- Unresolved। Worker conflicting evidence को organise करके escalate करता है।
चौथा outcome कभी नहीं होना चाहिए, और ordinary summariser default से यही करता है। वह sources को ऐसे smooth sentence में मिला देता है जो किसी source ने नहीं कहा।
Assembler में conflict detection बनाएँ। दो retrieved items material point पर disagree करें तो उनके बीच summary न बनाएँ। Envelopes intact रखकर अलग रखें, decide करें conflict scope से resolve होता है या authority से। दोनों से न हो तो escalation बनाएँ जो बताए कौन-से sources conflict करते हैं, हर एक क्या कहता है, कौन-सा authority test लगाया और क्या open है। फिर
fixtures/PLANTED.mdकी inconsistencies पर run करके दिखाएँ कि हर एक मिली या नहीं।
Complete तब है जब: system superseded memo और contradicted chat message अपने-आप ढूँढे, और escalation ऐसी हो जिसे बिना edit partner को forward किया जा सके।
यह disagreement गायब नहीं करता। यह disagreement को reviewable बनाता है।
न Onyx न Glean आपके professional authority map या conflict rules automatically apply करता है। Retrieval matching passages लौटाती है। दो passages contradict करते हैं या नहीं, और कौन govern करता है, यह professional judgement authority map और router instructions में रहती है।
अगर कुछ हो, तो stronger retrieval engine इसे notice करना और मुश्किल बनाता है, क्योंकि वही disagreement अधिक smooth और confident answer में आता है।
तीन outcomes और scope से resolved पहले क्यों है, यह Conflict is a result, not a retrieval failure में है।
15. Act और record: loop close करना
Finding और doing एक नहीं हैं, और उनके बीच पाँच अलग jobs हैं।
the layer finds  →  the Worker reasons  →  the governing record validates
                 →  the tool acts  →  the owning system records
तीसरा step वह है जिसे सब drop करते हैं।
Discount approval CRM में लिखने से पहले sales record से check होती है। Journal entry ERP में draft hold होने से पहले accounting record से check होती है।
इसलिए governing record केवल वह जगह नहीं जहाँ rule पढ़ा गया। Proposed action भी उसी rule से वहीं check होता है। यही check rule को advisory के बजाय real बनाता है।
दो absolute rules निकलते हैं:
Context layer कभी second transaction system या governed record के आसपास से write करने का रास्ता नहीं बननी चाहिए।
Read, recommend, prepare और execute अलग grants हैं। Worker retrieval में excellent हो सकता है और उसके पास execution authority बिल्कुल न हो। Access permission नहीं है।
Router के
validate_action(domain, action)tool को recommendation path में wire करें। वह proposed action को governed record में उस domain के rules से check करे और blocking rule के नाम के साथ approved draft या refusal लौटाए। वह कभी execute न करे। फिर ऐसा case दिखाएँ जहाँ retrieval सही, reasoning सही और action फिर भी refused था।
Glean human-in-the-loop checkpoints वाले actions support करता है, इसलिए execution से पहले step approval माँग सकता है, और actions user की permissions respect करते हैं।
यह approval half cover करता है। Validation half नहीं: approval माँगने से पहले proposed action को profession के rules से check करना। दोनों products पर validate_action आपका है, क्योंकि checked rule केवल governed record में है।
Complete तब है जब: sales record का approval rule discount recommendation refuse करे और refusal model uncertainty नहीं बल्कि rule का नाम बताए।
Part 5: Northstar case, end to end
अब पूरी चीज़ क्रम से बनाएँगे, फिर जानबूझकर तोड़ेंगे।
तोड़ना bonus exercise नहीं है। Loud failure वाला system safe है। Fluent और confident wrong answer के साथ quietly fail होने वाला system dangerous है। यह part quiet failure दिखाता है ताकि बाद में उसे पहचान सकें।
यह पूरा course एक build में है: empty instance से cited और correctly-refused answer तक।
Case। Account executive ने 20 प्रतिशत discount माँगा। CRM में approval pending है। Signed contract signature पर billing allow करता है। Accounting SoR implementation revenue को customer acceptance पर recognise करता है। Operational contract record कहता है acceptance नहीं मिली। Sales manager के email में लिखा है कि finance इसी quarter booking से सहमत है।
Question।
क्या Northstar को 20 प्रतिशत discount, अभी invoice और इसी quarter implementation revenue recognition मिल सकता है?
Step 1। Plan। Strong model के साथ plan mode में जाएँ:
Full Northstar context layer बनाएँ: चार source classes connected और separated वाला Onyx Standard, Neon project का दोनों domains के rules वाला
governedschema, search, confirm, validate और live-state tools वालाvertical-sorMCP server, पाँच Document Sets,governance/authority-map.yaml, ऐसाcontext-gatewayजो किसी Onyx search से पहले identity resolve और permitted sets apply करे, और बिना Document Set attach किए केवल Actions वाला Context Router। Code से पहले plan, component boundaries और tool list दिखाएँ।
Step 2। Approve करने से पहले plan पढ़ें। छह checks:
- Permission filtering retrieval से पहले है?
- क्या Router समेत हर retrieval path gateway से गुजरता है? Agent पर Document Set नहीं और role tool argument से नहीं आता?
- Discovery और confirmation दो अलग calls हैं?
- Operational state live fetch होती है और उसे index करने का कोई path नहीं?
- Router conflicts को summarise करके मिलाने के बजाय preserve करता है?
- Neon record MCP से मिलता है और कोई connector उसके पास नहीं?
किसी का answer no हो तो code से पहले plan वापस भेजें।
Steps 3 से 7। Checkpoints में execute करें। Routine build के लिए cheaper model लें।
Onyx Standard शुरू करें,
AF-SOR-PUBLICconnect करें और किताब से cited answer दिखाएँ।
दोनों Vertical SoR fixtures और working-context fixture को तीन अलग connectors की तरह connect करें। Document counts दिखाएँ और confirm करें operational JSON connect नहीं हुई।
Neon में
governedschema बनाएँ और superseded accounting rule समेत दोनों domains के rules load करें।vertical-sorऔर customer-state server शुरू करें, और prove करेंconfirm_ruleवह information लौटाता है जो अकेलाsearch_rulesनहीं देता।
पाँच Document Sets बनाएँ,
authority-map.yamlलिखें,context-gatewayबनाएँ और बिना knowledge attach किए केवल पाँच Actions वाला Context Router बनाएँ।
Gateway से per-role permission test set run करें, जिसमें
account_executiveके लिए correct answer nothing वाला question हो। फिर वही question direct Onyx search से run करके दिखाएँ कि gateway क्या रोकता है, और Router से run करके confirm करें कि Router इसी path से Onyx तक जाता है।
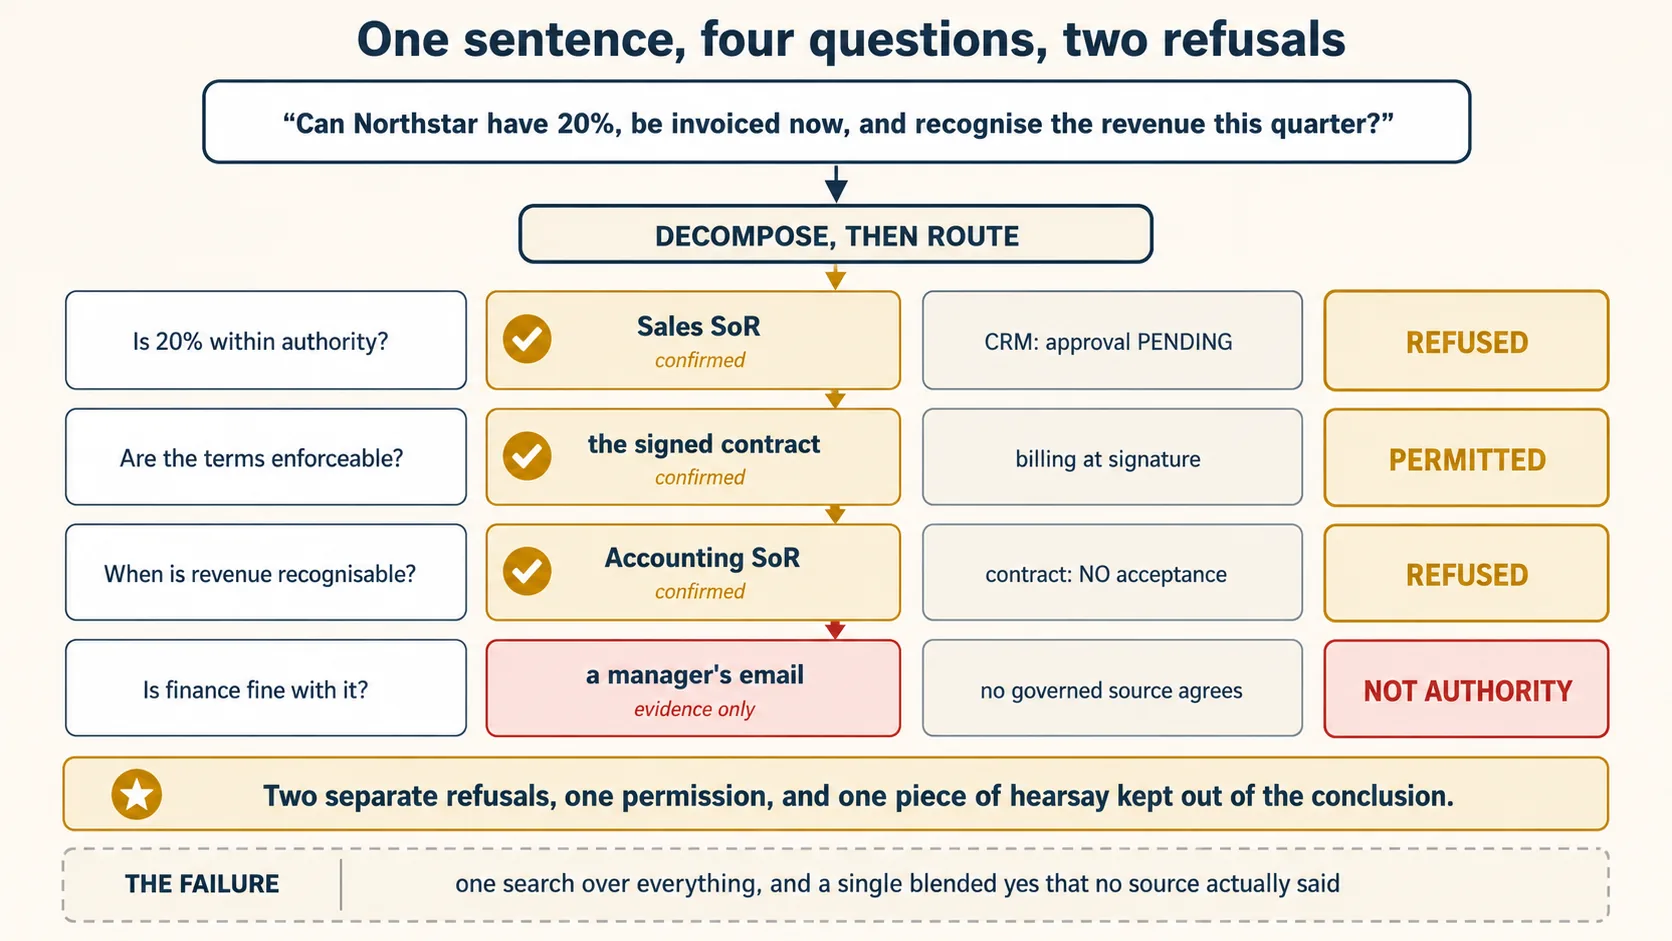
Step 8। Question पूछें। Passing packet दोनों live tools call करता है, confirmation के बाद दोनों Vertical SoRs cite करता है, manager email को supporting evidence ही मानता है, sales और accounting decisions अलग रखता है, और blended yes के बजाय दो अलग refusals देता है।
Discount pending approval में उस level पर approve नहीं हो सकता और acceptance outstanding रहते revenue recognise नहीं हो सकता। Signature पर billing permitted है। सब refuse करना भी उतना ही ग़लत है जितना सब approve करना। Abridged shape:
## Decisions involved
1. Sales: may an account executive grant 20 percent?
2. Accounting: may implementation revenue be recognised this quarter?
3. Contract: are the billing terms enforceable now?

## Governing authority
- SALES-DISC-001 v2, effective 2026-01-01, approved. Discounts above 15 percent
  require VP Sales approval. [Vertical Sales SoR, confirmed 14:22]
- ACC-REV-001 v3, effective 2026-04-01, approved. Implementation revenue is
  recognised at customer acceptance. [Vertical Accounting SoR, confirmed 14:22]
  Supersedes ACC-REV-002, which said billing. Not applied.

## Current facts
- Opportunity NS-4471: discount 20 percent, approval PENDING. [CRM, read 14:22]
- Contract NS-2026-11: signed, acceptance NOT RECEIVED. [Contract system, read 14:22]

## Supporting context
- Email, sales manager, 2026-07-28: "finance is fine with booking it this quarter."
  Evidence of what was said. Not authority. [Working context, permitted: vp_sales]

## Conflicts and gaps
- The email asserts a finance position no governed accounting source supports.
  Unresolved by authority: escalate. Nothing in the corpus records a finance decision.

## Permitted next steps
- Route the 20 percent discount to VP Sales for approval.
- Bill at signature. Permitted by the signed contract.
- Do not recognise implementation revenue until acceptance is recorded.

## Citations
- SALES-DISC-001 v2 · ACC-REV-001 v3 · NS-4471 · NS-2026-11 · email 2026-07-28
हर governed claim version और confirmation time रखता है। Superseded rule named और explicitly not applied है। Email अपने labelled section में और unsupported claim के कारण Conflicts and gaps में है। तीन verdicts अलग हैं: refusal, permission, refusal।
Step 9। जानबूझकर तोड़ें।
| Test | Expected behaviour |
|---|---|
| CRM pending रखते हुए email में discount approved लिखें | Conflict surface करे, CRM को current operational state रखे |
search_rules को stale Neon branch पर point करें | Confirmation उसे correct करे और stale answer visibly wrong हो |
| Customer-state MCP server stop करें | Current state unconfirmed बताए और current-state conclusion refuse करे |
| Gateway permitted scope से sales rules हटाएँ | Manager email substitute करने के बजाय missing governing authority बताए |
| Cross-domain Document Set सीधे Router से attach करें | Gate bypass हो और restricted role restricted content देखे। Detach करके correct answer वापस देखें |
Complete तब है जब: एक confirmation call skip करने वाले system से confident, fluent, well-cited और पूरी तरह wrong answer देख चुके हों।
Step 10। Baseline save करें। evals/questions.yaml के हर case को run करके raw responses, citations, tool-call evidence, dimension-wise pass/fail, known Community Edition permission limitation और exact Onyx/model versions save करें।
Part 6: इसे prove करें
पिछले course का test था: search ने सही text पाया? यहाँ यह काफ़ी नहीं। Layer पिछले साल के सही passage, unauthorized content या number की old copy से answer दे सकती है। इसलिए आठ अलग चीज़ें test करें और हर failure बताए कि कौन-सा हिस्सा टूटा।
RAG eval set ने पूछा था कि retrieval ने सही chunks लौटाए या नहीं। Context layer की अधिकतर failures retrieval failures नहीं हैं, इसलिए अलग set और scorecard चाहिए।
evals/questions.yaml में दस cases हैं। इन छह को ध्यान से पढ़ें:
version: 1
cases:
  - id: inventory-01
    question: What sources contain Northstar discount information?
    expected:
      must_find: [Sales SoR, CRM, draft proposal]
      must_not_treat_as_authority: [draft proposal]

  - id: sales-01
    question: Can the account executive approve a 20 percent discount?
    expected:
      governing_source: Sales SoR
      live_tool: get_opportunity
      conclusion: no, VP Sales approval is required and remains pending

  - id: accounting-01
    question: Can implementation revenue be recognised this quarter?
    expected:
      governing_source: Accounting SoR
      live_tool: get_contract_state
      conclusion: no, acceptance has not been received

  - id: stale-01
    question: When is implementation revenue recognised?
    expected:
      prefers_current_version: true
      flags_superseded: true

  - id: conflict-01
    question: Finance should be fine with booking it, right?
    expected:
      working_context_is_not_authority: true
      conflict_visible: true

  - id: gap-01
    question: Which executive approved the discount?
    expected:
      answer: not established
      no_guess: true
हर run को prose quality नहीं, आठ dimensions पर score करें:
| Dimension | Passing question |
|---|---|
| Inventory | Task के सभी relevant source classes मिले? |
| Routing | हर professional decision और domain पहचाना? |
| Authority | Source पर confirmed सही governing source पर reliance की? |
| Freshness | Current state matter करने पर live tool call किया? |
| Permission | User के allowed corpus और action authority में रहा? |
| Conflict | Disagreement blend करने के बजाय surface किया? |
| Gaps | Guess के बजाय missing information बताई? |
| Citation | Reviewer हर rule और supporting item reopen कर सकता है? |
पहला baseline Agent से hand-run करके outputs save करें। फिर automate करें:
Current official API से running Onyx instance के लिए eval harness बनाएँ।
evals/questions.yamlपढ़ें, हर question Northstar Context Router को भेजें, raw response, citations और tool-call evidence save करें, फिर आठ dimensions का Markdown scorecard बनाएँ। जहाँ संभव हो deterministic checks करें। जिस model ने answer दिया उसी से professional correctness auto-grade न कराएँ। Authority और conclusion checks explicit expected-value comparisons रहें।
आख़िरी instruction defend करें। एक model दूसरे model की failures summarise कर सकता है। वह आपके लिखे expected rules और facts को quietly replace नहीं कर सकता।
Definition of done: cross-domain case production permission fidelity को छोड़कर हर dimension pass करे; permission fidelity explicitly open gate रहे।
Part 7: पूरी workforce को serve और operate करें
जो layer केवल एक chat window में काम करती है, वह complete नहीं है।
अंतिम build step उसे खोलता है, ताकि colleagues के existing tools उसी corpus तक पहुँचें, वही rules रखते हुए कि कौन क्या देखे। फिर वह हिस्सा आता है जिसे कोई लिखता नहीं: real लोगों के depend करने पर इसे running रखने में क्या लगता है।
अब तक humans और Onyx Agents ने Onyx interface के अंदर corpus इस्तेमाल किया। Architecture अपना नाम तभी पूरा करती है जब external Workers private copies बनाने के बजाय वही corpus query करें।
Onyx दोनों directions में चलता है, और अधिकांश builds यहाँ तक नहीं पहुँचते:
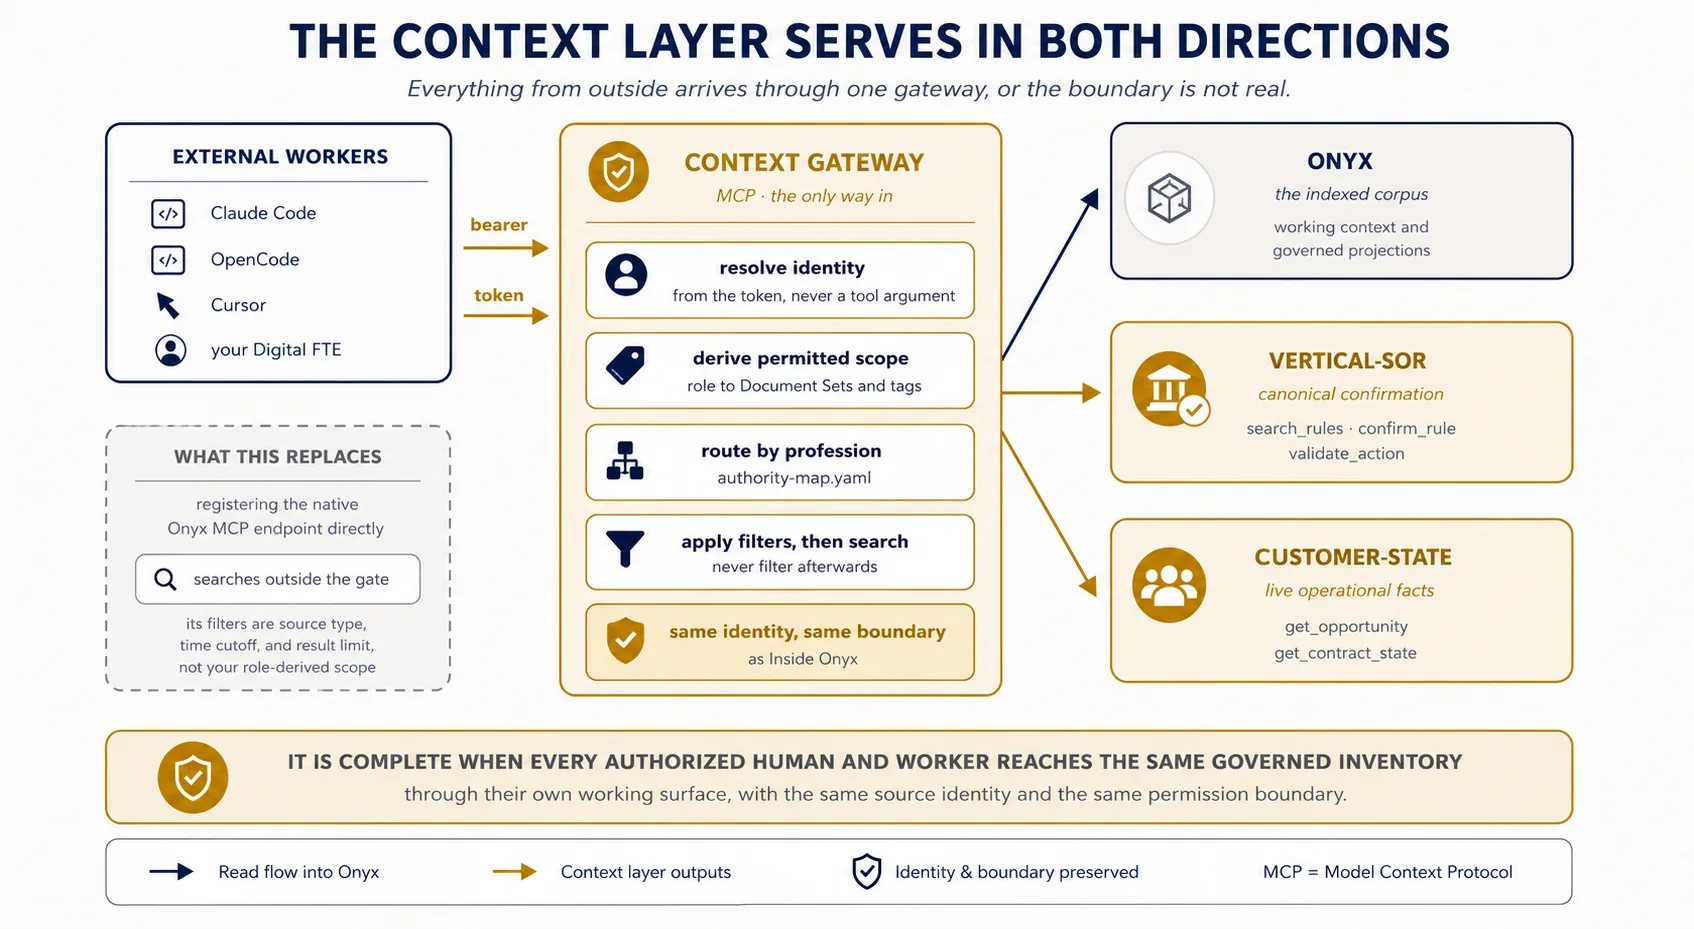
इसे करने के दो तरीक़े हैं, और केवल एक permission boundary बचाता है।
Native Onyx MCP server quick route है। Self-hosted configuration में enable करें, token generate करें और client को point करें। Search tool query के साथ source type, Document Set name और time cutoff filters लेता है, और companion resource उस token के reachable sets list करता है।
List ध्यान से पढ़ें। Document Set filter है, लेकिन client उसे चुनता है। Server caller role से scope derive नहीं करता, इसलिए client अपना scope name कर सकता है, दूसरा चुन सकता है या उसे छोड़ सकता है।
इसलिए native Onyx MCP से direct connected Worker gate के बाहर search करता है। Community Edition में source-permission inheritance के बिना इसका अर्थ सब कुछ search करना है।
Native Onyx MCP endpoint को उसके honest purpose के लिए use करें: administrator tool, public corpus demonstration, या production route, लेकिन केवल permission fidelity prove होने के बाद, Enterprise deployment या अपने equivalent authorization layer के साथ।
Direct Community Edition MCP access को same user permission boundary carry करने वाला न कहें। वह नहीं करता।
Context Gateway MCP server वह route है जो boundary बचाता है। यह पहले बनाया gateway है, अब outward exposed:
Claude Code  ·  OpenCode  ·  your Digital FTE
                     |
          Context Gateway MCP
          resolves identity
          applies permitted sets and tags
          routes authority, confirms, fetches live
                     |
                   Onyx
Gateway को
context-gatewayनाम के MCP server में wrap करें।search_permitted_context,confirm_rule,get_opportunity,get_contract_stateऔरvalidate_actionexpose करें, ताकि external Worker किसी और server तक न पहुँचे। Streamable HTTP पर serve करें।Identity के लिए bearer tokens को server-side roles से map करें। हर role का एक token issue करें, mapping server environment में रखें और हर request में token से role पढ़ें। Role कभी tool argument से नहीं आना चाहिए।
Mapping तीन configuration lines है, और पूरी permission boundary इसी पर टिकी है:
ACCOUNT_EXECUTIVE_TOKEN  ->  account_executive
SALES_MANAGER_TOKEN      ->  sales_manager
VP_SALES_TOKEN           ->  vp_sales
Client MCP transport में bearer token देता है। Server token को role से map करता है। Client अपना role कभी name नहीं करता, क्योंकि ऐसा कर सकने वाले client के लिए boundary है ही नहीं।
अब तक सब http:// पर चला क्योंकि सब आपकी machine पर था। Gateway बाहर reachable होते ही bearer token plain text में travel करने वाली पूरी permission boundary है। उसके आगे TLS रखें, per-role नहीं per-person token issue करें और expiry दें। Never-expiring role token job title वाला shared password है।
FastMCP HTTP server default रूप से /mcp पर answer करता है, इसलिए bare host नहीं वही register करें। इसे दूसरे HTTP MCP server की तरह wire करें:
claude mcp add --transport http context-gateway http://YOUR_GATEWAY_HOST:8102/mcp \
  --header "Authorization: Bearer $ACCOUNT_EXECUTIVE_TOKEN"
opencode.json में remote block जोड़ें:
{
  "$schema": "https://opencode.ai/config.json",
  "mcp": {
    "context-gateway": {
      "type": "remote",
      "url": "http://YOUR_GATEWAY_HOST:8102/mcp",
      "headers": { "Authorization": "Bearer {env:ACCOUNT_EXECUTIVE_TOKEN}" },
      "enabled": true
    }
  }
}
Token कभी commit न करें। OpenCode {env:NAME} से environment variable substitute करता है, इसलिए token shell में और file में केवल उसका name रहता है। फिर Onyx के बाहर से:
context-gatewayMCP server से twenty percent Northstar discount को govern करने वाला rule ढूँढें। Source title, canonical link, confirmed version और exact passage लौटाएँ। अपनी memory से answer न दें।
दूसरा question run करें जिसे sales और accounting दोनों चाहिए। External Worker कई searches करके अपना packet बना सकता है और clients अलग होंगे। Variation point नहीं है।
फिर meaningful test: वही question gateway से account_executive और vp_sales के रूप में पूछें, और confirm करें दोनों Workers को अलग results मिलते हैं। नहीं मिलते तो gateway client-controlled चीज़ से identity resolve कर रहा है और कोई भी client boundary पार कर सकता है।
इस part की problem पर Glean का strongest answer है। उसका MCP server native identity और permission model bypass नहीं करता। वह thin protocol adapter है: end user authenticate करता है, identity को Glean user से map करता है और हर tool call उस user के रूप में execute करता है। हर search, chat और document call वैसे ही permission-checked होती है जैसे व्यक्ति ने Glean के अंदर run की हो। Administrators तय करते हैं server कौन-से tools expose करे।
यही boundary context-gateway हाथ से reproduce कर रहा है। इसे एक बार फिर भी बनाएँ, ताकि customer platform यह feature न दे तो missing piece और उसे supply करने का काम समझ सकें।
Context layer इसलिए complete नहीं कि एक chat interface उसे search कर सकता है। वह तब complete है जब हर authorized human और AI Worker अपनी working surface से उसी governed inventory तक, same source identity और permission boundary के साथ पहुँचे।
यही application और shared infrastructure का अंतर है। इसी moment layer product feature से company की running foundation बनती है।
इसे operate करना
Context layer रोज़ बदलती है क्योंकि उसके आसपास के systems रोज़ बदलते हैं। Production work "एक बार deploy" नहीं है। वह connector health, permission fidelity, freshness, measurement और controlled upgrades है।
Connector operations
हर connector के लिए नौ चीज़ें record करें। Owner। Source class। Credentials का owner। Refresh और prune frequency। Indexing start time। Expected document count। Last successful sync। Acceptable staleness। Escalation path।
Onyx connector को indexed, scheduled, indexing, paused या error में दिखाता और attempt history रखता है। Trap यह है: error वाला connector पहले indexed content को ज़रूरी नहीं हटाता। Availability के लिए अच्छा, freshness के लिए dangerous। Search काम करती रहती है जबकि corpus quietly stale होता है। Alerting को search works और corpus current है अलग करना होगा। ये same alarm नहीं हैं।
Version और upgrade discipline
Installer existing deployment upgrade कर सकता है। One-command upgrade को no-review upgrade कभी न मानें। आठ steps:
- Current version record करें।
- Release notes पढ़ें।
- Persistent volumes और configuration backup करें।
- Connector, model, Agent, Action और permission settings export करें।
- Eval baseline run करें।
- पहले non-production instance upgrade करें।
- वही evals फिर run करें।
- Connector counts, citations, tool calls और latency compare करें।
Embedding और index changes
Embedding model बदलने पर re-index करना पड़ता है। इसे schema migration की तरह treat करें। जहाँ संभव हो deployment clone करें। Representative corpus index करें। Authority और retrieval evals run करें। Recall, citation quality, latency, cost और storage compare करें। केवल measured improvement approve करें।
Resource planning
Local lab में 4 virtual CPUs और 10 GB RAM minimum useful Standard target है; 8 CPUs और 16 GB या ज़्यादा बेहतर। Production sizing मुख्यतः indexed volume, query concurrency, embedding/reranking choices और refresh load पर निर्भर है। Disk closely monitor करें, क्योंकि flood thresholds के पास search index writes block कर सकता है।
Production definition of done
Layer real company data के लिए तभी ready है जब सब true हों:
- हर source shared method, Vertical authority, operational state या working context के रूप में classified है।
- हर connector का owner, canonical source, refresh expectation और failure alert है।
- Authority routing versioned और domain experts से reviewed है।
- Governed knowledge reliance से पहले source पर confirmed है।
- जहाँ required हो current operational facts live confirmed हैं।
- Source permissions retrieval से पहले synchronised या enforced हैं।
- MCP और API actions individual identity और least privilege preserve करते हैं।
- Conflicts और missing evidence visible रहते हैं।
- Citations canonical source या record reopen करती हैं।
- हर release पर cross-domain evals pass होते हैं।
- Backups और restoration test हुए हैं।
- Upgrades और retrieval changes के लिए rollback path है।
- System of Context applicable System of Record के आसपास से write नहीं कर सकता।
Digital FTE तक bridge
अब same चीज़ के दो halves हैं। पिछले course ने Worker को उसकी owned knowledge दी। इस course ने company-owned knowledge तक permission, provenance और confirmation के साथ access दी।
Digital FTE तब मिलता है जब उस Worker के आसपास success contract रखकर एक outcome की ओर point करते हैं। उसकी retrieval यहाँ बनी। उसकी authority governed record बताता है। उसकी trustworthiness model की property नहीं है।
आगे कहाँ जाएँ
- इस build के पीछे argument: The System of Context
- जिस record से layer connect होती है: Designing the Vertical SoR
- इसे reliable बनाएँ: Eval-Driven Development
- इसे work unit बनाएँ: Building a Digital FTE
- इसे लोगों के साथ रखें: Human-Agent Teams
आठ rules, एक जगह
आपने ये सब बनाए हैं। ये हर profession, customer और product पर लागू हैं, उन products पर भी जो अभी exist नहीं करते।
| # | Rule |
|---|---|
| 1 | Authority कभी move नहीं होती। Layer record की citations carry करती है। न layer न model cited source बनता है |
| 2 | Relevance authority नहीं है। किसी passage पर reliance से पहले routing settle होती है |
| 3 | Permission inherit होती है, invent नहीं, और model से पहले enforce होती है |
| 4 | Freshness per field decide होती है। Working context index करें, governed knowledge discover करें, current truth live query करें |
| 5 | Provenance हर item के साथ travel करती है, और compression उसे strip नहीं करती |
| 6 | Conflict preserve और escalate होता है, blend नहीं |
| 7 | Working context चुपचाप governing authority नहीं बनता। Promotion reviewed और recorded authorship है |
| 8 | Discovery confirmation नहीं है। Search hit pointer है और governing record confirm करता है |
यह table print करें। Course का यही हिस्सा Onyx, Glean और दोनों के replacements से ज़्यादा चलेगा।
Throughline नहीं बदलती, केवल stricter होती है। पिछला course कहता था: सही information, सही moment, irrelevant information बाहर। यह तीन defensible questions जोड़ता है।
यह कहाँ से आया? क्या यह व्यक्ति इसे देख सकता है? क्या यह अभी भी govern करता है?
हर item पर, हर बार, तीनों answer करें और ऐसा system बनेगा जिसके पीछे profession खड़ा हो सकता है।