开源 LLM:你的笔记本、服务器/集群与云端
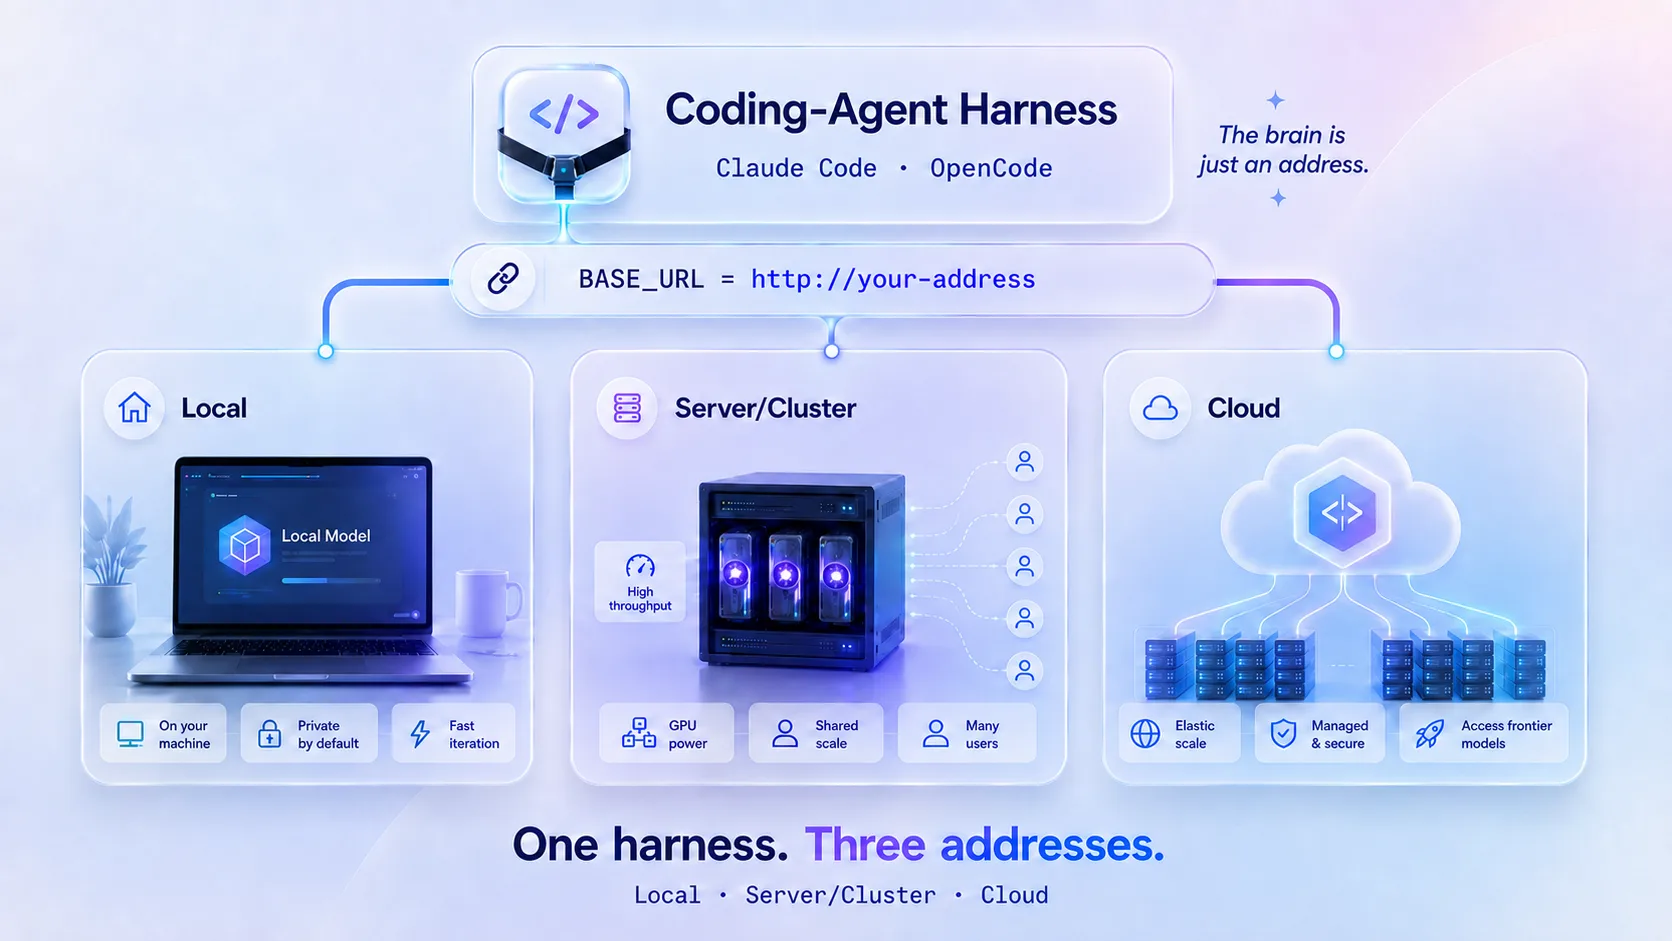
同一个模型家族,三种运行方式:在笔记本上用 Ollama 运行;在高性能机器上用 vLLM 同时服务 50 个人;通过 OpenRouter 进入云端,使用最大的开放模型。工具相同,思路相同,只是规模不同。
你以前用过 AI。在一个输入框里打字,它就会回答。那个 AI 并不住在你的电脑里,而是运行在远方某家公司拥有的大型机器上。你租用的只是它的一小段时间。
本课会展示你真正拥有的全部选择。开源模型改变了规则:模型权重可以免费下载,任何人都能运行。但「任何人都能运行」掩盖了一个实际问题:究竟在哪里运行?在笔记本上?在一台配有强大显卡的租用机器上?还是在别人的集群上,因为模型大到任何个人设备都装不下?
这就是本课的三个层级,每个层级各占一部分:
| 部分 | 层级 | 服务层 | 规模 | 你将完成什么 |
|---|---|---|---|---|
| 1 | 本地 | Ollama | 1 个人,1 台笔记本 | 在自己的机器上运行模型,并把 coding agent 指向它 |
| 2 | 服务器/集群 | vLLM | 多个用户,1 台机器或自己的集群 | 用同一个 Qwen3 8B 处理 50 个并发请求,并测量变化 |
| 3 | 云端 | OpenRouter(网关) | 几乎无人能自行托管的前沿模型 | 从同样的 coding agent 驱动 Kimi K3 和 DeepSeek V4 Pro |
三个层级,三个地址,三种账单。笔记本: Ollama 位于 http://localhost:11434,成本为零。服务器: vLLM 位于 http://localhost:8000,成本来自 GPU 租金;以 24 GB 显存的卡为例,不同供应商每小时大约收取 $0.50–$2。云端: OpenRouter 位于 https://openrouter.ai/api,按 token 收费;在撰写本页时,价格从每百万 token 约 $0.44(DeepSeek V4 Pro 输入)到 $15(Kimi K3 输出)不等。下文会告诉你,什么时候应该选择哪个地址。价格和租金会变化,制定预算前请实时查询。
一幅图可以贯穿整门课。任何 AI 工具都由两个部分组成。一部分位于你的机器上,负责实际操作,也就是 harness。另一部分是负责思考的大脑,也就是模型。harness 通过一个地址连接大脑。第 1 部分中,这个地址是你自己的笔记本;第 2 部分中,它是一台由你控制、配有真正显卡的机器;第 3 部分中,它是位于数万亿参数模型前方的云服务。harness 始终不变,只有地址改变。理解一次,三个层级就会变成同一个动作。
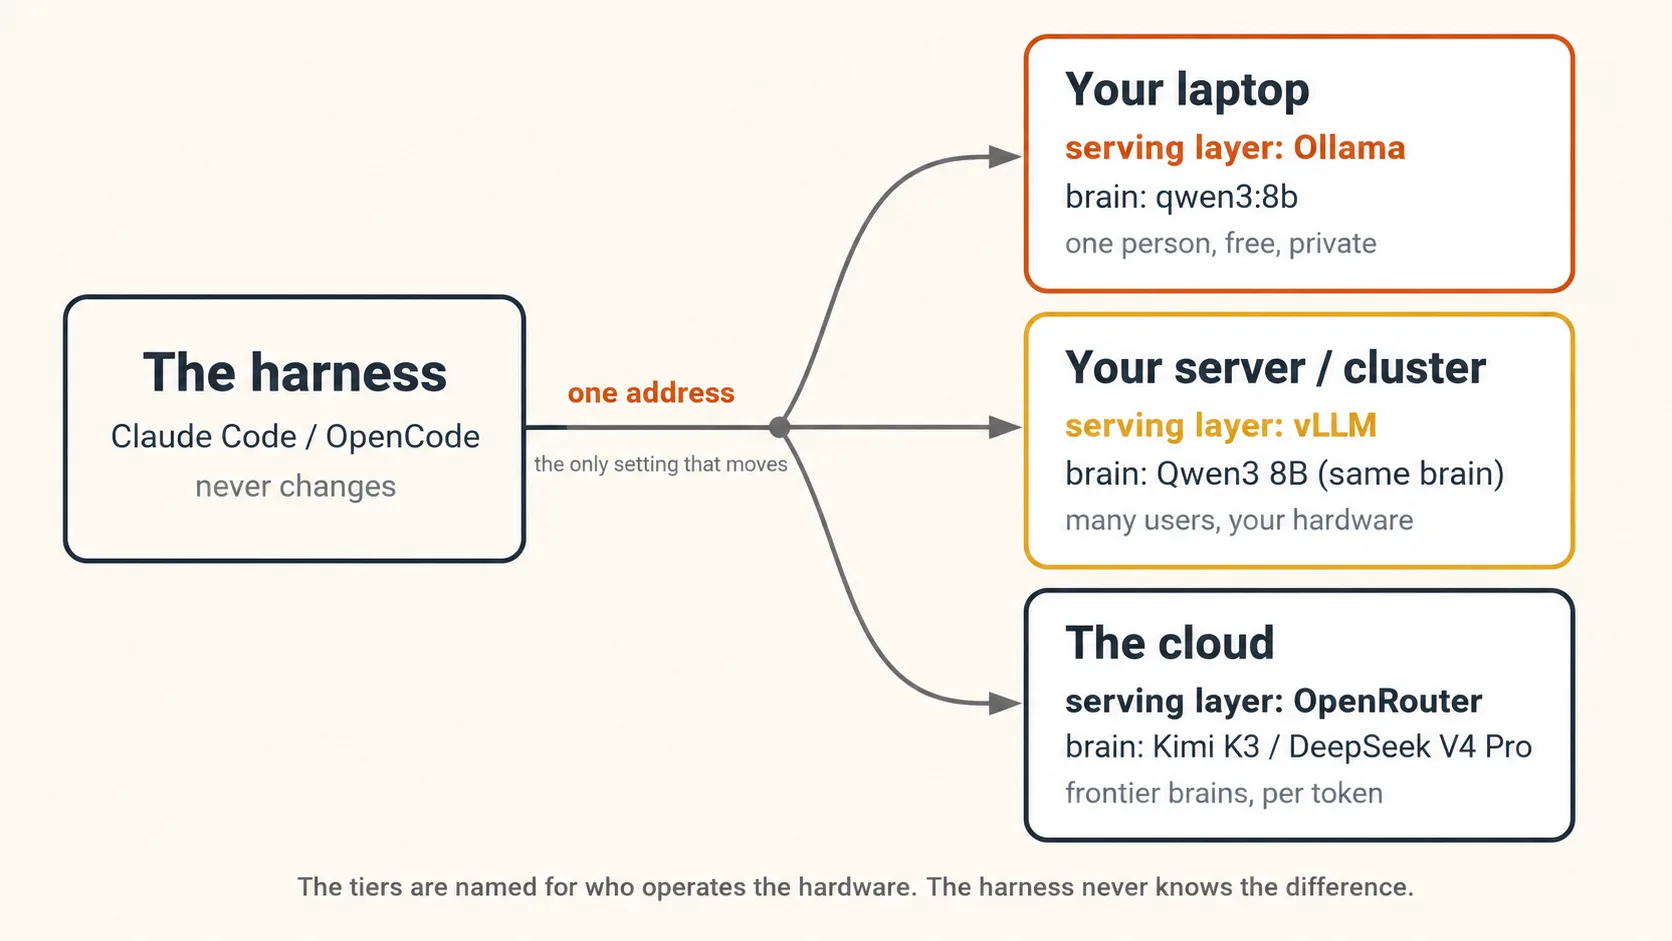
这是你在 General Agents 部分的第一站。你将在这里选定贯穿本书其余内容的 AI。我们从拥有大脑开始,因为它能让这一部分的核心观点从第一天就变得真实:agent 等于 harness 加上一个可替换的大脑。之后,你会学习如何驾驭这个 agent(Agentic Coding)、用书面 spec 指挥它(Spec-Driven Development),再交给它一个无需你参与也能运行的 loop(Loop Engineering)。
下面用简单的话给出诚实的承诺,也说明诚实的限制。第 1 部分真实、免费而且私密,任何机器都能运行;不过,普通笔记本处理繁重编程任务时会非常慢。这种缓慢不是课程的 bug。学会看见它并理解原因,正是第 1 部分的主要课程。第 2 部分需要一台配有 NVIDIA 显卡的机器,大多数学生会按小时租用,花费几美元。第 3 部分需要一个存有几美元余额的 OpenRouter 账号。每个部分都能独立完成。今天先做第 1 部分,准备好后再回来学习其余部分。
- **第 1 部分,与本地模型对话:**只需免费安装 Ollama,任何人都能完成
- **第 1 部分的编程环节,以及第 2、3 部分:**需要预先安装 coding agent(Claude Code 或 OpenCode)。还没有?Agentic Coding 速成课 会带你完成安装。可以先学那门课,也可以先完成本课的对话环节
- **仅第 2 部分:**需要访问一台配有 NVIDIA GPU 的 Linux 机器。标准构建大约需要 24 GB 显存;兼容硬件上的压缩构建约需 16 GB(第 2 部分会展示两条路径)。从云 GPU 供应商租用 1–2 小时既常见又便宜
- **仅第 3 部分:**一个免费的 OpenRouter 账号,以及几美元余额
从第一步开始,就可以在自己的机器上同步操作。本页命令使用 Bash,适用于 macOS、Linux,以及通过 WSL 运行的 Windows。如果改用 PowerShell,请在每款工具的实时文档中查找对应写法。涉及 coding agent 时,请始终在一个小型、可丢弃的 git 文件夹里操作,避免 agent 碰到任何重要内容。亲自撞上一项限制,比只阅读三项限制学得更多。
用日常语言解释关键词
现在先读一遍。以后遇到不清楚的词,再回到这里。下方每个概念都会在上下文中重新讲解这些词,因此无需在此背诵。
| 术语 | 日常含义 |
|---|---|
| 模型 / 大脑 | 真正负责思考的 AI。你发送文字,它返回文字。 |
| Ollama | 免费程序,用于下载 AI 模型并在你的机器上运行。面向单个用户设计。 |
| vLLM | 免费程序,用于同时向多个用户提供 AI 模型。面向共享机器设计。 |
| 服务层 | 加载模型并响应请求的软件。Ollama 和 vLLM 都是服务层。 |
| OpenRouter | 把数百个模型放在同一个地址后面的云网关。真正运行服务层的是它背后的托管方。 |
| harness / 工具 | 大脑外围的程序。它读取文件、运行命令并展示变化。Claude Code 就是一种 harness。 |
| coding agent | 替你编写和编辑代码的 harness,例如 Claude Code 或 OpenCode。 |
localhost | 表示「这台电脑本身」的地址。机器与自己通信,因此无需互联网。 |
| 地址 / 基础 URL | 工具发送工作的目的地。指向 localhost,工作就会留在你的机器上。 |
| 工具调用 | 模型发送的一条短小而精确的消息,用来表示「编辑这个文件」或「运行这条命令」。它是数据,不是一句话。 |
| token | 模型实际读取并计费的单位:单词的一部分,在英文中大约是 3–4 个字母。 |
| 上下文窗口 | 模型一次能容纳多少 token。窗口太小,就会忘记任务开头。 |
num_ctx | Ollama 的上下文窗口设置。默认值取决于机器,对 coding agent 来说通常太小。 |
| 两堵墙 | 本地编程配置必须越过的两项限制:模型足够强,硬件足够快。 |
| 并发量 | 同一时刻到达的请求数。1 个用户的并发量是 1,一个教室的并发量是 50。 |
| 吞吐量 | 每秒完成的有效工作总量。本课以所有用户合计每秒生成的 token 衡量。 |
| 连续批处理 | vLLM 的诀窍:把多个请求一起送入 GPU,并在运行中途把新请求插入空位。 |
| 开放权重模型 | 可以下载训练后权重的模型。它不一定符合严格的「开源」定义,训练数据和部分条款仍可能封闭。 |
| 前沿开放模型 | 排行榜顶端的开放权重模型,大到只能由集群提供服务。Kimi K3 就是一个例子。 |
| API 密钥 | 证明账号归你所有的秘密字符串。在云端层级,它也决定账单记在谁名下。 |
本课贯穿着两个层面,它们老化的速度截然不同。记住第一个,查询第二个。
- **长期有效的层面。**模型可以存在于三种规模:你的机器、你控制的机器,或你租用的集群。工具通过一个可更改的地址连接模型。为单个用户设计的服务层会在负载下排队,为多个用户设计的服务层则不会。选择哪个层级,最终取决于隐私、硬件和成本。你会先亲自感受到这些差异,再学会为它们命名。即使下方所有命令都已改变,这些原则依然成立
- **机械细节层面。**包括每个版本号、flag、模型名、价格和设置。Ollama、vLLM、OpenRouter 以及 coding 工具都变化很快。因此,请把每条命令视为实时文档的入口,而不是需要记住的事实。当本课与当前文档冲突时,以文档为准
本课涵盖什么
| 概念 | 部分 | 你将完成什么 |
|---|---|---|
| 1 | 1 | 在自己的机器上运行模型并与之对话,大约需要两分钟 |
| 2 | 1 | 学会让一切成立的核心观点:大脑只是一个地址 |
| 3 | 1 | 让模型执行操作:用一条命令把 coding agent 指向它 |
| 4 | 1 | 交给它一项真实编程任务,感受本地大脑在哪里能撑住、在哪里会崩溃 |
| 5 | 1 | 理解两堵墙:模型足够强,硬件足够快 |
| 6 | 1 | 查看一次真实工具调用的内部结构,也就是弱模型容易出错的地方 |
| 7 | 1 | 判断什么时候值得拥有大脑 |
| 8 | 2 | 看清 Ollama 为什么是单人厨房:向它发送 50 个请求,观察排队 |
| 9 | 2 | 用 vLLM 提供同一个 Qwen3 8B,并理解连续批处理的含义 |
| 10 | 2 | 对 vLLM 运行同样的 50 个请求,绘制两条曲线并读懂差异 |
| 11 | 2 | 把 Claude Code 和 OpenCode 接到 vLLM 服务器,中间无需转换器 |
| 12 | 2 | 判断什么时候值得使用服务器层级 |
| 13 | 3 | 认识几乎无人能自行托管的前沿开放模型:Kimi K3、DeepSeek V4 Pro |
| 14 | 3 | 通过 OpenRouter,用 Claude Code 和 OpenCode 驱动这两个模型 |
| 15 | 3 | 在性能和价格之间选择,为任何工作选出正确层级 |
| 16 | 3 | 在三个层级前放置一个 router,把层级策略写成配置 |
| A | 附录 | 用密钥、预算和一份统一菜单,把第 2 部分的服务器变成共享服务 |
📚 教学辅助材料
查看完整演示文稿:开源 LLM:你的笔记本、服务器/集群与云端
第 1 部分:本地层级,在自己的笔记本上运行模型(Ollama)
本部分的服务层是 Ollama,规模是 1 个人、1 台机器。这里的一切都免费而且私密。
1. 在自己的机器上放一个大脑:从这里开始
理解这件事最快的方法,是亲手做一次。因此,在任何理论之前,先让一个模型在你的机器上运行起来,再和它说句话。这一部分无需编写代码,任何人都能完成。
完成这件事的免费程序叫作 Ollama。它会下载 AI 模型并在你的电脑上运行。请选择与自己机器匹配的方式。
- 应用(Mac 或 Windows)
- 终端(任何电脑,包括 Linux)
- 前往 ollama.com/download,像安装普通软件一样安装 Ollama。安装包包含一个小型聊天应用。
- 打开 Ollama 应用。它位于 Mac 菜单栏或 Windows 系统托盘。
- 从顶部的选择器中挑一个模型。先从
gemma3:4b这类小模型开始。首次选择时会下载几 GB 数据,需要几分钟。 - 在输入框中键入问题,然后按 Enter。
就这么简单。回答来自在你自己机器上运行的模型。
打开终端,运行一条命令。首次运行会下载模型,然后直接进入聊天:
ollama run gemma3:4b
输入问题并按 Enter。要离开聊天,请输入 /bye。
如果尚未安装 Ollama,请先从 ollama.com/download 安装,再运行上面的命令。
**应该选择哪个模型?**从小模型开始。小模型回答快,也能装进配置普通的机器。之后可以再尝试更大的模型。
| 模型 | 大致下载量 | 舒适运行所需 RAM | 适合用途 |
|---|---|---|---|
gemma3:1b | 不到 1 GB | 约 4 GB | 小巧快速,但回答较弱 |
llama3.2:3b | 约 2 GB | 约 8 GB | 可靠的小型入门聊天模型 |
gemma3:4b | 约 3 GB | 约 8 GB | 强劲的小模型,适合作为默认选择 |
qwen3:8b | 约 5 GB | 约 16 GB | 回答更好,但需要更多内存 |
表中有一个模型的重要性会延伸到本部分之外:qwen3:8b。本课会在第 1、2 部分固定使用这个模型。这样,一旦结果发生变化,你就能准确知道原因。如果机器装得下,现在就把它拉取下来;如果装不下,请在这里使用更小的模型,到第 2 部分再租用硬件。
随着模型更新,上面的确切名称和大小也会改变。依赖任何标签前,请先到 ollama.com/library 查询。养成检查实时来源的习惯,正是在实践「需要查询的层面」。
概念 1 的完成标准:你提出一个问题,由运行在自己机器上的模型回答。关闭 wifi 后再问一次,依然能工作。任何内容都没有离开电脑。
最后一点值得稍作停留。模型作为一个小程序运行在你的机器上,监听名为 localhost 的地址。这个词只表示「这台电脑本身」。机器正在与自己通信,因此断网后仍然可以工作。
如果只想在自己的机器上拥有私密 AI,现在已经实现了。可以随时离线、免费运行,输入的任何内容都不会离开电脑。仅仅知道这一点就很有价值。
本课余下内容会让同一个本地模型执行操作:读取文件、编写代码、替你编辑。如果感兴趣,请继续;如果不感兴趣,你已经取得了成果。
2. 让这一切成立的核心观点:大脑只是一个地址
你刚才已经亲手完成了。现在需要为发生的事情命名,因为这个观点位于你以后会使用的每一种 AI 工具之下,也贯穿本课全部三个层级。值得放慢速度认真理解。
你的 AI 工具有两个部分:
- **harness:**位于机器上的程序。它读取文件、运行命令,并展示发生了哪些变化。Claude Code 是一种 harness,Ollama 聊天应用则是更简单的一种。
- **大脑:**读取所有内容,再决定说什么或做什么的模型。
harness 连接大脑的方式,与浏览器访问网站相同:通过一个地址。可以把它想成电话号码。harness 拨出号码,接电话的一方负责思考。
这个号码通常指向远方某家公司的机器。但它只是一个设置。更改号码,完全相同的 harness 就会与一个不同的大脑交谈。概念 1 中的新号码是 localhost,也就是你自己的机器。因此,回答问题的大脑来自你的笔记本。
想象一个外卖应用。手机上的应用每天都相同。更改餐厅地址,同一个应用就会从另一间厨房下单。AI 工具是应用,地址是电话号码,而该地址上的厨房就是模型烹饪答案的地方。
这里有一点很容易理解错,而且之后非常重要。本地大脑不是你以前所用大脑的缩小副本,而是一个不同的大脑。它可能弱得多。应用相同,厨房不同,新厨房的厨师也许没那么熟练。请记住这一点,它会直接引出概念 5。
继续保留厨房这幅图景,因为本课会造访三间厨房。第 1 部分是你家里的厨房;第 2 部分是你亲自运营、能够服务整家餐厅的工业厨房;第 3 部分是从世界上最好的餐厅点餐,因为任何家庭都装不下它们的厨房。应用始终相同,只有地址改变。
你更改了一个地址,一台本地机器上的模型作出了回答。AI 工具的哪一部分改变了,哪一部分保持不变? 大脑改变了:文字现在会发往你自己机器上的模型。harness 保持不变:应用、按钮以及交谈方式都没有变化。你只更改了它拨打的地址。查看答案
3. 让它执行操作:本地大脑上的 coding agent
与本地模型聊天是个好开端,但 agent 不只会聊天。它会读取文件、编写代码并替你运行命令。下面把 coding agent 指向同一个本地大脑。
这一步会把 coding agent 连接到本地模型,因此需要已经安装 Claude Code 或 OpenCode。装有其中一个即可继续。如果还没有,请先安装(Agentic Coding 速成课 会带你完成)。下方命令负责连接并启动,不会替你安装。
有两种做法。简单做法只需一条命令;手动做法会展示底层接线,值得看一次。请选择一个标签页。
- 直接运行
- 手动配置
新版本 Ollama 可以替你连接并启动 coding agent,无需编辑设置。只需一条命令:
ollama launch claude
这会把 Claude Code 配置为使用本地模型,然后启动。它会询问使用哪个模型;也可以直接指定已经拉取的模型:
ollama launch claude --model qwen3:8b
另一款工具也有对应命令:ollama launch opencode。
unknown command "launch"ollama launch 需要较新的 Ollama(0.15 或更高版本)。看到这个错误时,请重新运行 ollama.com/download 的安装程序,或在应用中更新 Ollama。运行 ollama --version 可以检查版本。
有一个小型配套技能,既能完成全部配置,也会在你花费时间前如实说明硬件情况。agent 会读取技能并完成工作。先安装,再用日常语言提出要求:
npx skills add panaversity/local-llm-agentic-coding --agent claude-code opencode -y
帮我配置 coding agent,让它在本地模型上运行。先诚实检查硬件,再一步一步带我完成;进行任何重大操作前,停下来等我批准。
安装程序可能会悄悄跳过无法识别的名称,因此可以先用 npx skills add panaversity/local-llm-agentic-coding --list 预览。
上面那条命令只是替你填写几个设置。下面列出这些设置,让你看懂接线,并能在任何地方手动完成。两款工具与同一个本地模型通信,但方式略有不同。
- Claude Code
- OpenCode
Claude Code 与本地模型交谈时,会把它当作 Anthropic。将工具指向本地地址,提供一个占位 token,并确保没有设置真正的 API 密钥:
export ANTHROPIC_BASE_URL=http://localhost:11434   # the local address, bare host, no /v1
export ANTHROPIC_AUTH_TOKEN=ollama                 # any non-empty word; it is sent as "Bearer ollama"
export ANTHROPIC_API_KEY=                          # must be empty, or it overrides the line above
claude --model qwen3:8b                             # use a model tag you have pulled
几条小提示可以省去麻烦:
- 地址必须是裸地址,只有主机和端口。Claude Code 会自行补充其余路径。不要添加
/v1 - 必须用
--model指定 Ollama 模型,否则 Claude Code 会寻找本地机器上不存在的模型名 - 在 Windows 上,
localhost有时会指向错误位置,因此很多用户改用http://127.0.0.1:11434(这是用户广泛报告的经验,并非官方文档说明)
如果希望每次会话都保留这些设置,请把它们放进 env 块,也就是 ~/.claude/settings.json 中,而不是每次重新输入:
{
  "env": {
    "ANTHROPIC_BASE_URL": "http://localhost:11434",
    "ANTHROPIC_AUTH_TOKEN": "ollama",
    "ANTHROPIC_API_KEY": ""
  }
}
OpenCode 与本地模型交谈时,会把它当作 OpenAI。它正式支持本地模型;官方支持的接入方式,是在名为 opencode.json 的文件中描述本地服务器。手动做一次很有价值,因为地址和模型映射都会清楚地摆在眼前。请注意末尾的 /v1:这里必须保留,也是它与 Claude Code 地址唯一不同的地方。
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "ollama": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Ollama (local)",
      "options": { "baseURL": "http://localhost:11434/v1" },
      "models": { "qwen3:8b": { "name": "Qwen3 8B (local)" } }
    }
  },
  "model": "ollama/qwen3:8b"
}
将它放在项目的 opencode.json 中;如果想应用于所有项目,则放在 ~/.config/opencode/opencode.json。models 下的模型名必须是实际拉取过的标签。在 Windows 上,请用 127.0.0.1 代替 localhost。
读完两个工具标签页,观察它们的形状:模型相同、机器相同、端口相同。Claude Code 拨打裸地址,OpenCode 拨打同一个地址,但末尾多出 /v1。这就是两款工具使用本地模型时的全部差异。掌握这个对照,就能把任何工具接到任何本地大脑。第 2、3 部分还会原样使用它。
**概念 3 的完成标准:**coding agent 已经启动,所用模型来自你自己的机器。问一个小问题,回答应该来自笔记本,而不是远方某家公司。
这就是概念 2 的实际效果。你把地址改成 localhost,完全相同的 coding agent 就开始把工作发送给本机大脑。
4. 现在施加压力:交给它真实任务并观察
本地模型回答问题只是很小的第一步,完成真实编程工作才是真正的测试。现在开始运行。
在一个小型、可丢弃的 git 文件夹中操作,里面放一点真实代码,即使只有一个脚本也可以。让 agent 指向本地大脑,再粘贴类似下面的提示:
查看这个文件夹。找出一项小而安全的改进,完成修改,再向我展示改了什么。
仔细观察。会出现两种情况,而两种都是课程的一部分。
在强劲机器上(优良显卡、中等规模模型),任务会成功。本地大脑读取文件、制定计划、完成编辑,再展示干净的修改。免费、离线、私密在这一刻成为现实。这是你自己的配置,而且确实能工作。
在普通笔记本上(没有显卡、模型较小),你会撞上墙。可能每一步都需要几分钟,因为机器正在缓慢读取大量文本;也可能运行到一半就停止,提示工具调用错误。大脑想表达「编辑这个文件」,却弄错了格式。
先不要修复,只需观察出现了哪种结果,以及整体感受。快速而干净?还是缓慢或中断?这种直接感受就是下一个概念的原材料。
如果任务缓慢爬行或直接中断,并没有什么出错。你只是遇到了在小机器上运行大模型的真实限制。在投入金钱或时间之前了解这一点,非常真实,也非常有用。下一个概念会准确解释刚才的感受。
**概念 4 的完成标准:**你要求本地大脑完成一次真实代码修改,并看到了结果,无论结果是干净的编辑、漫长的等待,还是中断的运行。
5. 为什么它能撑住或会崩溃:两堵墙
现在解释原因,因为你已经亲身感受了它。这是第 1 部分最重要的观点,下面直接讲清楚。
本地 coding agent 必须越过两堵彼此独立的墙。它们不是同一堵墙,修好一个也不会影响另一个。
**第一堵墙是能力。**模型每次采取行动时(编程工作中几乎每一轮都会如此),都必须写出有效的工具调用,也就是按照 harness 要求的严格格式,精确表达「编辑这个文件,把这一行改成那一行」。小模型很容易出错:它会跳过工具,或破坏格式,导致运行停止。更强、接受过工具使用训练的模型通常能解决这个问题。更快的硬件不能解决:高速机器运行微型模型,仍会写出错误的工具调用。
**第二堵墙是吞吐量。**每一轮中,在你的任务真正开始之前,harness 都会向模型发送一段很长的指令,其中包含工具规则以及所有可执行操作的定义。机器必须快速读完。使用显卡只需片刻;没有显卡、完全依靠处理器时,每轮可能要等几分钟。显卡能解决这个问题,更聪明的模型不能:聪明模型放在慢机器上,依然慢得令人痛苦。
| 墙 | 需要什么 | 如何解决 | 什么无法解决 |
|---|---|---|---|
| 能力 | 每次行动都写出正确的工具调用 | 使用更强、接受过工具训练的模型 | 只有更快的硬件 |
| 吞吐量 | 在几秒内读完长指令 | 显卡(GPU) | 更聪明、更小的模型 |
看下面的表格前,先诚实说明模型大小:可靠工具使用并不存在通用的参数量下限。工具使用训练、聊天模板以及与 harness 的适配程度,与原始规模同样重要;训练良好的小模型可能胜过训练不佳的大模型。不过,在当前常见的本地模型中,更大的模型通常能更可靠地处理多步工具使用。下方表格描述的就是这个大致规律。
廉价机器会同时撞上两堵墙。因此,普通笔记本很适合用模型聊天,却不适合运行 coding agent:接线没有问题,但两堵墙都没有越过。
把概念 2 的厨房放大来看。决定一顿饭的有两件事:厨师和炉灶。厨师是模型,炉灶是机器。能力关心厨师能否每次都正确完成订单;吞吐量关心炉灶能否在几秒而不是几分钟内出餐。优秀厨师配上慢炉灶,仍然需要等待;快速炉灶配上笨拙厨师,仍然会毁掉菜品。两者缺一不可。
关于硬件,只需记住一句诚实的话。本页所有内容在配有显卡的租用云机器上都相同:接线、设置和两堵墙都不变,只有速度变化。一张约有 16–24 GB 显存的显卡,能把本地配置变成真正可用的 coding agent。这句话也是第 2 部分的入口:你会租用这样一台机器,完成笔记本永远做不到的事。
下面是一份模型与机器的大致匹配指南:
| 模型 | 大小 | 所需内存 | 可以用于编程工作吗? |
|---|---|---|---|
llama3.2:3b | 3B | 约 8 GB | 不可以。适合聊天,但会破坏工具调用。 |
qwen3:8b | 8B | 约 16 GB | 可用于简单任务 |
phi4:14b | 14B | 约 12 GB | 接近这个组合中的实用下限 |
qwen3:30b-a3b | 30B 混合模型 | 约 20–24 GB | 最佳平衡:回答强劲,速度仍快 |
qwen3:32b | 32B | 约 24 GB | 能力强,比上面的混合模型稍慢 |
任务成功运行,但每一轮都需要 4 分钟。你在同一台笔记本上换用聪明得多的模型。速度会提升吗? 不会。轮次缓慢属于吞吐量墙,更聪明的模型对此毫无帮助。它甚至可能更慢,因为模型更大。吞吐量靠显卡解决,不靠模型选择。这个概念存在的目的,正是防止混淆两堵墙。查看答案
6. 查看内部:工具调用到底是什么
概念 5 说弱模型会「破坏工具调用」。这听起来很模糊。来看一次真实调用;亲眼看到后,整个问题都会变得清楚。
正常的工具调用不是普通文字,而是一小段结构化数据,也就是 harness 能直接执行的精确指令。它看起来像这样:
{
  "type": "tool_use",
  "name": "edit_file",
  "input": { "path": "README.md", "old": "Hello", "new": "Hello, world" }
}
harness 读取这段数据,再编辑文件。模型并没有亲自写入修改,而是发送一条精确指令,由 harness 完成工作。这才是「模型使用工具」的真正含义。聊天模型从一个聊天框变成能够行动的东西,就发生在这一刻。
下面看看能力太弱的模型会做什么。它把 input 作为一团文字发送,而不是一个真正的对象;harness 会拒绝它,并返回类似下面的校验错误:
invalid tool arguments: expected object, got string
具体措辞因 harness 而异。重要的是失败的形状:参数结构错误,因此 harness 拒绝执行。
运行停止,文件没有修改。概念 4 的运行往往正是被这一条格式错误的消息终止。这就是近距离看到的能力墙。
还有一个因素决定它能否工作:上下文窗口。它表示模型一次能容纳多少 token(token 是单词的一部分,也是模型实际计数的单位)。Ollama 用 num_ctx 设置窗口。harness 每轮都会发送那段长指令,而 Ollama 会根据机器显存选择默认窗口。多数笔记本的 VRAM 小于 24 GiB,默认值只有 4,096 个 token。这么小的窗口会悄悄截掉大部分指令。陷阱就在这里:系统不会报错。Ollama 只是裁掉指令,然后照常回答。于是聊天看似正常,编程任务却以令人困惑的方式失败,因为模型根本没有看到说明工具调用格式的部分。上下文被截断是这种现象最常见的原因,但不是唯一原因。因此,应当先检查它,而不是直接认定原因。
解决方法是扩大窗口。Ollama 当前对 agent 和 coding 工具的建议是至少 64,000 个 token。agent 启动后,可以直接告诉它:
上下文窗口似乎太小,导致工具调用失败。请把它设置为至少 64,000,再重试任务。
深入了解:为什么小窗口会在没有警告的情况下破坏任务
把上下文窗口提高到 64,000 个 token 或更多,是解决「本地 coding agent 坏了」最常见的办法。设置方式有几种:调整 Ollama 应用设置中的滑块;用 OLLAMA_CONTEXT_LENGTH=64000 启动服务器;创建自定义模型文件(Modelfile,其中包含 PARAMETER num_ctx 64000);或者在一次聊天会话中输入 /set parameter num_ctx 64000。窗口越大,需要的内存越多。ollama ps 会显示正在运行的模型实际拿到了多大窗口。如果配置能聊天,却无法完成真实任务,请先检查上下文窗口。
打开快速修复清单
- **能聊天,但在真实任务中忽略指令。**上下文窗口可能太小,指令遭到截断。先把
num_ctx提高到 64,000 或更多并重新测试,再寻找其他原因 - **每一轮都要几分钟,最后超时。**机器无法及时读完长指令。可以用
export API_TIMEOUT_MS=1200000延长超时。如果仍然超时,那就是吞吐量墙在如实告诉你机器极限 - **提示缺少密钥,或 connector 已关闭。**无需担心。出现提示是因为设置了占位 token,而本地模型本来就不会使用这些功能
无需记住这些内容,agent 可以带你逐项处理。
**概念 6 的完成标准:**你已经看到真实工具调用如何表现为结构化数据,并理解格式错误的调用或过小的上下文窗口会怎样破坏本地 coding agent。
7. 什么时候值得拥有大脑
现在已经可以运行。诚实的问题是:应该在什么时候运行?
在云端租用大模型,或按普通方式使用 coding agent,通常更简单,也往往更聪明。因此,本地方案只在特定情况下占优,需要明确说清:
- **隐私。**工作从不离开机器。对于敏感或受监管的工作,仅这一点就能决定选择
- **离线。**无需网络、账号,也不受服务中断影响。磁盘上的模型在飞机上或严格防火墙后依然工作
- **全天运行时的成本。**任何服务上的单次请求都很便宜,但一个整月每隔几分钟就运行的 loop 会形成完全不同的账单。工作永不停止时,拥有大脑可能比云端更便宜
最后一点会在本书中再次发挥重要作用。在 Loop Engineering 中,你将构建整天自行运行、在你睡觉时检查自己工作的 agent。到了这种场景,由谁的大脑运行 loop、每次运行花多少钱,就不再是细节,而是设计本身。你刚刚学会了拥有这个大脑。
还要注意一件事,它是整部分内容中安静但重要的课程。如果使用了配套技能,就没有手动配置任何内容。你安装了一项技能,由 agent 使用它。技能只是一个包含 SKILL.md 文件的文件夹,与技能速成课中的结构完全相同。这意味着你也能用同样方式打包自己的知识,分享给任何 agent 安装。准备发布时,gh skill publish --dry-run 会先依据 Agent Skills 规范进行检查。
第 1 部分完成。你拥有一个大脑,把两个 coding agent 接到了它上面,也理解了决定配置是否可用的两堵墙。但请注意刚才构建的一切:厨房只服务了一位顾客,也就是你。同时发送 10 个请求,它就会让你排队。第 2 部分要讲的正是这条队伍,以及消除队伍的软件。
第 2 部分:服务器层级,1 台机器服务多个用户(vLLM)
本部分的服务层是 vLLM,规模是在一台高性能机器上服务多个用户。模型不会改变,这正是关键。
开始前,先为本部分的核心新词命名:服务层。它是把模型加载进内存并响应请求的软件。Ollama 是服务层,vLLM 也是。本部分会固定大脑(Qwen3 8B),只改变它下方的服务层。在实践允许的范围内尽量固定其他一切,只改一项,测得的差异就主要属于这一项。这不只是良好的科学方法,也是你今后调试 agent 系统的基本方式:隔离变量,再进行测量。也要诚实说明限制:这是一项教学实验,不是实验室实验。模型精度、运行时代码和配置仍有少量差异,因此这里要验证的是预期模式,不是必须捍卫的小数。
一台配有 NVIDIA 显卡的 Linux 机器。下方标准全精度构建大约需要 24 GB 显存;也可以在 16 GB 显卡上改用压缩的 FP8 构建(概念 9 会展示两种方式)。几乎没人拥有这种机器,这完全没问题:从云 GPU 供应商租用 1–2 小时只需几美元,下方命令在租用机器上完全相同。如果暂时无法租用,也请继续阅读。即使还不能亲自画出最后两条曲线,理解它们也很有价值。
8. 单人厨房:向 Ollama 发送 50 个请求并观察
第 1 部分以一项判断结束:Ollama 配置只服务一位顾客。下面用测量证明,而不是只喊口号。
实验方法如下。编写一个小脚本,同时向模型服务器发送多个请求,并报告两个数字:整批请求耗时多久,以及所有请求合计每秒生成多少 token。同时到达的请求数称为并发量。1 个用户的并发量为 1;50 名学生同时按 Enter,并发量就是 50。
Ollama 和 vLLM 都响应同一种标准请求格式(也就是 OpenCode 配置中见过的 OpenAI 兼容格式),因此一个脚本可以测试两者。只需更改地址和模型名。将下面内容保存为 bench.py:
# bench.py: fire N concurrent requests at a model server and measure throughput.
# usage: python bench.py <base_url> <model> <concurrency>
import asyncio, sys, time
import httpx

BASE_URL = sys.argv[1]        # http://localhost:11434/v1 (Ollama) or http://localhost:8000/v1 (vLLM)
MODEL = sys.argv[2]           # qwen3:8b (Ollama) or Qwen/Qwen3-8B (vLLM)
N = int(sys.argv[3])          # how many requests at once

PROMPT = "Explain in about 200 words how a bank reconciliation works."

async def one_request(client):
    r = await client.post("/chat/completions", json={
        "model": MODEL,
        "messages": [{"role": "user", "content": PROMPT}],
        "max_tokens": 300,
        "temperature": 0,
    })
    r.raise_for_status()
    return r.json()["usage"]["completion_tokens"]

async def main():
    async with httpx.AsyncClient(base_url=BASE_URL, timeout=3600) as client:
        await one_request(client)   # warm-up: load the model before timing anything
        start = time.perf_counter()
        results = await asyncio.gather(*[one_request(client) for _ in range(N)],
                                       return_exceptions=True)
        wall = time.perf_counter() - start
    ok = [r for r in results if isinstance(r, int)]
    failed = len(results) - len(ok)
    total = sum(ok)
    print(f"concurrency={N}  ok={len(ok)}  failed={failed}  tokens={total}"
          f"  time={wall:.1f}s  throughput={total/wall:.1f} tok/s")

asyncio.run(main())
安装唯一依赖(pip install httpx),确认 Ollama 正在运行且已拉取 qwen3:8b,再固定一项设置,让实验可复现。Ollama 的并行槽位数因机器而异,而公平实验必须说明设置。用 OLLAMA_NUM_PARALLEL=4 ollama serve 重启 Ollama 服务器(PowerShell:$env:OLLAMA_NUM_PARALLEL=4; ollama serve),这样你和同学的曲线就来自相同规则。然后运行扫描。请在租用的 GPU 机器上完成,确保第 2 部分比较公平:两个服务层使用相同硬件。
python bench.py http://localhost:11434/v1 qwen3:8b 1
python bench.py http://localhost:11434/v1 qwen3:8b 5
python bench.py http://localhost:11434/v1 qwen3:8b 10
python bench.py http://localhost:11434/v1 qwen3:8b 25
python bench.py http://localhost:11434/v1 qwen3:8b 50
每个并发级别运行 3 次,记录 3 次吞吐量的中位数,避免一次偶发卡顿变成数据点。概念 10 的图需要这 5 个中位数。
现在解读结果。并发量为 1 时表现正常;但随着并发量升高,总吞吐量几乎不动,实际耗时却越来越长。到 50 时,整批任务很可能需要许多分钟。内部发生的事情很简单:Ollama 并行运行少量请求(刚才固定为 4 个 OLLAMA_NUM_PARALLEL 槽位),把其他所有请求放进队列。第 40 个请求必须等到槽位空出才会开始。显卡是整台机器最昂贵的部件,却在批处理的大部分时间里和队列一起等待。
这不是 Ollama 的缺陷,而是一项坦率的设计选择:Ollama 旨在让单个用户的笔记本用起来舒服,从未打算成为一家餐厅。
这是一间只有一位厨师、两个炉头的家庭厨房。服务一位晚餐客人,非常好;服务 50 位客人,其中 45 位只能拿着订单站在走廊。厨师不懒,炉灶也没坏,只是厨房从来没有为人群设计。
**概念 8 的完成标准:**你已经测得 Ollama 在并发量 1、5、10、25、50 时的 5 个吞吐量数字,并亲眼看到队列形成。
9. 工业厨房:用 vLLM 提供同一个大脑
下面更换服务层。vLLM 是一个免费开源程序,只有一项工作:在不浪费显卡的前提下,同时向多个用户提供模型。它源自 UC Berkeley 的研究,如今已成为企业在生产环境中提供开放模型的标准方式。Ollama 优化单个用户的舒适度,vLLM 优化总吞吐量。
它依靠两个思路获得吞吐量,两者都值得用日常语言理解:
- 连续批处理。显卡最擅长同时处理很多事情。因此,vLLM 会把多个请求一起送入显卡。巧妙之处在于,一个请求结束时,等待中的请求会在运行中途滑入空位,不会停止其他请求。只要队列里还有工作,显卡就不会闲置。相比之下,普通队列会先服务一小批,全部完成后再取下一批
- **分页内存(PagedAttention)。**每段活跃对话都需要占用显卡工作内存。旧服务器会为每段对话预留一大块空间,其中大部分为空,因此显卡远未真正装满就会显得「已满」。vLLM 像操作系统管理 RAM 一样,把内存切成小页,只在需要时分配。结果是同一张卡可以同时容纳更多对话
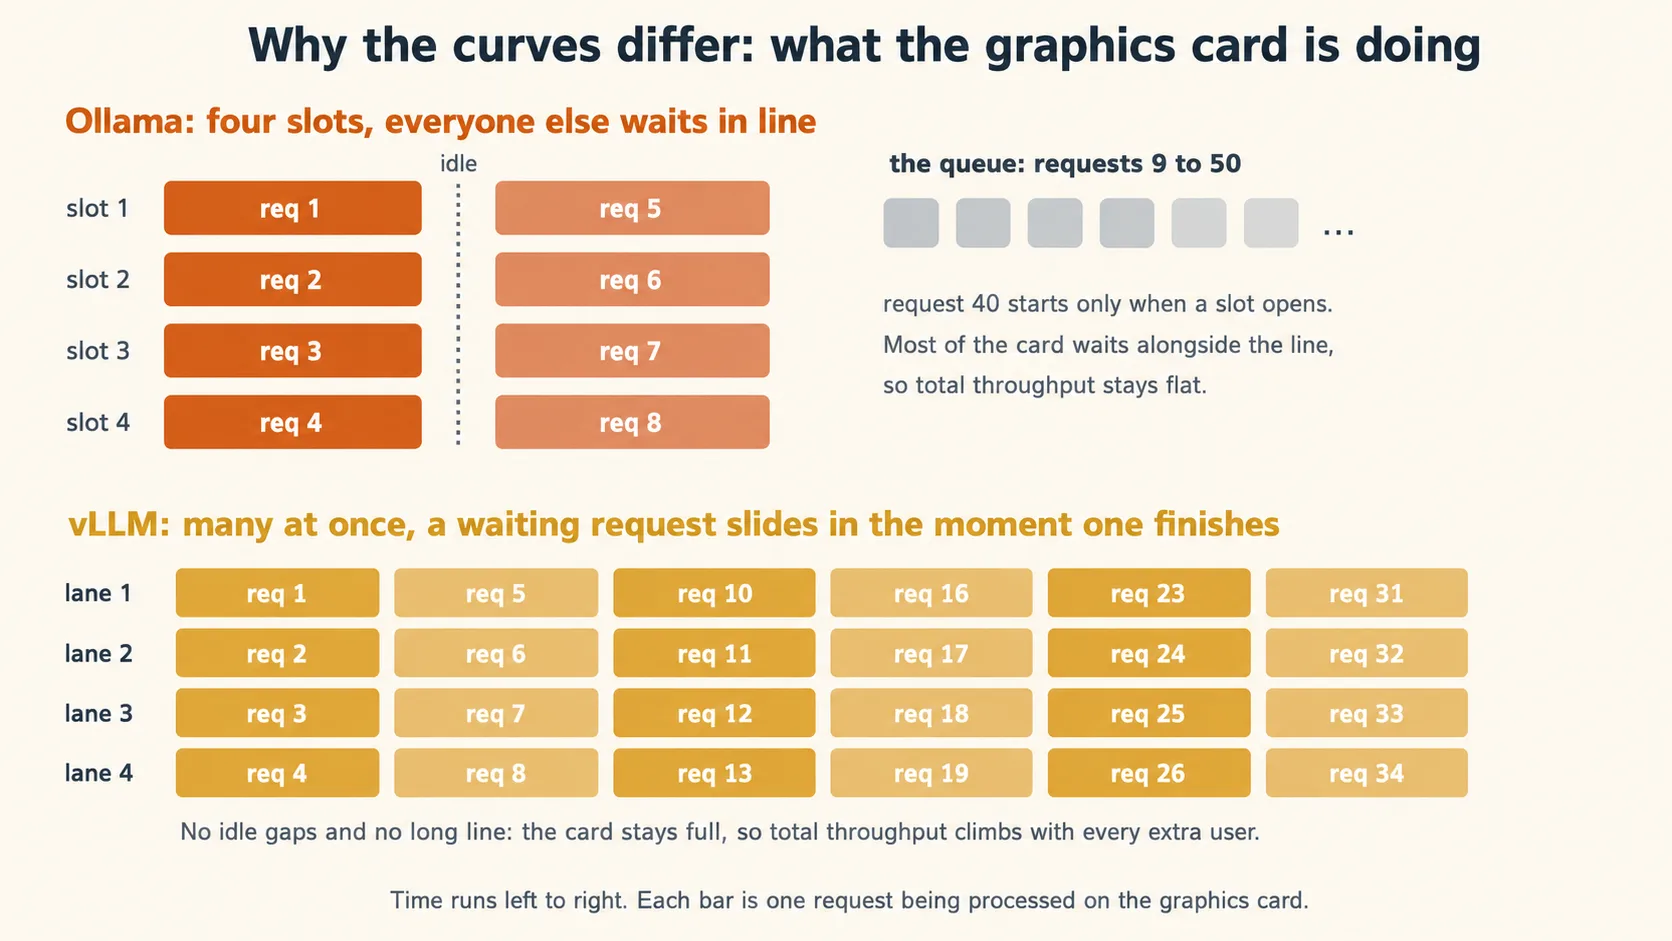
无需记住机制名称,只需记住效果:显卡始终保持满载,因此随着用户增加,总吞吐量会上升,而不是形成队列。
还要说明一点,避免层级名称误导。这里在单台机器上运行 vLLM,但 vLLM 本身并不限于此:它可以把一个模型分布到多张显卡,甚至分布到组成一个集群的多台机器。这不是另一款产品,而是同一软件扩大规模后的形态。第 3 部分租用的许多专业托管方,也正是在自家集群上运行它。因此,本课层级按照谁运营硬件命名,而不是软件能做什么。第 2 部分由你在一台服务器上运营 vLLM;第 3 部分由其他人在 64 个炉灶上运营,他们的厨房很可能也在运行 vLLM。
现在开始运行。在 GPU 机器上安装 vLLM,并提供刚才测试模型的对应版本。先说明名称:Ollama 和 vLLM 从不同模型库下载,因此同一个大脑有两个名字。Ollama 库中的 qwen3:8b,在 Hugging Face 上叫作 Qwen/Qwen3-8B,vLLM 从后者获取模型。还要诚实说明变量隔离:两份模型并非逐字节相同。Ollama 标签提供压缩(量化)后的权重,以便装进笔记本;vLLM 下载全精度原版。因此,本课所说的「同一个大脑」准确含义是:同一个 Qwen3 8B 模型的两种服务专用构建,其中 Ollama 版本更轻。精度差异是随数字一起变化的另一个变量,但不会改变实验要展示的吞吐量模式。若要尽可能接近,请在 vLLM 端也提供压缩构建:使用 vllm serve Qwen/Qwen3-8B-FP8,其他 flag 不变。
pip install vllm

vllm serve Qwen/Qwen3-8B \
  --enable-auto-tool-choice \
  --tool-call-parser hermes \
  --reasoning-parser qwen3
运行前还有一项硬件说明。全精度 8B 构建仅权重就需要约 16 GB 显存,尚未计算对话工作内存,因此最好使用 24 GB 显卡。如果只有 16 GB 显卡,请改用压缩构建:把模型名换成 Qwen/Qwen3-8B-FP8,保留相同 flag。如果 pip install vllm 因驱动和 CUDA 版本与机器冲突,vLLM 官方 Docker 镜像是最容易复现的安装方式,具体方法见 vLLM 文档。
首次运行会下载模型,随后服务器在 http://localhost:8000 启动。两个工具 flag 比看起来更重要:--enable-auto-tool-choice 配合工具调用解析器,能让 vLLM 把模型输出转换为概念 6 中干净、结构化的工具调用。省略它们,coding agent 会悄悄失败,因为服务器不会生成 harness 能执行的工具调用。(正确的解析器名称因模型家族而异;hermes 是 Qwen3 模型的标准选择。提供其他模型时,请查询 vLLM 工具调用文档。)
用一个请求证明服务已经启动:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "Qwen/Qwen3-8B", "messages": [{"role": "user", "content": "Say hello in one line."}]}'
看看刚才输入的内容:localhost、端口 8000、/v1/chat/completions。它与整门课使用的地址形状相同。大脑没有改变,改变的是地址背后的厨房。
**概念 9 的完成标准:**vLLM 已经在机器上提供 Qwen3 8B,并响应 curl 请求;你还能各用一句话说明连续批处理和分页内存带来的好处。
10. 揭晓结果:同样 50 个请求,两条曲线
一切都已就绪。机器相同,大脑相同,脚本相同,50 个请求也相同。只有服务层不同。对 vLLM 运行完全相同的扫描:
python bench.py http://localhost:8000/v1 Qwen/Qwen3-8B 1
python bench.py http://localhost:8000/v1 Qwen/Qwen3-8B 5
python bench.py http://localhost:8000/v1 Qwen/Qwen3-8B 10
python bench.py http://localhost:8000/v1 Qwen/Qwen3-8B 25
python bench.py http://localhost:8000/v1 Qwen/Qwen3-8B 50
特别观察并发量 50 的批次。Ollama 下延伸到许多分钟的实际耗时应该会骤降:50 个请求通常远早于固定配置的 Ollama 完成,回答会接近同时到达,而不是一批批出现。
现在画图,因为这幅图是第 2 部分最值得带走的内容。把测得的 10 个数字填入下面脚本(如有需要,先运行 pip install matplotlib),再执行:
# plot.py: tokens per second against concurrency, one line per serving layer.
import matplotlib.pyplot as plt

concurrency = [1, 5, 10, 25, 50]
ollama_tps = [0, 0, 0, 0, 0]   # your five Ollama numbers from Concept 8
vllm_tps = [0, 0, 0, 0, 0]     # your five vLLM numbers from this concept

plt.plot(concurrency, ollama_tps, marker="o", label="Ollama (qwen3:8b)")
plt.plot(concurrency, vllm_tps, marker="o", label="vLLM (Qwen/Qwen3-8B)")
plt.xlabel("Concurrent requests")
plt.ylabel("Total throughput (tokens/sec)")
plt.title("Same model, same machine, two serving layers")
plt.legend()
plt.savefig("two-curves.png", dpi=200)
最终会得到两条曲线。Ollama 曲线应该大致保持平坦:增加用户不会提高吞吐量,主要只会拉长队列,因此每个用户分到的吞吐量变少。vLLM 曲线应该会上升:每增加一个用户,吞吐量就提高一些;最初升得很快,显卡接近真正满载时逐渐弯曲。确切数字取决于显卡、版本和设置,不会与其他人完全相同,但曲线形状通常相同,而形状就是课程。要把一次运行变成证据,而不是轶事,请在数字旁记录显卡、驱动以及 Ollama、vLLM 版本。这样,不同硬件上的不同结果就是发现,不是谜团。
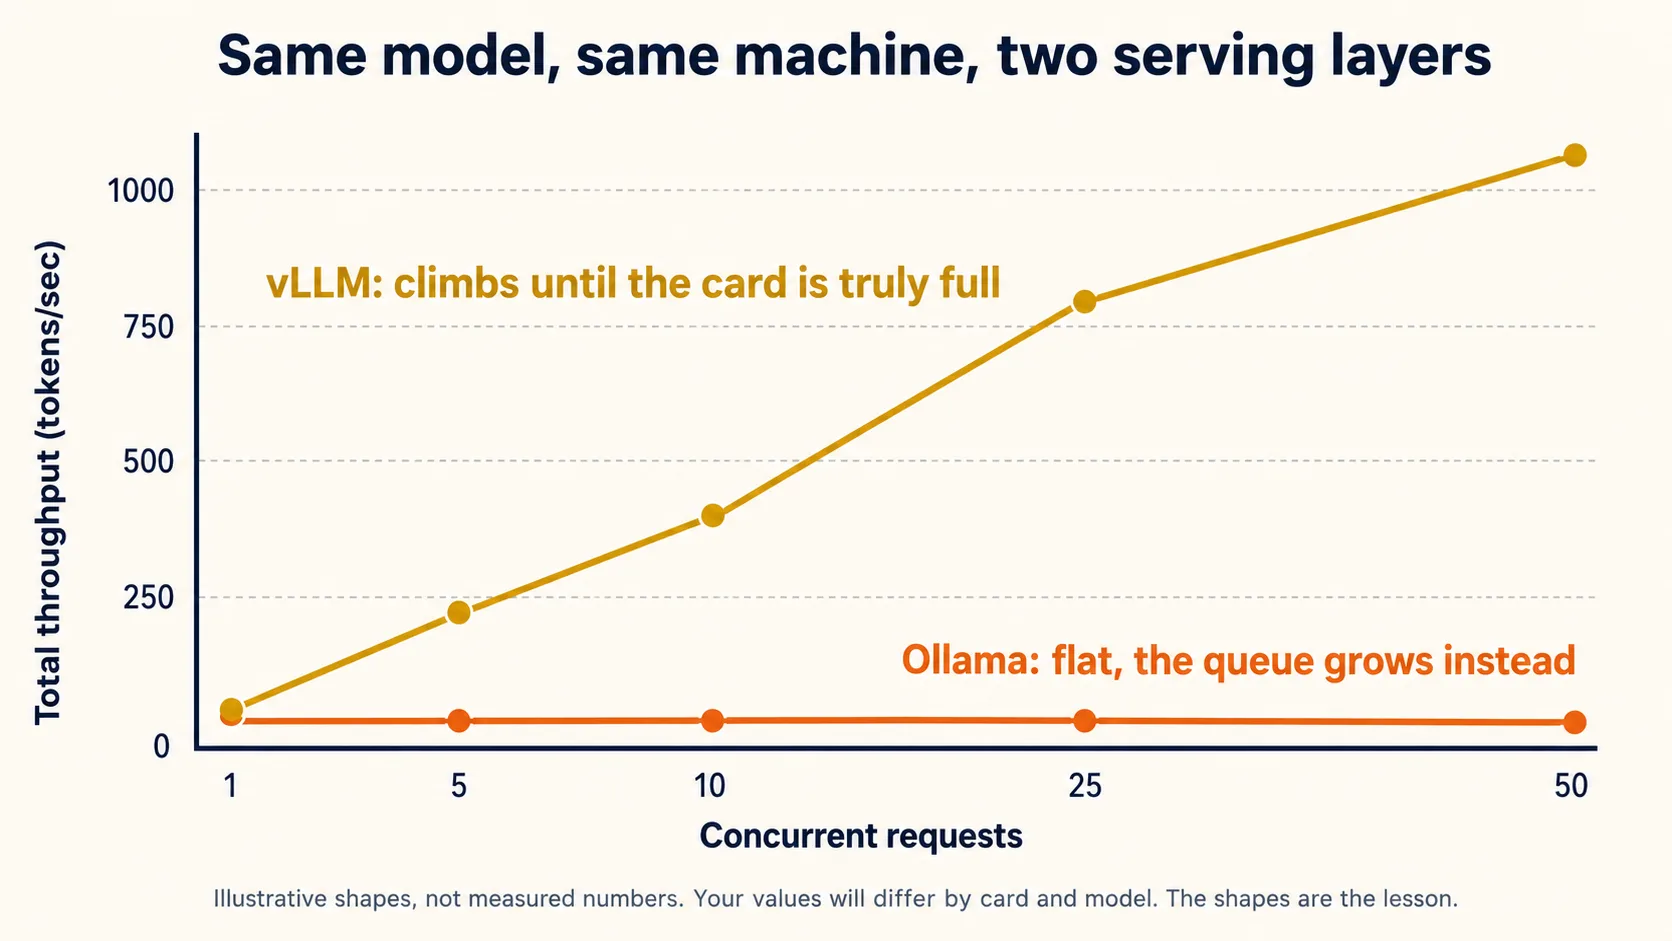
上图只展示预期的形状,并非真实测量。真正重要的是你用自己的 10 个数字绘制的图。
现在准确说明两条曲线之间的差距是什么。不是硬件,因为显卡相同;不是脚本,因为请求相同;也不是任何关键意义上的大脑,因为模型家族相同,只有概念 9 已经说明的精度差异作为附带变量。差距主要属于服务层。在实践允许的范围内固定其他一切,只改变一项,测得的效果却非常巨大。这是诚实的结论,而且已经足够有力。
朋友看到图后说:「所以 vLLM 会让模型更快,也应该在笔记本上使用。」这句话哪里正确,哪里错误? 两个部分都错了,但错法很有启发。对单个用户来说,vLLM 不会让模型更快:并发量为 1 时,两条曲线通常从相近位置开始,因为单个请求无法利用保持显卡满载的技巧。vLLM 提升的是负载下的机器速度,它会同时服务多个请求。它也帮不了普通笔记本,因为连续批处理需要一张显卡来承载批次。vLLM 的优势恰好出现在 Ollama 从未打算进入的场景:1 台强劲机器,多个用户。查看答案
**概念 10 的完成标准:**图已经绘制,一条曲线平坦,一条曲线上升;你还能用一句话解释为什么差距主要属于服务层。
11. 把 coding agent 接到服务器
只有工具能够使用,快速服务器才有意义。因此,再重复一次第 1 部分的动作,使用本课第三个地址:把 Claude Code 和 OpenCode 指向 vLLM。
到这里,下面一点应该熟悉得近乎可疑:接线完全相同。vLLM 同时支持两个 agent 使用的请求格式。它提供 OpenCode 所需的 OpenAI 风格地址,也原生实现 Claude Code 使用的 Anthropic Messages 格式,因此中间无需转换器。
- Claude Code
- OpenCode
仍然使用第 1 部分的 3 项设置,更改端口,再增加一项:告诉 Claude Code,所有模型层级都映射到正在提供的模型。
export ANTHROPIC_BASE_URL=http://localhost:8000      # bare address again, no /v1
export ANTHROPIC_AUTH_TOKEN=dummy
export ANTHROPIC_API_KEY=dummy
export ANTHROPIC_DEFAULT_OPUS_MODEL=Qwen/Qwen3-8B
export ANTHROPIC_DEFAULT_SONNET_MODEL=Qwen/Qwen3-8B
export ANTHROPIC_DEFAULT_HAIKU_MODEL=Qwen/Qwen3-8B
claude
这些模型层级设置存在,是因为 Claude Code 通常会按名称切换 Anthropic 的大小模型。把三个层级都映射到正在提供的模型,意味着无论它请求什么,都会得到 Qwen3 8B。(这些变量来自 vLLM 自己的 Claude Code 指南;内容变化时,应当查询这份实时来源。)
复制第 1 部分的 opencode.json,只改两个字符串:端口和模型名。
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "vllm": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "vLLM (server)",
      "options": { "baseURL": "http://localhost:8000/v1" },
      "models": { "Qwen/Qwen3-8B": { "name": "Qwen3 8B (vLLM)" } }
    }
  },
  "model": "vllm/Qwen/Qwen3-8B"
}
请注意 /v1 仍然存在:OpenCode 继续使用 OpenAI 风格,vLLM 会作出响应。第 1 部分中裸地址与 /v1 的对照原样保留。
然后在可丢弃的文件夹里运行概念 4 的同一任务:
查看这个文件夹。找出一项小而安全的改进,完成修改,再向我展示改了什么。
如果笔记本在第 1 部分缓慢爬行或中断,这次运行就是回报。模型相同,任务相同,但真正的显卡位于为工作而建的服务层后方:概念 5 的吞吐量墙消失了;启动 vLLM 时加入工具解析 flag,工具调用也能顺畅流动。
关于共享,需要坦率提醒。vLLM 机器一旦服务你之外的任何人,localhost 就会变成机器的真实地址,而暴露在互联网上的开放模型服务器就是一扇敞开的门。至少应使用 --api-key 和真正的秘密启动 vLLM,把密钥交给用户,并让机器处于网络的常规保护之下。vLLM 文档介绍了安全提供服务的方法。在教室开始使用前,请先阅读。
**概念 11 的完成标准:**至少一个 coding agent 已通过 vLLM 服务器完成真实任务;你还能说出与第 1 部分相比改变的一项内容(地址),以及没有改变的内容(其余一切)。
12. 什么时候值得使用服务器层级
现在两条测量曲线都在手里,因此这个决定可以依据事实,而不是追逐时髦。
当一台强劲机器需要服务许多张嘴时,服务器层级占优:
- **团队或教室。**50 名学生使用 50 台笔记本,会全部撞上第 1 部分的两堵墙。让 50 名学生指向 1 台 vLLM 机器,就能共享一套已经越过墙的配置。这就是实验室、公司或 PIAIC 教室如何用 1 张 GPU 的价格,为每个人提供有能力的 agent
- **全天运行的 loop。**之后在 Loop Engineering 中构建的 agent,会永远每隔几分钟发送请求。按 token 计费的账单也会一直增长。使用自己的 GPU 时,只要机器已经忙碌,再增加一个请求几乎没有额外成本。上升曲线正好解释了原因:吞吐量随负载提高,因此忙碌机器的每 token 成本很低
- **团队规模的隐私。**把第 1 部分的隐私优势扩展到整个组织:数据留在你控制的机器上,同时仍能服务所有人
再说明诚实的限制,它也是通往第 3 部分的桥梁。vLLM 只移动了一堵墙:吞吐量。另一堵墙完全没动。vLLM 后面的 Qwen3 8B 能快速回答 50 个人,但聪明程度与笔记本上基本相同,因为底层是同一个大脑。如果任务本身超出 8B 模型的能力,再好的服务层也无法挽救。能力墙需要更大的大脑来突破,而世界上最大的开放大脑装不进租用机器,也装不进你今后能拥有的任何单台机器。面对它们,需要再更改一次地址。
一个全天运行的 agent loop,在 Ollama 上处理高难重构任务时不断给出错误回答。同事建议迁移到 vLLM 来修好答案。可行吗? 不可行。高难任务中的错误回答属于能力墙,服务层不会改变它。vLLM 会更快地提供同一个大脑,不会把大脑变聪明。迁移到 vLLM 能修复队列和缓慢,也就是吞吐量;修复错误回答需要更强模型,而第 3 部分的云端层级正为此存在。这仍然是概念 5 的表格,只是提高了一个层级。查看答案
**概念 12 的完成标准:**你能说出一种服务器层级同时胜过笔记本和云端的场景,也能说明 vLLM 移动了哪堵墙、无法移动哪堵墙。
第 3 部分:云端层级,几乎无人能自行托管的前沿开放模型(OpenRouter)
本部分的服务层是别人的集群,通过 OpenRouter 访问。规模大到「自托管」对你以及地球上几乎每家公司都不再是真正的选择。
13. 你举不动的开放权重:Kimi K3 与 DeepSeek V4 Pro
第 2 部分以一项诚实限制结束:能力墙需要更大的大脑来突破。下面看看当前最大的开放大脑,并坦率理解在这种规模下「开放」意味着什么。
截至 2026 年 7 月撰写本页时,本课选择了两个模型,各自代表不同理由:
- Kimi K3 来自 Moonshot AI,代表性能。它于 2026 年 7 月发布,拥有 2.8 万亿参数和 100 万 token 的上下文窗口。发布时,它在主要能力指数中排名当时开放权重模型第一,已经接近最强闭源模型。排名每月都会变化,请把这视为带日期的快照;再次引用前应查看当前排行榜。它的权重确实开放,每一份都能下载
- DeepSeek V4 Pro 来自 DeepSeek,代表性价比。它拥有 1.6 万亿参数(每个 token 大约激活 490 亿),同样提供 100 万 token 上下文窗口,并以 MIT 许可证发布。原始能力比 K3 低一档,使用价格却便宜得多。这个取舍正是它出现在这里的原因
还有一项细节把三个层级连接起来。Moonshot 发布 K3 时,直接向 vLLM 贡献了新注意力设计的服务代码,让各地托管方都能运行。第 2 部分的工业厨房与本部分的前沿厨房,很多时候是同一款软件,只是规模相差巨大。
现在算一笔诚实的账。「开放权重」意味着你获准自行运行,不代表你有能力运行。Moonshot 建议用 64 块或更多加速芯片组成一台机器来提供 K3。DeepSeek V4 Pro 已经算较小的一个,自托管仍需要 8–16 张数据中心 GPU 组成的集群,硬件价格超过一栋房子。第 2 部分的技能可以扩展到 Qwen3 32B 这类模型,或租用多 GPU 机器上的 100B 级混合模型;但无法扩展到这里。除严肃的基础设施团队外,几乎没有人的技能能做到。使用前沿开放模型时,所有人都在租用。
既然仍要租用,「开放」能带来什么?有三项真实价值。**没有锁定:**任何拥有集群的组织都能提供相同权重,竞争者也确实这样做,因此没有一家公司能单独撤回模型、改变价格或悄悄修改模型。**选择房东:**许多公司托管相同权重,并在价格和速度上竞争。**为未来托底:**如果它真的变得至关重要,你、你的国家或公司仍能架设硬件。这个规模上的开放权重,与其说是「在家运行」,不如说是「没有人独占水龙头」。
托管方之间的竞争带来一个实际问题:数十家托管公司,各有账号、密钥和账单。OpenRouter 用整门课已经教你预期的方式解决:提供一个地址。必须准确理解它,因为层级表格有所简化。OpenRouter 是一个网关,也就是接收请求,再转发给实际提供模型的托管方。托管方运营服务层,常常就是 vLLM;OpenRouter 运营前门:一个账号、一把 API 密钥、一页账单,覆盖数百个模型。请在 openrouter.ai 注册,充值几美元,创建密钥,并在做任何事前设置月度支出上限。这把密钥既是秘密,也是钱包,合在一个字符串中:绝不要粘贴到会提交或共享的代码里。
第 1 部分是在家做饭,第 2 部分是经营自己的工业厨房,第 3 部分则是世界顶级餐厅:厨房里有 64 个炉灶和整支厨师团队。你永远不会在家建造一间,也不需要。OpenRouter 就是把所有这些餐厅放进同一份菜单的外卖应用,只需一次登录,收到一张账单。手机上的应用始终相同。
**概念 13 的完成标准:**你已经拥有 OpenRouter 账号、密钥和支出上限,并能用一句话解释为什么在这种规模下,「开放权重」不再等同于「你能自托管」。
14. 用同样两个 agent 驱动前沿大脑
第三个层级,同一个动作。现在要把第 1、2 部分完全相同的 harness 指向地球上最强的开放模型,接线看起来会熟悉得近乎尴尬。
- Claude Code
- OpenCode
OpenRouter 直接支持 Claude Code 的原生格式(它称之为 Anthropic 兼容端点),因此配置仍是第 1 部分的 3 个变量,只在中间放入真实密钥:
export ANTHROPIC_BASE_URL=https://openrouter.ai/api   # bare, one more time: no /v1
export ANTHROPIC_AUTH_TOKEN=sk-or-...                 # your OpenRouter key
export ANTHROPIC_API_KEY=                             # must be empty
claude --model moonshotai/kimi-k3
持久保存前,先注意密钥卫生。这把密钥就是钱包。shell export 只持续一次会话,是最安全的起点。如果把变量移入设置文件,请使用主目录中的 ~/.claude/settings.json,绝不要放进项目内会提交的设置文件。推送到 git 仓库的密钥,会被陌生人花掉。
OpenRouter 模型名采用 maker/model 形式,字符串必须完全正确:Kimi K3 是 moonshotai/kimi-k3,DeepSeek V4 Pro 是 deepseek/deepseek-v4-pro。一个字符写错就只会返回「model not found」。请从 openrouter.ai 的模型页面复制 slug,不要手打。
Claude Code harness 围绕 Anthropic 自家模型构建和测试,而 OpenRouter 只对 Anthropic 第一方供应商保证完整 Claude Code 兼容性。Kimi K3 与 DeepSeek V4 Pro 支持兼容格式,许多人也能成功这样驱动,但工具调用仍可能以奇怪方式落地。这属于 harness 与模型的适配问题,不是配置错误。请把这种组合视为实验。如果想使用本练习完全受支持的路径,请切换到 OpenCode 标签页:OpenRouter 是 OpenCode 原生供应商,没有兼容性附注。如果想保留 Claude Code 并磨平这些边缘,社区已经构建了专门工具:概念 16 会介绍 Claude Code Router。
两个习惯能省下整晚时间:
- 用
/status验证文字发往哪里。Anthropic base URL一行应该显示 OpenRouter 地址,token 应显示为当前凭据。相信检查,不要相信假设 - 根据 Claude Code 当前文档,
ANTHROPIC_AUTH_TOKEN优先于保存的 Anthropic 登录,因此变量本身应该获胜。但旧登录仍可能在启动时触发认证冲突警告,旧指南也报告过干扰。如果/status显示错误端点,或冲突警告指出两个凭据来源,请运行一次/logout,重启后再次检查
OpenCode 内置支持 OpenRouter,因此这次无需编写供应商块。在 OpenCode 中运行 /connect,选择 OpenRouter,再粘贴密钥(旧版本从 shell 运行 opencode auth login)。许多 OpenRouter 模型已经预载,可以用 /models 选择,也可以固定在 opencode.json 中:
{
  "$schema": "https://opencode.ai/config.json",
  "model": "openrouter/deepseek/deepseek-v4-pro"
}
要驱动另一个模型,请换成 openrouter/moonshotai/kimi-k3。完整配置只有这些。
现在最后运行一次概念 4 的同一任务。在同一个可丢弃文件夹中,每个模型各运行一次:
查看这个文件夹。找出一项小而安全的改进,完成修改,再向我展示改了什么。
感受它与之前每次运行的差别。应该不再排队、不再缓慢爬行,并能得到干净的工具调用:前沿模型轻松越过能力墙,吞吐量墙则交给别人的 64 个炉灶。只改变一个地址,两堵墙就同时越过。如果仍有运行跌倒,原因也已经转移:应检查模型与 harness 的适配、供应商、路由或提示词,而不是本地硬件。
还要注意你放弃了什么,因为取舍正是课程。自概念 1 以来,文字第一次离开你的机器;本课中,token 也第一次在流动时产生费用。任务结束后查看 OpenRouter 活动页,会看到真实请求以及附带的价格。私密和免费属于第 1 部分;这里强大,但按量计费。
agent 现在通过 OpenRouter 快速完成任务。与概念 1 相比,你放弃了哪两样东西?哪个习惯能告诉你文字究竟发往哪里? 你放弃了隐私(文字离开机器,经过供应商)和免费(每个 token 都会从余额中计费)。正确习惯是检查,而不是假设:Claude Code 的 查看答案
/status 或 OpenCode 模型选择器,会准确显示请求发往哪个地址。第 1 部分的规则适用于每个层级:相信看得见的设置,不要相信记忆中做过的配置。
**概念 14 的完成标准:**K3 和 V4 Pro 都通过 agent 完成了一次真实编程任务;/status(或 OpenCode 模型选择器)确认了请求目的地;活动页也显示一条带有真实价格的真实请求。
15. 性能还是价格:选择模型,选择层级
你刚才驱动了两个前沿模型。它们的成本不同,而在两者之间选择,是你第一次真正体验今后会不断面对的决定。
撰写本页时,标价大致如下:Kimi K3 每百万输入 token $3、每百万输出 token $15;DeepSeek V4 Pro 输入约 $0.44、输出约 $0.87。请慢慢读懂这个差距:在输出端,性价比选项大约比性能选项便宜 17 倍。价格变化很快,请像对待每个版本号一样对待这些数字:它们是用于推理的一张快照;制定预算前,必须在 OpenRouter 模型页面实时查询。
那么,什么时候 K3 值得多付 17 倍?当任务难到 V4 Pro 无法完成,而失败成本是你的时间。一场成功的长时间 agentic 运行,胜过 5 场需要你收拾残局的廉价运行。大多数团队最终采用的工作规则是:**默认使用性价比模型;只有廉价模型已被证明不足时,才升级到性能模型。**升级应由真实失败触发,不靠感觉。还有一个数字会彻底改变 agent 的计算方式:缓存输入。agent 每轮都会重发相同指令和仓库上下文;这段重复前缀命中供应商缓存时,两家都只收取输入价格的一小部分。对于 loop 型工作负载,实际账单往往远低于标价计算。每家供应商的定价页都会说明缓存规则。做 agent 工作时,请先读这一节,不要留到最后。
现在拉远视角,你已经可以看完整幅图。一个 harness、一个思路、三个层级:
| 层级 | 服务层 | 本课使用的大脑 | 地址 | 谁支付计算成本 | 优势 |
|---|---|---|---|---|---|
| 本地 | Ollama | Qwen3 8B | 你的 localhost | 已经支付(笔记本) | 隐私、离线、免费、学习 |
| 服务器 | vLLM | Qwen3 8B 的服务专用构建 | 你控制的机器 | 你按 GPU 小时支付 | 多用户、全天 loop、团队数据 |
| 云端 | OpenRouter(网关) | Kimi K3、DeepSeek V4 Pro | openrouter.ai | 你按 token 支付 | 最难任务、零配置、前沿能力 |
下面是决策流程,请按顺序提问。**第一,数据可以离开吗?**如果不可以,排除云端,再根据需要服务的人数,在本地和服务器之间选择。**第二,任务是否在中等规模开放模型的能力范围内?**如果可以,层级选择就是经济问题:一个人用笔记本,多人或 loop 用 vLLM 机器。**第三,如果任务需要前沿大脑,**就进入云端层级,使用本概念的规则:默认选便宜模型,出现已证实失败时才选昂贵模型。只有 3 个问题,而今后所有开放模型部署讨论都能放进这个框架。
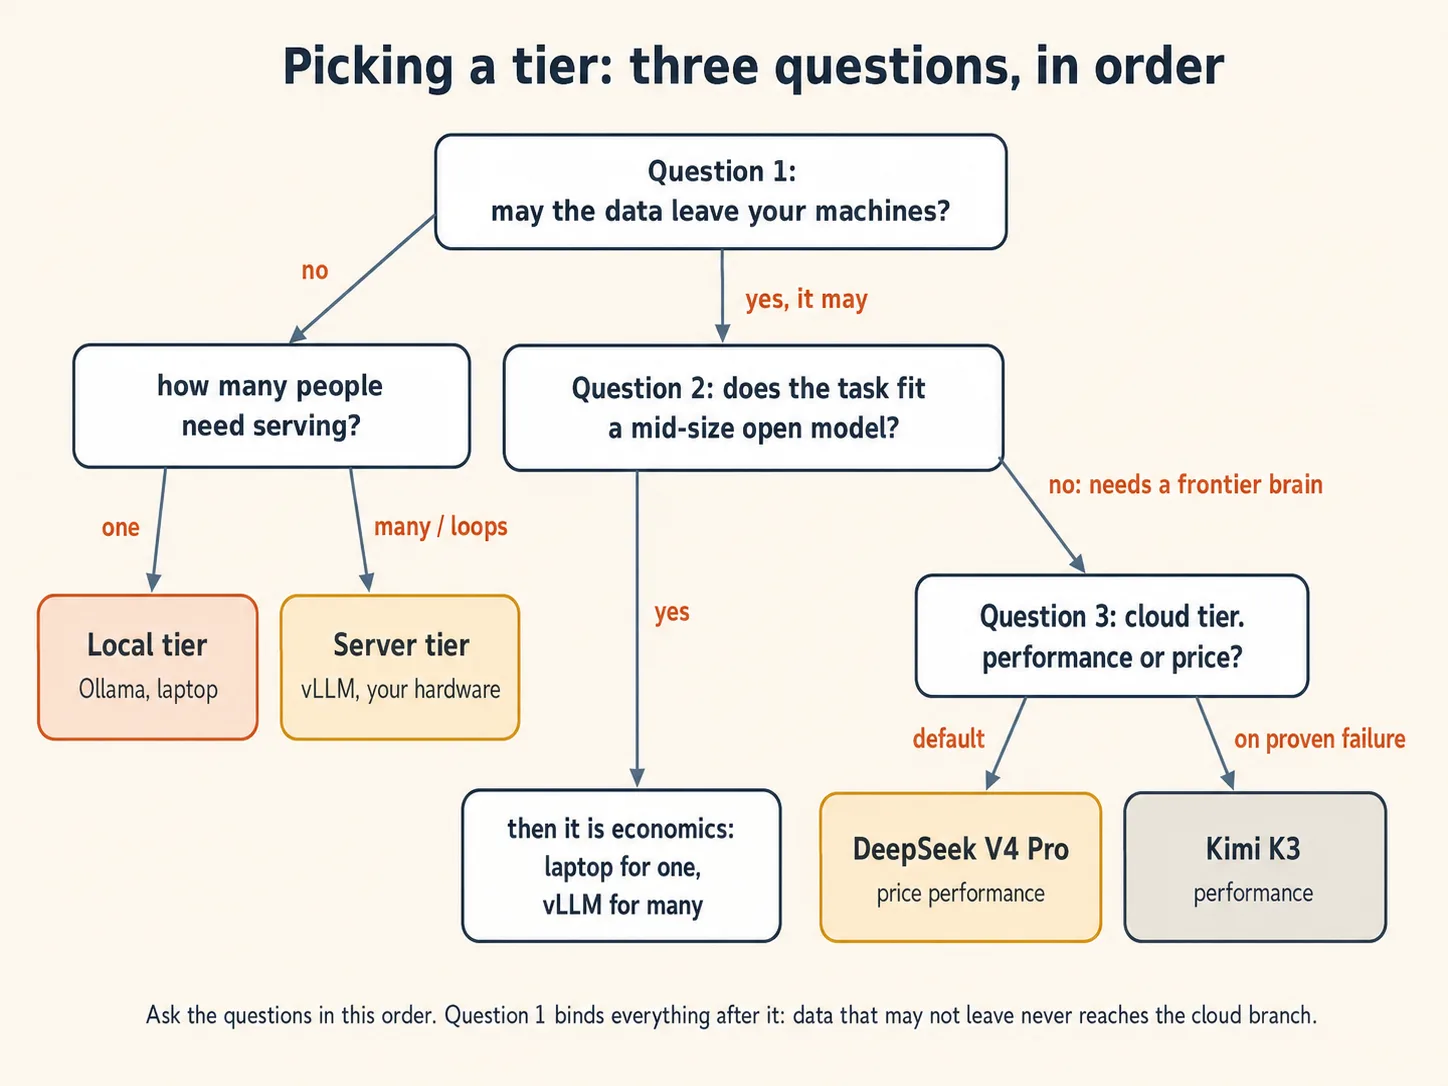
一家公司想让 agent 全天审查机密客户合同。任务难度中等,强劲的中等规模模型完全能够处理。应该选择哪个层级?另外两个为什么不对? 选择服务器层级。第 1 个问题排除了云端:机密合同不应离开公司控制的机器。笔记本层级在两方面不合格:需要服务的人数,以及每天需要运行的时长。为团队全天运行的 loop 会立刻撞上吞吐量墙。公司网络内的 vLLM 机器能越过吞吐量墙,让数据留在内部,也让全天 loop 的每 token 成本很低。如果后来证明任务超出模型能力,公司真正的选择是用更大的租用机器运行更大的开放模型,而不是公共云,因为第 1 个问题仍然有效。查看答案
**概念 15 的完成标准:**你能按顺序说出 3 个问题,并为一个没有现成答案的场景辩护自己的层级选择。
16. 用一个 router 跨越三个层级:Claude Code Router
整门课都建立在一个观点上:大脑只是一个地址。最后一步顺理成章,也有一款流行的社区工具实现了它。如果地址不指向某个大脑,而是指向一项决定,会怎样?
Claude Code Router(CCR)是 musistudio 开发的开源工具,也是 Claude Code 生态中 star 数最高的项目之一。它在本机运行一个小服务器,一端使用 Claude Code 原生格式,另一端连接多个供应商,并在中间转换。只需把 Claude Code 指向它一次,之后由配置文件逐个请求决定由哪个大脑回答。把它放在本课末尾学习,有三个理由:
- 按任务类型路由。
Router块会把 Claude Code 的不同工作映射到不同模型:default处理普通工作,background处理廉价后台杂务,think处理高难推理,longContext处理超过 token 阈值的请求。请再慢慢读一次这份列表。它就是概念 15 的规则,也就是默认用性价比模型、困难时升级,但现在已从个人纪律变成了配置 - **覆盖刚学过的所有层级。**配置中的供应商只有名称、地址和模型列表,因此一份文件可以同时容纳笔记本上的 Ollama、vLLM 服务器和 OpenRouter,并在它们之间路由
- **磨平粗糙边缘。**它的 transformer(
openrouter、tooluse、enhancetool等)会针对不同供应商调整请求与响应,也能提高对宽松工具调用格式的容错。这是社区对概念 14 兼容性提醒给出的实际答案
用 3 步完成配置。先把它安装在 Claude Code 旁边:
npm install -g @musistudio/claude-code-router
然后创建 ~/.claude-code-router/config.json。下面这份配置包含整门课,把三个层级都放在一个地址后面:
{
  "OPENROUTER_API_KEY": "$OPENROUTER_API_KEY",
  "Providers": [
    {
      "name": "ollama",
      "api_base_url": "http://localhost:11434/v1/chat/completions",
      "api_key": "ollama",
      "models": ["qwen3:8b"]
    },
    {
      "name": "vllm",
      "api_base_url": "http://localhost:8000/v1/chat/completions",
      "api_key": "dummy",
      "models": ["Qwen/Qwen3-8B"]
    },
    {
      "name": "openrouter",
      "api_base_url": "https://openrouter.ai/api/v1/chat/completions",
      "api_key": "$OPENROUTER_API_KEY",
      "models": ["deepseek/deepseek-v4-pro", "moonshotai/kimi-k3"],
      "transformer": { "use": ["openrouter"] }
    }
  ],
  "Router": {
    "default": "openrouter,deepseek/deepseek-v4-pro",
    "background": "ollama,qwen3:8b",
    "think": "openrouter,moonshotai/kimi-k3",
    "longContext": "openrouter,moonshotai/kimi-k3",
    "longContextThreshold": 60000
  }
}
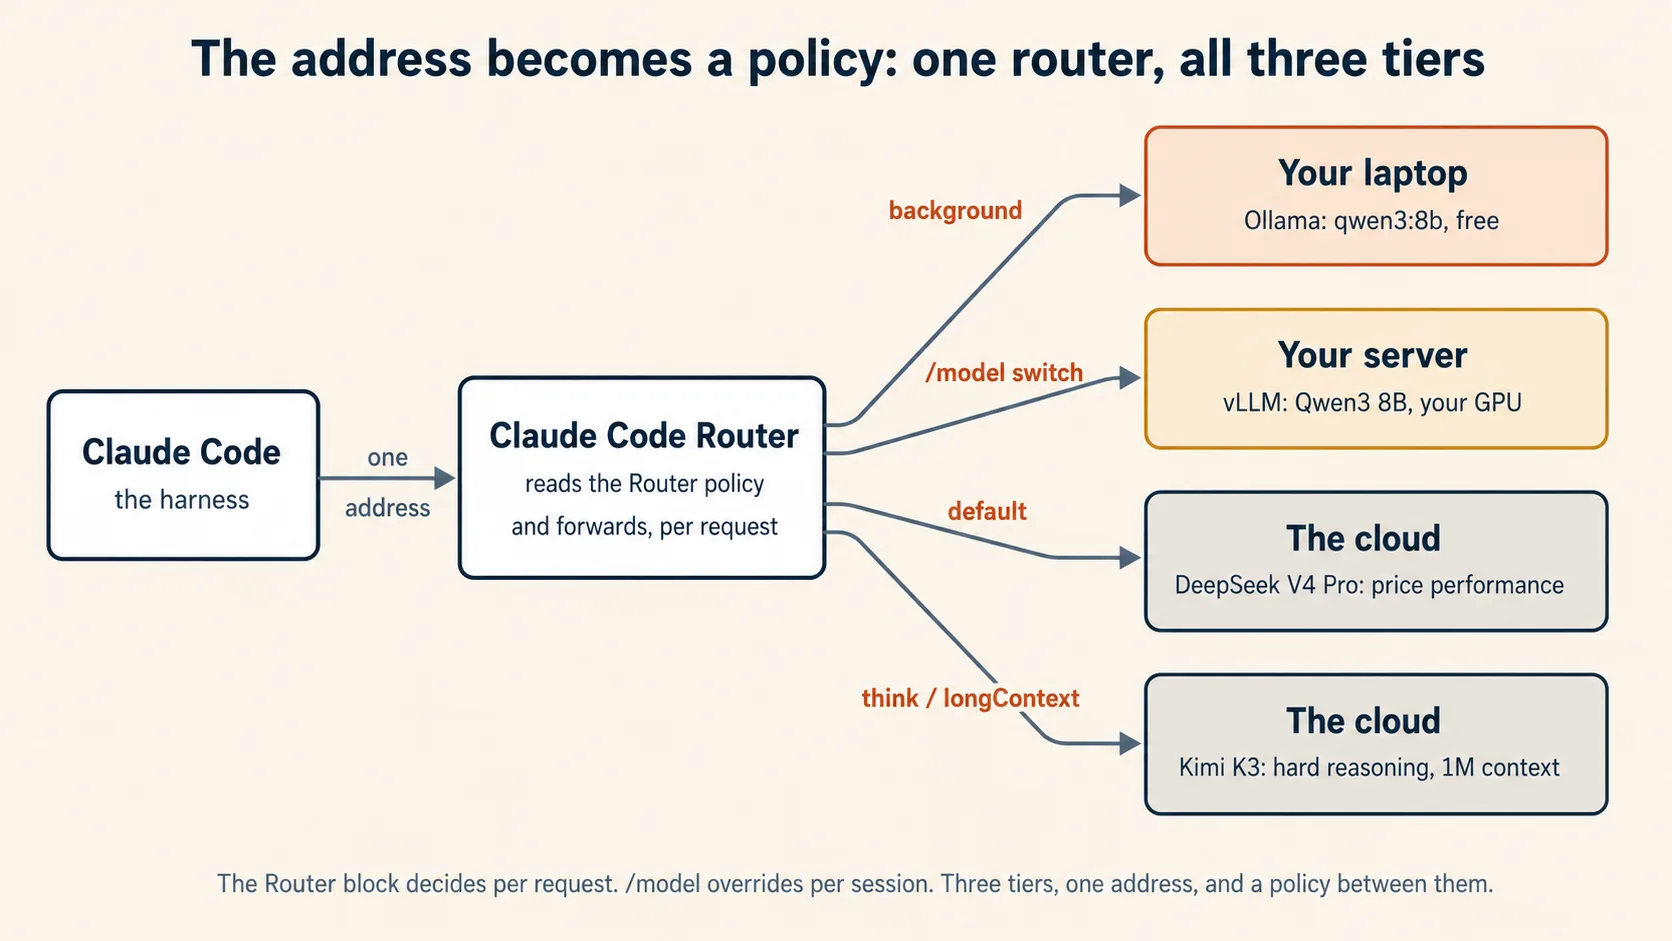
把 Router 块当作策略来读,因为它正是策略。普通工作交给最具性价比的前沿模型;廉价后台杂务留在自己的笔记本上,继续免费;高难推理和巨大上下文升级到 Kimi K3,其 100 万 token 窗口配得上 longContext 槽位。$OPENROUTER_API_KEY 语法会从环境中读取密钥,因此秘密不会写进文件。
然后通过 router 启动 Claude Code:
ccr code
几项操作可以节省时间:编辑配置后运行 ccr restart,让修改生效。在 Claude Code 会话中,可以用 /model provider,model 切换大脑,例如 /model ollama,qwen3:8b。如果不想编辑 JSON,ccr ui 会打开一个用于修改配置的网页。
最后给出两项诚实提醒。第一,CCR 是社区项目,不是 Anthropic 或任何供应商的产品。它变化很快,transformer 是实际修复而非保证;每个请求现在都会经过另一层软件,需要持续更新并阅读发布说明。第二,不要在没有必要的地方添加它。第 2 部分的 vLLM 服务器原生支持 Claude Code 格式,只在它前面放一个 router 不会带来任何收益。CCR 的价值,是让一个 Claude Code 同时指向多个大脑,并按任务路由。完成本课后,你已经知道该如何分析这种配置:三个层级、一个地址,现在再加一项在它们之间作出决定的策略。
**概念 16 的完成标准:**Claude Code 已经通过 router 运行;同一会话中至少有两个层级作出回答(用 /model provider,model 切换,并观察每次回复来自哪里);你还能把自己的 Router 块解读为它所编码的层级策略。
今天先按自己的规模尝试,再继续前进
今天先完成最小的真实版本。安装 Ollama,运行模型并与它聊天;仅这一项就能在 2 分钟内给你一套私密的本机 AI。如果写代码,请把 coding agent 接上去,亲自感受撞到哪堵墙。可以租用 GPU 一下午时,运行 50 请求实验,画出自己的两条曲线。本书很少有练习能在 1 小时里教你更多。任务击败所有能自行托管的大脑时,最后再改一次地址,用几美分或几美元借用前沿大脑。其他人需要共享成果时,附录 A 会把服务器变成可共享的服务。
把这套心智模型继续带下去,因为后续内容会按顺序建立在它上面。工具等于 harness 加可替换的大脑,而大脑只是一个地址。地址可以指向笔记本、服务器或世界最大的开放模型,harness 不知道区别。两堵墙决定配置能做什么:服务层和硬件移动吞吐量,只有更大的大脑能移动能力。接下来,你会在 Agentic Coding 中学会驾驭这个 agent,在 Spec-Driven Development 中用书面 spec 指挥它,再在 Loop Engineering 中交给它一个全天运行、无需你参与的 loop。到最后一门课时,你会准确知道应该由谁的大脑运行 loop、放在哪个层级,以及持续运行需要多少钱。
一句话小结
开源模型可以在三种规模上运行,而工具通过相同方式连接它们:一个地址。Ollama 服务 1 个人,vLLM 服务多个人,OpenRouter 连接几乎无人能自托管的前沿大脑。亲手用两条曲线测量一次差异,今后的整个职业生涯都能选对层级。
附录 A:构建一朵迷你 LLM 云
第 2 部分给了你一间工业厨房,但厨房不是餐厅。本附录会加上前门、菜单、桌号和账单,让一台能很好服务单个用户的机器,安全地服务整个班级。
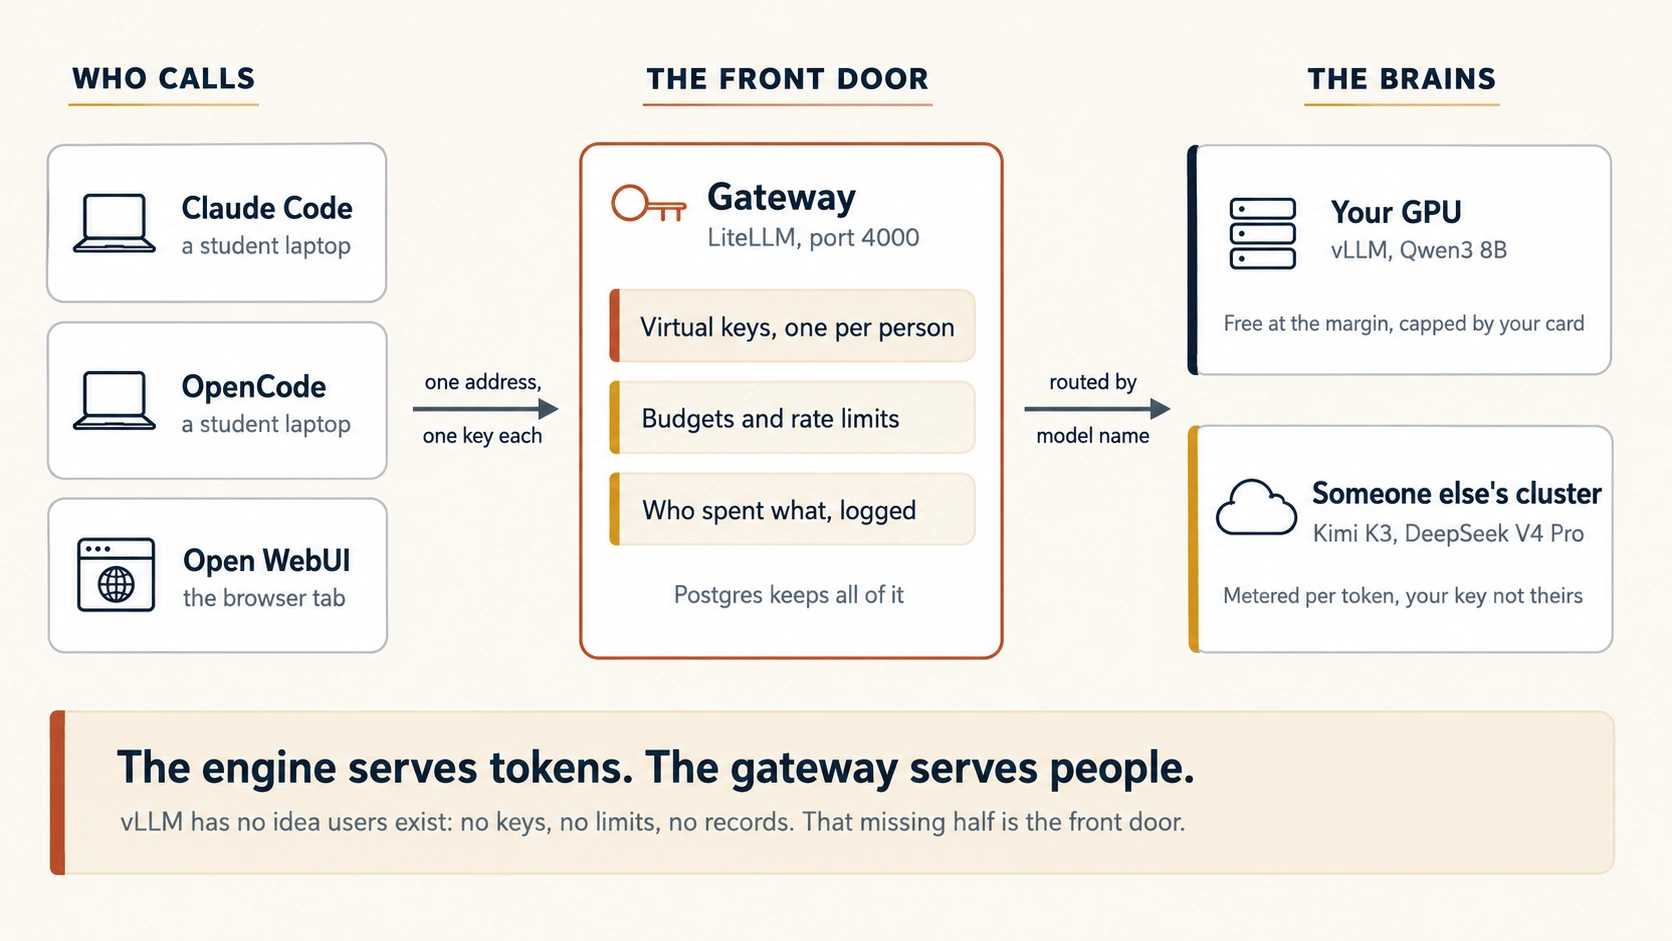
本附录要填补的缺口如下。第 2 部分结束时,vLLM 已在提供 Qwen3 8B;50 请求曲线持续上升,而 Ollama 曲线保持平坦。这是真实成果,但还不是一项服务。试着把它交给一个班级,问题会立即出现:谁可以使用?怎样阻止某位学生失控的 loop 整整一周吃掉全部机器?谁花了多少?Qwen3 8B 不够时,学生怎样连接前沿大脑,而不需要你把自己的 OpenRouter 密钥发给 200 个人?
这些问题都与提供 token 无关,因此 vLLM 不会回答。推理引擎负责加载模型并响应请求,仅此而已。它不知道用户存在,没有密钥、配额、支出记录,也没有拒绝请求的方式。这个缺失的另一半有一个名字,而本附录就要构建它。
本课的核心观点一直延伸到这里:大脑只是一个地址。第 1 部分的地址是笔记本,第 2 部分是你控制的机器,第 3 部分是别人的集群。在本附录中,你会成为这个地址:构建其他人用 agent 指向的东西。
第 2 部分所需的一切,另外还要在同一台 GPU 机器上安装 Docker 和 Docker Compose。如果已经完成第 3 部分,请为概念 A5 准备好 OpenRouter 密钥。即使不运行任何内容,也可以阅读完整附录;即使永远不构建技术栈,概念 A1、A2 和 A7 也值得阅读。
需要两个程序,不是一个。vLLM 提供 token。一个网关位于它前方,处理 vLLM 不做的一切:用户密钥、支出上限、模型路由和日志。这里使用的网关是 LiteLLM。加上 Postgres,让密钥与支出在重启后仍然存在;再加 Open WebUI,让不使用终端的人也能使用你的云。4 个容器、1 份文件、1 个下午。
本附录的新词
| 术语 | 日常含义 |
|---|---|
| 推理引擎 | 加载模型并响应请求的程序。vLLM 就是一个推理引擎。它知道 token,不知道人。 |
| 网关 / 代理 | 位于引擎前方的程序。它知道人:谁在调用、可以使用什么、需要花多少钱。 |
| 虚拟密钥 | 网关为每个人签发的 API 密钥,可以撤销,也能附加独立限制。 |
| 预算 | 一把密钥的支出上限。用完后,网关会拒绝请求,而不是让账单继续增长。 |
| 速率限制 | 每分钟请求数上限,防止一个繁忙用户挤掉其他所有人。 |
| 多租户 | 用共享硬件服务多个独立用户,同时避免相互影响。 |
| 回退 | 一条规则:「如果这个模型失败或已满,就尝试另一个。」 |
A1. 厨房不是餐厅
把本课从概念 8 开始使用的比喻再推进一步。Ollama 是有两个炉头的家庭厨房,vLLM 是让每个炉头持续工作的工业厨房。两者都是餐厅的后厨。
餐厅还需要前厅。门口要有人知道你是否预约;菜单要说明今天供应什么;桌号让厨房知道菜送去哪里;最后还要结账。这些都不是烹饪,但没有前厅的优秀厨房也不是餐厅,只是一间任由陌生人走进来的厨房。
裸 vLLM 服务器正是这种状态。任何能访问端口的人都可以永久免费使用。下面列出它不会做的事,请慢慢阅读,因为每一项原本都需要你自行构建:
| 你需要什么 | vLLM 会做吗? |
|---|---|
| 同时向多个用户快速提供 token | **会。**这是它的全部工作,而且做得非常好。 |
| 知道谁在调用 | 不会。 |
| 达到支出上限时切断某个人 | 不会。 |
| 阻止一个用户挤掉其余人 | 部分可以,通过排队实现,但无法按用户控制。 |
| 在一个地址提供多个模型 | 不会。一台服务器,一个模型。 |
| 当前模型失败时回退到其他模型 | 不会。 |
| 记录谁花了多少 | 不会。 |
| 本地模型失败时连接云端模型 | 不会。 |
表中每一个「不会」,都是网关的工作。
厨房负责做饭;前厅决定谁能吃、菜单有什么,以及由谁付款。你已经建成一间非常优秀的厨房,现在需要一扇门。
这里有一个合理问题:是否有一个程序能同时完成两者?差不多,但诚实答案很重要。服务是一项基础设施问题,开源世界已经解决得很好。计量、配额和账单则是产品问题,也是推理公司真正销售的东西。因此,开放工具会分别提供引擎和计量器,由你自行组装。好消息是,每一层都使用从第 1 部分开始采用的 OpenAI 兼容请求形状,所以组装只需要配置,不需要转换工作。
**概念 A1 的完成标准:**你能说出裸 vLLM 服务器无法完成、但 50 名学生第一天就会需要的 3 件事。
A2. 网关:一个地址,多个大脑,真实用户
网关是位于一个或多个模型服务器前方的小程序。请求到达网关,网关决定如何处理,再把它转发出去。它就是前门。
你已经使用过一个。第 3 部分的 OpenRouter 就是网关:一个地址、一把密钥、一张账单,后面有数百个模型,实际服务由你从不直接联系的托管方完成。本附录会在自己的规模、自己的机器上构建同样形状,由你而不是公司来运营。
这里使用的工具是 LiteLLM。它是一个开源代理,对用户使用 OpenAI 兼容格式,再向外转换到一长串供应商,其中包括自己的 vLLM 服务器。它适合这项工作的原因有四个:
- **虚拟密钥。**为每位学生签发独立密钥。可以附加限制、查看支出,并在学期结束或笔记本丢失时立即撤销
- **预算与速率限制。**密钥可以带有支出上限和每分钟限制。失控 loop 撞到上限后,网关会拒绝下一项请求。账单会停在你预先选择的数字
- **一个地址上的模型菜单。**本地 Qwen3 8B 与云端前沿模型可以同时出现在一个网关上,同一批学生用同一把密钥访问
- **记录。**每项请求都会记录到某位用户名下,「谁花了多少」变成一次查询,而不是调查
请注意它的形状。网关不会让任何东西变快,不会改变每秒 token 数,还会增加几毫秒延迟。它根本不是性能工具,而是控制工具;控制会把服务器变成服务。
一名学生说网关毫无意义,因为「vLLM 已经给了我 OpenAI 兼容地址,直接使用就行」。最有力的回答是什么? 关于地址,他说得对;关于服务,他说得不对。vLLM 地址很适合一个可信用户,这也正是概念 11 可以停在那里的原因。多人出现后,才需要网关处理随之而来的一切:独立密钥、支出上限、速率限制、包含多个模型的菜单、回退,以及谁使用了什么的记录。这些都不是速度功能,因此在某个失控 loop 运行整整一个周末、又没人知道是谁启动之前,这种比较会显得空洞。查看答案
**概念 A2 的完成标准:**你能用一句话说明网关会添加什么,而推理引擎永远不会添加什么;也能解释为什么它不是速度功能。
A3. 启动它:一份文件中的完整技术栈
4 个容器,1 台机器,1 份文件。
| 容器 | 工作 |
|---|---|
| vllm | 在 GPU 上提供 Qwen3 8B。与概念 9 的服务器相同,只是前方多了一扇门。 |
| litellm | 网关。用户唯一会直接接触的东西。 |
| postgres | 存储密钥、用户、预算和支出,重启不会抹掉整个班级。 |
| open-webui | 为不常使用终端的同学提供聊天页面。 |
先编写网关自身的配置。将它保存为 litellm-config.yaml:
model_list:
  # Your own GPU, from Part 2. Students see the name on the left.
  - model_name: qwen3-8b
    litellm_params:
      model: hosted_vllm/Qwen/Qwen3-8B
      api_base: http://vllm:8000/v1
      api_key: "not-needed"

general_settings:
  master_key: os.environ/LITELLM_MASTER_KEY
  database_url: os.environ/DATABASE_URL

litellm_settings:
  drop_params: true
其中两个细节值得明确说明。model_name 是用户输入的名称,不必与下方真实模型名相同。正是这种间接映射,让你以后可以替换大脑,不需要通知任何人。master_key 是整朵云的管理员密码,不是学生密钥,永远不应离开机器。
下面配置技术栈。将它保存为 docker-compose.yml:
services:
  vllm:
    image: vllm/vllm-openai:latest
    command: >
      --model Qwen/Qwen3-8B
      --enable-auto-tool-choice
      --tool-call-parser hermes
      --reasoning-parser qwen3
    volumes:
      - ./hf-cache:/root/.cache/huggingface
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: all
              capabilities: [gpu]

  postgres:
    image: postgres:16
    environment:
      POSTGRES_DB: litellm
      POSTGRES_USER: litellm
      POSTGRES_PASSWORD: ${POSTGRES_PASSWORD}
    volumes:
      - ./pgdata:/var/lib/postgresql/data

  litellm:
    # Pin the version. Read the security note below before you change this.
    image: ghcr.io/berriai/litellm:main-v1.80.5
    depends_on: [vllm, postgres]
    ports:
      - "4000:4000"
    environment:
      LITELLM_MASTER_KEY: ${LITELLM_MASTER_KEY}
      DATABASE_URL: postgresql://litellm:${POSTGRES_PASSWORD}@postgres:5432/litellm
    volumes:
      - ./litellm-config.yaml:/app/config.yaml
    command: ["--config", "/app/config.yaml", "--port", "4000"]

  open-webui:
    image: ghcr.io/open-webui/open-webui:main
    depends_on: [litellm]
    ports:
      - "3000:8080"
    environment:
      OPENAI_API_BASE_URL: http://litellm:4000/v1
      OPENAI_API_KEY: ${LITELLM_MASTER_KEY}
    volumes:
      - ./webui-data:/app/backend/data
把两个秘密放进同目录的 .env 文件,绝不要直接写进 Compose 文件:
LITELLM_MASTER_KEY=sk-choose-a-long-random-string
POSTGRES_PASSWORD=choose-another-long-random-string
然后启动技术栈,并证明它能工作:
docker compose up -d

curl http://localhost:4000/v1/chat/completions \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "qwen3-8b", "messages": [{"role": "user", "content": "Say hello in one line."}]}'
把这个请求与概念 9 的请求放在一起看。形状相同,/v1/chat/completions 相同,只多了一行:Authorization header。这一行就是服务器和服务之间的全部差别。现在,调用者必须说明自己是谁。
2026 年 3 月,LiteLLM 包遭到供应链攻击,恶意版本发布后才被撤下。网关保存云中的每一把密钥和每一条支出记录,因此是技术栈中价值最高的攻击目标。所以,请固定精确版本标签,绝不要跟踪 latest;升级前先阅读发布说明;完成这两项前,不要把网关暴露到公网。这并非 LiteLLM 特有的警告,而是运行任何保存凭据的服务都必须承担的责任。
驱动与 CUDA 不匹配是最常见原因,也是这份 Compose 文件使用官方镜像而非 pip install 的原因。主机还必须安装 NVIDIA Container Toolkit,否则 Docker 容器看不到 GPU。如果使用 16 GB 显卡,请像概念 9 一样,把模型行改为 Qwen/Qwen3-8B-FP8。
概念 A3 的完成标准:docker compose up -d 成功启动 4 个容器;通过端口 4000 的 curl 返回回答;移除 Authorization header 后,相同请求遭到拒绝。
A4. 分发密钥:预算、限制与支出归属
这个概念会真正把它变成一朵云。此前一切都只是管道。
为一名学生生成密钥:
curl -X POST http://localhost:4000/key/generate \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "user_id": "student-0417",
    "models": ["qwen3-8b"],
    "max_budget": 2.00,
    "budget_duration": "30d",
    "rpm_limit": 20
  }'
请读懂 4 项设置,因为每一项都是你刻意作出的决定:
user_id把今后每项请求和每一美元记录到具体的人。没有它,用量报告只会显示一个巨大的匿名数字models是这把密钥可以点的菜单。只列出qwen3-8b的密钥无法访问其他模型,无论学生输入什么max_budget配合budget_duration形成上限:每月 $2,此后网关开始拒绝。失控 loop 会在夜间自行停止,不会叫醒你rpm_limit防止一名过度热情的学生占满所有人的队列
响应会返回一把以 sk- 开头的密钥。学生只会拿到这串字符,其他内容一概不需要。
现在来到整份附录存在的理由。**学生使用你的云,与第 3 部分使用 OpenRouter 的方式完全相同。**仍然是两项设置,只改地址:
# OpenCode, or anything speaking the OpenAI shape
export OPENAI_BASE_URL="http://your-server:4000/v1"
export OPENAI_API_KEY="sk-the-students-key"
harness 不会知道发生过变化。它仍然是 harness 加大脑再加地址,只是地址现在恰好是一台位于你自己大楼里的机器。
专门针对 Claude Code,LiteLLM 还提供 Anthropic 格式端点,因此可以像前 3 次一样,把 ANTHROPIC_BASE_URL 直接指向网关的裸地址。这个接口变化得比本页更新更快,依赖前请查询 LiteLLM 实时文档。如果固定版本中无法使用,概念 16 的 Claude Code Router 可以多跳一步完成,而你的网关只会成为其配置中的另一个供应商。
班级开始使用后,你会经常运行下面两条命令:
# What has this key spent?
curl -X GET "http://localhost:4000/key/info?key=sk-the-students-key" \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY"

# Semester over, or laptop lost.
curl -X POST http://localhost:4000/key/delete \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{"keys": ["sk-the-students-key"]}'
每位客人都会获得附带支出上限的桌号。厨房完全没有改变,但现在你知道谁在吃饭,可以阻止一桌点完整份菜单;有人离开时,也能收回桌号。
你为 200 名学生各签发一把每月上限 $2 的密钥,全部指向自己的免费 GPU。同事问,本地模型每 token 不花钱,为什么还要设置预算?真正的答案是什么? 有两个答案,第二个更重要。第一,即使在本地,「免费」也不准确。GPU 的吞吐量固定;第 2 部分的曲线已经展示显卡装满后会发生什么。因此,即使没有资金流动,一名学生永不停止的 loop 也会消耗其他所有人的容量。预算是在配给共享资源。第二,也是概念 A5 的方向:一旦把云模型加入菜单,真实资金就会流过同一批密钥。在免费阶段养成预算习惯,就不必等到不再免费那天才慌忙构建。查看答案
**概念 A4 的完成标准:**另一台机器上的第二个人使用自己的密钥,通过网关完成了真实任务;你查询了其支出,之后又撤销了密钥。
A5. 把三个层级放在同一扇门后
你的云目前只提供一个大脑。现在把本课另外两个层级加入同一份菜单,让学生只改模型名、不改其他设置就能选择层级。
扩展 litellm-config.yaml:
model_list:
  # Tier 2: your own GPU. Free at the margin, capped by your hardware.
  - model_name: qwen3-8b
    litellm_params:
      model: hosted_vllm/Qwen/Qwen3-8B
      api_base: http://vllm:8000/v1
      api_key: "not-needed"

  # Tier 3: a frontier brain, rented. Your key, never theirs.
  - model_name: frontier
    litellm_params:
      model: openrouter/moonshotai/kimi-k3
      api_key: os.environ/OPENROUTER_API_KEY

  # Tier 3, the cheap end. The right default for high-volume work.
  - model_name: frontier-cheap
    litellm_params:
      model: openrouter/deepseek/deepseek-v4-pro
      api_key: os.environ/OPENROUTER_API_KEY

router_settings:
  fallbacks:
    - qwen3-8b: ["frontier-cheap"]
刚才发生了 3 件事,每件都值得单独说明。
**OpenRouter 密钥永远不会离开机器。**现在 200 名学生都能访问 Kimi K3,但没有人持有可以粘贴进公共仓库的凭据。他们持有的是网关密钥,可以用一条命令撤销,也无法花费超过自身上限。概念 14 曾提醒:OpenRouter 密钥既是秘密,也是钱包。这样就能共享钱包,却不交出字符串。
**层级选择变成模型名。**一名学生需要前沿大脑完成一次高难重构时,只需输入 frontier,而不是 qwen3-8b。概念 15 的 3 问流程由此变成一个人能在任务中途实际执行的操作。
**回退行是一项策略。**GPU 关闭或已满时,发往 qwen3-8b 的请求会悄悄转到 frontier-cheap,而不是失败。这是你有意作出的真实取舍:用金钱购买可用性。请把它记录在未来的自己能够找到的地方,因为忘记的回退会变成无法解释的账单。
前沿菜单会花费真实资金,因此现在为它设置不同限制:
curl -X POST http://localhost:4000/key/generate \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "user_id": "student-0417-frontier",
    "models": ["qwen3-8b", "frontier-cheap", "frontier"],
    "max_budget": 5.00,
    "budget_duration": "30d"
  }'
退后一步,看看你构建了什么。一个地址。它背后既有运行在你自有硬件上的模型,也有房间里任何人都不可能拥有的集群上的模型;它们出现在同一份菜单中,计入相同的额度,并通过相同的两个设置访问。概念 2 告诉你,大脑只是一个地址。现在把那句话倒过来读:**一个地址可以隐藏任意数量的大脑,而在它们之间作出选择,如今只是某个人配置文件中的一项设置。**这个人就是你。
你的回退规则会把失败的 所有原本免费的请求都在付费云端模型上运行了大约 60 小时,而且服务始终运行得非常好,这正是没有人注意到的原因。回退会悄无声息地用金钱换取可用性,而沉默正是危险所在。请添加两样东西:vLLM 容器不健康时的告警,以及网关上的支出告警。解决办法不是移除回退,而是确保回退持续超过几分钟时会通知某个人。qwen3-8b 请求发送到 frontier-cheap。某个周五晚上,你的 GPU 机器因驱动更新而重启,直到周一才有人注意到。周末发生了什么?你应该添加什么?显示答案
**概念 A5 的完成标准:**一个密钥可以按名称同时访问你的本地模型和前沿模型,而且你能解释回退规则带来了什么,以及它需要付出什么代价。
A6. 观察它:判断健康状况的 3 个数字
无人观察的服务会悄无声息地失败。vLLM 会在 http://localhost:8000/metrics 发布自己的指标,格式可由 Prometheus 读取;标准做法是由 Prometheus 收集指标,再由 Grafana 绘制图表。
第一天不需要搭建这些工具。但你确实需要知道哪 3 个数字最重要,因为它们能在学生发现问题之前告诉你哪里出了故障:
- **队列深度:有多少请求正在等待。**这是你掌握的最有用的单项指标,也是第二部分实验转化成的实时仪表。接近 0 表示机器运行轻松。持续上升并居高不下,表示 GPU 已经不够用了;此时该增加第二张卡、换用更小的模型,或坦诚地限制班级规模。
- **首个 token 延迟:用户要等多久才会看到任何内容。**吞吐量可能看起来非常出色,但每个用户的体验依然糟糕。这才是学生真正感受到的数字,也正是总 token 每秒指标所掩盖的内容。
- **GPU 已用显存。**显存会先于算力耗尽,而显存填满时,性能会在任何东西看似损坏之前下降。某个模型悄悄占满节点上的全部显存,会降低所有人的体验,即使每个容器仍报告健康。
此外还有两项指标。第一项是网关自己的支出仪表盘,它能让你在月底之前尽早发现意外账单。第二项是两个容器上的普通健康检查,因为凌晨 3 点时,你希望由机器回答“它还在运行吗”,而不是等学生发来消息。
队列深度是门口排队的人数。首个 token 延迟是每位顾客等餐的时间。GPU 显存是厨房有多拥挤。只关注总出餐量的餐厅老板,往往是最后一个发现餐厅正在失控的人。
**概念 A6 的完成标准:**你亲眼在 vLLM 容器上打开过 /metrics,而且当学生说“今天感觉很慢”时,你能说出首先要检查这 3 个数字中的哪一个。
A7. 何时值得构建,以及何时升级
下面仍以概念 7、12 和 15 的态度,诚实地算一笔账。
在以下情况构建迷你云:
- **你有许多用户和一份预算。**一个课堂、训练营、部门或小公司。一张 GPU 为 50 人提供服务,是其中任何人都能得到的最便宜的可用方案;网关让“50 人”变得安全,而不是混乱。
- **数据绝不能离开。**这是概念 15 的第一个问题在组织规模上的答案,外加一个对机构很重要的要素:显示谁访问了什么的审计记录。
- **你希望在不断变化的世界前面提供一个稳定地址。**模型、价格和提供商每隔几周就会变化。如果学生指向你的网关,你只需在一个配置文件中吸收这些变化,而不必要求 200 人修改设置。
- **loop 全天运行。**你稍后会遇到的 Loop 工程 agent 会不停发送请求。按 token 计费时,账单永远在增长。而当一张 GPU 已经由你拥有并充分利用时,多一个请求几乎不会增加额外成本。
在以下情况不要构建迷你云:
- **你只有一个人。**你就是整个前台。完全按照概念 11 所示直接使用 vLLM,并跳过本附录。
- **流量很少且偶尔出现。**闲置 GPU 与繁忙 GPU 的成本相同。在每日真实流量达到一定规模之前,通过第三部分租用资源,无论在金钱还是周末时间上都更划算,而且优势非常明显。
- **没有人负责它。**这是没人提前规划的失败。迷你云是一项服务,而服务需要有人在它出故障时负责。如果没有这个人,它会在第一次假日期间宕机时死去,所有人也会因此失去信任。
**何时从 Docker Compose 升级。**上面的 Compose 栈是一项真正的服务,能承载数量惊人的学生,但它只有一台机器,每种组件也只有一个实例。它没有自动扩缩容,也没有任何组件的第二份副本。超出它的能力时,不需要重写系统,只需把相同组件迁移到 Kubernetes。这里有两条值得记住名称的路径。vLLM production stack 提供 Helm chart,已经接好指标、仪表盘和缓存复用。KubeAI 更进一步,把模型作为 Kubernetes 资源来管理,底层运行 vLLM 和 Ollama,并附带聊天 UI,因此本附录的大部分内容会缩减成两次 Helm 安装。它们都不能替代网关,因为它们都不提供按用户密钥和预算。那一层会原样保留在你放置它的位置。
最后是诚实的限制,也与第二部分结尾的限制相同。网关无法移动任何一堵墙。它不会提升吞吐量,也不会让大脑更聪明。它会让快速的大脑变得可共享,这是一种不同的胜利,而且往往正是决定满屋子的人究竟能否使用 AI 的因素。
某个部门想为 40 名员工提供私有 AI 服务。有人提议直接采用带自动扩缩容和多节点服务的 Kubernetes,“这样以后就不用返工”。反对这个方案的理由是什么? 一张 GPU 加 Docker Compose 足以轻松服务 40 名用户,因此 Kubernetes 今天没有带来任何收益,却要付出数周的设置时间和永久的运维负担。升级路径也不是重写:当负载确实需要时,相同的容器、相同的网关配置和相同的模型会迁移到 Helm chart。先构建这个月就能工作的系统,测量真实流量,再让测量结果决定何时升级。正确的问题不是“我们会不会超出它的能力”,而是“它出故障时由谁值班”。显示答案
**概念 A7 的完成标准:**你能针对自己的情况论证正反两面,而且能说出网关不会改善的那一件事。
用一句话概括附录 A
推理引擎为 token 提供服务,网关为人提供服务;迷你 LLM 云只是这两个程序,再加一个保存密钥的地方。当许多人共享一份预算时,就构建它。同时请注意你真正完成了什么:对于所有指向你地址的人来说,现在你就是云。
参考资料
以下是本页命令的主要来源。它们变化很快,因此在依赖任何特定标志、价格或版本之前,请查看实时文档。
第一部分:本地(Ollama)
- Ollama,桌面应用(下载模型并与其聊天,无需终端)。https://ollama.com/blog/new-app 和 https://ollama.com/download
- Ollama,
ollama launch(用一条命令把 coding agent 连接到本地模型并启动)。https://ollama.com/blog/launch 和 https://docs.ollama.com/integrations/claude-code - Ollama,Anthropic API 兼容性(让无代理设置成为可能的原生端点)。https://ollama.com/blog/claude
- Ollama,上下文长度与
num_ctx,说明基于 VRAM 的默认值,以及面向 coding agent 的 64K 建议。https://docs.ollama.com/context-length - Claude Code,环境变量,说明
ANTHROPIC_BASE_URL、ANTHROPIC_AUTH_TOKEN和API_TIMEOUT_MS。https://code.claude.com/docs/en/env-vars - OpenCode,提供商,说明
opencode.json提供商块和 OpenAI 兼容端点。https://opencode.ai/docs/providers/ - skills 安装器和 GitHub CLI
gh skill命令,用于安装和发布 skills。https://skills.sh/docs
第二部分:服务器(vLLM)
- vLLM,文档主页(安装、
vllm serve和 OpenAI 兼容服务器)。https://docs.vllm.ai - vLLM,工具调用,说明
--enable-auto-tool-choice和各模型家族的工具调用解析器。https://docs.vllm.ai/en/latest/features/tool_calling/ - vLLM,Claude Code 集成,说明 Anthropic Messages 支持和
ANTHROPIC_DEFAULT_*_MODEL变量。https://docs.vllm.ai/en/latest/serving/integrations/claude_code/ - Qwen,vLLM 部署指南,说明如何提供 Qwen3 模型和推荐的解析器。https://qwen.readthedocs.io/en/latest/deployment/vllm.html
第三部分:云端(OpenRouter)
- OpenRouter,Claude Code 集成,说明环境变量和 Anthropic 兼容端点。https://openrouter.ai/docs/cookbook/coding-agents/claude-code-integration
- OpenRouter,Kimi K3 模型页面,提供实时 slug、价格和提供商信息。https://openrouter.ai/moonshotai/kimi-k3
- OpenRouter,DeepSeek V4 Pro 模型页面,提供实时 slug、价格和提供商信息。https://openrouter.ai/deepseek/deepseek-v4-pro
- Moonshot AI,Kimi K3 技术博客,介绍架构、上下文窗口和服务建议。https://www.kimi.com/blog/kimi-k3
- DeepSeek,API 定价,提供当前 V4 Pro 费率和缓存命中定价。https://api-docs.deepseek.com
概念 16:Claude Code Router
- Claude Code Router,介绍路由器安装、
Providers和Router配置、transformer 以及ccr命令。https://github.com/musistudio/claude-code-router
附录 A:迷你 LLM 云
- LiteLLM,代理服务器文档,介绍配置文件、虚拟密钥、预算和速率限制。https://docs.litellm.ai/docs/simple_proxy
- LiteLLM,虚拟密钥,介绍
/key/generate、/key/info、/key/delete和按密钥划分的模型访问权限。https://docs.litellm.ai/docs/proxy/virtual_keys - LiteLLM,预算和速率限制,介绍
max_budget、budget_duration和rpm_limit。https://docs.litellm.ai/docs/proxy/users - LiteLLM,可靠性与回退,介绍
router_settings回退规则。https://docs.litellm.ai/docs/proxy/reliability - vLLM,Docker 部署,介绍官方
vllm/vllm-openai镜像和 GPU 运行时标志。https://docs.vllm.ai/en/latest/deployment/docker.html - vLLM,生产指标,介绍 Prometheus 端点、队列深度和首个 token 延迟。https://docs.vllm.ai/en/latest/serving/metrics.html
- vLLM,production stack,用于 Kubernetes 升级路径的 Helm chart,其中包含路由、指标和仪表盘。https://github.com/vllm-project/production-stack
- KubeAI,面向 Kubernetes 的 AI 推理 operator,用于通过 vLLM 和 Ollama 把模型作为 Kubernetes 资源进行管理。https://www.kubeai.org
- Open WebUI,文档,介绍聊天界面以及如何将它连接到 OpenAI 兼容端点。https://docs.openwebui.com
- NVIDIA,Container Toolkit 安装指南,Docker 内部访问 GPU 所必需的指南。https://docs.nvidia.com/datacenter/cloud-native/container-toolkit/latest/install-guide.html