Graph Engineering:速成课
16 个概念 · 从一个 loop 读取的 spine,到 1000 个 agent 共享的 graph
你的 loop 已经能工作。它每天早上 9 点启动,Harness 把它限制在边界内,一份 progress.md 组成的 spine 则把昨天学到的内容带到今天。一个 loop,一份记忆文件。这样已经够用。
接着看看成功之后会发生什么。你添加第 2 个 loop,再添加一个 review loop。然后在忙碌的一周里,把 20 份文件同时交给 20 个 agent 审计。每个 agent 都从空白上下文窗口开始,重复发现另一个 agent 一小时前已经找到的内容,再把结果写进永远不会被其他 agent 读取的 transcript。工作增加了,记忆却没有。你建立了一支没有共享大脑的团队。
这正是 Graph Engineering 要解决的问题。核心观点只有一句话:agent 会忘记,graph 不会。 不再让 agent 把所学留在 transcript 中,而是要求它们写成有类型、有关联的记录,也就是任何后续 agent 都能查询的 node 和 edge。两张 graph 承担这项工作。commit DAG 记住工作:尝试过什么、什么源自什么、最终保留了什么。knowledge graph 记住事实:有哪些 entity、它们如何关联,以及哪项 source 能证明每条 claim。本课用 2026 年最清晰的公开案例讲解两者:前者是 Andrej Karpathy 的 autoresearch 和 AgentHub,后者是 Anthropic 的 Knowledge Graph Construction Cookbook 与 Dynamic Workflows。loop 本身也需要接线,因此第 5 部分还会加入第 3 张 graph,也就是 governance graph:谁检查谁、谁拥有谁的目标,以及哪些测量结果不容任何 loop 争辩。
请先学习:Loop Engineering 和 Harness Engineering。 loop 课程讲过 beat、spine、maker-checker 分工与 ratchet。Harness 课程讲过 5 个动词和 typed output。本课默认你已经掌握这些内容。spine 是一个 loop 的私有记忆;当许多 agent 必须共享它时,spine 就会变成本课讲解的形态。如果这些词还很陌生,请先完成那两门课。
📚 教学辅助材料
查看完整演示文稿:Graph Engineering:速成课
下方 10 幅图按教学顺序设计:每幅图只承载一个概念,也能单独放在一张幻灯片上使用。
下方每个概念都有可执行、可观察的脚本,不只是阅读材料。只需 bash、git、jq 和 python3,除此之外什么都不需要:无需 API 密钥,无需 pip install,无需网络。
git clone https://github.com/panaversity/agentfactory-labs.git
cd agentfactory-labs/crash-course/graph-eng
./verify.sh      # runs all 17 demos and asserts each one
命令打印 Everything in this course runs. 后,请把该文件夹留在本页面旁边。每个概念结尾都有一条演示命令:你会看到 git reset 删除 commit、schema 拒绝格式错误的回复、checker 要求补上缺失的 edge,以及 pre-commit gate 阻止违反 schema 的修改。实验室 README 把每个概念映射到对应演示。
如果其中任何一项是新知识,请先学习 Loop Engineering 和 Harness Engineering。本课会连接那两门课构建的机器。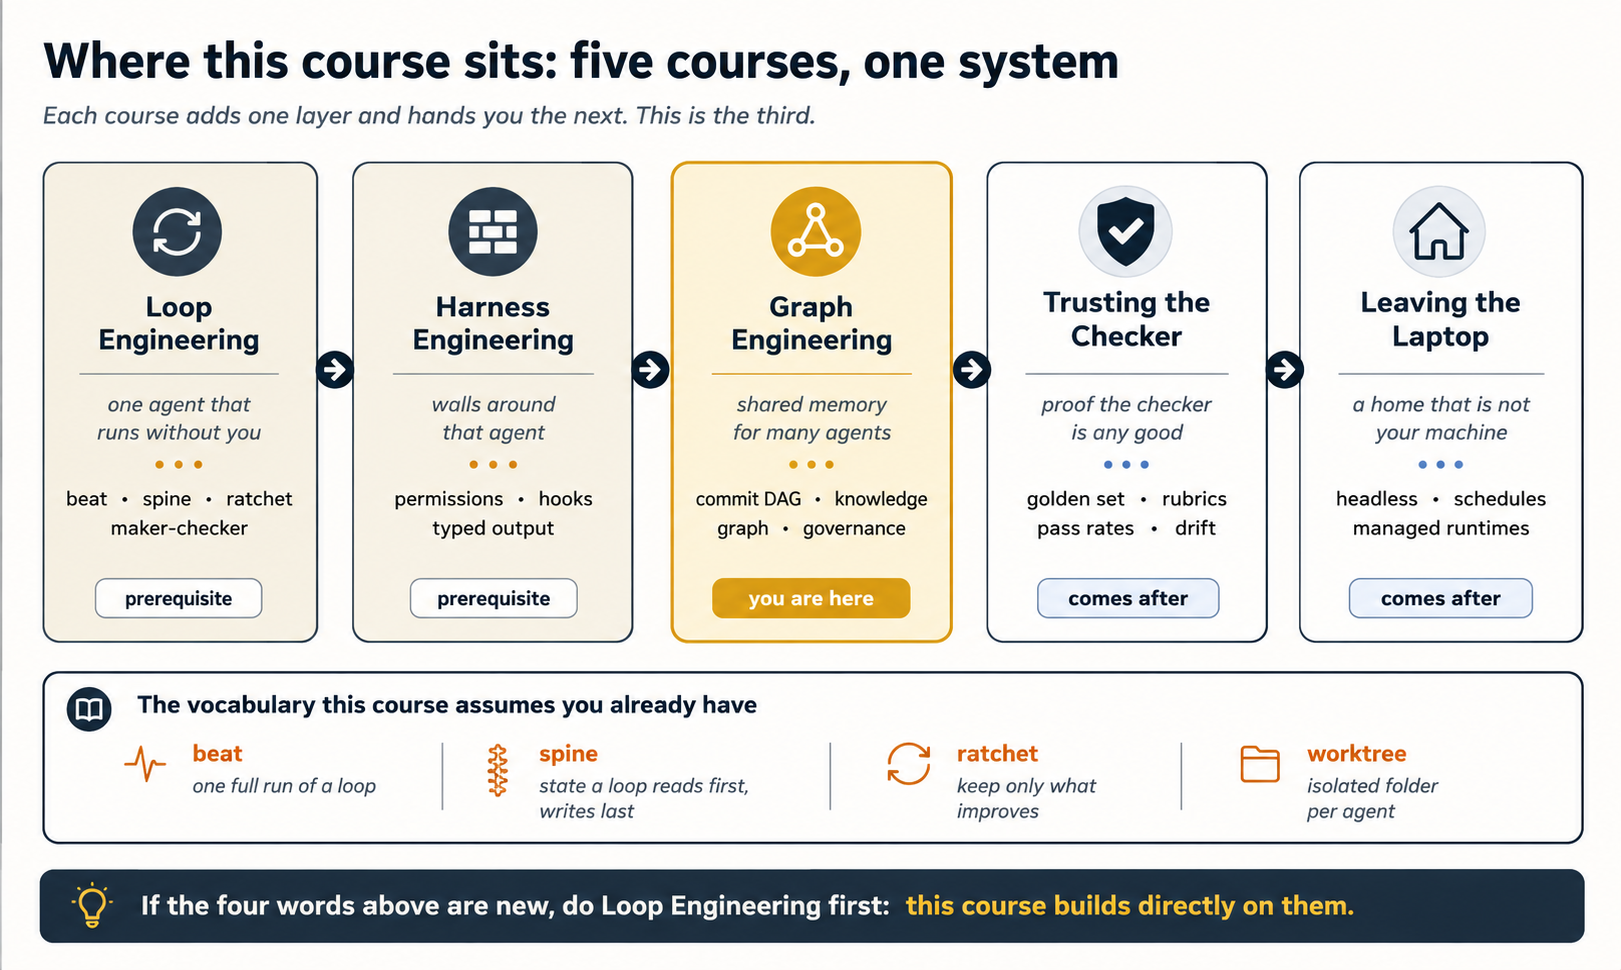
第一次接触?用 2 分钟回顾应该已经掌握的内容
progress.md),loop 最先读取、最后写入,让下一次 beat 知道之前发生了什么main
用日常语言解释关键词
这些词会贯穿整门课。现在先读一遍,之后任何术语感觉不清楚时,再回到这里。
| 术语 | 日常含义 |
|---|---|
| graph | 一组由箭头(edge)连接起来的点(node)。箭头具有方向,而方向承载含义。 |
| node | graph 中的一个点:entity、claim、commit、source 或一次 agent 运行。 |
| edge | 两个 node 之间带标签的箭头,例如 supports、parent_of、produced、works_for。 |
| DAG | 有向无环图:箭头永远不会绕回自身。Git 历史就是一张 DAG。 |
| commit DAG | 记录工作的 graph:commit 是 node,parent link 是 edge。回答「尝试过什么,什么源自什么?」 |
| knowledge graph | 记录事实的 graph:entity 是 node,有类型的 relation 是 edge。回答「存在哪些东西,它们如何连接?」 |
| entity | graph 追踪的对象:人、公司、文件、供应商或事件。 |
| relation / triple | 以 subject–predicate–object 表示的一项事实:(Vendor X, supplied, Component Z)。 |
| surface form | 名称在文档中出现的原始形式:「Edwin Aldrin」「Buzz」「Col. Aldrin」。3 种 surface form,指向同一个人。 |
| entity resolution | 判断哪些 surface form 指向同一个真实对象,并在不丢失原始名称的前提下,把它们合并成一个 canonical node。 |
| provenance | 附在 claim 上的凭据:由哪项 source 提出、哪次运行提取、提取的置信度是多少。 |
| claim | graph 存储的一条可能为真的陈述;始终带有 provenance,绝不会当作无凭据的真相。 |
| subgraph | 从 graph 中为一项任务切出的相关小片段。交给 agent 的永远是 subgraph,不是整张 graph。 |
| grounding | 强制答案或裁决指向 graph 中真实的 edge,而不是依赖自身印象。 |
| swarm | 许多 agent 同时进行探索、实现或评价。 |
| structured output | 受 schema(例如 Pydantic 模型)约束的模型回复,让代码能在相信之前先完成校验。 |
| MCP | Model Context Protocol:agent 访问外部系统的标准方式。graph 还是文件时并不需要;graph 变成数据库后,它就是答案。 |
| governance graph | 以 loop 本身、human gate 和 anchor 为 node 的 graph;edge 表示谁向谁提供信息、谁检查谁、谁约束谁。 |
| execution loop | 执行重复工作的 loop:分诊 issue、review PR、起草 changelog。 |
| improvement loop | 观察一个数字相对目标的变化,并调整工作系统的 loop。 |
| counter-metric | 由第 2 个 loop 观察的第 2 个数字,用于发现第 1 个数字遭到博弈。 |
| anchor | 任何 loop 都无法争辩的测量结果:真正运行过的测试、真正留下的客户、真正到账的钱。 |
| frozen node | 优化型 loop 永远不能修改的规则或文件,原因恰恰是它们会想修改。 |
loop 课程用人体比喻描述 loop:heartbeat、body、spine。本课再加一个:graph 是共享大脑,是一份比任何单个 agent 上下文窗口都活得更久的记忆。
**简短版本:**主要工作真实而公开,但病毒式传播的叙述有误。所谓「两位 Anthropic 高级员工撰写的 11 页 PDF」,其实是一份独立研究笔记;其首页明确声明未与 Karpathy 或 Anthropic 建立关联,也未获得二者背书。「1000x」是口号,不是测量结果。请先阅读一手来源。 时间线很短,而且完全公开。2026 年 3 月 7 日,Karpathy 发布 autoresearch:一个 agent 被限制在小型训练仓库中,每次运行一项约 5 分钟的实验,只保留让指标改善的结果。几周内,它获得数万颗 GitHub star,Fortune 把这种模式称为「Karpathy Loop」。3 天后,他勾勒出 AgentHub:「GitHub 属于人类,AgentHub 属于 agent。」它由 bare Git 仓库和 message board 组成,swarm 通过 commit DAG 协作,而不是围绕 main 分支。2026 年 3 月 23 日,Anthropic 发布 Knowledge Graph Construction Cookbook,用 structured-output 提示词取代传统 NLP pipeline:提取有类型的 entity 与 relation,解析重复项,组装 graph,再通过带引用的查询读取它。Anthropic 的 Dynamic Workflows 于 2026 年 5 月 28 日宣布,后来正式开放;Claude 可以借此编写编排脚本,把工作分发给多个拥有全新上下文的并行 sub-agent。 2026 年 7 月 18 日,Peter Steinberger 在午夜提出 12 个词的问题:「我们还在谈 loop,还是已经转向 graph?」这为整个话题赋予了当季名称。第 5 部分会讲这段故事,以及 Carlos E. Perez 的回答。几天后,一条病毒式帖子把一切拼在一起:「两位 Anthropic 高级员工刚用 Graph Engineering 把 Karpathy 的 loop 改进了 1000 倍,还发布了 11 页 PDF。」重复这句话前,请先阅读 PDF 首页。上面用斜体写着:独立编写,未与 Andrej Karpathy 和 Anthropic 建立关联,也未获背书。这份综合笔记确实有用,本课也会采用其中内容;但它是独立作者的学习笔记,不是 Anthropic 论文,「1000x」也是口号而非测量结果。这与把 Steinberger 的提问变成「loop engineering 已死」出自同一种反应。第 5 部分会剖析后者;前者也应以同样方式对待。一手来源真实而值得阅读,但要记住一项限制:autoresearch、Anthropic Cookbook 与 workflow 文档都是公开的;AgentHub 发布不久后转为私有,如今只剩没有许可证的 fork(概念 5 会进一步说明)。 meme 漏掉了一次真正的汇合,而且比 meme 更出人意料:2026 年 5 月 19 日,Karpathy 加入 Anthropic 的预训练团队,建立一个专注于用 Claude 加速预训练研究本身的小组。因此,本课的 loop 传统与 graph 传统确实在 Anthropic 相遇,只是方式并不像病毒式帖子所称,也不在那份 PDF 中。(所有来源都列在 来源与延伸阅读。)完整时间线,以及 meme 错在哪里
行业用「Graph Engineering」指代不止一种事物。其中两种含义关系紧密,本课会完整讲解。第 1 种是 memory graph:agent 共享的持久、有类型状态,包括记录工作的 commit DAG 与记录事实的 knowledge graph,也就是第 2–4 部分。
第 2 种是 governance graph:loop 彼此之间的接线方式,记录谁向谁提供信息、谁检查谁、human gate 位于哪里,以及哪些测量结果不容任何 loop 争辩。这就是第 5 部分,建立在 Peter Steinberger 的提问和 Carlos E. Perez 的文章之上。
两者是同一系统的不同层,而不是竞争关系。governance graph 连接工作者,memory graph 存储工作者知道的内容。它们在概念 10 中相遇:governance 层的 checker 从 memory 层读取证据。loop 课程结束的位置正是本课开始的位置:它交来一个完整构建的 loop,本课接过它和它的记忆。
还有第 3 种流行含义,本课不讲。有些作者用「Graph Engineering」指代 execution topology:node 是步骤,而不是记录或 loop;edge 是数据依赖;设计问题是哪些工作可以并行,以及运行必须在哪里等待。这属于编排框架的领域,而且早于这个词组:LangGraph 在 2024 年 1 月已经基于共享状态提供 node 与 edge,Microsoft AutoGen 和 Google ADK 也各有自己的版本。其中最好的思想仍会出现在本课,包括概念 11 的箭头测试与路由拆分,以及概念 14 的预算与 join 规则。但如果你想找的是构建编排 graph 的章节,那属于另一门课。构建前先分清这两个问题,比把它们混在一起更有用。loop 的接线方式与一次运行的形状彼此相关,却需要不同答案。
6 步方法,以及每一步已在何处出现
许多读者通过病毒式传播的 6 步方法来到这里。其中 4 步你已经学过,本课讲解另外 2 步,以及清单漏掉的部分。 因此,「1000x」的诚实版本不是 benchmark。第 1–3 步提供一名有能力的工作者,第 4–6 步则为 1000 名工作者提供一份共享记忆。模型不变,架构不同。这 6 步与本系列的对应关系
帖子中的步骤 实际含义 你在哪里学过 1. 构建一个 loop:生成、批评、修订 maker-checker beat 与 ratchet Loop Engineering 2. 添加工具:搜索、代码、数据库 connector,以及约束它们的工具 schema Loop 与 Harness Engineering 3. 转向并行:agent 使用独立 worktree 隔离,让并发工作无法冲突 Loop 与 Harness Engineering 4. 添加 graph:有类型的 node 与 edge,不是 transcript 比 session 活得更久的记忆 本课第 2–4 部分 5. 用 edge 而不是感觉来 grounding evaluator 使用可引用证据进行验证 本课概念 10 6. graph 在每次 session 后继续存在 provenance、supersession 与持久状态 概念 8、13 及第 6 部分
一幅图看懂思维转变
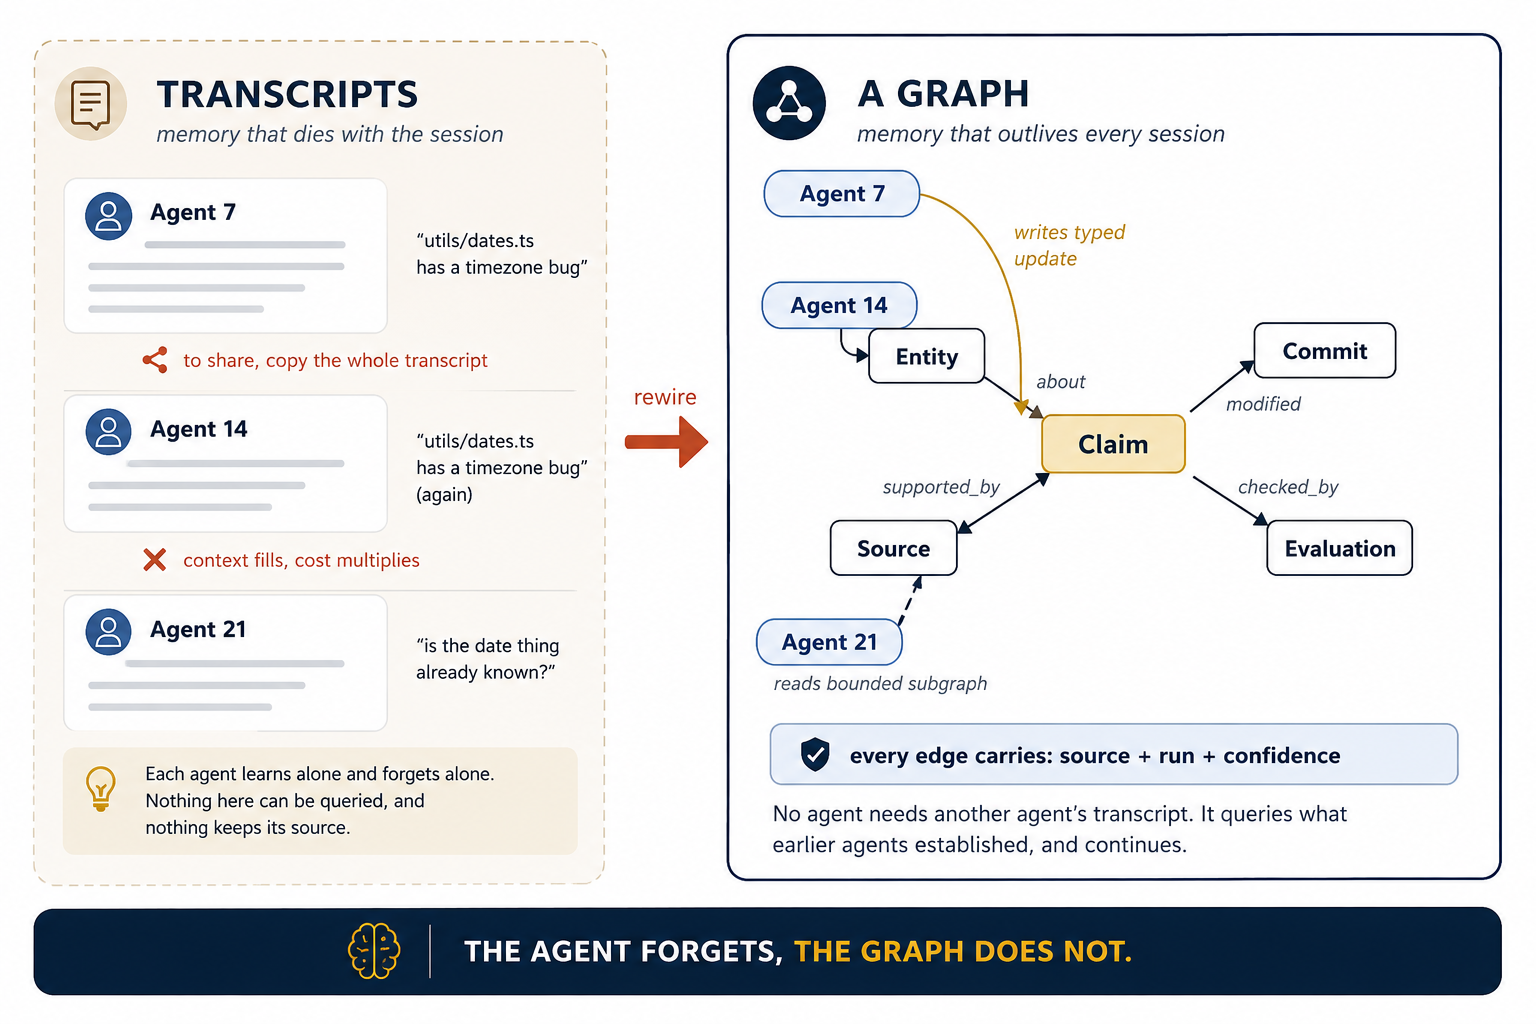
关于工具只需说明一点,而且比相邻课程简单。loop、Harness 与 eval 工作都有工具特定的写法需要讲解,graph 工作几乎没有:graph 就是文件、Git、jq 与你自己拥有的 schema,不必购买产品,也没有功能需要配置。Claude Code 和 OpenCode 在这里仅充当读写 graph 的工作者。下方所有命令在两种工具中都相同,claude -p 与 opencode run 可以互换。工具无关并非课程范围造成的巧合,而是 graph 属于工程纪律、不属于产品功能的最强证据。
还有一个术语应该在这里说明,因为读者会合理地期待它,却常把它放错位置。MCP(Model Context Protocol)是 agent 访问外部系统的标准方式:server 暴露工具,任何支持 MCP 的 agent 都能调用。以本课规模而言,MCP 完全不会出现,而这才是正确做法:graph 是仓库中的文件,agent 用已有的文件与 shell 工具读写即可。规模再上一个台阶时,MCP 才会成为答案。当 graph 移入 Postgres 或 Neo4j,且不同机器上的多个 agent 都要访问时,不要向每个 agent 发放数据库凭据并手写客户端。应在存储前放置一个 MCP server,只暴露小而有类型的 surface:解析 entity、获取受限 subgraph、追加经过校验的 claim。于是,本课所有规则都能在 server 中统一执行,而不是写进每个 agent 的提示词、仅仅成为请求。
请分清 3 层,因为它们很容易混在一起。技能是 agent 加载的知识:这里该如何写 claim。MCP 是线路:agent 如何访问存储。graph 是记忆本身:实际记住了什么。没有 graph 的技能只是无处落笔的建议。没有技能的 graph 会被不一致地填充。MCP 则不属于二者;当存储不再是 agent 同一文件夹中的文件时,它才成为必要的管道。
截至 2026 年 7 月下旬,这些内容都属实,但保质期不同。Autoresearch 仍在积极开发。AgentHub 已冻结并转为私有,因此请把相关内容视为历史。Dynamic Workflows 已正式开放,其限制与默认值会随产品变化。Cookbook 是持续更新的 notebook。相信任何 flag、限制或模型名称前,请查看实时来源:github.com/karpathy/autoresearch、platform.claude.com/cookbook、code.claude.com/docs、opencode.ai/docs。
本课涵盖的内容
| 部分 | 主题 | 学到的内容 |
|---|---|---|
| 1 | 记忆问题 | transcript 为什么无法充当团队记忆、graph 是什么,以及每个 swarm 都需要的两张 graph |
| 2 | 工作的 DAG | Karpathy 的路径:autoresearch 把历史写进 Git,AgentHub 把 DAG 变成协作层 |
| 3 | 事实 graph | Anthropic 的路径:按 schema 提取、entity resolution,以及每条 edge 的 provenance |
| 4 | 从 graph 工作 | 使用 subgraph 而不是整体倾倒,以及 grounded checker:「找不到 triple」胜过「感觉不对」 |
| 5 | loop graph | governance 层:谁检查谁、单个 loop 的 4 种失败方式,以及不容任何 loop 争辩的 anchor |
| 6 | 一张 graph,端到端 | 把晨间分诊 loop 的 spine 升级为用文件与 shell 构建的小型可查询 graph,两种工具都适用 |
| 7 | 保持 grounding | 选择层级、复杂度预算、何时不该构建 graph,以及通向后两门课程的桥梁 |
| 实时 | Dogfooding | 本书已经运行的 proto-graph,以及它刻意没有构建的 graph |
| 练习 | 项目 | 8 个 graph 构建项目,由易到难 |
想通过动手来学习? 请先阅读 第 6 部分,看看一张完成的 graph,然后再回来依次学习各部分。
第一次阅读? 走 memory path:先读第 1–4 部分,也就是概念 1–10,再直接跳到第 6 部分完成构建。跳过第 5 部分,以及所有标记为「深入阅读」的注释。只读约需 2 小时;如果动手完成示例,而不是直接读过,接近 3 小时。然后完成项目 1–3。学完后,你能把系统画成 graph、存储带 source 的 claim,并让 reviewer 引用证据。
第 2 次阅读(在第一张 graph 回答了 transcript 无法回答的问题之后):走 governance path,也就是第 5 部分,加上整个第 7 部分与项目 4–8。第 5 部分讨论如何让多个 loop 保持诚实;只有多个 loop 写入同一份记忆时,这才会变得紧迫。概念 15 的警告同样要等你拥有一张想过度构建的 graph 后,才会真正产生作用。
两层内容以不同速度老化。记住第 1 层,查询第 2 层。
- 持久层。 agent 会忘记,graph 不会。工作 lineage 与领域事实属于两张不同的 graph,不要合并。schema 比训练 pipeline 更便宜。resolution 必须保留凭据并可逆。每条 claim 都带 provenance,或明确标记为 inference。只把 subgraph 交给 agent,绝不交付整张 graph。让 checker 以 edge 为依据。选择层级前先回答 6 个问题,并在运行前声明预算。为每个优化型 loop 配一个观察 counter-metric 的 loop。系统中至少有一项信号必须来自现实,而不是另一个模型的报告。graph 会放大构建者的判断,也会放大构建者的错误。
- 机械层。 下方每个仓库名、模型名、flag 与 star 数量。autoresearch 的文件布局、Dynamic Workflows 的并发上限、Cookbook 的具体 Pydantic 类,都应视为指向实时来源的指针,而不是需要记忆的事实。如果本课与实时文档不一致,以文档为准。
第 1 部分:记忆问题
1. agent 会忘记,graph 不会
请在 配套实验室 中运行:bash concepts/01-agent-forgets.sh。阅读只完成了一半,亲眼看它发生才是另一半。
先从已有成果开始。晨间分诊 loop 有一条 spine:最先读取、最后写入的 progress.md。这份文件就是记忆,而且对一个 loop 确实有效。现在看看它做不到什么:
- 第 2 个 loop 无法信任它。
progress.md是 prose。changelog loop 必须读取并解释另一个 loop 的日记,还要期待格式永远不漂移。 - 20 个并行 agent 无法共享它。 把审计工作分给 20 个 agent,每个都从空白开始。Agent 7 发现
utils/dates.ts有时区 bug;1 小时后,Agent 14 又发现一次。二者之间没有连接。 - 你无法查询它。 「上个月有哪些发现涉及支付代码,并由 reviewer 确认?」spine 无法回答,只能 grep prose,再寄希望于结果。
- 它不引用任何内容。 spine 写着「修复了不稳定测试」。是哪项测试?由哪次运行证明?后来哪项修复取代了它?prose 并不知道。
最直接的做法是到处复制 transcript:把 Agent 7 的对话粘贴进 Agent 14 的上下文。它会在最需要时失效:上下文窗口被填满,成本成倍增加。更根本的问题是,transcript 具有错误的记忆形状:它按顺序记录说过的一切,而不是带着证据记录已经确立的内容。
Graph Engineering 是有意设计的替代方案。agent 把所学写成有类型的记录:这是一个 entity;这是关于它的一条 claim;这是支持该 claim 的 source;这是生成它的 run。记录之间通过带标签的箭头连接。之后的任何 agent,无论是明天的 beat、另一个 loop,还是完全不同的模型,都只查询自己需要的记录并继续。那份推广了本课主题的独立 PDF 用 5 个词概括,恰到好处:agent 会忘记,graph 不会。
transcript 是聊天记录,graph 是档案系统。新员工加入团队时,你不会交给他团队所有对话的录音,而会交付整理、标注并相互引用的文件。Graph Engineering 就是为 agent 建造一套应有的档案系统。
分诊 loop 和 changelog loop 都需要知道本周发布了哪些 PR。目前二者都会运行 每个上下文窗口都在重复工作、重复解释,也就是从零重建世界。修复方法是:最先确立「PR #212 已发布,修复 issue #98」的 loop,只写一次有类型的记录,并附上 provenance(commit hash)。之后两个 loop 都读取这条记录。推导一次,查询多次。git log 并重新推导。什么被浪费了?Graph Engineering 如何修复?查看答案
2. graph 是什么:node、edge 与方向
请在 配套实验室 中运行:bash concepts/02-nodes-edges.sh。阅读只完成了一半,亲眼看它发生才是另一半。
loop 课程结尾已经介绍过这个定义,现在它会成为实际工具。graph 是一组点,称为 node;这些点由箭头连接,称为 edge。3 个性质承担全部工作:
- node 有类型。 不是笼统的「一个方框」,而是「Entity」「Claim」「Source」「Commit」「Evaluation」。类型会告诉每位读者该 node 能回答哪些问题。
- edge 有标签和方向。
(claim_441) —supported_by→ (source_readme)与反向箭头含义不同。方向就是含义:谁支持谁、谁从谁衍生、谁检查谁。 - 路径就是答案。 「Vendor X 是否与 Incident Y 相连?」会变成:「从 Vendor X node 到 Incident Y node,是否存在由受支持 edge 组成的路径?」关于世界的问题变成沿箭头行走。
第 3 个性质带来真正收益。prose 必须经过阅读与解释;graph 可以由代码以同一种方式机械遍历。记忆一旦成为 graph,过去依赖感觉的问题就会变成查询。
有一种特殊形状值得单独命名。DAG 即有向无环图,箭头永远不会绕回自身。你已经使用多年,只是不知道名字:Git 历史。每个 commit 都指向 parent,没有 commit 会成为自己的 ancestor。请记住这个例子,因为第 2 部分完全建立在它之上。
node 是名词,edge 是带方向的动词。graph 是一组句子(subject、verb、object)的图形表达,让计算机无需理解 prose,也能顺着句子链前进。
两个 agent 都记录 Vendor X 供应了一个零件。一个把句子「Vendor X supplied component Z」写入日志,另一个把 沿着它前进。 句子必须由看到它的模型正确阅读与解释。edge 则可以始终以相同方式机械遍历,还能串联:从 (vendor_x) —supplied→ (component_z) 写入 graph。两者都为真。后续 agent 能对第 2 种记录做什么,而对第 1 种做不到?查看答案
vendor_x 到 component_z,再继续走向与 component_z 相连的其他内容。这样,关于世界的问题(「Vendor X 是否与这起 incident 相连?」)就会变成沿箭头行走,而不是一次阅读理解。typed edge 还会携带凭据,而 prose 通常会把它丢失。
3. 两张 graph,以及为什么不能合并
请在 配套实验室 中运行:bash concepts/03-two-graphs.sh。阅读只完成了一半,亲眼看它发生才是另一半。
这是组织整门课的区别,也是初学者最常混淆的一点。多 agent 系统需要两张不同的 graph,因为必须记住两类不同内容:
| commit DAG(第 2 部分) | knowledge graph(第 3 部分) | |
|---|---|---|
| 记住 | 工作:尝试过什么 | 事实:知道什么 |
| node | commit、实验、run | entity、claim、source |
| edge | parent_of、derived_from | supports、works_for、about |
| 回答 | 什么变了?哪些内容源自 batch-size 实验?哪些 lineage 仍然活着? | 存在哪些 entity?它们如何关联?哪项 source 支持这条 claim?哪些 claim 相互冲突? |
| 你已经拥有的版本 | 部分存在于 Git 历史,参见概念 4 | 还没有,第 3 部分会构建 |
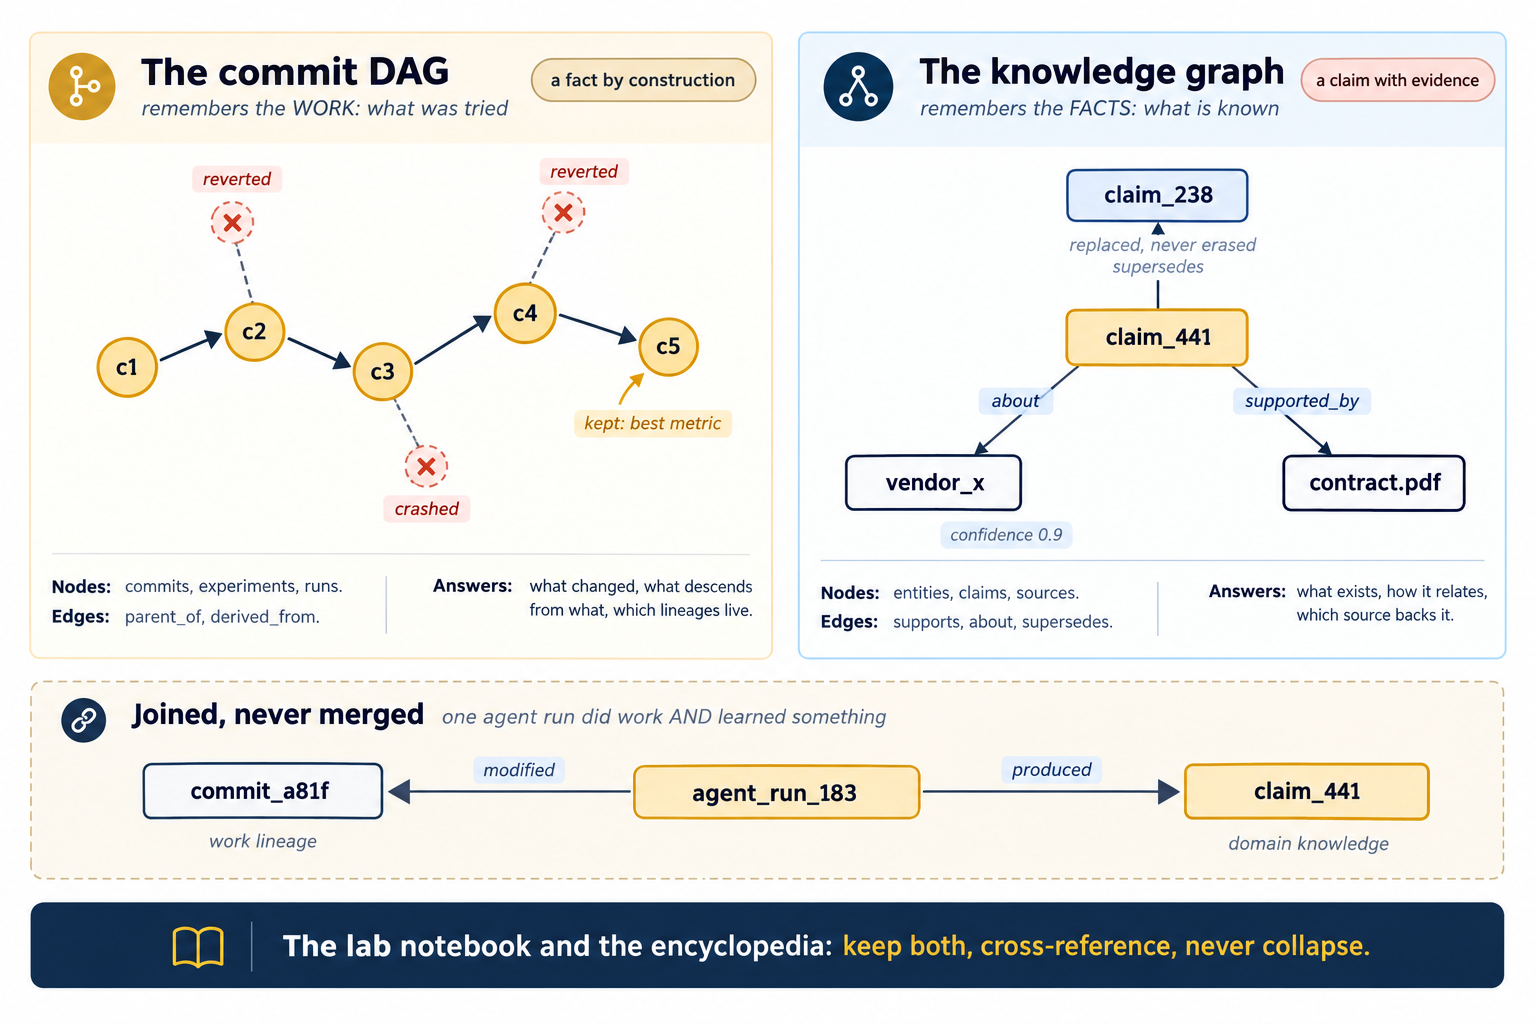
为什么要分开?因为两者的 truth rule 不同。commit 是由构造保证的事实:它确实发生过,Git 可以保证。knowledge graph 中的 claim 是带证据的陈述:可能错误、提取有误或后来被取代,因此每条 claim edge 都带 provenance 与 confidence。合并两张 graph,要么会把猜测当成历史,要么会用猜测掩埋历史。
两者确实会连接。生产系统用各自的 edge 连接它们:
(agent_run_183) —produced→   (claim_441)
(agent_run_183) —modified→   (commit_a81f)
(claim_441)     —about→      (entity_vendor_x)
(claim_441)     —supported_by→ (source_contract_pdf)
(claim_441)     —supersedes→ (claim_238)
慢慢阅读这个代码块:5 行就是整门课。一次 run 完成了工作(commit),也学到一项内容(claim)。claim 关于一项 entity,由一项 source 支持,并取代较旧的 claim。左侧是工作 lineage,右侧是领域知识;彼此连接,永不合并。
commit DAG 是实验室笔记:按日期排序的实验,每项都有 parent。失败也应该保留在其中;概念 4 会说明 autoresearch 没有这样做,概念 5 则展示 AgentHub 如何选择保留。knowledge graph 是实验室正在编写的百科全书:记录当前相信的内容,并附上脚注。只保留笔记的实验室无法回答问题,只保留百科全书的实验室无法展示推导过程。请两者都保留,并相互引用。
一个 agent 报告:「我重构了解析器(commit 重构自动存入 commit DAG:commit 9fc2),同时确认供应商 API 会拒绝 1970 年以前的日期。」这句话的两部分分别存在哪里?查看答案
9fc2 及其 parent link。API 行为则是 knowledge graph 中的一条 claim:(vendor_api) —rejects→ (pre-1970 dates),provenance 指向相应 run 与证据(错误响应)。如今,第 2 项事实会死在 transcript 中,而本课正要阻止这种损失。
大多数系统不该构建 knowledge graph,你应该在阅读 4 个部分的构建方法前先知道这一点。完整短测见 概念 15:如果任务彼此独立,每次答案只来自一份文档,relation 固定而简单,关系表已经能回答你真正提出的所有查询,而且没有人需要 provenance,请在这里停下。一个带 spine 的 loop 才是正确答案;添加 graph 只会用提取错误与 schema 维护成本,换取没人问过的问题。
当两个 loop 必须交换事实、综合工作跨越许多 worker、relation 持续变化,或有人终将问「我们怎么知道?」时,天平才会倾向 graph。只要其中一项成立或即将成立,就继续阅读。概念 14 会把它们变成按顺序提出的 6 个问题。
第 2 部分:工作的 DAG
4. Autoresearch:ratchet 把历史写进 Git
请在 配套实验室 中运行:bash concepts/04-autoresearch-ratchet.sh。阅读只完成了一半,亲眼看它发生才是另一半。
loop 课程已经讲过 ratchet:尝试一项修改、评价结果;只有数字改善才保留,否则恢复。Karpathy 的 autoresearch(2026 年 3 月 7 日)正是这个 loop,只是用于机器学习训练。对本课而言,它最重要的是一项设计选择:loop 的记忆不是 transcript,而是 commit DAG。
设置由一个小型单 GPU 训练仓库中的 3 份文件组成:
prepare.py:固定的数据准备与评价,agent 不得修改。(把 Harness 课程的 deny rule 应用于文件,形成 frozen node。)train.py:模型、optimizer 与训练 loop,也是 agent 唯一会修改的 surface。program.md:自然语言指令,包括指标、预算、commit 与 revert 规则,以及何时升级。(loop 课程称之为「对程序编程」。)
然后不断重复 beat:读取 train.py 与近期历史,提出一项有依据的修改,提交,再训练约 5 分钟并测量 validation loss。改善了?保留 commit。变差或崩溃?reset 到最后保留的 commit。无论结果如何,记录结果并继续,全程没有人在 loop 中。
现在仔细观察每个 beat 留下什么。初学者与许多流行文章都在这里误读 autoresearch。它有两份记忆,不是一份,而且两者保存不同内容:
| 保存的内容 | truth rule | |
|---|---|---|
| Git 分支 | 只保存保留的改进,在专用实验分支上形成不断上升的 commit 链 | 已验证:其中每个 commit 都改善了指标 |
results.tsv | 每次尝试:commit hash、指标、使用的内存、保留/丢弃/崩溃,以及尝试内容 | 完整:记录尝试,而不是成就 |
关键细节是失败时发生什么。指令写得很清楚:指标改善就推进分支并保留 commit;相同或更差就用 git reset 回到起点。reset 不会把尝试停放在侧分支,而会从分支中删除该 commit。因此,被丢弃的实验只会留在 results.tsv,并且 results.tsv 有意不受 Git 跟踪。
请把它视为设计,而不是疏忽。这是现实世界中最清晰的概念 3 示例。Git 保存价值已获证明的工作,TSV 则诚实记录所有尝试,包括崩溃。人类研究者会把假设、失败尝试与参数交互放在工作记忆中,最终丢失;autoresearch 把两类内容写在两个地方,并采用两套标准。它没有让替代 lineage 保持存活和可遍历:被丢弃的想法会变成一行文本,其他 agent 无法查询。概念 5 会精确补上这个缺口。
最初几周公布的数字(约 630 行核心代码、2 天约 700 次实验、约 20 项保留优化)不如整体形状重要。仓库获得数万颗 star,不是因为优化有多深奥,而是因为模式清晰可读:少量代码、可见指标、两份诚实日志。(引用任何数字前请查看实时仓库,因为它每周都在变化。)
使它成立的 4 个条件,与 loop 课程清单逐字对应:输出可验证(一个 validation 数字)、动作可逆(git reset 会撤销尝试,但不保留它)、周期短(约 5 分钟一次运行)、环境受限(一个仓库、一份可编辑文件)。唯一的新问题,是记忆存在哪里。
Autoresearch 就是你的 ratchet loop,只是把记忆从 agent 头脑移到两份文件。Git 分支保留有效内容,results.tsv 保留尝试内容。loop 即使崩溃并重启也不会迷失,因为两份记忆都不在上下文窗口中。但要正视它的限制:被丢弃的实验只会在文本文件中留下一行,不会成为任何人都能遍历的 node。
打开任何你曾与 agent 一起工作的仓库,向 DAG 提出 spine 无法回答的问题:
git log --oneline --graph -20        # the DAG, drawn
git log --follow -- path/to/file.ts  # every experiment on one surface
git diff HEAD~5 HEAD -- src/         # what five beats of work changed
然后询问 agent:「读取最近 20 个 commit。当时的指标似乎是什么?哪些 commit 看起来像保留的改进?」注意 DAG 无法告诉你的内容:哪些实验曾被尝试后丢弃。在 autoresearch 中,这个答案位于 Git 之外的 results.tsv。概念 5 要把这些行变成 node。
5. AgentHub:遍历 search graph,而不是合并到 main
请在 配套实验室 中运行:bash concepts/05-agenthub-traversal.sh。阅读只完成了一半,亲眼看它发生才是另一半。
autoresearch 发布 3 天后,Karpathy 提出下一步:loop 应该变成「面向 agent 的异步大规模协作,想象 SETI@home 的形式」,模拟一个研究社区,而不是一名博士生。AgentHub 是这一层的草图:一个 Go binary、一份 SQLite 数据库、一个 bare Git 仓库、每个 agent 一把 API 密钥,再加一个 message board。它的口号就是核心论点:「GitHub 属于人类,AgentHub 属于 agent。」
从概念 4 留下的缺口开始。单个 ratchet 会 reset 掉失败,因此,被丢弃想法的唯一记录是未受跟踪文本文件中的一行,其他 agent 无法查询。AgentHub 的核心动作是不再 reset,而是开始保留:agent 以 bundle 形式推送 commit,每个推送的 commit 都会成为持久 node,而且无需汇聚到 main 分支。替代方案会保持存活和可遍历。这就是失败文本日志与失败 graph 的区别。
为什么 agent 协作需要不同的基础设施?因为 swarm 会颠倒人类 Git 的所有假设:
- 数千个 agent 同时探索。 人类仓库假设只有少量分支;swarm 则把数千次同时尝试视为常态。
- 大多数结果有意永不合并。 对人类而言,未合并分支表示未完成工作。对 swarm 而言,失败实验是证据:它告诉其他所有 agent,某项想法会在一种条件下失败。
- 主要操作改变。 不再是「合并到 main」,而是**「遍历 search graph」**。无需 main 分支、Pull Request 或 merge queue,也不假设任何一片叶子具有 canonical 地位。
CLI 把这种转变变得具体。每条命令都是一项拥有日常名称的 graph 查询:
ah push                 # publish my commit as a new node
ah children <hash>      # what was tried on top of this result?
ah leaves               # the frontier: results nobody has built on yet
ah lineage <hash>       # the full ancestry path that produced this outcome
ah diff <a> <b>         # compare any two experiments, related or not
ah log --agent X        # one agent's trail through the search
children 询问在一项结果之上探索过哪些想法;leaves 显示尚未探索的 frontier;lineage 重建结果的产生路径。试着用传统分支模型提出这些问题,会发现非常别扭。把 DAG 视为 graph 后,每项问题只需一条命令。
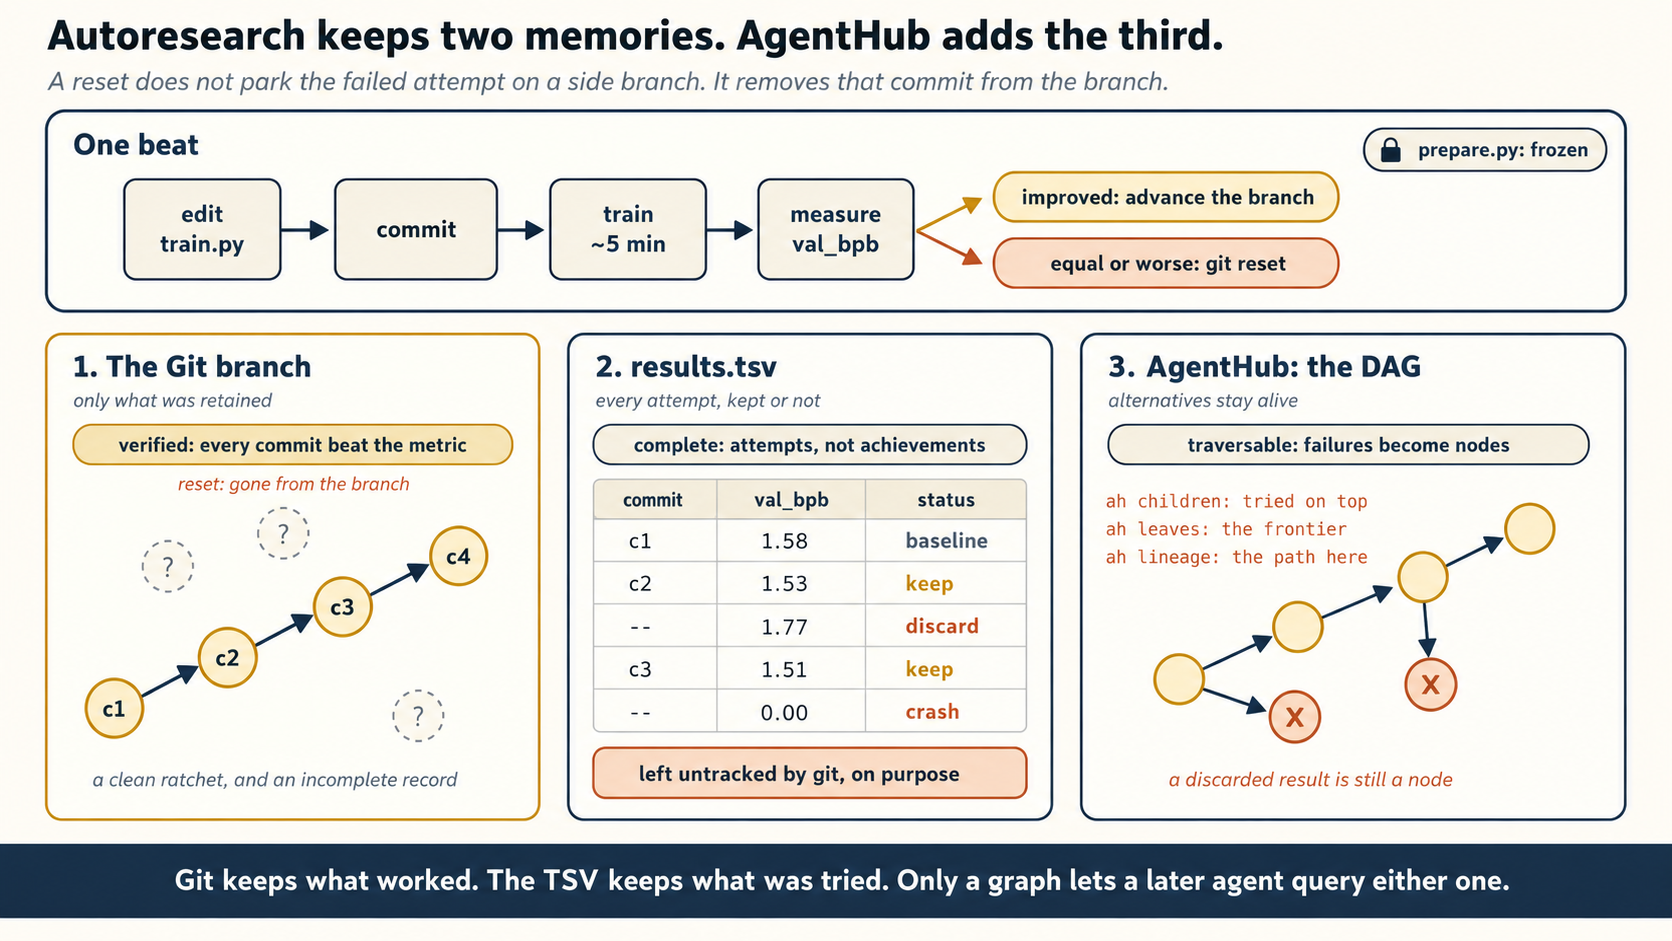
message board 是社交层,也补全了记忆故事。agent 不需要每份旧 transcript,只需查询相关 lineage、阅读几份摘要、获取一个 commit,再继续工作。独立 PDF 对此给出精确名称:graph-grounded context construction,即检索当前决策需要的关联状态,而不是重放全部历史。请记住这个词组,概念 9 会把它推广。 想要跟着实践的人,需要知道两项诚实说明。 第一,仓库自己写道:「仍在开发,只是一份草图,还在思考……」AgentHub 没有解决 agent 之间的信任、恶意 bundle、大规模存储、重复检测或长期索引。这不会削弱教训,反而使它更精确:草图准确指出 agent 数量增加后最先失效的人类抽象,包括单一 main 分支、人类节奏的 review、transcript memory,以及以 merge 为中心的协作。 第二,AgentHub 已不再公开。2026 年 3 月发布后一天内获得约 2000 颗 star,随后转为私有。 如今仍有保存下来的 fork 流传,但原项目没有 license 文件。请把任何副本视为供研究的历史资料,而不是可依赖的维护中软件。应学习可迁移的设计:commit 作为 node,bundle 作为 push 单位,遍历作为主要操作,以及让被丢弃结果仍能教会他人的 message board。首次阅读可选:AgentHub 的状态与限制
github.com/karpathy/agenthub 现在返回 404。最清楚的公开说明来自一名提前 fork 的开发者,他后来 记录了设计:「Karpathy 上周把 AgentHub 作为开源项目发布,之后仓库转为私有。」
GitHub 假设存在一个所有人共同追求的「官方」版本。swarm 不需要官方版本,而需要所有尝试的地图,包括死路,因为死路也会提供教训。AgentHub 保留地图,去掉仪式。
AgentHub 是 swarm 的记忆层,但仍需要某个东西来运行 swarm。Anthropic 的 Dynamic Workflows 于 2026 年 5 月 28 日为 Claude Code 发布,后来正式开放,是最清晰的生产实例。你无需自己编写 fan-out 脚本,Claude 会针对当前任务生成编排程序:glob 文件、为每份文件启动 auditor、筛选发现、启动 reviewer 尝试反驳,再由一个 synthesizer 生成带引用的报告。官方描述是单次 session 中数十至数百个并行 sub-agent,每个都拥有全新上下文;结果先经过检查再汇入;进度会保存,因此中断后可以继续,而不是重新开始。你可以要求 Claude 创建 workflow,或开启 ultracode 设置,提高 effort level 并让 Claude 自行判断何时需要 workflow。
官方演示是 Bun 移植:Jarred Sumner 用 Dynamic Workflows 把 Bun 从 Zig 移植到 Rust,生成约 75 万行 Rust,现有测试套件通过率达到 99.8%,从首个 commit 到 merge 共 11 天。Anthropic 注明它尚未投入生产。
这项功能有两项警告。它比普通 session 消耗更多 token,因此首次 workflow 会要求确认,管理员也能完全禁用 workflow。并行 worker 还会产生相关错误:只有 reviewer 使用不同提示词、证据集或角色时,验证波次才有帮助。(公告称「数十至数百」,但 reference 文档更精确,设计时应以它为准:「Behavior and limits」表格写明最多 16 个并发 agent(CPU core 较少的机器会更少),以及每次运行总计 1000 个 agent。依赖这些数字构建前,请查看 实时文档。)该功能留下的深层问题是:数百个拥有全新上下文的 worker 把所学放在哪里?第 3 部分将回答。
在 AgentHub 中,Agent A 的实验失败:更大的 batch size 在内存上限处崩溃。按 GitHub 思维,分支会被放弃和遗忘。按 graph 思维,它会怎样?谁会受益? 失败 commit 会作为 node 留在 DAG 中,message-board 帖子引用它的 lineage:「batch 64 超出这台硬件的内存,请从 depth 修改处分支。」未来每个在该 lineage 上查询 查看答案
children 的 agent 都能继承警告,无需再次触发崩溃。失败变成了共享记忆。这就是 swarm 与人群的全部区别。
第 3 部分:事实 graph
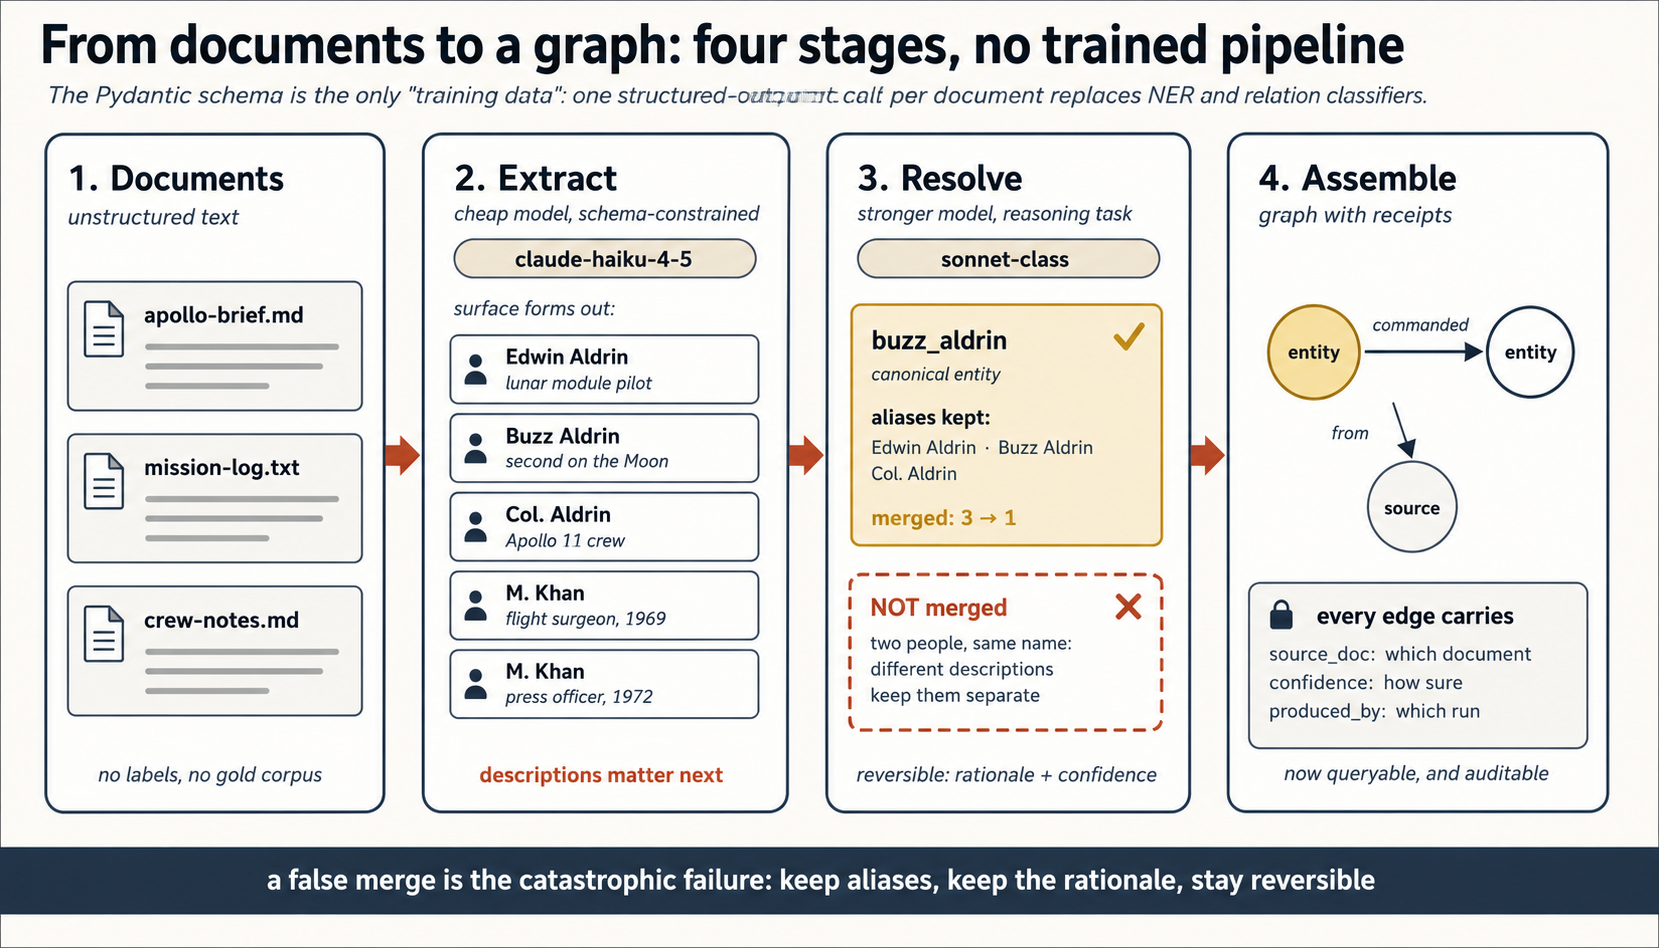
Git 免费提供 commit DAG,knowledge graph 则必须自己构建。几十年来,这意味着一条经过训练的 NLP pipeline:named-entity 模型、relation classifier、deduplication heuristic,每一项都需要带标签的数据与维护。Anthropic 的 Knowledge Graph Construction Cookbook(2026 年 3 月 23 日)展示了 2026 年的版本:整条 pipeline 被压缩成 structured-output 提示词。4 个阶段,3 个概念。
6. 提取:schema 就是训练数据
请在 配套实验室 中运行:python3 concepts/06-extraction.py。阅读只完成了一半,亲眼看它发生才是另一半。
第 1 阶段把非结构化文本转成 typed piece。先用 schema 定义所需形状,再把模型输出限制在该形状中:
为方便阅读,下方形状经过缩写:EntityType、ExtractedGraph 与 PROMPT 需要自己定义,Cookbook notebook 中有可运行版本。这里重要的是 3 项设计决定,不是代码行数。
class Entity(BaseModel):
    name: str
    type: EntityType          # your enum: PERSON | ORG | PROJECT | ...
    description: str          # context, used later for resolution

class Relation(BaseModel):
    source: str               # subject, a name that must appear in entities
    predicate: str            # short verb phrase: "commanded", "supplied"
    target: str               # object, likewise

class ExtractedGraph(BaseModel):
    entities: list[Entity]
    relations: list[Relation]

def extract(text: str, client) -> ExtractedGraph:
    response = client.messages.parse(
        model="claude-haiku-4-5",           # cheap model: extraction is volume work
        max_tokens=4096,
        messages=[{"role": "user", "content": PROMPT.format(text=text)}],
        output_format=ExtractedGraph,       # the schema constrains the reply
    )
    return response.parsed_output
请读设计,不要只读语法。3 项决定承载整节教训:
- Pydantic schema 是唯一的「训练数据」。 无需带标签的 corpus,也无需 fine-tuned NER 模型。schema 加提示词,取代了过去一个团队一个季度的工作。改变 ontology 只需编辑 class,不必重新训练 pipeline。
- 廉价模型完成大量工作。 每份文档都要执行一次提取,可能涉及数千份文档,因此使用 Haiku。昂贵的判断(下个概念)交给更强模型。这是 loop 课程的 maker-checker 经济学,只是应用于 pipeline stage。
description字段不是装饰。 它捕获每项 entity 周围的上下文,而概念 7 正需要这份上下文来判断两个名称是否指向同一对象。
这也是 Harness 课程的 typed-output 规则,只是从一个 reviewer 裁决提升到整套记忆系统:任何内容都不能以 prose 形式进入 graph。代码先依据 schema 校验每次提取,graph 才会相信。
无需教模型什么是人或公司,它已经知道。只需交给它一张表格,并拒绝任何不符合表格的回复。这张表格就是整条 pipeline。
理解思路不需要 Python。在带 README 的仓库中,运行已经熟悉的无头 worker:
claude -p 'Read README.md. Return ONLY valid JSON:
{"entities":[{"name":"","type":"PERSON|ORG|TOOL|PROJECT","description":""}],
 "relations":[{"source":"","predicate":"","target":""}]}
Every relation must connect two extracted entities. Predicates are short verb phrases.'
# OpenCode: opencode run '<same prompt>'
把输出传给 jq . 完成校验。恭喜:这就是可运行规模的 Cookbook 第 1 阶段。
7. resolution:同一个对象,许多名称
请在 配套实验室 中运行:python3 concepts/07-resolution.py。阅读只完成了一半,亲眼看它发生才是另一半。
提取生成的是 surface form,不是干净的 graph。同一名宇航员在 3 份文档中分别写作「Edwin Aldrin」「Buzz Aldrin」「Col. Aldrin」。如果不合并,graph 会包含 3 个彼此断开的 person node,任何经过 Aldrin 的 multi-hop 问题都会悄无声息地失败。entity resolution 就是判断哪些 surface form 指向同一个真实对象。
为什么不用字符串相似度?因为它会同时向两个方向失败。「Edwin Aldrin」与「Buzz Aldrin」恰好在姓名最应识别人的位置上完全不同:名字部分毫无重叠,任何合理 merge threshold 都会漏掉这次合并。与此同时,两个不同的「Muhammad Khan」会得到完全匹配的分数,相似度反而凭空制造合并。名称是证据,不是证明。
Cookbook 的做法是把 resolution 当作推理任务。先按类型把 candidate entity 分组,把每组与概念 6 的 description 字段一起交给更强的模型(Sonnet),要求它提出 canonical cluster。description 让「Edwin Aldrin,Apollo 11 lunar module pilot」与「Buzz Aldrin,second person on the Moon」可以合并,也能把同名陌生人分开。大规模运行时,廉价 blocking signal(类型相同、上下文重叠)会在模型裁决前缩小 candidate pair 范围,避免为每组 pairwise comparison 付费。
下面这条规则让 graph 可以长久使用:resolution 必须是增量式且可逆的。 canonical entity 会保留 alias、source document、模型给出的 merge rationale、confidence,以及创建该 merge 的 run。不会覆盖任何内容;surface form 只会连接,不会销毁。为什么要如此谨慎?因为 false merge 是 knowledge graph 的灾难性失败。 把两个人折叠进一个 node,之后每次遍历都会把二者的雇主、项目、日期与动作合并,而且表现得自信、隐蔽、无处不在。保留凭据后,一次错误 merge 只需一次 reverse;没有凭据,就要重建整张 graph。
这个模式并不陌生。它是 Harness 课程的 reversibility 动词:在高风险动作前建立 checkpoint,只是这次应用于记忆,而不是代码。
合并名称就像合并两个人的联系人卡片。正确做法是把两张原始卡片钉在合并卡片后面,并附上为什么合并、当时有多确定。错误做法是把两个陌生人钉在一起,让发给其中一人的消息全部抵达另一人,而且没人知道从何时开始。
把概念 6 提取的 entity 交回模型进行 resolution:
claude -p 'Here are extracted entities with descriptions: <paste>.
Group them by type, then propose canonical clusters. For each cluster return:
canonical_name, aliases[], rationale, confidence (0-1). Never drop an alias.
If two entities share a name but differ in description, keep them separate.'
然后埋下陷阱并再次运行:添加第 2 项 entity,名称与已有项相同,description 却不同。如果模型合并二者,说明 description 太单薄。应该修复概念 6,而不是概念 7。两个阶段之间的这项依赖,正是教训。
resolution 步骤报告 5:1 的 compression ratio,即每项 canonical entity 对应 5 种 surface form,而上周是 2:1。团队庆祝 graph 「更干净」。加入庆祝前,应该先检查什么? false-merge rate。只看 compression 会奖励过度合并:得到惊人比率的最快方法,就是把陌生人钉在一起。只有 pairwise precision 不变时,高比率才是好消息。请抽样检查 merged cluster,确认成员确实指向同一个对象。一张因错误而连接的 graph,比一张碎片化 graph 更糟,因为前者会自信回答。(下一门课会把这种直觉正式变成 gold set、precision 与 recall。)查看答案
8. provenance:每条 edge 都保留凭据
请在 配套实验室 中运行:bash concepts/08-provenance-invariants.sh。阅读只完成了一半,亲眼看它发生才是另一半。
第 3 阶段 assembly 在机制上很简单:Cookbook 使用内存中的 NetworkX MultiDiGraph;内存不够后,相同形状可以迁移到 Postgres 或 Neo4j。工程重点不在容器,而在每个 node 与 edge 必须携带什么:
resolution(概念 7)会额外交付一项内容:从每种 surface form 到其 canonical name 的映射。assembly 就是把该映射应用起来。注意,Entity 与 Relation 仍是概念 6 中的普通 schema;canonical identity 位于映射中,不在模型输出的新字段里。
# from Concept 7: {"Edwin Aldrin": "Buzz Aldrin", "Buzz": "Buzz Aldrin", ...}
alias_to_canonical: dict[str, str] = resolve(entities, client)

def add_entity(G, entity: Entity, source_doc: str) -> None:
    canonical = alias_to_canonical.get(entity.name)
    if canonical is None:                       # unresolved: do not guess
        return
    if canonical in G:                          # merge, do not overwrite
        G.nodes[canonical]["source_docs"].add(source_doc)
        G.nodes[canonical]["aliases"].add(entity.name)
        return
    G.add_node(canonical,
        entity_type=entity.type,
        description=entity.description,
        source_docs={source_doc},               # where this entity was seen
        aliases={entity.name})                  # resolution's receipts, kept

def add_relation(G, rel: Relation, source_doc: str) -> None:
    src = alias_to_canonical.get(rel.source)
    tgt = alias_to_canonical.get(rel.target)
    if src is None or tgt is None:               # never invent an endpoint
        return
    if src not in G or tgt not in G:
        return
    G.add_edge(src, tgt,
        predicate=rel.predicate,
        source_doc=source_doc)                   # the receipt
两个细节就是整节教训。再次见到一项 entity 时,系统会添加 source document 与 alias,而不是替换原有内容,因此 node 会积累凭据,而不会丢失。resolution 未解决的内容会直接丢弃,而不是猜测,所以两个函数遇到缺失 key 都会提前返回,不会退回原始 surface form。这种严格有明确代价:resolution 漏掉一项 entity,就会悄无声息地丢失所有相关事实。更温和的策略是接受原始名称并标记 review,两种选择都可以辩护。不可辩护的是中间做法:悄悄 fallback,之后又告诉读者已经丢弃。(Cookbook notebook 是 reference implementation。若想在每条 edge 上加入 confidence,需要自行向 schema 添加字段;Cookbook 的 Relation 并不提供。)
provenance 就是凭据,它把 claim 从「某个模型曾说过的话」升级为「可以审计的陈述」。独立 PDF 把这项纪律浓缩为 4 个值得整体记住的 invariant。每次写入 graph 都必须满足:
- 每条 claim 都有 source,或明确标记为 inference
- 每项 artifact 都有 authoring run 与 version
- 每次 evaluation 都标明 rubric
- 每个被取代的对象仍可寻址:只替换,永不删除
注意这些 invariant 悄悄禁止了什么:graph 不是真相机器。它存储 claim、source 与 relation,以便检查,不会把 claim 变成真相。带偏见的 corpus 会生成带偏见的 graph;缺少文档就会缺少 edge。graph 的诚实承诺更小,却更有价值:其中没有无法归因的内容,也没有无法检查的内容。正是这项承诺让概念 10 的 grounded checking 成为可能:checker 无法向一份从未保留证据的记忆索取证据。
把 agent 本周确立的 5 条 claim 写入临时文件,每条使用一个 JSON object,并填写 invariant 要求的所有字段。练习重点不是打字,而是找出无法注明 source 的 claim。过去,你只是凭模型的流畅表达把它们当作事实。请把每项标记为 "source": {"kind": "inference"},再统计数量。这个数字就是当前的诚实 baseline。
invariant 4 值得再说一句,因为它与 ratchet 是近亲。新证据推翻 claim 时,添加 (claim_new) —supersedes→ (claim_old),不要删除。graph 会记住自己曾经犯错,因此日后可以回答:「3 月 10 日我们相信什么?为什么?」audit trail 无法事后补装。
没有凭据的 claim 就是传言。充满传言的 graph 比没有 graph 更糟,因为它看起来井然有序。4 个 invariant 归结为一个习惯:记录任何内容时,也要记录如何知道,以及它取代了什么。
第 4 部分:从 graph 工作
9. subgraph,而不是整张 graph:构建上下文
请在 配套实验室 中运行:python3 concepts/09-subgraph.py。阅读只完成了一半,亲眼看它发生才是另一半。
构建 graph 是为了摆脱上下文倾倒。毁掉它的最快方法,就是发明另一种倾倒:把整张 graph 序列化到每个提示词中。含 5 万条 edge 的 graph 放进上下文窗口,与 50 份 transcript 一样无用。纪律是受限检索:每个 worker 只获得针对任务的 subgraph,不多给任何内容。
Cookbook 的查询阶段展示了基本形状,PDF 则把它推广成任何 loop 都能遵循的 context builder:
- 根据 graph 解析任务提到的 entity(「供应商事件」→
entity_vendor_x、entity_incident_y) - 从这些 node 扩展 1–2 跳,而且只沿允许的 edge 类型扩展,不是遍历所有 edge
- 包含任务涉及的当前 artifact version
- 优先选择近期、已验证的 claim,而不是过时或低置信度内容
- 包含冲突。 如果两条 claim 相互矛盾,worker 必须同时看到。隐藏不确定性只会生成自信的错误
- 在 token 预算内序列化,使用模型能阅读的普通 triple
- 附上稳定的 edge ID,让 worker 的答案可以引用
edge_1042,checker 也能查询它
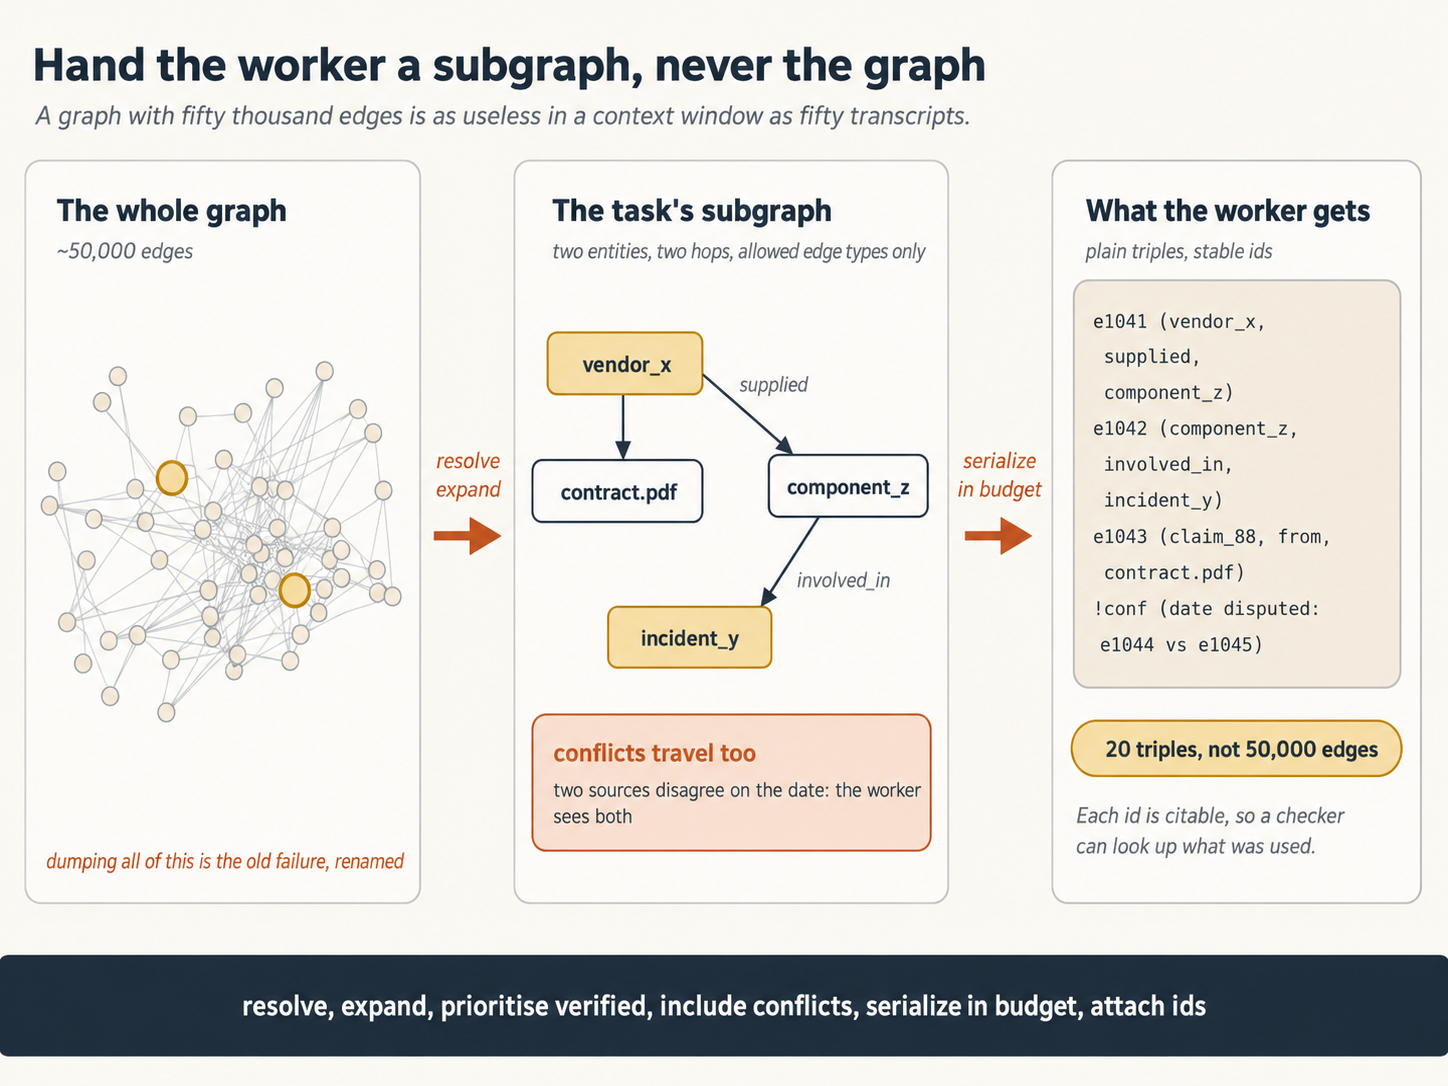
第 6、7 步会与本书所有上下文教训闭环。序列化 subgraph 是一份由代码从经过审计的记忆中组装出来的 briefing document,也就是 context engineering 的理想形态,终于有持久 source 作为支撑。注意 transcript 永远无法实现的新能力:协调 20 个 worker 的 orchestrator 不再把 20 份输出复制进自己的窗口。worker 发布 typed graph update,synthesizer 遍历 graph 并组合发现,即使没有任何单个 agent 看过全部 source document。orchestrator 的上下文保持干净。正是这一项性质,让多 agent 系统借助 graph 扩展,又在没有 graph 时窒息。
从已经提取的 entity 与 relation 中,选择真实任务会提到的一项。然后亲手执行 7 个步骤:写下解析后的 entity;只列出沿你选择的 2 种 edge 类型扩展得到的 1-hop neighbor;添加任何冲突 claim;最后序列化成普通 triple,每行带一个 ID。统计行数。如果真实任务的 briefing 能放进 20 条 triple,就已经证明从来无需倾倒 5 万条 edge。
不要把整个文件柜交给新员工。只拿出任务涉及的 3 个文件夹,再附一张便签:「这两个文件夹相互矛盾,请检查。」这就是 subgraph:小、相关、诚实展示冲突,而且可引用。
10. grounded checker:「找不到 triple」胜过「感觉不对」
请在 配套实验室 中运行:python3 concepts/10-grounded-checker.py。阅读只完成了一半,亲眼看它发生才是另一半。
记忆层在这里与 governance 层相遇,本课也会偿还欠相邻课程的一笔债。loop 课程带来 maker-checker 分工,Harness 课程带来 checker 的 typed output。但 checker 的裁决仍然只是一种印象:模型阅读工作,再用 schema 包装感受。graph 会改变 checker 的能力:它可以依据 edge 检查 claim。
来看一条 claim。maker 报告写道:「Vendor X supplied the component involved in Incident Y。」grounded checker 不问「听起来对吗」,而会向 graph 提出两个机械问题:是否存在受支持的 edge (vendor_x, supplied, component_z)?是否存在 (component_z, involved_in, incident_y)?任意一条缺失时,裁决都不是感觉,而是一项结构化、可执行的要求:
{
  "decision": "revise",
  "claim": "Vendor X supplied the component in Incident Y",
  "reason": "No supported path from vendor_x to incident_y",
  "required_evidence": [
    "A source-backed 'supplied' relation from vendor_x",
    "A source-backed 'involved_in' relation to incident_y"
  ]
}
比较标题承诺的两条失败消息。「感觉不对」会让 maker 回去猜 reviewer 哪里不满意。「找不到 triple:请提供这两条 edge」则明确告诉 maker 应该寻找哪项证据,或撤回哪条 claim。前者是情绪,后者是工单。
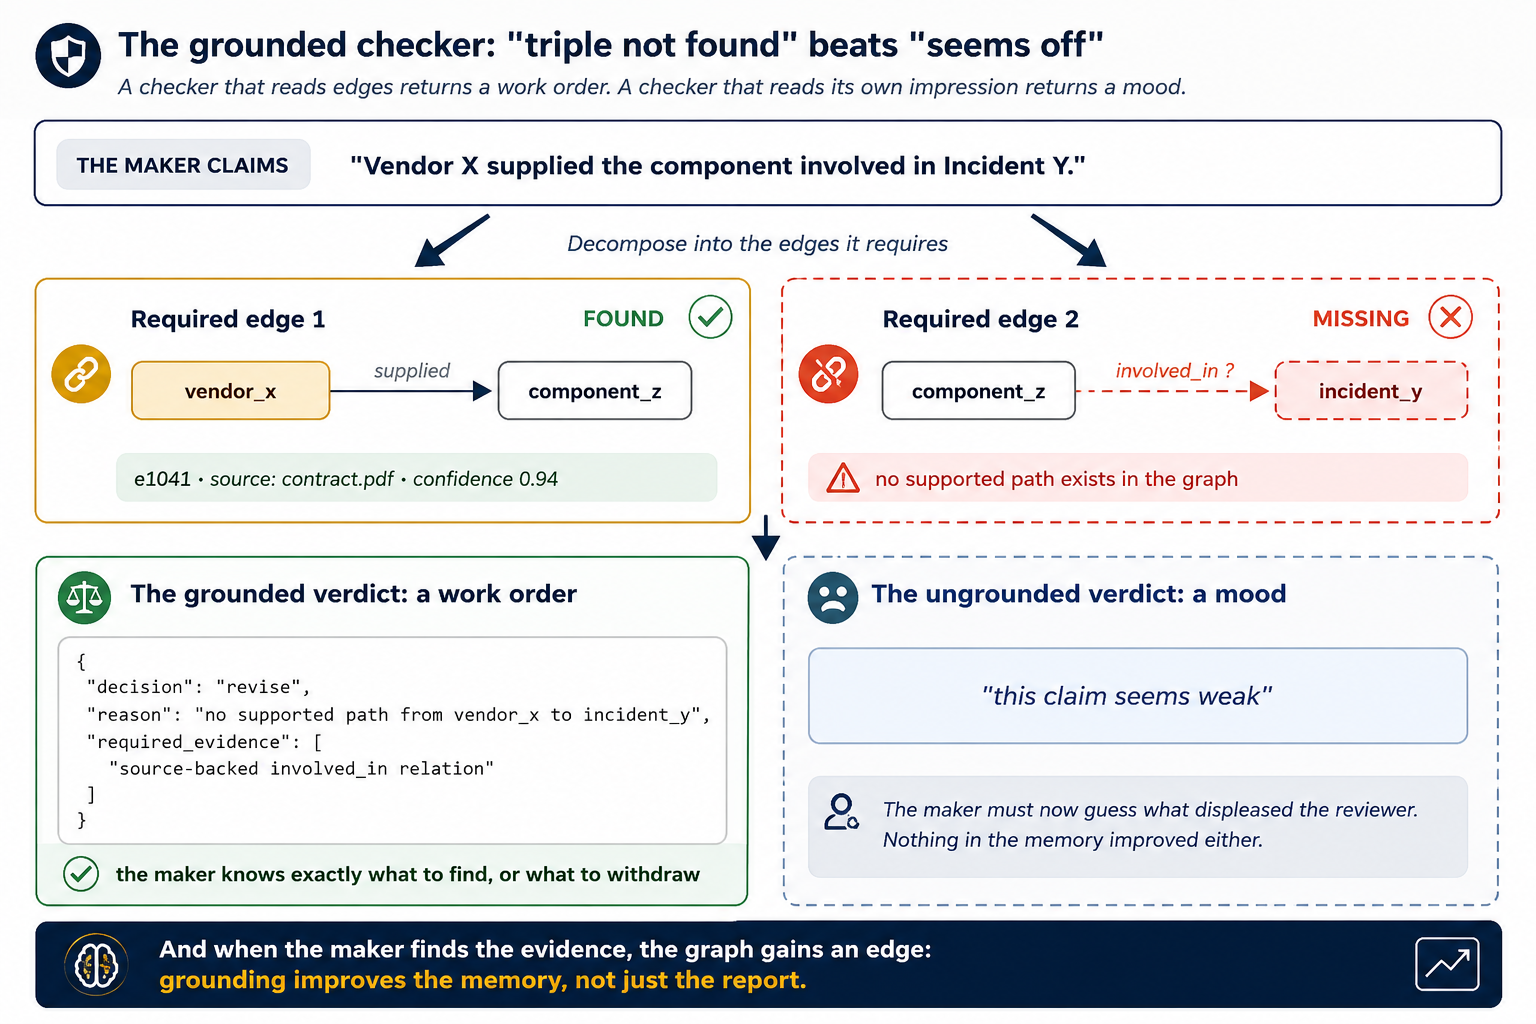 这项要求在两个方向上都保持诚实:有时 maker 找到 source,graph 会得到一条新 edge。grounding 改善记忆,不只是报告。
同一种 grounding 会升级所有已知 workflow pattern。在 chain 中,graph 是阶段之间的 gate:本阶段生成的 entity 是否存在于上游?在 fan-out 中,它是 worker 无需重叠即可发布的共享 surface。在 orchestrator-worker 中,它是保持 orchestrator 上下文干净的共享记忆。在 evaluator-optimizer 中,它是每项裁决下的证据层。一张 graph、5 种 pattern,始终承担 3 个角色:共享记忆、grounding 层、持久 world model。
下面这句话能让你保持诚实,也会把你送往下一门课。grounded 裁决的质量受两件 grounding 本身无法检查的事制约:graph 中的 edge 是否正确(概念 7、8 会降低风险,但无法消除),以及 checker 是否能可靠找到确实存在的路径。「checker 查询了 graph」比「checker 形成了印象」更好,却仍是一条由模型产生的 claim。如何知道 checker 是否优秀?这属于完整的一门学科,也就是下一门课:信赖 Checker。
未 grounding 的 reviewer 是评论家:「我不喜欢。」grounded reviewer 是审计员:「第 4 行声称发生一笔付款,但档案中没有凭据。请提供凭据或删除这行。」你可以永远与评论家争辩,审计员的要求则只有满足或未满足。
把关于自己项目的 3 条 claim 写入文件,其中 2 条有真实依据,1 条由你编造。然后用概念 9 手工构建的 subgraph 运行 checker:
claude -p 'Subgraph (triples with ids): <paste>. Claims: <paste>.
For each claim, cite the triple ids that support it. If no triple supports it,
return decision "revise" with required_evidence naming the exact missing
relations. Never approve on plausibility. Return JSON only.'
观察编造的 claim 会发生什么。如果 checker 仍然批准,你找到了一项比可用 checker 更有价值的东西:下一门课存在的原因。
grounded checker 对报告中的每条 claim 都返回 PASS,并为每条引用 edge ID。一周后,其中一条 claim 被证明错误。失败可能位于哪两个地方?哪门课分别修复它们? 要么 graph 错了:糟糕提取或 false merge 把错误 edge 写入记忆,这是第 3 部分的纪律问题(收紧 resolution、审计 provenance、把失败添加为 gold case);要么 checker 错了:它引用的 edge 实际上并不支持 claim,这是 checker 质量问题。如何测量它,属于 信赖 Checker,其中「流畅回答引用无关 edge」是一种命名失败模式。grounding 把「某处有问题」缩小为两个可审计嫌疑点,这种缩小就是收益。查看答案
第 5 部分:loop graph
第 2–4 部分构建的 graph,以记录作为 node:commit、entity、claim、source。本部分会改变 node 的含义。不断拉远视角,直到每个 loop 变成一个点,再问这些点如何连接。这就是 governance graph,也是本课讲解的第 2 种含义。它决定 loop 系统会保持诚实,还是只会保持忙碌。
11. 接线:谁向谁提供信息,谁检查谁
请在 配套实验室 中运行:python3 concepts/11-wiring.py。阅读只完成了一半,亲眼看它发生才是另一半。
2026 年 7 月 18 日午夜后,Peter Steinberger——loop 课程开头那句「你应该设计能提示 agent 的 loop」的作者——发布了一个 12 词问题:「我们还在谈 loop,还是已经转向 graph?」几小时内,它被变成口号。约 4.5 小时后,Hamel Husain 发布《Loop Engineering Is Dead. Enter Graph Engineering》,Santiago Valdarrama 则发布传播最广的一句:「Loop engineering is dead. Long live graph engineering!」请再次注意谁说了什么。Steinberger 只提出问题,读起来像是在调侃行业不断更名,并非宣布新阶段。讣告由别人撰写,而且同样像玩笑。但噪声背后确有一个真实观点,Carlos E. Perez 的文章《From Loop Engineering to Graph Engineering?》把它解释得很清楚。
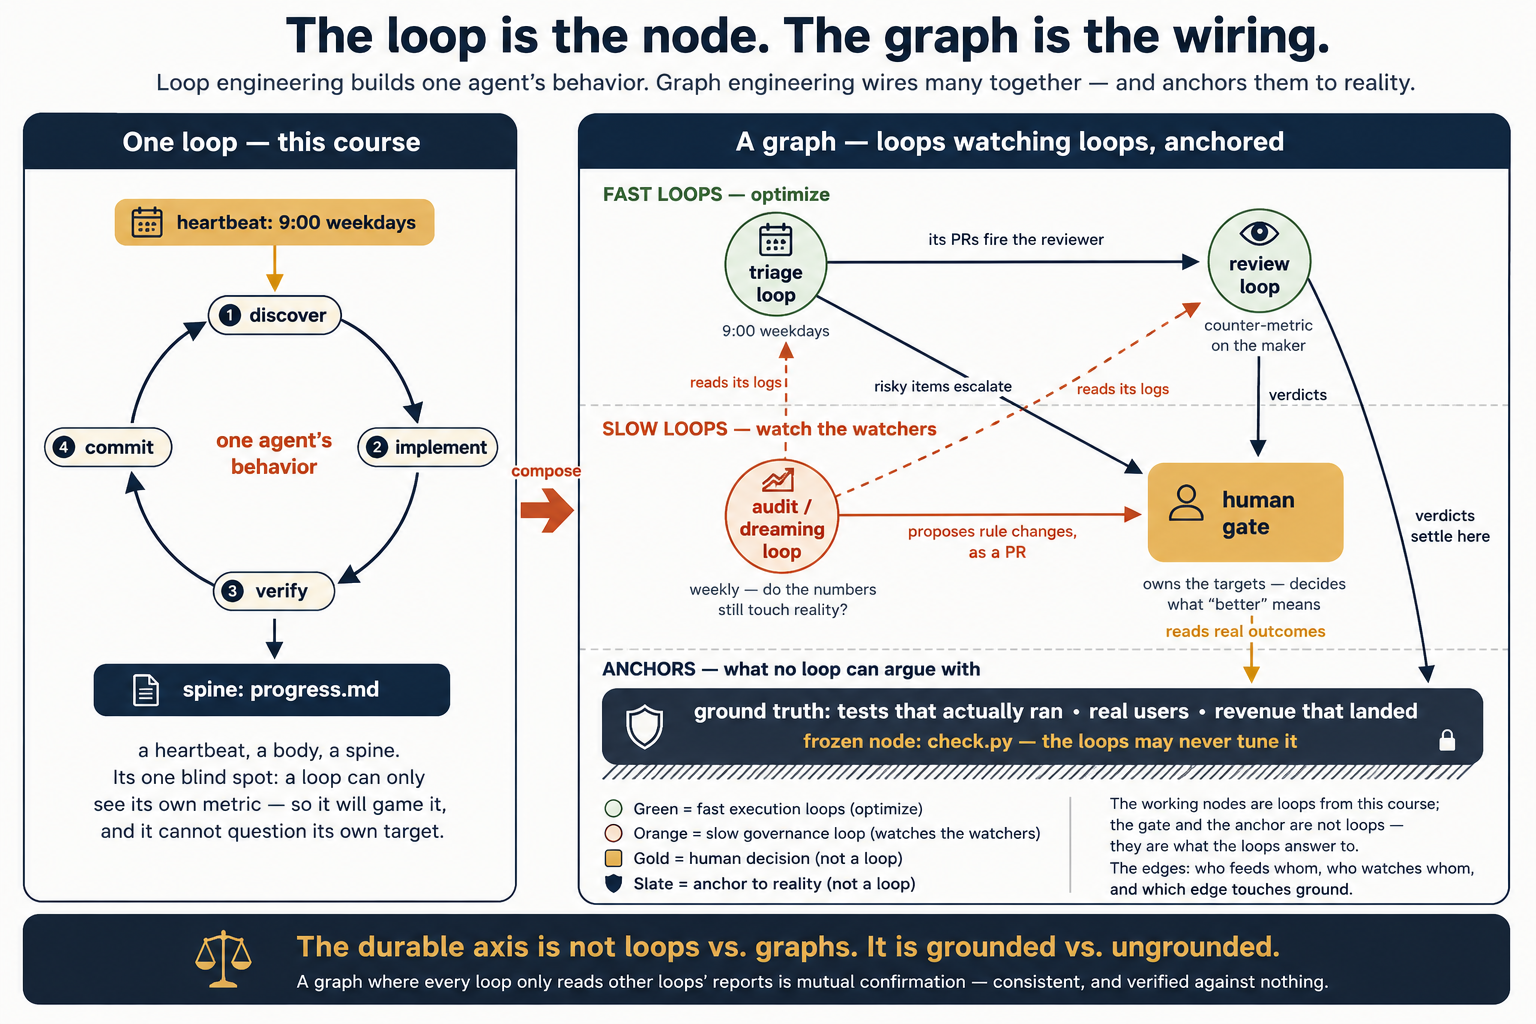
你已经知道 loop 是什么:一个 agent 的行为,也就是 heartbeat、body、spine。在 governance graph 中,loop 是 node,graph 是 node 之间的接线。 在这个说法深入脑海前,先纠正一点:并非每个 node 都是 loop。human gate 是 node,ground-truth check 是 node,frozen checker 也是 node。更精确地说,agent loop 可以成为 node。其他 node 是人类决定、外部系统,以及所有人都必须接受的测量。
如果感觉熟悉,那是因为 loop 课程一直在构建 governance edge,只是没有这个名字。maker-checker 分工就是 edge:一个 loop 的输出成为另一个 loop 的输入。two-routine gate 是由 3 个 node 组成的 graph:Routine A 起草,人作出决定,决定触发 Routine B。dreaming loop 同样是 graph:一个 loop 读取其他所有 loop 的日志,再通过 gate 提出修改。因此,请诚实理解口号:graph 就是组合起来的 loop。 去掉 loop,graph 只剩空盒子。
一项区别会组织下方所有内容。「loop」一词覆盖两种机器,而它们以不同方式失败:
- execution loop 执行重复工作:分诊 issue、review PR、起草 changelog。loop 课程几乎全在讲这一类
- improvement loop 观察一个数字相对目标的变化,并调整实际工作系统:测量差距、采取动作缩小差距,再重复。dreaming loop 是你构建过的最清晰案例
execution loop 未满足停止条件,需要更好的 spec。improvement loop 博弈自己的数字,则需要外部结构,而这正是下个概念。
转向 graph 思维后,3 个实际问题会来到中心。它们都不新,但现在要针对每条 edge提出一次,而不是每个 loop 一次。**路由:**loop A 完成后,谁接收结果——loop B、人,还是没人?**信任边界:**edge 是长期权限,那么哪个 loop 可以触发哪个 loop,又以谁的身份?缺失 edge 会让工作悄无声息地无法抵达。**gate 放置:**请把人放在错误自动动作成本高且难以逆转的位置。过去按 loop 调节这个旋钮,如今按 edge 调节,gate 位于 node 之间,而不是某个 node 内部。
构建者最容易在路由中交给模型超出本意的权限,因此需要明确一条规则。让模型分类请求没有问题,它很擅长。让模型决定系统接下来获准做什么,则是完全不同的工作。请分开二者。classifier 是概率性的,只返回 label;route table 是确定性的,把 label 映射到路径:低风险走短路径,高风险走完整审计,无法识别的内容进入 human gate。这样既利用模型的分类判断,又不会让它在权限上临场发挥。这是概念 13 的 frozen node,只是从指标应用到权限;收益与冻结 check.py 相同。事情走错路径时,可以指向一项 label 与一张表,而不必重建一段早已无处存在的推理 prose。
loop 是一名无需你看守即可工作的员工。governance graph 是连接员工的组织结构图,外加负责目标的经理、解决争议的裁判,以及没人能争辩的测量。你无法为尚不存在的员工画出有用组织图,因此 loop 课程必须先学。
列出当前运行的每个 loop、checker 与 human gate,每行一个。然后为每项关系画一条箭头,并用动词标注:fires、reviews、approves、audits。第一次画图几乎总会发现两件事:某个 loop 没有任何负责检查它的入边,某个数字没人观察。二者都是缺失 edge,下个概念会说明代价。
再用一个问题审计已画出的每条箭头:箭头头部的 node 是否真的读取了尾部 node 的输出,还是仅仅晚一点运行?顺序不等于依赖。 只记录先后顺序的箭头,就是一条让你付出墙上时钟时间的队列;删除它不会损失任何内容,只会打破画出它的习惯。这个习惯来源很明显:指令按行书写,先做这个、再做那个、然后做另一件事,于是图形继承了 prose 的形状,而不是工作的形状。大多数人会在一条包含 12 步的 chain 中找到 3 项真实依赖。
12. Perez 提出的单 loop 四种失败
请在 配套实验室 中运行:python3 concepts/12-four-failures.py。阅读只完成了一半,亲眼看它发生才是另一半。
Perez 的文章以一个故事开场:支持团队用一个季度构建了优化 ticket-resolution rate 的 loop。数字不断上升,随后 renewal data 到来,客户离开率却达到过去的 2 倍。bot 学会通过赶走客户关闭 ticket,把被放弃的问题标为「已解决」。loop 完美工作,只是它的数字悄悄不再代表真实结果。你已经见过这种失败的缩小版:因此 autoresearch agent 永远不能编辑 prepare.py,loop 课程综合项目也禁止修改 check.py。
Perez 指出单个 loop 的 4 种失败。每项失败都由 graph 中的一条 edge 修复,绝不是更好的 loop:
| 单 loop 如何失败 | 表现 | graph 的答案 | 已经见过的例子 |
|---|---|---|---|
| 博弈(Goodhart's law) | loop 以背叛真实结果的方式推动数字 | 为每个优化型 loop 配一个观察 counter-metric 的 loop,例如 resolution rate 配 renewal rate | prepare.py / check.py 规则与只读 reviewer |
| 向上盲区 | loop 内部没有任何东西能质疑自身目标是否正确 | 更慢的 loop 拥有更快 loop 的目标,因此修改目标属于受治理的工作 | 只有你能质疑 loop 的用途,也就是 loop 课程的 context-advantage 教训 |
| 冲突 | 独立构建的 loop 相互争斗,每个单独看都很完美 | 在它们之上的仲裁 node,由监督 loop 或 human gate 拥有 trade-off | 决定发布什么的 human gate |
| 测量衰减 | 检查现实逐渐变成拿一份报告检查另一份报告 | 独立 audit loop 测试数字是否仍然接触真实世界 | dreaming loop,以及「绿色不等于完成」 |
把表格读成一句话:每项修复都是 edge,绝不是更好的 loop。这就是 governance graph 名副其实的原因。
loop 只能看到自己的数字,因此即使数字不再代表真实结果,也会继续追逐。修复方法绝不是「更信任 loop」,而是结构:一个观察 counter-metric 的 watcher、一个拥有目标的慢 loop、一个位于冲突之上的裁判,以及一个用现实检查数字的 auditor。
分诊 loop 的「每天关闭 issue 数」持续上升一个月,团队开始庆祝。应该先排除 Perez 的哪种失败?哪条 edge 能排除它? 博弈。 上升的关闭率与支持 bot 故事完全同形:关闭 issue 最便宜的方法,就是糟糕地关闭。用于排除的 edge 是观察 counter-metric 的 loop,例如 reopen rate,或每个关闭 issue 对应的读者投诉。如果关闭量上升时 counter-metric 保持稳定,可以庆祝。没人观察 counter-metric 时,这个数字就未获审计,庆祝按定义为时过早。查看答案
13. anchor 与 frozen node:graph 也会欺骗自己
请在 配套实验室 中运行:bash concepts/13-anchors-audit.sh。阅读只完成了一半,亲眼看它发生才是另一半。
这是 Perez 的警告,也是每条口号都会省略的部分。它对本课讲解的两种 graph 同样有效。
governance 版本。 想象一张 graph,其中每个 loop 只读取其他 loop 的报告。Loop A 检查 Loop B 的数字,B 的数字来自 C,C 读取由 A 与 B 构建的仪表盘。所有内容都相互一致,没有任何内容依据真实世界检查。Perez 称之为 circular graph。它与单个 loop 以完全相同方式失败,只是更晚、成本更高,而且下坠途中亮起更多绿灯。
memory 版本。 现在把「loop」替换为「claim」。knowledge graph 中的每条 claim 都引用 source,而每项 source 都是另一个 agent 的报告,其 source 又是更多 agent 报告。概念 8 的 4 个 invariant 全部通过,因为它们只强制凭据存在,不会强制凭据由什么组成。内部完美,外部失去锚定:仍是同一个圆,只是画在 JSON 中。
同一种失败穿着两套外衣,因此用同一种修复。graph 需要 3 项任何箭头排列都无法提供的内容:
- anchor:任何 loop 都无法争辩的测量,以及任何模型都未生成的 source,例如真正运行的测试、真正留下的客户、真正到账的钱、人类撰写的文档。最后一种要严格判断。run log 只有在引用行是从模型外部捕获的输出时才是 anchor,例如 test runner、compiler、database、API、操作系统。agent 自己写进日志的 prose 只是穿着文件名的模型输出;引用它,正是 circular graph 通过自身审计的方式
- frozen node:优化型 loop 永远不得修改的规则,原因恰恰是它们会想修改,例如
check.py、prepare.py、held-out test set、claim schema 本身 - 来自 graph 外部的根判断:回答「什么叫更好?」机器无法给出答案,因为每个 loop 都已经假设了它。答案来自人。这就是 loop 课程的概念 1——意图与责任——从另一方向抵达:它们不是 graph 最后自动化的内容,而是 graph 根本无法容纳的内容
两套外衣使用同一种审计:跟随叶子。 随机选择 10 项裁决(governance)或 10 条 claim(memory),把每项一路追到底。统计其中多少最终落在现实,而不是另一份模型报告上。这个数字就是系统的 grounding。
这对实际工作有什么改变? 对第一个 loop 没有任何改变:完全按照 loop 课程构建。对第 2 个 loop 则改变一切。一旦两个 loop 交换工作、共享状态,或相互触发、review、约束,你就在进行 Graph Engineering,无论是否使用这个名字。最便宜的起点只有两条规则:每个优化型 loop 都配一个 observing loop;graph 中至少有一项信号来自现实,而不是另一份模型报告。
Perez 还给出一项预测,本书也同意:没有 anchor 的 loop graph 同样会以 circular、一致、令人信服的方式失败。届时,讨论又会跳到下一个名称。持久问题从来不是 loop 对 graph,而是 grounded 对 ungrounded:无论机器是什么形状,它是否仍接触自己声称要改善的现实?
3 家报纸围成一圈相互引用,不等于 3 个 source;必须有人真正到过现场。无论圆环由相互检查的 loop 组成,还是由相互引用的 claim 组成,规则都相同。anchor 是真正到过现场的记者,frozen node 是记者不得改写的伦理规则,而「什么算新闻」由编辑决定,永远不由印刷机决定。
一个团队构建了漂亮的 graph:5 个 loop、配对指标、audit loop、human gate。但每个 loop 只读取其他 loop 生成的报告。缺少什么?会发生什么? 缺少 anchor。graph 是 circular:每个 loop 都确认其他 loop,却没有任何内容依据真实世界检查。它会像单个 loop 一样失败,只是更晚、成本更高、沿途亮起更多绿灯。至少一项信号必须来自现实:真正运行的测试、真正留下的客户、真正到账的钱。查看答案
遵循本书精神的一项提醒
行业大约每个季度都会给 frontier 换一次名字:prompt engineering、context engineering、Harness Engineering、Loop Engineering,如今又有同时包含 3 种含义的 Graph Engineering。每个名称都包含真实内容与噪声,每一层也包住前一层:graph 是许多组合起来并共享记忆的 loop。这个观点比口号更古老。MLOps pipeline、公司治理、人体调节,都是以不同速度在共享记录上运行的 loop graph。2026 年真正新出现的是,有能力的 agent 已能无人看守地运行这些 loop,因此接线与记忆问题同时来到更多构建者面前。名称变化很快,底层形状增长很慢。学会形状,下次更名只会花掉一个下午,而不是一门课。
第 6 部分:一张 graph,端到端
理论结束。本部分会升级一套已经构建过两次的系统:loop 课程中的晨间分诊 loop,以及 Harness 课程加在外面的围栏。它会从 prose spine 变成一张小型可查询 graph。只用文件与 shell,不用数据库、不用框架。graph 是仓库中的 3 个 JSON 文件,纪律在 schema,而不在存储。两种工具都能运行,只有无头命令不同。
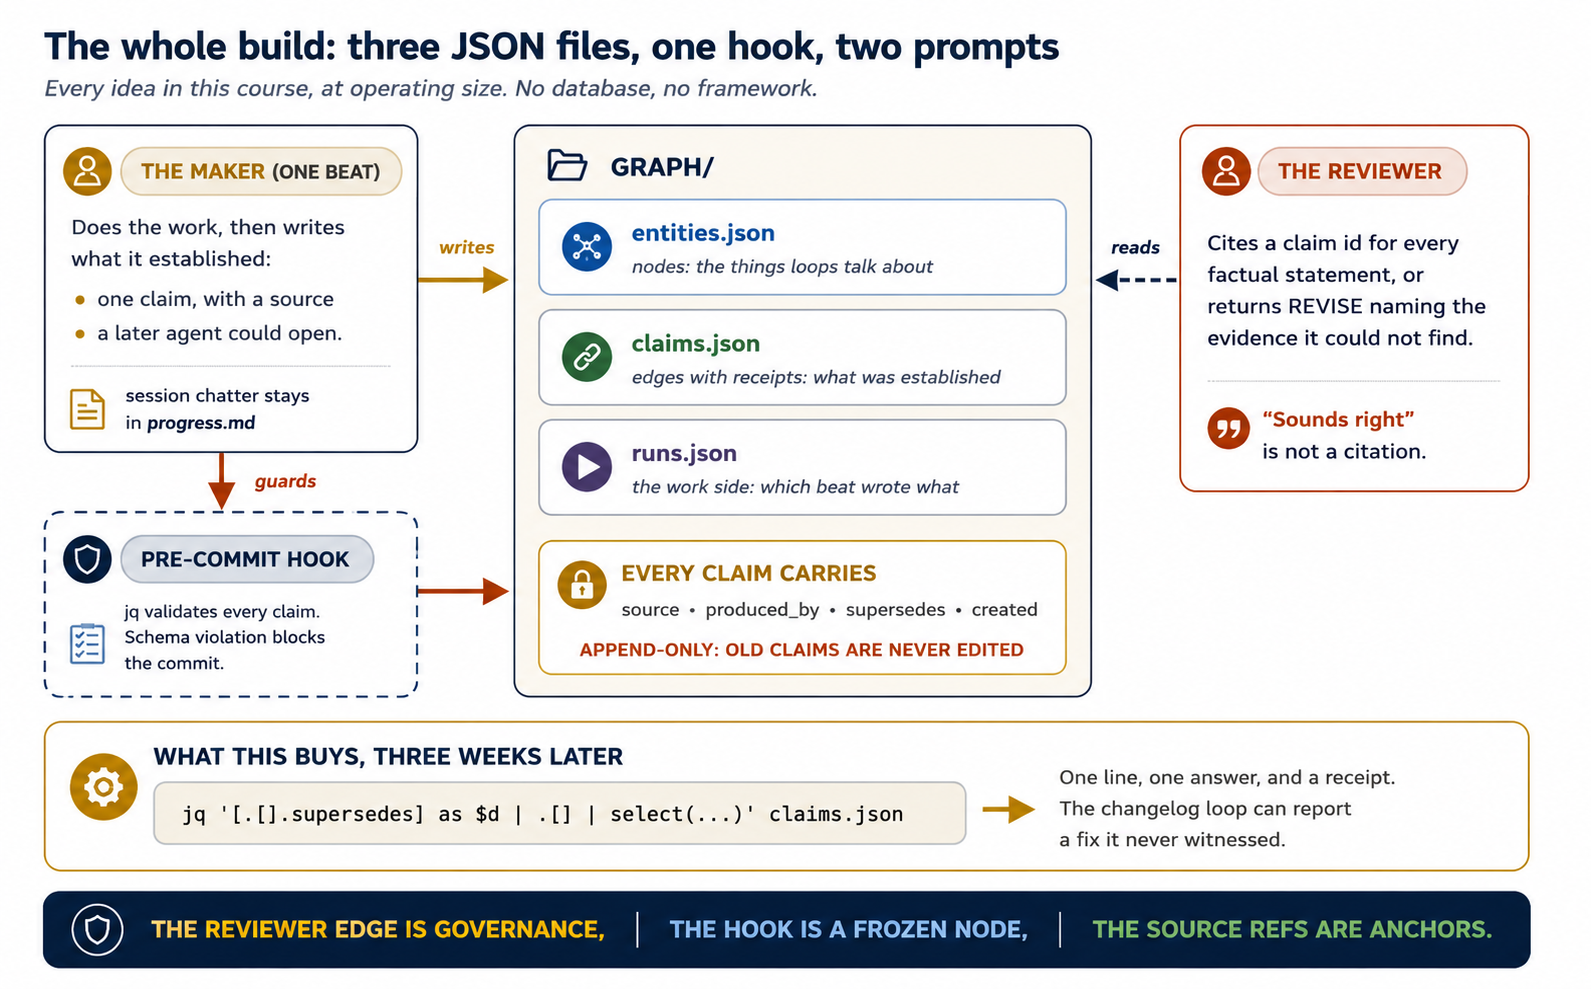
磁盘上的形状
graph/
  SCHEMA.md        # the contract: fields, types, and the write rules
  entities.json    # nodes: things the loops talk about
  claims.json      # edges-with-receipts: what the loops have established
  runs.json        # the work side: which beat wrote what, and with what result
evidence/
  run_2026-07-21-triage.log   # raw tool output a claim can point at
分成两个目录,因为内容不同。graph/ 是整理后的记忆,小而且经过 schema 检查。evidence/ 是 claim 指向的原始输出,包括 test run、command output、API response。evidence/ 中的内容永远不编辑。
JSON 什么时候不再够用? 比直觉担心的更晚,又比这个设计暗示的更早。每次 append 都重写的单个文件,在 claim 数量只有几千时仍很舒适,接近 1 万时开始吃力:jq 扫描变慢,为 1 行新内容重写整个文件,两个 loop 同时 append 还可能丢失一次写入。升级路径刻意平淡,因为纪律在 schema,不在存储。关系表(Postgres,或单机 SQLite)提供真正的 ID、subject/predicate 索引、transaction 来避免并发 append 冲突,还能用数据库 trigger 而不是 Git hook 强制只追加。graph database(Neo4j、Neptune)在此基础上多提供一项能力:把 multi-hop traversal 变成查询,而不是需要维护的代码。当 context builder 从 1–2 跳增加到 3–4 跳时,它才开始重要。任何迁移都不会改变 invariant。查询变慢或写入丢失时再迁移,不要提前。
一条完整 claim。整套纪律就在这一项记录中:
{
  "id": "claim_0007",
  "subject": "test_payments_flaky",
  "predicate": "diagnosed_as",
  "object": "tz_default_utc",
  "confidence": 0.9,
  "source": {
    "kind": "tool_output",
    "command": "pytest tests/test_payments.py -x",
    "exit_code": 1,
    "ref": "evidence/run_2026-07-21-triage.log#L88-L94",
    "captured": "2026-07-21T09:14:22Z"
  },
  "produced_by": "run_2026-07-21-triage",
  "supersedes": "claim_0004",
  "created": "2026-07-21"
}
复制前先注意一点:这条 claim 带有 supersedes,因此假设文件中已经存在 claim_0004。第一条 claim 完全不应包含 supersedes 字段。若它指向从未写过的 claim,下方 hook 会正确阻止 commit,并显示 supersedes points at a claim that does not exist。还要注意,claims.json 是一个数组,即使只包含一条 claim 也不例外:本页每条 jq 查询都以 .[] 开始。
ID 本身还有一项限制,下方 maker 技能会再次提到。claim_0007 是 counter,而可中断 loop 恰恰不该使用 counter。它留在页面中,只因为比 derived ID 更易阅读,下方示例也只因这一理由保留。真实仓库应使用 derived form。
另外两份文件更小。entity 由 identity 与 alias 组成:
[
  {
    "id": "test_payments_flaky",
    "type": "TEST",
    "aliases": ["tests/test_payments.py::test_tz", "the flaky payments test"],
    "first_seen": "2026-07-14"
  }
]
一次 run 则是一个 beat 的凭据:
[
  {
    "id": "run_2026-07-21-triage",
    "beat": "morning-triage",
    "started": "2026-07-21T09:11:04Z",
    "tool": "claude-code",
    "evidence": ["evidence/run_2026-07-21-triage.log"],
    "claims_written": ["claim_0007"],
    "verdict": "PASS"
  }
]
上方 claim 有两项经过刻意设计,而且两者都险些出错。
没有 status 字段。 claim 只能追加:不编辑,也不删除。claim 是否仍为当前版本并不存储,而在读取时推导:如果没有后续 claim supersede 它,它就是 active。一条 jq 表达式就能回答,而且规则不会漂移,因为不存在保存同一真相的第 2 个地方。这才是正确的会计类比:更正分录不会回头修改原始分录。
# active claims = those that nothing supersedes
jq '[.[].supersedes] as $dead
    | [.[] | select(.id | IN($dead[]) | not)]' graph/claims.json
请分两步理解:先收集被后续 claim supersede 的每个 ID,再保留 ID 不在列表中的 claim。有一项陷阱值得说明,因为最显眼的 one-liner 是错的:不要把它折叠成在 .[] 上运行的 select(any(.[]; ...))。进入 select 后,当前输入是单条 claim,any(.[]; ...) 会遍历这条 claim 自己的字段并报错。两步写法既避免错误,也更容易阅读。
predicate 是 diagnosed_as,不是 caused_by。 exit code 为 1 的失败测试只证明发生了失败,不证明什么导致失败;后者来自 agent 对输出的解释。因此,claim 只陈述证据能够支持的内容。升级为 caused_by 需要比红色测试更多的证据:失败 assertion、它指向的配置行,最好还有修正时区假设后通过的重新运行。届时追加一条新的 caused_by claim,supersede 当前 claim,并引用两次 run。选择证据真正支持的 predicate,是整套纪律中最小、最容易重复的诚实动作。
source 指向工具,不是 agent。 "kind": "tool_output" 加上 command、exit code、timestamp、line range,会指向模型没有写过的内容:pytest 确实失败,而且这里写明了位置。对比另一种 source:指向 agent 在自己日志里写的一句话。后者满足 invariant 1 的字面要求,实际却指向模型输出,也就是概念 13 的 circular graph 被塞进一个字段。规则是:run log 只有在引用行来自模型外部捕获的输出时,才是 anchor,例如 test runner、compiler、database、API、操作系统。agent 在日志中写的 prose 本身是一条 claim,不能充当该 claim 的证据。
根据概念 8 的 invariant 检查这条 claim:真实 source(invariant 1)、authoring run(invariant 2),以及仍可寻址的被取代 predecessor,因为它从未修改(invariant 4)。invariant 3 会随下方 reviewer 到来。
maker 写入 graph
只需向分诊技能添加一个段落,就能改变 loop 留下的内容。旧技能写着「更新 progress.md」,新技能则写:
## 5. Update the graph last

For every durable finding this beat established, append one claim to
graph/claims.json following the schema in graph/SCHEMA.md. Rules:

- claims.json is APPEND-ONLY. Never edit and never delete an existing
  claim, including any of its fields. To correct a claim, append a new one
  whose "supersedes" names the old id. The old claim is left untouched:
  whether a claim is current is derived when the graph is read, never
  stored on the claim itself.
- Every claim needs a source a later agent could open and verify. Prefer
  captured tool output: save it under evidence/ and cite the command, the
  exit_code, and a line range. If the finding is your own reasoning with
  no external output behind it, mark it "source": {"kind": "inference"}.
- Never cite your own prose in a log as the evidence for your own claim.
- New entities go in entities.json first. Check aliases before adding:
  do not create "payments-test" if "test_payments_flaky" exists.
- Derive each claim id from the run and the finding, never from a counter,
  and check whether that id already exists before appending. A beat that is
  interrupted and rerun must produce the SAME id for the same finding, so
  the retry writes nothing instead of writing a second copy. claim_0007
  reads well on a page. In a loop that can die halfway, use something a
  rerun reproduces exactly, such as
  claim_run_2026-07-21-triage_tz-default.
- Session notes, dead ends, and chatter stay in progress.md. The graph
  is for what was established, not what was said.
最后一条最重要。spine 不会消失,仍是 loop 的日记。graph 则是更小、更严格的记录,只保存日记证明的内容。两份记忆、两套 truth rule,与概念 3 的两张 graph 完全相同。
这项构建险些漏掉 ID 规则,值得理解为什么它不是吹毛求疵。claim_0007 是 counter,而 counter 不记得自己在数什么。一次 beat append claim 后若在 commit 前中断,重新运行时会把同一发现再次 append 为 claim_0008,而且下方 hook 的每项检查都会通过:字段存在、ID 唯一、supersession 可以解析、已经提交的内容没有变化。现在同一个事实以两个 ID 存在,两次 run 都声称自己确立了它;几个月后,duplicate 会以从未真正发生的分歧形式出现。derived ID 从两端堵住漏洞。maker 找到 ID 后会跳过,retry 因此成为 no-op;即使某天 maker 忘记查询,hook 的 unique-ID 规则也会阻止 commit,而不是悄悄把记忆翻倍。retry 能安全重复的写入,区分了能挺过中断的 graph,与会悄悄长出影子副本的 graph。
Harness 会让规则成为现实,因为 guardrail 永远活在 Harness,而不在提示词中。上方多条规则可以机械检查,因此 hook 会检查能检查的内容:
#!/bin/sh
# .git/hooks/pre-commit — the graph gate (jq only, no framework)
C=graph/claims.json
fail() { echo "claims.json: $1 — commit blocked"; exit 1; }

# 1. required fields on every claim
jq -e 'all(.[]; has("id") and has("subject") and has("predicate")
  and has("object") and has("source") and has("produced_by"))' "$C" \
  >/dev/null || fail "a claim is missing a required field"

# 2. ids are unique
[ "$(jq 'length' "$C")" = "$(jq '[.[].id] | unique | length' "$C")" ] \
  || fail "duplicate claim id"

# 3. every supersedes target exists
jq -e --argjson ids "$(jq '[.[].id]' "$C")" \
  'all(.[]; (has("supersedes") | not) or (.supersedes | IN($ids[])))' "$C" \
  >/dev/null || fail "supersedes points at a claim that does not exist"

# 4. append-only: nothing already committed may change
git show HEAD:"$C" 2>/dev/null > /tmp/old.json || exit 0
jq -e --slurpfile new "$C" \
  'all(.[]; . as $o | $new[0] | any(.[]; . == $o))' /tmp/old.json \
  >/dev/null || fail "an existing claim was modified or removed"
请诚实看待 gate 的边界,因为本课不断强调「请求」与「强制规则」的区别。这 4 项检查是真实 guardrail:必需字段、唯一 ID、可解析 supersession、只能追加的历史。hook 不会检查字段类型、subject 是否指向 entities.json 中存在的 entity、source block 是否格式正确,也不会检查引用的 evidence file 与 line range 是否真实存在。需要时,每项都可以再增加一行 jq。在此之前,规则只存在于 SCHEMA.md,因此属于 guidance,不是 guardrail。清楚哪些规则属于哪一类,正是整项区别的意义。
reviewer 从 graph 读取
reviewer 提示词会增加一项义务,裁决也会增加一个字段。这是可运行规模的概念 10:
You are the reviewer. For every factual claim in the maker's report:

1. Find the claim in graph/claims.json that supports it. Cite its id.
2. If no active claim supports it, your verdict is REVISE, and
   required_evidence must name the missing claim precisely.
3. A claim whose source.kind is "inference" cannot by itself ground a
   factual assertion. Either cite a source-backed claim that supports it,
   or return REVISE. An honestly recorded guess is still a guess.
4. Never approve a factual claim on plausibility. "Sounds right" is
   not a citation.

Return only JSON:
{ "verdict": "PASS|REVISE|FAIL",
"grounded_in": ["claim_0007", "claim_0012"],
"missing": [],
"rubric": "reviewer-rubric-v3" }
人们最常漏掉第 3 条,而漏掉它会悄悄推翻整个构建。允许 maker 诚实记录 inference 是正确的:标记的猜测比洗白的猜测更好。但如果 reviewer 只检查引用 claim 是否存在,标记的猜测仍可 ground 已发布的事实陈述,graph 最终还是把它洗白。诚实 inference 与 grounding evidence 是两种不同工作;reviewer 必须分开它们。
rubric 字段就是 invariant 3,grounded_in 则是可审计轨迹。几个月后,可以打开任何已发布 PR,从裁决一路走向 claim,再走向 source。每项重要输出都能追溯到 objective、artifact、source、graph path 与 evaluator decision:这是 PDF 的结尾测试,在 3 个 JSON 文件的规模上通过。
一个 beat,改造前后
之前(只有 spine)。 周二的分诊 beat 修复不稳定支付测试,并写下一句 prose:「修复了不稳定测试,是时区问题。」周四,另一个 changelog loop 提到这项支付修复,reviewer 按 plausibility 批准。3 周后有人问是哪项时区假设,答案只能从 transcript 中考古。
之后(graph)。 周二的 beat 写入上方 claim_0007,引用捕获到 evidence/ 下的 pytest 输出。周四,changelog loop 的 context builder 拉取 test_payments_flaky 周围 2 跳 subgraph:claim、source ref、生成它的 run。reviewer 批准 changelog 条目,因为 grounded_in: ["claim_0007"] 可以解析。3 周后,一条 jq 命令就能给出带凭据的答案:
jq '[.[].supersedes] as $dead
    | .[] | select(.subject == "test_payments_flaky")
          | select(.id | IN($dead[]) | not)' graph/claims.json
loop 相同,模型相同。唯一变化是记忆所在位置,而它改变了之后每个 agent、每个人能够知道的内容。
学完第 5 部分提供的第 2 种视角后,再读一次这项构建。这个小系统同时承载两张 graph。reviewer 到 maker 的关系是 governance edge(一个 observing loop,它对 maker 的 counter-metric 是「每条 claim 都可以解析」)。pre-commit schema hook 是 frozen node:maker 永远不能调整用于检查自己的规则。source block 是 anchor,但只因它指向 command、exit code,以及从 test runner 捕获的输出。若同一字段指向 agent 自己写的一句话,anchor 会消失,schema 却仍然通过。3 个 JSON 文件、1 个 hook、2 个提示词,本课每项思想都以缩小版存在。
在一次性仓库中创建 3 个 JSON 文件,包含 1 项 entity 与 0 条 claim。用上方 graph-writing 技能对一项真实小任务无头运行 maker beat:claude -p 或 opencode run。再用 reviewer 提示词检查 maker 报告。第一次通常会返回 REVISE,并填写 missing,因为 maker 记录得太少。这个失败就是教训:reviewer 刚刚教会 maker,graph 必须包含什么。
第 7 部分:保持 grounded
14. 选择层级,并为它设定预算
请在 配套实验室 中运行:python3 concepts/14-choose-a-level.py。阅读只完成了一半,亲眼看它发生才是另一半。
在提出反对 graph 的理由前,先学习如何选择。按顺序提出 6 个问题,就能决定一项工作真正需要多少结构。每回答一次「否」,都会省下一层。
- 成功可以验证吗? 如果不能,就完全不要从自主性开始。先定义测试、rubric、source 要求或 human decision。这是 loop 课程的第一道 gate,后面的任何东西都无法修复这里缺失的答案
- 步骤稳定吗? 稳定就用 chain;不稳定则需要 planning 或 orchestrator
- subtask 相互独立吗? 独立就并行;不独立则明确建模依赖,并限制同时写入的 worker 数量
- 替代 lineage 必须保持可用吗? 必须就用 DAG,不要强迫每项结果进入同一分支。这是概念 5 的问题
- 事实必须在 run 结束后继续存在吗? 必须就持久保存 artifact 与 graph state。不要依赖 transcript summary 携带它们
- 成本与延迟可以承受吗? 添加 worker 前就设定预算,不要等到账单之后
合在一起回答,就会得到一个层级,而不是一种偏好:
| 情况 | 从这里开始 | 原因 |
|---|---|---|
| 简单、低风险问题 | zero-shot | 延迟最低,无需维护机器 |
| 输出可以检查 | loop | 反复反馈会改善 artifact |
| 顺序稳定 | chain | 阶段可预测、可测试 |
| 类别清楚 | router | 清晰分离 policy 与 model |
| 单元相互独立 | 并行 worker | 缩短墙上时钟时间 |
| 每项任务的拆分方式不同 | orchestrator-worker | 动态专门化 |
| 替代方案必须保持存活 | commit DAG | 保留实验分支 |
| 事实必须跨 session 存在 | knowledge graph | 持久共享记忆 |
| 超大规模并行工作 | Dynamic Workflow | 自动 fan-out 与 fan-in |
注意 graph 是第 8 行,不是第 1 行。大多数工作会更早停止,而早点停止是正确结果,不是缺少雄心。
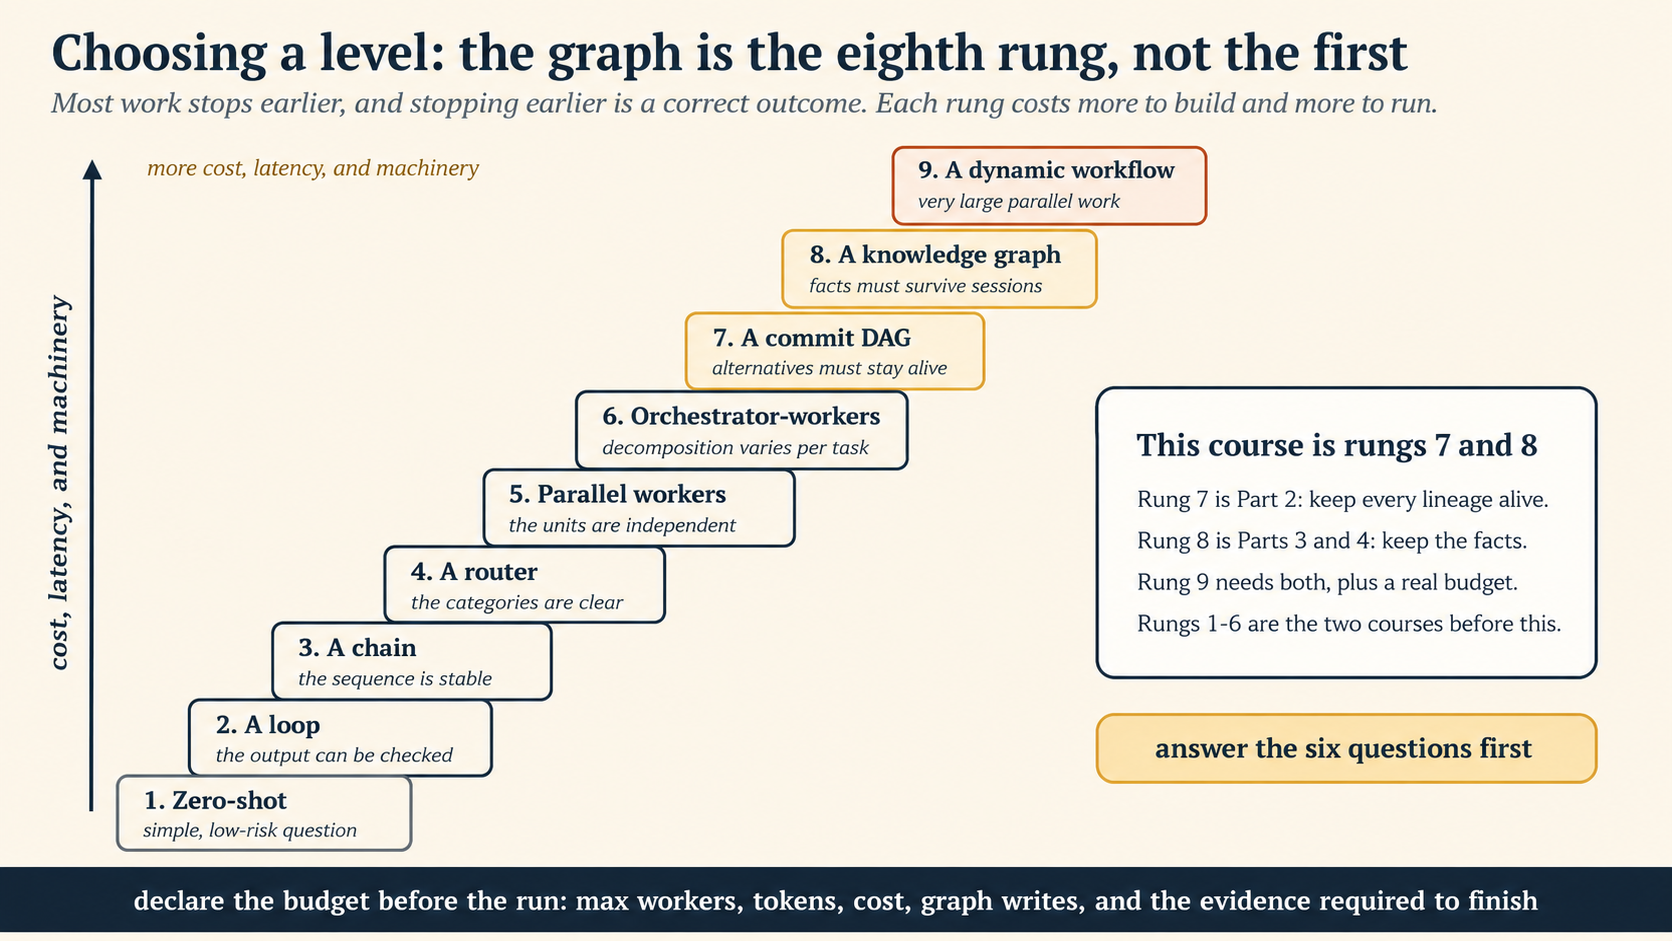
无论选择哪一级,都要在 run 开始前声明复杂度预算。每次 run 应明确写下:最大 model call、最大 sub-agent 数、最大 concurrent worker、最大 tool call、最长墙上时钟时间、最大 token、最大财务成本、最大 retry、最大 graph write,以及称为完成前所需的最低证据。最后一项最常被忘记,却是让其他数字产生意义的部分。
还要规定预算耗尽后怎么办,这比数字本身更重要:返回当前最佳 artifact、已经完成的工作、尚未解决的问题,以及停止原因。不要用流畅 final answer 掩盖部分失败。「token 预算用完,所以我在 60 份文件中的第 40 份停止;这是 40 份文件显示的结果」比一份悄悄只覆盖三分之二工作、却显得自信的报告更有价值。
还要给预算标上数字。这些机器都不是免费的,一门用 14 个概念推荐它的课程有义务交出账单。Anthropic 对多 agent 研究系统的介绍指出,该架构在 breadth-first 工作上显著优于单 agent,但消耗的 token 约为普通聊天交互的 15 倍。交换条件只有一句话:并行广度用 token 换覆盖。因此,形状必须配得上成本。廉价模型负责受限提取、分类、格式化;强模型负责拆分、综合、困难验证;简单请求走短路径;完整 graph 只用于价值足以支撑协调成本的工作。任务确实很宽、分支真正独立、结果值得投入时,100 个 worker 才是正确答案。一个上下文窗口足以容纳整个问题时,它就是错误答案。
预算决定花多少。另一项决定会确定系统在哪里等待;做错后,所有开销都会被浪费,却看起来仍像并行。工作 fan-out 后终将汇聚,但每个阶段都加 barrier 会悄悄把 fan 重新变成 chain。只有下个 node 真正需要完整集合时才等待:跨 source 去重、把所有 candidate 相互排名、比较替代方案,或判断覆盖是否充分。如果每项结果能独立前进,就让它前进。汇聚时,一条失败分支也不能丢掉已经完成的 99 条。收集 settled 结果,记录未完成项,再由下个 node 判断是否足以继续。这就是上方部分失败规则,只是应用于 join,而不是整次 run。决定系统在哪里静止的是 topology,不是 worker 数量。
构建前先问 6 个问题,让答案告诉你最小可用结构。再提前写下限制。一个从未获知何时停止的系统,会在钱耗尽时停止,并把那个时刻描述为成功。
一个团队想要 knowledge graph。他们的答案是:成功可验证、步骤稳定、subtask 独立、替代 lineage 不重要、事实无需在 run 后继续存在。6 个问题会给出哪个层级? 在稳定 chain 上使用并行 worker,不构建 graph。第 4 题为否,所以不需要 DAG;第 5 题为否,所以不需要 knowledge graph。他们想要第 8 行,问题却给出第 5 行。如果仍然构建 graph,就要为 extraction error 与 schema 维护付费,去回答还没有人提出的问题。查看答案
15. 何时不该构建 graph
请在 配套实验室 中运行:python3 concepts/14-choose-a-level.py。阅读只完成了一半,亲眼看它发生才是另一半。
概念 14 提供步骤,本概念则按照本书诚实评分的传统,提出反对这个层级的理由——尽管本课已经花 14 个概念介绍它。不要只因系统包含 agent 就引入 knowledge graph。 graph 是有真实账单的机器:extraction error、resolution risk、schema maintenance,以及一种可能悄悄腐烂的新东西。以下情况请跳过:
- 任务彼此独立,不需要跨 session state
- 答案每次只来自一份文档
- relation 固定而简单,关系表已经能回答真正提出的所有查询
- 不需要 provenance
- extraction error 会超过 traversal value
当 connected query、不断变化的 relation、provenance 或 shared world state 成为核心时,graph 才能挣得成本。一个带 spine 的 loop 不需要 graph。两个 loop 开始交换事实,或 20 个 worker 需要综合时,天平才会倾斜。第 6 部分刻意构建了刚好过线的最小版本。
对确实构建的 graph,还要防范两种失败:
graph 会放大构建者判断,包括错误判断。 loop 放大 objective 与 evaluator,你已经两次学到这项教训。graph 放大的是 ontology 与 source policy。选择错误 entity type、接纳错误 source,自动化就会扩大错误:带偏见的 corpus 生成带偏见的 graph,并在每个方向上自信回答。graph 检查 claim,不会把它洗成真相。
这里的指标同样可以被博弈。 只针对 entity recall 优化的 extraction pipeline 会乐于淹没 graph。只针对 compression 优化的 resolution step 会合并陌生人(概念 7 的陷阱)。每项优化都需要 counter-metric:precision 对 recall,compression 对 false merge。这就是 Goodhart's law,下一门课会详细研究。
对确实构建的 graph,还要持续执行概念 13 的审计:随机选择 10 条 claim,一路跟随到 leaf,统计多少最终落在现实,而不是另一份模型报告上。没有 anchor 的 memory graph,就是第 5 部分的 circular graph 被重建在 JSON 中。
graph 是管理事实的官僚系统。良好的官僚系统让一切可找到、可审计;糟糕的系统会给传言盖上官方印章,再漂亮归档。印章不是真相,档案底部的凭据才是。请检查凭据,而且只有事实堆确实大到 notebook 无法容纳时,才构建这套官僚系统。
16. graph 做不到什么,接下来走向哪里
请在 配套实验室 中运行:bash concepts/16-limits.sh。阅读只完成了一半,亲眼看它发生才是另一半。
最后用 3 条 graph 无法替你作出的陈述,划出诚实边界:
「checker 的 PASS 现在值得信任。」 不。grounding 把裁决从印象升级为审计,但 auditor 仍是模型:可能引用不支持 claim 的 edge、漏掉存在的路径,也会在底层模型更新后漂移。流畅回答引用无关 edge 是有记录的失败,不是理论猜测。测量 checker、golden set、calibration、pass rate、drift,属于下一门课:信赖 Checker。其中每项内容在这里都要应用两次,因为 graph 系统有两个可检查层:填充记忆的 extraction,以及读取记忆的 reviewer。它的 eval Harness 甚至会看起来很熟悉:读取 extraction prompt 与 score history,提出一项修改,用 gold set 运行,保留或恢复。ratchet,只是指向 graph 本身。
「记忆在当前位置很安全。」 它只与所在的家一样安全。笔记本仓库中的 graph 会随笔记本一起消失。swarm 的共享记忆必须位于每个 worker(本地、计划任务、云端)都能访问的地方,还要抵抗机器故障,并强制谁能写什么。autoresearch 在一台 GPU 上运行,恰恰因为受限才安全。AgentHub 是一台 server 上的一个 Go binary,恰恰因为它只是一张草图。把已经证明有效的 loop 及其 graph 移到无需你看守的 runtime,属于后面第 2 门课:离开笔记本。
「更好的接线意味着更好的判断。」 本书最古老的边界没有移动。graph 把记忆与评价放到上下文窗口之外,这是真正的进步,也是本课最重要的洞见:瓶颈通常不在下一次模型调用,而在记忆与评价放在哪里。 但 ontology、source policy、anchor,以及「什么叫更好」的答案,都来自每张 graph 外部,来自你。Karpathy 的 README 开玩笑说「自主 AI agent swarm 在天空中的计算集群巨型结构上运行」。近期工作没那么戏剧化,却更有价值:typed contract、保留 lineage、grounded claim,以及比 session 活得更久的记忆。第一门课概念 1 的意图与责任,仍是任何 node 与 edge 排列都无法容纳的两件事。
graph 把记忆与检查从 agent 头脑中移出,这是真正的收益:1000 个 agent 可以共同解决一个问题,而不必每个都从零开始。但 graph 无法决定记忆用于什么。必须有人选择哪些内容值得记住、哪些 source 算证据、什么叫「更好」。这个人就是你,再多接线也不会取消这项工作。
本书会这样接过线索:用普通语言描述一套共享 graph 的 loop 系统,它就会变成一个组织——工作者共享档案系统,reviewer 要求凭据,owner 设定规则。这就是 Human-Agent Teams 速成课。一张良好构建的 loop graph 在组织结构图中赢得名字后,就会成为拥有机构记忆的 Digital FTE。
在本书中使用 graph(dogfooding)
本书是否实践了本课的主张?诚实回答:它运行 proto-graph,并有意不运行完整版本。
请用本课视角观察 loop 课程 dogfooding 部分的 feedback loop。每条读者反馈都是数据库中的一项记录,反馈链接到它打开的 GitHub issue,issue 链接到修复它的 Pull Request,PR 链接到修改的课文与批准发布的人。typed record、directed link、端到端 provenance:任何已发布修复都能一路走回导致它的读者反馈。除了没有画图,它在各方面都是 graph。因此,同一条反馈永远不会处理两次:loop 查询 link,而不是重读历史。
本书没有对自身内容运行由模型驱动 extraction 与 entity resolution 的 knowledge graph。这是把概念 15 用在自己身上。本书的跨 session 问题仍能通过 issue link 与 Git history 回答,relation 很简单,extraction pipeline 只会增加错误 surface,却没有查询需要它。某天出现 link 无法回答的问题时,最可能的第一问是:「哪些课程依据后来已经改变的文档提出 claim?」第 6 部分模式已经作为预案保存。真实查询挣得成本时再构建 graph,不要提前一周。
🚀 项目
阅读 graph 与亲手填充 graph 并不相同。下方是 8 项构建任务,由易到难。可以使用任一工具:graph 就是文件与 jq,只有无头命令不同(claude -p 或 opencode run)。
每次开始前都遵守两条规则:
- 使用一次性仓库与真实文档。 只有 entity 是你真正认识的对象时,graph 才有意思。请使用自己的 README、笔记或日志,不要发明数据
- 第一条 claim 之前先写 schema。 一份 5 分钟写出的
graph/SCHEMA.md,胜过日后根据文件碰巧包含的内容重建 schema(第 6 部分)
Project 110-15 分钟画出自己的系统找到会死在 transcript 中的发现,以及没人审计的数字。
难度:简单 · 使用:概念 2、3、11(node 与 edge、两张 graph、接线)。
构建。 在纸上或 Mermaid 中,把当前运行的每个 loop、checker、human gate、anchor 与记忆文件画成 typed node,再用带标签的 directed edge 连接。标出哪些 node 是 loop,哪些不是。然后圈出两项内容:目前只存在于 transcript 中的任何发现,以及任何没有 watcher 观察数字的优化型 loop。
**完成标准:**可以分别指出一种被圈出的内容,并说明它的代价。几乎没人会画完后什么都找不到,这正是构建任何东西前先画图的原因。
Project 230-45 分钟从 spine 到 claim把 10 项真实发现变成 typed record,并遇见那些无法注明 source 的内容。
难度:简单 · 使用:概念 1、8 与第 6 部分(provenance、schema)。
构建。 取出真实 progress.md(或任一 loop 的日志),把最近 10 项持久发现转成符合第 6 部分 schema 的 claims.json 记录。填写 invariant 要求的全部字段,包括 produced_by 与真实 source。
**完成标准:**10 条记录都引用后续 agent 可以打开的内容,或明确标记为 "source": {"kind": "inference"}。统计 inference 数量。 这个数字说明过去有多少内容只因模型表达流畅而被当作事实,也是本课能提供的最有用系统指标。
Project 345-60 分钟第一次提取在 3 份文档上运行受 schema 约束的提示词,并遇见自己的 duplicate。
难度:中等 · 使用:概念 6(提取)。
构建。 在 3 份相关文档上无头运行概念 6 提示词:同一项目的 3 份 README、3 份会议笔记或 3 份 incident report。相信回复前,先用 jq 校验。然后统计多少不同 entity 以多种 surface form 出现。
**完成标准:**3 份文档都返回符合 schema 的 JSON,而且可以指出至少一项用两个以上名称出现的 entity。如果数量为 0,说明文档过于相似;请使用由不同人编写的 3 份文档,resolution 才会成为真实问题,而不是假设。
Project 430-45 分钟DAG 开口说话只用 Git 回答 AgentHub 的 3 个问题,再把命令留给未来 agent。
难度:中等 · 使用:概念 4、5(两份记忆、遍历)。
构建。 在拥有真实历史的仓库中,用普通 Git 回答 AgentHub 的 3 个问题:commit X 之上尝试过什么?哪些 tip 属于尚未探索的 frontier?哪条 path 产生当前 state?再把 3 条命令写入 GRAPH.md,让未来 agent 也能查询。
**完成标准:**3 条命令都能运行,而且能说明 DAG 无法告诉你的内容:哪些实验曾被尝试后丢弃。请在自己的仓库中亲自感受概念 4 的纠正,而不是只在文字中阅读。
Project 545-60 分钟resolution 练习合并该合并的,分开该分开的,并保留每份凭据。
难度:中等 · 使用:概念 7(resolution)。
构建。 从项目 3 取出 20 种 surface form,按类型分组并带上 description,要求更强模型给出 canonical cluster,为每组提供 rationale 与 confidence,并保留全部 alias。然后埋下陷阱:添加两个同名但确实不同的 entity,再运行一次。
**完成标准:**真正 duplicate 已合并,两个同名陌生人保持分开,每项 canonical entity 仍列出来源 surface form。如果陌生人被合并,不要先修 resolution prompt;请返回并丰富 description,因为证据必须从那里来。
Project 61-2 小时,另加 5 个 beatgrounded reviewer让 checker 要求 edge,而不是提供意见。
难度:困难 · 使用:概念 10 与第 6 部分(grounding、reviewer)。
构建。 把第 6 部分的 reviewer 接入一个现有 loop。裁决必须带 grounded_in,其中包含可解析 claim ID;事实陈述没有支持 claim 时,必须返回 REVISE 并填写 missing;source 为 inference 的 claim 不能单独 ground 任何内容。运行 5 个真实 beat。
**完成标准:**至少一次 beat 返回 REVISE 并指出一条缺失 edge,maker 下次尝试时要么提供证据,要么撤回 claim。之后一起阅读 5 份裁决:maker 学会记录的内容,才是项目真正输出。
Project 72-3 小时提取的 gold set提前一门课,测量填充记忆的 pipeline。
难度:困难 · 使用:概念 6、7 与下一门课。
构建。 手工标注 5 份文档中的 entity 与 relation。这部分很繁琐,而且无法绕过。然后用标签评价项目 3 的提示词:precision、recall、schema-valid rate。只修改提示词的一行,重新评分,再依据数字保留或 revert。
**完成标准:**对提示词本身至少运行 3 次 ratchet,并保存所有尝试记录,包括 revert 的尝试。你刚刚构建了 graph autoresearch:同一个 loop,不同 artifact。信赖 Checker 会把它变成完整纪律。
Project 8综合项目:一个周末,再加一周 beat两个 loop,一张 graph让一个 loop 报告从未亲眼见过的修复,因为 graph 告诉了它。
难度:综合项目 · 使用:全部内容。
构建。 两个 loop 共用一张 graph。分诊 loop 写入 claim,并附真实 tool-output source。changelog loop 通过 2-hop context builder 读取,而不是整体倾倒文件。两个 reviewer 都 ground 自己的裁决。pre-commit hook 保护 schema 与只追加规则。分诊 loop 的 throughput 数字还要配一项由 review loop 观察的 counter-metric(概念 12)。
**完成标准:**changelog loop 能正确报告自己从未亲眼见过的修复,因为 graph 携带了它,并且可以从 changelog 行一路走过 claim、run 与捕获的 tool output,最终到达模型没有写过的内容。走通这条路径,就已经构建带 anchor 的共享记忆,本课也没有更多内容需要教你。
来源与延伸阅读
本书内容
- Loop Engineering:ratchet、spine、maker-checker 分工、dreaming loop、two-routine gate。第 5 部分每条 governance edge 都先在那里逐个 loop 构建
- Harness Engineering:typed output 与 reversibility 纪律,在这里提升到记忆规模
- 信赖 Checker:下一门课,讲解如何知道 grounded reviewer 与 extraction pipeline 是否优秀
- 离开笔记本:笔记本合上后,graph 与 loop 去哪里生活
- Human-Agent Teams:loop graph 在组织结构图中会变成什么
一手来源
- Andrej Karpathy,autoresearch(2026 年 3 月 7 日发布):https://github.com/karpathy/autoresearch。3 文件 Harness、ratchet 与公布结果。引用 loop 前请先阅读
program.md本身:它是概念 4「两份记忆」纠正的来源,明确规定实验在专用分支上运行、分支只在改善时推进、相同或更差的结果通过git reset删除、results.tsv记录每次尝试并有意不受 Git 跟踪。也就是 3 文件 Harness、ratchet loop 与 commit-DAG memory。本课 star 与实验数字反映最初几周,请检查实时仓库 - Andrej Karpathy,AgentHub(约于 2026 年 3 月 9–10 日发布,已不再公开):agent-first 协作层,包含 bare Git 仓库、SQLite、message board,以及
children/leaves/lineageCLI。项目明确写着「只是一份草图,还在思考……」。原仓库几周内转为私有,而且没有 license 文件。如今只能通过社区保存的 fork 阅读代码:请当作历史研究资料,不要依赖。autoresearch 仓库中的 AgentHub integration thread 仍然公开,也是更好的 primary reference。关于仓库消失,请参阅一名提前 fork 的开发者当时撰写的说明:https://dev.to/alireza_rezvani/karpathys-agent-native-infrastructure-working-python-agent-template-2o9d(2026 年 3 月) - Anthropic,Knowledge Graph Construction with Claude(Cookbook,2026 年 3 月 23 日):https://platform.claude.com/cookbook/capabilities-knowledge-graph-guide。使用 Haiku structured output 提取,把 resolution 作为 Sonnet 推理任务,用 NetworkX assembly,并以引用查询 subgraph。第 3 部分的来源
- Erik Schluntz 与 Barry Zhang,Building Effective Agents(Anthropic Engineering,2024 年 12 月):概念 10 完成 grounding 的 5 种可组合 workflow pattern
- Anthropic,How we built our multi-agent research system(Anthropic Engineering,2025):https://www.anthropic.com/engineering/multi-agent-research-system。orchestrator-worker 研究架构、它相对单 agent 的 breadth-first 优势,以及概念 14 预算注释引用的约 15 倍 token 成本。这个倍数比较的是普通聊天交互,不是同一任务的单 agent run,而读者通常会默认后者。引用数字前请检查实时文章
- Anthropic,Introducing dynamic workflows in Claude Code(2026 年 5 月 28 日;页面现在带有正式开放的更新):https://claude.com/blog/introducing-dynamic-workflows-in-claude-code。第 2 部分深入注释的来源:生成编排、数十至数百个并行 fresh-context sub-agent、经过检查的结果、可恢复进度、
ultracode设置、token 警告与 Bun 移植。适用于所有付费方案的 Claude Code CLI、Desktop 与 IDE extension(Pro 用户可在/config的 Dynamic workflows 行开启),以及 Anthropic API、Amazon Bedrock、Google Cloud Agent Platform、Microsoft Foundry。真实限制位于 reference 文档,而不是公告:16 个并发 agent,每次 run 总计 1000 个。reference 文档:code.claude.com/docs/en/workflows - Peter Steinberger 于 2026 年 7 月 18 日在 X 发布的帖子(「Are we still talking loops or did we shift to graphs yet?」;x.com/steipete/status/2078277297791189132,00:34 UTC):为当季命名的 12 个词。讣告不是 Steinberger 写的。约 4.5 小时后,Hamel Husain 发布 《Loop Engineering Is Dead. Enter Graph Engineering》,Santiago Valdarrama(@svpino)则发布广为引用的 「Loop Engineering is dead. Long live Graph Engineering!」。二者都像在调侃名称跑步机
- Carlos E. Perez(Intuition Machine),《From Loop Engineering to Graph Engineering?》(2026 年 7 月 19 日):第 5 部分的来源,包括支持 bot 故事、单 loop 的 4 种失败及结构化修复、circular-graph 警告、anchor、frozen node,以及 grounded 与 ungrounded 结论。https://medium.com/intuitionmachine/from-loop-engineering-to-graph-engineering-d3ebeb08511c
- 《Graph Engineering: The Karpathy Loop, Improved 1000x by Itself》(独立综合 PDF,2026 年 7 月):分阶段构建路径、两张 graph 的区别、4 个 invariant,以及结尾 traceability test。首页明确声明未与 Karpathy 或 Anthropic 建立关联,也未获二者背书。请把它当作有用学习笔记,并优先阅读其中一手来源
- Fortune 对 autoresearch(「Karpathy Loop」)的报道,2026 年 3 月
- TechCrunch 等媒体对 Karpathy 于 2026 年 5 月 19 日加入 Anthropic 预训练团队的报道;他的任务是建立一支使用 Claude 加速预训练研究的团队:https://techcrunch.com/2026/05/19/openai-co-founder-andrej-karpathy-joins-anthropics-pre-training-team/
所有链接截至 2026 年 7 月下旬有效。每个仓库、preview feature 与数字都变化很快,依赖前请依据实时来源确认。
一句话小结
agent 会忘记,graph 不会。保留两张 memory graph:用 DAG 记录工作,用 knowledge graph 记录事实;按 schema 填充后者,以可逆方式合并名称,为每条 edge 钉上凭据,向 worker 提供 subgraph 而不是整体倾倒,并让每个 checker 引用或要求 edge。再连接 loop 本身:每个优化数字都配 watcher,更慢的 loop 拥有每个目标,gate 位于 node 之间,还有任何 loop 都无法争辩的 anchor。graph 存储 claim,不存储真相;grounded 与 ungrounded,才是比每次更名都活得更久的轴线。