设计智能体体验
人类在这里学会信任自主行动的机器
你已经在本书中不断构建真正执行工作的机器:通用智能体、数字全职员工,以及能够自行招募同事的智能体劳动力。本课关注那层纤薄却关键的接触面:人在这里遇见机器,并决定是否信任它。
这层接触面已不再只是一块屏幕。软件只能响应命令时,设计意味着排列按钮,让人类驾驶。软件开始自主行动后,人类不再驾驶,而是在委派。委派是一段关系,不是一笔交易。
因此,这门学科也改变了名称。我们不再设计由人操作的界面,而是设计由人监督的伙伴关系。这门手艺不再是“让按钮容易找到”,而是“让机器的判断可理解、自主程度可调整、错误可挽回”。这正是本课所教的内容。
智能体产品同时服务两类用户:必须信任它的人类和必须解析它的其他智能体。你的工作是设计一个同时服务双方、又不辜负任何一方的接触面。
你将构建什么。课程结束时,你会为本书前面出现过的一个数字全职员工起草一份“智能体体验简报”:面向人类的信任界面、面向智能体的机器界面、自主程度阶梯和恢复计划。无需编写新代码;你要指导智能体生成简报,就像人类—智能体团队指导它生成运营文档一样。附录 C 提供可填写的空白模板。在实践实验中,你还会发布第一个 MCP App:一个可用的退款审批组件,由配备官方 create-mcp-app 技能的编程智能体(Claude Code 或 OpenCode)构建。概念部分还贯穿一条无须构建的读者路径,供需要指导工作而非亲自实现的领导者和设计师使用。
课程包含四个部分、十八个概念:转变、人类界面、机器界面和新手艺。阅读约需两小时;完成结课简报需要一个晚上;读者路径需要专注的一小时。完整示例之后的实践实验会把第三部分变成可运行代码:你会像在本书其他地方一样,通过指导编程智能体构建并发布第一个 MCP App。末尾的参考附录说明 MCP Apps 的构造,并比较 MCP Apps 与 OpenAI Apps SDK。
本课会反复使用少量技术术语。这里先用简单语言解释一次,避免它们在后面妨碍理解:
- 智能体:为了实现你给出的目标而自主采取行动的软件,而不只是回答问题。
- 工作者/数字全职员工:本书对承担真实岗位的智能体的称呼,例如由软件构成的客户支持员工。
- MCP(模型上下文协议):让智能体发现并调用工具的开放标准,是智能体与软件之间的通用插头。
- 连接器/MCP 服务器:插头本身,也就是向智能体公开产品能力的软件。
- 人在回路中:智能体必须等待人的批准才能行动。
- 人在回路上:智能体自主行动,人类在旁监督并可介入。
- 幂等:可以安全重复;执行两次与执行一次效果相同,所以重试退款不会支付两次。
- 来源信息:信息实际来自哪里,即智能体真正读取的文件、页面或来源。
- 限定范围且可撤销的凭证:只开启必要权限、并可随时收回的钥匙。
- 升级处理:智能体不应独自决策时,停止并把任务交给人类的时刻。
📚 教学辅助资料
查看完整演示文稿 — 设计智能体体验
第一部分 · 转变
简而言之:软件开始自主行动后发生了什么变化,设计为什么必须随之改变。
概念 1 · 第三种范式:你不再设计“如何做”
计算机与人交流经历过三种方式。在批处理计算中,你预先指定完整工作流,然后等待。在命令式计算中,例如桌面、网页和应用,你逐步驾驶机器;知道如何达到目标的负担完全落在你身上。每一次点击、每一个菜单和表单,都是你必须知道要执行的步骤。
第三种范式的差异在性质,而不只在程度。你说明结果,智能体选择步骤。“如何做”的负担从人类转移到机器。正因如此,智能体软件让人感觉像直接传送到目标,而不是徒步穿过障碍场。
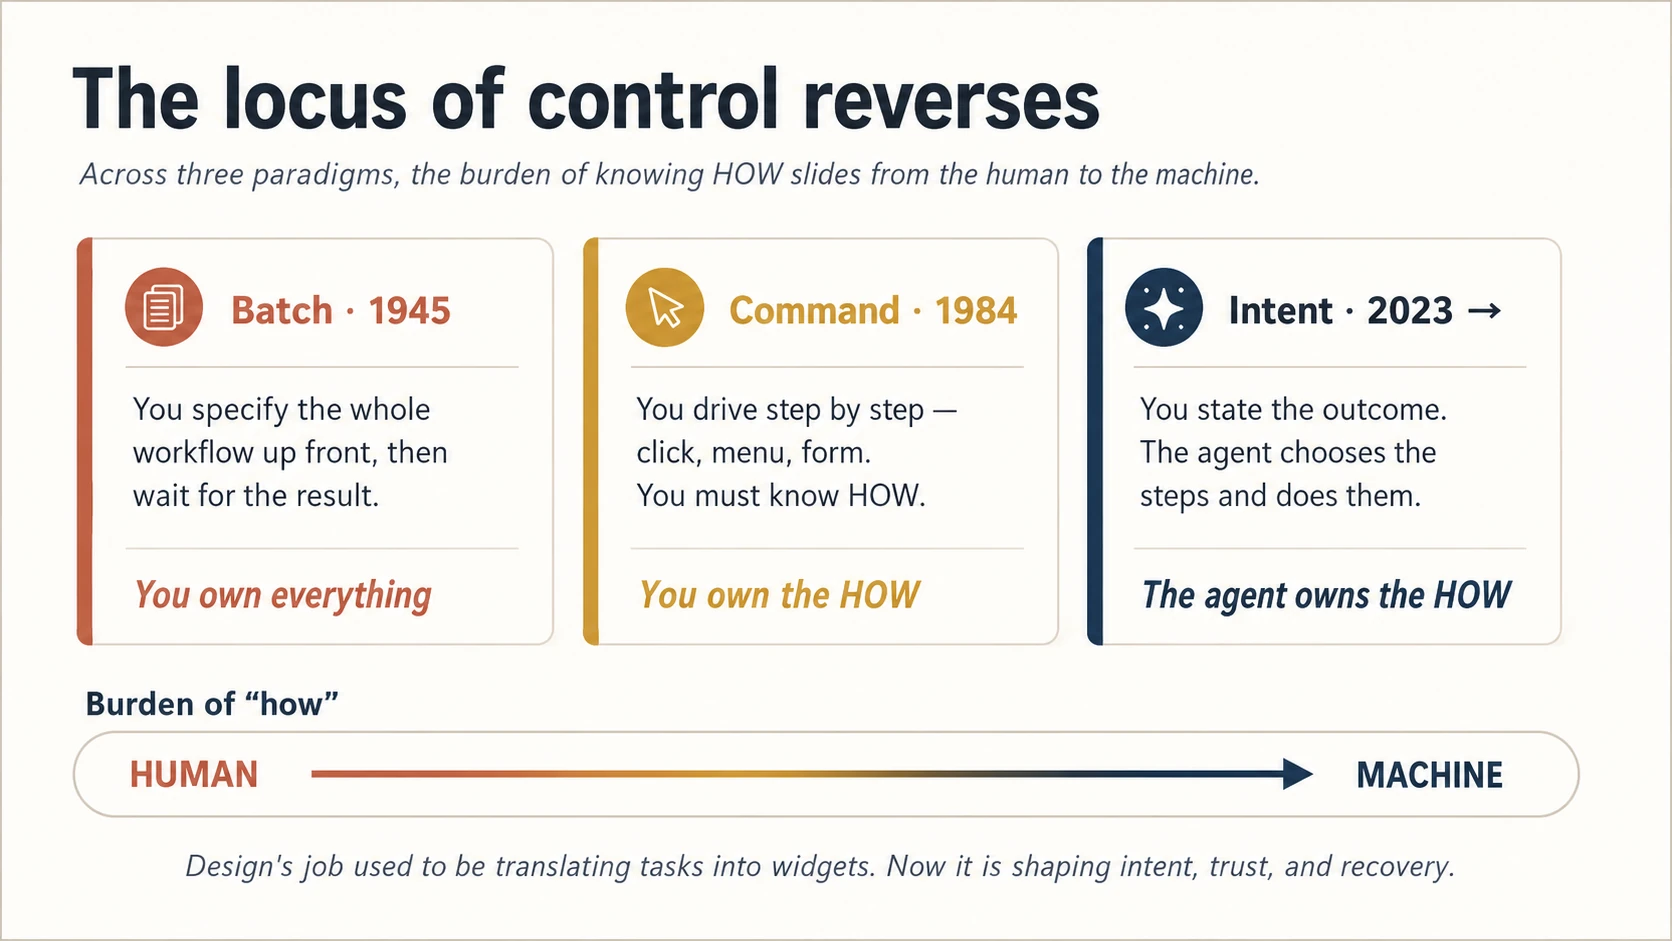
图 1:控制中心发生逆转。机器接管“如何做”后,设计师的工作移到上游:意图、信任和恢复。
本课其他所有概念都源于这一逆转。不再设计步骤时,你改为设计三件事:人如何表达意图,如何信任自己没有选择的步骤,以及机器选错时如何恢复。记住意图、信任和恢复这三个词,它们就是整门课的缩影。
概念 2 · 两类受众,一个系统
这是多数团队遗漏的观念,也值得尽早提出,因为第三部分的大部分内容都依赖它。
你的智能体产品同时被两类用户使用。一类是人,他们需要理解并信任正在发生的事。另一类是其他智能体:调用你的服务、读取你的数据并代表某个人行动的智能体。它们也是用户,只是读取结构而非像素。想象本课后面出现的退款工作者:人类看到一句简单的话(已退还 38 美元,要撤销吗?),支付服务商的智能体看到一个有类型、可安全重试的幂等工具调用。一个动作,两种界面,两者都必须正确。
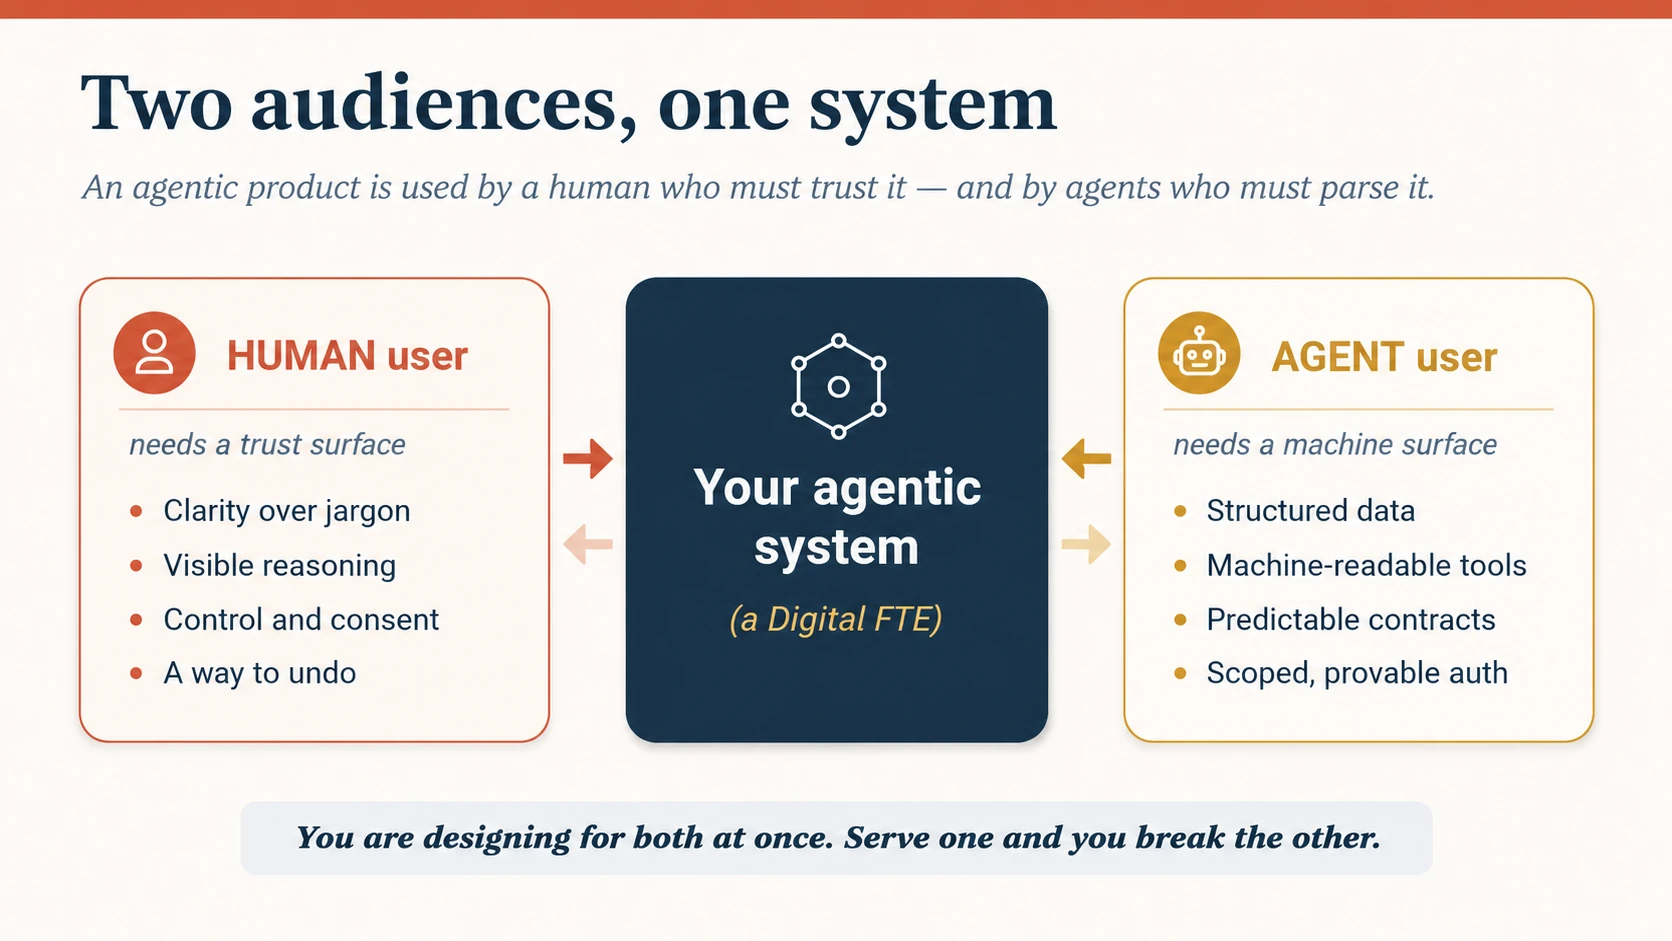
图 2:两类受众,一个系统。左侧界面用于建立信任;右侧界面用于机器解析。优秀产品会有意识地设计两者。
行业用同一个容易混淆的缩写 AX 指代图中的两个部分,最好现在就理清,以后不再混淆:
| 术语 | 提出者 | 含义 | 本课称呼 |
|---|---|---|---|
| 智能体式体验 | John Maeda | 人类把任务委派给智能体时的体验 | 人类界面(第二部分) |
| 智能体体验 | Matt Biilmann(Netlify) | 智能体作为产品用户时的体验 | 机器界面(第三部分) |
两者都是真实的设计工作。大多数课程只教第一种;本课同时教授两种,因为发布的数字全职员工会被人类和周围的智能体共同使用。如果在不可解析的机器界面上覆盖漂亮的人类界面,另一个智能体一尝试使用,整个系统就会失败。
概念 3 · 界面不会消失,只会转移
你会听到严肃人士提出一个强烈观点:智能体意味着界面设计的终结。用户不再访问屏幕,智能体会替他们浏览、点击和决定,精心设计的界面成为负担。这个观点值得认真对待,因为提出它的人帮助创建了这个领域。
但请观察风险升高时真正发生的事。地图应用推荐路线,你仍会看一眼。风险越高,人越想核实,而不是越少。每个自主智能体都会悄然创造三个过去不存在的新界面:
- 配置界面:如何教会智能体不断变化的偏好?
- 监控界面:如何了解它正在做什么,又不被信息淹没?
- 干预界面:出现问题时,如何介入并修正?
因此,诚实的立场位于中间。界面不会消失,它的重心会移动:不再是“把任务翻译成组件”,而是“塑造一个意图系统”。你不再绘制屏幕,而是设计委派关系的管道:智能体可以做什么、如何展示工作、人类如何夺回方向盘。本课其余内容就是这套管道。
第二部分 · 人类界面:为信任而设计
简而言之:如何设计人类看到的产品一面,让他们能够信任智能体、引导它,并修复错误。
概念 4 · 信任必须赢得,不能假定
委派依赖信任,而信任是智能体产品中最稀缺的资源。一个人把决策交出去,然后向后靠。这种放手就是全部价值,也是全部风险。机器只要在重要事情上背叛一次,人就会收回决策,再也不交出去。
你无法直接设计信任,只能设计它的输入条件,信任则逐渐累积:
信任 = 随时间证明的可靠性 × 可核实的透明度 × 能感受到的控制 × 可以撤销的错误。
这是乘积,不是加总:任何一项为零,整体就为零。可靠却像黑箱的智能体得不到信任;透明却无法引导的智能体得不到信任;可以引导却无法撤销的智能体也得不到信任。第二部分接下来会说明如何提高这四项。第一步最谦逊:**让智能体公开表达不确定性。**隐藏怀疑并自信犯错的智能体,比坦白“这部分我不确定,请检查”的智能体更能摧毁信任。
相反的失败同样真实:过度信任。智能体连续正确一百次后,人就不再检查,也察觉不到它悄然偏离。这是自动化自满,优秀设计同样会防范:即使置信度通常很高,也持续展示不确定性;真正高风险的工作永远不能升到完全自主(概念 8);在智能体队伍层面暴露偏离(概念 12)。真正目标是校准后的信任,既不过少也不过多,而非最大信任。
概念 5 · 初次接触:引导、冷启动信任和人人可用
概念 4 说信任要“随时间证明”。但第一天还没有时间:没有记录,也没有任何证明。智能体尚未赢得东西时如何获得信任?每当能力跃升,例如从回答问题变成采取行动,人的预期也必须重置;否则会用对待旧能力的信任程度对待新能力,两个方向都可能出错。
三种做法让初次接触保持诚实:
- 每次能力跃升都重置预期。界面获得行动能力时,直白说明:“我现在可以替你完成这件事,而不只是告诉你怎么做。它意味着这些变化。”最危险的时刻是能力已经改变,心智模型却没有改变。
- **通过降低风险借来信任。**你不能声称尚未证明的可靠性,所以要用另一种方式获得信任:从最低自主级别开始,行动前展示计划,让第一项任务规模小且易于撤销。第一天的信任来自让最初错误代价低,而不是承诺永不犯错。
- 坦白自己还很新。“我以前没有和你一起做过这件事,所以开始时会更频繁地请你确认。”初期经过校准的谦逊,才能让自主程度随后提高。
这些做法下还有一项基础要求:界面必须适合所有人。Nielsen 关于智能体会终结无障碍的挑衅是一项警告,不是预言。智能体可以扩大可访问性:用日常语言说明目标比穿过密集界面容易,也能帮助从不适应旧屏幕的人。不过,这只有在信任界面本身可访问时才成立:计划、置信信号、撤销和联系真人的路径,都必须能在没有视觉、没有鼠标或使用第二语言时工作。这里还有一个隐性好处:第三部分中结构化、有标签、有语义的机器界面,正是辅助技术读取的结构。为智能体用户设计和为残障用户设计方向一致;做好一方,另一方的大部分工作也已完成。
把要求写具体。以网络无障碍标准 WCAG 2.2 为底线,再加入智能体界面特别需要的标准,并把它们写成可测试的验收条件,而不是良好愿望:
- 状态和进度会由屏幕阅读器播报,而不只通过动画表达。
- 计划、撤销和联系真人的路径可用键盘到达,无需层层导航。
- 置信度和不确定性绝不能只靠颜色传达。
- 人可以暂停、继续或取消长时间任务。
- 通知的数量和强度可以调整,避免压垮容易受影响的人。
- 每段说明都提供日常语言版本。
把这些要求对应到概念 7 的透明层,就不再抽象:第一层的结果必须被屏幕阅读器播报,不只是显示;第三层的置信信号必须脱离颜色仍然有效;第四层的证据必须可用键盘访问。如果一个标准无法对应具体层级或控件,它只是意愿,不是要求。
概念 6 · 重新分配负担,并展示谁承担什么
智能体最深层的承诺是减轻人的负担。负担有三类:分析和决策的认知负担,起草和创造的创意负担,以及步骤和协调的事务负担。构建数字全职员工时,你在决定机器现在承担哪一部分。
设计错误在于悄悄转移负担。分工不可见时,就会产生实践者所称的智能体淤泥:人无法判断智能体做了什么、自己还欠什么,于是“为了保险”重做一遍,承诺节省的时间全部消失。
解决方法是一条规则:分工必须可见且可调整。人随时都应看见“这是我处理的,这是你处理的,这是正在等你的”,并能移动边界。它是人类—智能体团队中队伍名单和角色卡的界面表达:运营模型规定谁做什么,这个界面把它展示出来。
人类—智能体团队中的两个词会反复出现:工作者的角色卡是一页岗位规范,说明它做什么、输入和限制是什么,以及如何检查输出;队伍名单列出团队中的工作者和各自用途。本课设计这些文档的界面,即使没学另一门课也能继续;另一门课只是构建运营模型本身的地方。
概念 7 · 渐进式透明:推理可见,但不压倒人
透明度有一个陷阱。什么都不显示,智能体会成为无人信任的黑箱;显示一切,包括每个推理片段和工具调用,又会把人埋进无法使用的噪声。两个极端都会摧毁信任。答案是渐进式透明:默认显示结果,让人按自己的需要逐层深入推理。
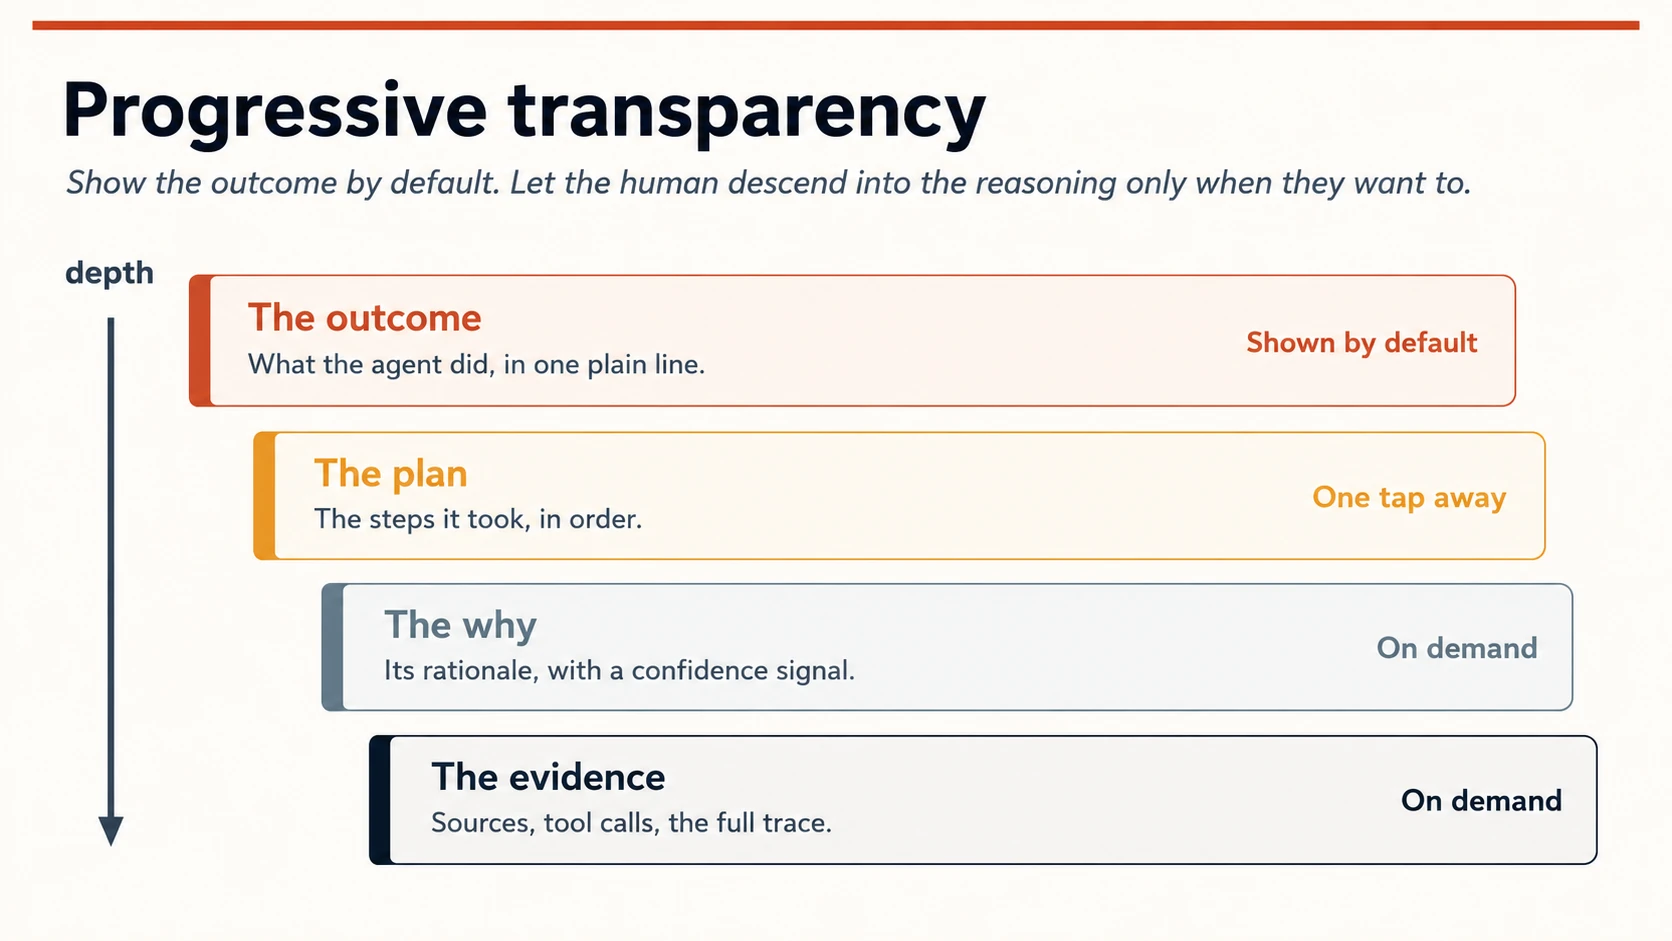
图 3:渐进式透明。默认视图是一句诚实的话;更深内容永远只需再点一次,但绝不强迫读者查看。
四个层级,每层比前一层深入一步:
- 结果:用一句日常语言说明智能体做了什么。多数人在多数时候只读这一层。
- 计划:按顺序列出步骤,供想核实工作形状的人查看。
- 原因:说明理由并附上诚实的置信信号。不要使用虚假的精确百分比,而要使用智能体真正表达的“高/低/不确定”。“73%”暗示模型并不具备的校准,“不确定”反而诚实。
- 证据:来源、工具调用和完整轨迹,供审计、调试以及怀疑结果时使用。
几个小而具体的元素会承担主要工作:来源标签(“基于你的 3 个文件”)、标出不稳部分的不确定性标记,以及轨迹链接。你不是在解释模型数学,而是在回答人的真实问题:我是否应该相信它?如果不信,先看哪里?
概念 8 · 自主程度旋钮:逐步增长的许可
自主不是从“关闭”切到“全部完成”的开关,而是一个旋钮,应该由人掌握,而不是由你掌握。发布时把它调低,智能体证明自己后再逐步提高,就像管理者在新员工赢得信任后给予更大空间。
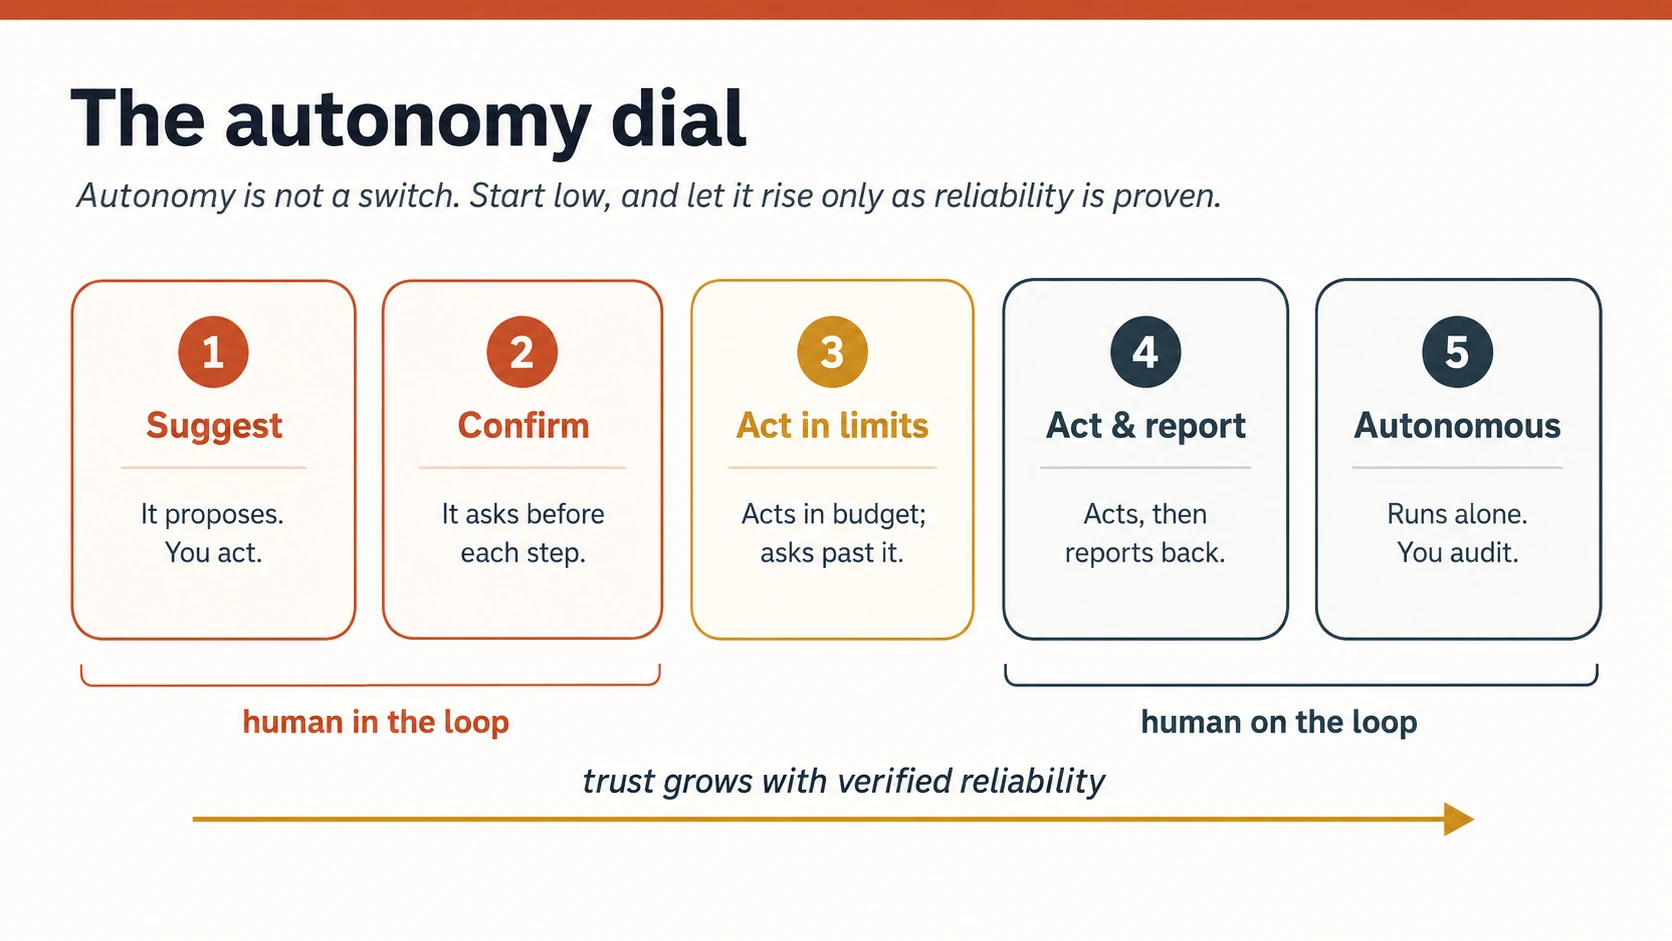
图 4:自主程度旋钮。两种机制:人在回路中,智能体等待;人在回路上,智能体行动,人类监督。经过验证的可靠性推动旋钮上升。
两个观念保证安全。第一,区分人在回路中和人在回路上。前者要求智能体行动前停下并等待批准;后者允许它行动,同时由人观察并介入。低风险、可撤销、经过充分证明的工作可以逐步进入回路上;高风险或不可逆工作无论多可靠,都应留在回路中。第二,安全默认值与逐项同意:新智能体从“建议”开始,每次提高都必须是人有意作出的选择。
这个旋钮是神经系统课程中审批关卡和数字全职员工课程中“审批即权力模型”的前台表现。后台的批准是持久、可审计的事件;前台则是人能够感知的旋钮。
概念 9 · 意图预览与计划审查习惯
最便宜的错误,是智能体还没有犯下的错误。行动之前,尤其涉及不可逆事项时,先展示计划并允许人编辑。“我将执行以下步骤:1、2、3。需要修改吗?”这个意图预览模式,比事后再多解释都更能防止后悔。
如果学过 Cowork,你已经练习过这种计划审查习惯。这里要把它做进你发布的产品,而不只是自己使用的工具。两条规则让它有效:
- **预览强度随风险变化。**发送一份内部草稿,只需轻声提示“即将发送,可以撤销”;向 500 位客户发邮件或转账,则需要完整计划和明确确认。
- 计划在执行中可编辑,而不只是可批准。只能接受或拒绝的计划是一堵墙;可以说“可以,但跳过第 2 步”的计划才是伙伴关系。
概念 10 · 为异步而设计:新的工作节奏
命令式软件是同步的:你行动,它响应;你等待,然后再次行动。智能体工作打破了这种节奏。你设定意图,离开连接,回来时看到进行中或已完成的工作。这是真正全新的协作形态,需要自己的设计。
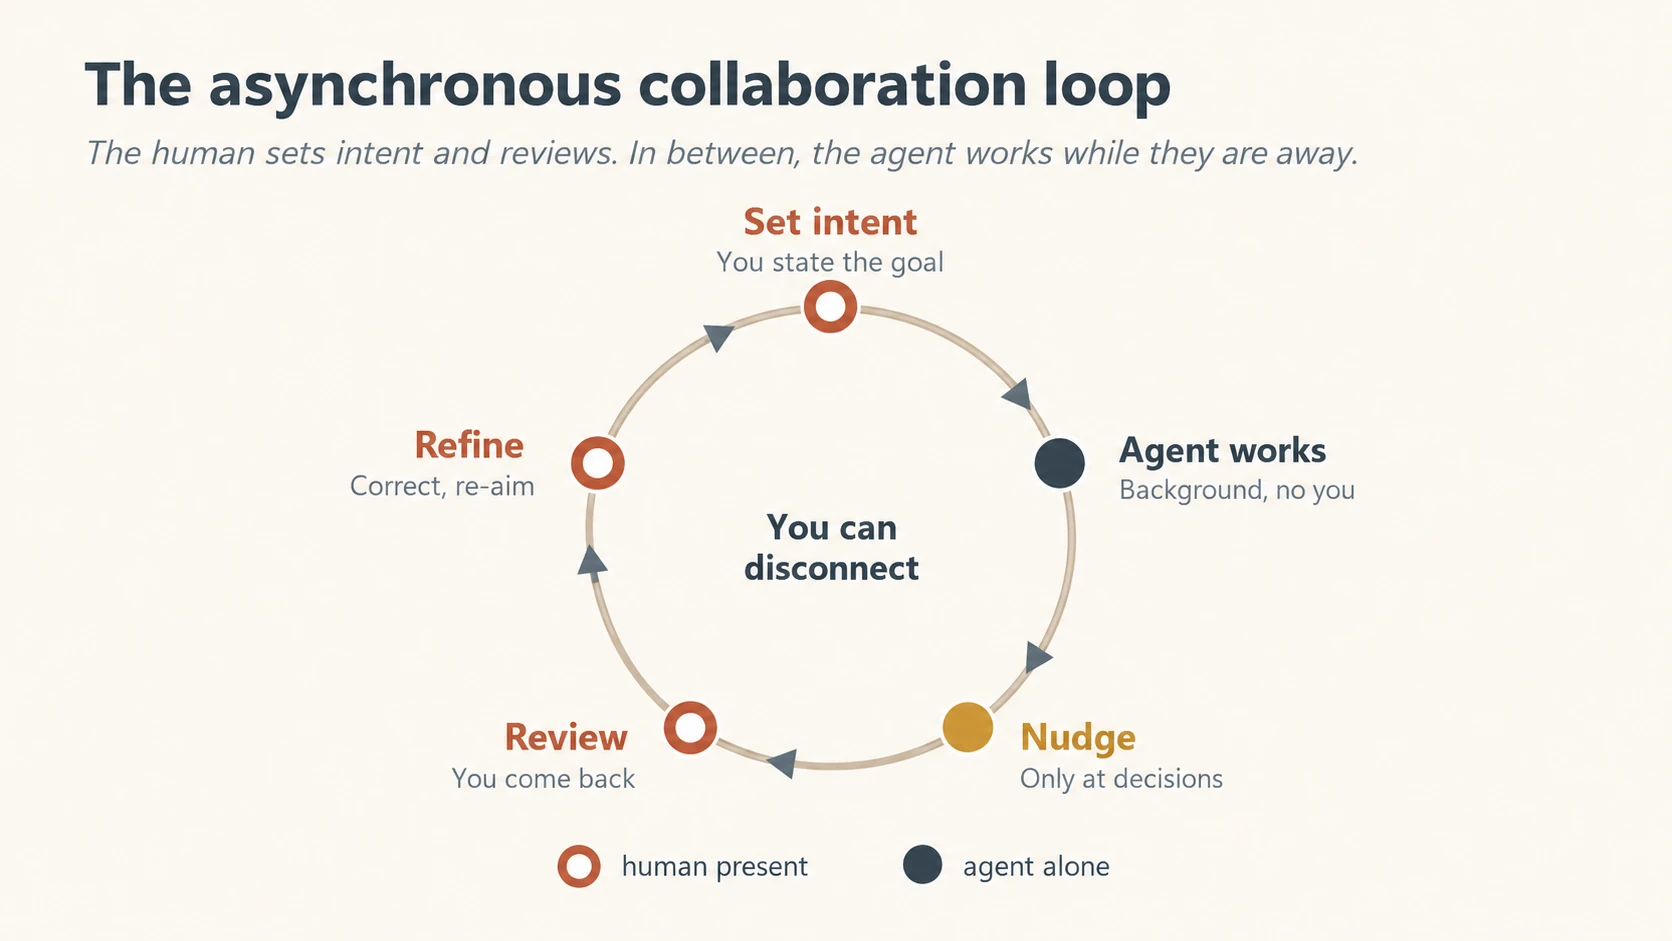
图 5:异步协作循环。人类负责设定意图和审查;其间智能体独立工作,只有决策真正需要人时才打断。
四种界面让异步协作保持人性化:
- 足够清晰的意图捕获,让智能体能在你不在场、无法澄清时继续工作。
- 一眼可懂的进度:三秒能理解的状态,不是一墙日志。
- **提醒,不要滥发通知。**只在真正的决策点打断,其余时间保持安静。每一步都提醒的智能体比没有还糟;你得到一个依赖性强、又不能独立信任的同事。规则是:每次打断都必须值得。
- 返回后的审查与调整界面:在同一处检查成品、纠正并重新指定方向。
结构之外还要设计等待时的感受。智能体速度慢且会花钱,设定意图并离开的人仍在问:“它在工作吗?还要多久?会花多少钱?”沉默会被理解为故障,而不是忙碌。因此要设计等待本身:诚实地命名当前步骤(“正在读取 40 张发票”优于旋转图标),预先给出粗略时间,昂贵运行时显示成本或预算消耗,并允许查看而不打断。延迟和成本不是应隐藏的后台问题;它们是体验的一部分。
概念 11 · 修复与补救:为它犯错的那一天而设计
你的智能体会采取错误行动。不是“可能”,而是“必然”。它是执行真实工作的概率系统,任务足够多时一定有失败。假装不会发生不是乐观,而是失职。可恢复性不是最后附加的错误状态,而是从一开始就设计的一等界面。
四种做法把背叛感变成一次颠簸:
- **尽量接近一键撤销。**这是整门课最强的信任构建方式。人愿意把真正自主权交给能够干净撤销的智能体。
- 直接道歉并清楚说明哪里出错,不含糊,也不把责任推给用户。
- 明确纠正措施和下一步:“我已撤销转账,并标记复查,避免再次发生。”
- **始终提供联系真人的可见路径。**它会缓解挫败,也证明智能体之上仍有问责。
无法衡量就无法改进,因此要观察两个数字。升级频率是智能体寻求人类帮助的比例;一项实践基准给出的健康区间约为 5–15%。过低说明该问时却在猜,过高说明过于胆怯。恢复成功率是升级或失败任务最终获得良好结果的比例,应保持在约 90% 以上。它们是针对自身领域校准的起点,不是法律。它们既是运营指标,也是用户体验指标,因为它们就是人对行动系统的切身感受。
概念 12 · 监督多个智能体:从单个智能体到一支劳动力
到目前为止,我们设计的是一个人监督一个智能体的界面。但本书构建的是智能体劳动力。十个工作者同时运行时,单智能体界面会崩溃:没有人能读十份计划、批准十个步骤或观察十条轨迹。设计问题从监控工作转变为分拣异常。
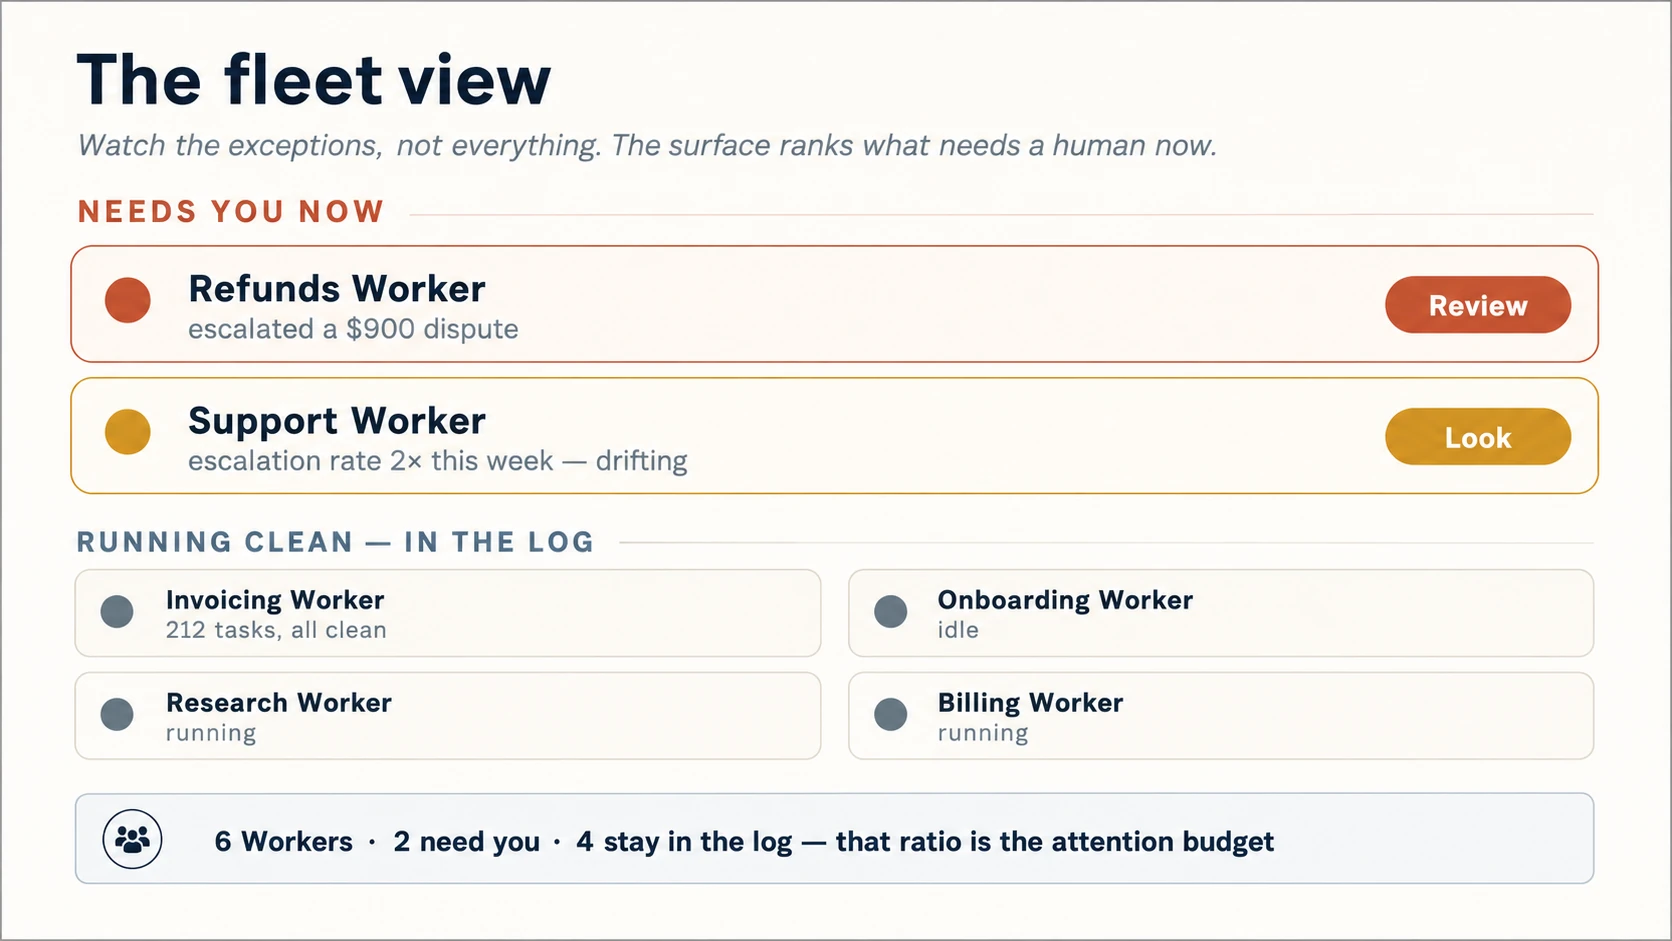
图 6:智能体队伍视图。规模化后,界面的任务是明智使用人的注意力:突出少数需要人的工作者,让大量正常工作者留在日志。
三种界面让一支智能体劳动力可以被监督:
- **智能体队伍视图。**一眼看见所有工作者:谁在运行、谁被阻塞、谁在等你。展示状态而非细节;它是运营看板,不是十个打开的聊天窗口。
- 注意力分拣。界面把现在需要人的事项排在前面。900 美元争议升到顶部,200 笔正常退款留在日志。这是把概念 10 的“提醒,不要滥发通知”从单个智能体扩展到团队;显示与静默的比例就是你的注意力预算。
- **不仅显示困境,也显示偏离。**不要只显示“这个工作者请求帮助”,还要显示“这个工作者本周升级率翻倍”。这是智能体大声失败之前,队伍层面发现它正悄然走偏的信号。概念 4 的过度信任不是靠人更加费力地盯住,而是靠界面替人观察来捕获。
偏离还可以触发响应,而不只是亮起警报。注意力预算的诚实形式是队伍级断路器:当工作者的升级率或错误率超过自身基线的某个倍数(不是通用魔法数字,而是你设定并反复检查的阈值),界面会自动把它降到更低的自主档位,或暂停并提交审查,而不是等待人类发现。阈值和概念 11 的升级区间一样需要校准;纪律在于系统主动分配人的注意力,并在工作者开始滑落时默认选择更少自主权。
这就是人类—智能体团队与 Paperclip 中队伍名单和控制平面的前台。运营模型定义团队成员;这里则设计人类观察团队工作的房间,更关键的是,决定哪些内容不必查看。
第三部分 · 机器界面:为作为用户的智能体而设计
简而言之:如何设计产品中由其他智能体使用的一面,让软件第一次就能正确使用你的产品。
概念 13 · 智能体体验(AX):你的产品有机器人用户
现在来到多数团队从未设计的另一半。越来越多的智能体在使用你的产品:代表用户行动的智能体,以及你自己的智能体劳动力中的其他工作者。它们看不到你精心安排的视觉布局,而是读取结构。如果结构对机器不友好,用户的智能体会悄然失败,而用户会责怪你,根本不知道中间存在一个智能体。
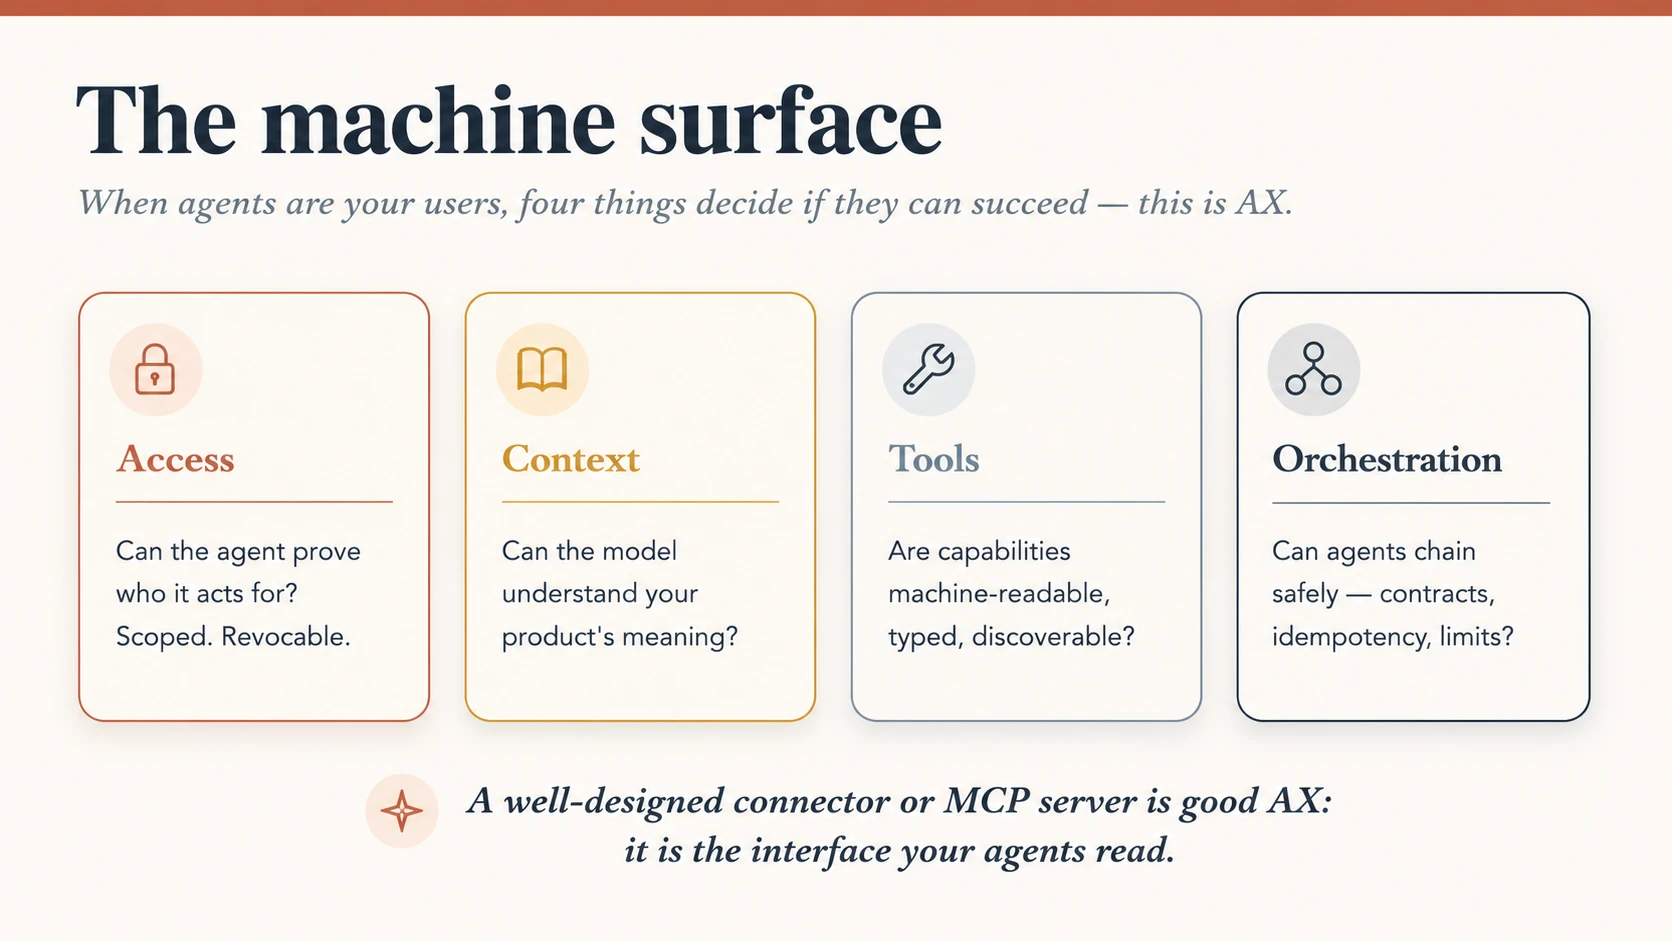
图 7:机器界面。四个问题决定智能体能否使用你的产品,每一个都是设计决策。
四个方面决定智能体能否成功使用产品:
- 访问:智能体能否通过限定范围、可撤销的凭证,证明自己在谁的授权下行动?(这是人工智能身份中的身份问题:这是谁的身份,权力如何传递给智能体?)
- 上下文:模型能否真正理解产品的含义?名称清晰、说明诚实、语义可读。
- 工具:能力是否机器可读、有类型、可发现,而非埋在模型必须抓取的界面里?
- 编排:智能体能否用可预测契约、幂等操作和合理限制,将这项能力与其他能力安全串联?
这里的回报把它与本书其他部分连接起来:**设计良好的连接器或 MCP 服务器就是良好的 AX。**你在技能与连接器和连接器原生应用中学到的一切,都是面向机器读者的界面设计。教智能体执行任务的 SKILL.md,以及签名清晰、有类型的 MCP 工具,就是产品为机器人用户提供的用户体验。要像设计屏幕一样认真设计它们。
具体来说,值得智能体信任的机器界面像一套良好 API,并带有几项智能体特有的习惯:
- 按动作清楚命名工具:使用
refund_order,不要使用process。名称是模型最先读取的内容。 - 让模式窄小、有类型且经过验证:紧密的输入契约帮助模型第一次就做对。
- 声明副作用和危险:标出哪些工具会改变现实,让危险工具要求确认或策略检查。
- 返回结构化且可操作的错误:不仅提供错误码,还要说明下一步,例如能否重试、
retry_after提示或可用备选。要求智能体解释的句子不如可分支的代码;没有下一步的代码也只是半个答案。 - 尽可能让操作幂等,避免重试造成重复扣款或重复发送。
- 携带来源与权限:数据来自哪里、依据谁的授权行动、如何撤销?
- 为智能体编写文档:示例、限制、失败模式和重试行为。模型读取文档,就像人类读取界面。
- 测试契约,而不只测试屏幕:智能体集成需要契约测试,也就是自动验证 API 是否持续兑现承诺;人工界面测试不会覆盖机器界面。
不过,要准确区分共享协议提供什么、不提供什么。截至 2026 年,MCP 标准化了工具发现与调用、资源读取和访问认证。通过第一个官方扩展 MCP Apps,它还增加了界面元数据封装:工具链接到 ui:// 界面,并通过 _meta.ui.resourceUri 指明它,因此可以返回交互组件而不只是文本。它有意把三件事留给你:编排,即智能体如何规划、排序和重试;治理,即谁能调用什么、具有什么审计与限制;以及状态,即长期运行的循环。直白地说,协议让智能体进门;进门后能做什么、由谁监督,仍是你的设计。
所以“良好 AX”有两部分。首先遵循协议,让任何智能体都能访问;然后设计协议遗漏的部分:服务器允许列表、同意关卡、支出限制和可审计日志。它们是概念 15 中策略界面的机器版。MCP Apps 提案也明确指出,隔离和这些控制属于主机职责,而非协议职责。通信格式正在成为通用品;建立在其上的策略属于你,真正的信任和安全也存在于那里。
概念 14 · 生成式界面:返回界面的智能体
两类受众正在同一界面相遇。借助 MCP Apps,工具不必只返回文本。它可以为所有主机返回普通文本结果,同时指向一个 ui:// 交互资源,并在工具的 _meta.ui.resourceUri 字段中命名它,供支持 Apps 的主机使用。主机会在对话内部的沙箱 iframe 中渲染界面,让人无需离开智能体工作流就能检查、批准、配置或探索。
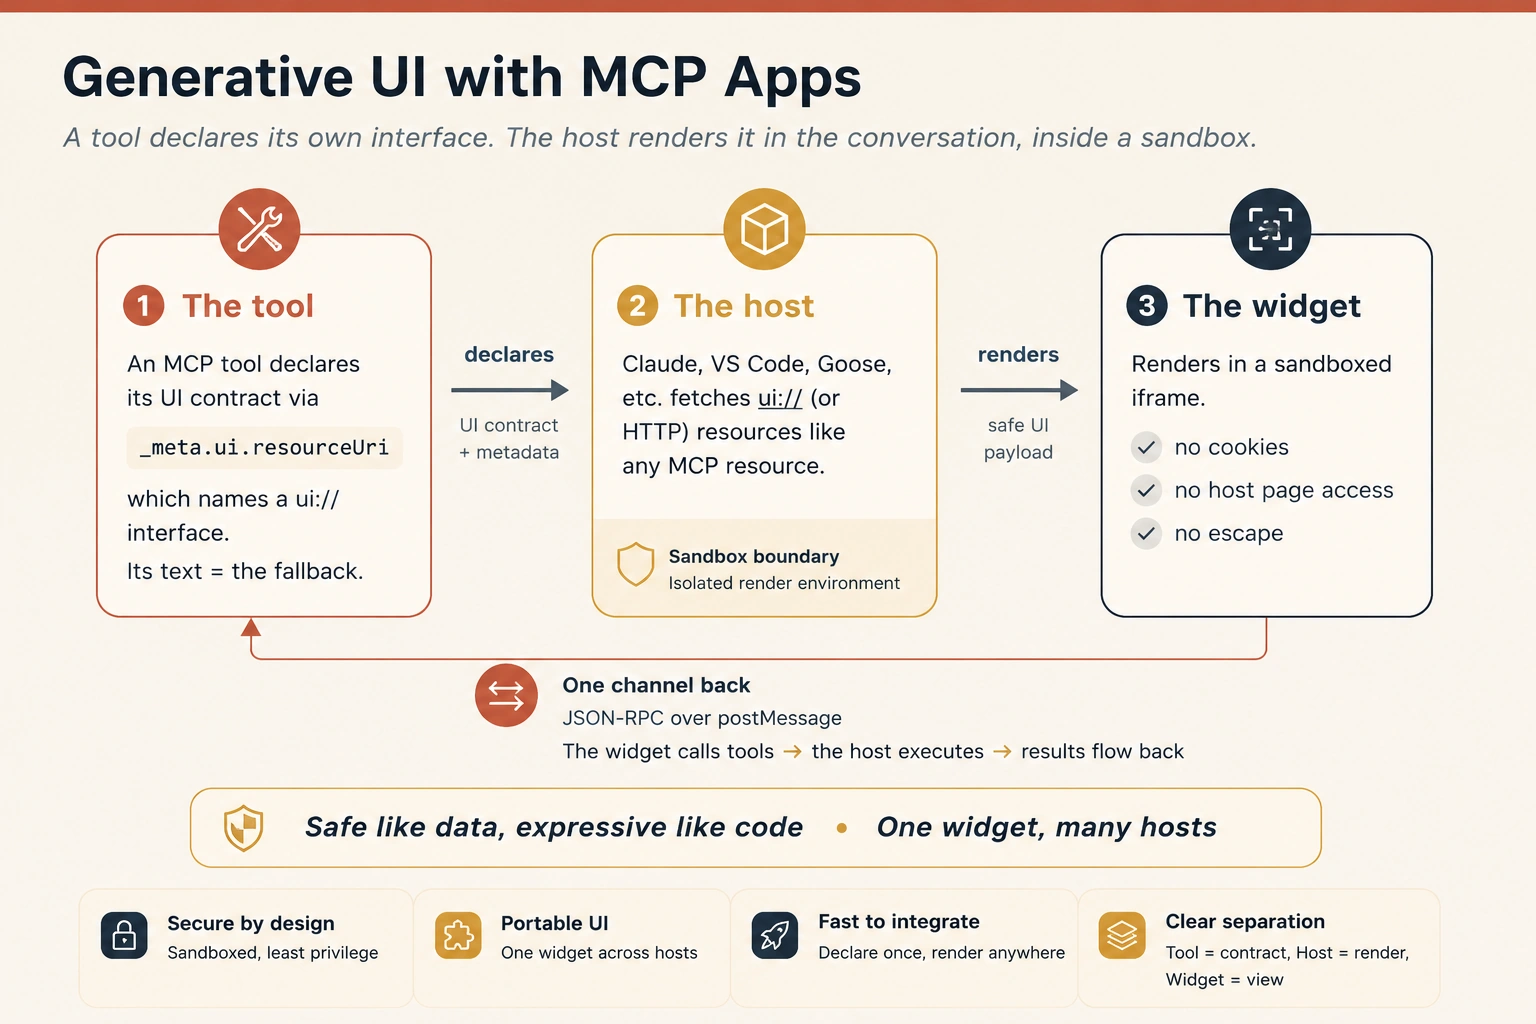
图 8:使用 MCP Apps 的生成式界面。工具声明自己的界面,主机在对话和沙箱中渲染;一条可审计通道传回一切。文本结果在其他地方仍是后备方案。
这就是 MCP 世界中的生成式界面:不是随机网页,也不是注入主机的任意代码,而是附在工具调用上的任务专用界面。智能体调用工具,工具返回后备文本并声明界面,主机在支持时渲染组件。不支持时,文本仍能传达决定。正如设计原则所说,界面保持**“像数据一样安全,像代码一样富有表现力”**:它作为内容在沙箱中渲染,而不是作为松散代码运行在客户端。
这个模式说明 MCP Apps 为什么对智能体体验重要。同一种能力同时拥有两种界面:供智能体使用的机器可读 MCP 工具,以及供人使用的人类可读组件。一次调用可以同时产生另一个智能体能解析的契约,以及人类能信任的审批卡、仪表板、地图、图表或审查面板。
MCP 是机器界面。MCP Apps 是交互式人类界面。两者结合,让一个工具同时服务智能体产品的两类用户:人类和智能体。
MCP Apps 是模型上下文协议的第一个官方界面扩展,于 2025 年 11 月提出,并在 2026 年 7 月规范中定稿,由 MCP-UI、OpenAI 和 Anthropic 团队共同构建。Claude、Claude Desktop、VS Code、Goose 和 Postman 等主机已支持它;OpenAI Apps SDK 也在同一 MCP 基础上构建 ChatGPT 应用。因此,它是这一层最接近事实标准的方案:一个组件,多种主机,虽然支持和功能因主机而异。这已经投入生产:Claude 在 2026 年 1 月启用 MCP Apps 时,同时推出 Asana、Slack、Figma、Canva、Box、Hex 等交互式连接器,包括可编辑项目时间线、格式化消息预览和实时分析图表。它们都遵循相同模式:到处返回文本,在主机支持时返回组件。
四个属性让 MCP App 不只是装在盒子里的网页,而且每个都是体验属性:
- **保留上下文。**应用位于对话内部。人不需要切换标签页、丢失位置,也不用猜哪次对话包含仪表板;界面就在产生它的讨论旁边。
- **双向通信。**组件可以调用服务器工具,主机可以推送新结果。独立网页需要自己的 API、登录和状态;MCP App 从协议继承这些能力。
- **经同意借用主机能力。**应用无需自行构建邮件或日历集成,而可请求结果(如“安排会议”),由主机通过用户已经连接的能力完成,并受用户同意约束。这是概念 8 的同意模型转化为机器形态。
- **在构造上安全。**沙箱阻止应用访问主机页面、Cookie 和存储;每条消息只通过一条可审计通道。概念 16 的安全界面内建于模式,而非事后补上。
组件什么时候值得出现?官方指南与本课一致:用于探索复杂数据(交互地图优于数字列表)、一次配置多个选项(表单优于二十轮问答)、丰富媒体(真正的 PDF 或三维查看器)、实时监控(动态仪表板)和多步骤工作流(逐项批准、审查和分拣)。实践实验中的退款审批卡正是最后一种情况。反向规则同样成立:纯文本足以服务人时,就返回文本。组件必须像提醒赢得打断机会一样赢得自己的位置。
保持可移植性的纪律来自网络的渐进增强:先按开放标准构建;单一主机提供支付流程(截至 2026 年仍为测试版且限于部分市场)或应用商店等附加功能时,再检测能力,并在其他地方优雅降级。只为单一供应商附加功能构建会把界面锁在那里;建立在开放基础上才能自由移动。
它之所以重要,是因为打破了“聊天”与“应用”之间的旧墙。智能体即时组合任务所需的恰当界面:适合表单时用表单,数字需要解释时用图表,而你仍控制样式、安全和组件集合。这是为人类设计和为智能体设计正在成为同一门学科的最明确信号:现在要设计智能体能够表达的组件词汇表,而不是人类必须穿过的固定屏幕。
MCP Apps 已在 2026 年 7 月规范中定稿,但仍在积极开发:SDK 辅助函数、方法名和主机支持会按月变化。请针对模式的形状设计,即把界面作为数据交付,在应用无法逃逸的沙箱中渲染;构建前再到 modelcontextprotocol.io/extensions/apps 核对细节。附录 A 绘制结构,完整示例后的实践实验会真正构建一个。
第四部分 · 新手艺
简而言之:这份工作的新技能,包括安全、衡量,以及为每个工作者编写的一页文档。
概念 15 · 新设计对象与编舞者的工作
如果不再绘制屏幕,你究竟画什么?这门手艺有了新的主要对象,它们占据你现在的设计时间:
- 策略界面:权限、支出上限和智能体永远不得越过的伦理边界。你在设计规则,以及让人设置规则的控件。
- 置信传达器:概念 7 和 11 中的来源标签、不确定性标记和清晰回滚。系统如何如实表达确定程度。
- 系统性情:智能体多耐心或主动、多久发言一次、听起来怎样。性格要根据场景调整:头脑风暴时积极,接近资金时谨慎。
负责这些对象的角色有了新重心。你不再主要制作屏幕,而更像一名编舞者,安排人类与智能体如何共同移动:信息架构、对话设计、运营感觉,以及判断人何时想掌握控制、何时想摆脱负担的行为洞察。它直接连接选择智能体架构:后台选择的模式(单智能体、规划器或多智能体)决定前台人类必须监督什么。架构和体验是同一个决策的两个视角。
概念 16 · 把界面作为安全控制
前面把界面视为建立信任的地方。它也是保护信任的地方。会在现实中行动的智能体有攻击面,而相当一部分防御不是后台加固,而是设计。行业共同使用的风险清单是 OWASP 大型语言模型应用十大风险(OWASP 是发布软件安全风险标准清单的非营利组织)。以下是已经设计的界面如何回应由设计师掌控的风险。
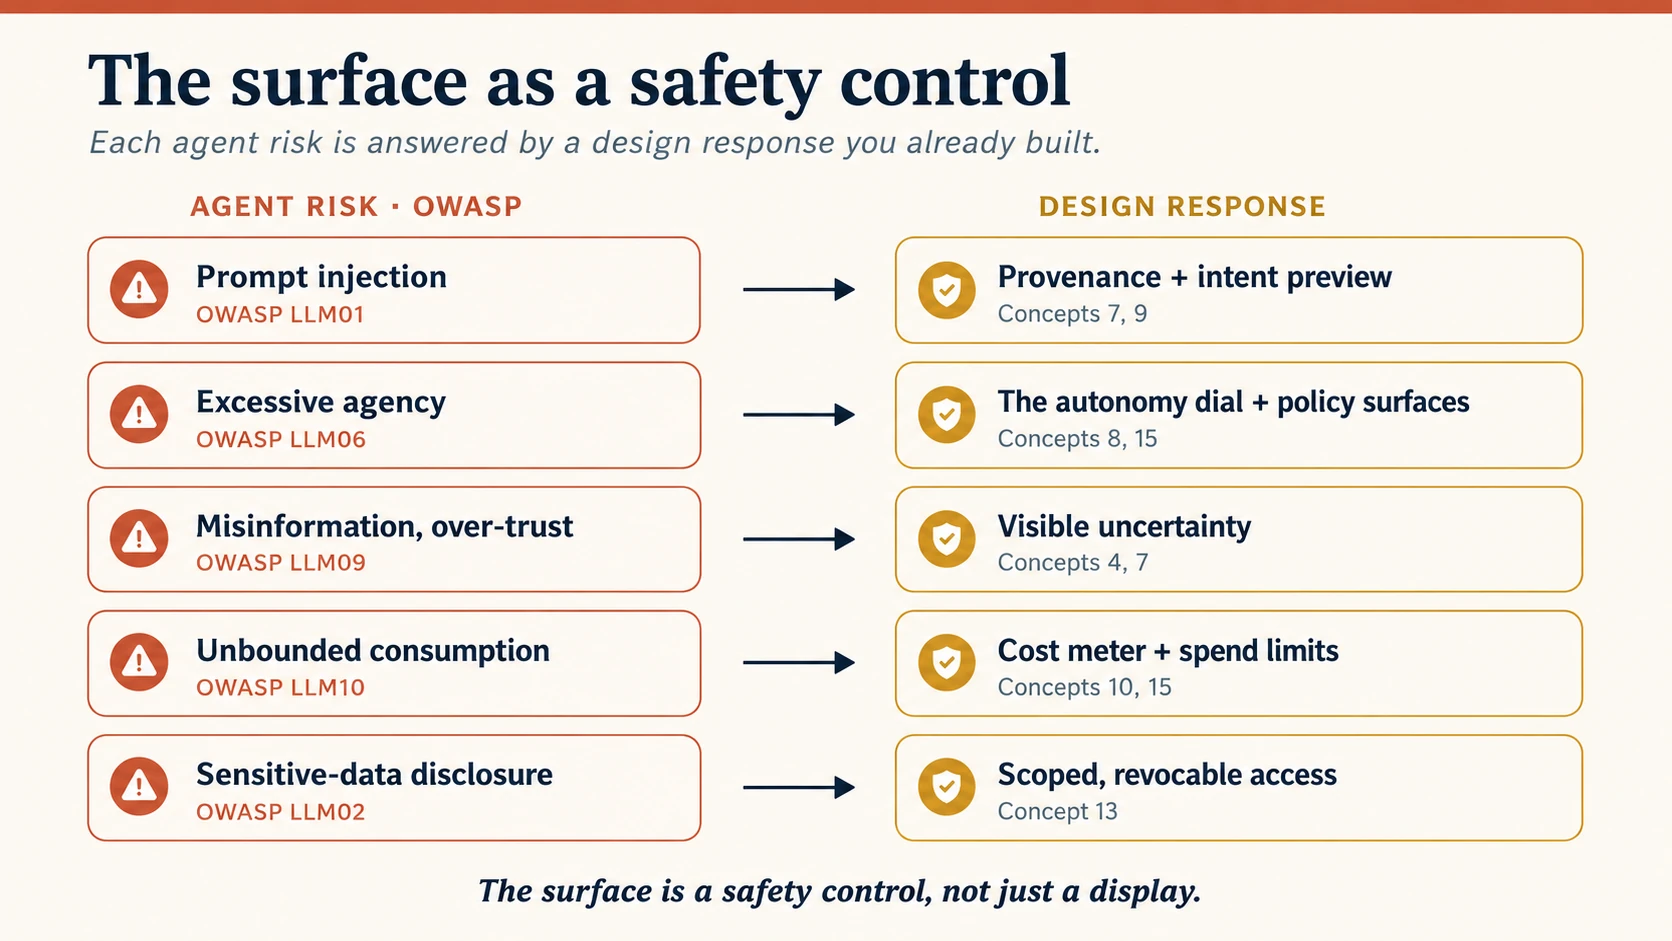
图 9:把界面作为安全控制。左侧每项 OWASP 风险,都由右侧课程已经构建的设计响应回答:安全是一项体验功能,不是后台杂务。
- 提示注入(LLM01):网页或文档悄悄要求智能体执行用户从未请求的事情。界面通过展示来源信息防御:结果说明智能体读了什么、指令来自哪里(概念 7);重大行动还要经过意图预览(概念 9),让注入指令无法静默行动。
- 过度代理权(LLM06):智能体能做的事超过当前需要。自主旋钮(概念 8)和策略界面(概念 15)负责防御:默认最小权力,高风险操作固定留在回路中,能力有意添加而不因偏离扩张。
- 错误信息与过度信任(LLM09):智能体自信地犯错,人类却相信它。防御是可见不确定性(概念 4)和来源信息(概念 7):绝不能让可疑说法与确定事实拥有同一外观。
- 无界消耗(LLM10):失控循环或“钱包拒绝服务”攻击消耗时间与预算。界面实时显示成本和预算(概念 10),并通过策略界面执行支出限制(概念 15)。
- 敏感数据泄露(LLM02)与权限滥用:智能体泄露信息或越过职责。防御是概念 13 的访问支柱:限定范围、可撤销的凭证,以及人能看见并撤回的同意关卡。
由此得到两条规则。第一,界面是安全控制,不只是显示器:来源、不确定性、预览和成本表都是防御;以“减少杂乱”为由删掉它们,会移除保护而非装饰。第二,每个智能体系统都需要信任界面可以指向的治理界面:谁能添加能力、谁审查失败、谁审计日志;还有任何产品都不能缺少的问题:**谁能一步暂停或终止智能体?**每一项都必须对应一个可访问控件:
| 治理界面 | 它回答的设计问题 |
|---|---|
| 能力审批 | 谁可以添加或扩大工作者能做的事? |
| 权限审查 | 谁批准工具范围和数据访问? |
| 事件审查 | 谁负责失败和事后复盘? |
| 审计日志 | 谁能检查行动、计划、工具调用和批准? |
| 终止开关 | 谁能一步暂停、停用或回滚? |
| 偏离审查 | 谁调查升级率上升或恢复率下降? |
这些是概念 15 策略界面背后的组织控制。NIST 人工智能风险管理框架等标准(NIST 是美国国家标准机构;框架包含治理、映射、衡量、管理)会命名这些控制,本书则在人类—智能体团队和使用 Paperclip 构建智能体劳动力的 Paperclip 控制平面中将其落地。界面设计的任务是让控制可访问,不是发明背后的政策。
概念 17 · 衡量体验
界面可能看起来优雅,却仍然失败。要知道设计是否产生价值,必须衡量体验,并明确它不是什么。本书的评估驱动开发衡量工作者输出是否正确:单元、工具使用、轨迹、安全和回归评估。这些很必要,但不是这里的对象。体验指标衡量关系:人能否委派、信任、引导和恢复。工作者可以通过所有正确性评估,却披着无人能够监督的界面。
使用一张小型计分卡,而不是一墙仪表:
| 指标 | 它说明什么 |
|---|---|
| 计划接受率 | 人们理解并批准计划,还是机械批准或拒绝? |
| 干预率 | 人类多久需要介入?关注趋势:下降表示正在赢得信任。 |
| 恢复成功率 | 失败或升级后,任务是否仍得到良好结果? |
| 过度信任与信任不足 | 人们接受错误输出,还是拒绝正确工作?两者都是校准失败。 |
| 通知精确度 | 发出的打断中有多少值得?这是可衡量的提醒预算。 |
| 节省时间与消耗注意力之比 | 捕获智能体淤泥:智能体减少了人类总负担,还是只转移了它? |
两项纪律让指标有意义。关注趋势而不是快照:不知道上个月的数值,12% 干预率没有意义。并按照 Microsoft 的 HAX Playbook 闭环:发布前预演可能的人机失败并设计恢复路径,而不是到生产环境才首次遇见。最重要的指标是最后一项,节省时间与消耗注意力之比,因为它用一个数字概括智能体的承诺。若结果为负,无论界面多漂亮都已经失败。
指标说明界面是否有效;测试流程说明发布前如何发现。对工作者执行以下序列:
- 计划审查测试:提供真实任务,确认人能在行动之前阅读、理解并纠正计划(概念 9)。
- 过度信任测试:提供看似正确但暗藏错误的输出,观察不确定性是否阻止机械批准(概念 4、7)。
- 恢复测试:让它故意犯一个可撤销的错误,测量人能否干净地撤销(概念 11)。
- 打断测试:运行一批任务,衡量多少提醒真正值得打断(概念 10)。
- 无障碍测试:只用键盘和屏幕阅读器访问计划、进度、撤销和升级(概念 5)。
- 机器界面契约测试:直接测试工具:错误类型被拒绝、危险操作有门槛、错误结构化、重试幂等(概念 13)。
六项测试对应所设计的界面。通过它们不能证明工作者正确,那是评估驱动开发的职责;但能证明出错时体验依然成立。
概念 18 · 反模式与你最终获得的设计简报
请把这张表放在随时可见的位置。每种反模式都是本课某项原则被破坏:
| 反模式 | 表现 | 违反的概念 |
|---|---|---|
| 黑箱 | 行动却不展示理由 | 7 · 渐进式透明 |
| 智能体淤泥 | 人重新检查一切,未节省时间 | 6 · 可见分工 |
| 过于急切的智能体 | 第一天就高度自主,没有赢得信任 | 8 · 自主程度旋钮 |
| 被过度信任的智能体 | 在无人检查的工作上高度自主 | 4 · 校准信任 |
| 通知轰炸 | 每一步都发提醒 | 10 · 提醒而非通知 |
| 警报疲劳控制台 | 每个工作者都提醒,人类最终忽略 | 12 · 注意力分拣 |
| 虚假确定性 | 把不稳的猜测说成确定事实 | 4 · 可见不确定性 |
| 陷阱门 | 无法撤销的操作 | 11 · 修复与补救 |
| 困惑代理人 | 无法区分用户指令与注入指令 | 16 · 安全界面 |
| 未衡量界面 | 看似优雅,却无人追踪是否有效 | 17 · 衡量体验 |
| 难以理解的 API | 没有智能体能够解析的机器界面 | 13 · 智能体体验 |
下面是你的交付物。请让智能体(使用规划模式也可以)为本书前面构建的一个数字 FTE 起草一份智能体体验简报。共十一部分,每部分对应一项决策:
- 两类受众:说出这个工作者的人类用户和智能体用户(概念 2)。
- 初次接触:如何引导新用户;当它获得行动能力时,如何重设预期;界面如何在不依赖视觉或鼠标时工作(概念 5)。
- 信任界面:默认展示什么,以及下面三层是什么(概念 7)。
- 负担地图:人保留什么,工作者承担什么,人如何看见这条边界(概念 6)。
- 自主阶梯:这个工作者的五个停靠点,以及哪些行动永远固定为人类在回路中(概念 8)。
- 异步计划:捕获意图、可扫读的进度、如何展示等待本身,以及哪些确切事件值得提醒(概念 10)。
- 恢复计划:这里的“撤销”意味着什么,升级路径是什么,以及要观察哪两个健康指标(概念 11)。
- 规模化运行:如果同时运行多个工作者,机群视图展示什么、什么值得人的注意,以及观察哪种偏离信号(概念 12)。
- 机器界面:该工作者暴露哪些连接器或 MCP 工具,并按 AX 的访问、上下文、工具和编排来判断(概念 13)。
- 安全界面:该工作者的界面必须缓解哪些智能体特有威胁(注入、过度代理权、失控成本),每项对应什么防御(概念 16)。
- 计分卡:要跟踪哪些少量体验指标,以及工作者正确性评估从哪里接手(概念 17)。
这份简报就是成果物。它之于工作者体验,就像人类—智能体团队中的运行文档之于团队运行模型:写一次,并在工作者每次变化时回来更新。用规范驱动开发的语言说,它是体验层的规范:为非确定性工作者提供确定、可审查界面的地方。附录 C 提供了可填写的空白版本。
实例:客服工作者的两个界面
以数字 FTE 课程中的客服数字 FTE 为例,同时观察两个界面。
它的人类界面。客服主管打开控制台。默认视图中每张工单只有一行:“已退款订单 #4021,$38,置信度:高。”这是第 1 层(概念 7)。轻点一次可看到计划:读取订单、检查退款政策、执行退款、给客户发邮件。再点一次则看到原因和所依据的政策条款。退款得以执行,因为 $38 在工作者的限额内,也就是自主阶梯第 3 站“在限制内行动”(概念 8)。下一张工单是一笔 $900 的拒付争议,超过限额,因此工作者停止并询问:回到第 2 站,人类在回路中,因为风险要求它固定在那里(概念 8)。每笔退款都可在 24 小时内撤销(概念 11)。主管处于回路之上,只需扫视而非亲自驾驶(概念 10)。当该工作者与另外九个一起运行时,机群视图会突出这笔 $900 的争议,正常退款则留在日志中(概念 12)。
**它的机器界面。**同一个工作者由公司的编排智能体调用,对支付提供方而言,它自己也是一个智能体。因此退款能力是带类型签名和硬限额的 MCP 工具(工具);它提交限定范围、可撤销的凭证,证明自己代表该商户行动(访问);工具描述准确告诉模型何时退款有效(上下文);退款还是幂等的,重试绝不会重复退款(编排)。概念 13 的四项全部具备,虽然人类界面上看不到任何一项,缺少它们整个系统却会崩塌。
一个工作者,两类受众,两个有意设计的界面。
当风险升高时。现在只改一件事:不再退款,而让该工作者批准一旦转出就无法收回的供应商付款。刚才的每个模式都要收紧。撤销(概念 11)不再是安全网,因为没有撤销;设计重心因此从恢复转向预防:意图预览(概念 9)必须详尽而强制,不能只是礼貌提示。自主旋钮(概念 8)永远不超过“在限制内行动”,限额保持很低,任何大额付款都永远固定为人类在回路中,不论工作者后来多可靠。无需询问即可行动的置信门槛也要提高。安全界面(概念 16)承担更多压力,因为错误或被注入的付款指令既昂贵又不可逆,所以来源信息和第二位人类审批者不再可选。治理界面同样更重:终止开关、完整审计日志,以及一名对超过阈值的每笔付款负责的具名人员。模式和概念都相同,只因出错成本提高而调得更严格。恢复与预防之间的旋钮,也适用于工资、临床分诊、评分以及任何受监管或不可逆的高风险领域。
实践实验:构建你的第一个 MCP App
第三部分说明机器界面也是设计工作。现在亲手完成它:构建一个真正的 MCP App,让工具返回可运行、可交互的小组件,而不是一堵文本墙,并在 Claude 或任何支持 MCP Apps 的主机中渲染。
构建方式与本书一致:**指挥编码智能体。**官方 MCP 构建指南明确指出,创建 MCP App 最快的方法,是让 AI 编码智能体加载 MCP Apps skill。这不是绕开学习的捷径:skill 携带架构和最佳实践,智能体负责输入代码,你负责本课训练的部分,也就是写规范并判断结果。
所需条件。Node.js 18 或更高版本、终端,以及支持 Skills 的编码智能体,例如 Claude Code、OpenCode、Codex、Cursor、Gemini CLI、Goose 等。在 Claude 内测试需要付费套餐(自定义连接器);第 3 步的本地测试主机则是免费路径。
第 1 步 · 安装 create-mcp-app skill
正如你在技能与连接器中学到的,skill 是一组指令和示例,智能体会在相关时加载。官方 create-mcp-app skill 教会智能体 MCP Apps 的架构、模式和陷阱,使它第一次就能正确搭建项目。
在 Claude Code 中,将它安装为插件:
/plugin marketplace add modelcontextprotocol/ext-apps
/plugin install mcp-apps@modelcontextprotocol-ext-apps
对于其他智能体(OpenCode、Codex、Cursor、Gemini CLI、Goose 等),跨智能体安装器只需一行:
npx skills add modelcontextprotocol/ext-apps
(若偏好手动方式:克隆 github.com/modelcontextprotocol/ext-apps,把 plugins/mcp-apps/skills/create-mcp-app 复制到智能体的 skills 文件夹,例如 ~/.claude/skills/、~/.codex/skills/ 或 ~/.cursor/skills/。)
确认安装成功。询问智能体:
What skills do you have access to?
列表中应出现 create-mcp-app。如果出现,智能体就已经知道如何构建 MCP Apps。
第 2 步 · 十分钟循环:搭建、构建、运行
先用官方 hello-world 走完整个循环。只给智能体一行:
Create an MCP App that displays a color picker
智能体会识别相关 skill,加载它并搭建完整项目:MCP 服务器、小组件界面和构建配置。完成后,在项目文件夹中运行:
npm install && npm run build && npm run serve
MCP 服务器现在运行在 http://localhost:3001/mcp。它已经存在,下一步让它真正显示出来。
第 3 步 · 看见它渲染
选项 A:本地测试主机(免费,无需账户)。ext-apps 仓库附带一个最小开发主机:
git clone https://github.com/modelcontextprotocol/ext-apps.git
cd ext-apps/examples/basic-host && npm install
SERVERS='["http://localhost:3001/mcp"]' npm start
打开 http://localhost:8080,选择工具并调用它,观察小组件在沙箱 iframe 中渲染。
**选项 B:在 Claude 内部(网页或 Desktop)。**Claude 原生渲染 MCP Apps,但必须能访问你的机器,因此在第二个终端打开隧道:
npx cloudflared tunnel --url http://localhost:3001
复制生成的 https://….trycloudflare.com URL,在 Claude 的 Settings → Connectors → Add custom connector 中添加它(自定义连接器需要 Pro、Max 或 Team 套餐)。然后开始新对话,让 Claude 提供颜色选择器,小组件就会出现在对话中。
第 4 步 · 阅读智能体构建的内容
构建真正项目之前,打开项目并找出完整模式:两个 MCP 原语和一座桥。在服务器端,一个工具的元数据指向 UI,一个资源负责提供该 UI:
// server.ts (the load-bearing lines)
const resourceUri = "ui://get-time/mcp-app.html"; // ui:// marks this as an App interface

registerAppTool(
  server,
  "get-time",
  {
    title: "Get Time",
    description: "Returns the current server time.",
    inputSchema: {},
    _meta: { ui: { resourceUri } }, // the one line that turns a tool into an App
  },
  async () => ({
    content: [{ type: "text", text: new Date().toISOString() }], // the text fallback
  }),
);

registerAppResource(
  server,
  resourceUri,
  resourceUri,
  { mimeType: RESOURCE_MIME_TYPE },
  async () => ({
    contents: [{ uri: resourceUri, mimeType: RESOURCE_MIME_TYPE, text: html }],
  }),
);
在小组件中,App 类打开沙箱唯一允许的通道:
// src/mcp-app.ts (the load-bearing lines)
const app = new App({ name: "Get Time App", version: "1.0.0" });
app.connect(); // open the postMessage channel to the host

app.ontoolresult = (result) => {
  /* the host pushes the first tool result here */
};

await app.callServerTool({ name: "get-time", arguments: {} }); // the UI calls tools back
对照本课来读。工具的文本 content 是不支持 Apps 的主机所用的回退内容(概念 14)。小组件绝不会接触主机页面或 Cookie;一切都通过 postMessage 上的一条可审计 JSON-RPC 通道传输(概念 16,模式内建)。每次 callServerTool 都是到服务器的一次往返,因此界面必须优雅处理等待(概念 10 的缩小版)。
第 5 步 · 真正构建:退款审批卡
现在构建本课自己的实例。给智能体一份规范,而不是模糊感觉;这就是把规范驱动开发应用到小组件:
Using the create-mcp-app skill, build an MCP App called refund-approval.

Tool: review_refund(order_id: string, amount: number, confidence: "high" | "low" | "unsure").
It returns the refund details as plain text (the fallback) and renders an approval card.

The card must:
1. Show one plain line: "Refund #<order_id> · $<amount> · confidence: <word>".
   Confidence is always a word, never a colour.
2. Offer two buttons, Approve and Escalate to a human. Both must be reachable
   by keyboard, with labels a screen reader announces.
3. On Approve, call the server tool approve_refund(order_id), then show
   "Approved · Undo available for 24h" with an Undo button that calls
   undo_refund(order_id).
4. If amount > 50, disable Approve and show "Above limit: needs a human",
   leaving only Escalate active.
5. Make approve_refund and undo_refund idempotent on order_id: calling either
   twice must be safe.
按第 2、3 步构建、运行并测试。然后执行设计检查,因为本课中交付不是终点;检查表如下:
| 检查 | 正在练习的概念 |
|---|---|
在不支持 Apps 的主机中调用工具(或读取文本 content):回退内容是否承载了决策? | 14 · 回退内建 |
| 置信度是否始终是词语而非颜色,卡片的一行是否直白? | 7 · 透明,5 · 无障碍 |
| 批准后再撤销:是否一键反转,点两次是否仍安全? | 11 · 修复,13 · 幂等性 |
| 尝试 $900 退款:卡片是否拒绝并转给人类? | 8 · 自主旋钮 |
| 只用键盘逐项切换:是否能到达每个控件? | 5 · 人人可用 |
工具是否按行动命名(review_refund,而不是 process)? | 13 · 机器界面 |
每一行都通过时,请注意刚刚完成的事情:一次工具调用既产生了人类可以信任的直白文字,也产生了另一个智能体可以调用的带类型、幂等契约。你有意交付了概念 2 的两个界面。
第 6 步 · 继续深入
官方文档才是持续变化的事实来源:modelcontextprotocol.io/extensions/apps/overview 的概览、本实验遵循的 modelcontextprotocol.io/extensions/apps/build 构建指南、apps.extensions.modelcontextprotocol.io 的完整 API 参考,以及 ext-apps GitHub 仓库。其 examples 目录包含交互地图、三维场景、PDF 查看器、仪表板,以及 React、Vue、Svelte 和原生 JavaScript 的起步模板。如果本实验某条命令失败,请采用智能体式做法:让智能体获取构建指南并协调差异。
本实验的每条命令和代码模式,都依据截至 2026 年中的官方 MCP Apps 构建指南验证。扩展已在 2026 年 7 月规范中定稿,但仍在积极开发,因此包名、SDK 辅助函数和主机支持会持续变化。持久的是工具 + ui:// 资源 + 沙箱渲染 + postMessage 通道这一模式,而不是某条固定咒语。
项目
- **审计你使用的智能体。**选择一个你依赖的智能体产品,按概念 18 的十一种反模式评分。哪个信任输入最弱?哪一项改动最能提升它?
- **画出旋钮。**针对已构建的一个工作者,用具体语言写出五个自主停靠点,标出哪些行动永远固定为人类在回路中,并说明原因(概念 8)。
- **设计提醒预算。**列出工作者可能打断人的每个事件,不断删减,直到只剩真正需要人类的事件。这份最终列表就是通知设计(概念 10)。
- **编写机器界面。**选择工作者的一项能力,编写连接器或 MCP 工具,使陌生智能体第一次就能正确使用。用 AX 的四个问题判断它(概念 13)。
- **设计机群视图。**想象五个工作者同时运行。勾画主管一眼看到什么,决定什么值得打断、什么留在日志,并指出要观察的偏离信号(概念 12)。
- **完整简报(综合项目)。**为一个数字 FTE 完成概念 18 的十一部分智能体体验简报。这就是本课围绕的交付物。
- **交付小组件。**完成实践实验到第 5 步,让退款审批卡在真实主机中运行并通过设计检查的每一行。再写下检查表迫使你做出的三个、普通网页表单不会要求的设计决策。
如果你来这里是为了指导而非亲手构建,请阅读概念 1–4、8、12、13、16 和 17,然后为一个工作者写出自主阶梯(项目 2)、机群视图(项目 5)和机器界面判断(项目 4)。这些足以审查一个智能体产品并判断其体验是否可信,而这正是领导者在这里的真正工作。
本课在全书中的位置
这是一门设计纪律,类似规范驱动开发:它是一种叠加在任何构建之上的思考方式,不是要安装的工具。它与人类—智能体团队配套:那门课编写团队的运行模型,本课设计人类体验团队工作的界面。两者结合,你同时拥有操作手册和控制室。
附录 A:MCP Apps 结构图(2026)
概念 13、14 和实践实验提到许多部件。下表逐项固定其含义,状态截至 2026 年中。MCP Apps 已在 2026 年 7 月规范中定稿,但仍在积极开发;构建前请以官方文档(modelcontextprotocol.io/extensions/apps)核对细节。本书采用 MCP Apps,是因为它直接位于 MCP 工具层,也就是智能体已经发现工具、调用能力、接收结构化结果,并开始渲染任务专用界面的地方。
| 部件 | 它是什么 |
|---|---|
| 工具 | 普通 MCP 工具,其 _meta.ui.resourceUri 字段指向界面;返回的文本是主机不支持 Apps 时的回退内容 |
ui:// 资源 | 界面本身:服务器像提供其他 MCP 资源一样提供的 HTML 页面,通常连同 CSS 和 JavaScript 打包 |
| 沙箱 iframe | 主机渲染 HTML 的隔离空间,不能读取主机页面、Cookie 或存储,也无法逃逸 |
| postMessage 通道 | 应用的通信方式:JSON-RPC 消息,多数为 ui/ 前缀方法,也包括 tools/call 等共享方法,全部可由主机审计 |
csp 和 permissions | 资源声明的需求:可从哪些外部源加载资产,以及请求哪些额外能力,如相机或麦克风 |
App 类 | 来自 @modelcontextprotocol/ext-apps 的便利封装:connect()、ontoolresult、callServerTool();它是可选的,底层仍是标准 Web API |
| 主机支持 | 截至 2026 年中包括 Claude、Claude Desktop、VS Code(Copilot)、Goose、Postman 和 MCPJam;OpenAI Apps SDK 在同一 MCP 基础上构建 ChatGPT 应用 |
与本课的关系:工具及其资源是你的机器界面(概念 13),渲染的小组件是人类界面(第二部分),沙箱、可审计通道和声明权限则是安全界面(概念 16)。一个模式,三个界面。
附录 B:MCP Apps 与 OpenAI Apps SDK,给设计师的说明
如果今天要为智能体工具提供 UI,常见路径是 MCP Apps 和 OpenAI Apps SDK。设计师常问该选哪个;诚实答案首先要拒绝这个问题的前提。
**它们不是对手。**OpenAI Apps SDK 构建在 MCP 之上:ChatGPT App 就是一台叠加 ChatGPT 专用功能的 MCP 服务器。两者使用相同的沙箱 iframe、JSON-RPC 通道和工具声明 UI 的方式,线协议、安全模型和渲染方式都是共享的。
Apps SDK 在体验层增加的内容,不只是代码差异:
- **发现界面。**ChatGPT 应用商店展示你的应用并把它放到用户面前;Claude 也有连接器目录(
claude.ai/directory)展示 MCP Apps。每个主机都在出现发现界面,而发现本身也是设计问题:一个人如何找到智能体应用,并在首次使用前决定是否信任它?这是概念 5 的冷启动信任在生态系统规模上的重演。 - **对话内支付。**结账调用让用户无需离开对话即可付款(截至 2026 年仍为测试版,且只限部分市场)。这是一种全新的同意界面,不是后台细节。对话内付款把熟悉的审查—确认—付款仪式压缩为一个瞬间,所以设计责任更重:承诺必须在发生前明确无误,发生后还应可干净撤销。这就是概念 9 的意图预览和概念 11 的修复应用到金钱。
- **分发。**触达 ChatGPT 用户群是优势,锁定单一主机是代价。
设计规则与概念 14 相同:先面向开放基础(MCP Apps)构建,让界面能够跨主机移动;再检测供应商附加功能(商店列表、结账流程),并在其他地方优雅降级。若只围绕单一供应商附加功能构建,界面就会被困在一个主机。
本附录提供设计层定位。真正构建时,请前往负责相应内容的课程:支持支付的智能体讲解结账机制,连接器原生应用和智能体插件讲解搭建 MCP 服务器。对于商店、付款和套餐细节应保持谨慎,因为供应商产品会频繁变化;依赖之前请以 OpenAI Apps SDK 文档确认。
附录 C:智能体体验简报(可填写模板)
这是概念 18 的交付物,已留空供你使用。复制它,在顶部填写一个工作者的名字,再完成每个字段。某个字段难以回答,正说明简报揭示了一项尚未做出的设计决策,请去做出它。由于每个字段都是具体问题,该模板也能作为生成提示:交给智能体起草第一版,或用作智能体工厂流水线为每个新工作者填写的规范。整份简报应控制在一两页内;过于冗长的简报无人会持续更新。
智能体体验简报:Worker name: ____________________________ · Owner: __________________ · Date: __________
1 · 两类受众 · 概念 2
人类用户是谁?该工作者的智能体用户(其他工作者、编排器、外部服务)是谁?
____________________________________________________________________
2 · 初次接触 · 概念 5
如何引导新用户?工作者获得行动能力时如何重设预期?界面如何在不依赖视觉或鼠标时工作(以 WCAG 2.2 为底线)?
____________________________________________________________________
3 · 信任界面 · 概念 7
默认展示什么(第 1 层)?下面三层是什么:计划、原因 + 置信度、证据?
____________________________________________________________________
4 · 负担地图 · 概念 6
人保留什么?工作者承担什么?人如何看见并移动这条边界?
____________________________________________________________________
5 · 自主阶梯 · 概念 8
这个工作者的五个停靠点是什么?哪些行动永远固定为人类在回路中?
____________________________________________________________________
6 · 异步计划 · 概念 10
如何捕获意图、让进度可扫读、展示等待本身(延迟、成本)?哪些确切事件值得提醒?
____________________________________________________________________
7 · 恢复计划 · 概念 11
这里的“撤销”意味着什么?升级给人类的路径是什么?你要观察哪两个健康指标?
____________________________________________________________________
8 · 规模化运行 · 概念 12
如果同时运行多个工作者,机群视图展示什么?什么值得人的注意?观察哪种偏离信号?
____________________________________________________________________
9 · 机器界面 · 概念 13
该工作者暴露哪些连接器或 MCP 工具?按 AX 的访问、上下文、工具、编排来看表现如何?
____________________________________________________________________
10 · 安全界面 · 概念 16
该界面必须缓解哪些智能体特有威胁(注入、过度代理权、失控成本、泄露)?每项对应什么防御?
____________________________________________________________________
11 · 计分卡 · 概念 17
要跟踪哪些少量体验指标?工作者正确性评估从哪里接手?
____________________________________________________________________
附录 D:已填写的简报(实例)
下面是为实例中的客服退款工作者填写的附录 C 模板。请把它当作自己的模型:每个答案都是一项具体决策,而不是复述问题。若你的答案和提示一样模糊,说明仍欠下一项设计决策。
智能体体验简报。Worker name: Refund Worker · Owner: Support Lead · Date: 2026-07-01
**1 · 两类受众。**人类是监督退款的客服主管。智能体用户是把工单传入的公司编排器,以及工作者调用来转移资金的支付提供方 API。
**2 · 初次接触。**以“建议”模式发布:为主管起草退款,等待审批。升级到行动模式时,一次性横幅明确说明:“我现在会自行发放不超过 $50 的退款,不再只是建议。”每个控件(工单行、计划、撤销、升级)都能通过键盘访问,并由屏幕阅读器朗读;置信度使用词语,绝不只用颜色。
**3 · 信任界面。**第 1 层(默认):每张工单一行,“已退款 #4021,$38,置信度:高。”第 2 层:计划(读取订单 → 检查政策 → 退款 → 发邮件)。第 3 层:原因、依据的政策条款,以及高/低/不确定区间。第 4 层:完整轨迹和提供方原始 API 响应。
**4 · 负担地图。**工作者承担后勤负担(读取订单、应用政策、执行退款、发送邮件)。超过限额或标记为低置信度的事项由主管判断。“等待你处理”通道让分工一眼可见。
**5 · 自主阶梯。**1 建议 → 2 确认 → 3 在限制内行动(退款 ≤ $50)→ 4 行动并报告 → 5 自主。该工作者位于第 3 站。永远固定为人类在回路中的事项:超过 $50 的退款、任何拒付争议、任何带未解决欺诈标记的账户。
**6 · 异步计划。**意图是一张工单、一个目标。进度明确当前步骤(“检查政策……执行退款……”)。退款成本足够低,不需要成本表。只有三种事件值得提醒:超过限额的退款、低置信度政策匹配或提供方错误。
7 · 恢复计划。“撤销”是在每次退款后 24 小时内可用的一键反转。升级路径先到客服主管,再到值班财务负责人。观察指标:升级频率(目标约 5–15%)和恢复成功率(目标高于约 90%)。
**8 · 规模化运行。**十个退款工作者共享一个机群视图。“现在需要你”突出 $900 的争议,以及升级率环比翻倍的任何工作者;正常退款留在日志。偏离信号:反转率超过该工作者自身基线两倍时,自动降至第 2 站审查。
**9 · 机器界面。**访问:限定范围、可撤销、只能退款的商户凭证。上下文:准确说明退款何时有效的工具描述。工具:refund_order(order_id, amount, reason),带类型和 $50 硬上限。编排:按 order_id 幂等,因此重试绝不会重复退款。
**10 · 安全界面。**注入(LLM01):工单正文是数据而非指令,计划展示工作者读取了什么。过度代理权(LLM06):$50 上限加人类在回路中的固定项。无界成本(LLM10):退款受上限约束,不存在钱包拒绝服务路径。泄露(LLM02):凭证只能访问退款端点。
**11 · 计分卡。**跟踪计划接受率、干预率趋势、恢复成功率,以及节省时间与消耗注意力之比。工作者正确性评估(它能否在黄金数据集上正确应用退款政策?)在“决策是否正确”处接手,这是评估驱动开发的工作,而不是本简报的工作。
来源与延伸阅读
本课的综合观点借鉴、也质疑了该领域的当前研究。建议阅读原始资料:
- John Maeda 的《Simplicity and Agentic Experience (AX)》与《Design in Tech Report 2026: From UX to AX》:瞬移到目标的框架和 UX→AX 转变,即人类界面。
- Matt Biilmann(Netlify)关于智能体体验的观点:把智能体视为用户,机器界面由访问、上下文、工具、编排构成。
- Microsoft Design 的《UX design for agents》:空间 / 时间 / 核心原则、“多提醒、少通知”,以及“接受不确定性,同时建立信任”,这也是校准信任的起点。
- **Adrian Levy(CyberArk)**的《When the Agents Go Marching In》:界面→协作、认知负担分配、运营透明、异步体验、双重受众这五种范式,构成本课结构。
- Smashing Magazine 的《Designing for Agentic AI: Practical UX Patterns for Control, Consent, and Accountability》:意图预览、自主旋钮、请求人类干预、修复与补救,以及升级/恢复基准;精确区间应视为起点而非定律。
- Jakob Nielsen 关于第三种 UI 范式、《No More UI》和“告别无障碍”的挑衅性观点:控制中心反转、新设计对象(策略界面、置信传达器、系统性情),以及概念 5 回应的无障碍警告;也应结合那些认为智能体会增加而非减少人类触点的反驳来读。
- MCP Apps(SEP-1865,协议首个官方扩展,2025 年 11 月提出,并在日期为 2026-07-28 的 MCP 2026 年 7 月规范中定稿)与 Model Context Protocol 本身。智能体渲染 UI 的机制是:工具关联
ui://HTML 资源,并通过_meta.ui.resourceUri指明它;主机在沙箱 iframe 中渲染,界面与主机通过可审计的 JSON-RPC 消息通信。该机制由 MCP-UI、OpenAI(Apps SDK)和 Anthropic 团队共同构建,目前可由 Claude、Claude Desktop、VS Code、Goose、Postman 等渲染。可从概览(modelcontextprotocol.io/extensions/apps/overview)、本实验遵循的构建指南(modelcontextprotocol.io/extensions/apps/build)、SEP(modelcontextprotocol.io/seps/1865-mcp-apps-interactive-user-interfaces-for-mcp)、API 参考(apps.extensions.modelcontextprotocol.io)和 GitHub 上的ext-apps仓库开始。后者包含create-mcp-appskill、SDK 和大量示例。Claude 的生产发布及 Asana、Slack、Figma、Canva、Box、Hex 等交互连接器,请参阅claude.com/blog/interactive-tools-in-claude。编排、治理和状态按设计位于协议之上;规范明确把主机端沙箱、允许列表、同意和审计交给部署者负责。 - OWASP Top 10 for LLM Applications(2025):概念 16 背后的共享威胁目录,包括提示注入、过度代理权、错误信息、无界消耗等;设计响应逐项映射这些风险。
- NIST AI Risk Management Framework(AI RMF 1.0):治理 / 映射 / 衡量 / 管理结构,以及概念 16 治理界面背后的可信 AI 特征。
- Microsoft HAX Toolkit 与 HAX Playbook:发布前排练可能的人机失败并设计恢复路径,是概念 17 背后的纪律。
- W3C WCAG 2.2:概念 5 验收标准所依据的无障碍底线。