构建上下文层:从一个 Worker 的存储到整支 Workforce 的语料库速成课
15 个概念 · Onyx、MCP 与四类来源 · 由你的 agent 构建,而不是手工搭建
AI 可搜索上下文 为一个 Worker 建立了自己的存储。本课程构建整支 workforce 共同读取的语料库。
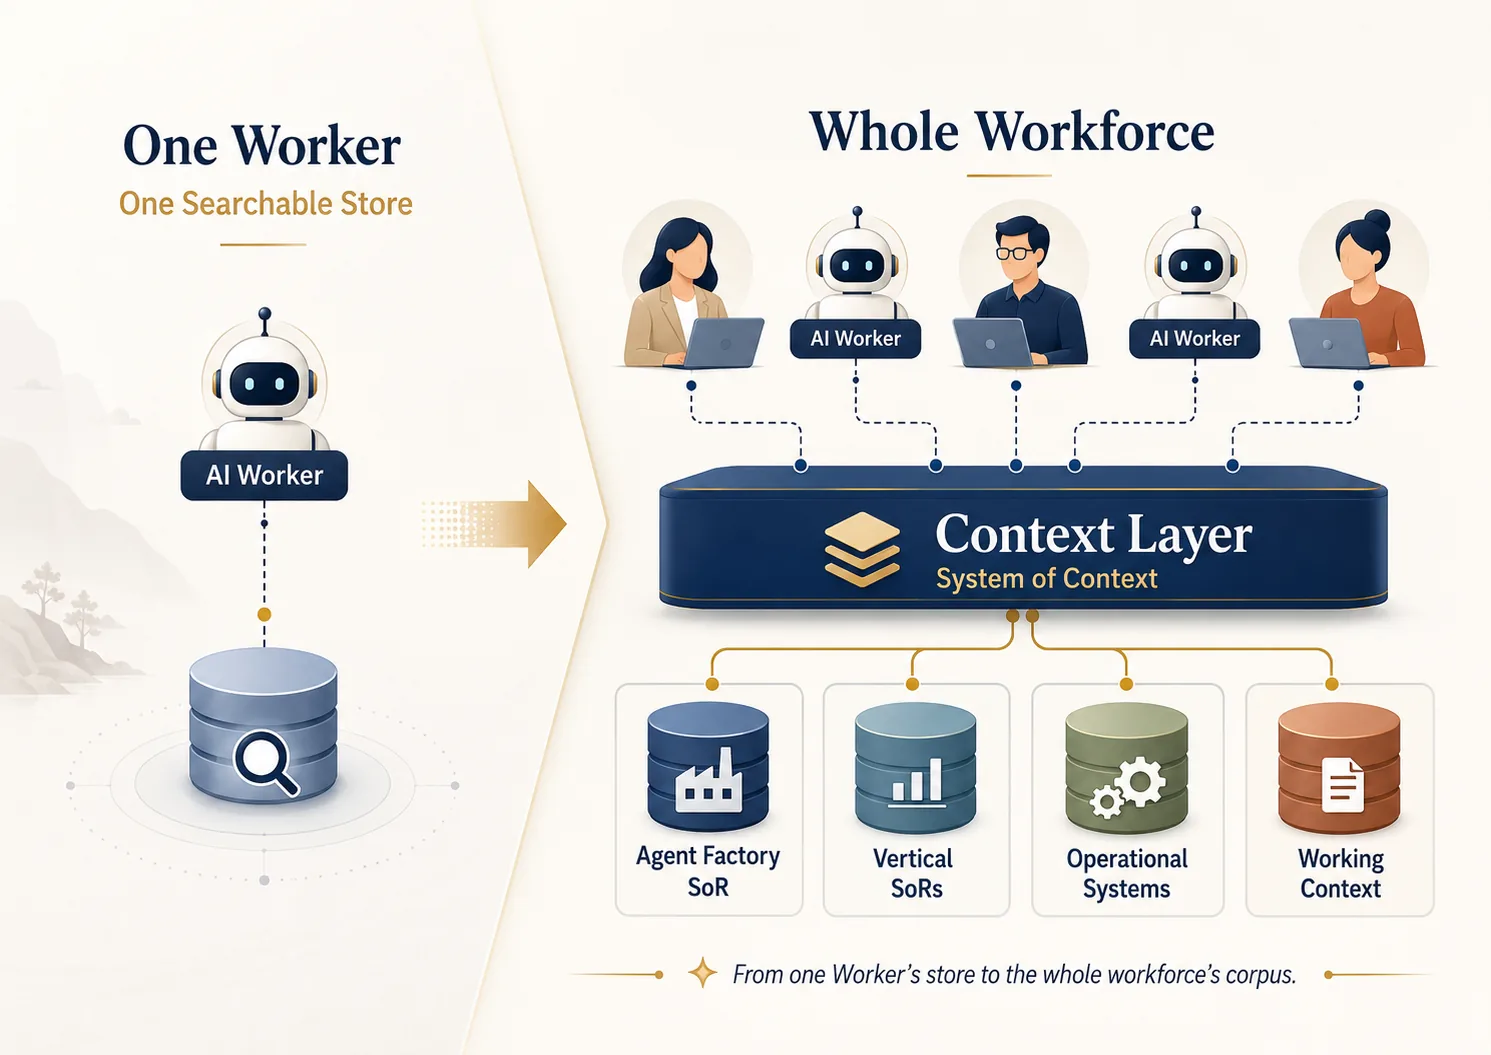
在 AI 可搜索上下文 中,你为一个 Worker 建立了自己的存储:由你控制的文档经过分块和嵌入,可以按语义搜索,并存放在你掌控的一套 Neon Postgres 中。你甚至把它包装成 MCP 工具,让其他 agent 也能调用。
但它仍然只是一个有明确边界的存储,而边界完全由你划定。其中的每份文档都由你选择。谁能够访问,也由你决定。没有任何内容会在你未放入的情况下自行出现。
现在,走进一家客户公司的办公楼。
他们二十年的工作底稿放在 SharePoint。委托函散落在邮件里。某项决定为何作出,藏在一段聊天记录里,也藏在一位正在出差的经理脑中。当前余额位于一个每小时都在变化的系统中。没有一样属于你的存储;完成工作却一样也不能少。
本课程要构建的,就是能够触达这一切的层,并围绕一家真实公司确实会问的问题来搭建它。
Northstar Services 想要 20% 的折扣,希望现在开票,还希望本季度确认实施收入。可以吗?
这是一个客户的一句话,却不是一个问题。它同时包含销售问题、会计问题、实时状态问题,以及邮件里的一条传闻。要正确回答,必须始终把这四者分开。课程结束时,一个 Worker 会妥善回答它:附带引用;实时获取当前事实;把邮件标记为证据而非权威;并把两项专业判断彼此分开,而不是混成一个听起来令人愉快的「可以」。
先解释三个词,以防它们对你来说还很陌生。Connector 是读取某个源系统并持续更新其内容副本的组件。Indexing 是存储这个副本,使其可被搜索。Permission inheritance 是把每份文档在原系统中的访问规则带进每一条搜索结果,确保读者看到的始终只是自己原本就能打开的内容。
一个观念就能让整门课豁然开朗。 上一门课只有一个问题:正确的 chunk 是否进入了 context window?本课程有三个问题,而且每个概念都服务于它们。对于这一层返回的每一项内容,都要问:
它来自哪里?这个人可以看吗?它现在仍然有效吗?
搜索框一个也回答不了。上下文层则对每一项内容、每一次查询都回答这三个问题。这就是二者的全部差别,也是为什么这是一门完整课程,而不是一个配置文件。
| 词 | 通俗含义 |
|---|---|
| System of Record | 正式保存某项内容的系统。如果副本与它不一致,错的是副本 |
| Vertical | 某一种职业或行业,例如会计、法律或销售工程。与通用型相对 |
| Authority class | 一项陈述属于哪一类,因此应有多大权重:法律、标准、合同、政策、交易、指南、消息或示例 |
| Working context | 一家公司日常产生的材料:邮件、聊天、草稿、文件。它们真实且有用,但绝不是规则 |
| Connector | 读取一个源系统并持续更新其内容副本的组件 |
| Sync | Connector 的一次运行,获取自上次以来发生的变化 |
| Index | 这一层保留的可搜索副本,用于快速查找内容 |
| Corpus | 这一层可以搜索的全部内容,横跨每个已连接来源 |
| Fixture | 为练习创建的虚构但逼真的文件,因此不会让真实数据承担风险 |
| Document Set | 一组有名称的 connector,用于规定一次搜索可以查看哪些来源 |
| Onyx Agent | 在 Onyx 内配置的 assistant,包含指令、知识和工具 |
| Action | Onyx Agent 可以调用的工具,例如你自己的搜索或实时查询 |
| Canonical | 原始、正式的副本,与从它复制出来的任何副本相对 |
| Projection | 受治理内容的可搜索副本,只为帮助 Worker 找到原始内容而保留 |
| Stable ID | 一条规则的永久名称,让副本能够指回原始记录 |
| Superseded | 已被更新版本替代,因此不再是当前适用的规则 |
| Gateway | 位于 Onyx 前面的自有代码,决定当前用户可以搜索什么 |
| Packet | 为一个问题组装的一包规则、事实和证据 |
| Envelope | 附在一项内容上的标签:它来自哪里、版本是什么、为什么允许你查看 |
| Provenance | 一项信息来自哪里的完整故事 |
其他新词都会在第一次出现时解释。
本课程假设你已经完成 AI 可搜索上下文。你应当已经在 Neon 上拥有一套使用 pgvector 的可运行 RAG,知道什么是 chunking 和 embedding worker,并且能够用 eval set 判断检索质量。保留那套 Neon 项目。 你会在这里复用它的基础设施和检索技能。不过,也要清楚它构建了什么、没有构建什么,因为二者的差别正是本课程的主题。
上一门课构建了一个有边界的检索存储:文档、chunk、embedding、搜索函数、回答函数和 eval set。它教会你如何把文档变成可搜索知识,但没有赋予这份存储专业权威性。其中没有 authority class、jurisdiction、effective period 或 supersession link。因此,在 概念 10 中,你会在原有结构旁增加一个小型 governed schema,而 概念 10 构建的正是访问它的路径。本课程还假设你学过 Agentic Coding,能够在 plan mode 下指挥 Claude Code 或 OpenCode;也学过 Skills 与 Connectors,了解 MCP。
本次构建背后的概念页面是 System of Context。如果想先理解论证,请先读它。本课程是工厂现场,而 Northstar 是该页面分解过的同一个贯穿案例。
下面是一页看清整个系统的地图。每落地一个概念,你都会逐步长成图中的样子:
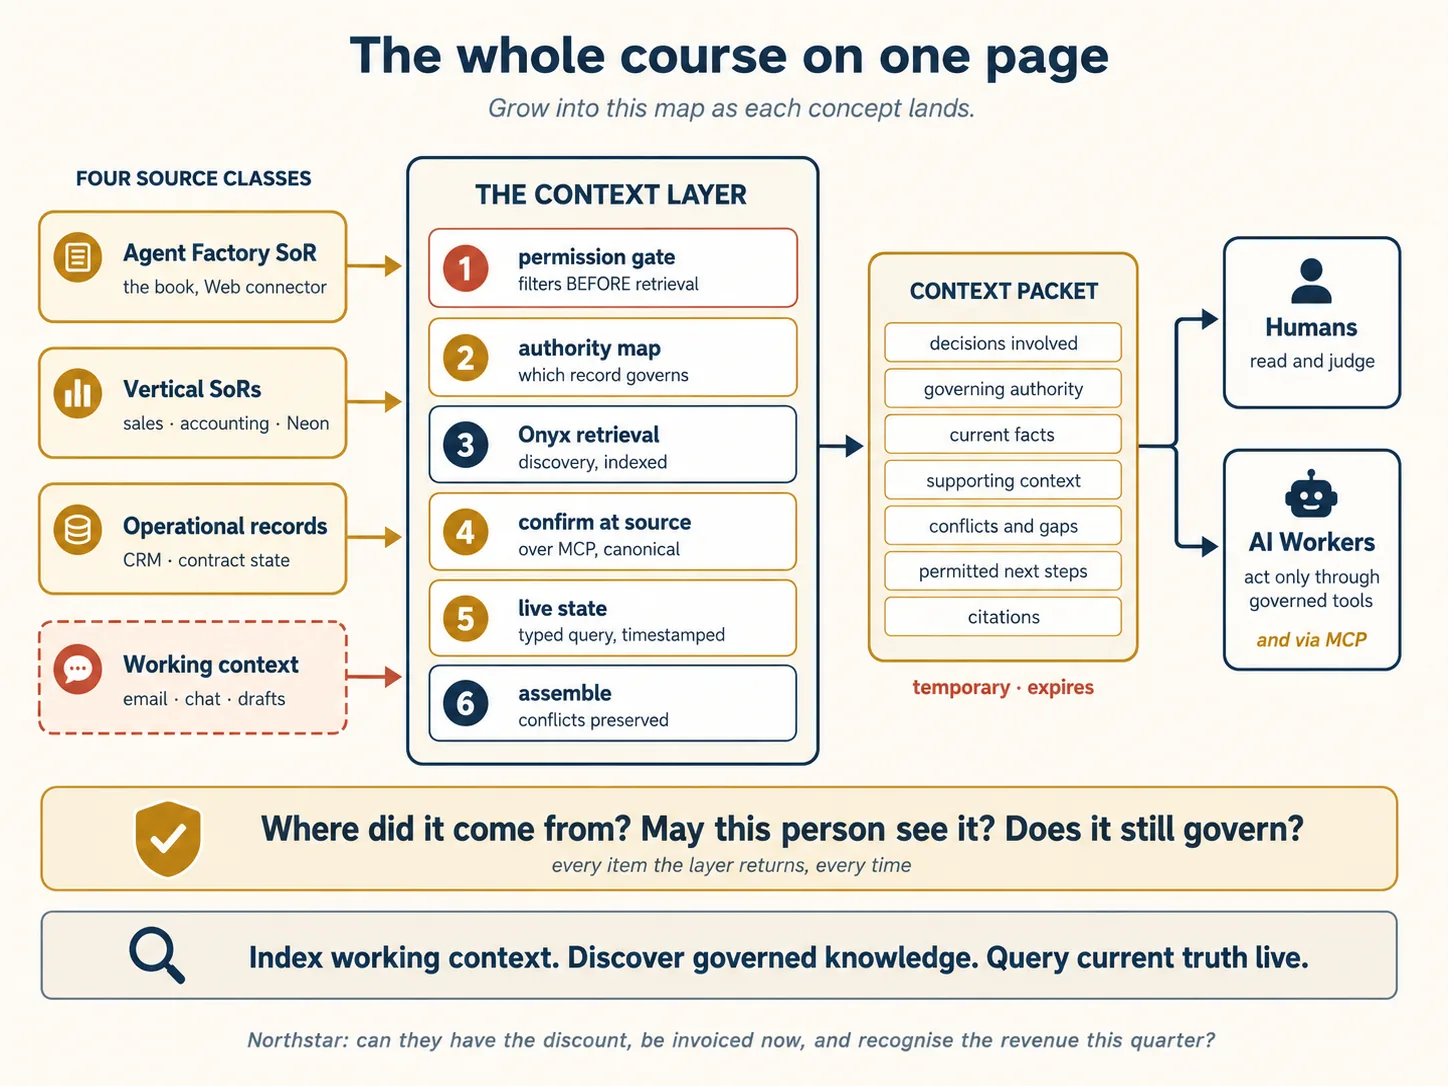
本课程涵盖什么
| 部分 | 主题 | 你将学到什么 |
|---|---|---|
| 1 | 基础 | 范围跃迁、四类来源、Onyx Standard、一种模型与搜索基线 |
| 2 | 你的第一份语料库 | 把本书作为共享方法、Northstar fixtures、Document Sets、chunker 与 permission gate |
| 3 | 受治理的一半 | 通过 MCP 提供你的 Neon 记录、发现与确认的区别,以及实时状态 |
| 4 | 路由与引用 | 先于 prompt 编写 authority map、七段式 packet,以及绝不能混合的冲突 |
| 5 | Northstar 案例 | 端到端完成整个构建,然后故意用四种方式破坏它 |
| 6 | 证明它 | 八个 eval 维度,以及为什么回答问题的模型不能为自己评分 |
| 7 | 提供服务并运营 | 为每个外部 Worker 提供同一 gateway,然后管理 connector 健康度、升级与完成定义 |
一套正在运行的 Onyx Standard 部署,连接四类来源并始终把它们分开。本书本身会作为共享方法被索引。两份 Northstar Vertical 记录,一份属于销售,一份属于会计,并让它们以一种有用的方式产生分歧。一个用于当前客户状态的实时 MCP server。你自己的 Neon 记录通过 MCP 提供,永远不被爬取。一份带版本的 authority-map.yaml,明确哪份记录治理哪类问题。一个 Context Router,每次都返回同样七个 section 并附带引用。一个由你亲手编写的 permission gate,并用一个正确答案为「什么都不返回」的角色测试。一个按八个维度评分的 eval set。最后还有 Context Gateway MCP endpoint,让获授权的外部 Worker 通过同一 identity 与 permission 边界查询共享语料库。
阅读方式。 第 1、2 部分与 第 5 部分 的 Northstar 构建组成完整系统,阅读约需两小时,键盘上的实际构建还需数小时。第 3、4 部分让它不只是能运行,而且值得信任,二者都不能省略:第 5 部分 会把每一个概念真正跑一遍。如果想先动手、之后再补为什么,请从 第 5 部分 开始。
📚 教学辅助材料
本课程的幻灯片正在准备中。
设置环境(只需一次)
你构建的一切都放在同一个文件夹里,而且已经预先接好线。
解压后,里面已有完整的 Northstar 案例等待连接、待填写的治理文件,以及三套 MCP server 骨架;其中困难部分都标为 TODO:
fixtures/          two governed records, live state, working context
                   plus PLANTED.md, the answer key for Part 5
governance/        authority map, model register, permission matrix,
                   production gates, boundary contract
mcp/               vertical_sor, customer_state, context_gateway
prompts/           the Context Router instruction file
evals/             ten cases, scored on eight dimensions
scripts/           the governed schema for your existing Neon project
AGENTS.md          the standing rules your agent reads every session
.env.example       every credential this course needs, and nowhere else to put them
cd context-layer-base
cp .env.example .env
本课程处理的凭据比上一门更多,而每一项都可能让你在一次 commit 中失去客户信任。
| 密钥 | 它能打开什么 |
|---|---|
| Neon pooled connection string | 你的 governed record |
| Model provider API key | 你的模型开支 |
| Onyx admin login | 整份语料库 |
| Onyx API key | 搜索能力,权限等同于该 key 所代表的身份 |
| Onyx MCP token | 可选,仅用于 第 7 部分 的原生 endpoint 对比 |
| Context Gateway tokens | 每个角色一个,在 server 端映射。它们就是 permission 边界 |
除 Onyx admin login 应保存在密码管理器中外,所有这些都放在 .env,而 .gitignore 已经排除该文件。它们都不应出现在你提交的文件、粘贴的 prompt 或展示给同学的终端截图中。
明确告诉 agent:从环境中读取凭据,绝不把它们写入要提交的文件,也绝不打印。然后在批准前检查 diff。
开始前要花多少钱。 如果你完成过上一门课,则无需额外花费。
| 项目 | 成本 |
|---|---|
| Onyx Community Edition | 免费,MIT 核心 |
| Neon | 免费套餐,无需信用卡 |
| 模型提供商 | 免费套餐足够完成本课程 |
需要多少时间。 第 1、2 部分约需两小时阅读,再加两到三小时键盘操作。概念 4 的安装大约等待 20 分钟,主要时间花在拉取镜像。第 5 部分 的 Northstar 构建要用一整天,如果这是你的第一个 MCP server,时间会更长。不要试图一次坐完。较好的拆分方式是:先完成 Onyx 和 connectors;再完成 governed record 与两套 MCP server;最后完成 gateway 与 Router。每一组本身都是一课,把三组都塞进一个晚上,只会让人误以为自己不擅长这件事。
除了这个文件夹,机器上还需要三样东西。Docker,因为 Onyx 以一组 container 的形式运行;uv,用于 Python 部分;以及你的 agent。在该文件夹中打开它:
cd context-layer-base
claude
cd context-layer-base
opencode
开始之前先记住一个警告,因为它决定了你应在哪里运行本课程。
Onyx 是真正的基础设施。 一次 Standard 部署会同时启动大约 12 个 container:Web 前端、API 后端、nginx proxy、Postgres、search index、Redis、object storage、两个模型 server(一个用于 indexing,一个用于 inference)、code interpreter,以及后台 sync worker。
它需要数 GB 内存。在配置一般、同时还开着其他应用的笔记本电脑上,体验并不好。因此有三种处理方式,按课堂使用的推荐顺序排列:
| 方式 | 最适合 | 成本 |
|---|---|---|
| 由机构运行一套共享实验实例 | 整个班级,共同连接一套人人可访问的 Onyx | 一台机器,只部署一次 |
| 本地最小部署,只开一个 connector | 需要观察内部结构并阅读代码的那一周 | 你自己的内存 |
| Onyx Cloud 试用 | 单周课程,或无法运行本地部署的笔记本电脑 | 14 天试用,无需信用卡 |
即使平时使用实验室共享实例,学习内部机制的那一周也要在本地运行。边看 connector 代码边观察一次 sync,是任何托管服务都无法替代的课程。
第 1 部分:基础
在安装任何东西之前,先掌握四个观念。
上一份存储很小也很安全,因为一切都由你控制。公司的来源并非如此。它们分为四类,把这些类别混在一起,是整个构建中代价最高的错误。你将使用 Onyx;它擅长查找内容,却不擅长判断什么是真的。Onyx 还提供两种安装模式,其中一种会悄悄关掉本课程真正要讲的部分。
1. 范围跃迁:从一个存储到所有人的来源
阅读时请一直把 Northstar 的问题放在心里,因为上一套构建根本无法触及它。
Northstar 能否获得 20% 的折扣、现在开票,并在本季度确认收入?
你的 Postgres 存储根本不知道 Northstar 是什么。它不知道谁批准了什么、客户何时完成验收,也不知道销售经理上周二在邮件里说了什么。这不是原有构建缺了一块,而是另一类系统。
你的存储有四个属性,你可能从未注意过,因为以前无需考虑它们。
其中的一切都由你编写。 每份文档都来自你的 docs/ 文件夹,没有任何内容会在你未放入时出现。它只有一位读者。 你的 app 允许什么,这个存储就允许什么。它只有一种真相。 其中所有内容都是你写的文档,每份文档权重相同。这里没有实时余额、已签署义务或某人在邮件里的意见,也没有哪份内容被一个你从未看到的新版本悄悄替代。并且,它在设计上天然保持最新,因为只有你的 worker 会写入。
一旦连接一家公司,这四个属性会同时消失。
现在内容属于客户,其中有些错误,有些已经失效。现在,一位刚入行的初级员工和一位合伙人问同一个问题,必须得到不同答案。现在,语料库里同时有已签合同、政策备忘录、聊天消息与实时发票状态,它们的权重天差地别。现在,你周二索引的文档可能在周三被某个永远不会通知你的人替换。
Northstar 让这四点都变得具体。合同和 CRM 属于客户。销售专员与销售副总裁对折扣问题必须得到不同答案。已签合同、政策备忘录、邮件和实时批准状态的权重完全不同。而在 Worker 组织答案期间,批准状态本身可能已经变化。
这就是范围跃迁,也是为什么本次构建必须换一种形状。
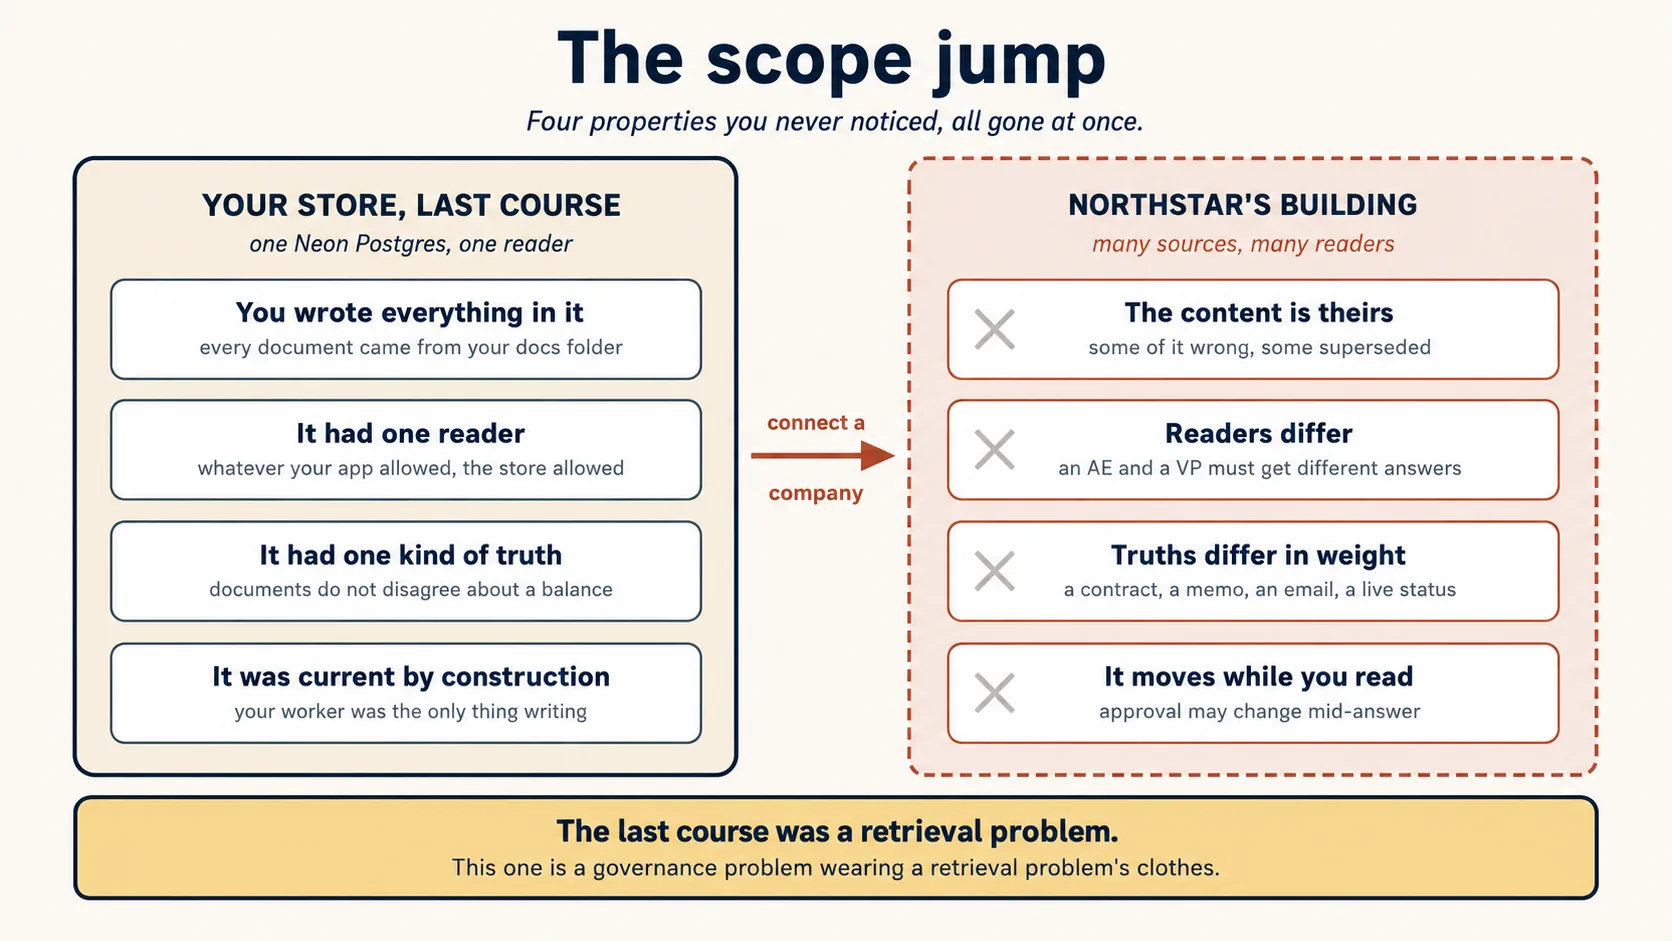
上一门课是检索问题。本课程是披着检索问题外衣的治理问题。
你在这里的工作和过去一样:指挥 agent,并判断它产出的内容。但判断对象已经变化。你不再主要问「它是否找到了正确的 chunk」,而是问「每一项返回内容是否说明了来源、这位读者是否有权获得它,以及是否有任何步骤确认它现在仍然适用」。
2. 四类来源,以及它们为何以不同方式到达
本次构建中代价最高的单一错误,是把每个已连接系统当成一堆没有区别的内容。连接任何来源之前,先把它们分成四类,因为类别决定内容如何获取,也决定 Worker 可以如何使用它。
| 类别 | 示例 | 到达方式 | Worker 可以引用吗? |
|---|---|---|---|
| Agent Factory System of Record | 共享方法与标准 | 通过 Web 索引用于发现,引用 canonical 页面 | 可以,作为共享方法 |
| Vertical Systems of Record | Northstar 的销售与会计规则,存于你的 Neon 记录 | 索引用于发现,然后通过 MCP 确认 | 可以,作为治理规则 |
| 客户 operational records | ERP、CRM、总账、合同系统 | 实时类型化查询,从不索引 | 可以,说明自身状态,并附时间戳 |
| 客户 working context | 邮件、聊天、文件、项目跟踪器 | 感知权限的索引 | 可以作为所说或所做之事的证据,绝不能作为规则 |
这张表有两点必须记住。
前三类都具有权威性,只是分别治理不同问题。一种常见的供应商话术说,传统记录「只存数据」,而上下文层负责解释。不要在财务总监面前复述这句话。他们的 ERP 会执行交易完整性、审批限额和审计追踪,正是这些控制让企业得以运营。二者的差距在于范围,而不是严肃程度:ERP 对自己的领域很完整,只是对周围的专业问题保持沉默。
只有第四类缺少治理专业问题的权威性。 注意这里的精确用词。邮件和聊天往往还受其他规则治理,例如访问控制、保留规则、隐私政策、诉讼保全和记录管理要求。它们缺少的是裁决专业问题的权威。
偏偏所有人最先都会把搜索工具指向第四类来源,所以许多试点项目给出了流畅的答案,背后却没有任何依据。
Glean 为第四类以及第三类中的许多系统提供原生 connector,对于未覆盖的系统还提供 Indexing API。你可以定义一个 custom datasource,推送包含正文、metadata 和权限的文档,然后在管理控制台激活它。
Glean 不会替你决定四个类别。它确实会为每个 datasource 标注类别,例如 KNOWLEDGE_HUB、EMAIL、MESSAGING、CRM、TICKETS 等十多种,但这些类别只会调整排名以及结果在页面上的呈现方式。它们没有一个会说明某个来源能否被引用为治理规则。每个来源属于哪一类,因此 Worker 可以把它引用为什么,仍然是你的设计决策。 Onyx 让你亲手建立隔离,因此你会切身体会这一点。Glean 允许跳过这个过程,恰恰因此,不少 Glean 部署最终也变成了扁平的一堆内容。
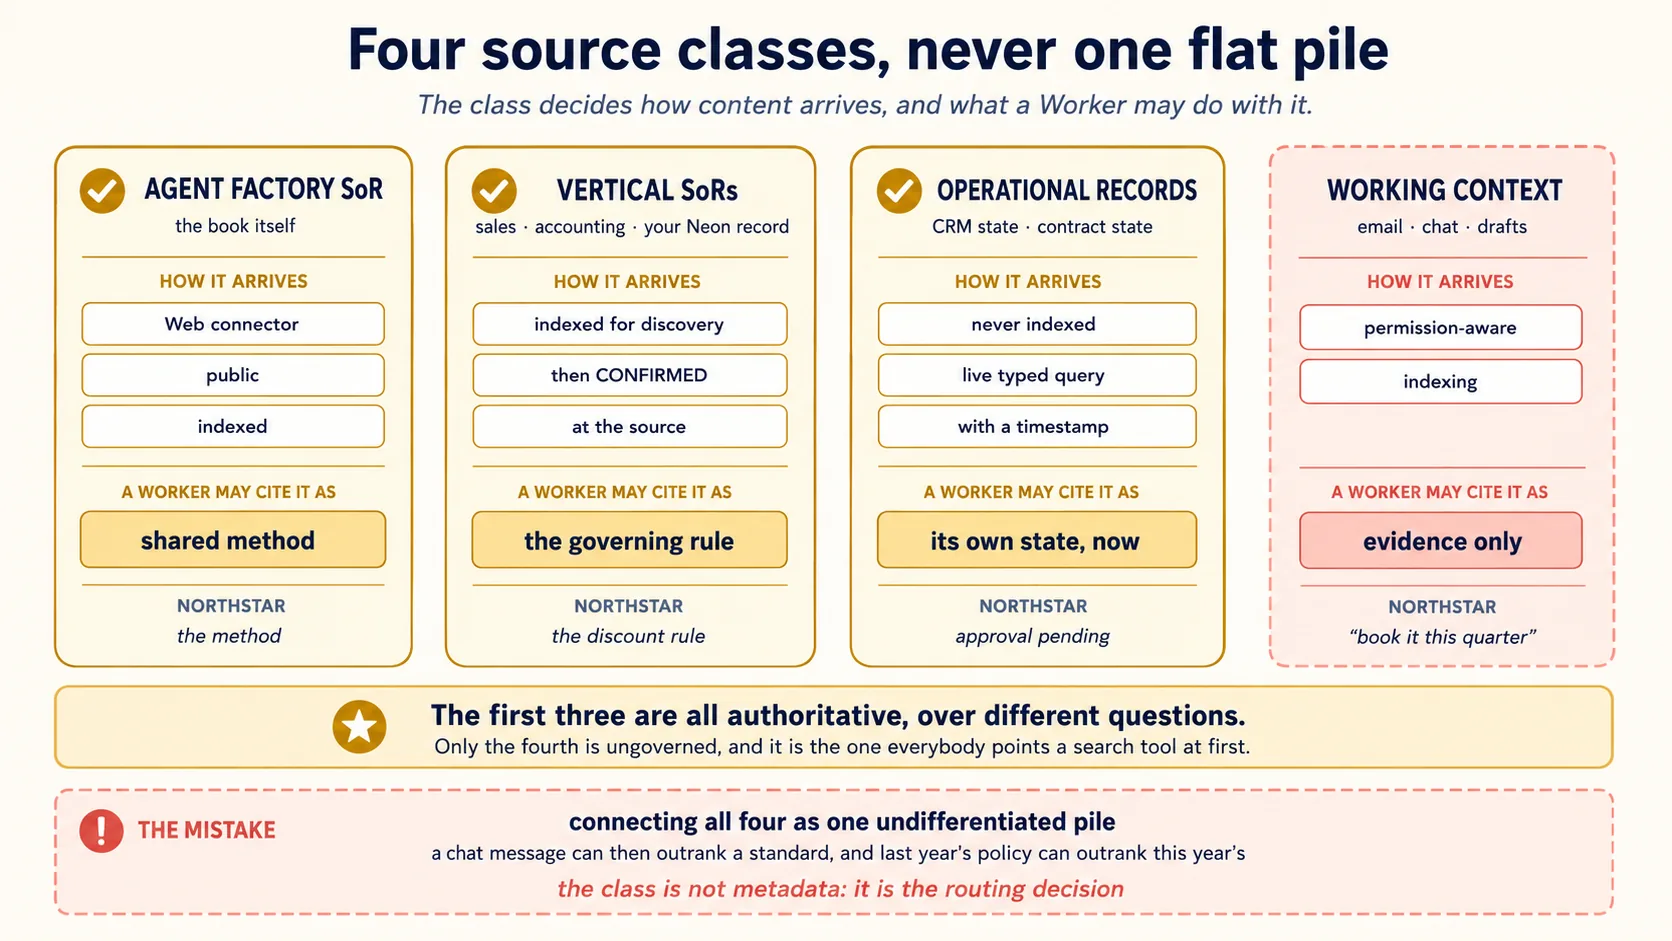
关于这四类来源的完整论证,以及为什么前三类分别对不同问题具有权威性,请参阅 权威分布在多份记录中,并受范围约束。
无论你从事什么职业,都要在第一个 connector 运行前,为自己的真实来源写出这张表。它会成为 概念 12 的 routing map。
3. Onyx 是什么,又不是什么
Onyx 将自己称为「连接你的文档、app 与人员的开源 AI chat」。本课程把它视为 System of Context 的开放参考实现;这个定位来自本书,而不是 Onyx 自己。它连接许多来源,保留同步副本,按语义和关键词搜索,返回带引用的答案,并暴露 agent 与 action。其核心采用 MIT 许可证,也真正支持自托管。这正是本课程选择它的原因。你可以阅读 connector 代码、观察一次 sync 运行,并看到 permission check 在哪里触发。它也确实在真实公司中以真实规模运行,因此你在这里学到的东西在面试中也能被识别。
它不是什么,有三点;每一点都对应你要亲手构建的内容。
它不是你的 System of Record。 Onyx 保存用于查找的副本。你的 governed record 保存用于引用的原件。这就是 唯一法则:这一层携带权威,却从不持有权威。如果把方向弄反,即使语料库看似保持最新,Worker 仍可能从一份从未收到更新的索引里引用去年的规则。
它不是 permission system。 在产品版本支持的范围内,它会继承权限,但不会自行执行你所在专业领域的控制。第 2 部分 会认真处理这个问题。
它不是答案。 一条 retrieval hit 是一个指针,只是在说「去这里看」。把指针变成答案还需要第二步,而 概念 10 就是那次调用。
还有一样东西根本不属于 Onyx,却比 Onyx 自身的任何行为都更快破坏你的构建:
你的 Worker 运行在语言模型上。如果检索没有给出内容,模型会用自身知识回答专业问题。输出看起来和有依据的答案完全相同,也不会出现任何错误提示。
模型没有来源,只有权重。它的答案背后不存在可查的 register row:没有出版者、authority class、jurisdiction、version 或 effective period,也无法在其中纠正某一条陈述。听起来可信不等于具备 provenance。
因此,构建时要留意三种悄无声息的泄漏:
- 填补缺口。 检索没有返回有用内容,模型仍自行作答。
- 漂移的改写。 模型检索到了正确规则,却在复述时丢掉了阈值或条件。
- 持久记忆。 一个会在 session 之间携带事实的模型,已经变成无人负责、没有版本的存储。
解决办法是结构性的,而不是再写一条 prompt。缺失证据是 packet 中的明确字段;找不到治理来源的 Worker 会升级问题,而不是继续执行。完整论证请见 概念页面。
完成标准: 不看资料也能说出这三个问题分别由什么回答;哪一个由 confirmation call 解决;哪一个由 permission gate 解决;以及哪一个解释了为什么你的 Neon 记录必须留在索引之外。
Glean 是最知名的商业化 System of Context。即使本课程不会部署它,也值得花一个小时了解。
原因有两个。第一,Glean 在当前 enterprise AI 市场中普及了 system of context 这一说法,并用它称呼自己的企业数据层。本书有意采用这一说法,让毕业生走进采购方办公室时,说的是对方已经在用的语言。Glean 是否发明了这个词是另一个问题,不值得在这里断言。第二,市场正是通过它为这一层定价。公司可能会提出「enterprise AI search」「work assistant」「AI knowledge layer」或「enterprise context platform」。它们都指向这个类别,而坐在你对面的人几乎肯定看过 Glean 的演示。
因此,把它的产品页面当作诊断材料,而不是教条。只问一个问题:
产品真正实现了本课程架构中的哪些部分,又悄悄把哪些部分留给了你?
用这个问题检查它的 connector 列表、permission model、citation format 和 action surface。你会看到相同的四类来源、相同的 permission 问题,以及你即将围绕它构建的相同 discovery 与 confirmation 缺口。
阅读时养成一个习惯。这个类别被反复改名,不同分析机构甚至会同时使用不同名称:insight engine、cognitive search、enterprise AI search、generative AI knowledge management。学习这一层,而不是某个 logo。 开篇的三个问题比列表中的每个产品名称都活得更久。毕业时,无论市场上出现什么产品,你都要用它们来判断。
从这里开始,大多数概念末尾都会有一段简短的**「在 Glean 中」**。它说明同一观念如何出现在商业产品中;更重要的是,哪些部分由 Glean 替你完成,哪些部分无论如何仍是你的设计工作。 你不需要拥有 Glean 账号,但应当能够走进会议室,准确说明两个产品的共同点与区别。
那么,为什么选择 Onyx,而不是 Glean?
这个问题的诚实答案有三条,只有第一条和产品本身有关。
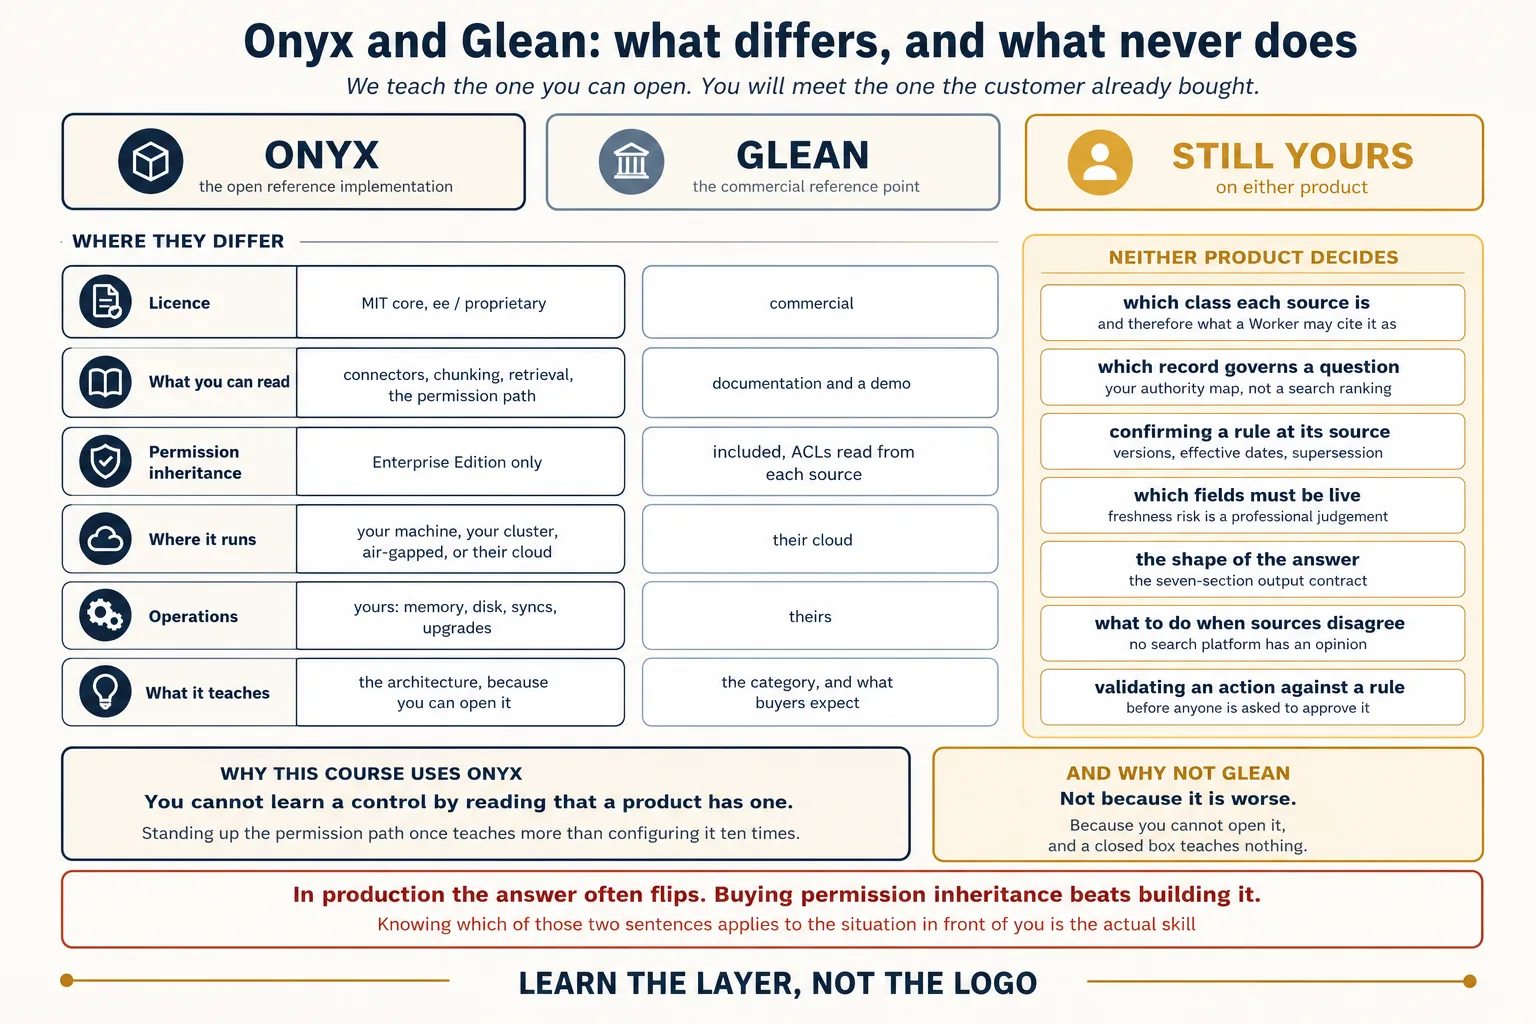
第一,你无法通过阅读「产品具有某项控制」来学会控制。 Glean 的 permission model 比你在 概念 9 中构建的更好,但它也是不可见的。你完成配置,它开始工作,然后这一周结束时,你只知道权限「发生了」,却不知道它没有发生时会怎样。哪怕先笨拙地搭出一次 permission path,并用一个什么都拿不到的角色测试,也比配置十次完善方案更有教育价值。
第二,封闭盒子教不了架构。 本课程的每个概念都能在 Onyx 中打开查看。你可以阅读 connector 代码,观察 chunker 丢掉 12 项控制,把搜索指向一个过时分支,再看带着完美引用的错误答案出现。产品页面无法让你做这些事。
第三,也是学生最容易忽略的一点:本课程的大部分内容根本不关乎产品。 看看上图的金色列。你构建的七件事,Onyx 和 Glean 都不会替你决定,因为它们是专业判断,不是平台功能:来源属于哪一类、哪份记录治理某个问题、规则是否仍然有效、两个来源冲突时怎么办。如果课程改用 Glean,这七件事仍要完全一样地教,只是你更难看到它们下面的三项机制。
客户什么时候应该改用 Glean?
很多时候都应该。请直说,因为装作不是这样,会让你在第一次会议中就失去客户信任。
如果公司下季度就需要跨十几套 SaaS 系统继承权限,购买远胜自行构建,两者根本不在一个量级。如果没有平台团队,托管也胜过自托管。如果公司已经购买 Glean,你的工作不是提一份迁移方案。你的工作是把他们的 governed record 接入其中,并告诉他们当前设置真正回答了三个问题中的哪几个。 这比重建更适合作为第一次谈话,而且只有真正理解这一层的人才能开展这种谈话。
因此,整门课程的规则是:
我们教授你能打开的产品。你会部署客户已经购买的产品。两者架构相同,而架构才是唯一真正属于你的部分。
4. 安装 Standard,而不是 Lite
Onyx 提供 Lite 与 Standard 两种部署模式,选错会浪费你一天。
Lite 是一个小型 chat 界面。它会禁用 vector index、后台 connector worker,以及本课程要教授的整套基础设施。选择 Standard。
安装程序使用 Docker Compose 部署,并询问你选择哪种模式。具体脚本会变化,所以让 agent 阅读当前文档,不要凭记忆猜测:
阅读当前官方 Onyx Quickstart 和 Resourcing 页面。根据文档要求,检查本机的 Docker CPU、RAM 和可用磁盘。在本课程中安装最新版稳定 Onyx Community Edition,使用 Standard 模式并仅绑定 localhost。在
README.md中记录准确的 Onyx 版本、安装方式、端口和持久数据位置。不要选择 Lite。启动任何 container 前,先把计划与资源检查结果给我看。
只有当计划明确写出 Standard 并注明持久数据位置时才批准。启动后:
检查正在运行的 Onyx container 和日志。报告哪些服务健康、哪个端口提供 UI,以及是否有反复出现的错误。除非先解释原因并展示准确命令,否则不要 restart 或 recreate 任何东西。
如果分给 Docker 的内存太少,Onyx Standard 的搜索与索引服务会重启、卡住或无法通过健康检查,而且每种症状看起来都和配置错误一模一样。
不要在只给 Docker 4 GB 内存的机器上花一小时调试配置。
本地实验可用的最低 Standard 配置是 4 个虚拟 CPU 和 10 GB RAM。8 个 CPU 与 16 GB 会更舒适。永远先确认资源。
阅读计划。 要求列出 container 不是为了考冷知识。读完计划后,你至少要能说出三种 container:最吃内存的 vector index;首次启动较慢的 model server;以及后台 sync worker,悄悄失败的 connector 往往就藏在这里。它们是之后最容易让你意外的三处。
注意: 首次启动要拉取数 GB 镜像,model server 也要几分钟才会就绪。这是预期行为,不是卡死。如果 stack 已启动但搜索没有结果,通常是还没有 connector 完成第一次 sync,而不是系统损坏。如果某个 container 循环重启,先检查内存,再检查配置。
完成标准: 你能打开 Web 界面,以第一位 admin 用户登录,并知道哪一条命令可以拆掉整个 stack 并回收磁盘空间。
你无需安装任何东西。Glean 作为托管服务运行,可以在 Glean 自己的基础设施上,也可以作为单 tenant 部署在你的 GCP 或 AWS 账号中;即便是后一种模式,也由 Glean 部署并打补丁,而不是你。因此,整个概念都会消失,随之消失的还有 container 清单、内存计算与 第 7 部分 的磁盘监控。
这就是交换,值得直接说清楚。你付费免去了运营,也放弃了阅读代码的能力。亲手搭过一次 Onyx 的学生知道 vector index 要消耗多少资源,也知道 sync 会在哪里悄悄失败。只用过托管产品的学生两者都不知道,更容易相信供应商所谓「很简单」的说法。
有意只选一个模型
Onyx 将上下文平台与语言模型分开。在 Admin Panel 中配置一个能力足够的提供商,并让可见模型列表保持简短:你来这里是评估上下文层,不是比较 10 个 chat 模型。然后让 agent 编写 governance/model-register.md,记录提供商、模型、日期、数据处理假设、谁能看到它,以及选择原因。再加一个字段:
替换测试。 更强的模型会改善工具使用与答案组织,却无法修复缺失的 connector、错误的 authority routing、过时的 operational fact 或损坏的 permission 边界。这些都是上下文层故障,升级模型一个也碰不到。把这句话写进 register,避免未来的你在压力之下忘记。
调优前先建立搜索基线
上一门课教过检索底层机制,让你能够判断它。现在 Onyx 把这些机制包装好了。不要立即替换 embedding 模型或打开每个实验性选项,因为更换 embedding 模型会强制完整 re-index,绝不是一个无关痛痒的开关。先使用稳定默认值,并记录 governance/search-baseline.md:Onyx 版本、embedding 模型、reranking 配置、基线日期、eval set 版本和原因。
上一门课的规则会以适合上下文层的形式延续:评估 retrieval 变更,而不是欣赏它们。 Onyx 隐藏了 SQL,却没有消除对证据的需要。
运行 /init,把生成内容精简为四行:你连接的是哪套 Onyx 实例;所有凭据都放在环境中,绝不进入 repo;本课程绝不连接真实客户数据;以及一条值得完整写下的硬规则:
绝不要连接本 session 中未经我明确批准的来源。
Connector 是复制他人数据的长期指令,应当接受与破坏性 SQL 同等严格的审查。
第 2 部分:你的第一份语料库
现在连接真实内容,并观察内容进入系统后发生了什么。
从本书开始,因为它公开且无需权限。接着创建一个名为 Northstar 的虚构客户,并连接其文件。仔细观察 search index 保留了什么、悄悄丢掉了什么。然后构建整门课最重要的东西:一项检查,用来决定每个人允许找到什么。
我们会构建一家小型虚构公司:两份 governed record、两份 operational snapshot,以及一个含邮件和聊天的 working-context 文件夹。故意使用合成数据,而 概念 8 会解释为什么这不是偷懒。
5. 先连接共享方法,再连接客户
从完全不需要权限的来源开始。Onyx 的 Web connector 会抓取某个 base URL 下的页面,沿着可访问链接继续抓取,清理文本,并保留用于引用的来源 metadata。
| 字段 | 值 |
|---|---|
| Connector type | Web |
| Name | AF-SOR-PUBLIC |
| Base URL | https://agentfactory.panaversity.org/docs/getting-started |
| Source class | Agent Factory System of Record |
| Permission basis | Public |
没错,你正在索引本书。这正是目的所在。Agent Factory System of Record 是一个真实、公开、受治理的来源,也是你第一天就能连接且完全无需处理权限问题的唯一类别。
有一点适用于每个 governed source。索引帮助 Worker 找到方法,而引用必须重新打开原始页面。
通过 Web 索引得到的 chunk,只是指向稳定网址的指针,不能替代原始页面。这和你将在 概念 10 中正式构建的「先找到,再确认」形状相同。
接下来是客户。Northstar fixture 已随 base 文件夹提供,所以你要连接它们,而不是重新生成。连接前先打开 fixtures/,看看里面有什么:
| 文件夹 | 内容 |
|---|---|
sales-sor/ | 三条受治理的销售规则,每条都有 stable ID、version 和 effective date。折扣规则允许销售专员最高批准 15% |
accounting-sor/ | 四条受治理的会计规则,其中故意放入一份已被替代的文件,说收入在开票时确认,而不是在验收时确认 |
operational/ | 两份 JSON 记录:批准待定、验收未收到。它们永远不被索引 |
working-context/ | 三封邮件和两段聊天记录,其中一封声称财务已经同意某件没有任何 governed source 支持的事 |
fixtures/PLANTED.md 列出了故意埋下的四处矛盾。不要索引该文件,并尽量在第 5 部分前不要仔细阅读。它是答案册。
如果更想生成自己的语料库,或想要第二套用来测试,下面的 prompt 会得到等价结果:
为一家名为 Northstar Services 的合成客户创建
fixtures/文件夹。在
fixtures/sales-sor/下创建一份小型 governed sales record:一条 discount-authority 规则,规定超过 15% 的折扣需要 VP Sales 批准,另加一套 qualification method 和一条 proposal policy。每条规则的 front matter 都要有 stable ID、version 和 effective date。在
fixtures/accounting-sor/下创建一份小型 governed accounting record:一条 implementation-revenue 规则,规定在客户验收时确认收入,再加两条辅助条目,使用相同 front matter。然后加入一份已被替代的文件,说收入在开票时确认,使用更早的 effective date,并带有 superseded-by link。在
fixtures/operational/下创建两份 JSON 记录:一份 opportunity,显示已申请 20% 折扣且批准待定;一份 contract,显示签署完成但验收未收到。在
fixtures/working-context/下创建三封邮件和两段聊天记录。其中一封由销售经理发出,写着「财务同意本季度入账」,但没有任何 governed source 支持这句话。最后编写
fixtures/PLANTED.md,列出你故意创建的每一处不一致,方便我之后检查系统是否找到它们。不要索引该文件。
把这些文件夹连接为彼此独立的 connector,绝不能合成一个:
| Connector | Source class | 为什么分开 |
|---|---|---|
VERTICAL-SALES-SOR | Vertical record | 治理折扣权限 |
VERTICAL-ACCOUNTING-SOR | Vertical record | 治理收入确认 |
CUSTOMER-WORKING-CONTEXT | Working context | 只能作为证据,绝不能作为权威 |
你即将索引客户的材料。它们始终属于客户。
Northstar 的邮件、聊天记录,乃至其 governed rule 都是客户实例中的客户内容。它们绝不能迁移到你在客户之间复用的共享 vertical record 中。那会造成污染:你的专业记录最终保存某一家公司的私密材料,此后再也无法安全带到任何地方。
材料只有通过晋升法则才能向上移动:同一种模式在至少三个客户中重复出现;完成去标识化;通过晋升审查;再由你的专家用自己的语言重新编写。这叫创作,不叫复制。
连接来源时要牢记的规则是:客户的世界可以流入,任何内容都不能流出。
注意表格里没有什么。Operational JSON 完全没有连接,而是在 概念 11 中实时提供。原因就是该概念的全部内容。
注意: 观察 connector 除正文外,每份文档究竟还携带什么。本地文件夹 connector 只能看到 path 与 modified time,完全不知道谁有权阅读文件。连接真实 SharePoint 或 Drive 的 connector 能看到更多,包括访问规则。这种不对称正是 概念 8 的全部主题,而先在本地文件夹上遇到它,是代价最低的学习方式。
还要注意: sync 报告已完成,但搜索仍无结果,通常说明后台 indexing 尚未结束,等一会儿再搜即可。Connector 报错但搜索仍可用,说明旧内容还留在索引中,这就是 第 7 部分的陷阱。权限变更也需要一点时间传播,因此限制访问后,某份文档可能还会短暂可见几秒。
Document Set:搜索范围,不是法律阶梯
Connector 说明内容来自哪里。Document Set 是 Onyx 对一组有名称 connector 的称呼,用于规定某次搜索或某个 Agent 可以查看哪些来源。
| Document Set | 包含 | 目的 |
|---|---|---|
AF Shared Method | AF-SOR-PUBLIC | 架构与方法论 |
Sales Authority | VERTICAL-SALES-SOR | 受治理的销售规则 |
Accounting Authority | VERTICAL-ACCOUNTING-SOR | 受治理的会计规则 |
Customer Working Context | CUSTOMER-WORKING-CONTEXT | 辅助证据 |
Northstar Cross-Domain | 全部四类 | 完整实验语料库 |
它们完成三件事:让范围可见;让 Agent 只搜索任务需要的内容;让你先在单一领域内测试,再跨领域测试,从而区分 routing bug 与 retrieval bug。还有一条警告:
Document Set 是搜索范围,不是权威层级。 它说明可以查看什么,完全不说明什么具有治理权。
真正说明什么具有治理权的是另一个文件,会在 概念 12 出现。
完成标准: 仅把搜索范围限定为 Sales Authority 时,收入确认相关内容一条也不会返回。这说明 scope 正常工作,也让你之后能够区分 routing bug 与 retrieval bug。
6. 观察一次 sync,看看 chunker 丢掉了什么
上一门课已经讲过 chunking。当时可调参数是大小与重叠,风险在于 recall。这里还多了一项更大的风险。
Governed record 中的一条记录会携带 12 项内容:stable ID、domain、authority class、jurisdiction、version、effective date、approval status、applicability condition、owner、superseded-by link、required checker 与 permission boundary。
普通 indexing pipeline 只会保留句子。
控制权转移时可以确认收入。
文字留了下来,12 项控制却全部消失,而且检索到的正文不会用任何方式提醒你它们已经缺失。
Worker 因而无法判断六件事:哪项标准治理这句话;它是否适用于这种合同;是否仍然有效;是否适用于这个国家;它是权威还是仅为解释;哪些例外会改变答案。
在自己的语料库上亲眼看看:
从
fixtures/accounting-sor/取一条 front matter 中带有 version 与 effective date 的规则。先展示原始文档,再准确展示它在索引中的一个 chunk:chunk 正文及其旁边保存的每个字段。明确指出哪些文档级事实没有进入 chunk。
完成标准: 拿起一个 chunk,就能说出它的父文档中某项真实信息,而只读这个 chunk 的 Worker 永远不会知道。这个缺口不是 Onyx 的 bug,而是 概念 10 必须存在 confirmation step 的原因。
Glean 的 Indexing API 允许把结构化 metadata 附到文档上,其 knowledge graph 还会保留普通 chunker 会丢掉的人、内容与流程关系。因此,这里的缺口比 Onyx 更窄。
更窄不等于闭合。 除非由你提供字段并教 Worker 检查,否则两个产品都不会知道规则的 effective date、jurisdiction 或 superseded-by link。无论选哪个产品,这 12 项控制都必须由你负责携带。
7. 搜索一次,看看返回的究竟是什么
在语料库中搜索一个答案横跨两份文档的问题。展示带 score 与 source 的结果,然后通过 Onyx chat 回答同一个问题,让我看到它附带的引用。
现在开始建立纪律。对每条结果大声问出三个问题,直到形成条件反射:
它来自哪里? Onyx 很擅长回答,引用就在旁边。检查它是否指向你认识的文档。
这个人可以看吗? 此刻诚实的答案是「所有人都能看到一切」,因为只有你一个用户,而且来源只是一个文件夹。先把这个念头保留四分钟。
它现在仍然有效吗? Onyx 无法告诉你。它找到了与关键词匹配的文档;该文档是否是当前版本,没有任何 similarity score 可以回答。试试看:搜索你在 概念 5 连接的 fixture 中那份已被替代的会计文件主题,看看哪个 version 先返回。
一条 retrieval hit 是指针,不是答案。 第 3、4 部分存在的全部意义,就是把指针变成你愿意为之辩护的答案。
还要精确说明这条规则适用于哪些项目。Governed knowledge 有原始记录可返回,因此 hit 是指针。Working context 则不同:经理上周二说过的话没有 canonical 版本,检索到的邮件本身就是那项内容。保证 working context 诚实的,是另外两个问题:这个人是否有权查看,以及它是否被标记为证据而不是规则。
完成标准: 搜索那份已被替代的会计文件主题,并看到哪个 version 最先返回。无论返回哪一个,你都已经知道 Onyx 不是根据当前有效性来选择它。
8. Permission inheritance,以及 Community Edition 的边界
这是全课程最重要,也最经常被跳过的概念,因为跳过后,大约六周里一切都会显得更容易。
文档的访问规则位于它的原系统中。私有 channel 就是私有的,受限文件夹就是受限的。你的上下文层复制文档时,也必须复制访问规则;每次查询发生时,都要针对具体提问者重新检查。Permission 只能继承,不能发明。 为什么这不仅是隐私问题,更是控制问题,请参阅 Permission 先于模型。
如果弄错,你构建的东西比泄漏还糟:它会「热心地」帮助泄漏。一位初级员工提出合理问题,系统把对方从未获准打开的薪酬备忘录排在第一位,还附上一段友好摘要。没有人攻击系统;这一层只是在错误规则下忠实完成了自己的工作。
Onyx Community Edition 足以学习 connector、indexing、retrieval、citation、agent 与 action,却无法单独证明生产环境中跨用户的 permission fidelity。
Onyx 文档把从外部系统继承用户权限的 permission-sync connector、user group、RBAC 和 group-based permission 列为 Onyx Cloud 与 Enterprise Edition 功能,而不是自托管 Community Edition 功能。需要从外部系统继承权限的部署,也被明确列为迁移到 Enterprise 的理由。
因此,在纯 Community Edition 实验中,每位学生看到的是同一份语料库。 你无法演示受限角色提问并正确得到空结果。(如果班级改用设置表里的 Onyx Cloud 试用,则可以做到,而且值得花一周观察真实 access-control sync 自动完成你即将手工做的工作。)
这个概念上,商业产品显然领先。与其防御,不如直接承认。
Glean 在读取每个已连接系统的内容时,也读取 access-control list,并执行来源中已有的权限。如果你无法打开 Drive 文件或阅读 Slack channel,它就不会出现在搜索结果中,也不会进入为你生成的答案。其 Indexing API 也为自有内容暴露同一模型:每份文档可以带 per-user 和 per-group permission,并提供 checkdocumentaccess endpoint 来验证。
所以在 Glean 中,你要配置它;在 Onyx Community Edition 中,你要构建它,也就是 概念 9。
亲手构建一次更有教育价值,生产环境通常更适合购买。能够判断眼前情况适用哪一句,才是真正的技能。
有三种处理方式,本课程选择第一种。
在自己的边界执行 permission check。 代码由你编写,因此完全由你控制。真正实现一次 access check,也比配置一次更有教育价值。这就是 概念 9。
阅读 ee/ 代码。 虽然不是 MIT 许可,但源码可查看。不部署它,也可以研究真实来源的 ACL inheritance 如何实现。
为一次实验使用试用版或许可证。 一周,一次演示,然后回到 Community Edition。
由此得出一条规则,而且学习阶段绝不能协商。
在部署通过 概念 9 的 permission test set 之前,不要连接真实语料库。不要连接雇主的 Drive、客户的系统,也不要连接自己的 inbox。尚未测试权限的一层不是半成品,而是一套速度很快、却指向错误规则的系统。
9. 亲手构建 gate,并用一个什么都拿不到的角色测试
由于 Community Edition 不会按用户对文档设 gate,你就在 retrieval 前一层自行构建。生产环境中这也是正确位置:只有在自己的边界,才能证明实际发生了什么。
写代码前先诚实说明一点。你即将为 fixture 发明权限,这恰好违背了刚学到的规则。这是实验属性,不是设计属性。本地文件夹没有可继承的访问规则,因此必须由某人写明;真实部署中,这个人应当是源系统。这里的标签只是对 Community Edition 无法演示之继承关系的替代,而 governance/production-gates.md 会记录生产环境仍欠缺什么。
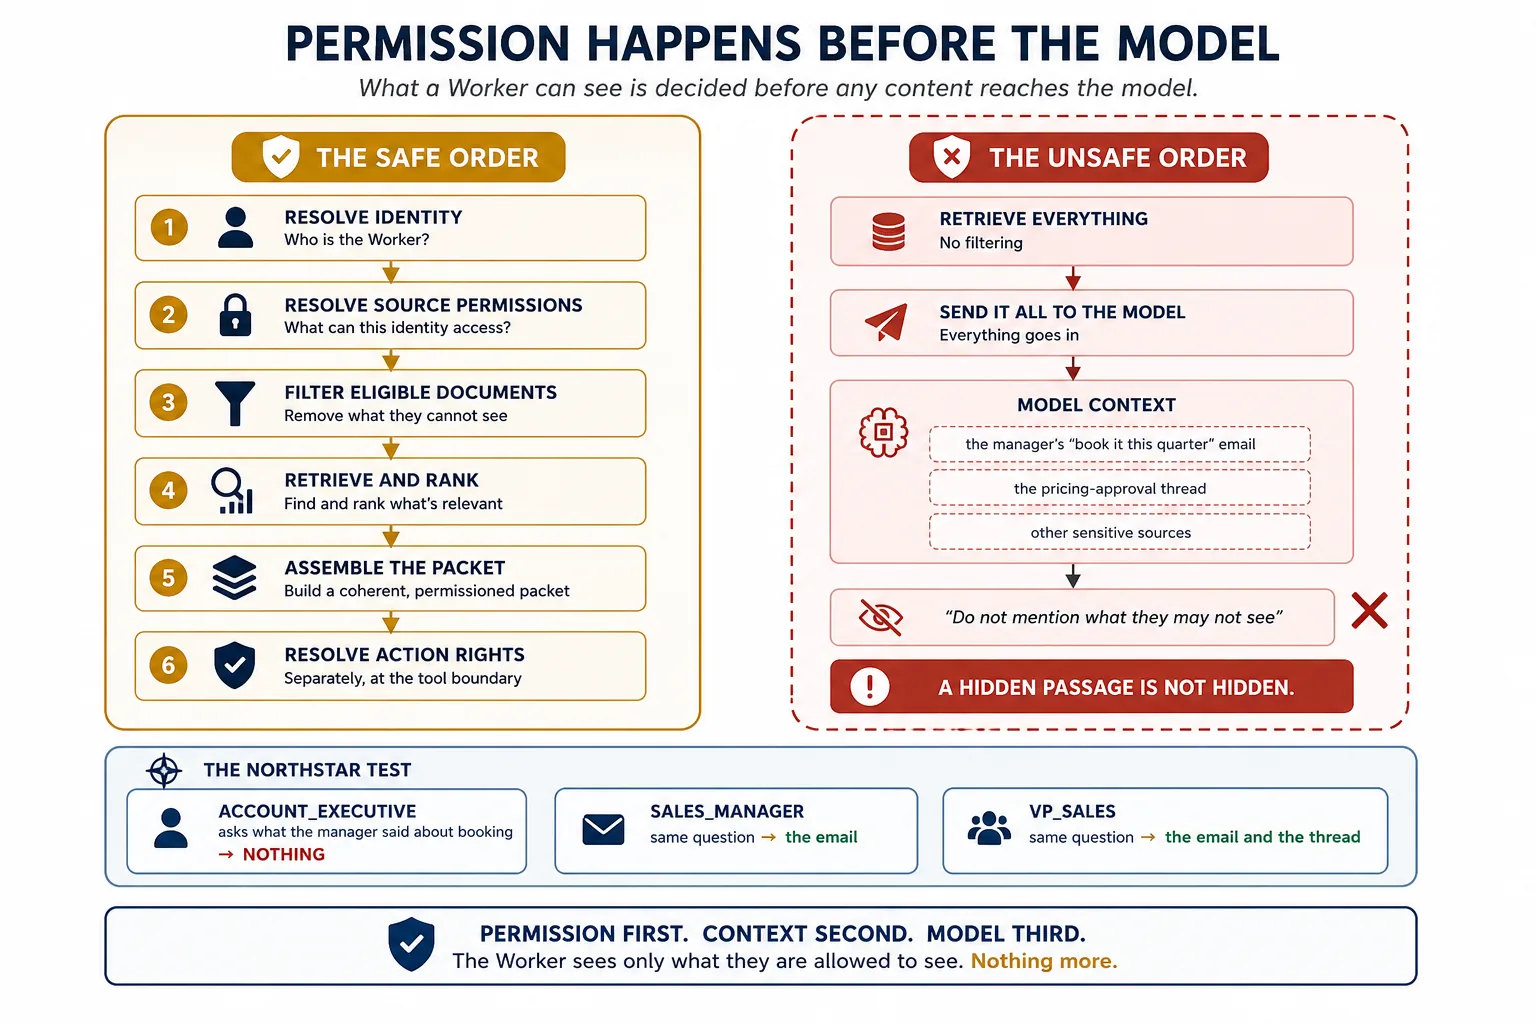
形状很简单,而顺序决定一切。
1. Resolve identity        who is asking
2. Resolve permissions     what may this identity see, per source
3. Filter eligible docs    remove everything else, BEFORE retrieval
4. Retrieve and rank       search only what remains
5. Assemble the answer     with citations
6. Resolve action rights   separately, at the tool boundary
不安全顺序反而最符合直觉:先检索一切;全都交给模型;再要求模型不要提及读者无权查看的内容。
藏在模型 context 里的 passage 并没有被隐藏。
开始构建:
governance/permission-matrix.csv 已经随 base 文件夹提供,每个来源一行。这既是 gate 执行的文件,也是之后交给 reviewer 的文件。
在 Onyx retrieval 前增加 access layer。定义三个 Northstar 侧角色:
account_executive、sales_manager与vp_sales。为每个 fixture 标注可以读取它的最低角色。Discount-authority 规则三者都可以读;pricing-approval thread 与经理的「本季度入账」邮件只有sales_manager及以上角色可读。然后编写search(query, role)函数。它必须在调用 Onyx 之前按角色过滤 eligible document set,绝不能在之后过滤。每条返回结果要包含 source,以及该角色获准查看它的原因。展示过滤发生的 code path,并证明任何不合资格的文档都不会进入模型。
接着完成比任何 retrieval benchmark 都重要的测试:
构建 permission test set:每个角色、每个问题一行,记录该角色在来源中允许看到什么、这一层返回什么,以及 pass 或 fail。必须包含关键 Northstar 案例:以
account_executive身份询问「销售经理对本季度入账说了什么」,正确答案应为什么都不返回。运行测试并展示表格。
完成标准: 三个角色都恰好得到自己允许查看的内容,而且 account_executive 询问经理邮件时得到空结果。一套从不返回空结果的层,还没有真正测试过。
注意这一次测试保护了什么。经理邮件是整个 Northstar 案例赖以展开的传闻。销售专员如果能检索它,就可以把自己经理的意见引用回来,仿佛那是财务决定。
然后写下两件事:实验室今天确实成立的事实,以及生产环境仍然需要什么。
先写 governance/permission-matrix.csv。每个来源一行,记录谁能读、permission 如何执行,以及是否已可用于生产:
source,student,teacher,production_employee,permission_mechanism,production_ready
Agent Factory SoR,read,read,read,public,yes
Sales fixture,read,read,not applicable,class-authorized,no
Accounting fixture,read,read,not applicable,class-authorized,no
Operational fixture,read,read,not applicable,synthetic MCP,no
Working context fixture,read,read,not applicable,synthetic files,no
再写 governance/production-gates.md,把它交给 security reviewer:
# Production permission gates
- [ ] Source permissions are synchronised or enforced before retrieval.
- [ ] Individual identity reaches live MCP and API tools.
- [ ] Search, chat, Agents, and external MCP clients enforce the same boundary.
- [ ] Revoked source access disappears within the accepted time window.
- [ ] A red-team test proves one user cannot retrieve another user's document.
- [ ] Connector credentials are encrypted and operationally protected.
同时编写两份文件,是为了让 Community Edition 的限制成为明确打开的 gate,而不是隐藏假设。这一区别正是实验与责任事故之间的区别。
在多数领域,permission 失败是隐私问题。在受监管职业中,它的影响更深,而且必须精确表述,因为宽泛版本的论证是错误的。
Segregation of duties 关乎能力组合,而不是可见性:既能创建 journal entry 又能批准它,既能发起交易又能完成 reconciliation。单纯的 read access 通常不是这种组合。如果声称上下文层「破坏职责分离」,controller 会让你输掉这场论证。
真正风险位于更底一层。Access control 是其他控制环境赖以成立的基础。因此,审计人员会把薄弱的 IT general control 当作怀疑上层 application control 的理由。公司的定期 access review 会确认具名用户拥有一组具体 entitlement,而你的上下文层却向该用户交付这些 entitlement 从未授予的内容。没有东西被盗,没有明文规则被正式违反,但这次 review 正在证明一幅不真实的图景。
因此,应当提出的论证是下面这一条,它既准确,也更有力。上下文层在 entitlement model 之外授予实际访问能力,不是破坏某一项控制,而是悄悄使负责证明全部控制的 review 失效。
第 3 部分:受治理的一半
搜索给你一个指针,不会直接给你答案。
这一部分会补上另一半。你自己的 Neon 数据库会得到一张小型 governed rule 表,每条规则都有 version 与 date。接着把它作为工具提供,让 Worker 拿着索引中找到的规则回到原始记录询问:它现在还是规则吗?至于 approval 是否通过这类实时数字,每一次都重新查询。
10. 通过 MCP 提供你的记录,以及两次调用模式
到目前为止,一切都属于索引发现的一半。其中已经包含 governed knowledge,因为你索引了两份 Vertical record 和本书。但所有内容都以可搜索副本到达,而副本只是指针。
现在加入canonical 与实时的一半,其行为完全不同。
先赋予记录权威
你的 Neon 项目保存文档、chunk 与 embedding,但还没有一条可以拿给 controller 引用的规则,因为上一门课没有理由构建它。因此,在现有结构旁增加一个小型 governed schema。这是本部分其余内容依赖的起点。
Base 文件夹的 scripts/ 保存所需 schema。在运行 prompt 前先阅读,确保批准的是你亲眼看过的内容。
在现有 Neon 项目的
devbranch 上创建一个governedschema,并加入rule表。列为:stable_id、domain(sales 或 accounting)、authority_class、jurisdiction、version、effective_from、effective_to、approval_status、superseded_by、owner和body。从fixtures/载入 Northstar 的销售与会计规则,包括已被替代的会计规则,并让它的superseded_bylink 指向当前规则。Commit branch 前先展示所有行。
这些列中的九项,就是 概念 6 提到的 12 项控制,只是现在由描述变成了真实字段。
两个专业的规则都保存在同一张表中,由 domain 列隔开。这让演示 server 保持简单,也让 概念 12 的 routing 真正做出可见选择,因为 Worker 必须先选 domain,之后才能确认任何内容。
然后提供它
Northstar 的会计规则规定,实施收入在客户验收时确认。这条规则有 version 与 effective date,fixture 中还存在一份说法不同、已被替代的文件。本概念中的一切,都是为了让 Worker 引用正确版本。
上一门课的存储已经在运行:一套位于 Neon 的小型 Postgres,已启用 pgvector,里面有你的文档,也有你用来构建的 dev branch。这里不会改变它的内容,改变的只是访问者。
它不是供 crawler 读取的文件夹。绝不要把 connector 指向它。 它是一个应该被询问的来源。询问方式与 上一门课第 6 部分 相同。
Base 文件夹中的 mcp/vertical_sor/ 是 FastMCP 骨架,下面三种工具已留好 stub,困难部分标有 TODO。先阅读,再让 agent 填写。
把托管在 Neon 上的 governed record 包装为名为
vertical-sor的 FastMCP server。每个工具都接收domain参数,值为 sales 或 accounting,让一套 server 同时演示两个专业。提供三种只读工具,并注意实时客户状态不在其中:
search_rules(domain, query)返回候选规则及其 stable IDconfirm_rule(domain, stable_id)返回完整的当前记录,包含 authority class、jurisdiction、version、effective period、approval status 与 superseded-by linkvalidate_action(domain, action)根据该 domain 的规则检查 proposed action,并返回 approved 或 refused,同时指出 blocking rule 使用环境中的 pooled Neon connection string,以只读角色连接,并通过 Streamable HTTP 以 stateless 模式提供服务,也就是请求之间不保留 MCP session,每个请求都可以独立回答。在编写代码前,先展示 tool list 与 docstring。
为什么是一套 server,而不是两套。 生产环境中,每个专业的记录可能属于不同主体、位于不同系统,而 domain 参数就是未来拆分的位置。对于速成课,一套 server 能让路径保持清晰。无论哪个专业,规则都只有一个确认位置。 Onyx 中的索引副本是它的 projection。Projection 是可搜索副本,只为帮助 Worker 找到原件而存在。每个 projected chunk 都保留 stable_id、domain 与 version,让 confirmation call 有可查询的键。
计划中还要检查两项 Neon 细节,因为它们都属于「实验中能运行,生产中会伤人」的问题。Server 必须使用 pooled connection string,也就是带 -pooler 的 host,因为上下文层会开启大量短生命周期连接,direct endpoint 并非为此设计。它还必须以只读角色连接,而不是拥有表的角色。这样,无论传入什么工具参数,都无法修改它本应引用的记录。
Stateless HTTP 在 FastMCP 中是运行时参数,不是 constructor 参数。FastMCP("vertical-sor", stateless_http=True) 在 FastMCP 2.x 中有效,在 3.x 中会抛出 TypeError,而模型最可能回忆起旧写法。当前形式是:
from fastmcp import FastMCP

mcp = FastMCP("vertical-sor")

if __name__ == "__main__":
    mcp.run(transport="http", host="127.0.0.1", port=8101, stateless_http=True)
看看这个形状实际完成了什么。每项 governed claim 都带 version 与 confirmation time。已被替代的规则会被明确点名并明确不采用,而不是悄悄消失。邮件带着标签出现在独立 section 中,又因为提出了没有 governed source 支持的主张,再次出现在 Conflicts and gaps。三个 verdict 仍然分开:一次拒绝、一次允许、一次拒绝。
第 9 步:故意破坏。 完成五项 failure test,而 expected behavior 本身就是课程:
| 测试 | 预期行为 |
|---|---|
| 修改邮件,声称折扣已获批准,但 CRM 仍显示待定 | 暴露冲突,继续把 CRM 作为当前 operational state |
把 search_rules 指向过时 Neon branch | Confirmation 纠正结果,让过时答案明显错误 |
| 停止 customer-state MCP server | 说明无法确认当前状态,拒绝依赖 current state 的结论 |
| 从 gateway permitted scope 中移除销售规则 | 指出缺少 governing authority,而不是用经理邮件代替 |
| 把 cross-domain Document Set 直接附到 Router | Gate 被绕过,受限角色看到受限内容。将它分离,再观察正确答案恢复 |
完成标准: 亲眼看到一套跳过一次 confirmation call 的系统,产出自信、流畅、引用充分却彻底错误的答案。没人会忘记这一幕。
第 10 步:保存基线。 运行 evals/questions.yaml 中的每个 case,并保存 raw response、citation、tool-call evidence、各维度 pass 或 fail、已知 Community Edition permission 限制,以及准确的 Onyx 与模型版本。
Server 随后在 /mcp 响应,而不是 bare host。这一细节会在 client 无法连接时浪费你一小时。批准计划前,让 agent 根据当前 FastMCP 文档检查这两点。
继续保持 branch 习惯。本课程修改记录 schema 时,仍然在 Neon branch 上完成并 preview。Branch 也是下面 stale-copy 演示成本最低的做法:fork 记录,故意让 fork 过期,把 discovery 指向它,然后丢弃 branch。
再看一次工具列表。search_rules 与 confirm_rule 是两次调用,而天真的设计只会写一次。这里的拆分正是重点。
Discovery 问:相关信息可能在哪里? 它针对 recall、similarity 与速度优化,输出是指针。
Confirmation 问:哪一来源正式适用于这项决策? 它检查 domain、authority class、jurisdiction、version、effective date 和 approval status,输出是答案。
因此,顺序固定,永远不能反过来:
search discovers → you route → the record confirms → the Worker cites
你可以为了 discovery 索引 governed page,而且这样做很有用。完全找不到规则的学生,比找到一个副本的学生处境更差。绝不能发生的是依赖副本。 这条原则叫 Discovery 不是 confirmation。
现在把两次调用接起来。编写
governing_rule(question):调用search_rules,取得 top candidate 的 stable ID,再调用confirm_rule,返回确认后的记录。如果记录已被替代,则沿 link 继续确认 successor。然后用整个案例依赖的规则演示它阻止的故障:为记录创建 Neon branch,在 default branch 上把 implementation-revenue 规则从 acceptance 改成 billing,让 branch 成为过时副本;让search_rules指向过时 branch,而confirm_rule仍指向当前记录;询问 Northstar 何时可以确认收入。并排展示两个答案,之后删除 branch。
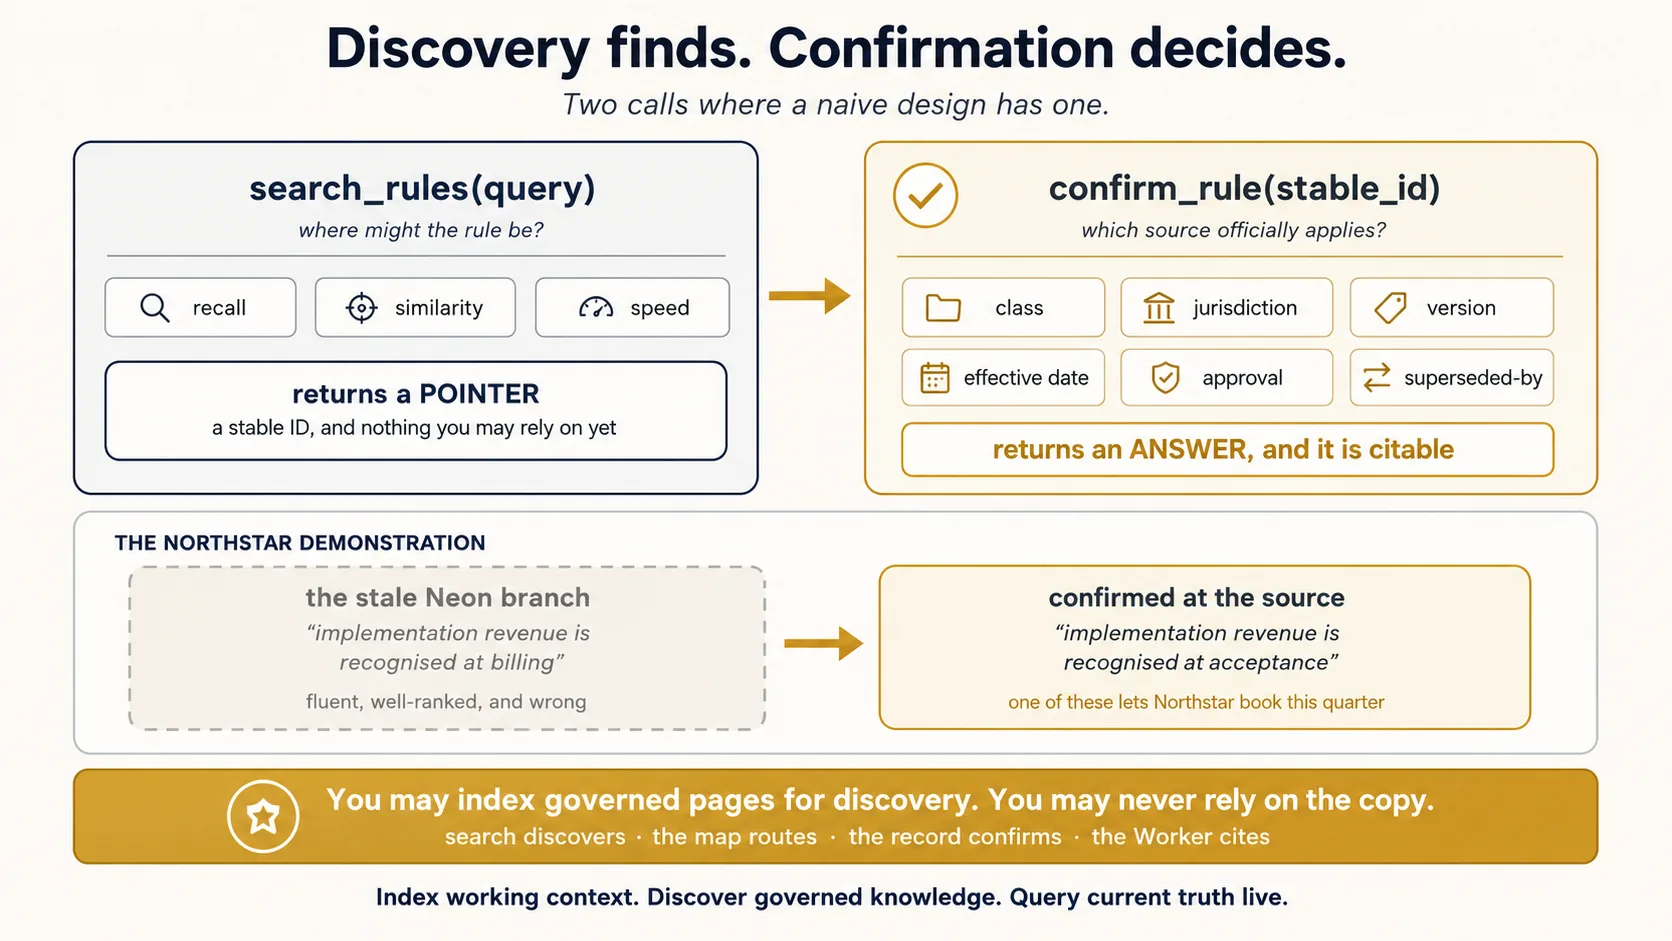
完成标准: 亲眼看到过时 branch 自信地回答「开票时」,再看到 confirmation call 把它纠正为「验收时」。
一个答案允许 Northstar 本季度入账,另一个不允许。这正是本课程存在的全部差别,也是整门课最有价值的一次演示。
这里,产品不会替你完成,这是全页最重要的一则说明。
Glean 的索引与检索很优秀,也确实携带一项 currentness 信号:owner 可以验证某个页面,结果会显示由谁、何时验证;失效页面也可以被 deprecated。这是附在文档上的人工提醒,却不是你所在专业的 authority class、jurisdiction、effective period 或 supersession link,因为这些属性属于你的 governed record,而不属于搜索平台。因此,Glean 部署完全可能返回一条已被替代的规则,带有完美引用、完整 permission fidelity 和绿色 verified badge,却仍然错误。
无论使用哪个产品,confirmation call 都必须由你构建。 Glean Agent 可以通过 remote MCP server 访问你的 confirm_rule 工具,就像 Onyx Agent 一样;不过在撰写本文时,该路径仍处于 beta,位于 agent 的 plan-and-execute step,而不是 single-step selection。设计本身没有任何变化。
11. 每次都重新查询实时状态
余额、approval status、open item、current version。它们都不是人为编写的,也不稳定,却要求精确。把它们索引起来,就等于为唯一价值来自「当前」的内容制作了一份粗糙且不断老化的副本。
规则只有一句话,应该写进每项 engagement 的 design record:
如果过时值可能改变结论、permission、付款、申报或客户 action,就实时获取。
因此,整个上下文层的核心原则可以压缩成三种 retrieval mode:
| 信息 | 访问方式 |
|---|---|
| Working context | 感知 permission 的 indexing |
| Governed knowledge | Discovery index,并在依赖前确认 |
| Current record 与 action | 通过 MCP 或 API 实时进行类型化查询 |
索引 working context。发现 governed knowledge。实时查询 current truth。
同一来源往往需要两种模式。合同文档被索引,便于查找条款;随后实时查询合同系统,确认找到的 version 仍然有效。
格式与长度什么也决定不了。Freshness risk 决定一切。
对于部分已连接系统,Glean 可以在查询时实时获取新鲜数据,而不是只依赖索引副本,因此会自动覆盖一部分问题。
一部分不等于全部。你所在专业中哪些字段对 freshness 敏感,没有平台能够替你判断。 这正是上面写进 design record 的判断。产品可以更换,决策规则仍会跟着你。
通过独立于
vertical-sor的 customer-state server 提供 Northstar 的两份 operational record:get_opportunity返回 approval status,get_contract_state返回 acceptance status。将二者分开,是把四类来源变成物理边界:Vertical record 治理规则,operational record 拥有状态。然后询问两次「可以确认收入吗」:第一次从 indexed snapshot 回答,第二次从实时调用回答;两次之间把 acceptance 从 not-received 改成 received。展示带时间戳的两个答案。
完成标准: 索引答案与实时答案发生分歧,而且你能准确说出哪一个可以呈交 controller。
第 4 部分:路由与引用
客户提出的一个问题,往往藏着多个专业问题。
这一部分教 Worker 把它们拆开,分别发送到负责治理的记录,并为带回的每项内容添加标签。它还会训练最难的习惯:两个来源发生分歧时,两者都要展示,绝不要把它们磨平为一句让人舒服的话。
12. Authority routing:哪份记录治理这个问题
专业工作会提出多种问题:必须决定什么、允许采取什么 action、适用哪个 checker、还缺什么证据。但为了组装 context,大多数证据请求都可以归为三种形态,而且各有自己的路径。
| 问题 | 来源 | 路径 | 返回内容 |
|---|---|---|---|
| 规则是什么? | System of Record | Discovery,然后 confirmation | Governed truth,带 class、jurisdiction 与 version 的引用 |
| 数值是多少? | 拥有该数值的系统 | 类型化查询 | 一项准确的当前值,附时间戳 |
| 这个案例中说过什么? | Working context | 感知 permission 的 retrieval | 证据,绝不是治理规则 |
无法判断自己在问哪种问题的 Worker,会用同一种方式回答三者,而第三条路径会悄悄吞掉前两条。
当客户运行多份 governed record 时,还需在三条路径前增加一步。中型公司可能有 accounting record、sales record 与 HR record,由三个不同的人构建,而且都不属于你。因此,routing 首先解决哪个专业拥有这个问题,然后才选择该专业中的来源。即使每个字都来自销售对话,「是否可以确认收入」仍然是会计问题。
写 prompt 前先写 map
模型不能根据偶然排名第一的 chunk 自行发明哪个来源具有治理权。因此,routing table 必须是你先写、审查并保留的一份 versioned artifact。Base 文件夹已经提供 governance/authority-map.yaml,route 仍为空。填入以下内容:
version: 1
updated_at: 2026-07-31

routes:
  shared_method:
    questions: [architecture, Agent Factory doctrine, implementation method]
    governing_source: AF-SOR-PUBLIC

  sales.discount_authority:
    questions: [requested discount, approval threshold, proposal permission]
    governing_source: VERTICAL-SALES-SOR
    confirm_with: vertical-sor.confirm_rule(domain=sales)
    current_state_tool: customer-state.get_opportunity

  accounting.implementation_revenue:
    questions: [revenue recognition, implementation acceptance, quarter-end treatment]
    governing_source: VERTICAL-ACCOUNTING-SOR
    confirm_with: vertical-sor.confirm_rule(domain=accounting)
    current_state_tool: customer-state.get_contract_state

rules:
  - working_context may support what was said or requested, but never governs a professional conclusion
  - indexed governed knowledge is discovered, then confirmed at the source before it is relied on
  - current state must be confirmed live before any action
  - conflicts are surfaced, never silently merged
  - missing authority or evidence becomes an explicit gap
其中每个名称都是你已经创建的名称:概念 5 的 connector、概念 10 与 11 的工具。这是有意为之。如果 routing map 中的来源无法解析为系统真正可以调用的东西,它就只是一张图,不是 router。
文件很简单,因为工作很简单。它把一个模糊的公司问题变成有名称的专业决策,每项决策都有具名治理来源。 生产环境中,这张 map 可能位于 governed registry 或 Vertical SoR。课程使用 YAML,是为了让决策从第一小时起即可检查、带版本。
构建
route(question)函数,读取governance/authority-map.yaml,把问题分类为相应专业决策,并为每项决策指出 governing source 与 current-state source。以带 reason 的结构化数据返回 routing decision,不要只调用工具。然后让它处理 Northstar 问题,展示 routing table,让我检查推理,而不只是答案。
注意: 返回决策本身而不是立刻采取行动,才让系统可审查。一个只产出答案的 router 无法审计。
完成标准: Northstar 问题至少产生两项 routed decision,一项销售、一项会计;二者都在任何 retrieval 发生前指出 governing source。
13. Provenance 与 citation envelope
这一层返回的每项重要内容都带着一个 envelope:一组随正文同行的标签,说明它来自哪里,以及你是否可以依赖。没有 envelope,packet 只是一堆文本;有了它,packet 才是可审查的证据。
| 字段 | 重要原因 |
|---|---|
| Source system | 说明谁拥有这项信息 |
| Stable ID | 让 reviewer 可以再次获取同一项内容 |
| Authority class | 法律、标准、合同、政策、交易、指南、消息或示例 |
| Scope | 说明它治理哪个问题、客户、jurisdiction 与 case |
| Version and effective period | 防止已退役规则悄悄返回 |
| Retrieved or synchronised at | 说明获取时有多新鲜 |
| Permission basis | 说明为什么允许这位读者接收它 |
下面这条规则让流畅答案保持诚实:
Worker 可以阅读任何已获准且与任务相关的 supporting context,但绝不能把 supporting context 呈现为治理答案的规则。
邮件可以被引用为客户提出某项要求的证据。以往 working paper 可以被引用为公司去年如何处理某件事的证据。二者都绝不是要求本身。
Packet 是输出契约
Onyx Agent 是一种配置好的 assistant:指令告诉它如何表现,知识是它可搜索的内容,Action 则是它可以调用的工具。创建一个名为 Northstar Context Router 的 Agent。
下面这一步很容易做错,而且会悄悄撤销 概念 9 的全部工作。
最显然的做法是把 Northstar Cross-Domain 直接附到 Agent,而且立即就能工作。但它也会创建两条 retrieval path,其中一条绕过你刚构建的 gate:
SAFE     user  ->  permission gate  ->  filtered Onyx search
BYPASS   user  ->  Onyx Agent  ->  the whole attached Document Set
Agent 附带的知识会变成它的可搜索范围。附上 cross-domain set 后,无论 gate 说什么,Agent 都能为任何人读取其中的一切。
所以 Router 完全不附带 role-sensitive knowledge。 它只获得 Action。
只给它下面五个 Action,不多也不少:
| Action | 作用 |
|---|---|
search_permitted_context(query) | 你的 gateway。从 Action 携带的 credential 解析 caller role,应用允许的 Document Set 或 tag,再调用 Onyx search |
confirm_rule(domain, stable_id) | 来自 vertical-sor 的 canonical confirmation |
get_opportunity(id) | 来自 customer-state server、带时间戳的实时 opportunity state |
get_contract_state(id) | 来自同一 server、带时间戳的实时 contract state |
validate_action(domain, action) | 根据治理规则检查 proposal |
构建一个包装 Onyx search API 的
search_permitted_contextAction。它从 Action 配置的 credential 中读取 role,绝不从工具参数读取;根据该 role 推导允许的 Document Set 与 tag,把它们应用为 search filter,然后才发出查询。返回结果时带上每条结果获准出现的原因。随后创建 Northstar Context Router,不附加任何 Document Set,只提供这个 Action 和四种 MCP 工具。
在哪里比较角色非常重要。 一个 Action 只携带一份已配置 credential,因此也只代表一个 role;所以同一 Router 无法以两个不同身份询问同一个问题。这是 wiring 属性,不是设计缺口,而且所有 host 都有同样约束。因此,要在 identity 真正解析的 gateway 上证明 gate:
向 gateway 询问一项只有
vp_sales能看的内容:先使用vp_salestoken,再使用account_executivetoken,并排展示两个结果。然后展示 Router 通过 Action 回答同一问题,并说明这个 Router 正以哪个 role 发言,以及你如何得知。
底层规则只有一句话,是前面规则向上再应用一层:
所有 indexed retrieval 都必须经过 gateway。如果某个 component 不经过 gateway 也能搜索,那么 gate 只是装饰。
默认情况下,Glean agent 会以调用它的用户 identity 运行,所以只能看到和执行该用户本来就能看到和执行的内容;你刚手工关闭的 bypass 不会以同样形式出现。Glean 还提供 agent identity,让 agent 使用管理员授予的 scoped service credential,而不是借用用户身份。注意这会把范围朝哪个方向改变:它把 unattended agent 的 reach 限制在管理员设定的 scope,而不是扩大它。
仍有两件事属于你。第一是七段式输出契约,因为固定、可审查的形状是一项设计决策,没有产品会强制。第二是 authority routing,因为判断收入问题属于会计而不是销售,是专业知识,不是平台功能。
现在,在 prompts/context-router.md 中为 Router 提供 instruction file,并以这个固定形状结尾:
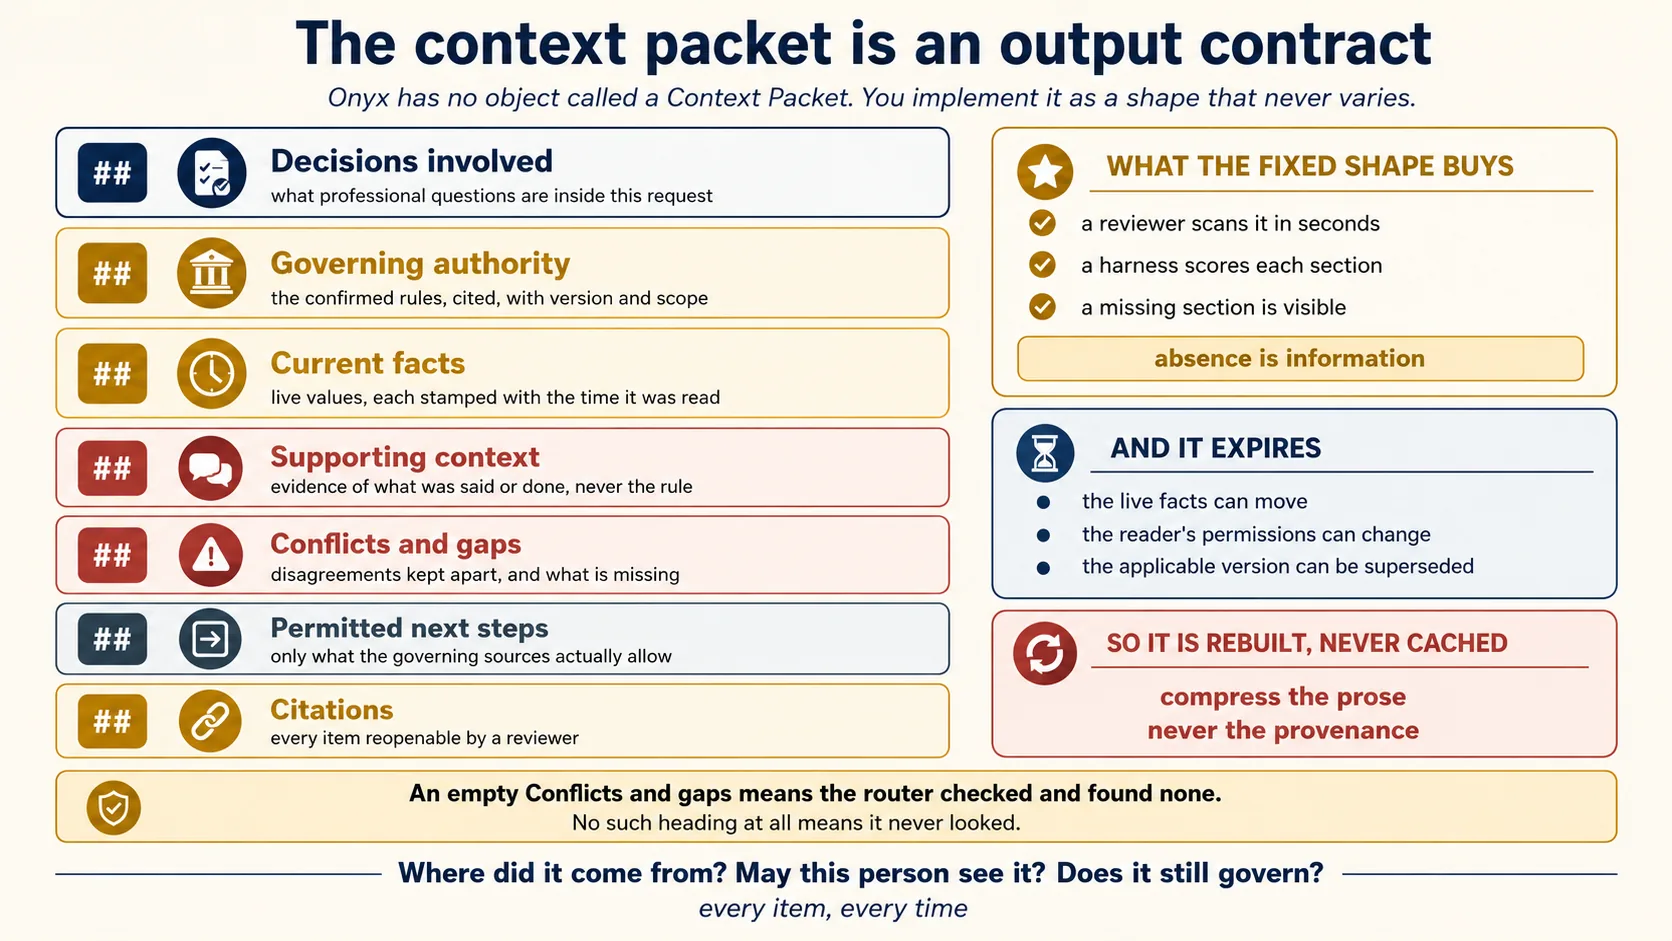
Return exactly these sections:

## Decisions involved
## Governing authority
## Current facts
## Supporting context
## Conflicts and gaps
## Permitted next steps
## Citations
这七个 section 就是 context packet,而固定形状做的工作比看上去更多。
Onyx 中没有名为 Context Packet 的数据库对象。你把它实现为一个任务的稳定输出契约。 因为形状永远不变,会带来三项结果:reviewer 可以在几秒内扫读任意答案;eval harness 可以逐节检查;缺少某节会显而易见,而不是悄悄消失。空的 Conflicts and gaps 表示 router 已检查且未发现冲突;连 heading 都没有,则说明根本没检查。
Packet 在设计上是临时的。当前事实会变化,读者 permission 会变化,适用 version 也可能被替代。因此,每次都重新构建,而不缓存。
构建该契约背后的 assembler。收到 routed question 后,收集 confirmed rule、live value 与获准的 supporting context;用携带完整 envelope 的内容填充每一节,并在视觉上将 governed truth 与 evidence 分开。然后用两种形式展示同一个答案:一次作为结构化对象,一次作为人类阅读的 prose。
完成标准: 即使某节内容为空,每个 heading 仍然存在;你还能指出某项 claim,并一路追溯到 source、version 与 permission basis。
Assembler 必须在 budget 内工作,因为 context window 有限,在过时消息上多花一个 token,就少一个 token 留给治理规则。因此,selection 与 compression 都是合理工作,却也是 provenance 最常被破坏之处。丢掉 version stamp、把两个来源合成一句话或去掉 authority class 的压缩,并没有节省 token,而是把证据变成了普通文本。
压缩 prose,绝不要压缩 provenance。
14. 冲突是一种结果,不是 retrieval failure
这正是 System of Context 与优秀搜索工具之间的区别。搜索工具对分歧没有立场,专业系统必须有。
回想你在 概念 5 连接的 fixture 中已经埋下的矛盾,然后去找出它们。
冲突只有三种结果:
- 按 scope 解决。 来源回答的是不同问题,各自在自己的范围内都正确。销售说交易在 6 月成交,会计说收入在验收前不得确认,二者都没有错。
- 按 authority 解决。 某个适用来源具有治理权,层级说明应采用哪一个。
- 未解决。 Worker 升级问题,同时把冲突证据组织好。
绝不能发生第四种结果,但普通 summarizer 默认就会这样做:把来源揉成一句任何来源都没有真正说过的顺滑陈述。
在 assembler 中构建 conflict detection。两项 retrieved item 在重要事实上发生分歧时,不要跨越它们进行总结。保持二者分离,保留完整 envelope,并判断冲突是按 scope 还是 authority 解决。如果都不能解决,则产生 escalation:说明哪些来源冲突、各自说什么、应用了哪项 authority test,以及什么仍然未决。然后用
fixtures/PLANTED.md中的不一致运行它,展示是否逐一捕获。
完成标准: 系统自行找到已被替代的 memo 与被其他来源反驳的 chat message,而且 escalation 读起来像一份无需编辑就能转发给 partner 的材料。
它不会让分歧消失,而会让分歧可以审查。
Onyx 与 Glean 都不会自动应用你的专业 authority map 或 conflict rule。Retrieval 只返回匹配 passage。两个 passage 是否冲突、哪一个具有治理权,是存在于你的 authority map 与 router instruction 中的专业判断。
更强的 retrieval engine 反而可能让这一点更难察觉,因为它会在同一分歧上生成更流畅、更自信的答案。
三种结果以及为什么「按 scope 解决」列在第一位,请参阅 冲突是一种结果,而不是 retrieval failure。
15. 行动并记录:闭合 loop
找到不等于做到,二者之间隔着五项不同工作。
the layer finds  →  the Worker reasons  →  the governing record validates
                 →  the tool acts  →  the owning system records
第三步是所有人最容易丢掉的一步。
折扣批准先交给 sales record 检查,之后 CRM 才写入。Journal entry 先交给 accounting record 检查,之后 ERP 才保存 draft。
因此,governing record 不只是读取规则的地方,也是根据规则检查 proposed action 的地方。正是这项检查,让规则成为真正的约束,而不是建议。
由此得出两条绝对规则:
上下文层绝不能成为第二套 transaction system,也绝不能成为绕过 governed record 的写入路径。
Read、recommend、prepare 与 execute 是彼此独立的授权。Worker 可能非常擅长 retrieval,却完全没有 execution authority。能够访问不等于获得 permission。
把 Router 的
validate_action(domain, action)工具接入 recommendation path。它接收 proposed action,根据 governed record 中该 domain 的规则检查,并返回 approved draft 或带 blocking rule 的 refusal。它绝不能执行。然后展示一个案例:retrieval 正确、reasoning 正确,但 action 仍被拒绝。
Glean 支持带 human-in-the-loop checkpoint 的 action,因此某一步可以要求人在执行前批准,而且 action 会遵守用户自己的 permission。
这只覆盖了 approval 的一半,没有覆盖 validation 的一半:在要求任何人批准前,先根据你所在专业的规则检查 proposed action。无论使用哪个产品,validate_action 都属于你,因为只有 governed record 保存它要检查的规则。
完成标准: 折扣 recommendation 被 sales record 的 approval rule 拒绝,而且 refusal 指出具体规则,而不是说模型不确定。
第 5 部分:Northstar 案例,端到端
现在按顺序构建全部内容,再故意破坏它。
破坏不是额外练习。会大声失败的系统是安全的;悄悄失败、同时给出流畅而自信错误答案的系统才危险。这一部分让你看到无声失败的样子,以后才能认出来。
这就是整门课的一次完整构建:从空实例到带引用、正确拒绝的答案。
案例。 销售专员申请 20% 折扣。CRM 显示批准待定。已签合同允许签署时开票。Accounting SoR 规定实施收入在客户验收时确认。Operational contract record 显示尚未收到验收。销售经理在邮件中说,财务同意本季度入账。
问题。
Northstar 能否获得 20% 折扣、现在开票,并在本季度确认实施收入?
第 1 步:计划。 使用强模型进入 plan mode:
构建完整 Northstar context layer:Onyx Standard 连接并分开四类来源;Neon 项目中的
governedschema 保存两个 domain 的规则;vertical-sorMCP server 提供 search、confirm、validate 与 live-state 工具;五个 Document Set;governance/authority-map.yaml;一套context-gateway,在任何 Onyx search 前解析 identity 并应用 permitted set;以及 Context Router,不附加 Document Set,只提供 Action。编写任何代码前,先展示计划、component boundary 与 tool list。
第 2 步:批准前阅读计划。 检查六点,而这六点正是本课程要训练你看见的内容。
- Permission filter 是否发生在 retrieval 之前,而不是之后?
- 是否每条 retrieval path 都经过 gateway,包括 Router 自己?Agent 不直接附带 Document Set,role 也不作为工具参数传入。
- Discovery 与 confirmation 是否是两次独立调用?
- Operational state 是否实时获取,而且没有任何 path 会索引它?
- Router 是否保留冲突项目,而不是跨越它们进行总结?
- Neon record 是否通过 MCP 访问,而且 connector 从未靠近它?
任何一项回答为否,都在代码出现前退回计划。
第 3 至 7 步:按 checkpoint 执行。 对常规构建改用更便宜的模型。
启动 Onyx Standard,连接
AF-SOR-PUBLIC,并展示一条取自本书、带引用的答案。
把两份 Vertical SoR fixture 与 working-context fixture 作为三个独立 connector 连接。展示 document count,并确认 operational JSON 没有被连接。
在 Neon 中创建
governedschema,载入两个 domain 的规则,包括已被替代的会计规则。启动vertical-sor与 customer-state server,并证明confirm_rule能返回search_rules单独无法提供的信息。
创建五个 Document Set,编写
authority-map.yaml,构建context-gateway,并创建不附带知识、只提供五个 Action 的 Context Router。
通过 gateway 运行 permission test set,每个角色一行,包括
account_executive的正确答案为空的问题。然后直接对 Onyx search 运行同一问题,展示 gateway 拦住了什么;最后通过 Router 再运行一次,确认 Router 只有这一条路径可以到达 Onyx。
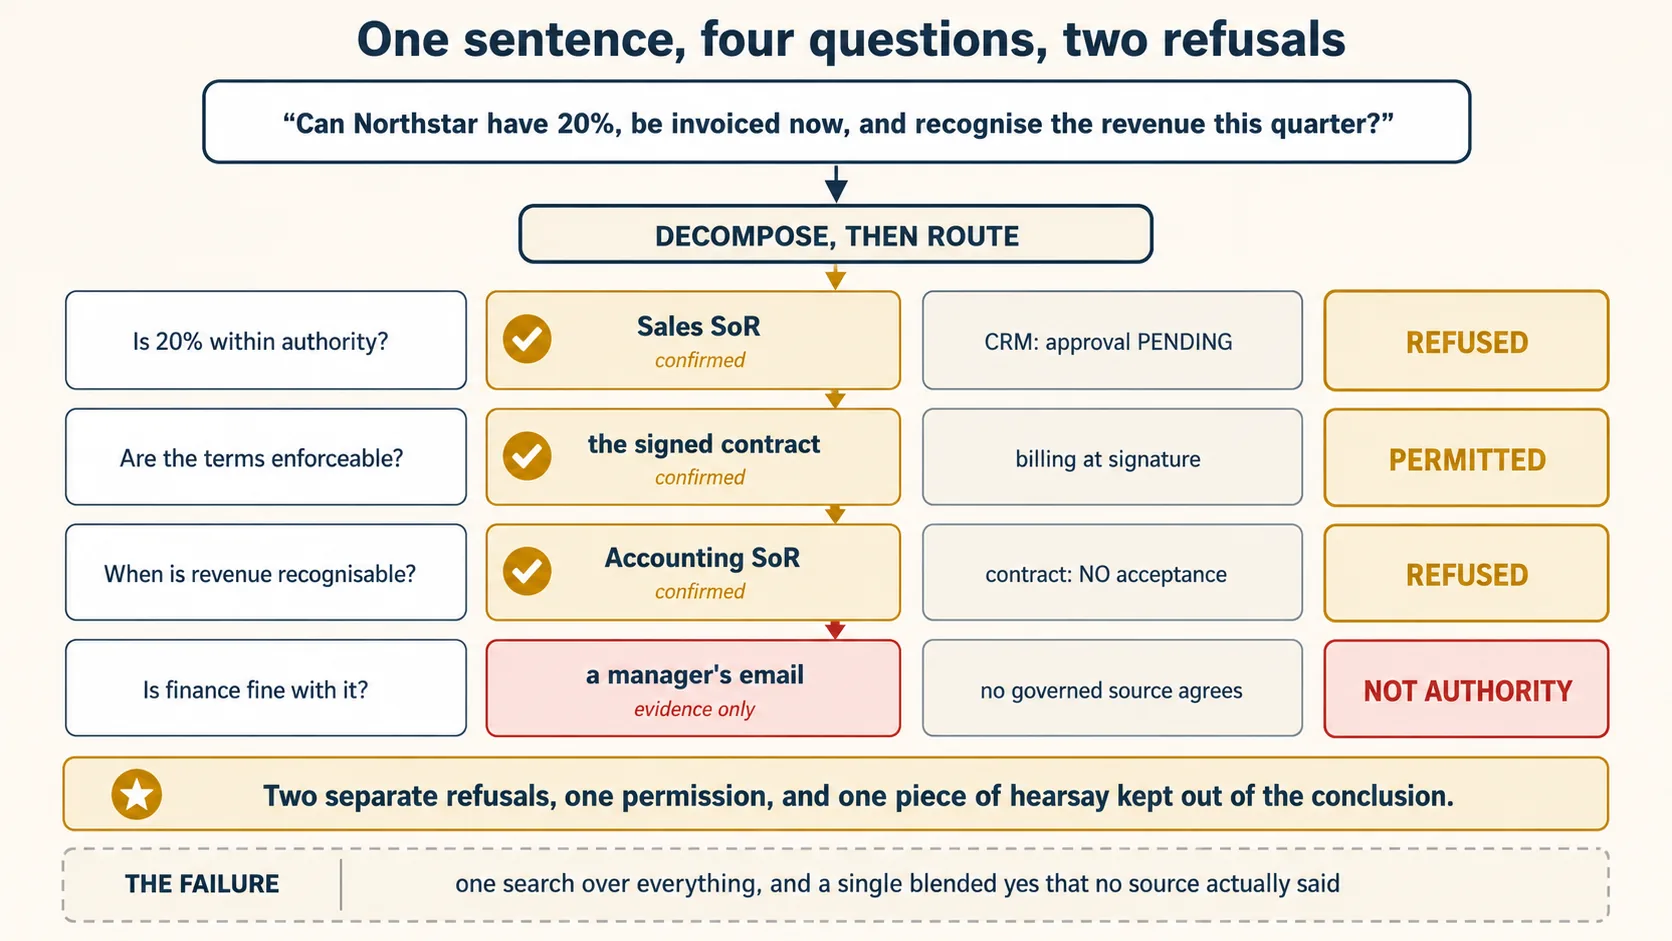
第 8 步:提出问题。 合格 packet 会完成五件事:调用两个 live tool;在确认后引用两份 Vertical SoR;把经理邮件标为 supporting evidence;让销售与会计决策各自位于独立 section;并且得到两次独立拒绝,而不是一个混合式「是」。
两次拒绝分别是:approval 待定时,该层级不能批准折扣;acceptance 未完成时,不能确认收入。签署时开票可以进行,准确说出这一点也是合格答案的一部分。全都拒绝与全都批准一样错误。
下面是返回结果的缩略示意。你的措辞会不同,形状不能不同。
## Decisions involved
1. Sales: may an account executive grant 20 percent?
2. Accounting: may implementation revenue be recognised this quarter?
3. Contract: are the billing terms enforceable now?

## Governing authority
- SALES-DISC-001 v2, effective 2026-01-01, approved. Discounts above 15 percent
  require VP Sales approval. [Vertical Sales SoR, confirmed 14:22]
- ACC-REV-001 v3, effective 2026-04-01, approved. Implementation revenue is
  recognised at customer acceptance. [Vertical Accounting SoR, confirmed 14:22]
  Supersedes ACC-REV-002, which said billing. Not applied.

## Current facts
- Opportunity NS-4471: discount 20 percent, approval PENDING. [CRM, read 14:22]
- Contract NS-2026-11: signed, acceptance NOT RECEIVED. [Contract system, read 14:22]

## Supporting context
- Email, sales manager, 2026-07-28: "finance is fine with booking it this quarter."
  Evidence of what was said. Not authority. [Working context, permitted: vp_sales]

## Conflicts and gaps
- The email asserts a finance position no governed accounting source supports.
  Unresolved by authority: escalate. Nothing in the corpus records a finance decision.

## Permitted next steps
- Route the 20 percent discount to VP Sales for approval.
- Bill at signature. Permitted by the signed contract.
- Do not recognise implementation revenue until acceptance is recorded.

## Citations
- SALES-DISC-001 v2 · ACC-REV-001 v3 · NS-4471 · NS-2026-11 · email 2026-07-28
第 6 部分:证明它
上一门课只有一个测试问题:搜索是否找到正确文本?
这里远远不够。这一层会以搜索测试看不到的方式失败:它可能从去年的规则中找到正确 passage;可能向某人展示其无权查看的内容;可能根据某个数值的过时副本作答。因此,你要测试八件不同的事,而且每次失败都必须指出坏的是哪一层。
RAG eval set 只问 retrieval 是否返回了正确 chunk。上下文层的大多数故障并非 retrieval failure,因此需要另一套测试与 scorecard。
evals/questions.yaml 已经带有 10 个 case。打开它,仔细阅读下面六个,因为每一个都测试不同阶段:
version: 1
cases:
  - id: inventory-01
    question: What sources contain Northstar discount information?
    expected:
      must_find: [Sales SoR, CRM, draft proposal]
      must_not_treat_as_authority: [draft proposal]

  - id: sales-01
    question: Can the account executive approve a 20 percent discount?
    expected:
      governing_source: Sales SoR
      live_tool: get_opportunity
      conclusion: no, VP Sales approval is required and remains pending

  - id: accounting-01
    question: Can implementation revenue be recognised this quarter?
    expected:
      governing_source: Accounting SoR
      live_tool: get_contract_state
      conclusion: no, acceptance has not been received

  - id: stale-01
    question: When is implementation revenue recognised?
    expected:
      prefers_current_version: true
      flags_superseded: true

  - id: conflict-01
    question: Finance should be fine with booking it, right?
    expected:
      working_context_is_not_authority: true
      conflict_visible: true

  - id: gap-01
    question: Which executive approved the discount?
    expected:
      answer: not established
      no_guess: true
每次运行都按八个维度评分,永远不要根据 prose 是否好看来评分:
| 维度 | 合格问题 |
|---|---|
| Inventory | 是否找到与任务相关的所有 source class? |
| Routing | 是否识别每项专业决策及其 domain? |
| Authority | 是否依赖了正确的 governing source,并回到来源确认? |
| Freshness | Current state 重要时,是否调用 live tool? |
| Permission | 是否始终位于用户允许的 corpus 与 action authority 内? |
| Conflict | 是否暴露分歧,而不是把它们混合? |
| Gaps | 是否说明缺少什么,而不是猜测? |
| Citation | Reviewer 是否可以重新打开每条规则与 supporting item? |
先手工通过 Agent 跑一次 baseline 并保存输出,再自动化:
使用当前官方 API,针对正在运行的 Onyx 实例构建 eval harness。读取
evals/questions.yaml,把每个问题发送给 Northstar Context Router,保存 raw response、citation 与 tool-call evidence,再按八个维度生成 Markdown scorecard。凡是可以确定性检查的地方都这样做。不要用回答问题的同一个模型自动评判专业正确性。 Authority 与 conclusion 检查仍然采用明确 expected-value comparison。
最后一句最需要捍卫。一个模型评判另一个模型可以帮助总结故障,却绝不能悄悄替代你亲自写下的 expected rule 与 fact。
完成定义: cross-domain case 除生产 permission fidelity 外,每个维度都通过;后者仍是一道明确打开的 gate。
第 7 部分:服务整支 Workforce,并运营它
只能在一个 chat 窗口里工作的层还没完成。
最后一步把它打开,让同事已经在使用的其他工具能够访问同一份 corpus,并遵守同一套可见性规则。随后处理没人愿意写下的部分:当真实用户开始依赖它后,怎样让它持续运行。
到目前为止,人类和 Onyx Agent 都在 Onyx 界面内使用语料库。只有当外部 Worker 查询同一 corpus,而不是各自制作私有副本时,这套架构才真正符合自己的名称。
Onyx 可以双向工作,而这也是多数构建从未抵达的一步:
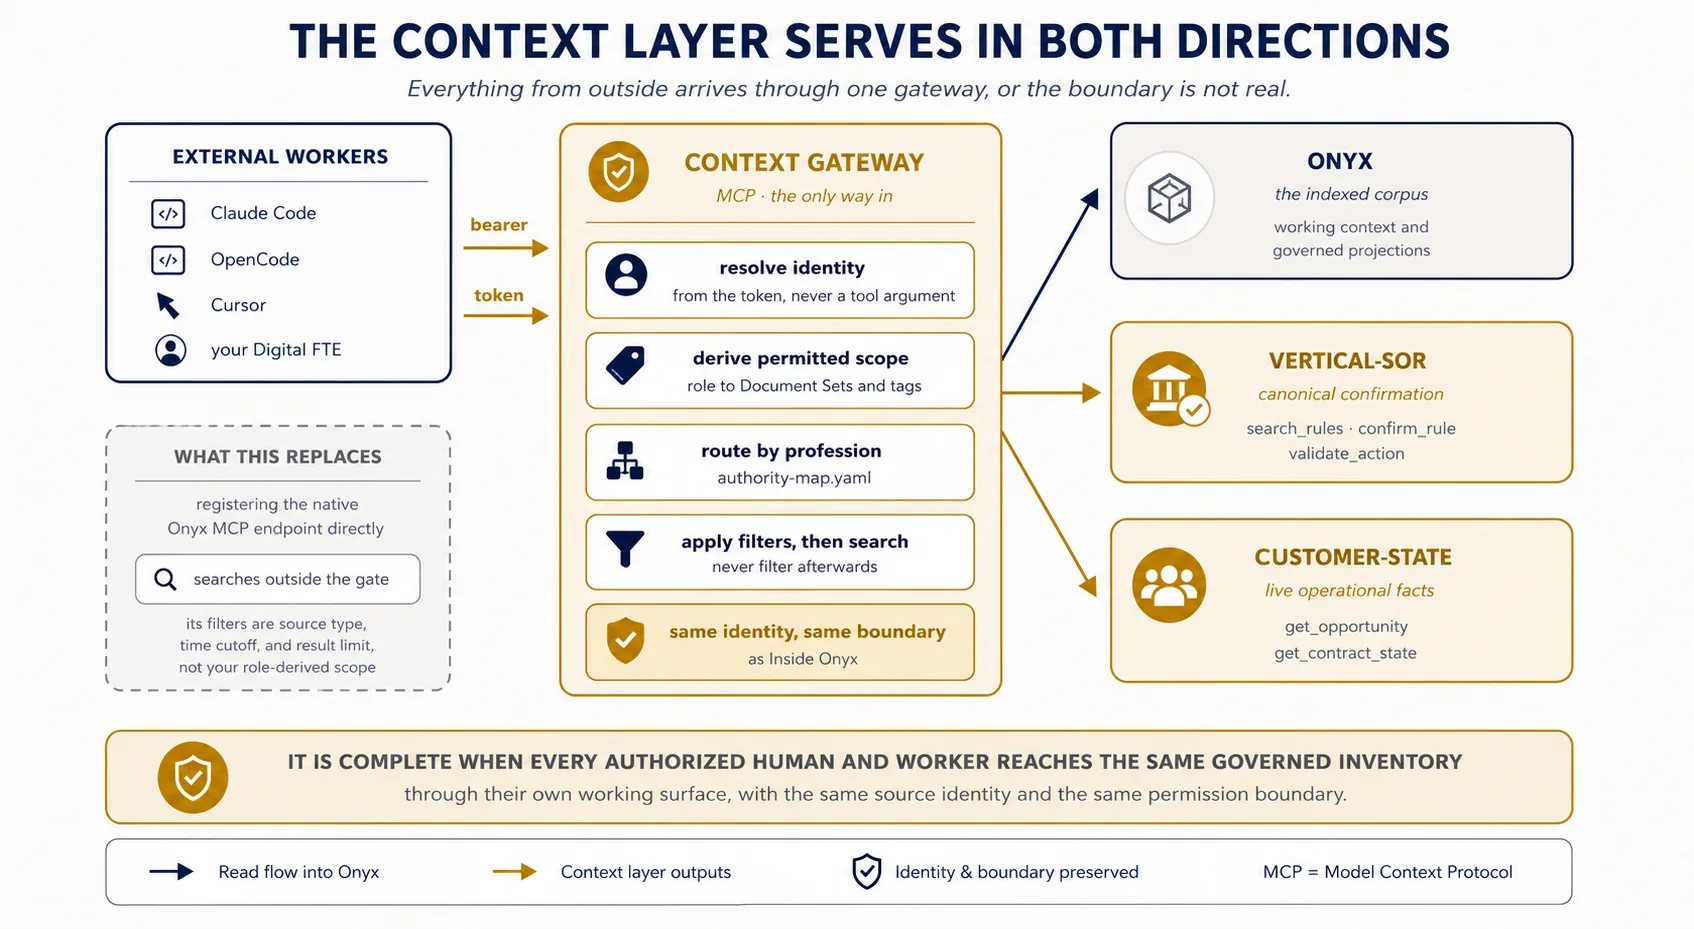
有两种实现方式,只有一种能保住 permission boundary。
原生 Onyx MCP server 是快捷路径。在自托管配置中启用,生成 token,再把 client 指向它。Search tool 接收 query,以及 source type、Document Set name 和 time cutoff filter;另一个 companion resource 会列出该 token 可以访问的 set。
仔细阅读列表,因为它并不会让人放心。Document Set filter 虽然存在,却由 client 选择。Server 完全不会根据 caller role 推导 scope,所以能够指定自身 scope 的 client 也能指定另一份 scope,或者完全不传。
因此,直接连接原生 Onyx MCP 的 Worker 会在你的 gate 之外搜索。Community Edition 底层没有 source-permission inheritance,这意味着它会搜索一切。
如实使用原生 Onyx MCP endpoint:它可以是管理员工具、公开语料库演示,或者生产路径,但最后一种只适用于 permission fidelity 已被证明之后,也就是使用 Enterprise 部署或由你提供等价 authorization layer。
不要声称直接的 Community Edition MCP access 携带相同用户 permission boundary。它没有。
Context Gateway MCP server 才是能够成立的路径。它就是前面构建的 gateway,只是现在向外提供:
Claude Code  ·  OpenCode  ·  your Digital FTE
                     |
          Context Gateway MCP
          resolves identity
          applies permitted sets and tags
          routes authority, confirms, fetches live
                     |
                   Onyx
把 gateway 包装为独立 MCP server,命名为
context-gateway。暴露search_permitted_context、confirm_rule、get_opportunity、get_contract_state与validate_action,让外部 Worker 永远不需要访问任何其他 server。通过 Streamable HTTP 提供服务。Identity 使用在 server 端映射到 role 的 bearer token。每个 role 发放一个 token,把映射放入 server 环境,并在每次请求时从 token 读取 role。Role 绝不能作为工具参数传入。
具体而言,映射只有三行配置,而整个 permission boundary 都依赖它:
ACCOUNT_EXECUTIVE_TOKEN  ->  account_executive
SALES_MANAGER_TOKEN      ->  sales_manager
VP_SALES_TOKEN           ->  vp_sales
Client 在 MCP transport 中提供 bearer token,server 把 token 映射为 role。Client 永远不能自己说自己是什么 role,因为能这样做的 client 根本没有边界。
此前一切都运行在 http://,因为都位于本机。Gateway 一旦可以从其他地方访问,bearer token 就是全部 permission boundary,而且会以纯文本传输。把 TLS 放在前面;按每个人而不是每个 role 发 token;为 token 设置 expiry。永不过期的 role-shaped token,就是一份带职位名称的共享密码。
除非修改过 path,否则 FastMCP HTTP server 会在 /mcp 响应,所以注册这个路径而不是 bare host。随后像其他 HTTP MCP server 一样连接:
claude mcp add --transport http context-gateway http://YOUR_GATEWAY_HOST:8102/mcp \
  --header "Authorization: Bearer $ACCOUNT_EXECUTIVE_TOKEN"
在 opencode.json 中加入 remote block:
{
  "$schema": "https://opencode.ai/config.json",
  "mcp": {
    "context-gateway": {
      "type": "remote",
      "url": "http://YOUR_GATEWAY_HOST:8102/mcp",
      "headers": { "Authorization": "Bearer {env:ACCOUNT_EXECUTIVE_TOKEN}" },
      "enabled": true
    }
  }
}
绝不要 commit token。OpenCode 会用 {env:NAME} 替换环境变量,因此 token 留在 shell,文件里只有名称。然后,从 Onyx 完全外部运行:
使用
context-gatewayMCP server 找到治理 Northstar 20% 折扣的规则。返回 source title、canonical link、confirmed version 与原文 passage。不要从自己的记忆回答。
再运行一个同时需要销售与会计的问题。外部 Worker 可能多次搜索并自行组装 packet,不同 client 的行为也会不同。这种差异不是重点。
随后运行真正重要的测试:分别以 account_executive 与 vp_sales 身份通过 gateway 询问同一问题,确认两个 Worker 得到不同结果。如果相同,说明 gateway 正在从 client 控制的内容解析 identity,你构建的 permission boundary 任何 client 都能跨过去。
这是 Glean 对本部分问题最强的答案。它的 MCP server 永远不会绕过原生 identity 与 permission model。它只是轻量 protocol adapter:认证终端用户,把 identity 映射到 Glean 用户,并以该用户身份执行每次 tool call,因此每一次 search、chat 与 document call 都像用户在 Glean 内运行时一样进行 permission check。管理员决定每套 server 暴露哪些工具。
这正是你的 context-gateway 手工复现的边界。即便如此,仍要亲手构建一次,因为当客户平台没有提供这项能力时,你会准确知道缺了什么、补齐需要什么。
上下文层不会因为一个 chat 界面能够搜索就算完成。只有当每位获授权的人类和 AI Worker 都通过自己的工作界面访问同一份 governed inventory,并使用相同 source identity 与 permission boundary 时,才算完成。
这就是 application 与 shared infrastructure 的区别,也是这一层不再只是产品功能、而真正成为公司运行基础的时刻。
运营它
上下文层每天都在变化,因为周围系统每天都在变化。所以生产工作不是「部署一次」,而是 connector health、permission fidelity、freshness、measurement 与受控升级。
Connector 运营
每个 connector 都要记录九件事:owner、source class、谁拥有 credential、refresh 与 prune 频率、indexing 开始时间、预期 document count、最近一次成功 sync、可接受 staleness,以及 escalation path。
Onyx 会把 connector 显示为 indexed、scheduled、indexing、paused 或 in error,并保留 attempt history。陷阱在于:出错 connector 不一定会删除已经索引的内容。 这对 availability 很好,对 freshness 却很危险,因为搜索继续工作,语料库却悄悄变旧。Alert 必须区分「搜索仍然可用」与「语料库仍是当前版本」,二者不是同一个 alarm。
Version 与升级纪律
安装程序可以升级现有部署。绝不要把 one-command upgrade 当成 no-review upgrade。 按顺序完成八步:
- 记录当前 version。
- 阅读 release note。
- 备份 persistent volume 与配置。
- 导出 connector、model、Agent、Action 与 permission 设置。
- 运行 eval baseline。
- 先升级非生产实例。
- 重新运行相同 eval。
- 比较 connector count、citation、tool call 与 latency。
Embedding 与索引变更
更换 embedding 模型需要重新索引。要像 schema migration 一样对待:尽可能 clone deployment;索引一份代表性语料库;运行 authority 与 retrieval eval;比较 recall、citation quality、latency、cost 与 storage;只批准测量后确有改善的变更。
资源规划
本地实验中,4 个虚拟 CPU 与 10 GB RAM 是可用的最低 Standard 目标,推荐 8 个 CPU 与至少 16 GB。生产 sizing 主要取决于 indexed volume、query concurrency、embedding 与 reranking 选择,以及 refresh load。密切监控磁盘,因为 search index 接近 disk flood threshold 时会阻止写入。
生产完成定义
只有满足下面全部条件,这一层才能接入真实公司数据:
- 每个来源都分类为 shared method、Vertical authority、operational state 或 working context。
- 每个 connector 都有 owner、canonical source、refresh expectation 与 failure alert。
- Authority routing 带版本,并由 domain expert 审查。
- Governed knowledge 在被依赖前已回到来源确认。
- 需要时,当前 operational fact 已实时确认。
- Source permission 在 retrieval 前已同步或执行。
- MCP 与 API action 保留个人 identity 与 least privilege。
- Conflict 与 missing evidence 始终可见。
- Citation 可以重新打开 canonical source 或 record。
- 每次 release 都通过 cross-domain eval。
- Backup 与 restoration 已实际测试。
- 升级与 retrieval 变更都有 rollback path。
- System of Context 无法绕过适用的 System of Record 写入。
通往 Digital FTE 的桥梁
现在,你拥有了同一件事的两个半面。上一门课 为 Worker 提供它自己拥有的知识;本课程让它访问公司拥有的知识,同时附上 permission、provenance 与 confirmation。
当你为这个 Worker 套上 success contract,并让它专注于一个 outcome,就得到 Digital FTE。它的 retrieval 是你在这里构建的,它的 authority 由 governed record 决定,而 trustworthiness 根本不是模型属性。
接下来去哪里
- 本次构建背后的论证: System of Context
- 这一层连接的记录: 设计 Vertical SoR
- 让它可靠: Eval-Driven Development
- 把它变成工作单元: 构建 Digital FTE
- 把它放在人类身边: Human-Agent Teams
八条规则,一页看全
你已经构建了下面的一切。无论职业、客户或产品是什么,包括尚未出现的产品,它们都成立。
| # | 规则 |
|---|---|
| 1 | Authority 永不移动。 这一层携带指向 record 的 citation;它和模型都永远不会成为被引用来源 |
| 2 | Relevance 不等于 authority。 依赖任何 passage 前,routing 已经确定 |
| 3 | Permission 只能继承,不能发明,并在模型之前执行 |
| 4 | Freshness 按字段决定。 索引 working context,发现 governed knowledge,实时查询 current truth |
| 5 | Provenance 随每项内容同行,compression 永不剥离它 |
| 6 | Conflict 被保留并升级,绝不混合 |
| 7 | Working context 永不悄悄变成 governing authority。 Promotion 是创作,必须审查并记录 |
| 8 | Discovery 不是 confirmation。 Search hit 是指针,governing record 负责确认 |
把这张表打印出来。它是本课程中比 Onyx、Glean 以及任何替代它们的产品活得更久的部分。
主线从未改变,只会越来越严格。上一门课说:在正确时刻提供正确信息,把无关信息排除。本课程再加入让系统可以辩护的三个问题。
它来自哪里?这个人可以看吗?它现在仍然有效吗?
每一项、每一次都回答三个问题,你就构建出一个专业领域愿意站在其背后的系统。