نماذج اللغة الكبيرة مفتوحة المصدر: حاسوبك المحمول، خادمك أو عنقودك، والسحابة
عائلة نماذج واحدة، وثلاث طرق لتشغيلها. على حاسوبك المحمول باستخدام Ollama. وعلى جهاز قوي باستخدام vLLM لخدمة 50 شخصا في الوقت نفسه. وفي السحابة عبر OpenRouter، حيث تعيش أكبر النماذج المفتوحة. الأدوات نفسها، والفكرة نفسها، وثلاثة مقاييس.
لقد استخدمت الذكاء الاصطناعي من قبل. كتبت في مربع فأجابك. لم يكن ذلك الذكاء الاصطناعي يعيش على حاسوبك، بل على أجهزة ضخمة بعيدة تملكها شركة. كنت تستأجر جزءا صغيرا من وقته.
تعلمك هذه الدورة النطاق الكامل للخيارات المتاحة لك فعلا. غيرت النماذج مفتوحة المصدر قواعد اللعبة: أوزان النموذج متاحة للتنزيل مجانا، ويستطيع أي شخص تشغيلها. لكن عبارة «يستطيع أي شخص تشغيلها» تخفي سؤالا حقيقيا: أين تشغلها؟ على حاسوبك المحمول؟ أم على جهاز مستأجر ببطاقة رسومية قوية؟ أم على عنقود يملكه شخص آخر، لأن النموذج أضخم من أي جهاز يمكن أن تملكه؟
هذه هي المستويات الثلاثة في هذه الدورة، ولكل منها جزء مستقل:
| الجزء | المستوى | طبقة التقديم | المقياس | ما ستفعله |
|---|---|---|---|---|
| 1 | محلي | Ollama | شخص واحد، حاسوب محمول واحد | تشغل نموذجا على جهازك وتوجه إليه وكيل برمجة |
| 2 | خادم أو عنقود | vLLM | مستخدمون كثيرون، جهاز واحد أو عنقودك الخاص | تقدم نموذج Qwen3 8B نفسه إلى 50 طلبا متزامنا وتقيس التغير |
| 3 | السحابة | OpenRouter (بوابة) | نماذج رائدة لا يكاد أحد يستطيع استضافتها ذاتيا | تقود Kimi K3 وDeepSeek V4 Pro من وكيلي البرمجة نفسيهما |
ثلاثة مستويات، وثلاثة عناوين، وثلاث فواتير. الحاسوب المحمول: يعمل Ollama على http://localhost:11434، وتكلفته صفر. الخادم: يعمل vLLM على http://localhost:8000، وتكلفته استئجار GPU، أي نحو $0.50 إلى $2 في الساعة لبطاقة سعتها 24 GB بحسب المزود. السحابة: يعمل OpenRouter على https://openrouter.ai/api، وتكون التكلفة حسب الرمز، من نحو $0.44 لكل مليون رمز، لإدخال DeepSeek V4 Pro، إلى $15 لكل مليون رمز، لإخراج Kimi K3، وقت كتابة هذه الصفحة. يعلمك كل ما يلي متى يكون كل عنوان هو الاختيار الصحيح. تتغير الأسعار والإيجارات، لذا تحقق منها مباشرة قبل إعداد الميزانية.
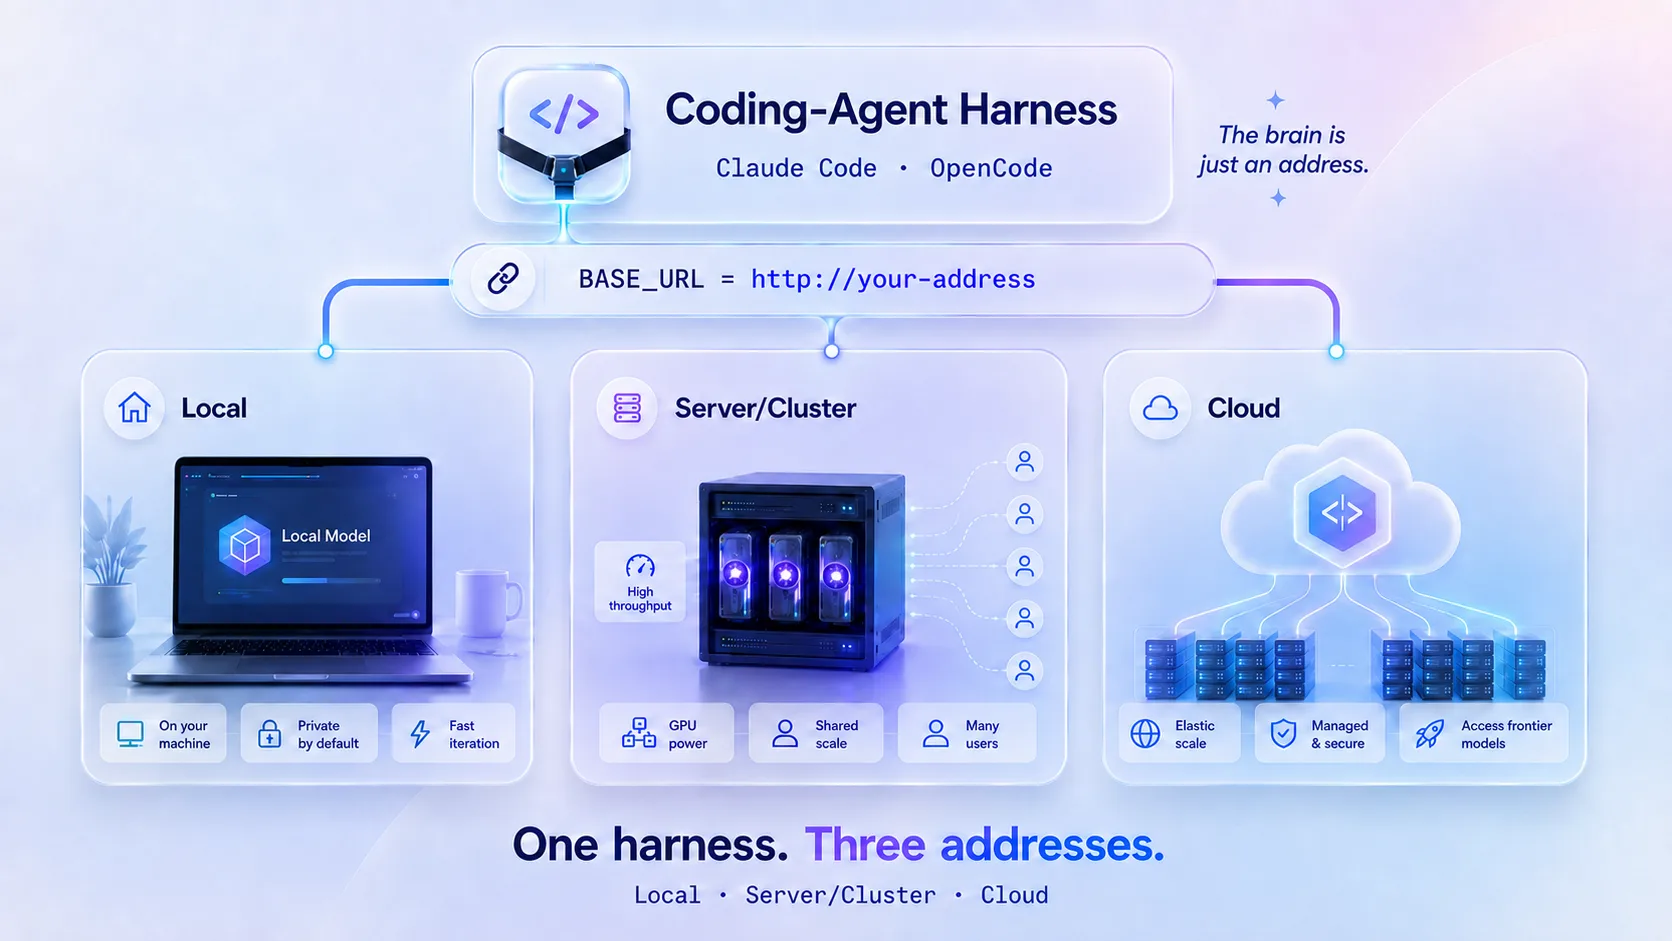
تصلح صورة واحدة للدورة كلها. تتكون أي أداة ذكاء اصطناعي من جزأين. يوجد على جهازك جزء ينفذ العمل العملي، وهو الحاضنة. والجزء الآخر هو الدماغ الذي يفكر، أي النموذج. تصل الحاضنة إلى الدماغ عند عنوان. في الجزء 1 يكون ذلك العنوان حاسوبك المحمول. وفي الجزء 2 يكون جهازا تتحكم فيه ويحمل بطاقة رسومية حقيقية. وفي الجزء 3 يكون خدمة سحابية تقف أمام نماذج تضم تريليونات المعاملات. لا تتغير الحاضنة أبدا، بل يتغير العنوان وحده. تعلم هذه الفكرة مرة واحدة، فتصبح المستويات الثلاثة الحركة نفسها.
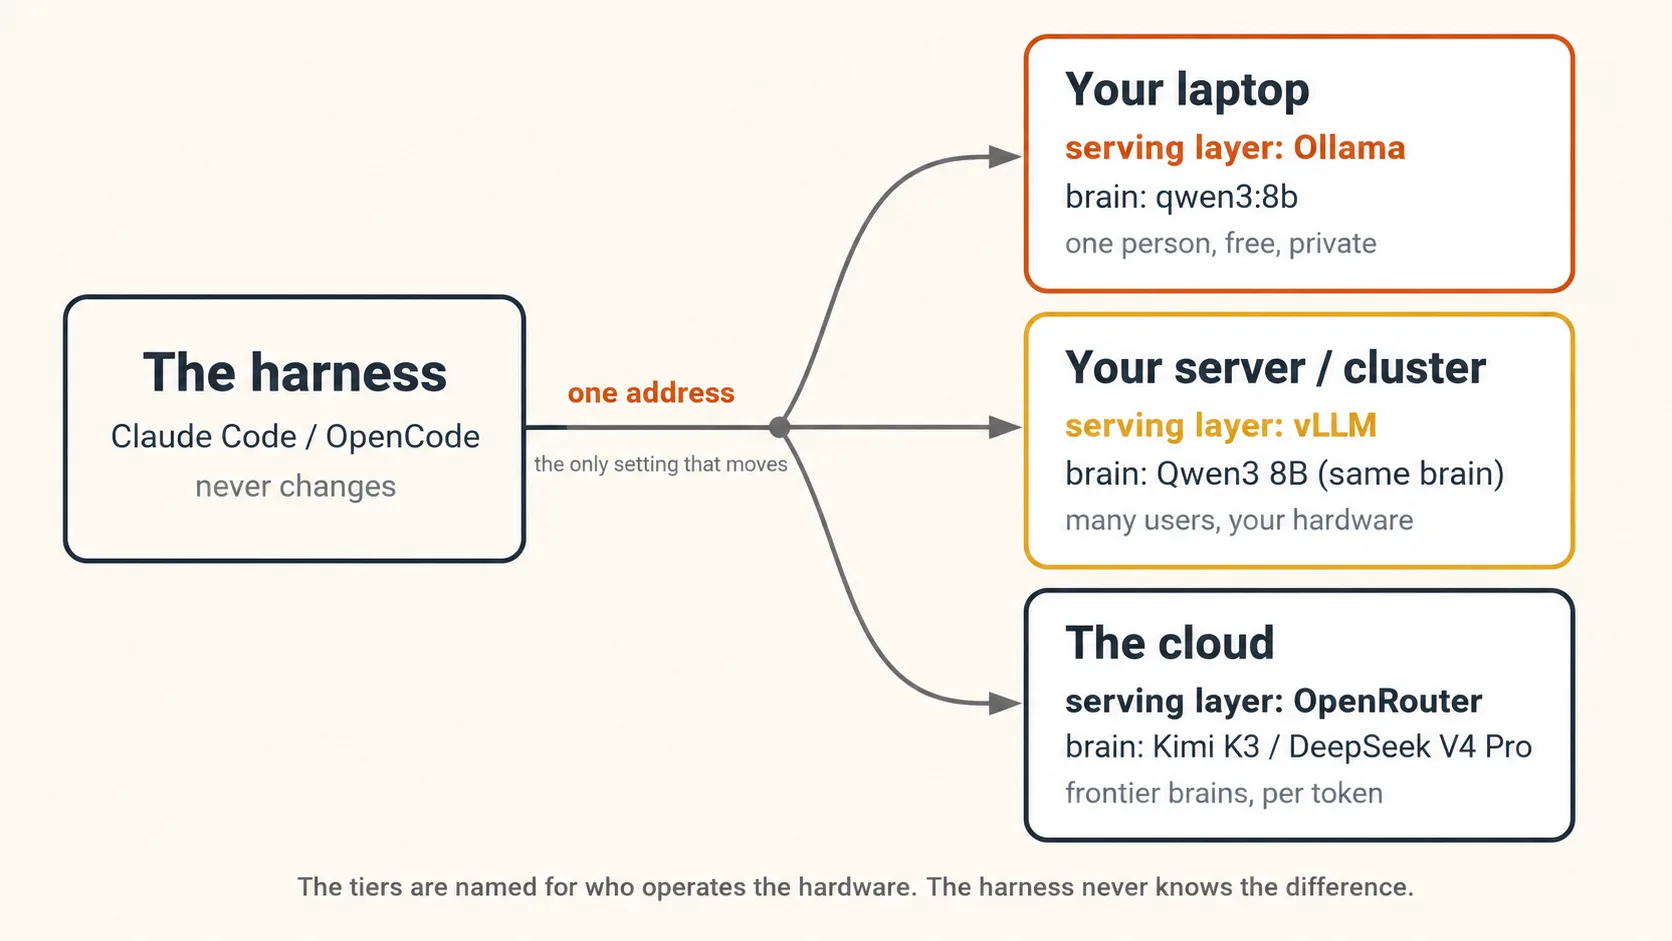
هذه محطتك الأولى في قسم الوكلاء العامين، حيث تختار الذكاء الاصطناعي الذي ستقوده خلال بقية الكتاب. تبدأ بامتلاك الدماغ، لأن ذلك يجعل الفكرة الأساسية للقسم ملموسة منذ اليوم الأول: الوكيل حاضنة مع دماغ قابل للتبديل. ومن هنا تنتقل إلى قيادة ذلك الوكيل جيدا في البرمجة الوكيلة، وتوجيهه بمواصفة مكتوبة في التطوير المدفوع بالمواصفات، ومنحه حلقة تعمل من دونك في هندسة الحلقات.
والآن إليك الوعد الصريح والحد الصريح بكلمات واضحة. الجزء 1 حقيقي ومجاني وخاص على أي جهاز، وإن كانت أعمال البرمجة الثقيلة بطيئة جدا على حاسوب محمول عادي. هذا البطء ليس خطأ في الدورة. وتعلم رؤيته وفهم سببه درس أساسي في الجزء 1. يحتاج الجزء 2 إلى جهاز ببطاقة رسومية من NVIDIA، ويستأجر معظم الطلاب واحدا بالساعة مقابل بضعة دولارات. ويحتاج الجزء 3 إلى حساب OpenRouter فيه بضعة دولارات من الرصيد. كل جزء مستقل. أنجز الجزء 1 اليوم، ثم عد إلى البقية متى كنت مستعدا.
- الجزء 1، التحدث مع نموذج محلي: لا شيء سوى تثبيت Ollama المجاني. يستطيع أي شخص فعل ذلك.
- الجزء 1، نصف البرمجة، والجزآن 2 و3: وكيل برمجة، سواء Claude Code أو OpenCode، مثبت مسبقا. ليس لديك واحد بعد؟ تعد لك دورة البرمجة الوكيلة المكثفة واحدا. ويمكنك إنجاز تلك الدورة قبل هذه الدورة أو بعدها.
- الجزء 2 فقط: وصول إلى جهاز Linux يحمل GPU من NVIDIA: نحو 24 GB من ذاكرة GPU للبناء القياسي، أو نحو 16 GB للبناء المضغوط على عتاد متوافق، ويعرض الجزء 2 المسارين. من المعتاد والرخيص أن تستأجر جهازا من مزود GPU سحابي لمدة ساعة أو ساعتين.
- الجزء 3 فقط: حساب OpenRouter مجاني وبضعة دولارات من الرصيد.
يمكنك المتابعة على جهازك منذ الخطوة الأولى. أوامر هذه الصفحة مكتوبة بلغة Bash لنظامي macOS وLinux، ولنظام Windows عبر WSL. إذا كنت تستخدم PowerShell بدلا منها، فتعرض الوثائق المباشرة لكل أداة الصيغة المطابقة. وفي أي خطوة تخص وكيل برمجة، اعمل داخل مجلد git صغير مؤقت، كي لا يستطيع الوكيل لمس أي شيء يهمك. ستتعلم من حد تصطدم به بنفسك أكثر مما تتعلم من ثلاثة حدود تقرأ عنها فقط.
كلمات أساسية بلغة بسيطة
اقرأ هذا مرة الآن، وعد إليه كلما بدت لك كلمة غير واضحة. تعيد المفاهيم أدناه تعليم هذه الكلمات في سياقها، فلا تحتاج إلى حفظها هنا.
| المصطلح | معناه بلغة بسيطة |
|---|---|
| النموذج أو الدماغ | الذكاء الاصطناعي الذي يفكر فعلا. ترسل إليه كلمات فيعيد إليك كلمات. |
| Ollama | برنامج مجاني ينزل نموذج ذكاء اصطناعي ويشغله على جهازك. صمم لشخص واحد. |
| vLLM | برنامج مجاني يقدم نموذج ذكاء اصطناعي إلى مستخدمين كثيرين في الوقت نفسه. صمم لجهاز مشترك. |
| طبقة التقديم | البرنامج الذي يحمل نموذجا ويجيب عن الطلبات. يعد Ollama وvLLM طبقتي تقديم. |
| OpenRouter | بوابة سحابية تضع مئات النماذج خلف عنوان واحد. ويشغل المضيفون خلفها طبقات التقديم. |
| الحاضنة أو الأداة | البرنامج المحيط بالدماغ. يقرأ ملفاتك ويشغل الأوامر ويعرض لك التغييرات. ومن أمثلته Claude Code. |
| وكيل البرمجة | حاضنة تكتب الشفرة وتحررها نيابة عنك، مثل Claude Code أو OpenCode. |
localhost | عنوان يعني «هذا الحاسوب نفسه». يتحدث جهازك إلى نفسه، فلا يحتاج إلى الإنترنت. |
| العنوان أو عنوان URL الأساسي | المكان الذي ترسل إليه الأداة عملها. وجهها إلى localhost فيبقى العمل على جهازك. |
| استدعاء الأداة | رسالة صغيرة ودقيقة يرسلها النموذج ليقول «حرر هذا الملف» أو «شغل هذا الأمر». إنها بيانات وليست جملة. |
| الرمز | الوحدة التي يقرؤها النموذج ويحاسبك عليها فعليا، وهي جزء من كلمة، يقارب 3 إلى 4 أحرف إنجليزية. |
| نافذة السياق | عدد الرموز التي يستطيع النموذج الاحتفاظ بها دفعة واحدة. إذا صغرت نسي بداية المهمة. |
num_ctx | إعداد Ollama لنافذة السياق. تعتمد قيمته الافتراضية على جهازك، وغالبا ما تكون أصغر من حاجة وكلاء البرمجة. |
| الجداران | الشرطان اللذان يجب أن يحققهما إعداد برمجة محلي: نموذج قوي بما يكفي وعتاد سريع بما يكفي. |
| التزامن | عدد الطلبات التي تصل في الوقت نفسه. مستخدم واحد يعني تزامنا قدره 1. وفصل دراسي يعني تزامنا قدره 50. |
| الإنتاجية | إجمالي العمل المفيد في الثانية، ويقاس هنا بالرموز في الثانية عبر جميع المستخدمين مجتمعين. |
| التجميع المستمر | حيلة vLLM: يمرر طلبات كثيرة عبر GPU معا، ويدخل طلبات جديدة في أثناء التشغيل. |
| النموذج مفتوح الأوزان | نموذج يمكن تنزيل أوزانه المدربة. وليس دائما «مفتوح المصدر» بالمعنى الرسمي، فقد تظل بيانات التدريب وبعض الشروط مغلقة. |
| النموذج المفتوح الرائد | نموذج مفتوح الأوزان يتصدر التصنيفات، وضخم إلى حد لا تستطيع تقديمه إلا العناقيد. ومن أمثلته Kimi K3. |
| مفتاح API | سلسلة سرية تثبت أن الحساب لك. وفي المستوى السحابي تحدد أيضا الجهة التي ستدفع الفاتورة. |
تمتد عبر هذه الدورة طبقتان تتقادمان بسرعتين مختلفتين جدا. تذكر الأولى، وابحث عن الثانية.
- الطبقة الدائمة. يمكن أن يعيش النموذج على ثلاثة مقاييس: جهازك، أو جهاز تتحكم فيه، أو عنقود تستأجره. تصل إليه أداتك عند عنوان تستطيع تغييره. تصطف الطلبات تحت الحمل في طبقة تقديم صممت لمستخدم واحد، ولا يحدث ذلك في طبقة صممت للكثيرين. ويعتمد اختيار المستوى الصحيح على الخصوصية والعتاد والتكلفة، بطرق ستشعر بها ثم تسميها. يبقى هذا صحيحا بعد زمن طويل من تغير كل أمر أدناه.
- الطبقة الميكانيكية. كل رقم إصدار وخيار واسم نموذج وسعر وإعداد. تتغير Ollama وvLLM وOpenRouter وأدوات البرمجة بسرعة. لذلك عامل كل أمر هنا بوصفه مؤشرا إلى الوثائق المباشرة، لا حقيقة تحفظها. وحين تختلف هذه الدورة عن الوثائق الحالية، تكون الوثائق هي الصحيحة.
ما تغطيه هذه الدورة
| المفهوم | الجزء | ما ستفعله |
|---|---|---|
| 1 | 1 | تشغل نموذجا على جهازك وتتحدث معه خلال دقيقتين تقريبا |
| 2 | 1 | تتعلم الفكرة الوحيدة التي تجعل كل شيء يعمل: الدماغ مجرد عنوان |
| 3 | 1 | تجعل النموذج ينفذ الأشياء: توجه إليه وكيل برمجة بأمر واحد |
| 4 | 1 | تمنحه مهمة برمجة حقيقية، وتشعر بموضع صمود الدماغ المحلي أو انهياره |
| 5 | 1 | تفهم الجدارين: نموذج قوي بما يكفي وعتاد سريع بما يكفي |
| 6 | 1 | تنظر داخل استدعاء أداة حقيقي، وهو الشيء الذي يخطئ فيه النموذج الضعيف |
| 7 | 1 | تقرر متى يستحق امتلاك الدماغ العناء |
| 8 | 2 | ترى لماذا يشبه Ollama مطبخا لشخص واحد: ترسل إليه 50 طلبا وتراقبها تصطف |
| 9 | 2 | تقدم نموذج Qwen3 8B نفسه باستخدام vLLM، وتتعلم معنى التجميع المستمر |
| 10 | 2 | تشغل الطلبات الخمسين نفسها على vLLM، وترسم المنحنيين، وتقرأ الفرق |
| 11 | 2 | تصل Claude Code وOpenCode بخادم vLLM من دون مترجم بينهما |
| 12 | 2 | تقرر متى يستحق مستوى الخادم العناء |
| 13 | 3 | تتعرف إلى النماذج المفتوحة الرائدة التي لا يكاد أحد يستطيع استضافتها ذاتيا: Kimi K3 وDeepSeek V4 Pro |
| 14 | 3 | تقود كليهما من Claude Code وOpenCode عبر OpenRouter |
| 15 | 3 | تختار بين الأداء والسعر، وتنتقي المستوى الصحيح لأي عمل |
| 16 | 3 | تضع موجها واحدا أمام المستويات الثلاثة، وتحول سياستك للمستويات إلى إعداد |
| A | الملحق | تحول خادم الجزء 2 إلى خدمة مشتركة ذات مفاتيح وميزانيات وقائمة واحدة |
📚 وسيلة تعليمية
اعرض العرض التقديمي كاملا: نماذج اللغة الكبيرة مفتوحة المصدر: حاسوبك المحمول، خادمك أو عنقودك، والسحابة
الجزء 1: المستوى المحلي، نموذج على حاسوبك المحمول (Ollama)
طبقة التقديم في هذا الجزء هي Ollama، والمقياس شخص واحد وجهاز واحد. كل شيء هنا مجاني وخاص.
1. دماغ على جهازك: ابدأ هنا
أسرع طريق إلى فهم هذا هو تنفيذه مرة واحدة. لذلك، وقبل أي نظرية، دعنا نشغل نموذجا على جهازك ونتحدث إليه. لا تحتاج إلى كتابة أي شفرة في هذا الجزء، ويستطيع أي شخص إنجازه.
يسمى البرنامج المجاني الذي يفعل ذلك Ollama. ينزل نموذج ذكاء اصطناعي ويشغله على حاسوبك. اختر الطريقة التي تطابق جهازك.
- التطبيق (Mac أو Windows)
- الطرفية (أي حاسوب، بما فيه Linux)
- انتقل إلى ollama.com/download وثبت Ollama بالطريقة المعتادة. ويشمل ذلك تطبيق محادثة صغيرا.
- افتح تطبيق Ollama. ستجده في شريط القوائم على Mac أو علبة النظام على Windows.
- اختر نموذجا من أداة الاختيار في الأعلى. ابدأ بنموذج صغير مثل
gemma3:4b. عند اختياره أول مرة ينزل بضعة غيغابايت، ويستغرق ذلك بضع دقائق. - اكتب سؤالا في المربع واضغط Enter.
هذا كل شيء. جاءت الإجابة من نموذج يعمل على جهازك.
افتح طرفية وشغل أمرا واحدا. ينزل النموذج في المرة الأولى، ثم يدخلك في محادثة:
ollama run gemma3:4b
اكتب سؤالك واضغط Enter. ولمغادرة المحادثة، اكتب /bye.
إذا لم يكن Ollama مثبتا لديك بعد، فثبته أولا من ollama.com/download، ثم شغل الأمر أعلاه.
أي نموذج تختار؟ ابدأ بنموذج صغير. يجيب النموذج الصغير بسرعة ويلائم جهازا متواضعا. ويمكنك تجربة نماذج أكبر لاحقا.
| النموذج | حجم التنزيل التقريبي | ذاكرة RAM المريحة | مناسب من أجل |
|---|---|---|---|
gemma3:1b | أقل من 1 GB | نحو 4 GB | صغير جدا وسريع، لكن إجاباته ضعيفة |
llama3.2:3b | نحو 2 GB | نحو 8 GB | محادثة أولى صغيرة وجيدة |
gemma3:4b | نحو 3 GB | نحو 8 GB | نموذج صغير قوي وخيار افتراضي جيد |
qwen3:8b | نحو 5 GB | نحو 16 GB | إجابات أفضل، ويحتاج إلى ذاكرة أكبر |
لنموذج واحد في هذا الجدول أهمية تتجاوز هذا الجزء، وهو qwen3:8b. فهذا هو النموذج الذي تثبته الدورة عبر الجزأين 1 و2، كي تعرف السبب بدقة حين تتغير النتائج. إذا كان جهازك يتسع له فنزله الآن. وإن لم يتسع، فاستخدم نموذجا أصغر هنا واستأجر العتاد في الجزء 2.
تتغير الأسماء والأحجام الدقيقة أعلاه مع تحديث هذه النماذج. وقبل الاعتماد على أي وسم، تحقق منه في ollama.com/library. تمثل عادة التحقق من المصدر المباشر طبقة «ابحث عنه» وهي تعمل.
يكتمل المفهوم 1 عندما: تطرح سؤالا ويجيب نموذج يعمل على جهازك. أوقف شبكة wifi واسأل مرة أخرى، وسيظل يعمل. لم يغادر حاسوبك شيء.
تستحق النقطة الأخيرة لحظة من التأمل. يعمل النموذج كبرنامج صغير على جهازك، ويستمع عند عنوان يسمى localhost. وتعني هذه الكلمة ببساطة «هذا الحاسوب نفسه». يتحدث جهازك إلى نفسه، ولهذا يظل يعمل والإنترنت متوقف.
إذا كنت تريد فقط ذكاء اصطناعيا خاصا على جهازك، فقد حصلت عليه. يمكنك تشغيله في أي وقت وبلا اتصال ومجانا، ولن يغادر جهازك أي شيء تكتبه. وهذه المعرفة وحدها تستحق العناء.
تجعل بقية الدورة النموذج المحلي نفسه ينفذ أشياء: يقرأ ملفاتك ويكتب الشفرة ويحررها لك. إذا كان ذلك يهمك فتابع القراءة. وإن لم يكن، فقد حققت الفوز بالفعل.
2. الفكرة الوحيدة التي تجعل هذا يعمل: الدماغ مجرد عنوان
لقد نفذت الأمر للتو. والآن دعنا نسمي ما حدث، لأن هذه الفكرة الواحدة تقع تحت كل أداة ذكاء اصطناعي ستستخدمها، وتحت المستويات الثلاثة للدورة. وتستحق أن نتمهل عندها.
تتكون أداة الذكاء الاصطناعي لديك من جزأين:
- الحاضنة: البرنامج الموجود على جهازك. يقرأ ملفاتك ويشغل الأوامر ويعرض لك ما تغير. يعد Claude Code حاضنة، ويعد تطبيق محادثة Ollama حاضنة أبسط.
- الدماغ: النموذج الذي يقرأ كل ذلك ويقرر ما سيقوله أو يفعله.
تصل الحاضنة إلى الدماغ بالطريقة نفسها التي يصل بها متصفحك إلى موقع ويب: عبر عنوان. فكر فيه كأنه رقم هاتف. تطلب الحاضنة رقما، ومن يجيب يتولى التفكير.
يشير ذلك الرقم عادة إلى مكان بعيد، أي أجهزة شركة ما. لكنه مجرد إعداد. غير الرقم، وستتحدث الحاضنة نفسها تماما إلى دماغ مختلف. كان الرقم الجديد في المفهوم 1 هو localhost، أي جهازك. ولذلك كان الدماغ الذي أجابك هو الموجود على حاسوبك المحمول.
فكر في تطبيق لتوصيل الطعام. يظل التطبيق على هاتفك نفسه كل يوم. غير عنوان المطعم، فيطلب التطبيق نفسه الآن من مطبخ مختلف. أداة الذكاء الاصطناعي هي التطبيق، والعنوان هو رقم الهاتف، والمطبخ الموجود عند ذلك العنوان هو المكان الذي يطهو فيه نموذجك.
إليك الجزء الذي يسهل فهمه خطأ، وسيهمنا لاحقا. الدماغ المحلي ليس نسخة أصغر من الدماغ نفسه الذي استخدمته من قبل، بل هو دماغ مختلف. وقد يكون أضعف كثيرا. التطبيق نفسه والمطبخ مختلف، وربما يكون طاهي المطبخ الجديد أقل مهارة. تذكر ذلك، فهو يقود مباشرة إلى المفهوم 5.
تمسك بصورة المطبخ، لأن هذه الدورة تزور ثلاثة مطابخ. الجزء 1 هو مطبخ منزلك. والجزء 2 مطبخ صناعي تديره بنفسك وصمم لخدمة مطعم كامل. والجزء 3 هو طلب الطعام من أفضل مطاعم العالم، لأن أي منزل لا يمكن أن يتسع لمطبخها. يظل التطبيق نفسه طوال الطريق، ولا يتغير سوى العنوان.
غيرت عنوانا واحدا، فأجاب نموذج على جهازك. أي جزء من أداة الذكاء الاصطناعي تغير، وأي جزء ظل كما هو؟ تغير الدماغ: تذهب كلماتك الآن إلى نموذج على جهازك. وظلت الحاضنة كما هي: التطبيق والأزرار وطريقة حديثك إليه. لم تغير سوى العنوان الذي تطلبه.اعرض الإجابة
3. اجعله ينفذ الأشياء: وكيل برمجة على دماغك المحلي
تمثل المحادثة مع نموذج محلي بداية جيدة، لكن الوكيل يفعل أكثر من المحادثة. فهو يقرأ ملفاتك ويكتب الشفرة ويشغل الأوامر لك. لذلك دعنا نوجه وكيل برمجة إلى الدماغ المحلي نفسه.
تصل هذه الخطوة وكيل برمجة بنموذجك المحلي. لذلك تحتاج إلى Claude Code أو OpenCode مثبتا مسبقا. إذا كان لديك أحدهما فأنت جاهز. وإن لم يكن، فثبت واحدا أولا، وستقودك دورة البرمجة الوكيلة المكثفة خلال ذلك. يصل الأمر أدناه الوكيل ويشغله، لكنه لا يثبته لك.
توجد طريقتان لتنفيذ ذلك. الطريقة السهلة هي أمر واحد، أما الطريقة اليدوية فتعرض لك الأسلاك الموجودة في الداخل، ويستحق الأمر رؤيتها مرة. اختر تبويبا.
- شغله مباشرة
- أعده يدويا
تستطيع الإصدارات الحديثة من Ollama توصيل وكيل برمجة وتشغيله لك من دون تحرير أي إعداد. تحتاج إلى أمر واحد:
ollama launch claude
يعد ذلك Claude Code لاستخدام نموذج محلي ثم يشغله. سيسألك عن النموذج الذي تريد استخدامه، أو يمكنك تسمية نموذج نزلته مسبقا:
ollama launch claude --model qwen3:8b
توجد أداة أخرى لها أمر مطابق: ollama launch opencode.
unknown command "launch"يحتاج الأمر ollama launch إلى إصدار حديث من Ollama، أي الإصدار 0.15 أو أحدث. إذا رأيت هذا الخطأ، فحدث Ollama بإعادة تشغيل المثبت من ollama.com/download، أو بالتحديث من التطبيق. تحقق من إصدارك باستخدام ollama --version.
توجد مهارة مرافقة صغيرة تنفذ الإعداد كله وتخبرك بحقيقة عتادك قبل أن تنفق وقتك. يقرأها وكيلك وينفذ العمل. ثبتها، ثم اطلب بكلمات واضحة:
npx skills add panaversity/local-llm-agentic-coding --agent claude-code opencode -y
أعد جهازي لتشغيل وكيل برمجة على نموذج محلي. افحص عتادي بصدق أولا، ثم قدني خلال العملية خطوة بخطوة، وتوقف لطلب موافقتي قبل أي إجراء كبير.
قد يتجاوز المثبت بهدوء اسما لا يتعرف إليه، لذا يمكنك المعاينة أولا باستخدام npx skills add panaversity/local-llm-agentic-coding --list.
لا يفعل الأمر الواحد أعلاه سوى ملء بضعة إعدادات نيابة عنك. إليك ما يملؤه، كي تفهم التوصيلات وتستطيع تنفيذها في أي مكان. تتحدث الأداتان إلى النموذج المحلي نفسه بطريقتين مختلفتين قليلا.
- Claude Code
- OpenCode
يتحدث Claude Code إلى النموذج المحلي كما لو كان يتحدث إلى Anthropic. توجهه إلى العنوان المحلي، وتعطيه رمزا بديلا، وتتأكد من عدم تعيين مفتاح API حقيقي:
export ANTHROPIC_BASE_URL=http://localhost:11434   # the local address, bare host, no /v1
export ANTHROPIC_AUTH_TOKEN=ollama                 # any non-empty word; it is sent as "Bearer ollama"
export ANTHROPIC_API_KEY=                          # must be empty, or it overrides the line above
claude --model qwen3:8b                             # use a model tag you have pulled
إليك ملاحظات صغيرة توفر عليك المتاعب:
- العنوان مجرد، أي يتكون من المضيف والمنفذ فقط. يضيف Claude Code بقية المسار بنفسه. لا تضف
/v1. - يجب أن تسمي نموذج Ollama باستخدام
--model، لأن Claude Code سيبحث من دون ذلك عن أسماء نماذج غير موجودة على جهازك المحلي. - قد يشير
localhostإلى المكان الخطأ على Windows، لذلك يستخدم كثير من الناسhttp://127.0.0.1:11434بدلا منه. وهذه ملاحظة شائعة بين المستخدمين وليست منصوصا عليها في الوثائق الرسمية.
لجعل الإعدادات ثابتة في كل جلسة، ضعها في كتلة env داخل ~/.claude/settings.json بدلا من كتابتها في كل مرة:
{
  "env": {
    "ANTHROPIC_BASE_URL": "http://localhost:11434",
    "ANTHROPIC_AUTH_TOKEN": "ollama",
    "ANTHROPIC_API_KEY": ""
  }
}
يتحدث OpenCode إلى النموذج المحلي كما لو كان يتحدث إلى OpenAI. وهو يدعم النماذج المحلية رسميا، والطريقة المعتمدة للدخول هي وصف خادمك المحلي في ملف يسمى opencode.json. ويستحق تنفيذ ذلك يدويا مرة لأنه يضع العنوان وربط النموذج أمامك. لاحظ /v1 في النهاية، فهو مطلوب هنا، وهو الاختلاف الوحيد عن عنوان Claude Code:
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "ollama": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Ollama (local)",
      "options": { "baseURL": "http://localhost:11434/v1" },
      "models": { "qwen3:8b": { "name": "Qwen3 8B (local)" } }
    }
  },
  "model": "ollama/qwen3:8b"
}
ضع هذا في opencode.json داخل مشروعك، أو في ~/.config/opencode/opencode.json ليشمل كل مشروع. يجب أن يكون اسم النموذج تحت models وسما نزلته فعلا. وعلى Windows استخدم 127.0.0.1 بدلا من localhost.
اقرأ تبويبي الأداتين ولاحظ البنية. النموذج نفسه والجهاز نفسه والمنفذ نفسه. يطلب Claude Code عنوانا مجردا، ويطلب OpenCode العنوان نفسه مع /v1 في نهايته. هذا هو الفرق كله بينهما في النماذج المحلية. تعلم هذا التباين الواحد، وستستطيع وصل أي أداة بأي دماغ محلي. وستستخدمه مرة أخرى بلا تغيير في الجزأين 2 و3.
يكتمل المفهوم 3 عندما: يبدأ وكيل البرمجة، ويكون النموذج الذي يستخدمه هو الموجود على جهازك. اسأله شيئا صغيرا. جاءت الإجابة من حاسوبك المحمول، لا من شركة بعيدة.
هذا هو المفهوم 2 وقد صار واقعا. غيرت العنوان إلى localhost، فأصبح وكيل البرمجة نفسه تماما يرسل عمله إلى الدماغ الموجود على جهازك.
4. ادفعه الآن: أعطه مهمة حقيقية وراقب
إجابة النموذج المحلي عن سؤال خطوة أولى صغيرة، أما تنفيذه عملا برمجيا حقيقيا فهو الاختبار الفعلي. لذلك دعنا نشغله.
اعمل داخل مجلد git صغير مؤقت فيه قدر قليل من الشفرة الحقيقية، حتى لو كان سكربتا واحدا. ثم الصق طلبا مثل الآتي، بينما يشير وكيلك إلى الدماغ المحلي:
ألق نظرة على هذا المجلد. اعثر على تحسين صغير وآمن، ثم نفذ التغيير واعرض لي ما غيرته.
راقب الآن بعناية. سيحدث أحد أمرين، وكلاهما جزء من الدرس.
على جهاز قوي، أي بطاقة رسومية جيدة ونموذج متوسط الحجم، يعمل كل شيء. يقرأ الدماغ المحلي الملفات ويضع خطة ويحررها ويعرض لك تغييرا نظيفا. في تلك اللحظة يصير المجاني وغير المتصل والخاص حقيقة. إنه إعدادك أنت وهو يعمل.
على حاسوب محمول عادي، بلا بطاقة رسومية وبنموذج صغير، ستشعر بالجدار. إما أن تستغرق كل خطوة دقائق لأن الجهاز يقرأ ببطء كمية ضخمة من النص، وإما أن يتوقف التشغيل في منتصف الطريق برسالة خطأ عن استدعاء أداة سيئ. حاول الدماغ أن يقول «حرر هذا الملف» لكنه أخطأ في التنسيق.
لا تصلح شيئا بعد. لاحظ فقط أي النتيجتين حصلت عليها، وكيف بدا الأمر تقريبا. هل كان سريعا ونظيفا؟ أم بطيئا أو معطلا؟ ذلك الشعور هو المادة الخام للمفهوم التالي.
إذا زحفت مهمتك أو تعطلت، فلم يحدث خطأ. لقد قابلت للتو الحد الصريح لتشغيل نموذج كبير على جهاز صغير. وهذه معرفة حقيقية ومفيدة قبل إنفاق المال أو الوقت. يشرح المفهوم التالي بالضبط ما شعرت به.
يكتمل المفهوم 4 عندما: تطلب من دماغ محلي تغييرا حقيقيا في الشفرة وترى النتيجة، سواء كانت تحريرا نظيفا أو انتظارا طويلا أو تشغيلا معطلا.
5. لماذا صمد أو انهار: الجداران
والآن يأتي الشرح، لأنك شعرت بما يشرحه. هذه أهم فكرة في الجزء 1، ولذلك إليك إياها بوضوح.
يجب أن يتجاوز وكيل البرمجة المحلي جدارين منفصلين. ليسا الجدار نفسه، ولا يفيد إصلاح أحدهما الآخر.
الجدار الأول هو القدرة. كلما تصرف النموذج، ويحدث ذلك في كل دور تقريبا أثناء البرمجة، يجب أن يكتب استدعاء أداة صالحا. ويعني ذلك قول «حرر هذا الملف، وغير هذا السطر إلى ذاك» بالتنسيق الدقيق والصارم الذي تتوقعه الحاضنة. كثيرا ما تخطئ النماذج الصغيرة في ذلك. فهي تتجاوز الأداة أو تشوه التنسيق، فيتوقف التشغيل. يصلح هذا عادة نموذج أقوى ومدرب على استخدام الأدوات. ولا يصلحه عتاد أسرع، لأن جهازا سريعا يشغل نموذجا ضئيلا سيظل يكتب استدعاءات أدوات معطلة.
الجدار الثاني هو الإنتاجية. ترسل الحاضنة إلى النموذج في كل دور تعليمة طويلة، أي قواعد الأداة وتعريفات كل ما تستطيع فعله، قبل أن تبدأ مهمتك أصلا. ويجب أن يقرأ الجهاز ذلك كله بسرعة. يستغرق الأمر لحظة مع بطاقة رسومية، وقد يستغرق دقائق في كل دور من دونها، عند الاعتماد على المعالج وحده. تصلح بطاقة رسومية هذا الجدار، ولا يصلحه نموذج أذكى: فالنموذج العبقري على جهاز بطيء يظل بطيئا إلى حد مؤلم.
| الجدار | ما يحتاج إليه | ما يصلحه | ما لا يصلحه |
|---|---|---|---|
| القدرة | استدعاء أداة صحيح كلما تصرف | نموذج أقوى ومدرب على استخدام الأدوات | العتاد الأسرع وحده |
| الإنتاجية | قراءة التعليمة الطويلة خلال ثوان | بطاقة رسومية (GPU) | نموذج أذكى وأصغر |
ملاحظة صريحة عن الحجم قبل الجدول أدناه: لا يوجد حد أدنى عالمي لعدد المعاملات يضمن استخدام الأدوات بموثوقية. فتدريب استخدام الأدوات وقالب المحادثة ومدى ملاءمة الحاضنة مهمة بقدر الحجم الخام، وقد يتفوق نموذج أصغر مدرب جيدا على نموذج أكبر سيئ التدريب. ومع ذلك، يظل النمط التقريبي بين النماذج المحلية الشائعة اليوم أن الأكبر يتعامل مع استخدام الأدوات متعدد الخطوات بموثوقية أكبر، وهو النمط الذي تصفه جداول هذه الصفحة.
تخفق الأجهزة الرخيصة في تجاوز الجدارين معا. ولهذا يكون الحاسوب المحمول العادي مكانا جيدا للدردشة مع نموذج، ومكانا سيئا لتشغيل وكيل برمجة: التوصيلات صحيحة، لكن أيا من الجدارين لم يجر تجاوزه.
كبر الصورة داخل مطبخ المفهوم 2. يحدد وجبتك شيئان: الطاهي والموقد. الطاهي هو نموذجك، والموقد هو جهازك. تسأل القدرة هل الطاهي ماهر بما يكفي لتنفيذ الطلب صحيحا كل مرة. وتسأل الإنتاجية هل الموقد سريع بما يكفي للخدمة خلال ثوان لا دقائق. سيجعلك طاه رائع على موقد بطيء تنتظر، وسيفسد موقد سريع مع طاه مرتبك الطبق. تحتاج إلى الاثنين.
إليك الجملة الصريحة الوحيدة عن العتاد. يظل كل شيء في هذه الصفحة كما هو على جهاز سحابي مستأجر يحمل بطاقة رسومية: التوصيلات والإعدادات والجداران. تتغير السرعة وحدها. تحول بطاقة رسومية بذاكرة تتراوح بين 16 و24 GB إعدادا محليا إلى وكيل برمجة قابل للاستخدام فعلا. وهذه الجملة هي أيضا مدخل الجزء 2، حيث ستستأجر ذلك الجهاز بالضبط وتنفذ شيئا لم يستطع حاسوبك المحمول تنفيذه قط.
دليل تقريبي للنموذج الملائم لكل جهاز:
| النموذج | الحجم | الذاكرة المطلوبة | هل هو جاهز لأعمال البرمجة؟ |
|---|---|---|---|
llama3.2:3b | 3B | نحو 8 GB | لا. جيد للمحادثة لكنه يشوه استدعاءات الأدوات. |
qwen3:8b | 8B | نحو 16 GB | مقبول للمهام البسيطة |
phi4:14b | 14B | نحو 12 GB | قريب من الحد العملي الأدنى في هذه المجموعة |
qwen3:30b-a3b | مزيج 30B | نحو 20 إلى 24 GB | أفضل توازن: إجابات قوية مع سرعة جيدة |
qwen3:32b | 32B | نحو 24 GB | قوي وأبطأ قليلا من المزيج أعلاه |
عملت مهمتك، لكن كل دور استغرق 4 دقائق. استبدلت النموذج على الحاسوب المحمول نفسه بنموذج أذكى كثيرا. هل يصبح أسرع؟ لا. الدور البطيء هو جدار الإنتاجية، ولا يفيد فيه النموذج الأذكى. بل قد يكون النموذج الأذكى أبطأ لأنه أكبر. تصلح بطاقة رسومية الإنتاجية، لا اختيار النموذج. والخلط بين الجدارين هو الخطأ الذي وجد هذا المفهوم لمنعه.اعرض الإجابة
6. انظر إلى الداخل: ما استدعاء الأداة فعلا؟
ذكر المفهوم 5 أن النموذج الضعيف «يشوه استدعاءات أدواته». تبدو هذه العبارة غامضة. دعنا ننظر إلى استدعاء حقيقي، لأن رؤيته توضح الأمر كله.
ليس استدعاء الأداة السليم كتابة عادية، بل قطعة صغيرة من البيانات المنظمة، أي تعليمة دقيقة تستطيع الحاضنة تنفيذها. يبدو هكذا:
{
  "type": "tool_use",
  "name": "edit_file",
  "input": { "path": "README.md", "old": "Hello", "new": "Hello, world" }
}
تقرأ الحاضنة ذلك وتحرر الملف. لم يكتب النموذج التغيير بنفسه، بل أرسل تعليمة دقيقة ونفذت الحاضنة العمل. هذا هو المعنى الحقيقي لعبارة «يستخدم النموذج الأدوات». إنها اللحظة التي يتوقف فيها نموذج المحادثة عن كونه مربع محادثة ويبدأ في التحول إلى شيء يتصرف.
والآن إليك ما يفعله نموذج أضعف مما ينبغي. يرسل input ككتلة نصية بدلا من كائن حقيقي، فترفضه الحاضنة بخطأ تحقق مثل:
invalid tool arguments: expected object, got string
تختلف الصياغة الدقيقة باختلاف الحاضنة. وما يهم هو شكل الإخفاق: وصلت الوسائط ببنية خاطئة، لذلك ترفض الحاضنة التصرف بناء عليها.
يتوقف التشغيل ولا يجري تحرير شيء. غالبا ما تكون تلك الرسالة المشوهة الوحيدة هي ما أنهى تشغيلك في المفهوم 4. هذا هو جدار القدرة عن قرب.
يحدد شيء آخر نجاح ذلك، وهو نافذة السياق. إنها عدد الرموز التي يستطيع النموذج الاحتفاظ بها دفعة واحدة، والرمز قطعة من كلمة وهو الوحدة التي تعدها النماذج فعليا. يضبطها num_ctx في Ollama. ترسل الحاضنة تلك التعليمة الطويلة في كل دور، ويختار Ollama نافذة افتراضية بحسب ذاكرة الرسوم في جهازك. وعلى معظم الحواسيب المحمولة ذات ذاكرة VRAM أقل من 24 GiB، لا تتجاوز القيمة الافتراضية 4,096 رمزا. تقطع نافذة بهذا الصغر معظم التعليمة بهدوء. وهنا يكمن الفخ: لا يظهر أي خطأ. يقتطع Ollama التعليمة ويجيب على أي حال. لذلك تبدو المحادثة سليمة، بينما تفشل مهام البرمجة بطرق محيرة، لأن النموذج لم ير الجزء الذي يشرح تنسيق استدعاء الأداة. النافذة المقتطعة هي السبب الأكثر شيوعا لهذا النمط، وإن لم تكن السبب الوحيد. ولذلك تتحقق منها أولا بدلا من افتراضها.
الحل هو تكبير النافذة. توصي إرشادات Ollama الحالية للوكلاء وأدوات البرمجة بما لا يقل عن 64,000 رمز. وبعد تشغيل وكيلك، يمكنك أن تطلب منه ببساطة:
تبدو نافذة السياق صغيرة جدا، وهذا يعطل استدعاءات الأدوات. اضبطها على 64,000 على الأقل، ثم جرب المهمة مرة أخرى.
للتعمق: لماذا تكسر النافذة الصغيرة الأشياء من دون تحذير؟
رفع نافذة السياق إلى 64,000 رمز أو أكثر هو الإصلاح الأكثر شيوعا لمشكلة «وكيل البرمجة المحلي لدي معطل». يمكنك ضبطها بطرق عدة: شريط تمرير في إعدادات تطبيق Ollama، أو بدء الخادم باستخدام OLLAMA_CONTEXT_LENGTH=64000، أو ملف نموذج مخصص، أي Modelfile يحتوي PARAMETER num_ctx 64000، أو جلسة واحدة داخل محادثة باستخدام /set parameter num_ctx 64000. تحتاج النوافذ الأكبر إلى ذاكرة أكثر، ويعرض ollama ps النافذة التي حصل عليها النموذج المشغل فعلا. إذا كان إعدادك يجيب عن المحادثة لكنه يفشل في المهام الحقيقية، فتحقق من نافذة السياق أولا.
افتح قائمة الإصلاح السريع
- يجيب عن المحادثة لكنه يتجاهل التعليمات في المهام الحقيقية. يرجح أن نافذة السياق صغيرة جدا، ولذلك قطعت التعليمات. ارفع
num_ctxإلى 64,000 أو أكثر، ثم أعد الاختبار قبل البحث عن أسباب أخرى. - يستغرق كل دور دقائق ثم تنتهي مهلته. الجهاز أبطأ من أن يقرأ التعليمة الطويلة في الوقت المحدد. يمكنك رفع المهلة باستخدام
export API_TIMEOUT_MS=1200000. وإذا ظلت تنتهي، فهذا جدار الإنتاجية يخبرك بالحقيقة. - رسالة عن مفتاح مفقود أو موصلات متوقفة. لا ضرر منها. تظهر لأنك عينت رمزا بديلا، والنموذج المحلي لا يستخدم تلك الميزات على أي حال.
لا تحتاج إلى حفظ هذه الأسباب. يستطيع وكيلك إرشادك خلال أي منها.
يكتمل المفهوم 6 عندما: ترى استدعاء أداة حقيقيا واحدا في صورة بيانات منظمة، وتفهم أن استدعاء مشوها أو نافذة سياق أصغر مما ينبغي هو ما يعطل وكيل البرمجة المحلي.
7. متى يستحق امتلاك الدماغ العناء؟
يمكنك تشغيل هذا الآن. والسؤال الصريح هو: متى ينبغي أن تفعل ذلك؟
غالبا ما يكون استئجار نموذج كبير في السحابة، أو استخدام وكيل برمجة بالطريقة المعتادة، أسهل وأذكى. لذلك يفوز المحلي في حالات محددة، ويستحق توضيحها:
- الخصوصية. لا يغادر العمل جهازك أبدا. ويمكن أن يحسم ذلك القرار وحده في الأعمال الحساسة أو الخاضعة للتنظيم.
- العمل بلا اتصال. لا شبكة ولا حساب ولا انقطاع خدمة. يظل النموذج الموجود على قرصك يعمل في الطائرة أو خلف جدار حماية مقيد.
- التكلفة حين يستمر العمل طوال اليوم. الطلب الواحد رخيص في أي خدمة، لكن الحلقة التي تعمل كل بضع دقائق طوال الشهر لها فاتورة مختلفة. حين لا يتوقف العمل، قد يكون امتلاك الدماغ أقل تكلفة من السحابة.
تهم النقطة الأخيرة مرتين في هذا الكتاب. ففي هندسة الحلقات، تبني وكلاء يعملون طوال اليوم بأنفسهم ويتحققون من عملهم أثناء نومك. عندئذ يتوقف سؤال دماغ من يشغل الحلقة، وتكلفة كل تشغيل، عن كونه تفصيلا ويصبح جزءا من التصميم. لقد تعلمت للتو امتلاك ذلك الدماغ.
توجد ملاحظة أخرى، وهي الدرس الهادئ لهذا الجزء كله. إذا استخدمت المهارة المرافقة، فأنت لم تعد شيئا يدويا. لقد ثبت مهارة واستخدمها وكيلك. وليست تلك المهارة سوى مجلد فيه ملف SKILL.md، بالبنية نفسها التي تعلمتها في دورة المهارات المكثفة. وهذا يعني أنك تستطيع حزم معرفتك بالطريقة نفسها ومشاركتها كي يثبتها أي وكيل. وعندما تصبح مستعدا لنشر مهارة، يفحصها gh skill publish --dry-run وفق مواصفة Agent Skills قبل أن ترسلها.
اكتمل الجزء 1. أنت تملك دماغا، وقد وصلت به وكيلي برمجة، وتعرف الجدارين اللذين يحددان قابليته للاستخدام. لكن لاحظ شيئا في كل ما بنيته: كان المطبخ يخدم عميلا واحدا بالضبط، وهو أنت. أرسل إليه 10 طلبات في الوقت نفسه وسيجعلك تنتظر في الصف. ذلك الصف، والبرنامج الذي يزيله، هو موضوع الجزء 2.
الجزء 2: مستوى الخادم، جهاز واحد ومستخدمون كثيرون (vLLM)
طبقة التقديم في هذا الجزء هي vLLM، والمقياس مستخدمون كثيرون على جهاز قوي واحد. لا يتغير النموذج، وهذه هي الفكرة كلها.
قبل أي شيء، سم الكلمة الجديدة التي يبنى عليها هذا الجزء: طبقة التقديم. إنها البرنامج الذي يحمل نموذجا في الذاكرة ويجيب عن الطلبات المرسلة إليه. يعد Ollama طبقة تقديم، وكذلك vLLM. تثبت في هذا الجزء الدماغ، أي Qwen3 8B، ولا تغير إلا طبقة التقديم تحته. ثبت كل شيء آخر بقدر ما تسمح به الممارسة، وغير شيئا واحدا، فيعود الفرق الذي تقيسه في معظمه إلى ذلك الشيء الواحد. وليس هذا علما جيدا فحسب، بل هو الطريقة التي ستنقح بها أنظمة الوكلاء طوال حياتك المهنية: اعزل المتغير ثم قسه. ويأتي معه التحفظ الصريح: هذه تجربة تعليمية لا مختبرا. تصاحبها اختلافات صغيرة في دقة النموذج وشفرة وقت التشغيل والإعدادات، ولهذا تحديدا يكون الادعاء نمطا تتوقعه، لا رقما عشريا تدافع عنه.
جهاز Linux يحمل بطاقة رسومية من NVIDIA. استهدف نحو 24 GB من ذاكرة GPU للبناء القياسي كامل الدقة أدناه، أو استخدم بطاقة 16 GB مع بناء FP8 المضغوط بدلا منه، ويعرض المفهوم 9 المسارين. لا يكاد أحد يملك جهازا كهذا، ولا بأس بذلك. يكلف استئجار جهاز من مزود GPU سحابي لمدة ساعة أو ساعتين بضعة دولارات، وتظل كل الأوامر أدناه مطابقة على الجهاز المستأجر. إذا لم تستطع استئجار واحد الآن، فاقرأ هذا الجزء مع ذلك. يستحق المنحنيان في النهاية أن تفهمهما حتى قبل أن تستطيع رسمهما بنفسك.
8. مطبخ لشخص واحد: أرسل 50 طلبا إلى Ollama وراقب
انتهى الجزء 1 بادعاء: يخدم إعداد Ollama لديك عميلا واحدا. دعنا نثبت ذلك بقياس لا بشعار.
إليك التجربة. ستكتب سكربتا صغيرا واحدا يرسل طلبات كثيرة في الوقت نفسه إلى خادم نموذج، ويبلغك برقمين: المدة التي استغرقتها الدفعة كلها، وإجمالي الرموز في الثانية عبر جميع الطلبات مجتمعة. يسمى عدد الطلبات الواصلة في الوقت نفسه التزامن. مستخدم واحد يعني تزامنا قدره 1، وفصل من 50 طالبا يضغطون Enter معا يعني تزامنا قدره 50.
يجيب Ollama وvLLM عن تنسيق الطلب القياسي نفسه، أي التنسيق المتوافق مع OpenAI الذي قابلته في إعداد OpenCode، ولذلك يختبر سكربت واحد كليهما. لا يتغير سوى العنوان واسم النموذج. احفظ هذا باسم bench.py:
# bench.py: fire N concurrent requests at a model server and measure throughput.
# usage: python bench.py <base_url> <model> <concurrency>
import asyncio, sys, time
import httpx

BASE_URL = sys.argv[1]        # http://localhost:11434/v1 (Ollama) or http://localhost:8000/v1 (vLLM)
MODEL = sys.argv[2]           # qwen3:8b (Ollama) or Qwen/Qwen3-8B (vLLM)
N = int(sys.argv[3])          # how many requests at once

PROMPT = "Explain in about 200 words how a bank reconciliation works."

async def one_request(client):
    r = await client.post("/chat/completions", json={
        "model": MODEL,
        "messages": [{"role": "user", "content": PROMPT}],
        "max_tokens": 300,
        "temperature": 0,
    })
    r.raise_for_status()
    return r.json()["usage"]["completion_tokens"]

async def main():
    async with httpx.AsyncClient(base_url=BASE_URL, timeout=3600) as client:
        await one_request(client)   # warm-up: load the model before timing anything
        start = time.perf_counter()
        results = await asyncio.gather(*[one_request(client) for _ in range(N)],
                                       return_exceptions=True)
        wall = time.perf_counter() - start
    ok = [r for r in results if isinstance(r, int)]
    failed = len(results) - len(ok)
    total = sum(ok)
    print(f"concurrency={N}  ok={len(ok)}  failed={failed}  tokens={total}"
          f"  time={wall:.1f}s  throughput={total/wall:.1f} tok/s")

asyncio.run(main())
ثبت العنصر الوحيد الذي يحتاج إليه السكربت باستخدام pip install httpx، وتأكد من أن Ollama يعمل وأن qwen3:8b منزل. ثم ثبت إعدادا واحدا كي يكون تشغيلك قابلا للتكرار: يختلف عدد خانات Ollama المتوازية بحسب الجهاز، والتجربة العادلة تصرح بإعداداتها. أعد تشغيل خادم Ollama باستخدام OLLAMA_NUM_PARALLEL=4 ollama serve، أو $env:OLLAMA_NUM_PARALLEL=4; ollama serve في PowerShell، كي يأتي منحناك ومنحنى زميلك من القواعد نفسها. ثم شغل المسح. افعل ذلك على جهاز GPU الذي استأجرته، كي تكون مقارنة الجزء 2 عادلة: العتاد نفسه لطبقتي التقديم.
python bench.py http://localhost:11434/v1 qwen3:8b 1
python bench.py http://localhost:11434/v1 qwen3:8b 5
python bench.py http://localhost:11434/v1 qwen3:8b 10
python bench.py http://localhost:11434/v1 qwen3:8b 25
python bench.py http://localhost:11434/v1 qwen3:8b 50
شغل كل مستوى تزامن 3 مرات، وسجل وسيط قيم الإنتاجية الثلاث، كي لا يتحول تعثر عابر إلى نقطة بيانات. تلك القيم الوسيطة الخمس هي ما تحتاج إليه للرسم في المفهوم 10.
اقرأ الآن ما رأيته. كان الأداء جيدا عند تزامن 1. لكن مع صعودك، بالكاد تغير إجمالي الإنتاجية، بينما طال الزمن الفعلي أكثر فأكثر. وعند 50، يرجح أن الدفعة استغرقت دقائق كثيرة. ما حدث في الداخل بسيط: يشغل Ollama عددا قليلا من الطلبات بالتوازي، أي خانات OLLAMA_NUM_PARALLEL الأربع التي ثبتها للتو، ويضع كل من تبقى في صف. لا يبدأ الطلب رقم 40 حتى تفتح خانة. وتقضي البطاقة الرسومية، وهي أغلى جزء في الجهاز، معظم الدفعة منتظرة إلى جانب الصف.
ليس شيء من ذلك عيبا في Ollama. إنه خيار تصميم صريح: بني Ollama لجعل حاسوب شخص واحد مريحا، ولم يبن قط ليكون مطعما.
هذا مطبخ منزلي فيه طاه واحد وموقد ذو شعلتين. ضيف عشاء واحد، رائع. أما مع 50 ضيفا، فيقف 45 منهم في الممر يحملون قسائم الطلب. الطاهي ليس كسولا والموقد ليس معطلا، بل المطبخ لم يصمم للحشود.
يكتمل المفهوم 8 عندما: تحصل على 5 قيم إنتاجية مقاسة في Ollama عند مستويات تزامن 1 و5 و10 و25 و50، وترى الصف يحدث بعينيك.
9. المطبخ الصناعي: قدم الدماغ نفسه باستخدام vLLM
والآن طبقة التقديم الأخرى. vLLM برنامج مجاني مفتوح المصدر له مهمة واحدة: تقديم نموذج إلى مستخدمين كثيرين في الوقت نفسه من دون إهدار البطاقة الرسومية. خرج من أبحاث UC Berkeley، وصار الآن الطريقة القياسية التي تقدم بها الشركات النماذج المفتوحة في الإنتاج. يحسن Ollama راحة شخص واحد، بينما يحسن vLLM إجمالي الإنتاجية.
يستمد تلك الإنتاجية من فكرتين، وتستحق كل منهما أن تفهمها بلغة بسيطة:
- التجميع المستمر. تكون البطاقة الرسومية في أفضل حالاتها حين تنفذ أشياء كثيرة معا. لذلك يمرر vLLM طلبات كثيرة عبرها معا، وهنا تأتي الفكرة الذكية: حين ينتهي طلب، يدخل طلب منتظر في خانته في أثناء التشغيل من دون إيقاف البقية. لا تتعطل البطاقة ما دام هناك عمل في الصف. قارن ذلك بصف تخدم فيه البطاقة بضعة طلبات وتنتهي منها ثم تلتقط الدفعة التالية.
- الذاكرة المقسمة إلى صفحات (PagedAttention). تحتاج كل محادثة نشطة إلى ذاكرة عمل على البطاقة. كانت الخوادم الأقدم تحجز كتلة كبيرة واحدة لكل محادثة، وتبقى معظمها فارغة، فتبدو البطاقة «ممتلئة» قبل امتلائها الحقيقي بزمن. يقسم vLLM تلك الذاكرة إلى صفحات صغيرة ولا يمنحها إلا عند الحاجة، مثلما يدير نظام التشغيل ذاكرة RAM. والنتيجة أن محادثات أكثر بكثير تلائم البطاقة نفسها في الوقت نفسه.
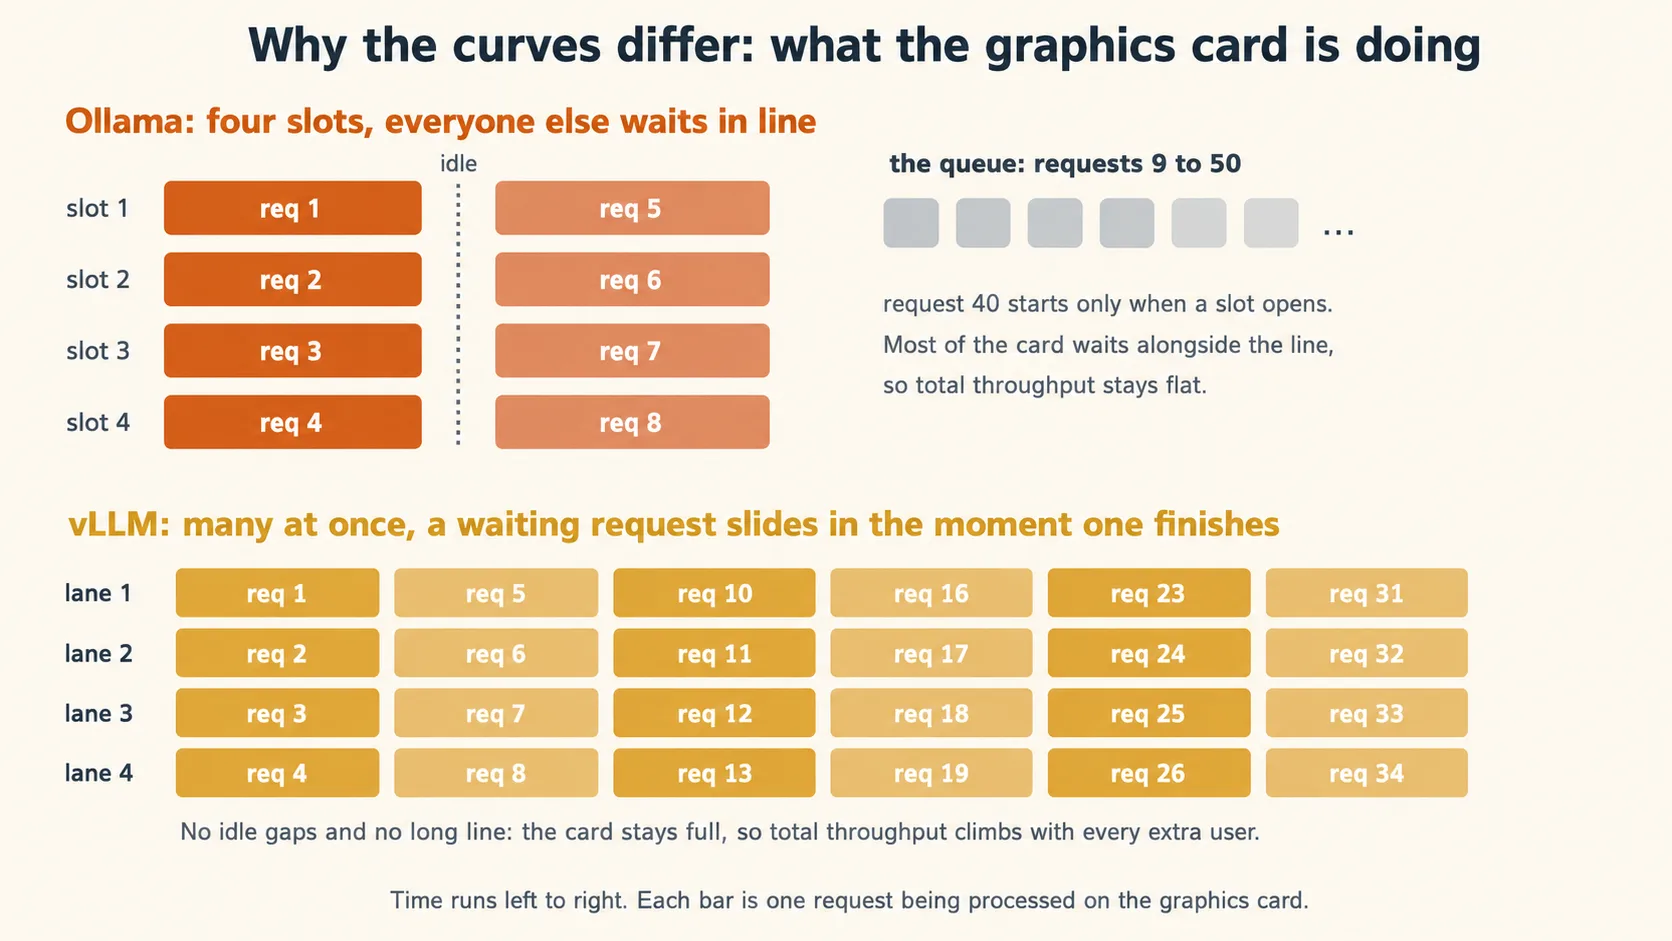
لا تحتاج إلى تذكر أسماء الآليات. تذكر الأثر: تظل البطاقة ممتلئة، فيرتفع إجمالي الإنتاجية كلما وصل مستخدمون أكثر بدلا من تشكل صف.
توجد نقطة أخرى كي لا تضللك أسماء المستويات. يشغل هذا الجزء vLLM على جهاز واحد، لكن vLLM نفسه لا يتوقف عند ذلك. يستطيع توزيع نموذج واحد على بطاقات رسومية كثيرة وعلى أجهزة كثيرة تعمل كعنقود واحد. ليس ذلك منتجا مختلفا، بل البرنامج نفسه على مقياس أكبر، وهو ما يشغله كثير من المضيفين المحترفين الذين ستستأجر منهم في الجزء 3 على عناقيدهم. لذلك تسمى مستويات الدورة بحسب من يشغل العتاد، لا بحسب ما يستطيع البرنامج فعله. أنت مشغل vLLM في الجزء 2 على خادم واحد. وفي الجزء 3 يكون المشغل شخصا آخر على 64 موقدا، ومن المحتمل جدا أن يشغل مطبخه vLLM أيضا.
شغله الآن. ثبت vLLM على جهاز GPU وقدم نظير النموذج الذي اختبرته للتو. ملاحظة عن الأسماء: ينزل Ollama وvLLM النماذج من مكتبتين مختلفتين، لذلك يكون للدماغ نفسه اسمان. يسمى qwen3:8b في مكتبة Ollama باسم Qwen/Qwen3-8B على Hugging Face، حيث يحصل vLLM على نماذجه. وملاحظة صريحة أخرى، لأن هذا الجزء وعد بعزل المتغير. النسختان غير متطابقتين بايتا ببايت: يشحن وسم Ollama نسخة مضغوطة، أو مكممة، من الأوزان كي تلائم الحواسيب المحمولة، بينما ينزل vLLM الأصل كامل الدقة. لذلك، حين تقول الدورة «الدماغ نفسه»، فاقرأها بدقة: نموذج Qwen3 8B نفسه في بنائين مخصصين لطبقتي التقديم، وتكون نسخة Ollama أخف. ذلك الاختلاف في الدقة متغير آخر يصاحب أرقامك، لكنه لا يغير نمط الإنتاجية الذي وجدت التجربة لعرضه. وإذا أردت أقرب تطابق، فقدم البناء المضغوط على جانب vLLM أيضا باستخدام vllm serve Qwen/Qwen3-8B-FP8 مع الخيارات نفسها.
pip install vllm

vllm serve Qwen/Qwen3-8B \
  --enable-auto-tool-choice \
  --tool-call-parser hermes \
  --reasoning-parser qwen3
ملاحظة عن العتاد قبل التشغيل. يحتاج بناء 8B كامل الدقة إلى نحو 16 GB من ذاكرة GPU للأوزان وحدها، قبل ذاكرة عمل محادثاتك، ولذلك يحتاج إلى بطاقة 24 GB ليعمل براحة. وعلى بطاقة 16 GB، قدم البناء المضغوط بدلا منه: استخدم Qwen/Qwen3-8B-FP8 اسما للنموذج واحتفظ بالخيارات نفسها. وإذا قاوم pip install vllm جهازك بسبب إصدارات برنامج التشغيل وCUDA، فإن صورة Docker الرسمية من vLLM هي مسار التثبيت الأكثر قابلية للتكرار، وتغطيه وثائق vLLM.
ينزل التشغيل الأول النموذج، ثم يبدأ الخادم عند http://localhost:8000. لهذين الخيارين المتعلقين بالأدوات أهمية أكبر مما يبدو: يتيح --enable-auto-tool-choice مع محلل استدعاءات الأدوات أن يحول vLLM مخرجات النموذج إلى استدعاءات الأدوات النظيفة والمنظمة التي قابلتها في المفهوم 6. احذفهما فيفشل وكلاء البرمجة بهدوء، لأن الخادم لا ينتج استدعاء أداة تستطيع الحاضنة تنفيذه. ويختلف اسم المحلل الصحيح بحسب عائلة النموذج. يعد hermes الخيار القياسي لنماذج Qwen3. تحقق من وثائق استدعاء الأدوات في vLLM حين تقدم أي نموذج آخر.
أثبت أنه يعمل بطلب واحد:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "Qwen/Qwen3-8B", "messages": [{"role": "user", "content": "Say hello in one line."}]}'
انظر إلى ما كتبته للتو. localhost، والمنفذ 8000، ثم /v1/chat/completions. هذا هو شكل العنوان نفسه الذي استخدمته طوال الدورة. لم يتغير الدماغ، بل تغير المطبخ خلف العنوان.
يكتمل المفهوم 9 عندما: يقدم vLLM نموذج Qwen3 8B على جهازك ويجيب عن طلب curl، وتستطيع أن تقول في جملة واحدة ما يمنحك إياه كل من التجميع المستمر والذاكرة المقسمة إلى صفحات.
10. لحظة الكشف: الطلبات الخمسون نفسها ومنحنيان
كل شيء جاهز. الجهاز نفسه والدماغ نفسه والسكربت نفسه والطلبات الخمسون نفسها. لا تختلف سوى طبقة التقديم. شغل المسح المطابق على vLLM:
python bench.py http://localhost:8000/v1 Qwen/Qwen3-8B 1
python bench.py http://localhost:8000/v1 Qwen/Qwen3-8B 5
python bench.py http://localhost:8000/v1 Qwen/Qwen3-8B 10
python bench.py http://localhost:8000/v1 Qwen/Qwen3-8B 25
python bench.py http://localhost:8000/v1 Qwen/Qwen3-8B 50
راقب الدفعة عند تزامن 50 خصوصا. ينبغي أن ينهار الزمن الفعلي الذي امتد دقائق كثيرة في Ollama: تكتمل دفعة الطلبات الخمسين عادة في وقت أقصر كثيرا من إعداد Ollama المثبت، وتصل الإجابات متقاربة بدلا من وصولها على نوبات.
ارسم الصورة الآن، لأن هذه الصورة هي الشيء الوحيد الذي ينبغي أن تحمله معك من الجزء 2. ضع قيمك العشر المقاسة في هذا السكربت، وثبت matplotlib باستخدام pip install matplotlib إذا لزم، ثم شغله:
# plot.py: tokens per second against concurrency, one line per serving layer.
import matplotlib.pyplot as plt

concurrency = [1, 5, 10, 25, 50]
ollama_tps = [0, 0, 0, 0, 0]   # your five Ollama numbers from Concept 8
vllm_tps = [0, 0, 0, 0, 0]     # your five vLLM numbers from this concept

plt.plot(concurrency, ollama_tps, marker="o", label="Ollama (qwen3:8b)")
plt.plot(concurrency, vllm_tps, marker="o", label="vLLM (Qwen/Qwen3-8B)")
plt.xlabel("Concurrent requests")
plt.ylabel("Total throughput (tokens/sec)")
plt.title("Same model, same machine, two serving layers")
plt.legend()
plt.savefig("two-curves.png", dpi=200)
تحصل على منحنيين. توقع أن يظل خط Ollama مسطحا تقريبا: لا تؤدي إضافة مستخدمين إلى زيادة الإنتاجية، بل تطيل الصف غالبا، فيصغر نصيب كل مستخدم. وتوقع أن يصعد خط vLLM: يضيف كل مستخدم جديد إنتاجية، بسرعة في البداية ثم بانحناء مع اقتراب البطاقة الرسومية من الامتلاء الحقيقي. تعتمد أرقامك الدقيقة على بطاقتك وإصداراتك وإعداداتك، ولن تطابق أرقام أي شخص آخر. لكن الأشكال ستتطابق غالبا، والأشكال هي الدرس. تحول عادة واحدة تشغيلك إلى دليل بدلا من حكاية: اكتب نوع بطاقتك وبرنامج التشغيل وإصداري Ollama وvLLM بجوار أرقامك، كي تصبح النتيجة المختلفة على عتاد مختلف اكتشافا لا لغزا.
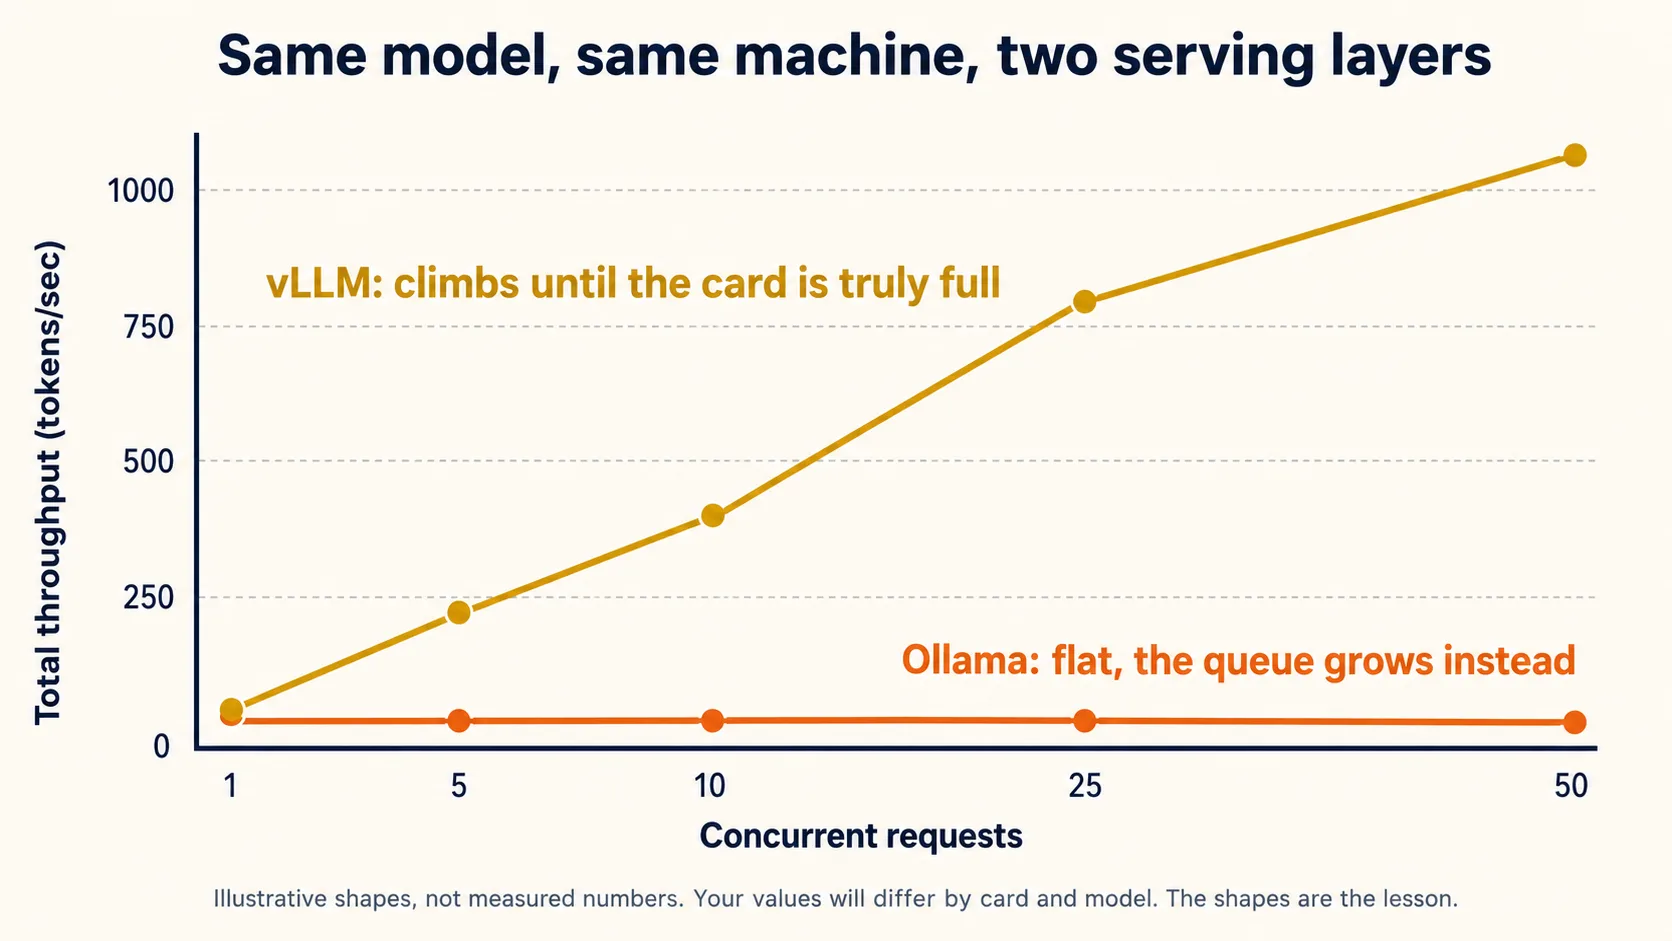
تعرض الصورة أعلاه الأشكال المتوقعة، لا قياسات حقيقية. الرسم الذي يهم هو رسمك من قيمك العشر.
والآن سم بدقة ما تمثله الفجوة بين المنحنيين. ليست العتاد، فالبطاقة نفسها. وليست السكربت، فالطلبات نفسها. وليست الدماغ بأي معنى مهم، فعائلة النموذج نفسها، مع اختلاف الدقة الذي أشار إليه المفهوم 9 بوصفه متغيرا آخر يصاحب الأرقام. تعود الفجوة في معظمها إلى طبقة التقديم. ثبت كل شيء آخر بقدر ما تسمح به الممارسة، وغيرت شيئا واحدا، وكان الأثر المقاس هائلا. هذا هو الادعاء الصريح، وهو أقوى مما يكفي.
يرى صديق رسمك ويقول: «إذن يجعل vLLM النموذج أسرع. ينبغي أن تستخدمه على حاسوبك المحمول أيضا». ما الصحيح وما الخطأ في هذه الجملة؟ النصفان خطأ بطريقة مفيدة. لا يجعل vLLM النموذج أسرع لمستخدم واحد: يبدأ المنحنيان عادة متقاربين عند تزامن 1، لأن الطلب الواحد لا يستطيع استخدام الحيل التي تبقي البطاقة ممتلئة. يجعل vLLM الجهاز أسرع تحت الحمل بخدمة طلبات كثيرة معا. ولن يفيد حاسوبا محمولا عاديا، لأن التجميع المستمر يحتاج إلى بطاقة رسومية يجمع عليها الطلبات. يتألق vLLM تحديدا حيث لم يصمم Ollama للذهاب: جهاز قوي واحد ومستخدمون كثيرون.اعرض الإجابة
يكتمل المفهوم 10 عندما: يوجد رسمك، بمنحنى مسطح وآخر صاعد، وتستطيع أن تشرح في جملة واحدة لماذا تعود الفجوة في معظمها إلى طبقة التقديم.
11. صل وكيلي البرمجة بخادمك
لا تكون للخادم السريع أهمية إلا إذا استطاعت أدواتك استخدامه. لذلك كرر حركة الجزء 1، عند العنوان الثالث في الدورة: وجه Claude Code وOpenCode إلى vLLM.
إليك الجزء الذي يفترض أن يبدو مريبا من شدة ألفته الآن: إنها التوصيلات نفسها. يتحدث vLLM بتنسيقي الطلب اللذين يستخدمهما الوكيلان. لديه العنوان بأسلوب OpenAI الذي يريده OpenCode، وينفذ أيضا تنسيق Anthropic Messages الذي يتحدث به Claude Code أصلا، فلا يوجد مترجم بينهما.
- Claude Code
- OpenCode
الإعدادات الثلاثة نفسها من الجزء 1 مع منفذ جديد، وإضافة واحدة: تخبر Claude Code أن كل مستوى نموذج يرتبط بنموذجك المقدم.
export ANTHROPIC_BASE_URL=http://localhost:8000      # bare address again, no /v1
export ANTHROPIC_AUTH_TOKEN=dummy
export ANTHROPIC_API_KEY=dummy
export ANTHROPIC_DEFAULT_OPUS_MODEL=Qwen/Qwen3-8B
export ANTHROPIC_DEFAULT_SONNET_MODEL=Qwen/Qwen3-8B
export ANTHROPIC_DEFAULT_HAIKU_MODEL=Qwen/Qwen3-8B
claude
توجد أسطر مستويات النموذج لأن Claude Code ينتقل عادة بين نماذج Anthropic الكبيرة والصغيرة بالاسم. ويعني ربط المستويات الثلاثة بنموذجك المقدم أنه سيحصل على Qwen3 8B مهما طلب. تأتي هذه المتغيرات من دليل Claude Code في وثائق vLLM، وهو المصدر المباشر الذي ينبغي التحقق منه حين تتغير التفاصيل.
انسخ opencode.json من الجزء 1 وغير سلسلتين: المنفذ واسم النموذج.
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "vllm": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "vLLM (server)",
      "options": { "baseURL": "http://localhost:8000/v1" },
      "models": { "Qwen/Qwen3-8B": { "name": "Qwen3 8B (vLLM)" } }
    }
  },
  "model": "vllm/Qwen/Qwen3-8B"
}
لاحظ بقاء /v1: ما زال OpenCode يتحدث بأسلوب OpenAI ويجيبه vLLM. انتقل التباين بين العنوان المجرد والعنوان ذي /v1 من الجزء 1 من دون تغيير واحد.
ثم شغل مهمة المفهوم 4 نفسها تماما داخل مجلدك المؤقت:
ألق نظرة على هذا المجلد. اعثر على تحسين صغير وآمن، ثم نفذ التغيير واعرض لي ما غيرته.
إذا زحف حاسوبك المحمول أو تعطل في الجزء 1، فهذا التشغيل هو مكافأتك. النموذج نفسه والمهمة نفسها، لكن خلف طبقة تقديم بنيت للعمل توجد بطاقة رسومية حقيقية: اختفى جدار الإنتاجية من المفهوم 5، وتتدفق استدعاءات الأدوات لأنك بدأت vLLM بخيارات محلل الأدوات.
ملاحظة صريحة عن المشاركة. بمجرد أن يخدم جهاز vLLM لديك شخصا غيرك، يتحول localhost إلى العنوان الحقيقي للجهاز، ويكون خادم النموذج المفتوح على الإنترنت بابا مفتوحا. ابدأ vLLM على الأقل باستخدام --api-key مع سر حقيقي، وأعط ذلك المفتاح لمستخدميك، وأبق الجهاز خلف وسائل الحماية المعتادة في شبكتك. تغطي وثائق vLLM التقديم الآمن. اقرأها قبل أن يستخدمه فصل دراسي.
يكتمل المفهوم 11 عندما: ينجز وكيل برمجة واحد على الأقل مهمة حقيقية عبر خادم vLLM، وتستطيع تسمية الشيء الذي تغير منذ الجزء 1، وهو العنوان، والشيء الذي لم يتغير، وهو كل ما عداه.
12. متى يستحق مستوى الخادم العناء؟
لديك الآن المنحنيان المقاسان، ولذلك يمكن أن يكون هذا القرار صريحا لا تابعا للموضة.
يفوز مستوى الخادم حين يستطيع جهاز قوي واحد إطعام أفواه كثيرة:
- فريق أو فصل دراسي. يصطدم 50 طالبا على 50 حاسوبا محمولا بجدارَي الجزء 1. ويتشارك 50 طالبا موجهين إلى جهاز vLLM واحد جدارا واحدا جرى تجاوزه. بهذه الطريقة يمنح مختبر أو شركة أو فصل PIAIC الجميع وكيلا قادرا مقابل سعر GPU واحد.
- حلقات تعمل طوال اليوم. ترسل وكلاء هندسة الحلقات التي ستبنيها لاحقا طلبات كل بضع دقائق إلى الأبد. ولا تتوقف الفاتورة القائمة على كل رمز عن الارتفاع. أما على GPU تملكه، فحين يكون مشغولا بالفعل لا يكلفك طلب إضافي شيئا تقريبا، ومنحناك الصاعد هو الصورة الدقيقة للسبب: ترتفع الإنتاجية مع الحمل، فيكون الجهاز المشغول رخيصا لكل رمز.
- الخصوصية على مقياس الفريق. حجة الخصوصية من الجزء 1، لكن لمؤسسة كاملة: تبقى البيانات على جهاز تتحكم فيه، مع استمرار خدمة الجميع.
وهنا يأتي الحد الصريح الذي يصلنا بالجزء 3. حرك vLLM جدارا واحدا هو الإنتاجية، ولم يفعل شيئا بالجدار الآخر. يجيب Qwen3 8B خلف vLLM عن 50 شخصا بسرعة، ويظل ذكاؤه في جوهره كما كان على حاسوبك المحمول، لأن الدماغ تحته هو نفسه. إذا كانت المهمة أصعب من قدرة نموذج 8B، فلن تنقذه أي طبقة تقديم. يتجاوز جدار القدرة دماغ أكبر، ولا تلائم أكبر الأدمغة المفتوحة في العالم جهازك المستأجر ولا أي جهاز ستملكه يوما. ولأجلها، تغير العنوان مرة أخرى.
تنتج حلقة وكيلك التي تعمل طوال اليوم إجابات خاطئة باستمرار في مهام إعادة الهيكلة الصعبة. يقترح زميل الانتقال من Ollama إلى vLLM لإصلاحها. هل سينجح ذلك؟ لا. الإجابات الخاطئة في المهام الصعبة هي جدار القدرة، ولا تمسه طبقة التقديم: يقدم vLLM الدماغ نفسه بسرعة أكبر، ولا يجعله أذكى. يصلح الانتقال إلى vLLM الصفوف والبطء، أي الإنتاجية. أما إصلاح الإجابات الخاطئة فيحتاج إلى نموذج أقوى، وهذا ما وجد له المستوى السحابي في الجزء 3. إنه جدول المفهوم 5، لكن على مستوى أعلى.اعرض الإجابة
يكتمل المفهوم 12 عندما: تستطيع تسمية موقف يتفوق فيه مستوى الخادم على الحاسوب المحمول والسحابة معا، وتستطيع قول أي الجدارين يحركه vLLM وأيهما يعجز عنه.
الجزء 3: المستوى السحابي، نماذج مفتوحة رائدة لا يكاد أحد يستطيع استضافتها ذاتيا (OpenRouter)
طبقة التقديم في هذا الجزء هي عنقود يملكه شخص آخر وتصل إليه عبر OpenRouter. المقياس هو نماذج ضخمة إلى حد يتوقف معه تعبير «الاستضافة الذاتية» عن كونه خيارا حقيقيا لك ولأغلب شركات العالم.
13. أوزان مفتوحة لا تستطيع رفعها: Kimi K3 وDeepSeek V4 Pro
انتهى الجزء 2 بحد صريح: يتجاوز جدار القدرة دماغ أكبر. لذلك دعنا ننظر إلى أكبر الأدمغة المفتوحة الموجودة الآن، ونكن صرحاء بشأن معنى «مفتوح» عند هذا الحجم.
تستخدم الدورة نموذجين منها، وقت كتابة هذه الصفحة في يوليو 2026، وقد اختير كل منهما لسبب مختلف:
- Kimi K3 من Moonshot AI، واختير من أجل الأداء. صدر في يوليو 2026، وهو نموذج يضم 2.8 تريليون معامل ونافذة سياق من مليون رمز. وعند إصداره، صنف أقوى نموذج مفتوح الأوزان حتى ذلك الوقت على مؤشرات القدرة الكبرى، وقريبا من أفضل النماذج المغلقة. تتغير التصنيفات شهريا، لذلك عامل ذلك كلقطة مؤرخة وتحقق من لوحات الصدارة الحالية قبل تكراره. الأوزان مفتوحة حقا، ويمكنك تنزيلها كلها.
- DeepSeek V4 Pro من DeepSeek، واختير من أجل الأداء مقابل السعر. إنه نموذج يضم 1.6 تريليون معامل، ينشط منها نحو 49 مليار معامل لكل رمز، وله نافذة السياق نفسها ذات المليون رمز، وقد صدر برخصة MIT. تقل قدرته الخام خطوة عن K3، لكنه أرخص كثيرا في الاستخدام، وهذه المقايضة هي سبب وجوده هنا.
وإليك تفصيلا يصل المستويات معا: عندما أصدرت Moonshot نموذج K3، أسهمت بشفرة تقديم تصميم الانتباه الجديد مباشرة في vLLM، كي يستطيع المضيفون في كل مكان تشغيله. المطبخ الصناعي الذي تعلمته في الجزء 2 ومطابخ هذا الجزء الرائدة هما، في حالات كثيرة، البرنامج نفسه على مقياسين مختلفين جدا.
والآن الحساب الصريح. تعني «الأوزان المفتوحة» أنه مسموح لك بتشغيل هذه النماذج بنفسك، لا أنك قادر على ذلك. توصي Moonshot بتقديم K3 على إعدادات تضم 64 شريحة تسريع أو أكثر تعمل كجهاز واحد. ويعد DeepSeek V4 Pro النموذج الصغير بينهما، ومع ذلك تحتاج استضافته ذاتيا إلى عنقود من 8 إلى 16 وحدة GPU لمراكز البيانات، أي عتاد تكلفته أكبر من منزل. تمتد مهارات الجزء 2 إلى نماذج مثل Qwen3 32B أو مزيج من فئة 100B على جهاز مستأجر متعدد وحدات GPU، لكنها لا تمتد إلى هذا. ولا تكاد مهارات أحد خارج فرق البنية التحتية الجادة تمتد إليه. يستأجر الجميع النماذج المفتوحة الرائدة.
فما الذي يمنحك إياه «الانفتاح» إذا كنت ستستأجر على أي حال؟ ثلاثة أشياء حقيقية. لا ارتهان: لا تستطيع شركة واحدة سحب النموذج أو إعادة تسعيره وحدها أو تغييره سرا، لأن أي جهة تملك عنقودا تستطيع تقديم الأوزان نفسها، ويفعل المنافسون ذلك. اختيار المؤجر: تستضيف شركات كثيرة الأوزان نفسها وتتنافس في السعر والسرعة. حد أدنى لمستقبلك: إذا صار الأمر مهما حقا، تستطيع أنت أو بلدك أو شركتك إقامة العتاد. لا تعني الأوزان المفتوحة بهذا الحجم «شغله في المنزل» بقدر ما تعني «لا أحد يملك الصنبور».
يخلق تنافس المضيفين مشكلة عملية: عشرات شركات الاستضافة، ولكل منها حساباتها ومفاتيحها وفواتيرها. يحل OpenRouter المشكلة بالطريقة التي علمتك الدورة كلها توقعها: عنوان واحد. كن دقيقا في تعريفه، لأن جدول المستويات يبسط الصورة: OpenRouter بوابة، أي موجه يتلقى طلبك ويمرره إلى أحد المضيفين الذين يقدمون النموذج فعلا. يشغل المضيف طبقة التقديم، وغالبا ما تكون vLLM نفسها. ويدير OpenRouter الباب الأمامي: حسابا واحدا ومفتاح API واحدا وصفحة فوترة واحدة عبر مئات النماذج. سجل في openrouter.ai، وأضف بضعة دولارات من الرصيد، وأنشئ مفتاحا، واضبط حدا للإنفاق الشهري قبل أي شيء آخر. ذلك المفتاح سر ومحفظة في سلسلة واحدة: لا تلصقه أبدا في شفرة ستودعها أو تشاركها.
كان الجزء 1 طهيا في المنزل، والجزء 2 إدارة مطبخك الصناعي، والجزء 3 هو مطاعم العالم العظيمة: مطابخ فيها 64 موقدا وكتيبة طهاة. لن تبني واحدا في منزلك، ولا تحتاج إلى ذلك. OpenRouter هو تطبيق التوصيل الذي يضع كل تلك المطاعم في قائمة واحدة، بتسجيل دخول واحد وفاتورة واحدة. ويظل التطبيق نفسه على هاتفك طوال الوقت.
يكتمل المفهوم 13 عندما: يكون لديك حساب OpenRouter ومفتاح وحد إنفاق مضبوط، وتستطيع أن تشرح في جملة واحدة لماذا لم تعد عبارتا «أوزان مفتوحة» و«تستطيع استضافته ذاتيا» ادعاء واحدا عند هذا الحجم.
14. قد الأدمغة الرائدة من الوكيلين نفسيهما
المستوى الثالث والحركة نفسها. ستوجه الحاضنتين نفسيهما من الجزأين 1 و2 إلى أقوى النماذج المفتوحة على الأرض، وستبدو التوصيلات مألوفة إلى حد محرج.
- Claude Code
- OpenCode
يتحدث OpenRouter تنسيق Claude Code الأصلي مباشرة، ويسمي ذلك نقطة النهاية المتوافقة مع Anthropic. لذلك يتكون الإعداد من المتغيرات الثلاثة نفسها في الجزء 1، مع مفتاح حقيقي في الوسط:
export ANTHROPIC_BASE_URL=https://openrouter.ai/api   # bare, one more time: no /v1
export ANTHROPIC_AUTH_TOKEN=sk-or-...                 # your OpenRouter key
export ANTHROPIC_API_KEY=                             # must be empty
claude --model moonshotai/kimi-k3
ملاحظة نظافة قبل تثبيت ذلك في أي مكان. هذا المفتاح محفظة. تستمر صادرات الصدفة جلسة واحدة، وهذا هو المكان الآمن للبدء. وإذا نقلت المتغيرات إلى ملف إعدادات، فاستخدم ~/.claude/settings.json في مجلدك المنزلي، ولا تستخدم أبدا ملف إعدادات مودعا داخل مشروع، لأن المفتاح المرفوع إلى مستودع git مفتاح سينفقه غرباء.
تتبع أسماء نماذج OpenRouter بنية maker/model، والسلسلة الدقيقة مهمة: يخص moonshotai/kimi-k3 نموذج Kimi K3، ويخص deepseek/deepseek-v4-pro نموذج DeepSeek V4 Pro. يعيد الحرف الخاطئ رسالة «model not found» مجردة، لذا انسخ الأسماء من صفحة النموذج على openrouter.ai بدلا من كتابتها.
بنيت حاضنة Claude Code واختبرت على نماذج Anthropic نفسها، ولا يضمن OpenRouter توافق Claude Code الكامل إلا مع مزود Anthropic المباشر. يتحدث Kimi K3 وDeepSeek V4 Pro التنسيق المتوافق، ويقودهما كثيرون بهذه الطريقة بنجاح، لكن استدعاء أداة قد يصل مع ذلك بصورة غريبة لأسباب تتعلق بملاءمة الحاضنة للنموذج لا بإعدادك. عامل هذا الاقتران كتجربة. إذا أردت المسار المدعوم بالكامل لهذا التمرين، فاستخدم تبويب OpenCode، إذ يعد OpenRouter مزودا أصليا في OpenCode بلا تحفظات توافق. وإذا أردت إبقاء Claude Code وتنعيم هذه الحواف، فقد بنى المجتمع أداة لهذه المهمة تحديدا: Claude Code Router، ويغطيها المفهوم 16.
عادتان توفران على الناس مساء كاملا:
- تحقق من وجهة كلماتك باستخدام
/status. ينبغي أن يعرض عنوان OpenRouter في سطرAnthropic base URL، ورمزك بوصفه بيانات الاعتماد النشطة. ثق بالتحقق لا بالافتراض. - وفقا لوثائق Claude Code الحالية، تسبق قيمة
ANTHROPIC_AUTH_TOKENتسجيل دخول Anthropic المحفوظ، فلا يفترض أن يحرف تسجيل قديم طلباتك. لكن تسجيل الدخول القديم قد يطلق مع ذلك تحذير تعارض مصادقة عند البدء، وتذكر أدلة أقدم أنه يتدخل أحيانا. إذا عرض/statusنقطة النهاية الخاطئة، أو سمى تحذير التعارض مصدري بيانات اعتماد، فشغل/logoutمرة، وأعد التشغيل، ثم تحقق مجددا.
يتعرف OpenCode إلى OpenRouter مباشرة، ولذلك لا توجد هذه المرة كتلة مزود تكتبها. شغل الأمر /connect داخل OpenCode، واختر OpenRouter، والصق مفتاحك. تستخدم الإصدارات الأقدم opencode auth login من الصدفة. تحمل نماذج OpenRouter كثيرة مسبقا، ولذلك تستطيع اختيار أحدها باستخدام /models، أو تثبيته في opencode.json:
{
  "$schema": "https://opencode.ai/config.json",
  "model": "openrouter/deepseek/deepseek-v4-pro"
}
استخدم openrouter/moonshotai/kimi-k3 بدلا منه لقيادة النموذج الآخر. هذا هو الإعداد كله.
شغل الآن مهمة المفهوم 4 نفسها للمرة الأخيرة داخل المجلد المؤقت نفسه، مرة بكل نموذج:
ألق نظرة على هذا المجلد. اعثر على تحسين صغير وآمن، ثم نفذ التغيير واعرض لي ما غيرته.
اشعر بالفرق عن كل تشغيل سابق. لا تتوقع صفا ولا زحفا، بل استدعاءات أدوات نظيفة: تتجاوز النماذج الرائدة جدار القدرة بسهولة، وصارت مواقد الإنتاجية الأربعة والستون ملكا لشخص آخر. تجاوزت الجدارين معا بتغيير عنوان. وإذا تعثر تشغيل، فقد انتقل السبب أيضا: افحص ملاءمة النموذج لحاضنتك أو المزود أو التوجيه أو التعليمة، لا عتادك المحلي.
ولاحظ ما تخليت عنه، لأن المقايضة هي الدرس. للمرة الأولى منذ المفهوم 1 غادرت كلماتك جهازك، وللمرة الأولى في الدورة تكلف الرموز مالا أثناء تدفقها. راقب صفحة نشاط OpenRouter بعد المهمة، وشاهد الطلب يظهر وسعره معه. كان الخاص والمجاني في الجزء 1. وهذا قوي ومحسوب.
ينجز وكيلك الآن المهام بسرعة عبر OpenRouter. مقارنة بالمفهوم 1، سم الشيئين اللذين تخليت عنهما، والعادة الوحيدة التي تخبرك بالحقيقة عن وجهة كلماتك. تخليت عن الخصوصية، لأن كلماتك تغادر جهازك وتمر عبر مزود، وعن المجانية، لأن كل رمز يحسب من رصيدك. والعادة هي التحقق لا الافتراض: يعرض اعرض الإجابة
/status في Claude Code، أو أداة اختيار النموذج في OpenCode، العنوان الذي تذهب إليه طلباتك بدقة. تظل قاعدة الدورة من الجزء 1 صحيحة عند كل مستوى: ثق بالإعداد الذي تراه، لا بالإعداد الذي تتذكر تنفيذه.
يكتمل المفهوم 14 عندما: ينجز كل من K3 وV4 Pro مهمة برمجة حقيقية عبر وكيلك، ويؤكد /status أو أداة اختيار النموذج في OpenCode وجهة الطلبات، وترى طلبا حقيقيا بسعر حقيقي في صفحة نشاطك.
15. الأداء أم السعر: اختيار نموذج واختيار مستوى
لقد قدت النموذجين الرائدين للتو. لم تكلفتهما واحدة، والاختيار بينهما هو أول اختبار حقيقي لقرار ستتخذه باستمرار من الآن فصاعدا.
وقت كتابة هذه الصفحة، تقارب أسعار القائمة ما يأتي: Kimi K3 بسعر $3 لكل مليون رمز إدخال و$15 لكل مليون رمز إخراج، وDeepSeek V4 Pro بنحو $0.44 للإدخال و$0.87 للإخراج. اقرأ هذه الفجوة ببطء: في الإخراج، يكون اختيار الأداء مقابل السعر أرخص بنحو 17 مرة من اختيار الأداء. تتغير الأسعار بسرعة، لذلك عامل هذه الأرقام كما تعامل الدورة كل رقم إصدار: لقطة تستدل بها وشيء تتحقق منه مباشرة في صفحات النماذج على OpenRouter قبل إعداد أي ميزانية.
فمتى يستحق K3 تكلفة أعلى 17 مرة؟ عندما تكون المهمة صعبة إلى حد يفشل فيه V4 Pro، وتكون تكلفة الإخفاق هي وقتك. تشغيل وكيلي طويل واحد ينجح أفضل من 5 تشغيلات رخيصة يجب أن تفكك فوضاها. والقاعدة العملية التي تستقر عليها أغلب الفرق هي: ابدأ افتراضيا بنموذج الأداء مقابل السعر، وانتقل إلى نموذج الأداء حين يثبت النموذج الرخيص عدم كفايته، واجعل الإخفاقات الحقيقية لا الانطباعات هي ما يطلق الانتقال. ويغير رقم واحد هذا الحساب كله للوكلاء تحديدا: الإدخال المخزن مؤقتا. يعيد الوكيل إرسال التعليمات نفسها وسياق المستودع نفسه في كل دور، ولا يتقاضى المزودان إلا جزءا ضئيلا من سعر الإدخال حين تصيب تلك البادئة المكررة ذاكرة التخزين المؤقت. في أحمال الحلقات تكون الفاتورة الفعلية غالبا أقل بكثير من حساب سعر القائمة. تشرح صفحات الأسعار قواعد التخزين المؤقت لكل مزود. اقرأ ذلك القسم أولا لا أخيرا في أعمال الوكلاء.
والآن ابتعد بالصورة كلها، فقد استحققتها. حاضنة واحدة وفكرة واحدة وثلاثة مستويات:
| المستوى | طبقة التقديم | الدماغ في هذه الدورة | العنوان | من يدفع ثمن الحوسبة | مواضع التفوق |
|---|---|---|---|---|---|
| محلي | Ollama | Qwen3 8B | localhost لديك | دفعته مسبقا في الحاسوب المحمول | الخصوصية، العمل بلا اتصال، المجانية، التعلم |
| الخادم | vLLM | Qwen3 8B ببناء مخصص للتقديم | جهاز تتحكم فيه | أنت، لكل ساعة GPU | مستخدمون كثيرون، حلقات طوال اليوم، بيانات الفريق |
| السحابة | OpenRouter (بوابة) | Kimi K3 وDeepSeek V4 Pro | openrouter.ai | أنت، لكل رمز | أصعب المهام، بلا إعداد، النماذج الرائدة |
وهذه هي طريقة اتخاذ القرار، بترتيب الأسئلة الصحيح. أولا، هل يجوز أن تغادر البيانات؟ إذا كانت الإجابة لا، يستبعد المستوى السحابي، وتختار بين المحلي والخادم بحسب عدد من يحتاجون إلى الخدمة. ثانيا، هل تقع المهمة ضمن قدرة نموذج مفتوح متوسط الحجم؟ إذا كانت الإجابة نعم، يصبح المستوى مسألة اقتصاد: حاسوب محمول لشخص واحد، أو جهاز vLLM للكثيرين أو للحلقات. ثالثا، إذا كانت المهمة تحتاج إلى دماغ رائد، فانتقل إلى المستوى السحابي وطبق قاعدة هذا المفهوم: النموذج الرخيص افتراضيا، والغالي عند إخفاق مثبت. ثلاثة أسئلة، وتلائمها كل مناقشة نشر ستخوضها يوما بشأن النماذج المفتوحة.
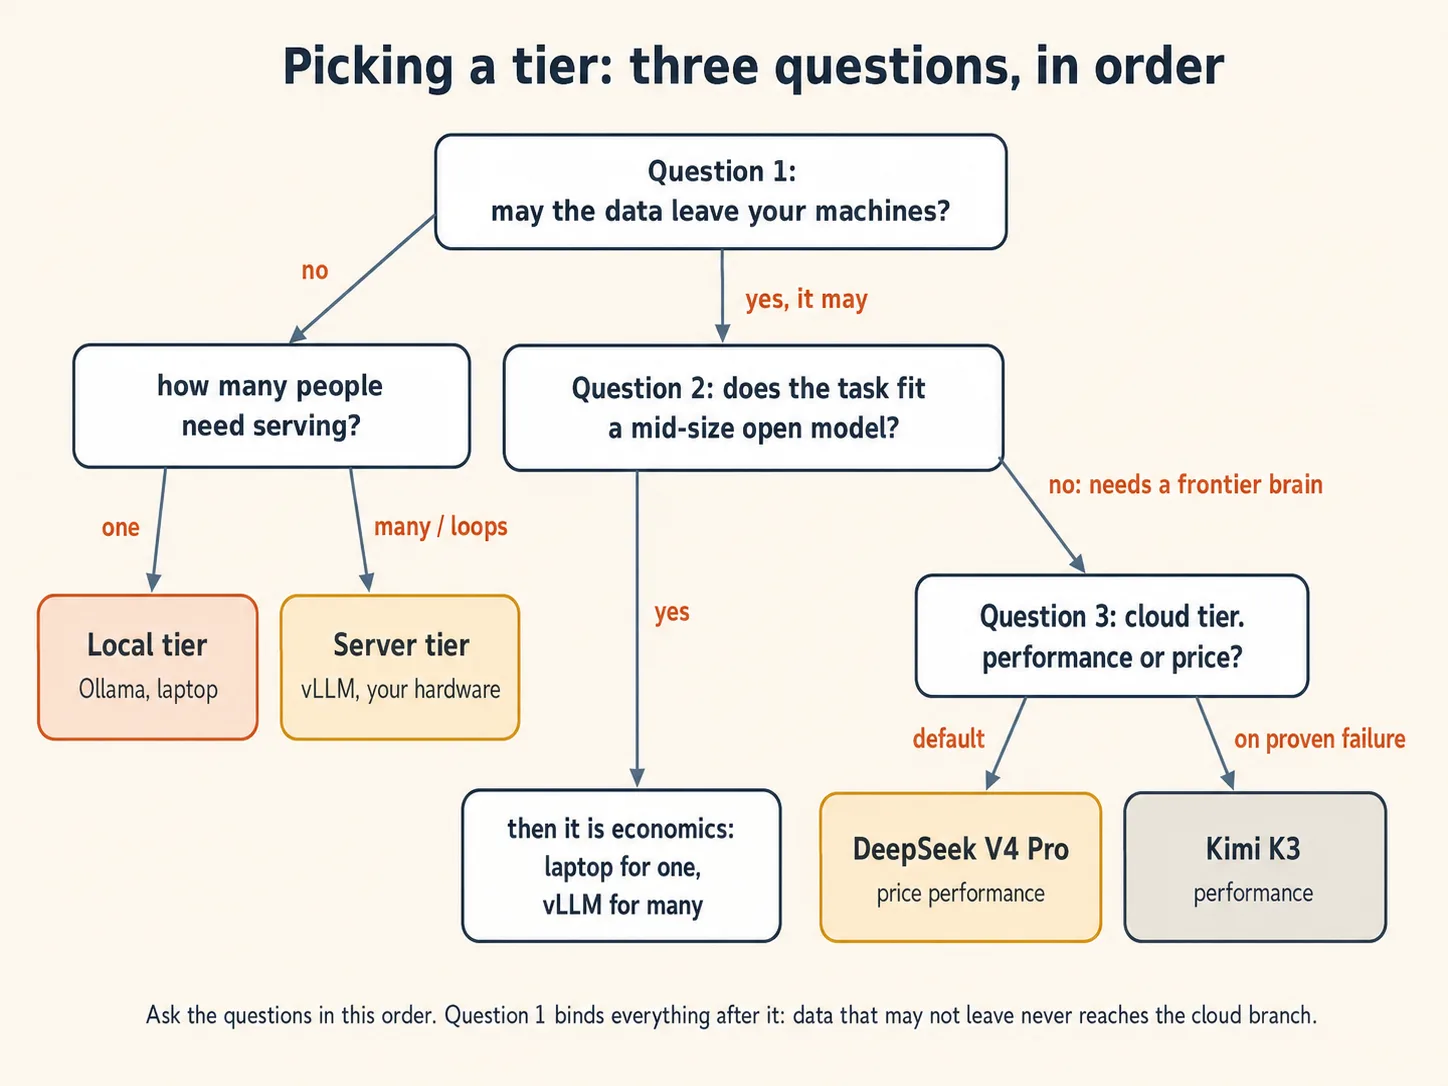
تريد شركة وكيلا يراجع عقود العملاء السرية طوال اليوم وكل يوم. المهام متوسطة الصعوبة وتقع ضمن قدرة نموذج متوسط الحجم قوي. أي مستوى تختار، ولماذا يكون كل من الخيارين الآخرين خطأ؟ مستوى الخادم. يستبعد السؤال الأول السحابة، لأن العقود السرية ينبغي ألا تغادر الأجهزة التي تتحكم فيها الشركة. ويخفق مستوى الحاسوب المحمول من جهتين: عدد من يجب أن يخدمهم ومقدار اليوم الذي يجب أن يعمل خلاله. تصطدم حلقة تعمل طوال اليوم لفريق بجدار الإنتاجية فورا. يتجاوز جهاز vLLM داخل شبكة الشركة جدار الإنتاجية، ويبقي البيانات في الداخل، ويجعل الحلقة المستمرة رخيصة لكل رمز. وإذا ثبت لاحقا أن المهام أصعب من قدرة النموذج، فخيار الشركة الحقيقي هو نموذج مفتوح أكبر على جهاز مستأجر أكبر، لا السحابة العامة، لأن السؤال الأول لا يزال ملزما.اعرض الإجابة
يكتمل المفهوم 15 عندما: تستطيع ذكر الأسئلة الثلاثة بالترتيب، والدفاع عن اختيار مستوى في سيناريو لم يعطك أحد إجابته.
16. موجه واحد عبر المستويات الثلاثة: Claude Code Router
استند كل شيء في هذه الدورة إلى فكرة واحدة: الدماغ مجرد عنوان. توجد خطوة أخيرة طبيعية، وقد نفذتها أداة مجتمعية شهيرة. ماذا لو لم يشر العنوان إلى دماغ واحد، بل إلى قرار؟
Claude Code Router، أو CCR، أداة مفتوحة المصدر من musistudio، وهي من أكثر المشاريع حصولا على النجوم في منظومة Claude Code. تشغل خادما صغيرا على جهازك يتحدث تنسيق Claude Code الأصلي من جهة ومزودين كثيرين من الجهة الأخرى، ويترجم بينهما. توجه Claude Code إليه مرة واحدة، ثم يقرر ملف إعداد، طلبا بعد طلب، أي دماغ يجيب. تجعل ثلاثة أمور معرفته جديرة بالاهتمام في ختام الدورة:
- يوجه بحسب نوع المهمة. تربط كتلة
Routerأنواع عمل Claude Code المختلفة بنماذج مختلفة:defaultللعمل العادي، وbackgroundلمهام التدبير الرخيصة، وthinkللاستدلال الصعب، وlongContextللطلبات التي تتجاوز عتبة رموز. اقرأ تلك القائمة ببطء مرة أخرى. إنها قاعدة المفهوم 15، أي البدء بنموذج الأداء مقابل السعر والانتقال في الحالات الصعبة، مكتوبة كإعداد بدلا من كونها انضباطا. - يمتد عبر كل مستوى تعلمته للتو. لا يتكون المزود في إعداده إلا من اسم وعنوان وقائمة نماذج. لذلك يستطيع ملف واحد حمل Ollama على حاسوبك المحمول وخادم vLLM وOpenRouter جنبا إلى جنب، والتوجيه بينها.
- ينعم الحواف الخشنة. تكيف محولاته، مثل
openrouterوtooluseوenhancetoolوغيرها، الطلبات والاستجابات لكل مزود، بما في ذلك إضافة تحمل الأخطاء إلى استدعاءات الأدوات من النماذج التي تنسقها بتساهل. وهذه إجابة المجتمع العملية عن تحذير التوافق في المفهوم 14.
أعده في ثلاث خطوات. ثبته بجانب Claude Code:
npm install -g @musistudio/claude-code-router
ثم أنشئ ~/.claude-code-router/config.json. يجمع الإعداد الآتي هذه الدورة كلها، أي المستويات الثلاثة خلف عنوان واحد:
{
  "OPENROUTER_API_KEY": "$OPENROUTER_API_KEY",
  "Providers": [
    {
      "name": "ollama",
      "api_base_url": "http://localhost:11434/v1/chat/completions",
      "api_key": "ollama",
      "models": ["qwen3:8b"]
    },
    {
      "name": "vllm",
      "api_base_url": "http://localhost:8000/v1/chat/completions",
      "api_key": "dummy",
      "models": ["Qwen/Qwen3-8B"]
    },
    {
      "name": "openrouter",
      "api_base_url": "https://openrouter.ai/api/v1/chat/completions",
      "api_key": "$OPENROUTER_API_KEY",
      "models": ["deepseek/deepseek-v4-pro", "moonshotai/kimi-k3"],
      "transformer": { "use": ["openrouter"] }
    }
  ],
  "Router": {
    "default": "openrouter,deepseek/deepseek-v4-pro",
    "background": "ollama,qwen3:8b",
    "think": "openrouter,moonshotai/kimi-k3",
    "longContext": "openrouter,moonshotai/kimi-k3",
    "longContextThreshold": 60000
  }
}
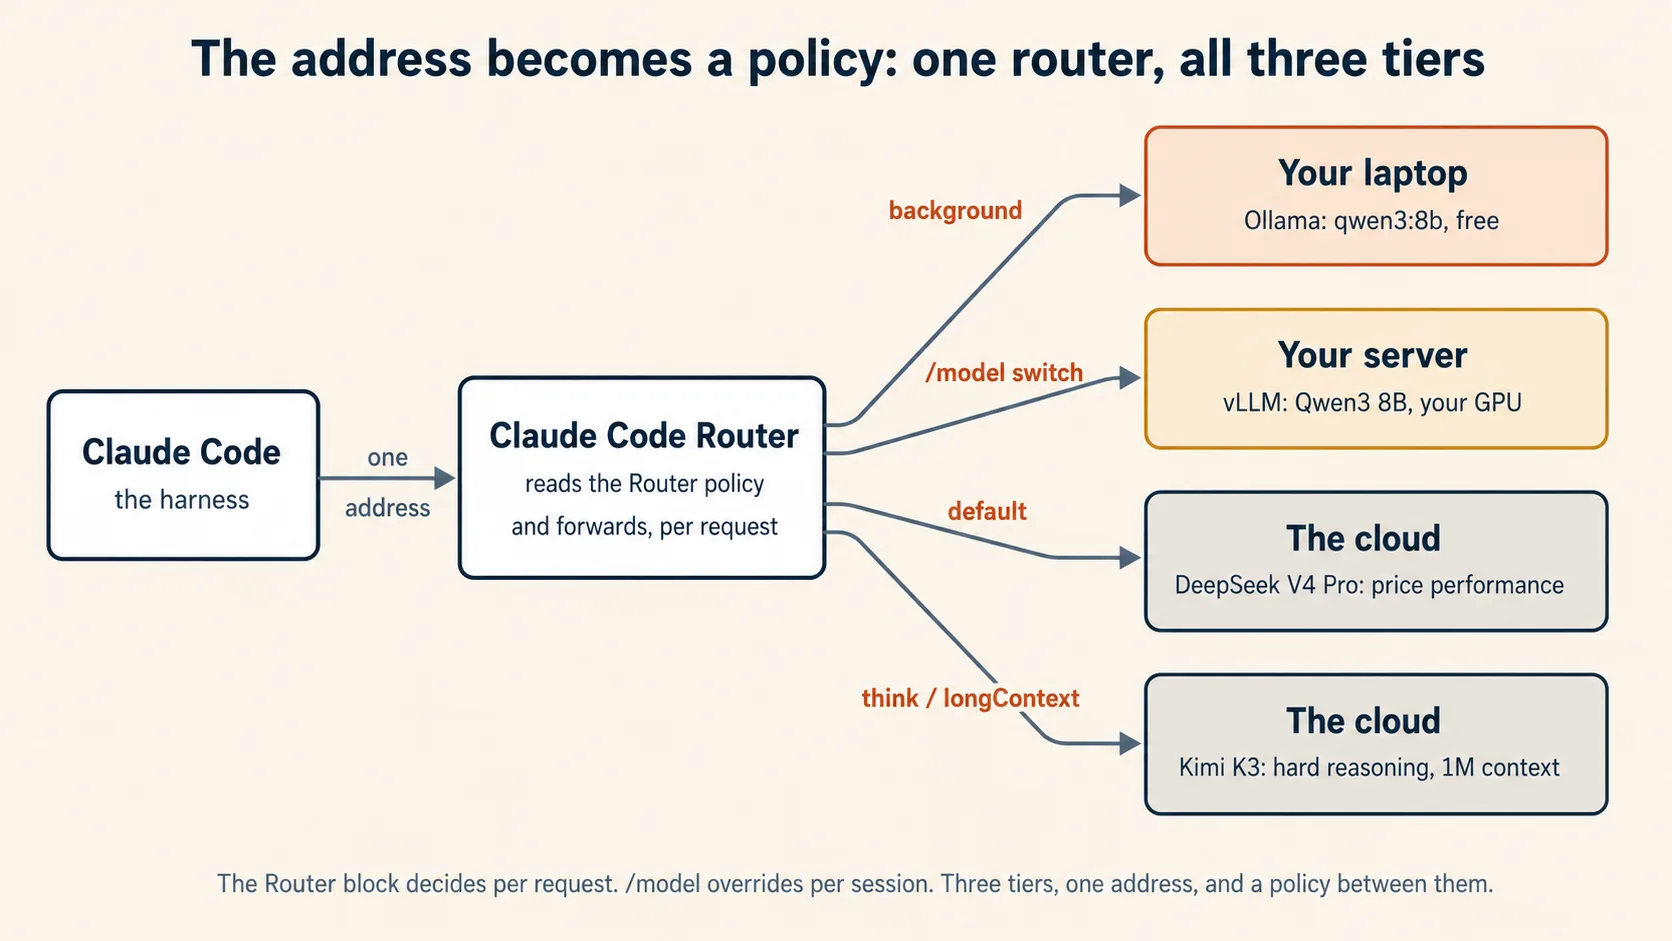
اقرأ كتلة Router بوصفها سياسة، لأنها كذلك. يذهب العمل العادي إلى النموذج الرائد الأفضل أداء مقابل السعر. وتبقى الأعمال الخلفية الرخيصة مجانية على حاسوبك المحمول. وينتقل الاستدلال الصعب والسياقات الضخمة إلى Kimi K3، الذي تكسبه نافذته ذات المليون رمز خانة longContext. تسحب صيغة $OPENROUTER_API_KEY مفتاحك من البيئة، فلا يستقر السر في الملف أبدا.
ثم ابدأ Claude Code عبر الموجه:
ccr code
إليك بعض التفاصيل التي توفر الوقت: بعد تحرير الإعداد، شغل ccr restart كي تدخل التغييرات حيز التنفيذ. وبدل الأدمغة في منتصف الجلسة داخل Claude Code باستخدام /model provider,model، مثل /model ollama,qwen3:8b. ويفتح ccr ui صفحة ويب لتحرير الإعداد إذا كنت تفضلها على JSON.
ملاحظتان صريحتان للختام. أولا، CCR مشروع مجتمعي لا منتج من Anthropic أو أي مزود. يتغير بسرعة، ومحولاته إصلاحات عملية لا ضمانات، ويمر كل طلب الآن عبر برنامج إضافي ينبغي أن تحدثه وتقرأ ملاحظات إصداره. ثانيا، لا تضفه حيث لا تحتاج إليه: يتحدث خادم vLLM من الجزء 2 تنسيق Claude Code مباشرة، لذلك لا يكسبك وضع موجه أمامه وحده شيئا. يستحق CCR مكانه حين تريد توجيه Claude Code واحد إلى أدمغة كثيرة معا بحسب المهمة. وبعد هذه الدورة، هذا هو الإعداد الذي تعرف كيف تفكر فيه بالضبط: ثلاثة مستويات وعنوان واحد، والآن سياسة تقرر بينها.
يكتمل المفهوم 16 عندما: يعمل Claude Code عبر الموجه، ويجيب مستويان على الأقل من جلسة واحدة، بأن تبدل باستخدام /model provider,model وتراقب مصدر كل إجابة، وتستطيع قراءة كتلة Router الخاصة بك بوصفها سياسة المستويات التي ترمز إليها.
جربه على مقياسك اليوم، ثم واصل التقدم
نفذ أصغر نسخة حقيقية اليوم. ثبت Ollama وشغل نموذجا وتحدث إليه. هذا وحده ذكاء اصطناعي خاص على جهازك، ويستغرق دقيقتين. إذا كنت تكتب الشفرة، فصل به وكيل برمجة واشعر بأي جدار تصطدم. وعندما تستطيع استئجار GPU لظهيرة، شغل تجربة الطلبات الخمسين وارسم منحنييك. نادرا ما يعلمك تمرين في هذا الكتاب أكثر في كل ساعة. وحين تهزم مهمة كل دماغ تستطيع استضافته، غير العنوان للمرة الأخيرة واستعر دماغا رائدا مقابل سنتات أو دولارات. وحين يحتاج أشخاص آخرون إلى ما بنيته، يحول الملحق A خادمك إلى خدمة يستطيعون مشاركتها.
احمل النموذج الذهني معك، لأن القسم يبني عليه بالترتيب. أداتك حاضنة مع دماغ قابل للتبديل، والدماغ مجرد عنوان. يمكن أن يشير العنوان إلى حاسوبك المحمول أو خادمك أو أكبر النماذج المفتوحة في العالم، ولا تعرف الحاضنة الفرق. يحدد جداران ما يستطيع الإعداد فعله: تحرك طبقة التقديم والعتاد الإنتاجية، ولا تحرك القدرة إلا دماغ أكبر. ومن هنا تنتقل إلى قيادة هذا الوكيل جيدا في البرمجة الوكيلة، وتوجيهه بمواصفة مكتوبة في التطوير المدفوع بالمواصفات، ومنحه حلقة تعمل طوال اليوم من دونك في هندسة الحلقات. وعندما تبلغ الأخيرة، ستعرف بدقة دماغ من ينبغي أن يشغل الحلقة، وعلى أي مستوى، وما تكلفة استمرارها.
الخلاصة في سطر واحد
تعمل النماذج مفتوحة المصدر على ثلاثة مقاييس، وتصل أداتك إلى الثلاثة بالطريقة نفسها: عبر عنوان. Ollama لشخص واحد، وvLLM للكثيرين، وOpenRouter للأدمغة الرائدة التي لا يكاد أحد يستطيع استضافتها ذاتيا. قس الفرق مرة بمنحنييك، وستختار المستوى الصحيح طوال بقية حياتك المهنية.
الملحق A: ابن سحابة مصغرة لنماذج اللغة الكبيرة
منحك الجزء 2 مطبخا صناعيا، لكن المطبخ ليس مطعما. يضيف هذا الملحق الباب الأمامي والقائمة وأرقام الطاولات والفاتورة، كي يخدم جهاز يقدم الخدمة جيدا لشخص واحد فصلا كاملا بأمان.
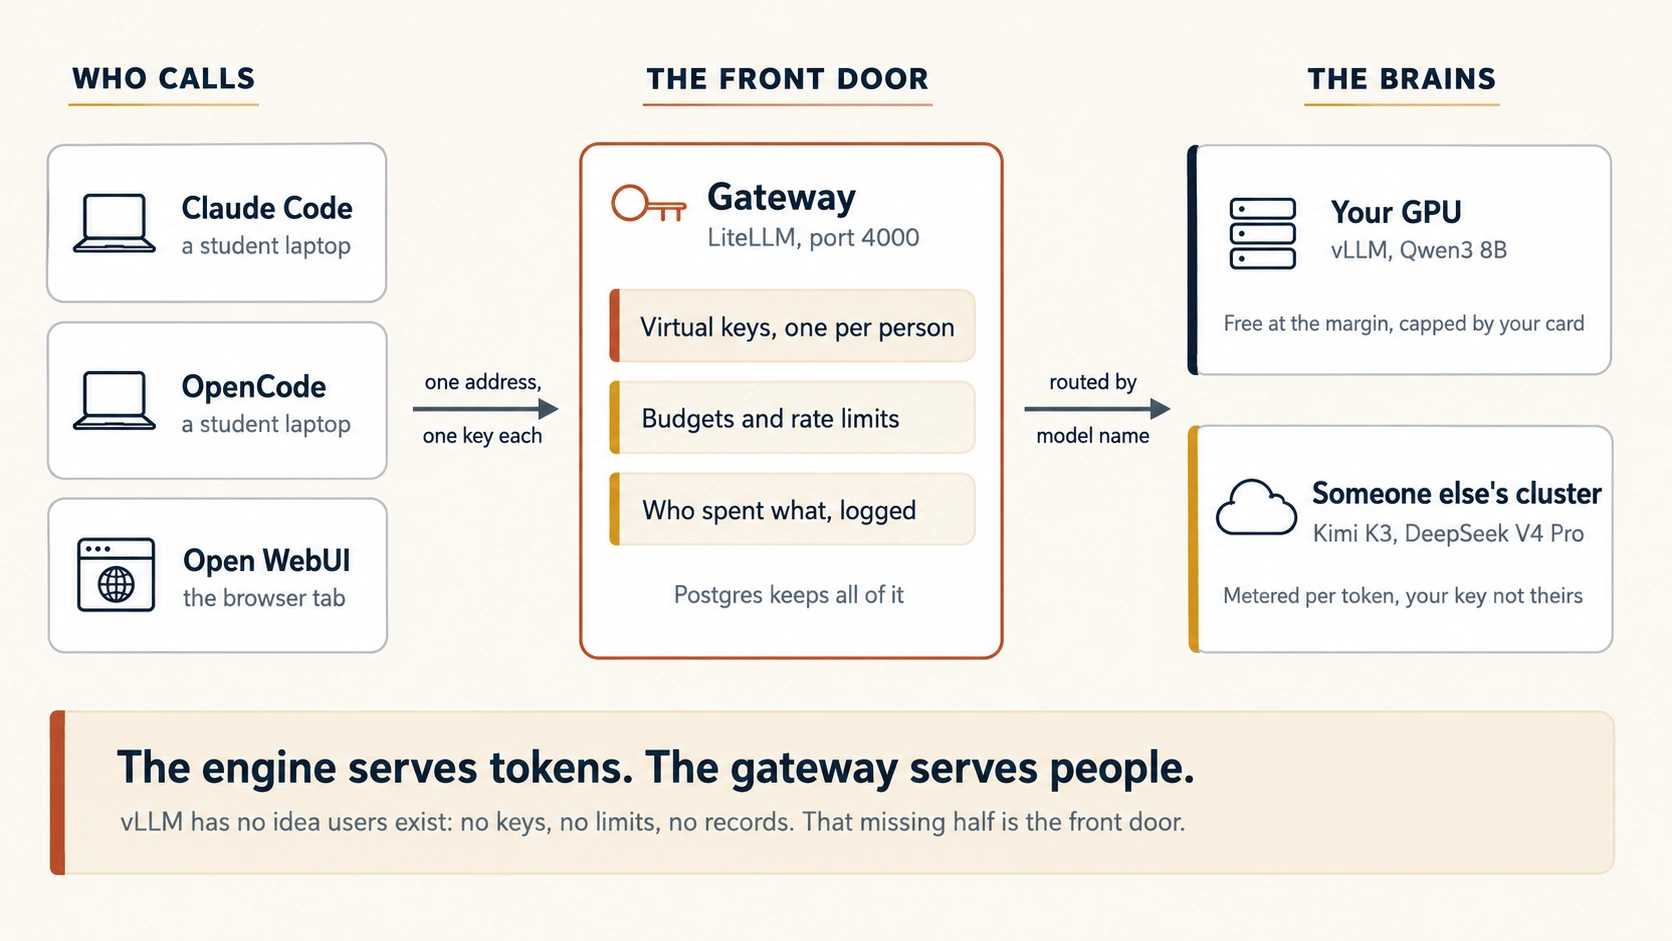
هذه هي الفجوة التي يغلقها الملحق. كان vLLM في نهاية الجزء 2 يقدم Qwen3 8B، وكان منحنى طلباتك الخمسين يصعد بينما تسطح منحنى Ollama. هذا إنجاز حقيقي، لكنه ليس خدمة بعد. حاول تسليمه إلى فصل فتبدأ الأسئلة فورا. من المسموح له استخدامه؟ ما الذي يمنع حلقة طالب منفلتة من استهلاك الجهاز كله طوال أسبوع؟ من أنفق ماذا؟ وكيف يصل طالب إلى دماغ رائد حين لا يكفي Qwen3 8B، من دون أن تعطي مفتاح OpenRouter الخاص بك إلى 200 شخص؟
لا يتعلق أي من هذه الأسئلة بتقديم الرموز، ولهذا تحديدا لا يجيب عنها vLLM. يحمل محرك الاستدلال نموذجا ويجيب عن الطلبات. ولا يعرف أن المستخدمين موجودون. ليست لديه مفاتيح ولا حصص ولا سجلات إنفاق ولا وسيلة للرفض. لهذا النصف المفقود اسم، وبناؤه هو موضوع الملحق.
تمتد فكرة الدورة الواحدة إلى هنا. الدماغ مجرد عنوان. كان العنوان في الجزء 1 حاسوبك المحمول، وفي الجزء 2 جهازا تتحكم فيه، وفي الجزء 3 عنقود شخص آخر. وفي هذا الملحق تصبح أنت العنوان: تبني الشيء الذي يوجه الآخرون وكلاءهم إليه.
كل ما احتاج إليه الجزء 2، إضافة إلى Docker وDocker Compose على جهاز GPU نفسه. إذا أنجزت الجزء 3، فأبق مفتاح OpenRouter في متناولك للمفهوم A5. يمكنك قراءة الملحق كله من دون تشغيل شيء، وتستحق المفاهيم A1 وA2 وA7 القراءة حتى إن لم تبن المكدس قط.
برنامجان لا واحد. يقدم vLLM الرموز. وتقف أمامه بوابة تتولى كل ما لا يفعله vLLM: مفاتيح المستخدمين وحدود الإنفاق وتوجيه النماذج والسجلات. البوابة المستخدمة هنا هي LiteLLM. أضف Postgres كي تبقى المفاتيح والإنفاق بعد إعادة التشغيل، وOpen WebUI كي يستطيع من لا يستخدم الطرفية استعمال سحابتك. أربع حاويات وملف واحد وظهيرة واحدة.
كلمات جديدة لهذا الملحق
| المصطلح | معناه بلغة بسيطة |
|---|---|
| محرك الاستدلال | البرنامج الذي يحمل نموذجا ويجيب عن الطلبات. vLLM أحدها. يعرف الرموز لا الناس. |
| البوابة أو الوكيل الوسيط | البرنامج الموجود أمام المحرك. يعرف الناس: من يتصل، وما المسموح له استخدامه، وما تكلفته. |
| المفتاح الافتراضي | مفتاح API خاص بكل شخص تصدره بوابتك وتستطيع إلغاءه، وترتبط به حدوده الخاصة. |
| الميزانية | سقف إنفاق لمفتاح. حين ينفد، ترفض البوابة الطلب بدلا من استمرار نمو الفاتورة. |
| حد المعدل | سقف للطلبات في الدقيقة، كي لا يزاحم مستخدم مشغول الجميع. |
| تعدد المستأجرين | خدمة مستخدمين منفصلين كثيرين من عتاد مشترك، من دون أن يؤثر بعضهم في بعض. |
| البديل الاحتياطي | قاعدة تقول «إذا فشل هذا النموذج أو امتلأ، فجرب ذاك بدلا منه». |
A1. المطبخ ليس مطعما
خذ الاستعارة التي استخدمتها الدورة منذ المفهوم 8 وادفعها خطوة. كان Ollama مطبخا منزليا بموقد ذي شعلتين، وكان vLLM مطبخا صناعيا يبقي كل شعلة مشتعلة. وكلاهما يقع في خلف المطعم.
يحتاج المطعم أيضا إلى واجهة. شخص عند الباب يعرف هل لديك حجز، وقائمة تقول ما المتاح اليوم، ورقم طاولة كي يعرف المطبخ أين يرسل كل طبق، وفاتورة في النهاية. لا يعد شيء من ذلك طهيا، والمطبخ الرائع بلا واجهة ليس مطعما، بل مطبخا يدخله الغرباء.
هذه تحديدا حالة خادم vLLM مجرد. يستطيع كل من يصل إلى المنفذ استخدامه مجانا إلى الأبد. إليك ما لا يفعله، ويستحق أن تقرأه ببطء، لأن كل عنصر شيء كنت ستضطر إلى بنائه بنفسك:
| ما تحتاج إليه | هل يفعله vLLM؟ |
|---|---|
| تقديم الرموز بسرعة لمستخدمين كثيرين معا | نعم. هذه مهمته كلها، وهو ممتاز فيها. |
| معرفة من يتصل | لا. |
| إيقاف شخص عند حد إنفاق | لا. |
| منع مستخدم من مزاحمة البقية | جزئيا، عبر الصف، لكن ليس لكل مستخدم. |
| عرض أكثر من نموذج عند عنوان واحد | لا. خادم واحد ونموذج واحد. |
| الانتقال إلى نموذج آخر عند إخفاق هذا | لا. |
| تسجيل من أنفق ماذا | لا. |
| الوصول إلى نموذج سحابي عند إخفاق المحلي | لا. |
كل «لا» في ذلك الجدول هي مهمة البوابة.
يطهو المطبخ. وتقرر الواجهة من يأكل، وما في القائمة، ومن يدفع. لقد بنيت مطبخا جيدا جدا، وتحتاج الآن إلى باب.
سؤال وجيه هنا: هل يوجد برنامج واحد يفعل الأمرين؟ تقريبا، والإجابة الصريحة مهمة. التقديم مشكلة بنية تحتية، وقد حلها عالم المصدر المفتوح جيدا جدا. أما القياس والحصص والفوترة فهي مشكلة منتج، وهي ما تبيعه شركات الاستدلال فعلا. لذلك تمنحك الأدوات المفتوحة المحرك والمقياس كقطعتين منفصلتين، وتجمعهما أنت. والميزة المنقذة أن كل طبقة هنا تتحدث شكل الطلب المتوافق مع OpenAI نفسه الذي استخدمته منذ الجزء 1، ولذلك يعني التجميع إعدادا لا عمل ترجمة.
يكتمل المفهوم A1 عندما: تستطيع تسمية 3 أشياء لا يستطيع خادم vLLM مجرد فعلها، ويحتاج إليها فصل من 50 طالبا منذ اليوم الأول.
A2. البوابة: عنوان واحد وأدمغة كثيرة ومستخدمون حقيقيون
البوابة برنامج صغير يقف أمام خادم نموذج واحد أو أكثر. تصل الطلبات إلى البوابة، فتقرر ما تفعله بها ثم تمررها. إنها الباب الأمامي.
لقد استخدمت واحدة بالفعل. OpenRouter من الجزء 3 بوابة: عنوان واحد ومفتاح واحد وفاتورة واحدة، وخلفها مئات النماذج، مع تنفيذ التقديم الفعلي بواسطة مضيفين لا تتصل بهم مباشرة. يبني هذا الملحق البنية نفسها على مقياسك وعلى جهازك، ويجعلك المشغل بدلا من شركة.
الأداة المستخدمة لهذه المهمة هي LiteLLM، وهو وكيل وسيط مفتوح المصدر يتحدث الشكل المتوافق مع OpenAI إلى مستخدميك ويترجم إلى قائمة طويلة من المزودين، ومن بينهم خادم vLLM الخاص بك. تجعله أربعة أمور القطعة الصحيحة:
- المفاتيح الافتراضية. تصدر لكل طالب مفتاحه الخاص. تستطيع ربط حدود به، ورؤية ما أنفقه، وإلغاءه لحظة انتهاء الفصل الدراسي أو ضياع حاسوب محمول.
- الميزانيات وحدود المعدل. يستطيع المفتاح حمل سقف إنفاق وحد لكل دقيقة. وعندما تصطدم حلقة منفلتة بالسقف، ترفض البوابة الطلب التالي. تتوقف فاتورتك عند رقم اخترته مسبقا.
- قائمة نماذج عند عنوان واحد. يمكن أن يظهر Qwen3 8B المحلي ونموذج سحابي رائد على البوابة نفسها، ويصل إليهما الطلاب أنفسهم بالمفتاح نفسه.
- السجلات. يسجل كل طلب باسم مستخدم، فيصبح سؤال «من أنفق ماذا؟» استعلاما لا تحقيقا.
لاحظ شكل الأمر. لا تجعل البوابة أي شيء أسرع. لا تغير شيئا في الرموز في الثانية، بل تضيف بضعة أجزاء من الألف من الثانية. ليست أداة أداء إطلاقا، بل أداة تحكم، والتحكم هو ما يحول الخادم إلى خدمة.
يقول طالب إن البوابة بلا فائدة لأن «vLLM يمنحني بالفعل عنوانا متوافقا مع OpenAI، ولذلك يمكنني استخدامه مباشرة». ما أقوى رد؟ هو محق بشأن العنوان ومخطئ بشأن الخدمة. يعمل عنوان vLLM جيدا لشخص موثوق واحد، ولهذا تحديدا استطاع المفهوم 11 التوقف عنده. توجد البوابة من أجل كل ما يظهر لحظة وجود أشخاص كثيرين: مفاتيح منفصلة، وسقوف إنفاق، وحدود معدل، وقائمة تضم أكثر من نموذج، وبدائل احتياطية، وسجل بمن استخدم ماذا. ليست أي منها ميزات سرعة، ولهذا تبدو المقارنة فارغة حتى تعمل حلقة منفلتة طوال عطلة نهاية الأسبوع ولا يستطيع أحد معرفة صاحبها.اعرض الإجابة
يكتمل المفهوم A2 عندما: تستطيع أن تقول في جملة واحدة ما تضيفه البوابة مما لن يضيفه محرك الاستدلال أبدا، ولماذا ليست ميزة سرعة.
A3. شغله: المكدس كله في ملف واحد
أربع حاويات، وجهاز واحد، وملف واحد.
| الحاوية | المهمة |
|---|---|
| vllm | يقدم Qwen3 8B على GPU لديك. إنه الخادم نفسه من المفهوم 9، وأمامه باب الآن. |
| litellm | البوابة. الشيء الوحيد الذي يتعامل معه المستخدمون. |
| postgres | يخزن المفاتيح والمستخدمين والميزانيات والإنفاق، كي لا تمحو إعادة التشغيل فصلك. |
| open-webui | صفحة محادثة لمن لا يعيشون في الطرفية داخل فصلك. |
ابدأ بإعداد البوابة نفسها. احفظه باسم litellm-config.yaml:
model_list:
  # Your own GPU, from Part 2. Students see the name on the left.
  - model_name: qwen3-8b
    litellm_params:
      model: hosted_vllm/Qwen/Qwen3-8B
      api_base: http://vllm:8000/v1
      api_key: "not-needed"

general_settings:
  master_key: os.environ/LITELLM_MASTER_KEY
  database_url: os.environ/DATABASE_URL

litellm_settings:
  drop_params: true
يستحق تفصيلان هنا التسمية. model_name هو الاسم الذي يكتبه مستخدموك، ولا يلزم أن يطابق اسم النموذج الحقيقي تحته. يسمح لك هذا الفصل بتبديل الدماغ لاحقا من دون إخبار أحد. أما master_key فهو كلمة مرور المسؤول لسحابتك كلها، وليس مفتاح طالب، ولا يغادر جهازك أبدا.
والآن المكدس. احفظ الآتي باسم docker-compose.yml:
services:
  vllm:
    image: vllm/vllm-openai:latest
    command: >
      --model Qwen/Qwen3-8B
      --enable-auto-tool-choice
      --tool-call-parser hermes
      --reasoning-parser qwen3
    volumes:
      - ./hf-cache:/root/.cache/huggingface
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: all
              capabilities: [gpu]

  postgres:
    image: postgres:16
    environment:
      POSTGRES_DB: litellm
      POSTGRES_USER: litellm
      POSTGRES_PASSWORD: ${POSTGRES_PASSWORD}
    volumes:
      - ./pgdata:/var/lib/postgresql/data

  litellm:
    # Pin the version. Read the security note below before you change this.
    image: ghcr.io/berriai/litellm:main-v1.80.5
    depends_on: [vllm, postgres]
    ports:
      - "4000:4000"
    environment:
      LITELLM_MASTER_KEY: ${LITELLM_MASTER_KEY}
      DATABASE_URL: postgresql://litellm:${POSTGRES_PASSWORD}@postgres:5432/litellm
    volumes:
      - ./litellm-config.yaml:/app/config.yaml
    command: ["--config", "/app/config.yaml", "--port", "4000"]

  open-webui:
    image: ghcr.io/open-webui/open-webui:main
    depends_on: [litellm]
    ports:
      - "3000:8080"
    environment:
      OPENAI_API_BASE_URL: http://litellm:4000/v1
      OPENAI_API_KEY: ${LITELLM_MASTER_KEY}
    volumes:
      - ./webui-data:/app/backend/data
ضع السرين في ملف .env بجواره، ولا تضعهما أبدا في ملف Compose نفسه:
LITELLM_MASTER_KEY=sk-choose-a-long-random-string
POSTGRES_PASSWORD=choose-another-long-random-string
ثم شغله وأثبت أنه يعمل:
docker compose up -d

curl http://localhost:4000/v1/chat/completions \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "qwen3-8b", "messages": [{"role": "user", "content": "Say hello in one line."}]}'
انظر إلى هذا الطلب بجانب طلب المفهوم 9. البنية نفسها و/v1/chat/completions نفسها، مع سطر جديد واحد هو ترويسة Authorization. تمثل تلك الترويسة الواحدة الفرق كله بين خادم وخدمة. يجب الآن أن يصرح أحد بهويته.
تعرضت حزمة LiteLLM في مارس 2026 لهجوم على سلسلة التوريد، ونشرت إصدارات خبيثة قبل سحبها. تحمل بوابتك كل مفتاح وكل سجل إنفاق في سحابتك، وهذا يجعلها أعلى هدف قيمة في المكدس. لذلك ثبت وسم إصدار دقيقا، ولا تتبع latest أبدا، واقرأ ملاحظات الإصدار قبل الانتقال، وأبق البوابة بعيدة عن الإنترنت العام حتى تنجز الأمرين. هذا التحذير ليس مقصورا على LiteLLM، بل هو معنى تشغيل أي خدمة تحمل بيانات اعتماد.
عادة ما يكون عدم تطابق برنامج التشغيل وCUDA هو السبب، ولهذا يستخدم ملف Compose الصورة الرسمية بدلا من pip install. وتحتاج أيضا إلى NVIDIA Container Toolkit مثبتة على المضيف، وإلا ظل GPU غير مرئي داخل Docker. وإذا كنت تستخدم بطاقة 16 GB، فاستخدم Qwen/Qwen3-8B-FP8 في سطر النموذج تماما كما في المفهوم 9.
يكتمل المفهوم A3 عندما: يشغل docker compose up -d أربع حاويات، ويعيد طلب curl عبر المنفذ 4000 إجابة، ويرفض الطلب نفسه من دون ترويسة Authorization.
A4. وزع المفاتيح: الميزانيات والحدود ومن أنفق ماذا
هذا هو المفهوم الذي يجعله سحابة. كان كل ما قبله أعمال تمديد.
أنشئ مفتاحا لطالب واحد:
curl -X POST http://localhost:4000/key/generate \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "user_id": "student-0417",
    "models": ["qwen3-8b"],
    "max_budget": 2.00,
    "budget_duration": "30d",
    "rpm_limit": 20
  }'
اقرأ الإعدادات الأربعة، لأن كل واحد منها قرار تتخذه عن قصد:
- يربط
user_idكل طلب مستقبلي وكل دولار مسجل بشخص. ومن دونه يكون تقرير استخدامك رقما مجهولا كبيرا واحدا. - تمثل
modelsالقائمة التي يستطيع هذا المفتاح الطلب منها. لا يستطيع مفتاح لا يسرد إلاqwen3-8bالوصول إلى شيء آخر مهما كتب الطالب. - يمثل
max_budgetمعbudget_durationالسقف. دولاران شهريا، ثم تبدأ البوابة الرفض. تتوقف الحلقة المنفلتة بنفسها ليلا من دون إيقاظك. - يمنع
rpm_limitطالبا متحمسا من ملء الصف على حساب الجميع.
تعود الاستجابة بمفتاح تكون بدايته sk-. يحصل الطالب على تلك السلسلة وحدها، ولا شيء غيرها.
والآن تأتي اللحظة التي وجد الملحق كله لأجلها. يستخدم الطالب سحابتك بالطريقة نفسها تماما التي استخدم بها الجزء 3 خدمة OpenRouter. الإعدادان نفسيهما وعنوان جديد:
# OpenCode, or anything speaking the OpenAI shape
export OPENAI_BASE_URL="http://your-server:4000/v1"
export OPENAI_API_KEY="sk-the-students-key"
لا تعلم الحاضنة أن شيئا تغير. ما زالت حاضنة مع دماغ وعنوان، لكن العنوان صار جهازا في مبناك.
وبالنسبة إلى Claude Code تحديدا، يعرض LiteLLM أيضا نقطة نهاية بتنسيق Anthropic، مما يسمح لك بتوجيه ANTHROPIC_BASE_URL مباشرة إلى بوابتك، بالحركة نفسها ذات العنوان المجرد التي نفذتها ثلاث مرات. يتغير هذا السطح أسرع مما تستطيع الصفحة متابعته، لذا تحقق من وثائق LiteLLM المباشرة قبل الاعتماد عليه. وإذا لم يعمل في الإصدار الذي ثبتته، يوصلك Claude Code Router من المفهوم 16 بقفزة إضافية واحدة، وتصبح بوابتك مجرد مزود آخر في إعداده.
ستستخدم أمرين باستمرار بعد بدء الفصل:
# What has this key spent?
curl -X GET "http://localhost:4000/key/info?key=sk-the-students-key" \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY"

# Semester over, or laptop lost.
curl -X POST http://localhost:4000/key/delete \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{"keys": ["sk-the-students-key"]}'
يحصل كل ضيف على رقم طاولته المرتبط بحد إنفاق. لم يتغير المطبخ إطلاقا، لكنك تعرف الآن من يأكل، وتستطيع منع طاولة واحدة من طلب القائمة كلها، وتستعيد طاولة الشخص عند مغادرته.
أصدرت 200 مفتاح للطلاب، لكل منها سقف دولارين شهريا، وكلها تشير إلى GPU تملكه. يسألك زميل لماذا أزعجت نفسك بالميزانيات ما دام النموذج المحلي لا يكلف شيئا لكل رمز. ما الإجابة الحقيقية؟ إجابتان، والثانية هي الأهم. أولا، وصف «مجاني» خاطئ حتى محليا: يمتلك GPU إنتاجية ثابتة، كما عرض منحنى الجزء 2 عند امتلاء البطاقة، ولذلك تنفق حلقة طالب مستمرة سعة الجميع حتى حين لا ينتقل مال. تقنن الميزانية موردا مشتركا. ثانيا، وهذا هو اتجاه المفهوم A5، تتدفق أموال حقيقية عبر المفاتيح نفسها لحظة إضافة نموذج سحابي إلى القائمة. بناء عادة الميزانية وهي مجانية يعني أنك لن تبنيها في ذعر يوم تتوقف فيه عن المجانية.اعرض الإجابة
يكتمل المفهوم A4 عندما: يشغل شخص ثان على جهاز مختلف مهمة حقيقية عبر بوابتك باستخدام مفتاحه، وتبحث عن مقدار إنفاقه، ثم تلغي المفتاح.
A5. ضع المستويات الثلاثة كلها خلف باب واحد
تعرض سحابتك حاليا دماغا واحدا. أضف الآن المستويين الآخرين من الدورة إلى القائمة نفسها، كي يختار الطالب مستوى بتغيير اسم نموذج ولا شيء آخر.
وسع litellm-config.yaml:
model_list:
  # Tier 2: your own GPU. Free at the margin, capped by your hardware.
  - model_name: qwen3-8b
    litellm_params:
      model: hosted_vllm/Qwen/Qwen3-8B
      api_base: http://vllm:8000/v1
      api_key: "not-needed"

  # Tier 3: a frontier brain, rented. Your key, never theirs.
  - model_name: frontier
    litellm_params:
      model: openrouter/moonshotai/kimi-k3
      api_key: os.environ/OPENROUTER_API_KEY

  # Tier 3, the cheap end. The right default for high-volume work.
  - model_name: frontier-cheap
    litellm_params:
      model: openrouter/deepseek/deepseek-v4-pro
      api_key: os.environ/OPENROUTER_API_KEY

router_settings:
  fallbacks:
    - qwen3-8b: ["frontier-cheap"]
حدثت ثلاثة أمور للتو، ويستحق كل منها جملة.
لا يغادر مفتاح OpenRouter جهازك أبدا. يستطيع 200 طالب الآن الوصول إلى Kimi K3، ولا يملك أي منهم بيانات اعتماد يمكن لصقها في مستودع عام. يحملون مفتاح بوابتك الذي تستطيع إلغاءه بأمر واحد، ولا يستطيع الإنفاق بعد سقفه. حذر المفهوم 14 من أن مفتاح OpenRouter سر ومحفظة في سلسلة واحدة. هكذا تشارك المحفظة من دون تسليم السلسلة.
صار اختيار المستوى اسم نموذج. يكتب الطالب الذي يحتاج إلى دماغ رائد لإعادة هيكلة صعبة واحدة frontier بدلا من qwen3-8b. وهذا يحول إجراء المفهوم 15 ذي الأسئلة الثلاثة إلى شيء يستطيع شخص فعله في منتصف المهمة.
سطر البديل الاحتياطي سياسة. إذا كان GPU متوقفا أو ممتلئا، تذهب طلبات qwen3-8b بهدوء إلى frontier-cheap بدلا من الفشل. وهذه مقايضة حقيقية تختارها عمدا: توافر تشتريه بالمال. اكتبها في مكان سيعثر عليه مستقبلك، لأن البديل الذي نسيته فاتورة لن تفهمها.
ضع الآن حدودا مختلفة لقائمة النماذج الرائدة، لأنها تكلف مالا حقيقيا:
curl -X POST http://localhost:4000/key/generate \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "user_id": "student-0417-frontier",
    "models": ["qwen3-8b", "frontier-cheap", "frontier"],
    "max_budget": 5.00,
    "budget_duration": "30d"
  }'
ابتعد وانظر إلى ما بنيته. عنوان واحد، وخلفه نموذج على عتاد تملكه ونماذج على عناقيد لا يستطيع أحد في الغرفة امتلاكها، كلها معروضة في القائمة نفسها، وتحاسب وفق السقوف نفسها، ويصل إليها الإعدادان نفسيهما. علمك المفهوم 2 أن الدماغ مجرد عنوان. وهذه هي الجملة مقروءة بالعكس: يستطيع عنوان إخفاء أي عدد من الأدمغة، وصار الاختيار بينها ملف إعداد يملكه شخص ما. إنه ملفك.
يرسل البديل الاحتياطي طلبات عمل كل طلب كان سيجري مجانا على نموذج سحابي مدفوع لنحو 60 ساعة، وظلت الخدمة تعمل بلا عيب، وهذا تحديدا سبب عدم ملاحظة أحد. تستبدل البدائل الاحتياطية المال بالتوافر في صمت، والصمت هو الخطر. أضف شيئين: تنبيها حين تكون حاوية vLLM غير سليمة، وتنبيه إنفاق على البوابة. ليس الحل إزالة البديل، بل التأكد من أن استمراره أكثر من بضع دقائق يخبر شخصا.qwen3-8b الفاشلة إلى frontier-cheap. يعاد تشغيل جهاز GPU لتحديث برنامج التشغيل مساء الجمعة، ولا يلاحظ أحد حتى الاثنين. ماذا حدث في عطلة نهاية الأسبوع، وماذا ينبغي أن تضيف؟اعرض الإجابة
يكتمل المفهوم A5 عندما: يصل مفتاح واحد إلى نموذجك المحلي ونموذج رائد بالاسم، وتستطيع شرح ما تشتريه قاعدة البديل وما تكلفه.
A6. راقبه: ثلاثة أرقام تخبرك هل هو سليم
الخدمة التي لا يراقبها أحد خدمة تفشل في صمت. ينشر vLLM أرقامه عند http://localhost:8000/metrics بالتنسيق الذي يقرؤه Prometheus، والصورة القياسية هي جمع Prometheus لها ورسم Grafana إياها.
لا تحتاج إلى ذلك في اليوم الأول، لكنك تحتاج إلى معرفة الأرقام الثلاثة المهمة، لأنها تخبرك بما تعطل قبل أن يخبرك طالب:
- عمق الصف: كم طلبا ينتظر؟ هذا أكثر أرقامك فائدة، وهو تجربة الجزء 2 وقد تحولت إلى مقياس حي. قربه من الصفر يعني أن الجهاز يعمل براحة. وصعوده وبقاؤه مرتفعا يعني أن سعة GPU نفدت، وأن الوقت حان لبطاقة ثانية أو نموذج أصغر أو حد صريح للفصل.
- الوقت حتى أول رمز: كم ينتظر المستخدم قبل ظهور أي شيء؟ قد تبدو الإنتاجية رائعة بينما يعاني كل شخص. هذا هو الرقم الذي يشعر به طلابك فعلا، وهو بالضبط ما يخفيه إجمالي الرموز في الثانية.
- ذاكرة GPU المستخدمة. تمتلئ الذاكرة قبل الحوسبة، وعندما تمتلئ ينخفض الأداء قبل أن يبدو أي شيء معطلا. يؤدي نموذج يستهلك كل ذاكرة العقدة بهدوء إلى تدهور تجربة الجميع بينما تستمر كل حاوية في إعلان أنها سليمة.
يقف شيئان بجوار تلك الأرقام. لوحة إنفاق البوابة، حيث تكتشف فاتورة غير متوقعة مبكرا لا في نهاية الشهر. وفحص سلامة بسيط للحاويتين، لأن سؤال «هل يعمل؟» تريد من جهاز الإجابة عنه عند 3 صباحا، لا من رسالة طالب.
عمق الصف هو الطابور عند الباب، والوقت حتى أول رمز هو مدة انتظار كل ضيف طعامه، وذاكرة GPU هي مدى امتلاء المطبخ. صاحب المطعم الذي لا يراقب سوى إجمالي الوجبات المقدمة هو آخر من يعلم أن المكان ينهار.
يكتمل المفهوم A6 عندما: تحمل /metrics من حاوية vLLM بعينيك، وتستطيع تسمية أول رقم من الثلاثة ستفحصه حين يقول طالب «يبدو بطيئا اليوم».
A7. متى يستحق العناء ومتى يحين الانتقال؟
إليك الحساب الصريح، بروح المفاهيم 7 و12 و15 نفسها.
ابن سحابة مصغرة عندما:
- يكون لديك مستخدمون كثيرون وميزانية واحدة. فصل دراسي أو معسكر تدريبي أو قسم أو شركة صغيرة. يعد GPU واحد يخدم 50 شخصا أرخص إعداد قادر سيحصل عليه أي منهم، والبوابة هي ما يجعل «50 شخصا» آمنا لا فوضويا.
- يجب ألا تغادر البيانات. هذا هو السؤال الأول في المفهوم 15 مجابا عنه على مقياس المؤسسة، مع قطعة إضافية تهم المؤسسة: مسار تدقيق يعرض من وصل إلى ماذا.
- تريد عنوانا ثابتا واحدا أمام عالم متغير. تتغير النماذج والأسعار والمزودون كل بضعة أسابيع. إذا أشار طلابك إلى بوابتك، تستوعب التقلب في ملف إعداد بدلا من مطالبة 200 شخص بتغيير إعداداتهم.
- تعمل الحلقات طوال اليوم. ترسل وكلاء هندسة الحلقات التي ستقابلها لاحقا طلبات إلى الأبد. لا تتوقف الفاتورة لكل رمز عن الارتفاع. أما على GPU تملكه بالفعل وأشبعته بالفعل، فلا يكلفك طلب إضافي شيئا تقريبا.
لا تبن واحدة عندما:
- تكون شخصا واحدا. أنت واجهة المطعم كلها. استخدم vLLM مباشرة كما عرض المفهوم 11 بالضبط، وتجاوز هذا الملحق.
- تكون حركة المرور قليلة وعرضية. تكلف وحدات GPU الخاملة ما تكلفه المشغولة. تحت حجم حقيقي من الحركة اليومية، يفوز الاستئجار عبر الجزء 3 في المال وعطلات نهاية الأسبوع معا، ويفوز بفارق كبير.
- لا يملكها أحد. هذا هو الإخفاق الذي لا يخطط له أحد. السحابة المصغرة خدمة، وتحتاج الخدمات إلى شخص مسؤول عند تعطلها. إذا لم يوجد ذلك الشخص، يموت الشيء أول مرة يتوقف فيها في عطلة، ويفقد الجميع الثقة به.
متى تنتقل إلى ما بعد Docker Compose؟ مكدس Compose أعلاه خدمة حقيقية، وسيحمل عددا مدهشا من الطلاب، لكنه جهاز واحد وفيه نسخة واحدة من كل شيء. لا يملك توسعا تلقائيا ولا نسخة ثانية من شيء. وعندما تتجاوزه، لا تعيد الكتابة، بل تنقل القطع نفسها إلى Kubernetes. يستحق مساران أن تعرفهما بالاسم. يشحن مكدس vLLM للإنتاج مخطط Helm مع المقاييس ولوحات المعلومات وإعادة استخدام ذاكرة التخزين المؤقت موصولة مسبقا. وتذهب KubeAI أبعد، فتدير النماذج كموارد Kubernetes، وتشغل vLLM وOllama في الداخل، وتحزم واجهة محادثة، فينكمش معظم هذا الملحق إلى تثبيتي Helm. لا يستبدل أي منهما البوابة، لأن أيا منهما لا يوفر مفاتيح وميزانيات لكل مستخدم. تبقى تلك الطبقة في مكانها تماما.
والحد الصريح هو نفسه الذي انتهى عنده الجزء 2. لا تحرك البوابة أيا من الجدارين. لا تحسن الإنتاجية ولا تجعل الدماغ أذكى. إنها تجعل الدماغ السريع قابلا للمشاركة، وهذا فوز من نوع مختلف، وغالبا ما يحسم هل تستطيع غرفة مليئة بالناس استخدام الذكاء الاصطناعي أصلا.
يريد قسم خدمة ذكاء اصطناعي خاصة تخدم 40 موظفا. يقترح شخص الانتقال مباشرة إلى Kubernetes مع التوسع التلقائي والتقديم متعدد العقد «كي لا نعيد العمل لاحقا». ما الحجة المضادة؟ يقع 40 مستخدما بسهولة ضمن قدرة GPU واحد خلف Docker Compose، ولذلك لا يشتري Kubernetes شيئا اليوم، بينما يكلف أسابيع إعداد وعبئا تشغيليا دائما. وليس مسار الترقية إعادة كتابة: تنتقل الحاويات نفسها وإعداد البوابة نفسه والنموذج نفسه إلى مخططات Helm حين يبرر الحمل ذلك. ابن ما يعمل هذا الشهر، وقس حركتك الحقيقية، ودع القياس يقرر موعد الانتقال. ليس السؤال الصحيح «هل سنتجاوز هذا؟»، بل «من سيكون مناوبا حين يتعطل؟».اعرض الإجابة
يكتمل المفهوم A7 عندما: تستطيع الدفاع عن الجانبين في وضعك، وتستطيع تسمية الشيء الوحيد الذي لا تحسنه البوابة.
الملحق A في سطر واحد
يقدم محرك الاستدلال الرموز وتقدم البوابة الخدمة للناس، وليست سحابة نماذج اللغة الكبيرة المصغرة سوى هذين البرنامجين مع مكان لحفظ المفاتيح. ابنها حين تشترك أفواه كثيرة في ميزانية واحدة. ولاحظ ما فعلته حقا: بالنسبة إلى كل من يشير إلى عنوانك، أنت الآن السحابة.
المراجع
هذه هي المصادر الأساسية لأوامر الصفحة. تتغير بسرعة، لذا تحقق من الوثائق المباشرة قبل الاعتماد على خيار أو سعر أو إصدار محدد.
الجزء 1: محلي (Ollama)
- Ollama، تطبيق سطح المكتب، لتنزيل نموذج والتحدث معه من دون طرفية. https://ollama.com/blog/new-app وhttps://ollama.com/download
- Ollama،
ollama launch، لأمر واحد يصل وكيل برمجة بنموذج محلي ويشغله. https://ollama.com/blog/launch وhttps://docs.ollama.com/integrations/claude-code - Ollama، التوافق مع API في Anthropic، لنقطة النهاية الأصلية التي تجعل الإعداد بلا وكيل وسيط ممكنا. https://ollama.com/blog/claude
- Ollama، طول السياق و
num_ctx، للقيم الافتراضية المبنية على VRAM وإرشاد 64K لوكلاء البرمجة. https://docs.ollama.com/context-length - Claude Code، متغيرات البيئة، من أجل
ANTHROPIC_BASE_URLوANTHROPIC_AUTH_TOKENوAPI_TIMEOUT_MS. https://code.claude.com/docs/en/env-vars - OpenCode، المزودون، من أجل كتلة المزود في
opencode.jsonونقطة النهاية المتوافقة مع OpenAI. https://opencode.ai/docs/providers/ - مثبت المهارات وأوامر GitHub CLI المسماة
gh skill، لتثبيت المهارات ونشرها. https://skills.sh/docs
الجزء 2: الخادم (vLLM)
- vLLM، الصفحة الرئيسية للوثائق، للتثبيت و
vllm serveوالخادم المتوافق مع OpenAI. https://docs.vllm.ai - vLLM، استدعاء الأدوات، من أجل
--enable-auto-tool-choiceومحلل استدعاء الأدوات لكل عائلة نماذج. https://docs.vllm.ai/en/latest/features/tool_calling/ - vLLM، تكامل Claude Code، لدعم Anthropic Messages ومتغيرات
ANTHROPIC_DEFAULT_*_MODEL. https://docs.vllm.ai/en/latest/serving/integrations/claude_code/ - Qwen، دليل النشر باستخدام vLLM، لتقديم نماذج Qwen3 والمحللات الموصى بها. https://qwen.readthedocs.io/en/latest/deployment/vllm.html
الجزء 3: السحابة (OpenRouter)
- OpenRouter، تكامل Claude Code، لمتغيرات البيئة ونقطة النهاية المتوافقة مع Anthropic. https://openrouter.ai/docs/cookbook/coding-agents/claude-code-integration
- OpenRouter، صفحة نموذج Kimi K3، للاسم المباشر والسعر والمزودين. https://openrouter.ai/moonshotai/kimi-k3
- OpenRouter، صفحة نموذج DeepSeek V4 Pro، للاسم المباشر والسعر والمزودين. https://openrouter.ai/deepseek/deepseek-v4-pro
- Moonshot AI، مدونة Kimi K3 التقنية، للبنية ونافذة السياق وتوصيات التقديم. https://www.kimi.com/blog/kimi-k3
- DeepSeek، تسعير API، لأسعار V4 Pro الحالية وتسعير إصابة ذاكرة التخزين المؤقت. https://api-docs.deepseek.com
المفهوم 16: Claude Code Router
- Claude Code Router، لتثبيت الموجه وإعداد
ProvidersوRouterوالمتحولات وأوامرccr. https://github.com/musistudio/claude-code-router
الملحق A: سحابة نماذج لغة كبيرة مصغرة
- LiteLLM، وثائق الخادم الوكيل، لملف الإعداد والمفاتيح الافتراضية والميزانيات وحدود المعدل. https://docs.litellm.ai/docs/simple_proxy
- LiteLLM، المفاتيح الافتراضية، من أجل
/key/generateو/key/infoو/key/deleteوالوصول إلى النماذج لكل مفتاح. https://docs.litellm.ai/docs/proxy/virtual_keys - LiteLLM، الميزانيات وحدود المعدل، من أجل
max_budgetوbudget_durationوrpm_limit. https://docs.litellm.ai/docs/proxy/users - LiteLLM، الموثوقية والبدائل الاحتياطية، لقواعد البدائل في
router_settings. https://docs.litellm.ai/docs/proxy/reliability - vLLM، النشر باستخدام Docker، للصورة الرسمية
vllm/vllm-openaiوخيارات وقت تشغيل GPU. https://docs.vllm.ai/en/latest/deployment/docker.html - vLLM، مقاييس الإنتاج، لنقطة نهاية Prometheus وعمق الصف والوقت حتى أول رمز. https://docs.vllm.ai/en/latest/serving/metrics.html
- vLLM، مكدس الإنتاج، وهو مخطط Helm مع التوجيه والمقاييس ولوحات المعلومات لمسار الترقية إلى Kubernetes. https://github.com/vllm-project/production-stack
- KubeAI، مشغل استدلال الذكاء الاصطناعي في Kubernetes، لإدارة النماذج كموارد Kubernetes عبر vLLM وOllama. https://www.kubeai.org
- Open WebUI، الوثائق، لواجهة المحادثة وربطها بنقطة نهاية متوافقة مع OpenAI. https://docs.openwebui.com
- NVIDIA، دليل تثبيت Container Toolkit، وهو مطلوب لوصول GPU داخل Docker. https://docs.nvidia.com/datacenter/cloud-native/container-toolkit/latest/install-guide.html